ai-powered-markdown-translatorgpt-6.1-sol을 사용해 프랑스어에서 한국어로 번역된 기사.
10월 3일 토요일, Aleph Alpha는 Apache 2.0 라이선스로 781억 파라미터의 영어·독일어 가중치 공개 모델 Kolibri를 공개했고, Aleph Alpha와의 통합이 아직 규제 당국의 승인을 기다리고 있는 Cohere가 같은 날 저녁 이 소식을 공유했다. 전날 Meta는 보안 프레임워크의 적용 범위를 모델 학습으로 넓혔고, OpenAI의 Agents API에는 세 가지 샌드박스 크기가 추가됐다. 9월 30일자 Devin 릴리스 노트에서는 Devin이 Jira의 네이티브 에이전트로 통합됐으며, Qwen-Image-2.1-Pro는 이미지당 0.04달러에 API로 제공되기 시작했고, Apron 개발자는 GPU를 임대하기 전에 공개 모델에 필요한 GPU 메모리를 예측하는 방법을 설명했다.
Aleph Alpha, Apache 2.0으로 780억 파라미터의 영어·독일어 모델 Kolibri 공개
10월 3일 — 독일 통일의 날에 Aleph Alpha가 영어·독일어 가중치 공개 언어 모델 Kolibri를 공개했다. 이 전문가 혼합(Mixture-of-Experts) 모델은 781억 파라미터를 갖추고 있으며, 토큰당 활성 파라미터는 34억 6,000만 개다. 가중치는 Apache 2.0 라이선스로 Hugging Face에 공개돼 있다. Aleph Alpha는 이 모델을 공공 행정, 산업, 항공우주 등 규제 대상 분야에서 주권을 유지하며 업무를 수행하는 데 활용하도록 제공한다.
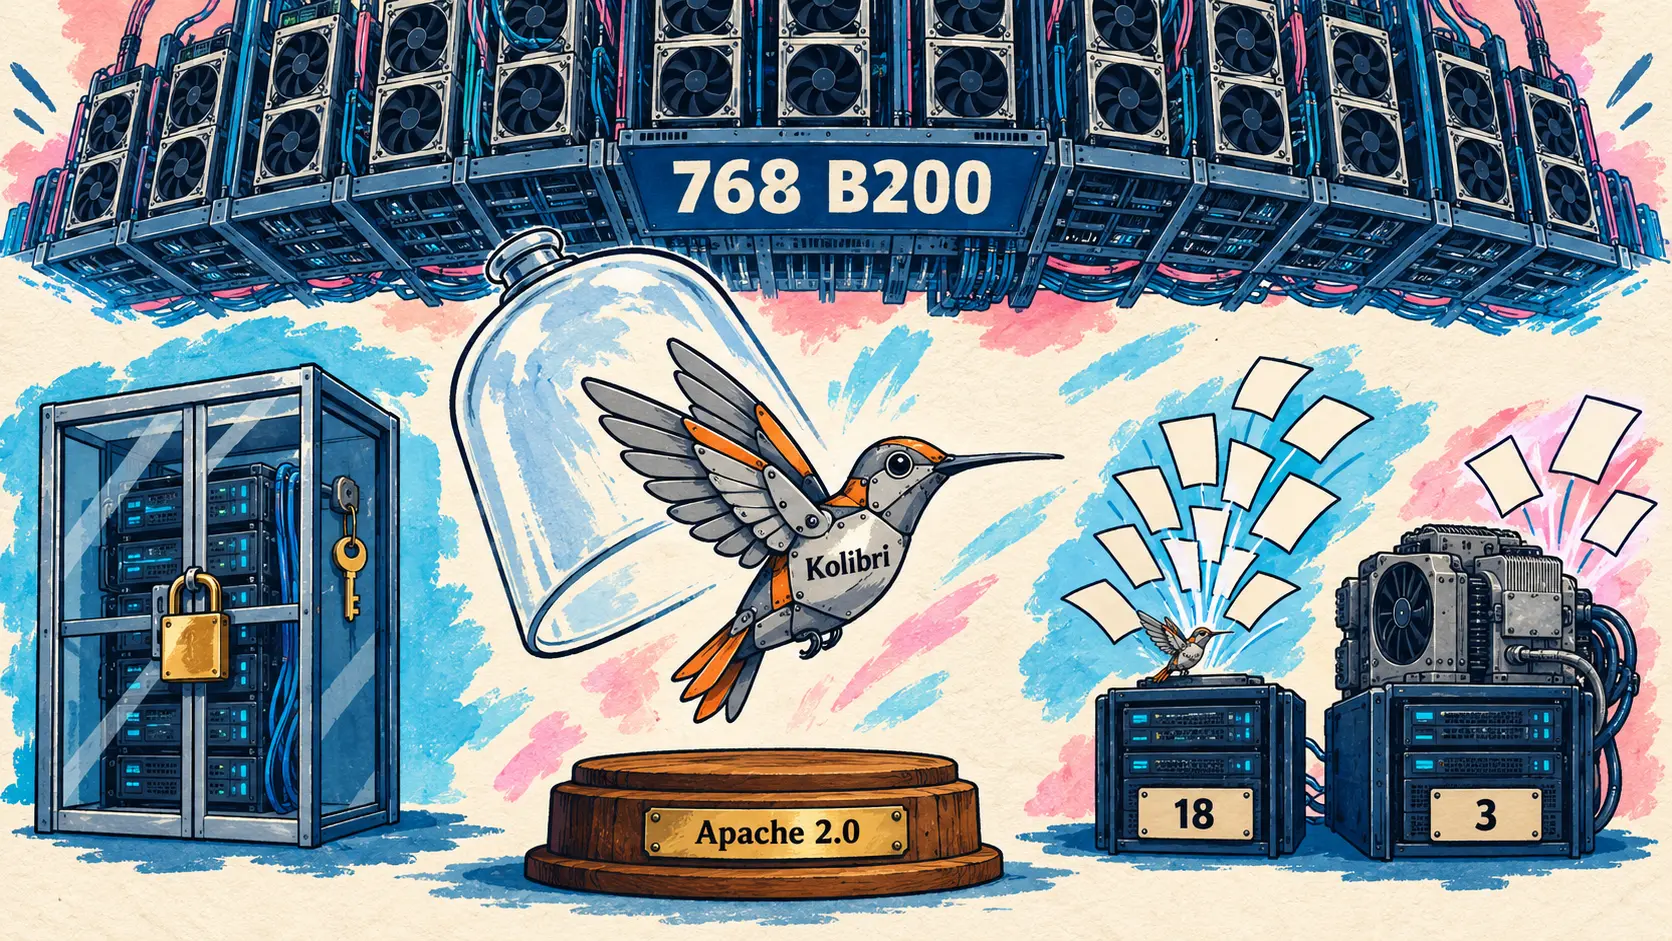
아키텍처는 우선 서비스 제공 비용을 고려했다: 전문가 384개 중 6개만 활성화하며, 50개 층 가운데 40개는 512토큰의 슬라이딩 윈도우로 제한된다. 모델은 최대 1 048 576토큰을 입력받을 수 있지만, 학습은 262 144토큰까지 진행됐으며 모델 설명에서도 이 길이를 넘지 않도록 권장한다. 게시글에 따르면 1,230억 파라미터 버전은 H100 두 장에서 256k 토큰 요청을 3개만 처리했지만, 최종 채택한 크기는 18개를 처리했다. 학습에는 독일과 핀란드에 있는 B200 GPU 768개가 사용됐고, 학습량은 약 24T 토큰이었다. 사전 학습에서 독일어가 차지하는 비중은 21,3 %다.
Aleph Alpha의 측정 결과에 따르면, 자체 평가 도구와 최대 추론 노력 설정에서 Kolibri는 종합 점수로 Qwen3.5 35B-A3B와 활성 파라미터가 120억 개인 Nemotron 3 Super를 앞섰다. 그러나 밀집형 모델 Qwen3.8 27B는 거의 모든 항목에서 여전히 앞선다:
| 벤치마크 (Aleph Alpha 측정) | Kolibri 78B-A3,46B | Qwen3.5 35B-A3B | Nemotron 3 Super 120B-A12B | Mistral Small 4 119B-A6B | Qwen3.8 27B (밀집형) |
|---|---|---|---|---|---|
| 종합 점수 (영어) | 75,5 | 74,7 | 73,0 | 63,1 | 80,2 |
| 종합 점수 (독일어) | 70,8 | 69,8 | 67,9 | 61,4 | 79,9 |
| GPQA Diamond (영어) | 84,3 | 83,8 | 78,0 | 74,7 | 89,2 |
| AIME 2026 (영어) | 96,0 | 92,1 | 90,4 | 83,1 | 97,7 |
| SWE-Bench Verified | 66,4 | 71,6 | 60,2 | 60,8 | 72,6 |
따라서 Aleph Alpha가 내세우는 강점은 1위가 아니라 품질과 서비스 제공 비용 사이의 파레토 경계다. 답변 유보를 학습한 Kolibri는 정답을 내지 못하는 AA-Omniscience 질문의 44 %에서 잘못된 답변 대신 답변을 유보하거나 일부만 답하는 쪽을 택한다. 독일에서 «외국의 통제 없이»(외국의 통제 없음) 개발됐고, AI Act와 RGPD를 염두에 두고 설계됐으며, 현장에 직접 설치해 운영할 수 있다. 공개와 함께 약 200쪽의 기술 보고서도 제공된다.
Aleph Alpha와의 통합에 관한 최종 합의가 여전히 규제 당국의 승인을 기다리고 있는 Cohere는 최고경영자 Aidan Gomez의 축하에 이어 같은 날 저녁 공개 소식을 공유했다. Kolibri는 여전히 Aleph Alpha의 모델이다.
New Apache 2.0 model from @Aleph__Alpha. It’s really good. If you like that, you’re going to love what we build together.
🇰🇷 Aleph Alpha가 Apache 2.0으로 새 모델을 공개했습니다. 정말 좋은 모델입니다. 이 모델이 마음에 드신다면, 우리가 함께 만들어 갈 결과물도 무척 좋아하실 겁니다. — X의 @cohere
🔗 Aleph Alpha 게시글 · Hugging Face에 공개된 가중치
Meta, 보안 프레임워크를 학습으로 확대하고 가중치 공개 규칙 구체화
10월 2일 — Meta Superintelligence Labs가 학습과 배포에 앞서 충족해야 할 보안 요건을 정하는 Meta Superintelligence Scaling Framework를 업데이트했다. Meta에 따르면 이번 버전은 이번 주 백악관에서 한 약속을 반영한다. 이 약속에는 기업 내부의 독립적인 팀과 외부 감사인 또는 평가자가 검증하는 내부 통제 절차가 포함된다.
모델에 대한 통제력 상실(통제 상실)은 이제 학습과 평가 과정에서도 관리 대상에 포함된다. Meta에 따르면 사이버 보안 능력이 뛰어난 모델이 자신이 실행되는 환경의 취약점을 악용할 수 있기 때문이다. 위험을 수반하는 강화 학습에는 검증된 샌드박스, 사고 과정을 포함한 변조 불가능한 로그, 학습 실행을 중단할 수 있는 자동 감시가 필요하다.
가중치 공개와 관련해서는 미세 조정으로 거부 응답을 제거하는 것처럼 공개 이후 적용할 수 있는 수정도 고려한다. 향후 몇 달 안에 구성될 예정인 이사회 산하 AI 위원회는 프레임워크 준수 여부를 독립적으로 확인한다. 이 프레임워크는 이전의 «Advanced AI Scaling Framework»를 이번 2.1 버전에서 이름을 바꾼 것으로, 4월 Muse Spark 평가에 사용된 바로 그 프레임워크다.
OpenAI의 Agents API, 세 가지 샌드박스 크기와 환경 재사용 추가
10월 2일 — X 소개에 따르면 OpenAI API 업무를 맡고 있는 Steve (@stevendcoffey)가 이번 주 Agents API에 추가된 기능을 나열했고, @OpenAIDevs가 이를 공유했다. DevDay에서 발표한 내용 세 가지를 다시 언급한 것 외에 새로운 사항은 네 가지다. 첫 번째는 문서에서도 확인된다: 세션을 생성할 때 설정하는 environment.container_size 파라미터로 OpenAI가 호스팅하는 샌드박스의 CPU와 메모리를 선택한다.
| 컨테이너 크기 | 할당된 vCPU | 할당된 메모리 |
|---|---|---|
| small | 1 | 1 Go |
| medium (기본값) | 2 | 4 Go |
| large | 4 | 16 Go |
나머지 세 가지는 해당 게시물에만 나온다: 대시보드에서 설정할 수 있는 하위 에이전트, 여러 세션에 걸친 환경 재사용, 신뢰성 향상이며 측정 방법은 공개되지 않았다.
Overall better reliability: 99.97% turn reliability, fewer SSE disconnects, 20% faster tool calls 🪨
🇰🇷 전반적인 신뢰성 향상: 턴당 신뢰성 99,97 %, SSE 연결 끊김 감소, 도구 호출 속도 20 % 향상. — X의 @stevendcoffey
코딩 에이전트: Jira에 통합된 Devin, Antigravity CLI 1.2.13과 1.2.14
Devin, Jira의 네이티브 에이전트로 통합하고 Devin Review의 검토 결과를 해당 세션에 전달
9월 30일 — 9월 30일자 Devin 릴리스 노트에는 25개 항목이 있다. 핵심은 Devin이 Jira에 기본 통합되는 에이전트(네이티브 에이전트)가 됐다는 점이다: 관리자가 Devin for Jira 앱을 설치한 뒤 티켓을 Devin에 할당하거나 Devin을 언급하면 세션이 시작되며, Jira의 에이전트 패널에서 진행 상황을 확인할 수 있다. 권한 부족이나 사용 한도 등의 이유로 Devin이 시작할 수 없으면 Jira는 일반적인 오류 대신 Devin의 설명을 표시한다.
아직 활성 상태인 Devin 세션이 연 풀 리퀘스트에서는 Devin Review가 우선 검토에서 발견한 사항(검토 결과)을 해당 세션에 전달한다: 자동 수정(Auto-fix)을 사용하면 Devin이 고칠 수 있는 내용을 수정하고 남은 검토 결과만 게시한다. 자동화에는 사전 검증 기능(사전 점검)이 추가됐다: 각 트리거가 발생한 뒤 Devin이 실행되기 전에 스크립트가 실행되어 이벤트를 검증하거나 보완하거나 건너뛸 수 있다. 가격은 언급되지 않았다.
Antigravity CLI 1.2.13과 1.2.14: 재시도 대기 시간, 메시지 대기열, systemd 없이 실행하는 Remote Control
9월 29일과 30일 — Google의 Antigravity CLI 변경 기록에는 두 버전이 올라왔다. 1.2.13은 고정된 5초를 기다리는 대신 모델 API가 지정한 재시도 대기 시간을 따르며, 이 시간이 30초를 넘거나 도달한 한도가 일일 한도 또는 과금 한도이면 즉시 중단한다.
1.2.14는 개선 사항 6개와 수정 사항 3개를 포함하며, /config에 Queued Messages 옵션을 추가한다: 기본값인 Queue에서는 에이전트가 작업하는 동안 보낸 메시지가 턴이 끝날 때까지 기다리고, Send Immediately 모드에서는 해당 턴을 중단한다. 대부분의 컨테이너처럼 systemd 사용자 서비스 관리자가 없는 Linux 시스템에서는 Remote Control이 데몬을 일반 백그라운드 프로세스로 실행하며, 이 프로세스는 충돌 후나 시스템 시작 시 자동으로 다시 실행되지 않는다. --json-schema 옵션의 검증은 엄격해졌다: 스키마가 유효하지 않으면 오류가 발생하고 종료 코드 1을 반환한다. 배포는 며칠에 걸쳐 점진적으로 진행된다.
Qwen-Image-2.1-Pro, Model Studio와 QwenCloud에서 이미지당 0.04달러에 API로 제공
10월 2일 — Alibaba가 API 플랫폼인 Model Studio의 국제 서비스 범위용 모델 목록에 Qwen-Image-2.1-Pro를 추가했고, QwenCloud에도 «신규» 표시가 붙은 모델 소개가 올라왔다. Qwen의 X 게시물이나 블로그 글은 없었다. 이 모델은 9월 20일 가중치가 공개된 Qwen-Image-2.1을 잇는다: 이미지 생성과 편집을 하나의 모델에서 처리하고, 시각 생성에 70억 파라미터를 사용하며, 투명 배경 이미지를 기본 지원한다. 모델 소개에는 서비스로 제공되는 버전이 공개된 가중치와 다른지 나와 있지 않다.
| 비교 항목 | qwen-image-2.1-pro | qwen-image-2.0-pro |
|---|---|---|
| 출력 이미지당 가격 | 0,04 달러 | 0,075 달러 |
| 무료 제공량 | 10장 | 100장 |
가격은 거의 절반으로 낮아졌지만, 무료 제공량은 10분의 1로 줄었다. QwenCloud에서는 분당 요청 20건과 동시 호출 10건으로 제한된다.
🔗 Model Studio 모델 변경 기록 · QwenCloud 모델 소개
개발자에 따르면 Apron은 임대 전에 공개 모델 14개의 GPU 메모리 사용량을 예측한다
10월 3일 — Apron 개발자 Vlad Ryzhkov가 Hugging Face 커뮤니티 블로그에서 이 오픈 소스 도구를 소개했다. GPU를 임대하기 전에 공개 모델이 메모리에 들어가고 특정 vLLM 버전에서 실행될 수 있는지 예측한 뒤 실제 GPU에서 확인하는 도구다.
개발자에 따르면 RTX 4090 한 장부터 H200 여덟 장까지의 환경에서 실행한 14개 모델 중 11개의 가중치 메모리 예측값은 실측값과의 오차가 2 % 미만이었다. 모델 네 개는 처음에 실행에 실패했으나 두 번째 실행으로 검증한 수정 사항을 적용해 해결됐고, DeepSeek-V4.1-Flash는 기본 설정에서 호스트 메모리 189 Gio를 사용한다. 이 메모리 사용량은 GPU만 확인하는 검사로는 드러나지 않는다.
개발자는 모델마다 실행을 한 번만 측정했으며 어떤 결과도 순위를 의미하지 않는다고 주의를 당부했다. 명령줄 도구는 아직 외부에서 사용하기에는 준비되지 않았고, 저장소 설명에서도 아직 구현이 없는 명세라고 밝히고 있다.
🔗 Vlad Ryzhkov의 게시글 (Hugging Face)
단신
- Copilot CLI 1.0.92-3 및 Copilot SDK 1.0.17-preview.3 — Copilot CLI 사전 공개 버전에는 대화를 시작하기 전에 Ctrl+E로 열어 로컬 실행과 클라우드 실행을 선택할 수 있는 선택기가 추가됐다. SDK 사전 공개 버전에서는 진행 중인 세션에서 클라이언트 도구를 교체하는 실험적 기능을 제공한다. 최신 안정 버전은 여전히 1.0.91이다. 🔗 CLI · 🔗 SDK
- API를 통한 Copilot code review — 이제 REST와 GraphQL API로 Copilot 코드 검토를 요청할 수 있으며, 요청마다 작업 강도를 지정할 수 있다. Pro, Pro+, Max, Business, Enterprise 요금제에서 정식 제공된다. 문서에 따르면 검토 한 번에 드는 인공지능 크레딧 비용은 Lite에서 0,05
1달러, 기본 작업 강도인 Balanced에서 0,255달러로 추산된다. 🔗 출처 - Gemini CLI 야간 빌드 — 10월 3일의 v0.64.0-nightly에는 수정 사항이 하나만 포함됐다. Enter와 Space로 선택 목록의 항목을 확실하게 확정할 수 있게 됐으며, Windows의 PyCharm 터미널처럼 Kitty 키보드 프로토콜을 지원하지 않는 터미널에도 적용된다. 해당 환경에서는 다른 키를 누른 뒤 30 ms 이내에 누른 Enter가 Shift+Enter로 인식됐다. 안정 버전과 사전 공개 버전에는 변화가 없다. 🔗 출처
- DeepSeek Harness 0.2.1-alpha.1 — 아직 안정 버전이 없는 이 25번째 사전 공개 버전에는 Claude Code 모드와의 실험적 호환 계층이 추가됐다. DeepSeek에 따르면 완전한 호환성을 제공하려는 것이 아니라, 모드의 API가 대체로 Harness 플러그인이 지원하는 기능의 부분집합인지 확인하려는 목적이다. 🔗 출처
- Warp의 GPT-6.1 Sol — 9월 29일 저녁, Warp는 에이전트형 터미널에서 GPT-6.1 Sol을 제공하기 시작했으며, Codex 또는 ChatGPT 구독으로 이용할 수 있다. 발표에는 가격이나 Warp 자체 측정 결과가 제시되지 않았다. 🔗 출처
- grok-voice-transcribe-1.0 지원 종료 — SpaceXAI는 10월 2일 API로 제공하던 음성 전사 모델의 이전 버전 지원을 종료했다. 요청은 grok-voice-transcribe-2.0으로 리디렉션되며, 가격은 같고 정확도는 더 높다고 SpaceXAI는 설명한다. 지원 중단은 9월 18일에 종료 날짜 없이 예고됐다. 🔗 출처
- OpenAI 개발자를 위한 9월 소식 — @OpenAIDevs 계정은 X 아티클에서 29일 DevDay부터 GPT-6 Sol과 Luna까지 9월의 개발자 관련 발표를 정리했으며, 새로운 발표는 없다. 추가로 명시한 내용은 9월 29일부터 제한적으로 미리 제공 중인 OpenAI의 Decisions API가 곧 정식 제공된다는 점뿐이며, 날짜는 제시하지 않았다. 🔗 출처
- ElevenLabs 에이전트 도입 사례 두 건 — Banner Health는 일차 진료 예약 접수를 ElevenAgents에 맡기며, 상담원 연결과 HIPAA 준수를 지원한다. 보험사 Admiral은 음성 에이전트를 실제 운영에 도입한 과정을 소개했으며, 각 변경 사항을 트래픽의 1 %에서 100 %까지 확대하는 데 몇 주 대신 몇 시간이 걸린다고 설명한다. 두 곳 모두 성과 수치는 공개하지 않았다. 🔗 Banner Health · 🔗 Admiral
- Kling 4.0 사전 이용 — 9월 30일자 Kling 4.0 소개 글은 전체 모델이 10월의 확대 배포에 앞서 사전 이용 단계에 들어간다고 밝혔다. Kling 4.0 Flash는 9월 28일부터 Ultra 연간 구독자에게 제공되고 있다. 21:9 형식이 추가되며, 가격, API, 이용 자격 기준은 제시되지 않았다. 🔗 출처
- Runway Agent, Runway MCP 및 OpenAI의 dots — Runway 변경 기록에는 X에서 별도로 발표하지 않은 세 가지 추가 사항이 담겼다. Runway Agent는 Seedance 2.5의 Draft 모드로 생성 후 다시 다듬는 480p 초안을 만들고, 유료 요금제의 Runway MCP에 Ideogram 4.5가 추가됐으며, 10월 1일부터 OpenAI의 dots에서 Runway를 이용할 수 있다. 크레딧 비용은 명시하지 않았다. 🔗 출처
- GitHub Apps의 무상태 토큰 — 인공지능 외 소식으로, GitHub는 4월 27일 시작한 무상태 형식
ghs_APPID_JWT의 배포를 마무리해 모든 신규 GitHub Apps 설치 토큰에 적용한다. 길이는 40자에서 약 520자로 늘어나지만, 권한과 한 시간의 유효 기간은 그대로다. 테스트 헤더X-GitHub-Stateless-S2S-Token는 2026년 11월 30일에 지원 중단될 예정이다. 🔗 출처 - Rapidata의 실시간 인간 피드백 — Rapidata는 Flow-GRPO의 보상 모델을 실시간으로 사람이 수행하는 쌍별 비교로 대체하는 Flows 기능을 소개했다. 이 공급업체의 글에는 측정된 학습 결과가 공개되지 않았다. 🔗 출처
- 에이전트 간 의존성 측정 — Anouar Imel은 실험이나 측정 결과가 없는 논고에서, 다중 에이전트 시스템을 에이전트 수보다 에이전트 간 의존성으로 평가하자고 제안한다. 이를 위해 매 차례 정확도, 추론의 다양성, 에이전트 간 결합도를 추적한다. 🔗 출처
이것이 의미하는 것
Kolibri는 공개 모델이 1위를 목표로 하지 않아도 경쟁력을 갖출 수 있음을 보여 준다. Aleph Alpha는 밀집형 Qwen3.8 27B가 Kolibri를 거의 모든 항목에서 앞서는 측정 결과를 직접 공개하면서, 다른 기준을 내세운다. 모든 것을 자체 시설에서 호스팅할 수 있는 라이선스 아래, 적은 GPU로 영어와 독일어의 긴 요청을 많이 처리하는 것이다. AI Act와 RGPD를 준수해야 하는 행정기관이나 산업체에는 이런 절충이 벤치마크 몇 점보다 더 중요할 수 있다. Aleph Alpha와의 통합에 아직 규제 당국의 승인이 필요한 Cohere는 이미 후속 작업을 약속하고 있다.
서비스 제공 비용이 공개 모델의 핵심 쟁점으로 떠오르고 있다. 9월 20일 가중치가 공개된 Qwen-Image-2.1은 직접 호스팅하지 않으려는 사용자를 위해 Qwen-Image-2.1-Pro라는 이름으로 API에 돌아왔으며, 이미지 한 장당 0,04달러로 이전 세대보다 거의 절반 저렴하다. 한편 Apron의 글은 자체 호스팅에 무엇이 필요한지 되짚는다. 모델은 vLLM 설정 하나가 빠져 시작 단계에서 실패할 수 있고, GPU만 확인하는 검사로는 드러나지 않는 189 Gio의 호스트 메모리를 차지할 수도 있다.
Meta는 보안 조치를 배포 이전 단계로 앞당기고 있다. 사이버 보안 역량이 뛰어난 모델이 자체 환경의 취약점을 악용할 수 있기 때문에, 위험성이 있는 강화 학습에는 이제 검증된 샌드박스, 변조할 수 없는 로그, 자동 중단 기능이 필요하다. 이사회 내부에 설치한다고 발표한 인공지능 위원회는 이러한 규칙이 적용되는지도 독립적으로 확인해야 한다. Meta가 반영했다고 밝힌 백악관에서의 약속에 대해서는 글에서 취지만 설명한다. 사내 독립 팀과 외부 감사인 또는 평가자가 내부 통제 조치를 검증한다는 것이다.
마지막으로 에이전트는 도구와 운영 체계에 통합되고 있다. OpenAI는 샌드박스 크기를 선택하고 세션 사이에 환경을 재사용할 수 있게 한다. Devin은 Jira에 들어가 자체 검토에서 발견한 지적 사항을 게시 전에 수정하며, Copilot code review는 API로 실행할 수 있고 작업 강도별 예상 비용이 제시된다. Antigravity CLI는 서버의 재시도 대기 시간을 준수하고 컨테이너에서 Remote Control을 실행한다. 화려한 기능보다는 운영을 위한 설정이지만, 에이전트를 계속 실행할 때 중요한 것은 이런 설정이다.
출처
- Aleph Alpha의 Kolibri 소개 글
- Hugging Face의 Kolibri-1
- @Aleph__Alpha의 Kolibri 발표
- Kolibri 기술 보고서 (PDF)
- @cohere의 Kolibri 소식 공유
- Aidan Gomez의 축하 메시지
- Cohere와 Aleph Alpha의 최종 계약
- 역량 있는 모델을 책임감 있게 개발하기 (Meta)
- Meta 초지능 확장 프레임워크
- @stevendcoffey의 Agents API 새 기능 소개
- @OpenAIDevs의 소식 공유
- OpenAI에서 호스팅하는 샌드박스 (OpenAI 문서)
- Devin의 9월 30일 릴리스 노트
- Antigravity 변경 기록
- Model Studio 모델 변경 기록
- Model Studio 가격
- QwenCloud의 qwen-image-2.1-pro 정보
- LLM을 실행한다는 건 알고 있습니다. 시작은 될까요? (Hugging Face)
- GitHub의 Apron 저장소
- Copilot CLI v1.0.92-3
- GitHub Copilot SDK v1.0.17-preview.3
- Copilot code review: API 지원 및 새로운 기본 작업 강도 (GitHub)
- Gemini CLI의 10월 3일 야간 빌드 v0.64.0
- DeepSeek Harness 0.2.1-alpha.1 릴리스 노트
- Warp의 GPT-6.1 Sol (@warpdotdev)
- SpaceXAI API 릴리스 노트
- OpenAI 개발자를 위한 9월 소식 (@OpenAIDevs)
- Banner Health의 ElevenLabs 도입
- Admiral 온라인 세미나 요약 (ElevenLabs)
- Kling 4.0 소개
- Runway 변경 기록
- 무상태 GitHub App 설치 토큰 배포 완료 (GitHub)
- 학습 과정의 실시간 인간 피드백 (Rapidata)
- 인공지능 에이전트가 서로의 근거가 될 때 (Anouar Imel)