ai-powered-markdown-translatorgpt-6.1-solを使用してフランス語から日本語に翻訳された記事。
10月3日(土)、Aleph Alphaは、Apache 2.0ライセンスで重みを公開した781億パラメータの英語・ドイツ語モデルKolibriを発表した。同日夜にはCohereもこの発表を紹介したが、同社とAleph Alphaの統合は依然として規制当局の承認待ちだ。前日にはMetaが安全性の枠組みをモデルの学習にも拡張し、OpenAIのAgents APIには3種類のサンドボックスサイズが追加された。9月30日付のDevinのリリースノートでは、DevinがJiraに組み込まれたエージェントとなった。Qwen-Image-2.1-Proは1画像あたり0,04ドルでAPI提供を開始し、Apronの開発者は、GPUを借りる前にオープンモデルのGPUメモリ使用量を予測する方法を解説している。
Aleph Alphaが780億パラメータの英語・ドイツ語モデルKolibriをApache 2.0で公開
10月3日 — ドイツ統一の日に、Aleph Alphaは重みを公開した英語・ドイツ語の言語モデルKolibriを発表した。この混合エキスパート(Mixture-of-Experts)モデルは781億のパラメータを持ち、トークンごとに34億6000万のパラメータが有効になる。重みはApache 2.0ライセンスでHugging Faceに公開されている。Aleph Alphaは、公共行政、産業、航空宇宙など、規制対象分野で主権を確保した業務に使うことを想定している。
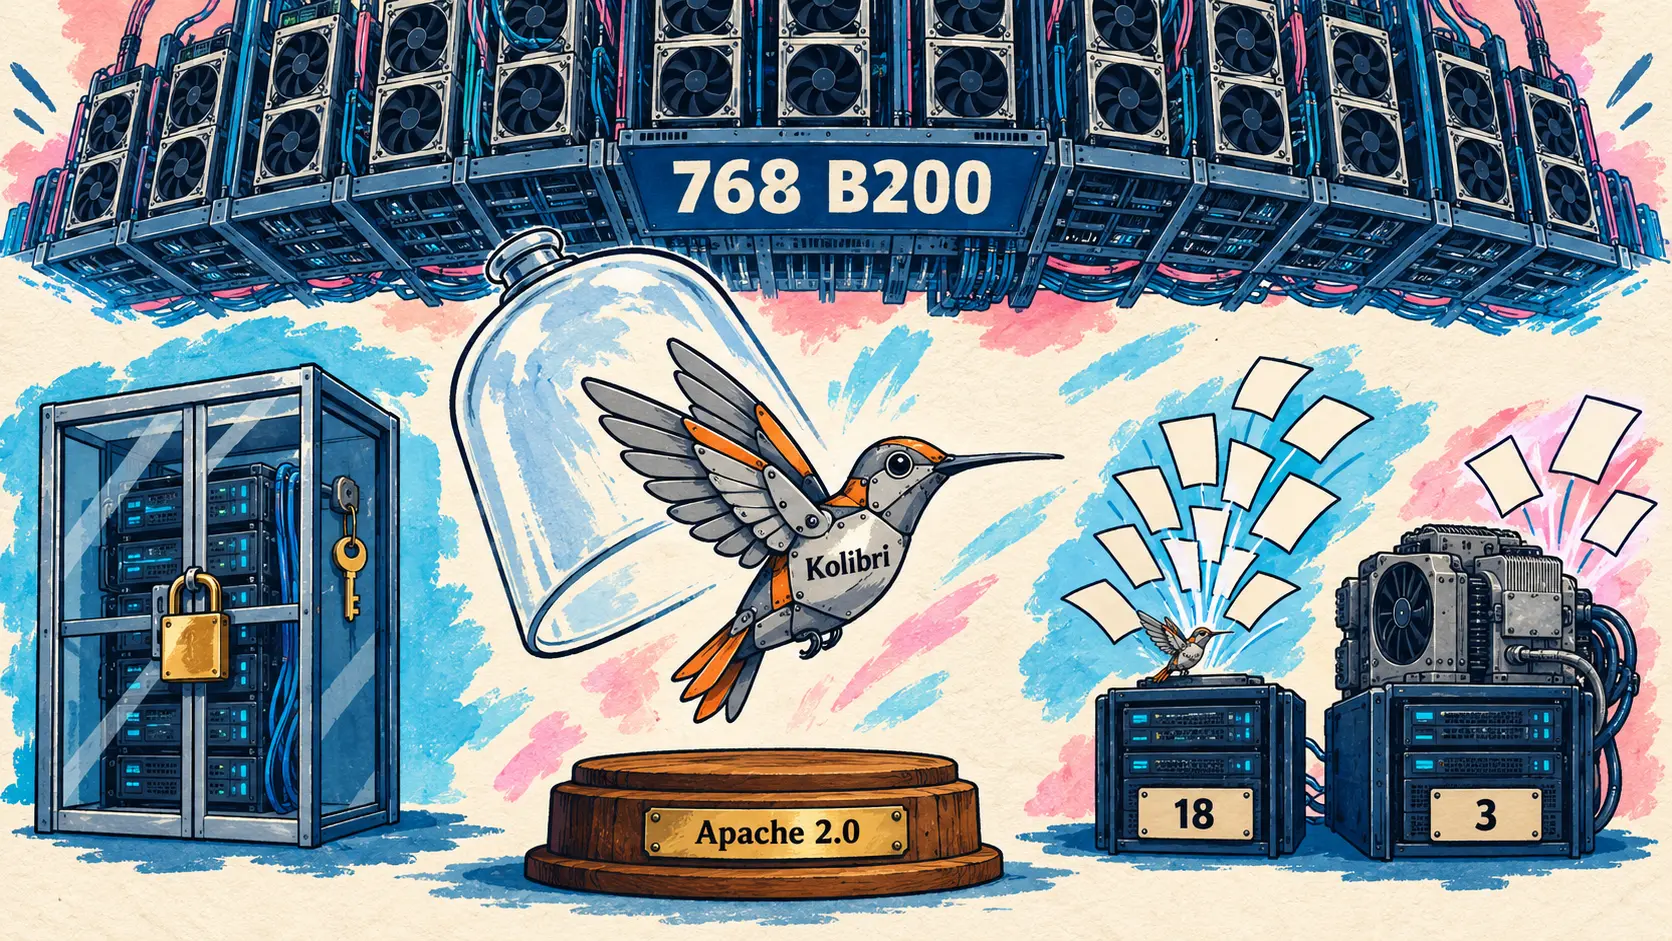
設計上、まず重視されているのは提供コストだ。384個のエキスパートのうち6個が有効になり、50層のうち40層は512トークンのスライディングウィンドウに制限されている。モデルは最大1 048 576トークンを受け付けるが、学習時の最大長は262 144トークンで、モデルカードもこの長さを超えないことを推奨している。記事によると、1,230億パラメータ版では2基のH100で256kトークンのリクエストを3件しか処理できなかったのに対し、採用されたサイズでは18件を処理できた。学習にはドイツとフィンランドで768基のB200 GPUを使用し、約24Tトークンを処理した。事前学習におけるドイツ語の割合は21,3 %だった。
Aleph Alphaの測定(独自の評価基盤、推論努力は最大設定)では、Kolibriの総合スコアはQwen3.5 35B-A3Bと、有効パラメータ数が120億のNemotron 3 Superを上回る。ただし、密なモデルであるQwen3.8 27Bは、ほぼすべての項目でさらに上回っている。
| ベンチマーク(Aleph Alphaによる測定) | Kolibri 78B-A3,46B | Qwen3.5 35B-A3B | Nemotron 3 Super 120B-A12B | Mistral Small 4 119B-A6B | Qwen3.8 27B(密) |
|---|---|---|---|---|---|
| 総合スコア(英語) | 75,5 | 74,7 | 73,0 | 63,1 | 80,2 |
| 総合スコア(ドイツ語) | 70,8 | 69,8 | 67,9 | 61,4 | 79,9 |
| GPQA Diamond(英語) | 84,3 | 83,8 | 78,0 | 74,7 | 89,2 |
| AIME 2026(英語) | 96,0 | 92,1 | 90,4 | 83,1 | 97,7 |
| SWE-Bench Verified | 66,4 | 71,6 | 60,2 | 60,8 | 72,6 |
したがって、Aleph Alphaが訴求するのは首位ではなく、品質と提供コストの間のパレートフロンティアだ。回答を控えるようにも学習したKolibriは、AA-Omniscienceで正答できない質問の44 %について、誤答するより回答を控えるか、部分的に回答することを選ぶ。ドイツで「外国による支配を受けず」(外国による支配なし)に開発され、AI ActとRGPDを念頭に設計されており、オンプレミスでも稼働できる。公開に合わせて、約200ページの技術報告書も発表された。
Cohereは、最高経営責任者のエイダン・ゴメスが祝意を示した後、同日夜にこの公開を紹介した。同社とAleph Alphaの統合に関する最終合意は、引き続き規制当局の承認を条件としている。KolibriはAleph Alphaのモデルだ。
New Apache 2.0 model from @Aleph__Alpha. It’s really good. If you like that, you’re going to love what we build together.
🇯🇵 Aleph AlphaによるApache 2.0ライセンスの新モデルです。とても優れています。これを気に入っていただけたなら、私たちが一緒に開発するものをきっと大好きになるはずです。 — Xの@cohere
🔗 Aleph Alphaの記事 · Hugging Faceで公開された重み
Metaが安全性の枠組みを学習にも拡張し、公開する重みのルールを明確化
10月2日 — Meta Superintelligence Labsは、学習とデプロイの前に満たすべき安全性要件を定めたMeta Superintelligence Scaling Frameworkを更新した。Metaによると、この版は今週ホワイトハウスで表明した約束を反映している。その約束には、社内の独立したチームと外部の監査人または評価者が検証する内部統制が含まれる。
制御喪失(制御の喪失)への対策は、学習と評価の段階にも適用されるようになった。Metaによると、サイバーセキュリティ能力の高いモデルは、自身の環境の脆弱性を悪用できるためだ。リスクを伴う強化学習では、検証済みのサンドボックス、思考の連鎖を含む改ざん不可能なログ、そして学習の実行を停止できる自動監視が求められる。
公開する重みについては、ファインチューニングで拒否動作を取り除くといった、公開後に可能な改変も考慮している。今後数か月以内に設置予定の取締役会のAI委員会が、この枠組みの遵守を独立して確認する。この枠組みは、従来の「Advanced AI Scaling Framework」を今回のバージョン2.1で改称したもので、4月にMuse Sparkを評価した際にも用いられた。
OpenAIのAgents APIに3種類のサンドボックスサイズと環境の再利用を追加
10月2日 — XのプロフィールによるとOpenAIのAPI開発に携わっているスティーブ(@stevendcoffey)が、Agents APIの今週の更新内容を列挙し、@OpenAIDevsが紹介した。DevDayの発表を再掲した3項目に加え、新しい項目が4つある。最初の項目はドキュメントでも確認できる。セッション作成時に設定するパラメータenvironment.container_sizeで、OpenAIがホストするサンドボックスのCPUとメモリを選択できる。
| コンテナのサイズ | 割り当てられるvCPU | 割り当てられるメモリ |
|---|---|---|
| small | 1 | 1 Go |
| medium(既定) | 2 | 4 Go |
| large | 4 | 16 Go |
残る3項目は投稿にのみ記載されている。ダッシュボードから設定できるサブエージェント、複数のセッションにわたる環境の再利用、そして信頼性の向上だが、測定方法は公開されていない。
Overall better reliability: 99.97% turn reliability, fewer SSE disconnects, 20% faster tool calls 🪨
🇯🇵 全体の信頼性が向上:ターンごとの信頼性は99,97 %、SSEの切断が減少し、ツール呼び出しが20 %高速化。 — Xの@stevendcoffey
コーディングエージェント:JiraのDevin、Antigravity CLI 1.2.13と1.2.14
DevinがJiraに組み込まれたエージェントとなり、Devin Reviewの指摘を自身のセッションに引き継ぐ
9月30日 — 9月30日付のDevinのリリースノートには25項目がある。主な変更は、DevinがJiraに標準で組み込まれるエージェント(ネイティブエージェント)になることだ。管理者がDevin for Jiraアプリをインストールすると、チケットをDevinに割り当てるか、Devinにメンションすることでセッションが始まり、Jiraのエージェントパネルで追跡できる。権限不足や利用上限によりDevinが開始できない場合、Jiraは一般的なエラーではなく、Devinによる理由の説明を表示する。
まだ稼働中のDevinセッションが作成したプルリクエストでは、Devin Reviewはまず、レビューで見つかった問題(指摘事項)をそのセッションに送る。自動修正(Auto-fix)を使うと、Devinは修正可能な問題を直し、残った指摘だけが公開される。自動化には事前の検証(事前チェック)が追加された。各トリガーの後、Devinの実行前にスクリプトを動かし、イベントを検証、情報追加、または無視できる。料金への言及はない。
Antigravity CLI 1.2.13と1.2.14:再試行の待機時間、メッセージキュー、systemdを使わないRemote Control
9月29日・30日 — GoogleのAntigravity CLIの変更履歴には、2つのバージョンが記載されている。1.2.13では、固定の5秒間を待つ代わりに、モデルのAPIが指定した再試行の待機時間に従う。その時間が30秒を超える場合や、到達した上限が1日あたりの上限または請求上の上限である場合は、直ちに再試行を断念する。
1.2.14(改善6件、修正3件)では、/configにQueued Messagesオプションが追加された。既定のQueueでは、エージェントの作業中に送信されたメッセージはターンの終了を待つ。Send Immediatelyモードでは、進行中のターンに割り込む。多くのコンテナのように、systemdのユーザーサービスマネージャーがないLinuxマシンでは、Remote Controlはデーモンを通常のバックグラウンドプロセスとして起動する。このプロセスは、クラッシュ後にもシステム起動時にも再起動しない。--json-schemaオプションの検証は厳格になり、無効なスキーマはエラーと終了コード1を返す。展開は数日かけて段階的に行われる。
Qwen-Image-2.1-ProがModel StudioとQwenCloudでAPI提供を開始、1画像あたり0,04ドル
10月2日 — Alibabaは、APIプラットフォームであるModel Studioのカタログに、サービス提供範囲International向けのQwen-Image-2.1-Proを追加した。QwenCloudにも「新規」と表示されたモデル紹介ページが掲載されたが、Qwenからの投稿や記事はない。このモデルは、9月20日に重みが公開されたQwen-Image-2.1を発展させたものだ。単一モデルで生成と編集を行い、視覚生成用に70億のパラメータを持ち、透過画像の生成に標準対応する。紹介ページには、提供される版が公開済みの重みと異なるかどうかは記載されていない。
| 比較項目 | qwen-image-2.1-pro | qwen-image-2.0-pro |
|---|---|---|
| 出力画像1枚あたりの価格 | 0,04 dollar | 0,075 dollar |
| 無料枠 | 10 枚 | 100 枚 |
価格はほぼ半額になったが、無料枠は10分の1になった。QwenCloudでは、毎分20リクエスト、同時呼び出し10件が上限となっている。
🔗 Model Studioのモデル更新履歴 · QwenCloudのモデル紹介ページ
ApronはGPUを借りる前に14のオープンモデルのGPUメモリ使用量を予測、開発者が説明
10月3日 — Apronの開発者であるヴラド・リシュコフが、Hugging Faceのコミュニティブログでこのオープンソースツールを紹介した。GPUを借りる前に、オープンモデルがメモリに収まり、特定のバージョンのvLLMで起動するかを予測し、その後、実際のGPUで検証する。
開発者によると、RTX 4090から8基のH200までの構成で起動した14モデルのうち11モデルでは、重みのメモリ使用量の予測値と実測値の差が2 %未満だった。4モデルは当初起動に失敗したが、修正を加え、2回目の起動で復旧を確認した。また、DeepSeek-V4.1-Flashは既定で189 Gioのホストメモリを使用するが、GPUだけを対象とする確認ではこれを検出できない。
開発者は、各モデルで測定した起動は1回だけであり、結果はランキングではないと注意を促している。このコマンドラインツールは外部利用に向けた準備が整っておらず、リポジトリにも、まだ実装のない仕様として説明されている。
短報
- Copilot CLI 1.0.92-3 と Copilot SDK 1.0.17-preview.3 — Copilot CLI のプレビュー版では、会話開始前に Ctrl+E で開く選択画面が追加され、ローカル実行かクラウド実行かを選べるようになった。SDK のプレビュー版では、実行中のセッションでクライアントのツールを差し替える機能が実験的に利用できる。最新の安定版は引き続き 1.0.91。🔗 CLI · 🔗 SDK
- API による Copilot code review — Copilot のレビューを REST API と GraphQL API から依頼できるようになり、リクエストごとに処理の労力レベルを指定できる。Pro、Pro+、Max、Business、Enterprise プランで一般提供されている。ドキュメントによると、レビュー1回の費用は、Lite で 0.05〜1 ドル分の IA クレジット、既定の労力レベルである Balanced で 0.25〜5 ドル分と見積もられている。🔗 出典
- Gemini CLI の Nightly — 10月3日の v0.64.0-nightly に含まれる修正は1件のみ。Enter キーとスペースキーで選択肢のリストを確実に確定できるようになった。Windows 上の PyCharm のターミナルなど、Kitty キーボードプロトコルに対応していないターミナルも対象で、こうした環境では、別のキーを押してから 30 ms 未満で Enter キーを押すと Shift+Enter と判定されていた。安定版とプレビュー版に変更はない。🔗 出典
- DeepSeek Harness 0.2.1-alpha.1 — まだ安定版のないこの25番目のプレビュー版には、Claude Code の mod に対応する実験的な互換性レイヤーが追加された。DeepSeek によると、これは mod の API が Harness のプラグインで可能な機能の概ね部分集合になっているかを確かめるためのもので、完全な互換性の提供を目指してはいない。🔗 出典
- Warp で GPT-6.1 Sol が利用可能に — 9月29日夜、Warp はエージェント機能を備えたターミナルで GPT-6.1 Sol の提供を開始した。Codex または ChatGPT のサブスクリプションで利用できる。発表には料金も Warp 独自の測定結果も記載されていない。🔗 出典
- grok-voice-transcribe-1.0 の提供終了 — SpaceXAI は10月2日、API で提供していた文字起こしモデルの旧版を終了した。リクエストは grok-voice-transcribe-2.0 に転送され、料金は同じで、SpaceXAI によると精度は向上している。廃止は9月18日に日程を示さず告知されていた。🔗 出典
- OpenAI 開発者向け9月の振り返り — @OpenAIDevs は X の記事で、29日の DevDay から GPT-6 Sol と Luna まで、9月の開発者向け発表を振り返っている。新たな発表はない。唯一の補足として、9月29日から限定プレビュー中の OpenAI の Decisions API が近日中に一般提供されると記載されているが、日程は示されていない。🔗 出典
- ElevenLabs のエージェント導入事例2件 — Banner Health は、プライマリケアの予約受付を ElevenAgents に任せ、人間への引き継ぎと HIPAA 準拠に対応している。保険会社 Admiral は音声エージェントを本番運用へ移行した経緯を紹介し、各変更の適用範囲をトラフィックの 1 % から 100 % へ広げるまでの時間が、数週間から数時間になったとしている。どちらも成果を示す数値は公表していない。🔗 Banner Health · 🔗 Admiral
- Kling 4.0 の早期アクセス — 9月30日付の Kling 4.0 紹介記事によると、完全版のモデルは10月の提供拡大に先立って早期アクセスに入り、Kling 4.0 Flash は9月28日から Ultra の年間契約者に提供されている。21:9 の形式も追加されるが、料金、API、利用条件の情報は示されていない。🔗 出典
- Runway Agent、Runway MCP、OpenAI の dots — Runway の変更履歴には、X での告知なしに3件の追加が記載されている。Runway Agent が Seedance 2.5 の Draft モードを使用し、480p の下書きを生成後に手直しできること、有料プラン向けの Runway MCP に Ideogram 4.5 が加わったこと、10月1日から OpenAI の dots で Runway が利用できることだ。クレジットの消費量は示されていない。🔗 出典
- GitHub Apps のステートレスなトークン — IA 分野以外では、GitHub が4月27日に開始したステートレス形式
ghs_APPID_JWTの展開を完了し、GitHub Apps の新規インストールトークンすべてに適用した。長さは40文字から約520文字になり、権限と1時間の有効期間は従来どおり。テスト用ヘッダーX-GitHub-Stateless-S2S-Tokenは2026年11月30日に非推奨となる。🔗 出典 - Rapidata のリアルタイムの人間によるフィードバック — Rapidata は、Flow-GRPO の報酬モデルを、人間によるリアルタイムの一対比較に置き換える Flows 機能を紹介している。提供元のブログ記事では、測定した学習結果は一切公表されていない。🔗 出典
- エージェント間の依存関係を測る — アヌアール・イメルは、実験や測定を伴わない論考で、マルチエージェントシステムをエージェントの数ではなく、エージェント間の依存関係で評価することを提案している。各ターンで正確さ、推論の多様性、エージェント間の結合度を追跡するというものだ。🔗 出典
これが意味すること
Kolibri は、首位を目指さなくてもオープンなモデルが十分に競争できることを示している。Aleph Alpha 自身が公表した測定結果では、Dense モデルの Qwen3.8 27B がほぼすべての項目で上回っているが、同社は別の基準を打ち出している。英語でもドイツ語でも、多数の長いリクエストを少数の GPU で処理し、すべてをオンプレミスで運用できるライセンスで提供することだ。AI Act と RGPD に従う必要のある行政機関や産業企業にとって、この選択はベンチマークの数ポイントの差よりも重みを持ち得る。Aleph Alpha との提携でまだ規制当局の承認を待つ Cohere は、すでに次の展開を約束している。
オープンなモデルでは、提供コストが中心的な課題になりつつある。9月20日に重みが公開された Qwen-Image-2.1 は、自ら運用することを望まない利用者向けに、Qwen-Image-2.1-Pro という名称で API に再登場した。画像1枚あたり 0.04 ドルと、前世代のほぼ半額だ。一方、Apron の記事はセルフホスティングで必要になる対応を思い起こさせる。vLLM の設定が1つ欠けているためにモデルが起動に失敗したり、GPU だけを確認していては分からない 189 Gio のホストメモリを占有したりすることがある。
Meta は安全性への対応を、デプロイより前の段階に移している。サイバーセキュリティに強いモデルは自らの環境の脆弱性を悪用できるため、リスクのある強化学習には、検証済みのサンドボックス、改ざんできないログ、自動停止が必要になった。さらに、取締役会内に設置すると発表された IA 委員会は、これらの規則が適用されていることを独立した立場で確認しなければならない。Meta が反映していると述べるホワイトハウスでの約束について、記事が示しているのは基本的な考え方だけだ。社内の独立したチームと、社外の監査人または評価者が、内部統制を検証するというものだ。
最後に、エージェントはツールや運用に組み込まれつつある。OpenAI ではサンドボックスの規模を選び、セッションをまたいで環境を再利用できる。Devin は Jira に入り、自らのレビューで見つけた問題を公開前に修正する。Copilot code review は API から起動でき、労力レベルごとの費用の目安も示されている。Antigravity CLI はサーバーの再試行待機時間を守り、コンテナ内で Remote Control を動かす。派手な機能というより運用上の調整だが、エージェントを常時稼働させるときには、こうした点が重要になる。
出典
- Aleph Alpha による Kolibri の記事
- Hugging Face 上の Kolibri-1
- @Aleph__Alpha による Kolibri の発表
- Kolibri の技術報告書(PDF)
- @cohere による Kolibri の紹介
- エイダン・ゴメスからの祝辞
- Cohere と Aleph Alpha の最終合意
- 高性能モデルの責任ある開発(Meta)
- Meta の超知能スケーリングフレームワーク
- @stevendcoffey による Agents API の新機能紹介
- @OpenAIDevs による紹介
- OpenAI がホストするサンドボックス(OpenAI ドキュメント)
- Devin の9月30日のリリースノート
- Antigravity の変更履歴
- Model Studio のモデル更新履歴
- Model Studio の料金
- QwenCloud の qwen-image-2.1-pro 紹介ページ
- LLM を動かしているのは知っています。起動はできますか?(Hugging Face)
- GitHub 上の Apron リポジトリ
- Copilot CLI v1.0.92-3
- GitHub Copilot SDK v1.0.17-preview.3
- Copilot code review:API 対応と新しい既定の労力レベル(GitHub)
- Gemini CLI の10月3日の Nightly v0.64.0
- DeepSeek Harness 0.2.1-alpha.1 のリリースノート
- Warp での GPT-6.1 Sol(@warpdotdev)
- SpaceXAI API のリリースノート
- OpenAI 開発者向け9月の振り返り(@OpenAIDevs)
- Banner Health での ElevenLabs 導入
- Admiral のウェビナーの振り返り(ElevenLabs)
- Kling 4.0 の紹介
- Runway の変更履歴
- ステートレスな GitHub App インストールトークンの展開完了(GitHub)
- 学習ループ内でのリアルタイムの人間によるフィードバック(Rapidata)
- AI エージェントが互いの根拠になるとき(アヌアール・イメル)