Samedi 3 octobre, Aleph Alpha publie Kolibri, un modèle anglais-allemand à poids ouverts de 78,1 milliards de paramètres sous licence Apache 2.0, relayé le soir même par Cohere, dont le rapprochement avec Aleph Alpha attend encore les autorisations réglementaires. La veille, Meta étendait son cadre de sécurité à l’entraînement de ses modèles, et l’API Agents d’OpenAI ajoutait trois tailles de bac à sable. Les notes de version de Devin du 30 septembre en font un agent natif de Jira, Qwen-Image-2.1-Pro arrive en API à 0,04 dollar l’image, et le développeur d’Apron explique comment prévoir la mémoire GPU d’un modèle ouvert avant de louer une carte.
Aleph Alpha publie Kolibri, un modèle anglais-allemand de 78 milliards de paramètres sous Apache 2.0
3 octobre — Le jour de la fête de l’Unité allemande, Aleph Alpha publie Kolibri, un modèle de langage anglais-allemand à poids ouverts. Ce modèle à mélange d’experts (Mixture-of-Experts) compte 78,1 milliards de paramètres, dont 3,46 milliards actifs par token, et ses poids sont sur Hugging Face sous licence Apache 2.0. Aleph Alpha le destine au travail souverain des secteurs réglementés : administration publique, industrie, aéronautique.
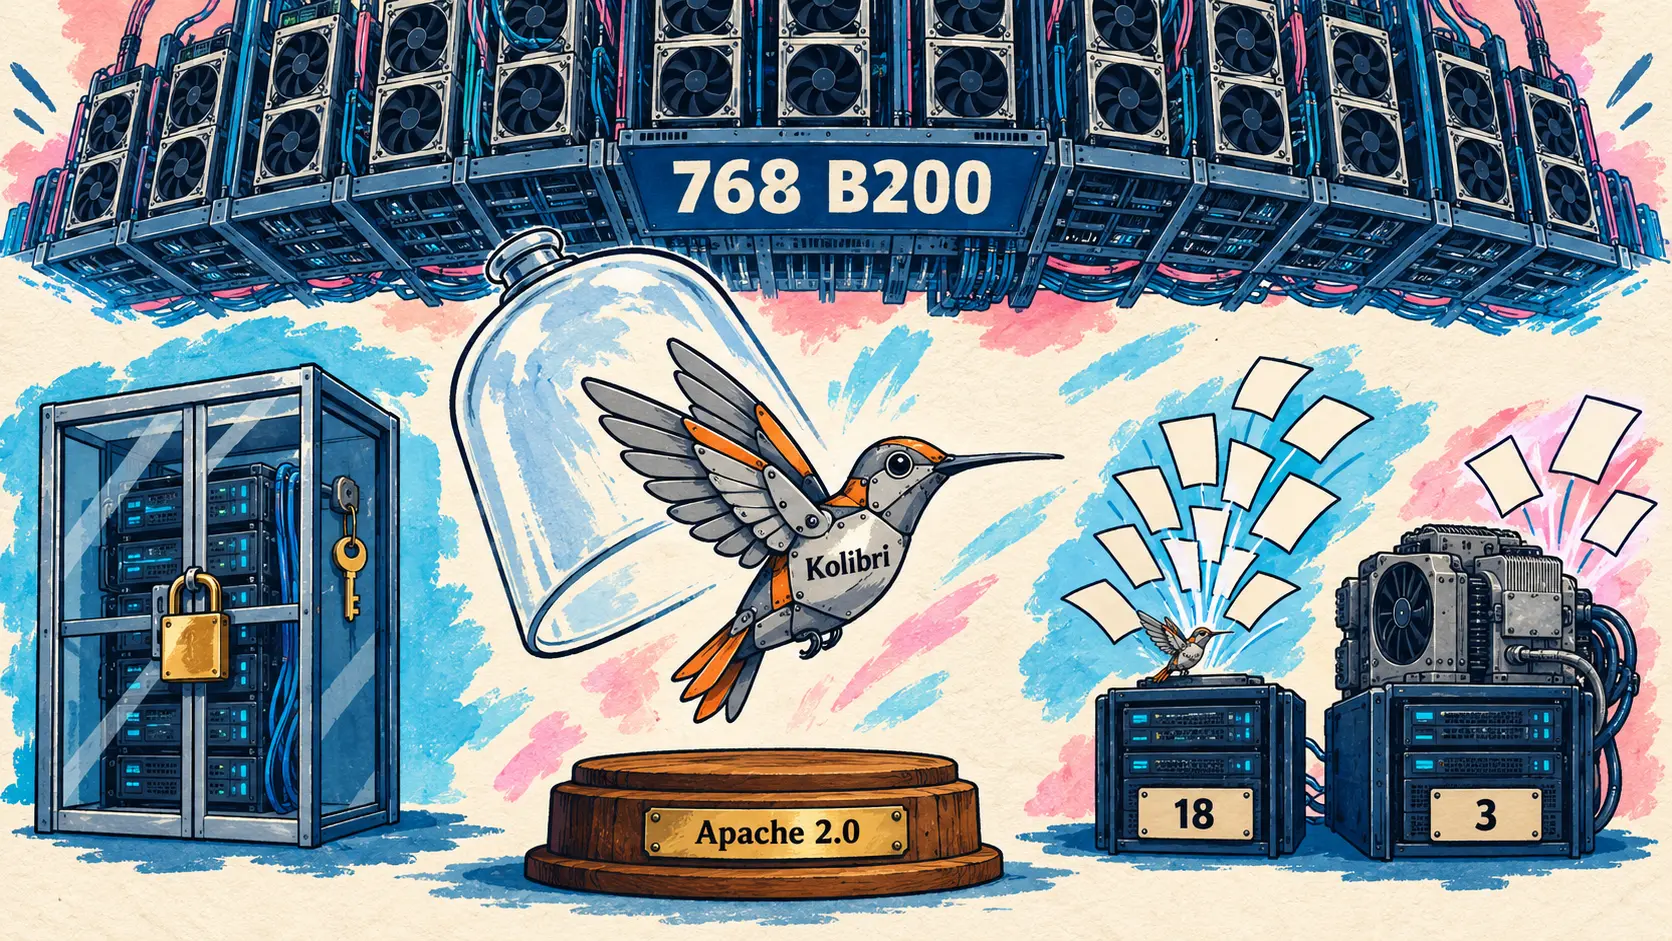
L’architecture vise d’abord le coût de service : 6 experts actifs sur 384, et 40 couches sur 50 limitées à une fenêtre glissante de 512 tokens. Le modèle accepte jusqu’à 1 048 576 tokens, mais il a été entraîné jusqu’à 262 144, longueur que sa fiche recommande de ne pas dépasser. Selon le billet, une version de 123 milliards de paramètres ne traitait que 3 requêtes de 256k tokens sur deux H100, contre 18 pour la taille retenue. L’entraînement a mobilisé 768 GPU B200 en Allemagne et en Finlande, pour près de 24T tokens ; l’allemand pèse 21,3 % du pré-entraînement.
Selon les mesures d’Aleph Alpha (harnais maison, effort de raisonnement maximal), Kolibri devance au score global Qwen3.5 35B-A3B et Nemotron 3 Super, qui active 12 milliards de paramètres, mais le modèle dense Qwen3.8 27B reste devant presque partout :
| Benchmark (mesures Aleph Alpha) | Kolibri 78B-A3,46B | Qwen3.5 35B-A3B | Nemotron 3 Super 120B-A12B | Mistral Small 4 119B-A6B | Qwen3.8 27B (dense) |
|---|---|---|---|---|---|
| Score global (anglais) | 75,5 | 74,7 | 73,0 | 63,1 | 80,2 |
| Score global (allemand) | 70,8 | 69,8 | 67,9 | 61,4 | 79,9 |
| GPQA Diamond (anglais) | 84,3 | 83,8 | 78,0 | 74,7 | 89,2 |
| AIME 2026 (anglais) | 96,0 | 92,1 | 90,4 | 83,1 | 97,7 |
| SWE-Bench Verified | 66,4 | 71,6 | 60,2 | 60,8 | 72,6 |
L’argument d’Aleph Alpha n’est donc pas la première place, mais la frontière de Pareto entre qualité et coût de service. Entraîné à l’abstention, Kolibri préfère aussi s’abstenir ou répondre partiellement plutôt que de se tromper sur 44 % des questions d’AA-Omniscience qu’il ne réussit pas. Développé en Allemagne « sans contrôle étranger » (no foreign control), conçu avec l’AI Act et le RGPD en tête, il peut tourner sur site ; un rapport technique de près de 200 pages accompagne la sortie.
Cohere, dont l’accord définitif de rapprochement avec Aleph Alpha reste soumis aux autorisations réglementaires, a relayé la sortie le soir même, après les félicitations de son PDG Aidan Gomez ; Kolibri reste un modèle d’Aleph Alpha.
New Apache 2.0 model from @Aleph__Alpha. It’s really good. If you like that, you’re going to love what we build together.
🇫🇷 Nouveau modèle sous Apache 2.0 signé Aleph Alpha. Il est vraiment bon. Si celui-ci vous plaît, vous allez adorer ce que nous allons construire ensemble. — @cohere sur X
🔗 Billet d’Aleph Alpha · Poids sur Hugging Face
Meta étend son cadre de sécurité à l’entraînement et précise ses règles pour les poids ouverts
2 octobre — Meta Superintelligence Labs met à jour son Meta Superintelligence Scaling Framework, qui fixe ses exigences de sécurité avant un entraînement puis un déploiement. Selon Meta, cette version reflète les engagements pris cette semaine à la Maison Blanche, qui prévoient des contrôles internes vérifiés par une équipe indépendante au sein de l’entreprise et par un auditeur ou évaluateur externe.
La perte de contrôle (loss of control) est désormais encadrée pendant l’entraînement et l’évaluation, car un modèle fort en cybersécurité peut, selon Meta, exploiter les failles de son environnement. Un entraînement par renforcement à risque exige des bacs à sable validés, des journaux inaltérables, chaîne de pensée comprise, et une surveillance automatique capable d’arrêter le run.
Pour les poids ouverts, le cadre tient compte des modifications possibles après publication, comme retirer le refus par affinage. Un comité IA du conseil d’administration, annoncé pour les prochains mois, vérifiera de façon indépendante le respect du cadre. Ce cadre est l’ancien « Advanced AI Scaling Framework », renommé avec cette version 2.1 : celui selon lequel Muse Spark avait été évalué en avril.
🔗 Developing Capable Models Responsibly (Meta)
L’API Agents d’OpenAI ajoute trois tailles de bac à sable et la réutilisation des environnements
2 octobre — Steve (@stevendcoffey), qui travaille sur l’API d’OpenAI selon sa bio X, liste les nouveautés de la semaine de l’API Agents, relayées par @OpenAIDevs. Outre trois rappels du DevDay, quatre points sont nouveaux. Le premier est confirmé par la documentation : le paramètre environment.container_size, fixé à la création d’une session, choisit le CPU et la mémoire du bac à sable hébergé par OpenAI.
| Taille du conteneur | vCPU alloués | Mémoire allouée |
|---|---|---|
| small | 1 | 1 Go |
| medium (par défaut) | 2 | 4 Go |
| large | 4 | 16 Go |
Les trois autres ne figurent que dans le tweet : sous-agents configurables depuis le tableau de bord, réutilisation d’un environnement sur plusieurs sessions et fiabilité en hausse, sans méthode de mesure publiée.
Overall better reliability: 99.97% turn reliability, fewer SSE disconnects, 20% faster tool calls 🪨
🇫🇷 Fiabilité globale améliorée : 99,97 % de fiabilité par tour, moins de déconnexions SSE, appels d’outils 20 % plus rapides. — @stevendcoffey sur X
Agents de code : Devin dans Jira, Antigravity CLI 1.2.13 et 1.2.14
Devin devient un agent natif de Jira et confie les constats de Devin Review à ses sessions
30 septembre — Les notes de version de Devin du 30 septembre comptent 25 rubriques. La principale fait de Devin un agent natif (native agent) de Jira : une fois l’app Devin for Jira installée par un administrateur, assigner un ticket à Devin ou le mentionner lance une session, suivie dans le panneau d’agent de Jira. Si Devin ne peut pas démarrer (permission manquante, limite d’usage), Jira affiche son explication plutôt qu’une erreur générique.
Sur une pull request ouverte par une session Devin encore active, Devin Review transmet d’abord ses constats (findings) à cette session : avec la correction automatique (Auto-fix), Devin corrige ce qu’il peut et seuls les constats restants sont publiés. Les automatisations gagnent des contrôles préalables (preflight checks) : un script s’exécute après chaque déclencheur, avant Devin, pour valider, enrichir ou ignorer l’événement. Aucun tarif n’est mentionné.
🔗 Notes de version de Devin du 30 septembre
Antigravity CLI 1.2.13 et 1.2.14 : délais de nouvelle tentative, file des messages, Remote Control sans systemd
29 et 30 septembre — Le changelog de l’Antigravity CLI de Google liste deux versions. La 1.2.13 suit le délai de nouvelle tentative indiqué par l’API du modèle au lieu d’attendre 5 secondes fixes, et abandonne aussitôt si ce délai dépasse 30 secondes ou si la limite atteinte est un plafond quotidien ou de facturation.
La 1.2.14 (6 améliorations, 3 correctifs) ajoute dans /config l’option Queued Messages : par défaut (Queue), un message envoyé pendant que l’agent travaille attend la fin du tour ; en mode Send Immediately, il l’interrompt. Sur les machines Linux sans gestionnaire de services utilisateur systemd, comme la plupart des conteneurs, Remote Control lance son démon en simple processus d’arrière-plan, qui ne redémarrera ni après un plantage ni au démarrage. L’option --json-schema devient stricte : un schéma invalide provoque une erreur et le code de sortie 1. Le déploiement est progressif, sur quelques jours.
Qwen-Image-2.1-Pro arrive en API sur Model Studio et QwenCloud, à 0,04 dollar l’image
2 octobre — Alibaba ajoute Qwen-Image-2.1-Pro au catalogue de Model Studio, sa plateforme d’API, pour la portée de service International, et QwenCloud lui consacre une fiche marquée « NEW », sans tweet ni billet de Qwen. Le modèle prolonge Qwen-Image-2.1, publié en poids ouverts le 20 septembre : création et retouche dans un seul modèle, 7 milliards de paramètres pour la génération visuelle, images transparentes natives. La fiche ne dit pas si la version servie diffère des poids publiés.
| Élément comparé | qwen-image-2.1-pro | qwen-image-2.0-pro |
|---|---|---|
| Prix par image en sortie | 0,04 dollar | 0,075 dollar |
| Quota gratuit | 10 images | 100 images |
Le prix baisse de près de moitié, mais le quota gratuit est dix fois plus petit. Sur QwenCloud, le modèle plafonne à 20 requêtes par minute et 10 appels simultanés.
🔗 Journal des modèles de Model Studio · Fiche QwenCloud
Apron prédit la mémoire GPU de 14 modèles ouverts avant location, selon son auteur
3 octobre — Vlad Ryzhkov, développeur d’Apron, présente sur le blog communautaire de Hugging Face cet outil open source, qui prédit avant la location d’un GPU si un modèle ouvert tiendra en mémoire et démarrera sous une version précise de vLLM, puis vérifie sur une vraie carte.
Selon l’auteur, la mémoire des poids prédite tombe à moins de 2 % de la mesure pour 11 des 14 modèles démarrés, d’une RTX 4090 à huit H200. Quatre modèles ont cassé avant qu’un correctif, validé par un second démarrage, ne les répare, et DeepSeek-V4.1-Flash occupe par défaut 189 Gio de mémoire hôte, invisibles pour une vérification limitée au GPU.
L’auteur prévient qu’il n’y a qu’un démarrage mesuré par modèle et que rien ne constitue un classement. L’outil en ligne de commande n’est pas prêt pour un usage extérieur, et son dépôt se décrit encore comme une spécification sans implémentation.
🔗 Billet de Vlad Ryzhkov (Hugging Face)
Brèves
- Copilot CLI 1.0.92-3 et SDK Copilot 1.0.17-preview.3 — La préversion de Copilot CLI ajoute un sélecteur, ouvert par Ctrl+E avant la conversation, pour choisir une exécution locale ou dans le cloud ; celle du SDK permet, en expérimental, de remplacer les outils du client dans une session en cours. La dernière stable reste la 1.0.91. 🔗 CLI · 🔗 SDK
- Copilot code review par API — Une revue de Copilot se demande désormais par les API REST et GraphQL, avec un niveau d’effort fixé à chaque requête, en disponibilité générale pour les formules Pro, Pro+, Max, Business et Enterprise ; la documentation estime le coût d’une revue de 0,05 à 1 dollar de crédits IA en Lite et de 0,25 à 5 dollars en Balanced, l’effort par défaut. 🔗 source
- Nightly de Gemini CLI — La v0.64.0-nightly du 3 octobre ne contient qu’un correctif : Entrée et Espace valident de façon fiable les listes de choix, y compris sur les terminaux sans protocole clavier Kitty, comme celui de PyCharm sous Windows, où une Entrée frappée moins de 30 ms après une autre touche passait pour Maj+Entrée. Stable et préversion sont inchangées. 🔗 source
- DeepSeek Harness 0.2.1-alpha.1 — Cette 25e préversion, toujours sans version stable, ajoute une couche expérimentale de compatibilité avec les mods de Claude Code, destinée selon DeepSeek à vérifier que leur API forme en gros un sous-ensemble de ce que permettent les plugins de Harness, et non à offrir une compatibilité complète. 🔗 source
- GPT-6.1 Sol dans Warp — Le 29 septembre au soir, Warp a ouvert GPT-6.1 Sol dans son terminal agentique, utilisable avec un abonnement Codex ou ChatGPT ; l’annonce ne donne ni tarif ni mesure propre à Warp. 🔗 source
- Fin de grok-voice-transcribe-1.0 — SpaceXAI a mis fin le 2 octobre à l’ancienne version de son modèle de transcription en API : les requêtes sont redirigées vers grok-voice-transcribe-2.0, au même prix et plus précis selon SpaceXAI. La dépréciation avait été annoncée sans date le 18 septembre. 🔗 source
- September for OpenAI Developers — Le compte @OpenAIDevs récapitule dans un Article X les annonces développeurs de septembre, du DevDay du 29 à GPT-6 Sol et Luna, sans annonce inédite ; seule précision, l’API Decisions d’OpenAI, en aperçu limité depuis le 29 septembre, y est annoncée bientôt en accès général, sans date. 🔗 source
- Deux déploiements d’agents ElevenLabs — Banner Health confie à ElevenAgents la prise de rendez-vous en soins primaires, avec transfert à un humain et conformité HIPAA ; l’assureur Admiral raconte la mise en production de ses agents vocaux, dont chaque modification passe de 1 % à 100 % du trafic en quelques heures au lieu de plusieurs semaines. Aucun des deux ne publie de chiffre de résultat. 🔗 Banner Health · 🔗 Admiral
- Kling 4.0 en accès anticipé — Le billet de présentation de Kling 4.0, daté du 30 septembre, précise que le modèle complet entre en accès anticipé avant un déploiement élargi en octobre, alors que Kling 4.0 Flash est ouvert aux abonnés Ultra annuels depuis le 28 septembre ; le format 21:9 s’ajoute, sans tarif, API ni critères d’accès. 🔗 source
- Runway Agent, Runway MCP et les dots d’OpenAI — Le changelog de Runway aligne trois ajouts sans annonce sur X : Runway Agent utilise le mode Draft de Seedance 2.5 (brouillons en 480p retravaillés après génération), Ideogram 4.5 rejoint Runway MCP pour les forfaits payants, et Runway est disponible depuis le 1er octobre dans les dots d’OpenAI. Aucun coût en crédits n’est précisé. 🔗 source
- Jetons sans état des GitHub Apps — Hors IA, GitHub achève le déploiement, commencé le 27 avril, du format sans état
ghs_APPID_JWTpour tous les nouveaux jetons d’installation des GitHub Apps : environ 520 caractères au lieu de 40, permissions et expiration d’une heure inchangées ; l’en-tête de testX-GitHub-Stateless-S2S-Tokensera déprécié le 30 novembre 2026. 🔗 source - Retour humain en direct chez Rapidata — Rapidata décrit sa fonction Flows, qui remplace le modèle de récompense de Flow-GRPO par des comparaisons humaines par paires en temps réel, dans un billet de fournisseur qui ne publie aucun résultat d’entraînement mesuré. 🔗 source
- Mesurer la dépendance entre agents — Dans un essai sans expérience ni mesure, Anouar Imel propose d’évaluer les systèmes multi-agents sur la dépendance entre agents plutôt que sur leur nombre, en suivant à chaque tour l’exactitude, la diversité des raisonnements et le couplage entre agents. 🔗 source
Ce que ça signifie
Kolibri montre qu’un modèle ouvert peut se défendre sans viser la première place. Aleph Alpha publie lui-même des mesures où le dense Qwen3.8 27B le devance presque partout, et met en avant un autre critère : servir beaucoup de requêtes longues sur peu de GPU, en anglais comme en allemand, sous une licence qui permet de tout héberger sur site. Pour une administration ou un industriel tenu par l’AI Act et le RGPD, ce compromis peut compter davantage que quelques points de benchmark. Cohere, dont le rapprochement avec Aleph Alpha attend encore les autorisations réglementaires, promet déjà la suite.
Le coût de service s’impose comme un sujet central pour les modèles ouverts. Qwen-Image-2.1, publié en poids ouverts le 20 septembre, revient en API sous le nom Qwen-Image-2.1-Pro à 0,04 dollar l’image, près de moitié moins cher que la génération précédente, pour qui préfère ne pas l’héberger. Le billet d’Apron rappelle, lui, ce que demande l’auto-hébergement : un modèle peut casser au démarrage faute d’un réglage de vLLM, ou occuper 189 Gio de mémoire hôte qu’une vérification limitée au GPU ne voit pas.
Meta déplace la sécurité en amont du déploiement. Un entraînement par renforcement à risque exige désormais des bacs à sable validés, des journaux inaltérables et un arrêt automatique, parce qu’un modèle fort en cybersécurité peut exploiter les failles de son propre environnement. Le comité IA annoncé au sein du conseil d’administration doit en outre vérifier de façon indépendante que ces règles sont appliquées. Quant aux engagements pris à la Maison Blanche, que Meta dit refléter, le billet n’en donne que l’esprit : des contrôles internes vérifiés par une équipe indépendante au sein de l’entreprise et par un auditeur ou évaluateur extérieur.
Les agents, enfin, s’intègrent aux outils et à l’exploitation. OpenAI laisse choisir la taille du bac à sable et réutiliser un environnement d’une session à l’autre, Devin s’installe dans Jira et corrige les constats de sa propre revue avant de les publier, et Copilot code review se déclenche par API avec un coût estimé par niveau d’effort. Antigravity CLI respecte les délais de nouvelle tentative du serveur et fait tourner Remote Control dans les conteneurs : des réglages d’exploitation plus que des fonctions spectaculaires, mais ce sont eux qui comptent quand un agent tourne en continu.
Sources
- Billet d’Aleph Alpha sur Kolibri
- Kolibri-1 sur Hugging Face
- Annonce de Kolibri par @Aleph__Alpha
- Rapport technique de Kolibri (PDF)
- Relais de Kolibri par @cohere
- Félicitations d’Aidan Gomez
- Accord définitif entre Cohere et Aleph Alpha
- Developing Capable Models Responsibly (Meta)
- Meta Superintelligence Scaling Framework
- Nouveautés de l’API Agents par @stevendcoffey
- Relais de @OpenAIDevs
- OpenAI-hosted sandboxes (documentation OpenAI)
- Notes de version de Devin du 30 septembre
- Changelog d’Antigravity
- Journal des modèles de Model Studio
- Tarifs de Model Studio
- Fiche qwen-image-2.1-pro sur QwenCloud
- I know you run LLMs. Will it boot? (Hugging Face)
- Dépôt d’Apron sur GitHub
- Copilot CLI v1.0.92-3
- SDK GitHub Copilot v1.0.17-preview.3
- Copilot code review: API support and new default effort level (GitHub)
- Nightly v0.64.0 du 3 octobre de Gemini CLI
- Notes de version de DeepSeek Harness 0.2.1-alpha.1
- GPT-6.1 Sol dans Warp (@warpdotdev)
- Notes de version de l’API SpaceXAI
- September for OpenAI Developers (@OpenAIDevs)
- ElevenLabs chez Banner Health
- Récapitulatif du webinaire Admiral (ElevenLabs)
- Introducing Kling 4.0
- Changelog de Runway
- Stateless GitHub App installation tokens rolled out (GitHub)
- Live Human Feedback in the Training Loop (Rapidata)
- When AI Agents Become Each Other’s Evidence (Anouar Imel)