ai-powered-markdown-translatorArtikel översatt från fr till sv med gpt-6.1-sol.
Lördagen den 3 oktober publicerar Aleph Alpha Kolibri, en engelsk-tysk modell med öppna vikter och 78,1 miljarder parametrar under Apache 2.0-licens. Nyheten delas samma kväll av Cohere, vars samgående med Aleph Alpha fortfarande väntar på myndighetsgodkännanden. Dagen före utökade Meta sitt säkerhetsramverk till träningen av sina modeller, och OpenAI:s API Agents fick tre sandlådestorlekar. Devins versionsanteckningar från den 30 september gör det till en inbyggd agent i Jira, Qwen-Image-2.1-Pro blir tillgänglig via API för 0,04 dollar per bild, och utvecklaren bakom Apron förklarar hur man kan förutsäga en öppen modells GPU-minnesbehov innan man hyr ett kort.
Aleph Alpha publicerar Kolibri, en engelsk-tysk modell med 78 miljarder parametrar under Apache 2.0
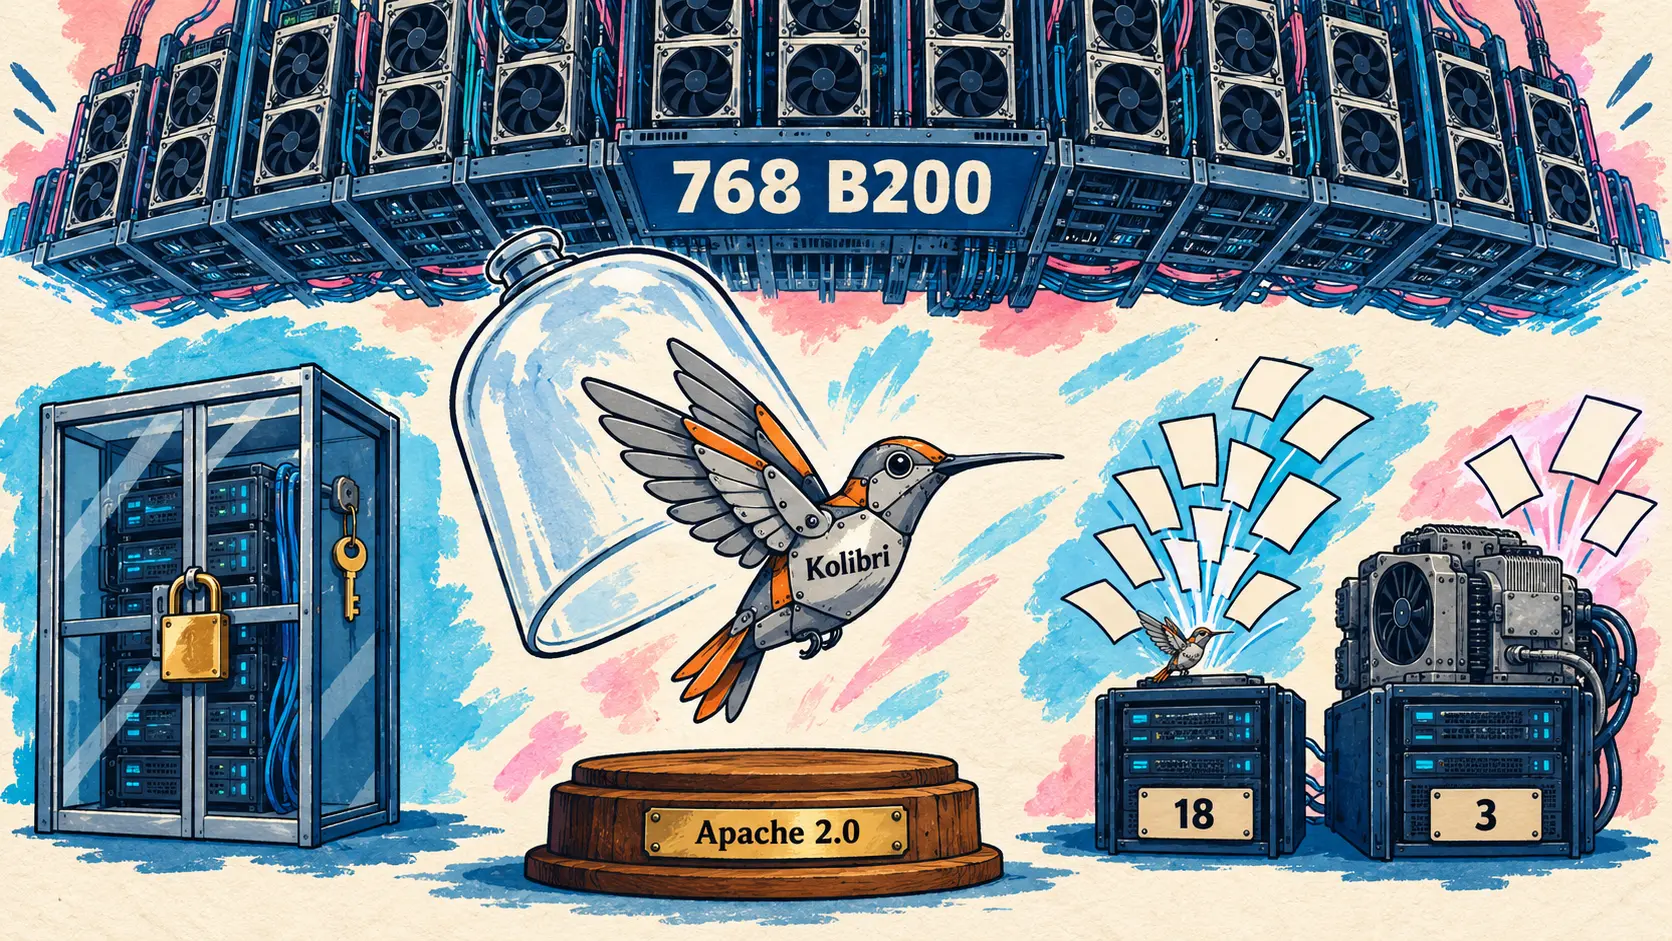
3 oktober — På den tyska enhetens dag publicerar Aleph Alpha Kolibri, en engelsk-tysk språkmodell med öppna vikter. Denna modell med en blandning av experter (Mixture-of-Experts) har 78,1 miljarder parametrar, varav 3,46 miljarder är aktiva per token, och vikterna finns på Hugging Face under Apache 2.0-licens. Aleph Alpha avser modellen för suverän användning inom reglerade sektorer: offentlig förvaltning, industri och flygindustri.
Arkitekturen fokuserar främst på driftkostnaden: 6 aktiva experter av 384, och 40 av 50 lager begränsade till ett glidande fönster på 512 tokens. Modellen accepterar upp till 1 048 576 tokens, men har tränats med upp till 262 144, en längd som modellkortet rekommenderar att man inte överskrider. Enligt inlägget kunde en version med 123 miljarder parametrar bara hantera 3 förfrågningar på 256k tokens på två H100, jämfört med 18 för den valda storleken. Träningen använde 768 B200-GPU:er i Tyskland och Finland för närmare 24T tokens; tyskan står för 21,3 % av förträningen.
Enligt Aleph Alphas mätningar (egenutvecklat utvärderingsramverk, maximal resonemangsinsats) får Kolibri högre totalpoäng än Qwen3.5 35B-A3B och Nemotron 3 Super, som aktiverar 12 miljarder parametrar, men modellen Qwen3.8 27B med dense-arkitektur ligger fortfarande före på nästan alla punkter:
| Benchmark (Aleph Alphas mätningar) | Kolibri 78B-A3,46B | Qwen3.5 35B-A3B | Nemotron 3 Super 120B-A12B | Mistral Small 4 119B-A6B | Qwen3.8 27B (dense) |
|---|---|---|---|---|---|
| Totalpoäng (engelska) | 75,5 | 74,7 | 73,0 | 63,1 | 80,2 |
| Totalpoäng (tyska) | 70,8 | 69,8 | 67,9 | 61,4 | 79,9 |
| GPQA Diamond (engelska) | 84,3 | 83,8 | 78,0 | 74,7 | 89,2 |
| AIME 2026 (engelska) | 96,0 | 92,1 | 90,4 | 83,1 | 97,7 |
| SWE-Bench Verified | 66,4 | 71,6 | 60,2 | 60,8 | 72,6 |
Aleph Alphas argument är alltså inte förstaplatsen, utan Paretofronten mellan kvalitet och driftkostnad. Kolibri är tränad på att avstå från att svara och föredrar också att avstå eller ge ett delvis svar framför att svara fel på 44 % av de frågor i AA-Omniscience som den inte klarar. Modellen är utvecklad i Tyskland ”utan utländsk kontroll” (ingen utländsk kontroll), utformad med AI Act och RGPD i åtanke och kan köras lokalt; en teknisk rapport på närmare 200 sidor följer med lanseringen.
Cohere, vars slutliga avtal om samgående med Aleph Alpha fortfarande kräver myndighetsgodkännanden, delade nyheten samma kväll, efter gratulationer från sin vd Aidan Gomez; Kolibri är fortfarande en modell från Aleph Alpha.
New Apache 2.0 model from @Aleph__Alpha. It’s really good. If you like that, you’re going to love what we build together.
🇸🇪 Ny modell under Apache 2.0 från Aleph Alpha. Den är riktigt bra. Om ni gillar den här kommer ni att älska det vi ska bygga tillsammans. — @cohere på X
🔗 Aleph Alphas inlägg · Vikter på Hugging Face
Meta utökar sitt säkerhetsramverk till träning och förtydligar sina regler för öppna vikter
2 oktober — Meta Superintelligence Labs uppdaterar sitt Meta Superintelligence Scaling Framework, som fastställer säkerhetskraven inför träning och därefter driftsättning. Enligt Meta återspeglar denna version åtagandena som gjordes denna vecka i Vita huset. Dessa omfattar interna kontroller som granskas av ett oberoende team inom företaget och av en extern revisor eller utvärderare.
Förlust av kontroll (loss of control) omfattas nu av regler under träning och utvärdering, eftersom en modell med stark cybersäkerhetsförmåga enligt Meta kan utnyttja sårbarheter i sin miljö. Riskfylld förstärkningsträning kräver validerade sandlådor, oföränderliga loggar inklusive tankekedjan, och automatisk övervakning som kan stoppa körningen.
För öppna vikter tar ramverket hänsyn till möjliga ändringar efter publicering, som att ta bort modellens vägran att svara genom finjustering. En AI-kommitté i styrelsen, som ska inrättas under de kommande månaderna, kommer att oberoende kontrollera att ramverket följs. Ramverket är det tidigare ”Advanced AI Scaling Framework”, som byter namn med denna version 2.1: samma ramverk som Muse Spark utvärderades enligt i april.
🔗 Ansvarsfull utveckling av kapabla modeller (Meta)
OpenAI:s API Agents får tre sandlådestorlekar och återanvändning av miljöer
2 oktober — Steve (@stevendcoffey), som enligt sin X-biografi arbetar med OpenAI:s API, listar veckans nyheter i API Agents, vilka delas vidare av @OpenAIDevs. Utöver tre påminnelser från DevDay är fyra punkter nya. Den första bekräftas av dokumentationen: parametern environment.container_size, som anges när en session skapas, väljer CPU och minne för sandlådan som OpenAI tillhandahåller.
| Containerstorlek | Tilldelade vCPU | Tilldelat minne |
|---|---|---|
| small | 1 | 1 Go |
| medium (standard) | 2 | 4 Go |
| large | 4 | 16 Go |
De tre övriga nämns bara i tweeten: underagenter som kan konfigureras från kontrollpanelen, återanvändning av en miljö i flera sessioner och ökad tillförlitlighet, utan någon publicerad mätmetod.
Overall better reliability: 99.97% turn reliability, fewer SSE disconnects, 20% faster tool calls 🪨
🇸🇪 Förbättrad övergripande tillförlitlighet: 99,97 % tillförlitlighet per tur, färre SSE-frånkopplingar, 20 % snabbare verktygsanrop. — @stevendcoffey på X
Kodagenter: Devin i Jira, Antigravity CLI 1.2.13 och 1.2.14
Devin blir en inbyggd agent i Jira och skickar Devin Reviews iakttagelser till sina sessioner
30 september — Devins versionsanteckningar från den 30 september innehåller 25 avsnitt. Den viktigaste nyheten gör Devin till en inbyggd agent (native agent) i Jira: när en administratör har installerat appen Devin for Jira startas en session genom att tilldela Devin ett ärende eller nämna Devin, och sessionen följs i Jiras agentpanel. Om Devin inte kan starta (saknad behörighet, användningsgräns) visar Jira dess förklaring i stället för ett generiskt fel.
På en pull request som öppnats av en fortfarande aktiv Devin-session skickar Devin Review först sina iakttagelser (findings) till denna session: med automatisk korrigering (Auto-fix) åtgärdar Devin det den kan, och bara de återstående iakttagelserna publiceras. Automatiseringarna får förhandskontroller (preflight checks): ett skript körs efter varje trigger, före Devin, för att validera, berika eller ignorera händelsen. Ingen prissättning nämns.
🔗 Devins versionsanteckningar från den 30 september
Antigravity CLI 1.2.13 och 1.2.14: väntetider vid nya försök, meddelandekö, Remote Control utan systemd
29 och 30 september — Googles changelog för Antigravity CLI listar två versioner. Version 1.2.13 följer väntetiden för nya försök som modellens API anger i stället för att alltid vänta 5 sekunder, och avbryter direkt om väntetiden överstiger 30 sekunder eller om den uppnådda gränsen är en dagsgräns eller faktureringsgräns.
Version 1.2.14 (6 förbättringar, 3 korrigeringar) lägger till alternativet Queued Messages i /config: som standard (Queue) väntar ett meddelande som skickas medan agenten arbetar tills turen är avslutad; i läget Send Immediately avbryter meddelandet agenten. På Linux-maskiner utan systemd som hanterare för användartjänster, vilket gäller de flesta containrar, startar Remote Control sin daemon som en vanlig bakgrundsprocess, som varken startas om efter en krasch eller vid uppstart. Alternativet --json-schema blir strikt: ett ogiltigt schema ger ett fel och exitkod 1. Utrullningen sker gradvis under några dagar.
Qwen-Image-2.1-Pro blir tillgänglig via API på Model Studio och QwenCloud, för 0,04 dollar per bild
2 oktober — Alibaba lägger till Qwen-Image-2.1-Pro i katalogen för Model Studio, sin API-plattform, för tjänsteområdet International, och QwenCloud ger modellen ett modellkort märkt ”NY”, utan någon tweet eller något inlägg från Qwen. Modellen bygger vidare på Qwen-Image-2.1, som publicerades med öppna vikter den 20 september: skapande och redigering i en enda modell, 7 miljarder parametrar för visuell generering och inbyggt stöd för transparenta bilder. Modellkortet anger inte om den tillhandahållna versionen skiljer sig från de publicerade vikterna.
| Jämförd egenskap | qwen-image-2.1-pro | qwen-image-2.0-pro |
|---|---|---|
| Pris per genererad bild | 0,04 dollar | 0,075 dollar |
| Kostnadsfri kvot | 10 bilder | 100 bilder |
Priset sjunker med nästan hälften, men den kostnadsfria kvoten är tio gånger mindre. På QwenCloud är modellen begränsad till 20 förfrågningar per minut och 10 samtidiga anrop.
🔗 Model Studios modelljournal · QwenClouds modellkort
Apron förutsäger GPU-minnesbehovet för 14 öppna modeller innan man hyr en GPU, enligt utvecklaren
3 oktober — Vlad Ryzhkov, utvecklaren bakom Apron, presenterar detta open source-verktyg på Hugging Faces communityblogg. Verktyget förutsäger, innan man hyr en GPU, om en öppen modell får plats i minnet och startar med en viss version av vLLM, och kontrollerar sedan detta på ett riktigt kort.
Enligt utvecklaren ligger det förutsagda minnet för vikterna inom 2 % av det uppmätta värdet för 11 av de 14 startade modellerna, från en RTX 4090 till åtta H200. Fyra modeller misslyckades vid starten innan en korrigering, som verifierades genom en andra start, fick dem att fungera, och DeepSeek-V4.1-Flash använder som standard 189 Gio värdminne, vilket inte syns i en kontroll som är begränsad till GPU:n.
Utvecklaren påpekar att det bara finns en uppmätt start per modell och att resultaten inte utgör någon rangordning. Kommandoradsverktyget är inte redo för extern användning, och dess repository beskrivs fortfarande som en specifikation utan implementation.
🔗 Vlad Ryzhkovs inlägg (Hugging Face)
Notiser
- Copilot CLI 1.0.92-3 och SDK Copilot 1.0.17-preview.3 — Förhandsversionen av Copilot CLI lägger till en väljare som öppnas med Ctrl+E före samtalet för att välja lokal körning eller körning i molnet; förhandsversionen av SDK gör det möjligt att experimentellt ersätta klientens verktyg i en pågående session. Den senaste stabila versionen är fortfarande 1.0.91. 🔗 CLI · 🔗 SDK
- Copilot code review via API — En granskning med Copilot kan nu begäras via REST- och GraphQL-API:erna, med en insatsnivå som anges för varje begäran, och är allmänt tillgänglig för abonnemangen Pro, Pro+, Max, Business och Enterprise; dokumentationen uppskattar kostnaden för en granskning till mellan 0,05 och 1 dollar i IA-krediter med Lite och mellan 0,25 och 5 dollar med Balanced, som är standardnivån. 🔗 källa
- Nightly för Gemini CLI — v0.64.0-nightly från den 3 oktober innehåller bara en korrigering: Enter och mellanslag bekräftar tillförlitligt val i listor, även i terminaler utan Kittys tangentbordsprotokoll, som terminalen i PyCharm under Windows, där ett tryck på Enter mindre än 30 ms efter en annan tangent tolkades som Skift+Enter. Den stabila versionen och förhandsversionen är oförändrade. 🔗 källa
- DeepSeek Harness 0.2.1-alpha.1 — Denna 25:e förhandsversion, som fortfarande saknar en stabil version, lägger till ett experimentellt kompatibilitetslager för mods till Claude Code, enligt DeepSeek avsett att kontrollera att deras API i stort sett utgör en delmängd av vad plugins till Harness möjliggör, utan att erbjuda fullständig kompatibilitet. 🔗 källa
- GPT-6.1 Sol i Warp — På kvällen den 29 september gjorde Warp GPT-6.1 Sol tillgängligt i sin agentbaserade terminal, där det kan användas med ett Codex- eller ChatGPT-abonnemang; tillkännagivandet anger varken pris eller mätresultat specifika för Warp. 🔗 källa
- Slutet för grok-voice-transcribe-1.0 — SpaceXAI avvecklade den 2 oktober den äldre versionen av sin transkriptionsmodell i API:et: förfrågningarna omdirigeras till grok-voice-transcribe-2.0, som har samma pris och enligt SpaceXAI är mer exakt. Utfasningen tillkännagavs den 18 september utan något datum. 🔗 källa
- September för OpenAI-utvecklare — Kontot @OpenAIDevs sammanfattar utvecklarnyheterna från september i en X-artikel, från DevDay den 29:e till GPT-6 Sol och Luna, utan några nya tillkännagivanden; den enda preciseringen är att OpenAI:s Decisions-API, som har funnits i en begränsad förhandsversion sedan den 29 september, uppges bli allmänt tillgängligt snart, utan något datum. 🔗 källa
- Två driftsättningar av ElevenLabs-agenter — Banner Health överlåter tidsbokning inom primärvården till ElevenAgents, med överlämning till en människa och efterlevnad av HIPAA; försäkringsbolaget Admiral berättar om driftsättningen av sina röstagenter, där varje ändring går från 1 % till 100 % av trafiken på några timmar i stället för flera veckor. Ingen av dem publicerar några resultatsiffror. 🔗 Banner Health · 🔗 Admiral
- Kling 4.0 med tidig åtkomst — Presentationsinlägget om Kling 4.0, daterat den 30 september, preciserar att den fullständiga modellen får tidig åtkomst före en bredare utrullning i oktober, medan Kling 4.0 Flash har varit tillgängligt för Ultra-abonnenter med årsabonnemang sedan den 28 september; formatet 21:9 tillkommer, utan uppgifter om pris, API eller åtkomstkriterier. 🔗 källa
- Runway Agent, Runway MCP och OpenAI:s dots — Runways changelog listar tre tillägg utan något tillkännagivande på X: Runway Agent använder Draft-läget i Seedance 2.5 (utkast i 480p som bearbetas efter generering), Ideogram 4.5 läggs till i Runway MCP för betalabonnemangen, och Runway finns sedan den 1 oktober i OpenAI:s dots. Ingen kostnad i krediter anges. 🔗 källa
- Tillståndslösa token för GitHub Apps — Utanför IA-området slutför GitHub utrullningen, som inleddes den 27 april, av det tillståndslösa formatet
ghs_APPID_JWTför alla nya installationstoken för GitHub Apps: cirka 520 tecken i stället för 40, med oförändrade behörigheter och en oförändrad giltighetstid på en timme; testheadernX-GitHub-Stateless-S2S-Tokenkommer att fasas ut den 30 november 2026. 🔗 källa - Mänsklig feedback i realtid hos Rapidata — Rapidata beskriver sin funktion Flows, som ersätter belöningsmodellen i Flow-GRPO med mänskliga parvisa jämförelser i realtid, i ett inlägg från leverantören där inga uppmätta träningsresultat publiceras. 🔗 källa
- Mäta beroendet mellan agenter — I en essä utan experiment eller mätningar föreslår Anouar Imel att system med flera agenter ska utvärderas utifrån beroendet mellan agenterna snarare än deras antal, genom att i varje omgång följa korrektheten, mångfalden i resonemangen och kopplingen mellan agenterna. 🔗 källa
Vad det betyder
Kolibri visar att en öppen modell kan hävda sig utan att sikta på förstaplatsen. Aleph Alpha publicerar själv mätresultat där dense-modellen Qwen3.8 27B ligger före nästan överallt, och lyfter fram ett annat kriterium: att hantera många långa förfrågningar med få GPU:er, på både engelska och tyska, under en licens som tillåter att allt körs lokalt. För en myndighet eller ett industriföretag som måste följa AI Act och RGPD kan denna avvägning väga tyngre än några benchmarkpoäng. Cohere, vars samgående med Aleph Alpha fortfarande väntar på myndighetsgodkännanden, lovar redan en fortsättning.
Driftkostnaden blir en central fråga för öppna modeller. Qwen-Image-2.1, som publicerades med öppna vikter den 20 september, återkommer via API under namnet Qwen-Image-2.1-Pro för 0,04 dollar per bild, nästan hälften så dyrt som den föregående generationen, för den som föredrar att slippa drifta modellen själv. Aprons inlägg påminner i sin tur om vad egen drift kräver: en modell kan krascha vid starten om en inställning i vLLM saknas, eller ta upp 189 Gio värdminne som en kontroll begränsad till GPU:n inte upptäcker.
Meta flyttar säkerhetsarbetet till fasen före driftsättningen. Riskfylld förstärkningsinlärning kräver nu validerade sandboxar, loggar som inte kan ändras och automatisk avstängning, eftersom en modell som är stark inom cybersäkerhet kan utnyttja sårbarheterna i sin egen miljö. Den IA-kommitté som har aviserats inom styrelsen ska dessutom oberoende kontrollera att dessa regler följs. När det gäller åtagandena som gjordes i Vita huset, och som Meta säger sig återspegla, återger inlägget bara deras grundtanke: interna kontroller som verifieras av ett oberoende team inom företaget och av en extern revisor eller utvärderare.
Slutligen integreras agenterna i verktygen och driften. OpenAI låter användaren välja sandboxens storlek och återanvända en miljö mellan sessioner, Devin flyttar in i Jira och åtgärdar fynden från sin egen granskning innan de publiceras, och Copilot code review startas via API med en uppskattad kostnad per insatsnivå. Antigravity CLI följer serverns väntetider för nya försök och kör Remote Control i containrar: driftinställningar snarare än spektakulära funktioner, men det är dessa som räknas när en agent körs kontinuerligt.
Källor
- Aleph Alphas inlägg om Kolibri
- Kolibri-1 på Hugging Face
- Tillkännagivande av Kolibri från @Aleph__Alpha
- Teknisk rapport om Kolibri (PDF)
- Vidaredelning av Kolibri från @cohere
- Gratulationer från Aidan Gomez
- Slutligt avtal mellan Cohere och Aleph Alpha
- Utveckla kapabla modeller på ett ansvarsfullt sätt (Meta)
- Metas ramverk för skalning av superintelligens
- Nyheter i Agents-API:et från @stevendcoffey
- Vidaredelning från @OpenAIDevs
- Sandboxar som driftas av OpenAI (OpenAI-dokumentation)
- Versionsanteckningar för Devin från den 30 september
- Antigravitys changelog
- Modellogg för Model Studio
- Priser för Model Studio
- Informationssida för qwen-image-2.1-pro på QwenCloud
- Jag vet att du kör LLMs. Går det att starta? (Hugging Face)
- Aprons repository på GitHub
- Copilot CLI v1.0.92-3
- SDK GitHub Copilot v1.0.17-preview.3
- Copilot code review: API-stöd och ny standardnivå för insats (GitHub)
- Gemini CLI Nightly v0.64.0 från den 3 oktober
- Versionsanteckningar för DeepSeek Harness 0.2.1-alpha.1
- GPT-6.1 Sol i Warp (@warpdotdev)
- Versionsanteckningar för SpaceXAI:s API
- September för OpenAI-utvecklare (@OpenAIDevs)
- ElevenLabs hos Banner Health
- Sammanfattning av Admirals webbinarium (ElevenLabs)
- Presentation av Kling 4.0
- Runways changelog
- Tillståndslösa installationstoken för GitHub App har rullats ut (GitHub)
- Mänsklig feedback i realtid i träningsloopen (Rapidata)
- När AI-agenter blir varandras bevis (Anouar Imel)