ai-powered-markdown-translatorArticol tradus din fr în ro cu gpt-6.1-sol.
Sâmbătă, 3 octombrie, Aleph Alpha lansează Kolibri, un model englez-german cu ponderi deschise și 78,1 miliarde de parametri, sub licența Apache 2.0, a cărui lansare este promovată în aceeași seară de Cohere, companie a cărei asociere cu Aleph Alpha așteaptă încă aprobările autorităților de reglementare. Cu o zi înainte, Meta își extindea cadrul de siguranță la antrenarea modelelor sale, iar API-ul Agents de la OpenAI adăuga trei dimensiuni de sandbox. Notele de versiune ale Devin din 30 septembrie îl transformă într-un agent nativ pentru Jira, Qwen-Image-2.1-Pro devine disponibil prin API la 0,04 dolari pe imagine, iar dezvoltatorul Apron explică modul în care poate fi estimată memoria GPU necesară unui model deschis înainte de închirierea unei plăci.
Aleph Alpha lansează Kolibri, un model englez-german cu 78 de miliarde de parametri sub Apache 2.0
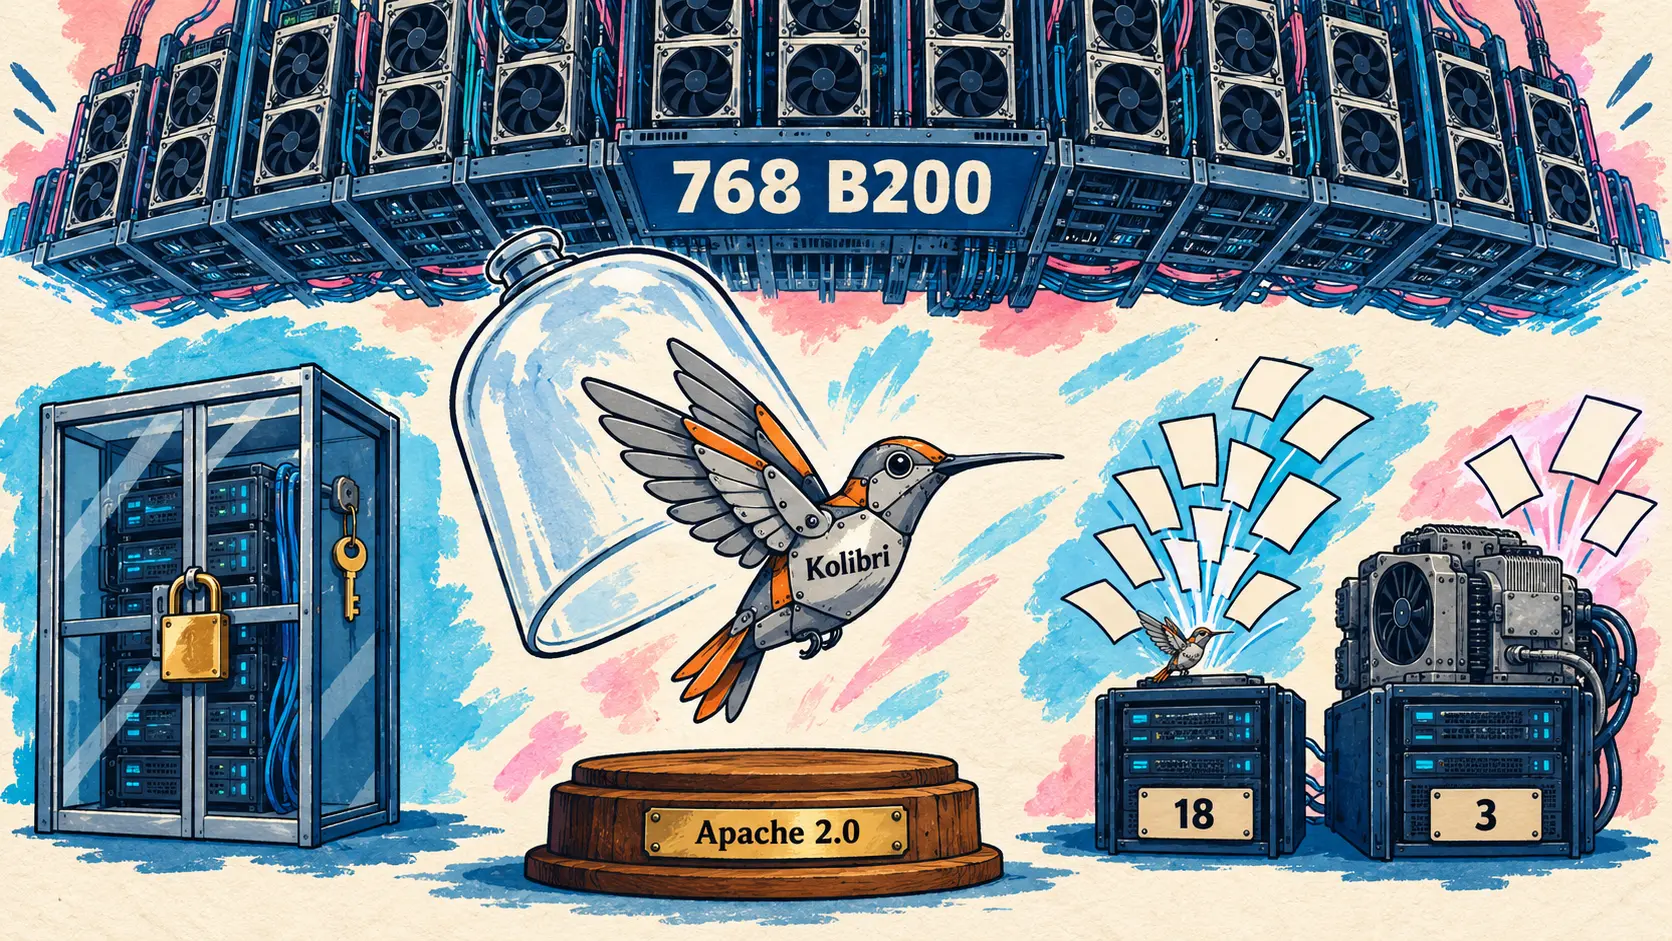
3 octombrie — De Ziua Unității Germane, Aleph Alpha lansează Kolibri, un model lingvistic englez-german cu ponderi deschise. Acest model cu amestec de experți (Mixture-of-Experts) are 78,1 miliarde de parametri, dintre care 3,46 miliarde sunt activi pentru fiecare token, iar ponderile sale sunt disponibile pe Hugging Face sub licența Apache 2.0. Aleph Alpha îl destinează activităților desfășurate în mod suveran în sectoarele reglementate: administrație publică, industrie, aeronautică.
Arhitectura urmărește în primul rând costul de operare: 6 experți activi din 384 și 40 de straturi din 50 limitate la o fereastră glisantă de 512 tokens. Modelul acceptă până la 1 048 576 tokens, dar a fost antrenat până la 262 144, lungime pe care fișa sa recomandă să nu o depășiți. Potrivit articolului, o versiune cu 123 de miliarde de parametri procesa doar 3 cereri de 256k tokens pe două H100, față de 18 pentru dimensiunea aleasă. Antrenarea a folosit 768 de GPU B200 în Germania și Finlanda, pentru aproape 24T tokens; germana reprezintă 21,3 % din preantrenare.
Potrivit măsurătorilor Aleph Alpha (sistem propriu de evaluare, efort de raționament maxim), Kolibri depășește la scorul global Qwen3.5 35B-A3B și Nemotron 3 Super, care activează 12 miliarde de parametri, dar modelul dens Qwen3.8 27B rămâne în față aproape peste tot:
| Benchmark (măsurători Aleph Alpha) | Kolibri 78B-A3,46B | Qwen3.5 35B-A3B | Nemotron 3 Super 120B-A12B | Mistral Small 4 119B-A6B | Qwen3.8 27B (dens) |
|---|---|---|---|---|---|
| Scor global (engleză) | 75,5 | 74,7 | 73,0 | 63,1 | 80,2 |
| Scor global (germană) | 70,8 | 69,8 | 67,9 | 61,4 | 79,9 |
| GPQA Diamond (engleză) | 84,3 | 83,8 | 78,0 | 74,7 | 89,2 |
| AIME 2026 (engleză) | 96,0 | 92,1 | 90,4 | 83,1 | 97,7 |
| SWE-Bench Verified | 66,4 | 71,6 | 60,2 | 60,8 | 72,6 |
Argumentul Aleph Alpha nu este, așadar, primul loc, ci frontiera Pareto dintre calitate și costul de operare. Antrenat să se abțină, Kolibri preferă să se abțină sau să răspundă parțial în loc să greșească la 44 % dintre întrebările AA-Omniscience pe care nu le rezolvă. Dezvoltat în Germania „fără control străin” (no foreign control), conceput ținând cont de AI Act și RGPD, poate rula local; un raport tehnic de aproape 200 de pagini însoțește lansarea.
Cohere, al cărei acord definitiv de asociere cu Aleph Alpha rămâne supus aprobărilor autorităților de reglementare, a promovat lansarea în aceeași seară, după felicitările adresate de CEO-ul său, Aidan Gomez; Kolibri rămâne un model al Aleph Alpha.
New Apache 2.0 model from @Aleph__Alpha. It’s really good. If you like that, you’re going to love what we build together.
🇷🇴 Un nou model sub Apache 2.0 de la Aleph Alpha. Este foarte bun. Dacă acesta vă place, veți adora ceea ce vom construi împreună. — @cohere pe X
🔗 Articolul Aleph Alpha · Ponderi pe Hugging Face
Meta își extinde cadrul de siguranță la antrenare și își clarifică regulile pentru ponderile deschise
2 octombrie — Meta Superintelligence Labs actualizează Meta Superintelligence Scaling Framework, care stabilește cerințele sale de siguranță înainte de antrenare și apoi de implementare. Potrivit Meta, această versiune reflectă angajamentele asumate săptămâna aceasta la Casa Albă, care prevăd controale interne verificate de o echipă independentă din cadrul companiei și de un auditor sau evaluator extern.
Pierderea controlului (loss of control) este acum reglementată pe durata antrenării și evaluării, deoarece un model performant în securitate cibernetică poate, potrivit Meta, să exploateze vulnerabilitățile mediului său. O antrenare prin întărire care prezintă riscuri necesită sandbox-uri validate, jurnale care nu pot fi modificate, inclusiv lanțul de raționament, și o monitorizare automată capabilă să oprească run-ul.
Pentru ponderile deschise, cadrul ține cont de modificările posibile după publicare, precum eliminarea refuzului prin ajustare fină. Un comitet pentru IA al consiliului de administrație, anunțat pentru lunile următoare, va verifica independent respectarea cadrului. Acest cadru este fostul „Advanced AI Scaling Framework”, redenumit odată cu această versiune 2.1: cel pe baza căruia Muse Spark fusese evaluat în aprilie.
🔗 Dezvoltarea responsabilă a modelelor capabile (Meta)
API-ul Agents de la OpenAI adaugă trei dimensiuni de sandbox și reutilizarea mediilor
2 octombrie — Steve (@stevendcoffey), care lucrează la API-ul OpenAI potrivit biografiei sale de pe X, enumeră noutățile săptămânii pentru API-ul Agents, distribuite de @OpenAIDevs. Pe lângă trei reamintiri de la DevDay, patru puncte sunt noi. Primul este confirmat de documentație: parametrul environment.container_size, stabilit la crearea unei sesiuni, selectează CPU-ul și memoria sandbox-ului găzduit de OpenAI.
| Dimensiunea containerului | vCPU alocate | Memorie alocată |
|---|---|---|
| small | 1 | 1 Go |
| medium (implicit) | 2 | 4 Go |
| large | 4 | 16 Go |
Celelalte trei apar doar în tweet: subagenți configurabili din panoul de control, reutilizarea unui mediu în mai multe sesiuni și fiabilitate crescută, fără publicarea metodei de măsurare.
Overall better reliability: 99.97% turn reliability, fewer SSE disconnects, 20% faster tool calls 🪨
🇷🇴 Fiabilitate generală îmbunătățită: 99,97 % fiabilitate pe tură, mai puține deconectări SSE, apeluri de instrumente cu 20 % mai rapide. — @stevendcoffey pe X
Agenți de programare: Devin în Jira, Antigravity CLI 1.2.13 și 1.2.14
Devin devine un agent nativ pentru Jira și transmite constatările Devin Review către sesiunile sale
30 septembrie — Notele de versiune ale Devin din 30 septembrie cuprind 25 de rubrici. Principala noutate îl transformă pe Devin într-un agent nativ (native agent) pentru Jira: odată ce aplicația Devin for Jira este instalată de un administrator, atribuirea unui tichet lui Devin sau menționarea sa pornește o sesiune, urmărită în panoul de agent din Jira. Dacă Devin nu poate porni (permisiune lipsă, limită de utilizare), Jira afișează explicația sa în locul unei erori generice.
Pentru un pull request deschis de o sesiune Devin încă activă, Devin Review transmite mai întâi constatările sale (findings) către acea sesiune: cu remedierea automată (Auto-fix), Devin corectează ce poate, iar numai constatările rămase sunt publicate. Automatizările primesc verificări preliminare (preflight checks): un script se execută după fiecare declanșator, înaintea lui Devin, pentru a valida, îmbogăți sau ignora evenimentul. Nu este menționat niciun tarif.
🔗 Notele de versiune ale Devin din 30 septembrie
Antigravity CLI 1.2.13 și 1.2.14: timpi de reîncercare, coada de mesaje, Remote Control fără systemd
29 și 30 septembrie — Changelog-ul Antigravity CLI de la Google enumeră două versiuni. Versiunea 1.2.13 respectă timpul de reîncercare indicat de API-ul modelului în loc să aștepte un interval fix de 5 secunde și renunță imediat dacă acest timp depășește 30 de secunde sau dacă limita atinsă este un plafon zilnic ori de facturare.
Versiunea 1.2.14 (6 îmbunătățiri, 3 remedieri) adaugă în /config opțiunea Queued Messages: implicit (Queue), un mesaj trimis în timp ce agentul lucrează așteaptă sfârșitul turei; în modul Send Immediately, îl întrerupe. Pe calculatoarele Linux fără managerul de servicii de utilizator systemd, precum majoritatea containerelor, Remote Control își pornește daemon-ul ca simplu proces în fundal, care nu va reporni nici după o cădere, nici la pornirea sistemului. Opțiunea --json-schema devine strictă: o schemă invalidă provoacă o eroare și codul de ieșire 1. Lansarea se face treptat, pe parcursul câtorva zile.
Qwen-Image-2.1-Pro devine disponibil prin API pe Model Studio și QwenCloud, la 0,04 dolari pe imagine
2 octombrie — Alibaba adaugă Qwen-Image-2.1-Pro în catalogul Model Studio, platforma sa de API, pentru domeniul de serviciu International, iar QwenCloud îi dedică o fișă marcată „NOU”, fără vreun tweet sau articol de la Qwen. Modelul continuă Qwen-Image-2.1, publicat cu ponderi deschise pe 20 septembrie: creare și retușare într-un singur model, 7 miliarde de parametri pentru generarea vizuală, imagini transparente native. Fișa nu precizează dacă versiunea oferită diferă de ponderile publicate.
| Element comparat | qwen-image-2.1-pro | qwen-image-2.0-pro |
|---|---|---|
| Preț pe imagine generată | 0,04 dollar | 0,075 dollar |
| Cotă gratuită | 10 imagini | 100 imagini |
Prețul scade cu aproape jumătate, dar cota gratuită este de zece ori mai mică. Pe QwenCloud, modelul este limitat la 20 de cereri pe minut și 10 apeluri simultane.
🔗 Jurnalul modelelor Model Studio · Fișa QwenCloud
Apron estimează memoria GPU pentru 14 modele deschise înainte de închiriere, potrivit autorului său
3 octombrie — Vlad Ryzhkov, dezvoltatorul Apron, prezintă pe blogul comunității Hugging Face acest instrument open source, care estimează înainte de închirierea unui GPU dacă un model deschis va încăpea în memorie și va porni cu o versiune precisă de vLLM, apoi verifică pe o placă reală.
Potrivit autorului, memoria estimată pentru ponderi diferă cu mai puțin de 2 % față de valoarea măsurată pentru 11 dintre cele 14 modele pornite, de la o RTX 4090 până la opt H200. Patru modele au eșuat înainte ca o remediere, validată printr-o a doua pornire, să le repare, iar DeepSeek-V4.1-Flash ocupă implicit 189 Gio de memorie a sistemului gazdă, invizibili pentru o verificare limitată la GPU.
Autorul avertizează că există o singură pornire măsurată pentru fiecare model și că nimic nu constituie un clasament. Instrumentul de linie de comandă nu este pregătit pentru utilizare externă, iar repository-ul său se descrie încă drept o specificație fără implementare.
🔗 Articolul lui Vlad Ryzhkov (Hugging Face)
Știri pe scurt
- Copilot CLI 1.0.92-3 și SDK Copilot 1.0.17-preview.3 — Versiunea preliminară a Copilot CLI adaugă un selector, deschis prin Ctrl+E înainte de conversație, pentru a alege între execuția locală și cea în cloud; cea a SDK permite, experimental, înlocuirea instrumentelor clientului într-o sesiune în curs. Cea mai recentă versiune stabilă rămâne 1.0.91. 🔗 CLI · 🔗 SDK
- Copilot code review prin API — O revizuire efectuată de Copilot poate fi solicitată acum prin API-urile REST și GraphQL, cu un nivel de efort stabilit pentru fiecare cerere, în disponibilitate generală pentru abonamentele Pro, Pro+, Max, Business și Enterprise; documentația estimează costul unei revizuiri la 0,05 până la 1 dolar în credite IA pentru Lite și la 0,25 până la 5 dolari pentru Balanced, nivelul de efort implicit. 🔗 sursă
- Nightly pentru Gemini CLI — Versiunea v0.64.0-nightly din 3 octombrie conține o singură corecție: Enter și Spațiu confirmă în mod fiabil selecțiile din liste, inclusiv în terminalele fără protocolul de tastatură Kitty, precum cel din PyCharm pe Windows, unde o apăsare pe Enter la mai puțin de 30 ms după o altă tastă era interpretată ca Shift+Enter. Versiunile stabilă și preliminară rămân neschimbate. 🔗 sursă
- DeepSeek Harness 0.2.1-alpha.1 — Această a 25-a versiune preliminară, încă fără o versiune stabilă, adaugă un strat experimental de compatibilitate cu modurile Claude Code, destinat, potrivit DeepSeek, să verifice dacă API-ul acestora constituie în linii mari un subset al capabilităților oferite de pluginurile Harness, fără a oferi compatibilitate completă. 🔗 sursă
- GPT-6.1 Sol în Warp — În seara de 29 septembrie, Warp a făcut disponibil GPT-6.1 Sol în terminalul său cu agenți, utilizabil cu un abonament Codex sau ChatGPT; anunțul nu oferă nici prețuri, nici măsurători specifice Warp. 🔗 sursă
- Retragerea grok-voice-transcribe-1.0 — SpaceXAI a retras pe 2 octombrie vechea versiune a modelului său de transcriere prin API: cererile sunt redirecționate către grok-voice-transcribe-2.0, la același preț și cu o precizie mai bună, potrivit SpaceXAI. Scoaterea din uz fusese anunțată pe 18 septembrie, fără o dată. 🔗 sursă
- Septembrie pentru dezvoltatorii OpenAI — Contul @OpenAIDevs recapitulează într-un articol pe X anunțurile pentru dezvoltatori din septembrie, de la DevDay din 29 până la GPT-6 Sol și Luna, fără noutăți; singura precizare este că API-ul Decisions al OpenAI, disponibil în previzualizare limitată din 29 septembrie, este anunțat ca urmând să devină disponibil pentru toți în curând, fără o dată. 🔗 sursă
- Două implementări de agenți ElevenLabs — Banner Health încredințează ElevenAgents programarea consultațiilor de asistență medicală primară, cu transfer către un operator uman și conformitate HIPAA; asigurătorul Admiral descrie punerea în producție a agenților săi vocali, ale căror modificări sunt extinse de la 1 % la 100 % din trafic în câteva ore, în loc de câteva săptămâni. Niciunul dintre cei doi nu publică rezultate numerice. 🔗 Banner Health · 🔗 Admiral
- Kling 4.0 în acces anticipat — Articolul de prezentare a Kling 4.0, datat 30 septembrie, precizează că modelul complet intră în acces anticipat înaintea unei lansări mai ample în octombrie, în timp ce Kling 4.0 Flash este disponibil abonaților Ultra anuali din 28 septembrie; se adaugă formatul 21:9, fără prețuri, API sau criterii de acces. 🔗 sursă
- Runway Agent, Runway MCP și dots de la OpenAI — Changelog-ul Runway enumeră trei noutăți fără un anunț pe X: Runway Agent folosește modul Draft al Seedance 2.5 (variante preliminare în 480p prelucrate din nou după generare), Ideogram 4.5 este adăugat în Runway MCP pentru abonamentele plătite, iar Runway este disponibil din 1 octombrie în dots de la OpenAI. Nu este precizat niciun cost în credite. 🔗 sursă
- Tokenuri fără stare pentru GitHub Apps — În afara IA, GitHub finalizează lansarea, începută pe 27 aprilie, a formatului fără stare
ghs_APPID_JWTpentru toate tokenurile noi de instalare ale GitHub Apps: aproximativ 520 de caractere în loc de 40, cu permisiunile și expirarea după o oră neschimbate; antetul de testX-GitHub-Stateless-S2S-Tokenva fi declarat învechit pe 30 noiembrie 2026. 🔗 sursă - Feedback uman în timp real la Rapidata — Rapidata descrie funcția sa Flows, care înlocuiește modelul de recompensă al Flow-GRPO cu comparații umane în perechi, în timp real, într-un articol al furnizorului care nu publică niciun rezultat măsurat al antrenamentului. 🔗 sursă
- Măsurarea dependenței dintre agenți — Într-un eseu fără experimente sau măsurători, Anouar Imel propune evaluarea sistemelor cu mai mulți agenți pe baza dependenței dintre agenți, în locul numărului lor, urmărind la fiecare rundă corectitudinea, diversitatea raționamentelor și cuplarea dintre agenți. 🔗 sursă
Ce înseamnă acest lucru
Kolibri arată că un model deschis poate concura fără să urmărească primul loc. Aleph Alpha publică el însuși măsurători în care modelul dens Qwen3.8 27B îl depășește aproape peste tot și pune în prim-plan un alt criteriu: deservirea multor cereri lungi cu puține GPU-uri, atât în engleză, cât și în germană, sub o licență care permite găzduirea integrală la sediu. Pentru o administrație publică sau o companie industrială care trebuie să respecte AI Act și RGPD, acest compromis poate conta mai mult decât câteva puncte de benchmark. Cohere, a cărui asociere cu Aleph Alpha așteaptă încă aprobările autorităților de reglementare, promite deja următoarea etapă.
Costul deservirii cererilor devine un subiect central pentru modelele deschise. Qwen-Image-2.1, publicat cu ponderi deschise pe 20 septembrie, revine prin API sub numele Qwen-Image-2.1-Pro la 0,04 dolari pe imagine, aproape la jumătate din prețul generației precedente, pentru cei care preferă să nu îl găzduiască. Articolul Apron amintește, la rândul său, ce presupune găzduirea pe cont propriu: un model poate eșua la pornire din cauza lipsei unei setări vLLM sau poate ocupa 189 Gio de memorie a gazdei, pe care o verificare limitată la GPU nu o detectează.
Meta mută măsurile de securitate înaintea implementării. Un antrenament prin întărire care implică riscuri necesită acum medii sandbox validate, jurnale inalterabile și o oprire automată, deoarece un model performant în securitate cibernetică poate exploata vulnerabilitățile propriului mediu. Comitetul de IA anunțat în cadrul consiliului de administrație trebuie, de asemenea, să verifice independent aplicarea acestor reguli. În privința angajamentelor asumate la Casa Albă, pe care Meta spune că le reflectă, articolul prezintă doar principiile lor: controale interne verificate de o echipă independentă din cadrul companiei și de un auditor sau evaluator extern.
În sfârșit, agenții se integrează în instrumente și în procesele operaționale. OpenAI permite alegerea dimensiunii mediului sandbox și reutilizarea unui mediu de la o sesiune la alta, Devin se instalează în Jira și remediază problemele identificate în propria revizuire înainte de a le publica, iar Copilot code review poate fi declanșat prin API, cu un cost estimat pentru fiecare nivel de efort. Antigravity CLI respectă intervalele de reîncercare indicate de server și rulează Remote Control în containere: mai degrabă ajustări operaționale decât funcții spectaculoase, dar acestea sunt cele care contează atunci când un agent rulează continuu.
Surse
- Articolul Aleph Alpha despre Kolibri
- Kolibri-1 pe Hugging Face
- Anunțul despre Kolibri al @Aleph__Alpha
- Raportul tehnic Kolibri (PDF)
- Redistribuirea anunțului Kolibri de către @cohere
- Felicitările lui Aidan Gomez
- Acordul definitiv dintre Cohere și Aleph Alpha
- Dezvoltarea responsabilă a unor modele capabile (Meta)
- Cadrul Meta de scalare a superinteligenței
- Noutățile API-ului Agents prezentate de @stevendcoffey
- Redistribuirea de către @OpenAIDevs
- Medii sandbox găzduite de OpenAI (documentația OpenAI)
- Notele de versiune Devin din 30 septembrie
- Changelog-ul Antigravity
- Jurnalul modelelor Model Studio
- Tarifele Model Studio
- Fișa qwen-image-2.1-pro pe QwenCloud
- Știu că rulezi LLM-uri. Va porni? (Hugging Face)
- Repository-ul Apron pe GitHub
- Copilot CLI v1.0.92-3
- SDK GitHub Copilot v1.0.17-preview.3
- Copilot code review: suport API și un nou nivel de efort implicit (GitHub)
- Nightly v0.64.0 din 3 octombrie pentru Gemini CLI
- Notele de versiune DeepSeek Harness 0.2.1-alpha.1
- GPT-6.1 Sol în Warp (@warpdotdev)
- Notele de versiune ale API-ului SpaceXAI
- Septembrie pentru dezvoltatorii OpenAI (@OpenAIDevs)
- ElevenLabs la Banner Health
- Recapitularea webinarului Admiral (ElevenLabs)
- Prezentarea Kling 4.0
- Changelog-ul Runway
- Lansarea tokenurilor de instalare fără stare pentru GitHub App (GitHub)
- Feedback uman în timp real în bucla de antrenament (Rapidata)
- Când agenții AI devin dovezi unii pentru alții (Anouar Imel)