ai-powered-markdown-translatorArtykuł przetłumaczony z francuskiego na polski za pomocą gpt-6.1-sol.
W sobotę 3 października Aleph Alpha publikuje Kolibri, angielsko-niemiecki model z otwartymi wagami o 78,1 miliarda parametrów na licencji Apache 2.0. Jeszcze tego samego wieczoru publikację nagłaśnia Cohere, którego połączenie z Aleph Alpha nadal czeka na zgody organów regulacyjnych. Dzień wcześniej Meta rozszerzyła swoje ramy bezpieczeństwa na trening modeli, a API Agents od OpenAI dodało trzy rozmiary piaskownicy. Informacje o wydaniu Devin z 30 września czynią z niego natywnego agenta Jira, Qwen-Image-2.1-Pro trafia do API w cenie 0,04 dolara za obraz, a twórca Apron wyjaśnia, jak przewidzieć zapotrzebowanie otwartego modelu na pamięć GPU przed wynajęciem karty.
Aleph Alpha publikuje Kolibri, angielsko-niemiecki model o 78 miliardach parametrów na licencji Apache 2.0
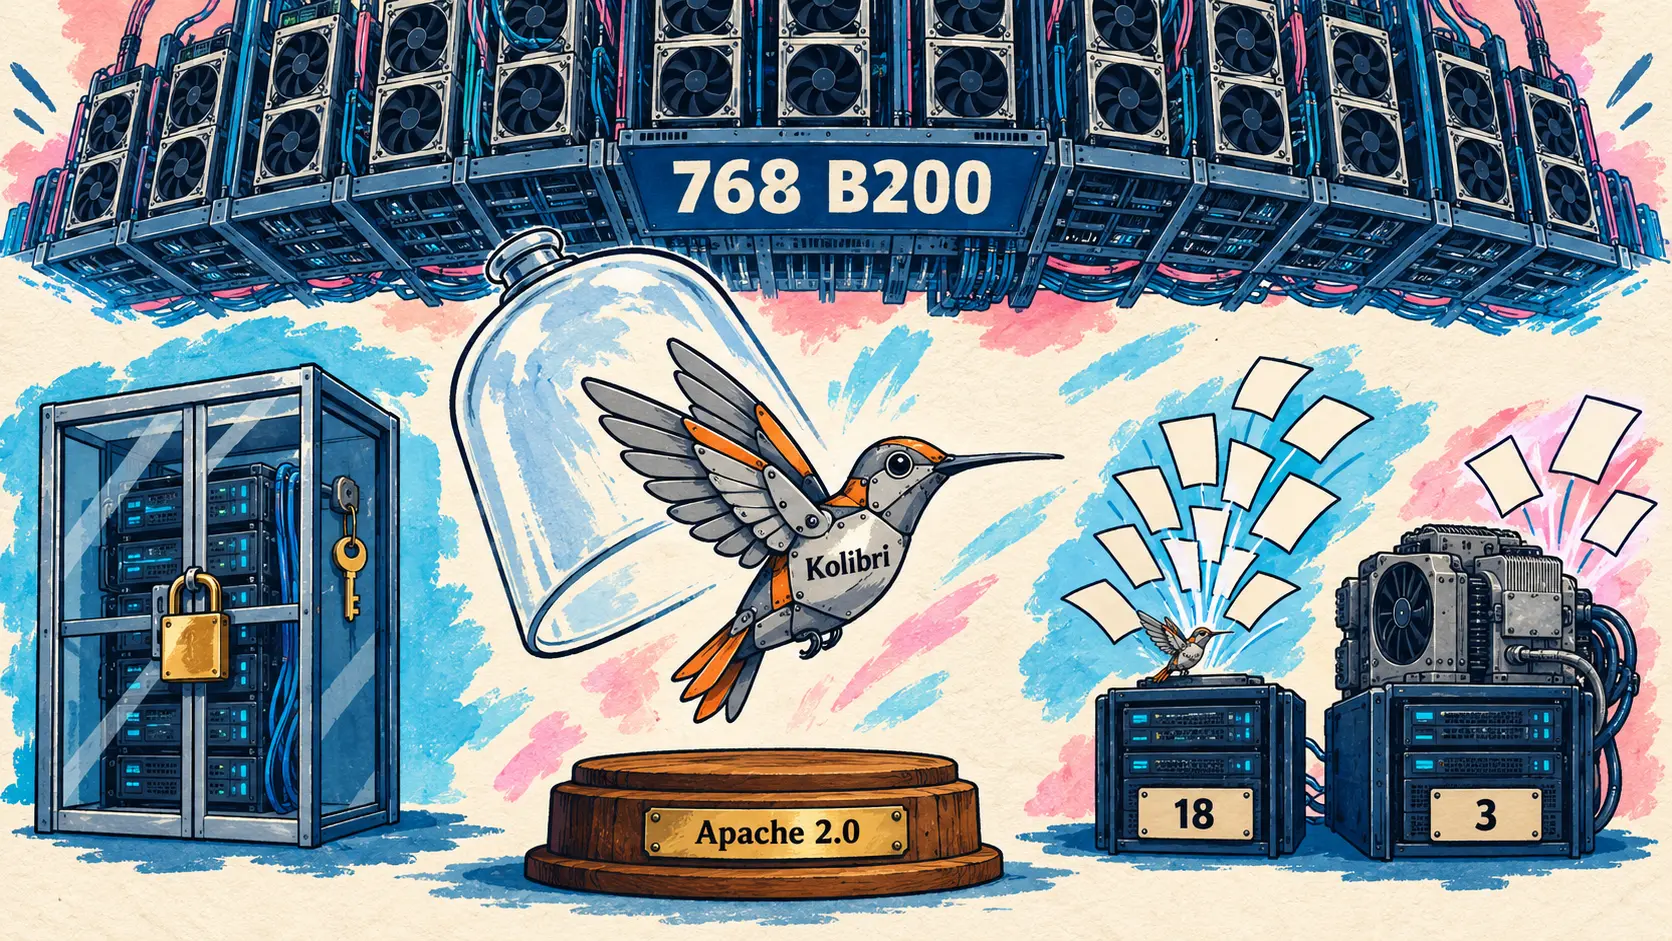
3 października — W Dniu Jedności Niemiec Aleph Alpha publikuje Kolibri, angielsko-niemiecki model językowy z otwartymi wagami. Ten model oparty na mieszance ekspertów (Mixture-of-Experts) ma 78,1 miliarda parametrów, z czego 3,46 miliarda jest aktywnych na token, a jego wagi są dostępne na Hugging Face na licencji Apache 2.0. Aleph Alpha przeznacza go do pracy z zachowaniem suwerenności w sektorach regulowanych: administracji publicznej, przemyśle i lotnictwie.
Architektura ma przede wszystkim ograniczać koszt obsługi: 6 aktywnych ekspertów spośród 384 oraz 40 z 50 warstw ograniczonych do przesuwnego okna o długości 512 tokenów. Model obsługuje do 1 048 576 tokenów, ale był trenowany do długości 262 144, której jego karta zaleca nie przekraczać. Według wpisu wersja o 123 miliardach parametrów obsługiwała tylko 3 zapytania po 256k tokenów na dwóch H100, wobec 18 dla wybranego rozmiaru. Trening wykorzystywał 768 GPU B200 w Niemczech i Finlandii oraz niemal 24T tokenów; język niemiecki stanowi 21,3 % treningu wstępnego.
Według pomiarów Aleph Alpha (własne środowisko ewaluacyjne, maksymalny poziom wysiłku rozumowania) Kolibri wyprzedza w wyniku ogólnym Qwen3.5 35B-A3B i Nemotron 3 Super, który aktywuje 12 miliardów parametrów, ale gęsty model Qwen3.8 27B pozostaje na prowadzeniu niemal wszędzie:
| Benchmark (pomiary Aleph Alpha) | Kolibri 78B-A3,46B | Qwen3.5 35B-A3B | Nemotron 3 Super 120B-A12B | Mistral Small 4 119B-A6B | Qwen3.8 27B (dense) |
|---|---|---|---|---|---|
| Wynik ogólny (angielski) | 75,5 | 74,7 | 73,0 | 63,1 | 80,2 |
| Wynik ogólny (niemiecki) | 70,8 | 69,8 | 67,9 | 61,4 | 79,9 |
| GPQA Diamond (angielski) | 84,3 | 83,8 | 78,0 | 74,7 | 89,2 |
| AIME 2026 (angielski) | 96,0 | 92,1 | 90,4 | 83,1 | 97,7 |
| SWE-Bench Verified | 66,4 | 71,6 | 60,2 | 60,8 | 72,6 |
Argumentem Aleph Alpha nie jest więc pierwsze miejsce, lecz granica Pareto między jakością a kosztem obsługi. Kolibri, trenowany do powstrzymywania się od odpowiedzi, woli też nie odpowiedzieć lub odpowiedzieć częściowo zamiast popełnić błąd w przypadku 44 % pytań z AA-Omniscience, z którymi sobie nie radzi. Opracowany w Niemczech «bez zagranicznej kontroli» (bez zagranicznej kontroli), zaprojektowany z myślą o AI Act i RGPD, może działać lokalnie; publikacji towarzyszy raport techniczny liczący niemal 200 stron.
Cohere, którego ostateczna umowa o połączeniu z Aleph Alpha nadal wymaga zgód organów regulacyjnych, nagłośniło publikację jeszcze tego samego wieczoru, po gratulacjach od swojego prezesa Aidana Gomeza; Kolibri pozostaje modelem Aleph Alpha.
New Apache 2.0 model from @Aleph__Alpha. It’s really good. If you like that, you’re going to love what we build together.
🇵🇱 Nowy model na licencji Apache 2.0 od Aleph Alpha. Jest naprawdę dobry. Jeśli ten wam się podoba, pokochacie to, co zbudujemy razem. — @cohere na X
🔗 Wpis Aleph Alpha · Wagi na Hugging Face
Meta rozszerza swoje ramy bezpieczeństwa na trening i doprecyzowuje zasady dotyczące otwartych wag
2 października — Meta Superintelligence Labs aktualizuje Meta Superintelligence Scaling Framework, który określa wymagania bezpieczeństwa przed treningiem, a następnie wdrożeniem. Według Meta ta wersja odzwierciedla zobowiązania podjęte w tym tygodniu w Białym Domu, przewidujące kontrole wewnętrzne weryfikowane przez niezależny zespół w firmie oraz zewnętrznego audytora lub ewaluatora.
Utrata kontroli (loss of control) jest teraz objęta zasadami podczas treningu i ewaluacji, ponieważ model o dużych możliwościach w zakresie cyberbezpieczeństwa może, według Meta, wykorzystać luki w swoim środowisku. Trening przez wzmacnianie obarczony ryzykiem wymaga zweryfikowanych piaskownic, niezmienialnych logów obejmujących również łańcuch myślowy oraz automatycznego monitorowania zdolnego zatrzymać przebieg treningu.
W przypadku otwartych wag ramy uwzględniają możliwe modyfikacje po publikacji, takie jak usunięcie odmów przez dostrajanie. Komitet zarządu ds. AI, którego powołanie zapowiedziano na najbliższe miesiące, będzie niezależnie weryfikować przestrzeganie tych ram. To dawny «Advanced AI Scaling Framework», przemianowany wraz z wersją 2.1: ten sam, według którego w kwietniu oceniano Muse Spark.
🔗 Odpowiedzialne tworzenie modeli o dużych możliwościach (Meta)
API Agents od OpenAI dodaje trzy rozmiary piaskownicy i ponowne wykorzystywanie środowisk
2 października — Steve (@stevendcoffey), który według swojego opisu na X pracuje nad API OpenAI, wymienia nowości tygodnia w API Agents, udostępnione dalej przez @OpenAIDevs. Oprócz trzech przypomnień z DevDay pojawiają się cztery nowe punkty. Pierwszy potwierdza dokumentacja: parametr environment.container_size, ustawiany przy tworzeniu sesji, określa CPU i pamięć piaskownicy hostowanej przez OpenAI.
| Rozmiar kontenera | Przydzielone vCPU | Przydzielona pamięć |
|---|---|---|
| small | 1 | 1 Go |
| medium (domyślnie) | 2 | 4 Go |
| large | 4 | 16 Go |
Pozostałe trzy pojawiają się tylko w tweecie: subagenci konfigurowani z panelu, ponowne wykorzystywanie środowiska w wielu sesjach oraz wzrost niezawodności, bez opublikowanej metody pomiaru.
Overall better reliability: 99.97% turn reliability, fewer SSE disconnects, 20% faster tool calls 🪨
🇵🇱 Poprawiona ogólna niezawodność: 99,97 % niezawodności na turę, mniej rozłączeń SSE, wywołania narzędzi szybsze o 20 %. — @stevendcoffey na X
Agenci programistyczni: Devin w Jira, Antigravity CLI 1.2.13 i 1.2.14
Devin staje się natywnym agentem Jira i przekazuje ustalenia Devin Review do swoich sesji
30 września — Informacje o wydaniu Devin z 30 września obejmują 25 pozycji. Główna czyni z Devin natywnego agenta (native agent) Jira: po zainstalowaniu aplikacji Devin for Jira przez administratora przypisanie zgłoszenia do Devin lub oznaczenie go uruchamia sesję, którą można śledzić w panelu agenta w Jira. Jeśli Devin nie może wystartować (brak uprawnień, limit użycia), Jira wyświetla jego wyjaśnienie zamiast ogólnego błędu.
W przypadku pull requestu otwartego przez nadal aktywną sesję Devin, Devin Review najpierw przekazuje swoje ustalenia (findings) do tej sesji: przy automatycznej naprawie (Auto-fix) Devin poprawia to, co może, a publikowane są tylko pozostałe ustalenia. Automatyzacje zyskują kontrole wstępne (preflight checks): po każdym wyzwalaczu, przed Devin, uruchamia się skrypt, który weryfikuje, wzbogaca lub pomija zdarzenie. Nie podano żadnych cen.
🔗 Informacje o wydaniu Devin z 30 września
Antigravity CLI 1.2.13 i 1.2.14: czas oczekiwania na ponowną próbę, kolejka wiadomości, Remote Control bez systemd
29 i 30 września — Changelog Antigravity CLI od Google wymienia dwie wersje. Wersja 1.2.13 stosuje czas oczekiwania na ponowną próbę wskazany przez API modelu zamiast stałych 5 sekund i od razu rezygnuje, jeśli czas ten przekracza 30 sekund lub osiągnięty limit jest limitem dziennym albo rozliczeniowym.
Wersja 1.2.14 (6 ulepszeń, 3 poprawki) dodaje w /config opcję Queued Messages: domyślnie (Queue) wiadomość wysłana podczas pracy agenta czeka na koniec tury; w trybie Send Immediately przerywa jego pracę. Na maszynach z Linux bez menedżera usług użytkownika systemd, takich jak większość kontenerów, Remote Control uruchamia swojego demona jako zwykły proces w tle, który nie uruchomi się ponownie ani po awarii, ani przy starcie systemu. Opcja --json-schema jest teraz rygorystyczna: nieprawidłowy schemat powoduje błąd i kod wyjścia 1. Wdrożenie odbywa się stopniowo, przez kilka dni.
Qwen-Image-2.1-Pro trafia do API w Model Studio i QwenCloud w cenie 0,04 dolara za obraz
2 października — Alibaba dodaje Qwen-Image-2.1-Pro do katalogu Model Studio, swojej platformy API, dla zakresu usługi International, a QwenCloud publikuje kartę modelu oznaczoną «NOWOŚĆ», bez tweeta ani wpisu Qwen. Model rozwija Qwen-Image-2.1, opublikowany z otwartymi wagami 20 września: tworzenie i edycja w jednym modelu, 7 miliardów parametrów do generowania obrazów, natywne obrazy z przezroczystością. Karta nie informuje, czy wersja udostępniana przez usługę różni się od opublikowanych wag.
| Porównywany element | qwen-image-2.1-pro | qwen-image-2.0-pro |
|---|---|---|
| Cena za obraz wyjściowy | 0,04 dollar | 0,075 dollar |
| Bezpłatny limit | 10 obrazów | 100 obrazów |
Cena spada niemal o połowę, ale bezpłatny limit jest dziesięć razy mniejszy. W QwenCloud model ma limit 20 zapytań na minutę i 10 równoczesnych wywołań.
🔗 Rejestr modeli Model Studio · Karta QwenCloud
Apron przewiduje zapotrzebowanie 14 otwartych modeli na pamięć GPU przed wynajmem, według swojego autora
3 października — Vlad Ryzhkov, twórca Apron, przedstawia na społecznościowym blogu Hugging Face to narzędzie open source, które przed wynajęciem GPU przewiduje, czy otwarty model zmieści się w pamięci i uruchomi pod konkretną wersją vLLM, a następnie weryfikuje to na rzeczywistej karcie.
Według autora przewidywana pamięć wag różni się od pomiaru o mniej niż 2 % dla 11 z 14 uruchomionych modeli, na konfiguracjach od jednej RTX 4090 po osiem H200. W przypadku czterech modeli wystąpiły błędy, które usunęła poprawka zweryfikowana drugim uruchomieniem, a DeepSeek-V4.1-Flash domyślnie zajmuje 189 Gio pamięci hosta, niewidocznych przy sprawdzaniu ograniczonym do GPU.
Autor zaznacza, że dla każdego modelu zmierzono tylko jedno uruchomienie i że żadne wyniki nie stanowią rankingu. Narzędzie wiersza poleceń nie jest gotowe do użytku zewnętrznego, a jego repozytorium nadal opisuje się jako specyfikację bez implementacji.
🔗 Wpis Vlada Ryzhkova (Hugging Face)
Krótkie wiadomości
- Copilot CLI 1.0.92-3 i SDK Copilot 1.0.17-preview.3 — Wersja zapoznawcza Copilot CLI dodaje selektor, otwierany skrótem Ctrl+E przed rozmową, pozwalający wybrać uruchomienie lokalne lub w chmurze; wersja zapoznawcza SDK pozwala eksperymentalnie zastępować narzędzia klienta podczas trwającej sesji. Najnowszą stabilną wersją pozostaje 1.0.91. 🔗 CLI · 🔗 SDK
- Copilot code review przez API — Przegląd kodu przez Copilot można teraz zlecić przez API REST i GraphQL, określając poziom wysiłku przy każdym żądaniu, w ramach ogólnej dostępności dla planów Pro, Pro+, Max, Business i Enterprise; dokumentacja szacuje koszt przeglądu na od 0,05 do 1 dolara w kredytach IA w trybie Lite oraz od 0,25 do 5 dolarów w Balanced, domyślnym poziomie wysiłku. 🔗 źródło
- Nightly Gemini CLI — Wersja v0.64.0-nightly z 3 października zawiera tylko jedną poprawkę: Enter i Spacja niezawodnie zatwierdzają listy wyboru, także w terminalach bez obsługi protokołu klawiatury Kitty, takich jak terminal PyCharm w Windows, gdzie naciśnięcie Enter mniej niż 30 ms po innym klawiszu było interpretowane jako Shift+Enter. Wersje stabilna i zapoznawcza pozostają bez zmian. 🔗 źródło
- DeepSeek Harness 0.2.1-alpha.1 — Ta 25. wersja zapoznawcza, nadal bez wersji stabilnej, dodaje eksperymentalną warstwę zgodności z modami Claude Code, która według DeepSeek ma sprawdzić, czy ich API stanowi w przybliżeniu podzbiór możliwości pluginów Harness, a nie zapewniać pełną zgodność. 🔗 źródło
- GPT-6.1 Sol w Warp — Wieczorem 29 września Warp udostępnił GPT-6.1 Sol w swoim terminalu agentowym, z możliwością korzystania za pomocą subskrypcji Codex lub ChatGPT; ogłoszenie nie podaje ceny ani pomiarów specyficznych dla Warp. 🔗 źródło
- Wycofanie grok-voice-transcribe-1.0 — SpaceXAI wycofał 2 października poprzednią wersję swojego modelu transkrypcji dostępnego przez API: żądania są przekierowywane do grok-voice-transcribe-2.0, który ma tę samą cenę i według SpaceXAI jest dokładniejszy. Wycofanie zapowiedziano 18 września, nie podając daty. 🔗 źródło
- Wrzesień dla deweloperów OpenAI — Konto @OpenAIDevs podsumowuje w artykule na X wrześniowe ogłoszenia dla deweloperów, od DevDay z 29 września po GPT-6 Sol i Luna, bez nowych zapowiedzi; jedyna dodatkowa informacja dotyczy API Decisions OpenAI, dostępnego od 29 września w ograniczonej wersji zapoznawczej, które ma wkrótce stać się ogólnie dostępne, bez podanej daty. 🔗 źródło
- Dwa wdrożenia agentów ElevenLabs — Banner Health powierza ElevenAgents umawianie wizyt w ramach podstawowej opieki zdrowotnej, z możliwością przekazania sprawy człowiekowi i zachowaniem zgodności z HIPAA; ubezpieczyciel Admiral opisuje wdrożenie swoich agentów głosowych do środowiska produkcyjnego, w którym każda zmiana przechodzi od 1 % do 100 % ruchu w ciągu kilku godzin zamiast kilku tygodni. Żadna z tych firm nie publikuje liczbowych wyników. 🔗 Banner Health · 🔗 Admiral
- Kling 4.0 we wczesnym dostępie — Wpis prezentujący Kling 4.0, datowany na 30 września, precyzuje, że pełny model trafia do wczesnego dostępu przed szerszym wdrożeniem w październiku, podczas gdy Kling 4.0 Flash jest dostępny dla posiadaczy rocznych subskrypcji Ultra od 28 września; dodano format 21:9, nie podając ceny, informacji o API ani kryteriów dostępu. 🔗 źródło
- Runway Agent, Runway MCP i dots OpenAI — Changelog Runway wymienia trzy nowości bez ogłoszenia na X: Runway Agent korzysta z trybu Draft w Seedance 2.5 (szkice w 480p dopracowywane po wygenerowaniu), Ideogram 4.5 dołącza do Runway MCP w płatnych planach, a Runway jest dostępny od 1 października w dots OpenAI. Nie podano kosztów w kredytach. 🔗 źródło
- Bezstanowe tokeny GitHub Apps — Poza IA GitHub kończy wdrażanie formatu bezstanowego
ghs_APPID_JWT, rozpoczęte 27 kwietnia, dla wszystkich nowych tokenów instalacyjnych GitHub Apps: około 520 znaków zamiast 40, z niezmienionymi uprawnieniami i godzinnym czasem ważności; nagłówek testowyX-GitHub-Stateless-S2S-Tokenzostanie oznaczony jako przestarzały 30 listopada 2026. 🔗 źródło - Informacje zwrotne od ludzi na żywo w Rapidata — Rapidata opisuje funkcję Flows, która zastępuje model nagrody Flow-GRPO porównaniami parami dokonywanymi przez ludzi w czasie rzeczywistym; wpis tego dostawcy nie zawiera żadnych zmierzonych wyników treningu. 🔗 źródło
- Pomiar zależności między agentami — W eseju bez eksperymentów ani pomiarów Anouar Imel proponuje oceniać systemy wieloagentowe na podstawie zależności między agentami zamiast ich liczby, śledząc w każdej turze dokładność, różnorodność rozumowania i sprzężenie między agentami. 🔗 źródło
Co to oznacza
Kolibri pokazuje, że otwarty model może sobie dobrze radzić bez dążenia do pierwszego miejsca. Aleph Alpha sam publikuje pomiary, w których model dense Qwen3.8 27B przewyższa go niemal pod każdym względem, i podkreśla inne kryterium: obsługę wielu długich żądań na niewielu GPU, zarówno po angielsku, jak i po niemiecku, na licencji pozwalającej hostować wszystko we własnej infrastrukturze. Dla administracji publicznej lub firmy przemysłowej zobowiązanej do przestrzegania AI Act i RGPD ten kompromis może mieć większe znaczenie niż kilka punktów w benchmarku. Cohere, którego połączenie z Aleph Alpha nadal czeka na zgody regulatorów, już zapowiada dalszy ciąg.
Koszt obsługi staje się kluczowym tematem w przypadku otwartych modeli. Qwen-Image-2.1, którego otwarte wagi opublikowano 20 września, wraca w API pod nazwą Qwen-Image-2.1-Pro w cenie 0,04 dolara za obraz, niemal o połowę taniej niż poprzednia generacja, dla tych, którzy wolą nie hostować go samodzielnie. Wpis Apron przypomina natomiast, czego wymaga samodzielne hostowanie: model może nie uruchomić się z powodu braku odpowiedniego ustawienia vLLM albo zajmować 189 Gio pamięci hosta, czego nie wykaże weryfikacja ograniczona do GPU.
Meta przenosi kwestie bezpieczeństwa na etap poprzedzający wdrożenie. Ryzykowne uczenie ze wzmocnieniem wymaga teraz zweryfikowanych środowisk sandbox, logów zabezpieczonych przed modyfikacją i automatycznego zatrzymania, ponieważ model o dużych kompetencjach w cyberbezpieczeństwie może wykorzystać luki we własnym środowisku. Zapowiedziany w ramach rady dyrektorów komitet ds. IA ma ponadto niezależnie sprawdzać, czy te zasady są stosowane. Jeśli chodzi o zobowiązania podjęte w Białym Domu, które Meta, jak twierdzi, odzwierciedla, wpis oddaje tylko ich ogólny sens: wewnętrzne mechanizmy kontroli weryfikowane przez niezależny zespół w firmie oraz zewnętrznego audytora lub ewaluatora.
Wreszcie agenci integrują się z narzędziami i procesami operacyjnymi. OpenAI pozwala wybierać rozmiar sandboxa i ponownie wykorzystywać środowisko między sesjami, Devin pojawia się w Jira i naprawia problemy wykryte we własnym przeglądzie, zanim opublikuje jego wyniki, a Copilot code review można uruchomić przez API z kosztem szacowanym według poziomu wysiłku. Antigravity CLI przestrzega wskazanych przez serwer czasów oczekiwania przed ponowną próbą i uruchamia Remote Control w kontenerach: to bardziej ustawienia operacyjne niż spektakularne funkcje, ale właśnie one mają znaczenie, gdy agent działa bez przerwy.
Źródła
- Wpis Aleph Alpha o Kolibri
- Kolibri-1 na Hugging Face
- Ogłoszenie Kolibri przez @Aleph__Alpha
- Raport techniczny Kolibri (PDF)
- Wpis o Kolibri udostępniony przez @cohere
- Gratulacje od Aidana Gomeza
- Ostateczna umowa między Cohere a Aleph Alpha
- Odpowiedzialne rozwijanie modeli o dużych możliwościach (Meta)
- Ramy skalowania superinteligencji Meta
- Nowości w API Agents od @stevendcoffey
- Wpis udostępniony przez @OpenAIDevs
- Sandboxy hostowane przez OpenAI (dokumentacja OpenAI)
- Informacje o wydaniu Devin z 30 września
- Changelog Antigravity
- Dziennik modeli Model Studio
- Cennik Model Studio
- Karta qwen-image-2.1-pro w QwenCloud
- Wiem, że uruchamiasz LLMs. Czy wystartuje? (Hugging Face)
- Repozytorium Apron na GitHub
- Copilot CLI v1.0.92-3
- SDK GitHub Copilot v1.0.17-preview.3
- Copilot code review: obsługa API i nowy domyślny poziom wysiłku (GitHub)
- Nightly v0.64.0 Gemini CLI z 3 października
- Informacje o wydaniu DeepSeek Harness 0.2.1-alpha.1
- GPT-6.1 Sol w Warp (@warpdotdev)
- Informacje o wydaniach API SpaceXAI
- Wrzesień dla deweloperów OpenAI (@OpenAIDevs)
- ElevenLabs w Banner Health
- Podsumowanie webinaru Admiral (ElevenLabs)
- Przedstawiamy Kling 4.0
- Changelog Runway
- Wdrożono bezstanowe tokeny instalacyjne GitHub App (GitHub)
- Informacje zwrotne od ludzi na żywo w pętli treningowej (Rapidata)
- Gdy agenci AI stają się dla siebie źródłem dowodów (Anouar Imel)