ai-powered-markdown-translatorgemini-3.8-flash-highでフランス語から日本語に翻訳された記事。
土曜から日曜にかけての夜、MicrosoftとHugging FaceはThinkingBoxをOpenEnvに接続しました。このベンチマークは507件のビジネス業務タスクをそれぞれ20回再実行し、エージェントをデータベースの最終状態に基づいて評価するもので、試行の反復によって順位が変動します。10月4日日曜日、3名の著者がHubのExgentic組織下で公開されたOpenTelemetry形式の10,000件のエージェント実行記録「Exgentic Agent LLM Traces」を発表しました。短信では、Claude Code 2.1.289とCopilot CLI 1.0.92-4がガードレールを強化し、FeynがMetaのSAM 3を基盤としたマッティングモデルMultiMatteを発表、ChatGPT Enterpriseは10月1日よりAdmin consoleでプラグインを管理できるようになりました。
MicrosoftとHugging FaceがThinkingBoxをOpenEnvに接続:タスクあたり20回の試行で順位が変動
10月3日 — MicrosoftとHugging Faceの共同記事として公開されたブログ記事で、Tuhin Kundu氏(Microsoft)は、AIエージェントを回答内容ではなくデータベースに残された状態によって評価するベンチマーク「ThinkingBox」について解説しています。Microsoft Copilot StudioチームがTolokaと共同で構築したこのベンチマークは、決して目新しいものではありません(8月20日の研究論文、8月下旬に公開されたデータセット)。今回の新展開は、Hugging Faceがホストするオープンなエージェント環境インターフェースであるOpenEnvへの統合と、18モデルの結果の公開です。
クリーンな初期状態から507件の合成されたビジネスワークフロー(workflows)がそれぞれ20回再実行され、決定論的なジャッジがデータベースの最終状態と期待される状態を比較します。著者らによる結果は以下のとおりです。なお、OpenRouterの定価(Claude Opus 5.5についてはAnthropicの価格)に基づいて推計されたコストは比較用の指標であり、実際の請求額ではありません。
| 評価対象モデル | 全体pass@1 | 20回中20回成功したタスク(507件中) | 信頼できるタスクあたりのコスト |
|---|---|---|---|
| Claude Opus 5.5 | 67,16 % | 241 | 7,80 dollars |
| Claude Opus 5 | 66,50 % | 241 | 13,30 dollars |
| GPT-5.4 | 65,36 % | 128 | 6,80 dollars |
| GPT-5.6 Sol | 61,91 % | 82 | 9,76 dollars |
| GPT-6 Astra | 58,31 % | 231 | 7,45 dollars |
| Kimi-K3(オープンウェイト) | 57,37 % | 68 | 20,68 dollars |
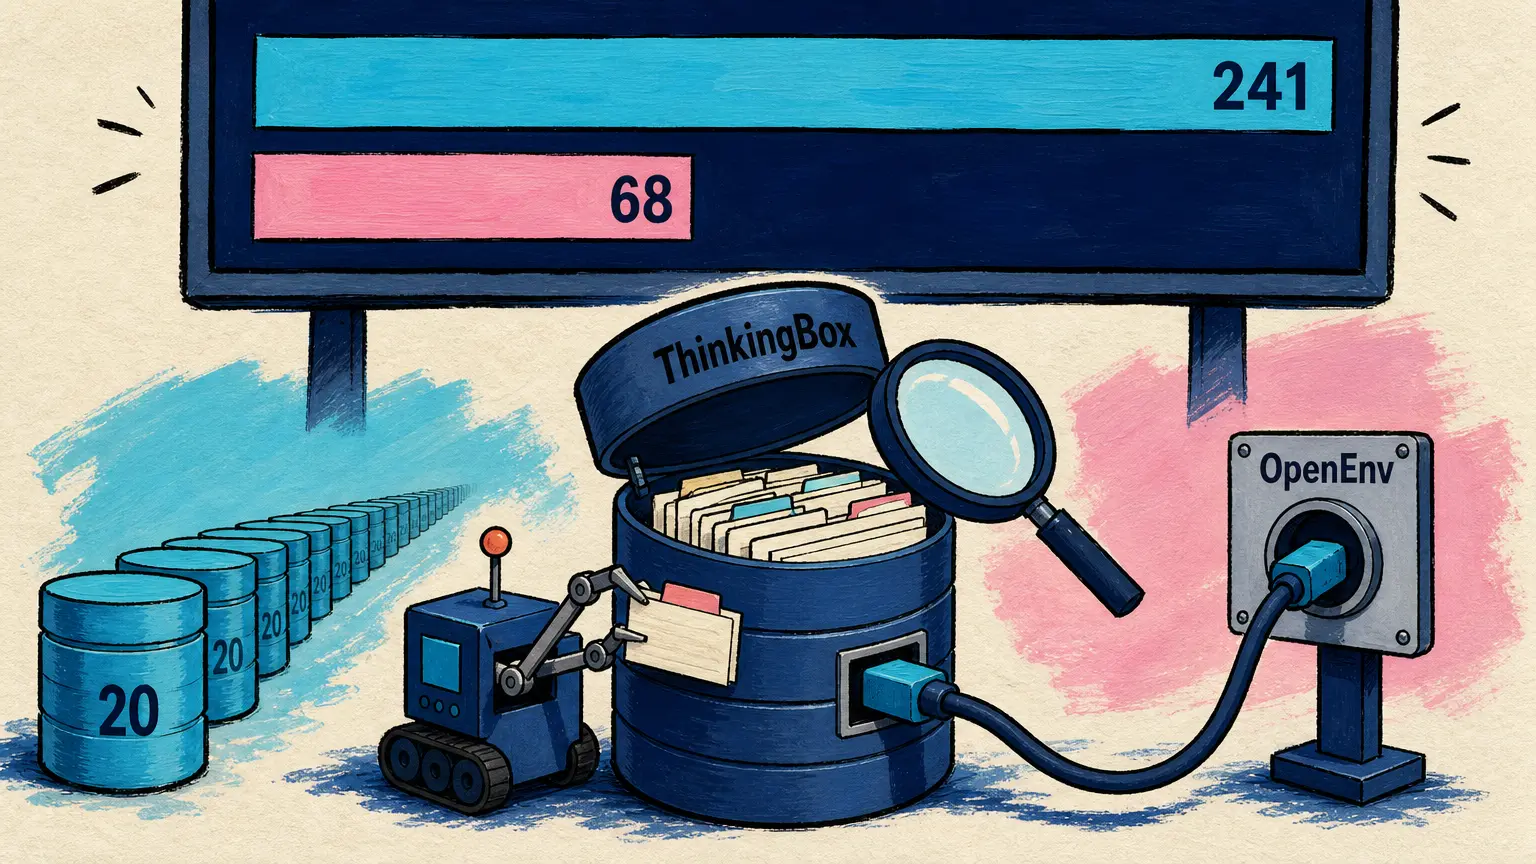
試行の反復によって順位は一変します。オープンウェイトのトップモデルであるKimi-K3は、507件のタスクのうち476件を少なくとも1回は解決したものの、20回の試行すべてで成功したのはわずか68件にとどまりました。これに対し、Claude Opus 5およびClaude Opus 5.5はともに241件でした。チームによると、失敗の約5分の4は推論ではなくツールの使用に起因しています。コードはMITライセンス、データはCDLA-Permissive-2.0で提供されています。
A trajectory is a claim. Database state is the evidence. Repetition is the trust test.
🇯🇵 軌跡は主張にすぎない。データベースの状態こそが証拠である。反復こそが信頼性の試金石である。 — MicrosoftとHugging Faceのブログ記事
🔗 ThinkingBox-Benchデータセット · OpenEnv内のThinkingBox
Exgentic Agent LLM Traces:OpenTelemetry形式で保存された10,000件のエージェント実行記録
10月4日 — Hugging Faceのコミュニティブログにおいて、Lena Dankin氏、Elron Bandel氏、Michal Shmueli-Scheuer氏が、HubのExgentic組織下で公開されたデータセット「Exgentic Agent LLM Traces」を発表しました。各実行のスコアとコストとともに、OpenTelemetryのGenAI規約に従って保存された10,000件のエージェント実行記録と242,000回のモデル呼び出しが含まれています。
これらの実行は6つのベンチマーク(SWE-bench、BrowseComp Plus、AppWorld、およびτ²-benchの3つのバリアント)と最大5種類のエージェント設計を網羅しています。1回の実行あたり、Claude Opus 4.5は平均240万トークンを消費したのに対し、GPT-5.2は552,000トークンでした。
2つの注意点があります。評価対象の5つのモデルが旧世代であること(DeepSeek-V3.2、Kimi-K2.5、GPT-5.2、Claude Opus 4.5、Gemini 3 Pro)、そして記事中では当日のリリースとして紹介されているものの、リポジトリ自体は6月10日に作成されており、カード内にライセンスが明記されていない点です。
🔗 ブログ記事 · Hugging Face上のデータセット
短信
- Claude Code 2.1.289 — 27項目の更新を含むこのバージョンでは、denyおよびaskの権限ルールが適用されない4件のケースが修正されました。また、ユーザーがインストールしたプラグインが管理対象MCPサーバーの接続ツールの説明を上書きできなくなり、その他18項目はMODやプラグインに関する修正となっています。🔗 出典
- Copilot CLI 1.0.92-4およびCopilot SDK 1.0.17-preview.4 — プレビュー版のCLI(最新の安定版:1.0.91)には、設定の一覧表示、読み取り、設定、削除を行うサブコマンド
copilot configが追加され、明示的に設定されていない限り、環境のGITHUB_TOKENをサンドボックスのシェルに渡さなくなりました。SDKには、サブエージェントの最初のプロンプトを補強し、その応答を検査または置換するためのフックOnSubagentStartおよびOnSubagentStopが導入されています。🔗 CLI · 🔗 SDK - FeynのMultiMatte — このマッティング(切り抜き)モデルはテキストによる誘導が可能です。残したい対象の名前を指定すると、モデルがそれ以外を除去し、髪の毛やぼやけた境界をより高精度に表現するアルファマット(alpha matte)を生成します。MetaのSAM 3をベースに構築され、LoRAアダプターでファインチューニングされたこのモデルは、著者らによるとDIS-VDにおけるS-measureで0.901を達成(SAM 3は0.667)。カードによるとApache 2.0ライセンスで提供されているウェイトは、8月20日から公開されています。🔗 出典
- Admin consoleでのChatGPT Enterpriseプラグイン管理 — 10月1日、EnterpriseおよびEduのリリースノートにて、ChatGPT Enterpriseワークスペースのオーナーおよび管理者が、Admin consoleの「Plugins」および「Marketplaces」ページからプラグインやそのマーケットプレイス(marketplaces)を管理できるようになると発表されました。アプリケーションは既存の権限のまま、引き続き「Workspace settings > Apps」で管理されます。🔗 出典
これが意味するもの
ThinkingBoxは、エージェントに対して投げかける問いを変革します。それは「タスクを実行できるか」ではなく、「毎回確実に実行できるか」という点です。1回の試行では、Kimi-K3はGPT-6 Astraとの差が1ポイント未満ですが、20回の試行となると、全回成功したのはGPT-6 Astraの231件に対してわずか68件にとどまります。データベースを変更する操作をエージェントに任せる立場にとって、真に重要なのはこの後者の数値であり、このベンチマークはエージェントが実行したと主張する内容ではなく、データベースの最終状態に基づいてそれを測定します。
コストに関しても同様の論理が成り立ちます。すべての試行で成功したタスクのみに絞って換算すると、最も安価なのはGPT-5.4(信頼できるタスクあたり6.80ドル)となり、1回の成功試行あたりでは最も安価(0.127ドル)だったGPT-5.6 Solではありません。一方、Kimi-K3は信頼できるタスクあたり20.68ドルとなり、GPT-5.4の3倍以上のコストがかかります。著者らが喚起しているとおり、これらの金額はあくまで比較用の指標であり、実際の請求額ではない点に留意する必要があります。
Exgentic Agent LLM Tracesの著者らも、同様の限界意識から出発しています。従来のベンチマークが実行結果を1つのスコアに縮約してしまうのに対し、トレースは選択されたツール、コンテキストの肥大化、エラーからの回復プロセスを如実に示します。標準化されたフォーマットですべての呼び出しを保存することで、リファレンスと比較しながらエージェントをデバッグしたり、別のモデルで特定のステップを再実行したり、実際のエージェント負荷の下で推論インフラをテストしたりすることが可能になると著者らは考えています。すでにKubernetes SIGのベンチマークツールであるinference-perfを用いて実践しているチームもあり、その結果は後日発表される予定です。
情報源
- ThinkingBoxに関するMicrosoftとHugging Faceの共同ブログ記事
- Hugging Face上のThinkingBox-Benchデータセット
- OpenEnvドキュメント内のThinkingBox環境
- GitHub上のThinkingBoxコード
- GitHub上のThinkingBoxデータ
- Exgentic Agent LLM Traces(Hugging Faceブログ)
- Exgentic/agent-llm-traces-v2データセット
- Claude Code v2.1.289
- Claude Codeの変更履歴
- Copilot CLI v1.0.92-4
- GitHub Copilot SDK v1.0.17-preview.4
- MultiMatte(Feynのブログ記事)
- Hugging Face上のfeyninc/multimatteモデル
- ChatGPT EnterpriseおよびEduのリリースノート