ai-powered-markdown-translator使用 gemini-3.8-flash-high 从法语翻译为中文的文章。
在周六至周日的夜间,微软与 Hugging Face 将 ThinkingBox 接入了 OpenEnv:该基准测试将 507 项业务任务各自重放 20 次,并根据数据库的最终状态来评估 Agent,而重复测试改变了排名。10 月 4 日周日,三位作者介绍了 Exgentic Agent LLM Traces——在 Hub 的 Exgentic 组织下发布的 10 000 条 OpenTelemetry 格式的 Agent 执行记录。快讯方面,Claude Code 2.1.289 和 Copilot CLI 1.0.92-4 增强了安全护栏,Feyn 推出了基于 Meta SAM 3 构建的抠图模型 MultiMatte,而 ChatGPT Enterprise 自 10 月 1 日起可在 Admin console 中管理其插件。
微软与 Hugging Face 将 ThinkingBox 接入 OpenEnv:每项任务 20 次测试,排名发生变动
10 月 3 日 — 在一篇由微软与 Hugging Face 联合发布的博文中,Tuhin Kundu(微软)介绍了 ThinkingBox。这是一个根据 AI Agent 在数据库中留下的状态而非其回答来评估 Agent 的基准测试。该基准由 Microsoft Copilot Studio 团队与 Toloka 共同构建,并非全新产物(研究论文发表于 8 月 20 日,数据集于 8 月底发布):其新颖之处在于接入了由 Hugging Face 托管的开放 Agent 环境接口 OpenEnv,并公布了 18 个模型的结果。
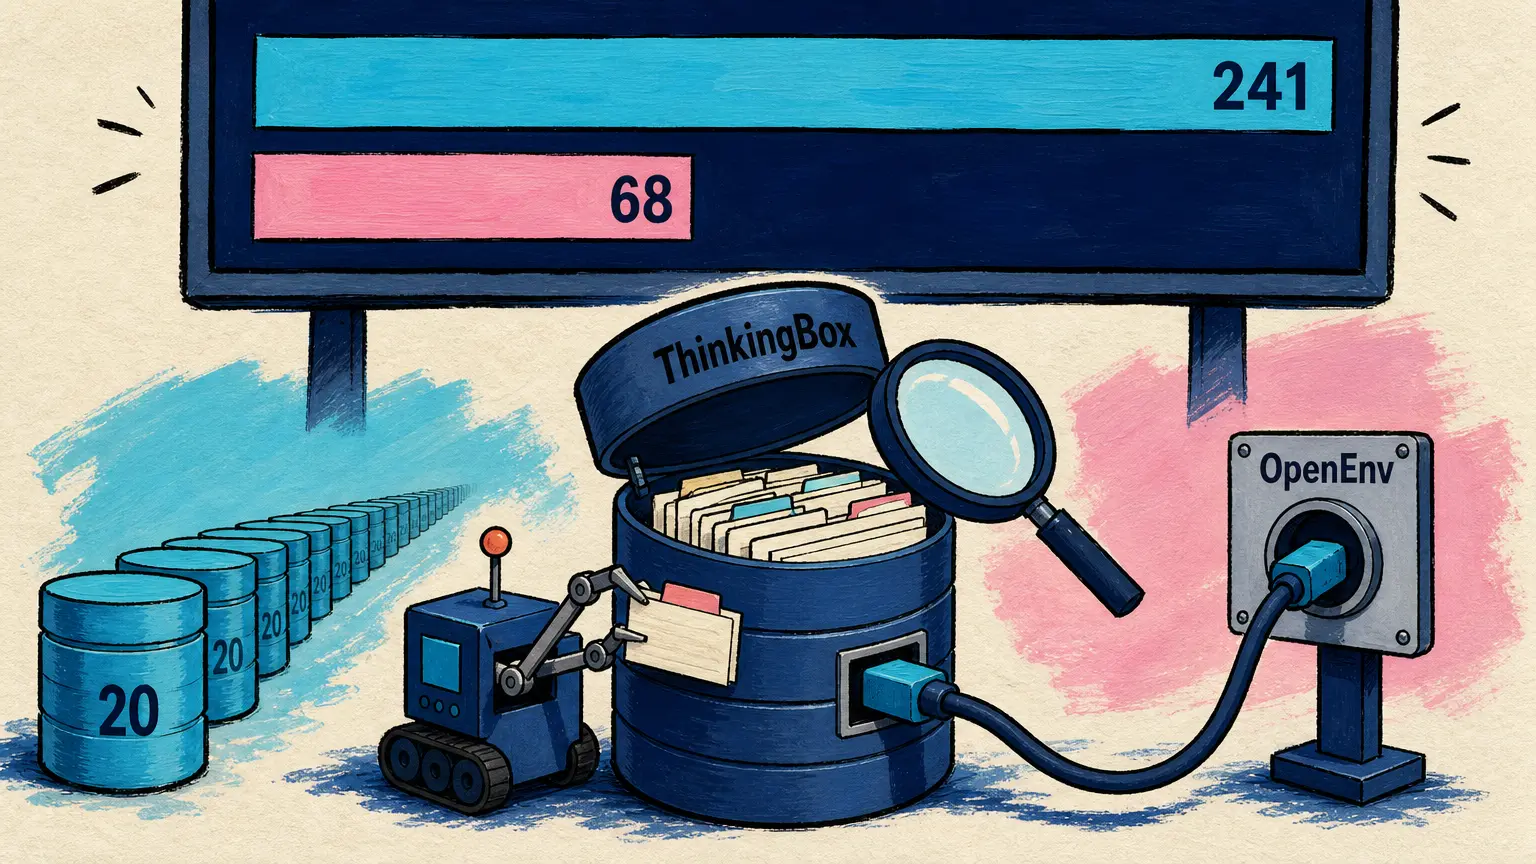
其 507 个合成业务工作流(workflows)各自从干净状态开始重放 20 次,确定性裁判会将数据库的最终状态与预期状态进行比对。以下为作者给出的结果;其成本根据 OpenRouter 的标价(Claude Opus 5.5 采用 Anthropic 的价格)进行估算,仅供对比参考,并非实际账单:
| 评估模型 | 总体 pass@1 | 20 次测试全部成功的任务数(共 507 项) | 每项可靠任务的成本 |
|---|---|---|---|
| Claude Opus 5.5 | 67,16 % | 241 | 7,80 美元 |
| Claude Opus 5 | 66,50 % | 241 | 13,30 美元 |
| GPT-5.4 | 65,36 % | 128 | 6,80 美元 |
| GPT-5.6 Sol | 61,91 % | 82 | 9,76 美元 |
| GPT-6 Astra | 58,31 % | 231 | 7,45 美元 |
| Kimi-K3 (开源权重) | 57,37 % | 68 | 20,68 美元 |
重复测试改变了排名:作为表现最佳的开源权重模型,Kimi-K3 在 507 项任务中至少成功解决过 476 项,但在全部 20 次测试中每次都能成功的仅有 68 项;相比之下,Claude Opus 5 和 Claude Opus 5.5 均达到了 241 项。据该团队称,大约五分之四的失败源于工具的使用而非推理问题。代码采用 MIT 许可证,数据采用 CDLA-Permissive-2.0 许可证。
A trajectory is a claim. Database state is the evidence. Repetition is the trust test.
🇨🇳 轨迹是一种主张。数据库的状态才是证明。重复则是信任的检验。 — 微软与 Hugging Face 的博文
🔗 ThinkingBox-Bench 数据集 · OpenEnv 中的 ThinkingBox
Exgentic Agent LLM Traces:以 OpenTelemetry 格式保留的 10 000 条 Agent 执行记录
10 月 4 日 — 在 Hugging Face 社区博客上,Lena Dankin、Elron Bandel 和 Michal Shmueli-Scheuer 介绍了 Exgentic Agent LLM Traces,这是在 Hub 的 Exgentic 组织下发布的数据集:包含 10 000 条 Agent 执行记录和 242 000 次模型调用,每条记录均遵循 OpenTelemetry 的 GenAI 规范进行保存,并附有每次执行的得分与成本。
这些执行记录涵盖了六个基准测试(SWE-bench、BrowseComp Plus、AppWorld 以及 τ²-bench 的三种变体)和多达五种 Agent 架构设计。平均而言,Claude Opus 4.5 每次执行消耗 240 万个 token,而 GPT-5.2 为 552 000 个。
存在两点保留意见:评估的五款模型均属于上一代(DeepSeek-V3.2、Kimi-K2.5、GPT-5.2、Claude Opus 4.5 和 Gemini 3 Pro),且该博文将一个创建于 6 月 10 日且卡片中未声明许可证的仓库描述为当日发布。
🔗 博文 · Hugging Face 上的数据集
快讯
- Claude Code 2.1.289 — 此版本包含 27 项更新,修复了 deny 和 ask 权限规则未能生效的四种情况;用户安装的插件无法再重写受管 MCP 服务器的连接工具描述,另外 18 项更新涉及 mod 和插件。🔗 来源
- Copilot CLI 1.0.92-4 与 Copilot SDK 1.0.17-preview.4 — 处于预览版的 CLI(最新稳定版为 1.0.91)新增了用于列出、读取、设置和删除配置项的子命令
copilot config,且除非显式配置,否则不再将外层的GITHUB_TOKEN传递给沙箱 shell;SDK 引入了OnSubagentStart与OnSubagentStop钩子,用于丰富子 Agent 的首个 prompt,随后检查或替换其响应。🔗 CLI · 🔗 SDK - Feyn 的 MultiMatte — 这款抠图模型由文本引导:用户指定要保留的对象,模型便会移除其余部分,并通过 Alpha 遮罩(alpha matte)更好地呈现毛发和模糊区域。该模型基于 Meta 的 SAM 3 构建,并通过 LoRA 适配器进行微调,据作者称,其在 DIS-VD 上的 S-measure 达到 0,901,而 SAM 3 仅为 0,667;根据其卡片,其权重采用 Apache 2.0 许可证,自 8 月 20 日起便已上线。🔗 来源
- ChatGPT Enterprise 插件进入 Admin console — 10 月 1 日,Enterprise 与 Edu 的版本说明宣布,ChatGPT Enterprise 工作区的所有者和管理员现在可在 Admin console 的 Plugins 和 Marketplaces 页面中管理插件及其市场(marketplaces);应用程序仍保留在 Workspace settings > Apps 中,并遵循既有权限。🔗 来源
这意味着什么
ThinkingBox 改变了对 Agent 提出的核心问题:不再是它能否完成某项任务,而是它能否每一次都能完成。单次尝试中,Kimi-K3 与 GPT-6 Astra 的差距不到 1 个百分点;而在 20 次测试中,它能够每次都成功的任务仅有 68 项,而后者达到 231 项。对于将修改数据库的操作托付给 Agent 的人来说,真正重要的是后一个数字,而该基准根据数据库的最终状态来衡量,而非 Agent 自称完成的工作。
成本同样遵循这一逻辑。仅折算到每次测试都能成功的任务上,GPT-5.4 是成本最低的(每项可靠任务 6,80 美元),而非单次成功测试成本最低(0,127 美元)的 GPT-5.6 Sol;相比之下,Kimi-K3 每项可靠任务的成本为 20,68 美元,是 GPT-5.4 的三倍多。作者提醒,这些金额仍是指标性对比,并非实际账单。
Exgentic Agent LLM Traces 的作者则指出了一个相似的局限:基准测试往往将一次执行简化为一个分数,而追踪记录则能展示所选工具、上下文的膨胀以及错误后的恢复过程。通过以标准格式保存每一次调用,他们认为这可以用来对照基准调试 Agent、用另一个模型重放某一环节,或在真实的 Agent 负载下测试推理基础设施;已有团队正在使用 Kubernetes SIG 的基准测试工具 inference-perf 进行此项尝试,其结果将在稍后公布。
来源
- 微软与 Hugging Face 关于 ThinkingBox 的联合博文
- Hugging Face 上的 ThinkingBox-Bench 数据集
- OpenEnv 文档中的 ThinkingBox 环境
- GitHub 上的 ThinkingBox 代码
- GitHub 上的 ThinkingBox 数据
- Exgentic Agent LLM Traces(Hugging Face 博客)
- Exgentic/agent-llm-traces-v2 数据集
- Claude Code v2.1.289
- Claude Code 更新日志
- Copilot CLI v1.0.92-4
- GitHub Copilot SDK v1.0.17-preview.4
- MultiMatte(Feyn 博文)
- Hugging Face 上的 feyninc/multimatte 模型
- ChatGPT Enterprise 与 Edu 版本说明