ai-powered-markdown-translatorArtykuł przetłumaczony z fr na pl za pomocą gemini-3.8-flash-high.
W nocy z soboty na niedzielę Microsoft i Hugging Face podłączyli ThinkingBox do OpenEnv: ten benchmark odtwarza 507 zadań biznesowych 20 razy każde i ocenia agentów na podstawie ostatecznego stanu bazy danych, a powtarzalność zmienia w nim ranking. W niedzielę 4 października troje autorów opisało Exgentic Agent LLM Traces – 10 000 wykonań agentów w formacie OpenTelemetry, opublikowanych w ramach organizacji Exgentic na Hubie. W skrócie: Claude Code 2.1.289 i Copilot CLI 1.0.92-4 wzmacniają zabezpieczenia, Feyn prezentuje MultiMatte – model do szparowania oparty na SAM 3 od Mety, a ChatGPT Enterprise od 1 października zarządza swoimi wtyczkami w konsoli Admin console.
Microsoft i Hugging Face podłączają ThinkingBox do OpenEnv: 20 prób na zadanie i ranking ulega zmianie
3 października — We wpisie przedstawionym jako wspólna publikacja Microsoftu i Hugging Face, Tuhin Kundu (Microsoft) opisuje ThinkingBox – benchmark oceniający agentów AI na podstawie tego, co pozostawiają w bazie danych, a nie na podstawie ich odpowiedzi. Stworzony przez zespół Microsoft Copilot Studio we współpracy z Toloką, nie jest zupełną nowością (artykuł badawczy z 20 sierpnia, zbiór danych opublikowany pod koniec sierpnia): nowością jest jego integracja z OpenEnv, otwartym interfejsem środowisk dla agentów hostowanym przez Hugging Face, oraz publikacja wyników 18 modeli.
Jego 507 syntetycznych biznesowych przepływów pracy (workflows) jest odtwarzanych 20 razy każdy z czystego stanu, a deterministyczni sędziowie porównują stan końcowy bazy z oczekiwanym. Wyniki według autorów; ich koszty, oszacowane na podstawie cenników katalogowych OpenRouter (oraz Anthropic w przypadku Claude Opus 5.5), stanowią wskaźnik porównawczy, a nie rzeczywisty rachunek:
| Oceniany model | Ogólny pass@1 | Zadania zaliczone 20 razy na 20 (na 507) | Koszt na niezawodne zadanie |
|---|---|---|---|
| Claude Opus 5.5 | 67,16 % | 241 | 7,80 dolara |
| Claude Opus 5 | 66,50 % | 241 | 13,30 dolara |
| GPT-5.4 | 65,36 % | 128 | 6,80 dolara |
| GPT-5.6 Sol | 61,91 % | 82 | 9,76 dolara |
| GPT-6 Astra | 58,31 % | 231 | 7,45 dolara |
| Kimi-K3 (otwarte wagi) | 57,37 % | 68 | 20,68 dolara |
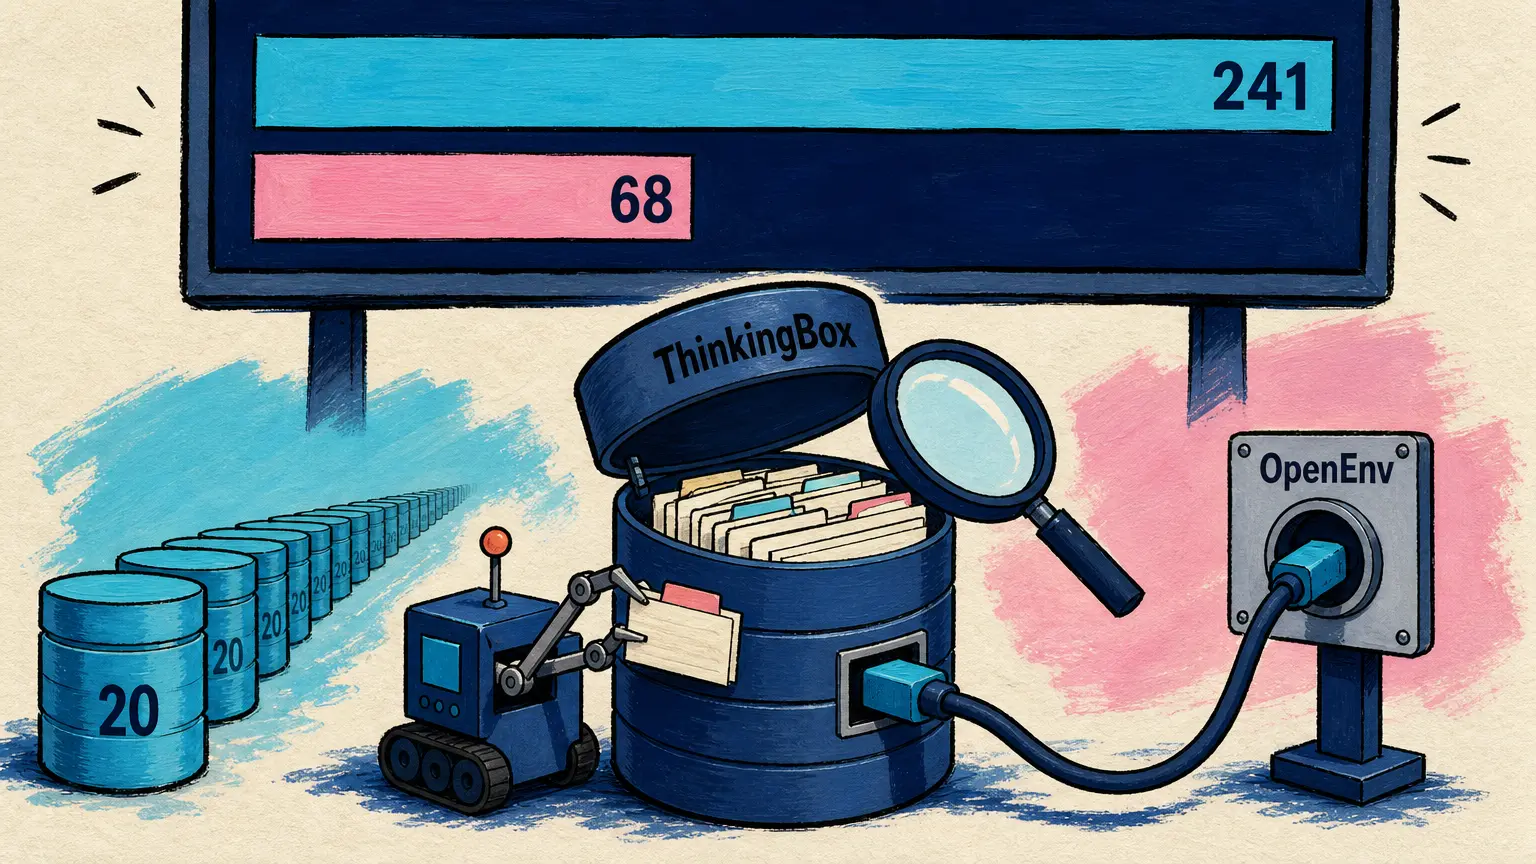
Powtarzalność zmienia ranking: Kimi-K3, najlepszy model o otwartych wagach, rozwiązuje 476 z 507 zadań przynajmniej raz, ale tylko 68 przy każdej z 20 prób, w porównaniu z 241 zarówno w przypadku Claude Opus 5, jak i Claude Opus 5.5. Według zespołu około cztery na pięć niepowodzeń wynika z użycia narzędzi, a nie z samego wnioskowania. Kod jest udostępniony na licencji MIT, a dane na licencji CDLA-Permissive-2.0.
A trajectory is a claim. Database state is the evidence. Repetition is the trust test.
🇵🇱 Trajektoria to twierdzenie. Stan bazy danych jest dowodem. Powtarzalność to test zaufania. — Wpis Microsoftu i Hugging Face
🔗 Zbiór danych ThinkingBox-Bench · ThinkingBox w OpenEnv
Exgentic Agent LLM Traces: 10 000 wykonań agentów zachowanych w formacie OpenTelemetry
4 października — Na blogu społeczności Hugging Face Lena Dankin, Elron Bandel i Michal Shmueli-Scheuer prezentują Exgentic Agent LLM Traces – zbiór danych opublikowany w ramach organizacji Exgentic na Hubie: 10 000 wykonań agentów i 242 000 wywołań modeli, z których każde zapisano zgodnie z konwencjami GenAI OpenTelemetry, wraz z wynikiem i kosztem każdego wykonania.
Wykonania te obejmują sześć benchmarków (SWE-bench, BrowseComp Plus, AppWorld oraz trzy warianty τ²-bench) i do pięciu architektur agentów. Średnio Claude Opus 4.5 zużywa 2,4 miliona tokenów na wykonanie, w porównaniu z 552 000 w przypadku GPT-5.2.
Dwa zastrzeżenia: pięć modeli pochodzi z poprzednich generacji (DeepSeek-V3.2, Kimi-K2.5, GPT-5.2, Claude Opus 4.5 i Gemini 3 Pro), a wpis przedstawia jako dzisiejszą premierę repozytorium utworzone 10 czerwca, bez zadeklarowanej licencji na swojej karcie.
🔗 Wpis · Zbiór danych na Hugging Face
W skrócie
- Claude Code 2.1.289 — To wydanie zawierające 27 pozycji naprawia cztery przypadki, w których reguły uprawnień deny i ask nie były stosowane; wtyczka zainstalowana przez użytkownika nie może już nadpisywać opisów narzędzi połączeniowych zarządzanego serwera MCP, a 18 innych pozycji dotyczy modów i wtyczek. 🔗 źródło
- Copilot CLI 1.0.92-4 i SDK Copilot 1.0.17-preview.4 — CLI, w wersji zapoznawczej (ostatnia stabilna: 1.0.91), dodaje podpolecenia
copilot configdo wyświetlania, odczytywania, ustawiania i usuwania ustawienia oraz nie przekazuje już bieżącegoGITHUB_TOKENdo powłok piaskownicy, chyba że zostało to jawnie skonfigurowane; SDK otrzymuje hookiOnSubagentStartiOnSubagentStop, aby wzbogacić pierwszy prompt podagenta, a następnie sprawdzić lub zastąpić jego odpowiedź. 🔗 CLI · 🔗 SDK - MultiMatte od Feyn — Ten model do szparowania jest kierowany tekstem: wskazuje się obiekt do zachowania, a model usuwa resztę, tworząc maskę alfa (alpha matte), która lepiej oddaje włosy i obszary rozmyte. Zbudowany na bazie SAM 3 od Mety, dostrojony za pomocą adaptera LoRA, osiąga według autorów wskaźnik S-measure na poziomie 0,901 w teście DIS-VD, w porównaniu z 0,667 dla SAM 3; jego wagi, na licencji Apache 2.0 według ich karty, są dostępne online od 20 sierpnia. 🔗 źródło
- Wtyczki ChatGPT Enterprise w konsoli Admin console — 1 października w informacjach o wydaniu dla wersji Enterprise i Edu ogłoszono, że właściciele i administratorzy przestrzeni ChatGPT Enterprise zarządzają teraz wtyczkami oraz ich rynkami (marketplaces) w konsoli Admin console na stronach Plugins i Marketplaces; aplikacje pozostają w Workspace settings > Apps z dotychczasowymi uprawnieniami. 🔗 źródło
Co to oznacza
ThinkingBox zmienia pytanie zadawane agentowi: nie chodzi już o to, czy potrafi wykonać zadanie, lecz czy wykonuje je za każdym razem. W pojedynczej próbie Kimi-K3 traci mniej niż punkt do GPT-6 Astra; w dwudziestu zalicza bezbłędnie za każdym razem zaledwie 68 zadań, w porównaniu z 231. Dla każdego, kto powierza agentowi operacje modyfikujące bazę danych, liczy się właśnie ta druga liczba, a benchmark mierzy ją na podstawie końcowego stanu bazy, a nie tego, co agent twierdzi, że zrobił.
Koszt podąża za tą samą logiką. W przeliczeniu wyłącznie na zadania zakończone sukcesem przy każdej próbie wskazuje GPT-5.4 jako najtańszy (6,80 dolara na niezawodne zadanie), a nie GPT-5.6 Sol, będący przecież najtańszym w przeliczeniu na udaną próbę (0,127 dolara); z kolei Kimi-K3 kosztuje 20,68 dolara na niezawodne zadanie – trzykrotnie więcej niż GPT-5.4. Kwoty te pozostają, jak przypominają autorzy, wskaźnikiem porównawczym, a nie rachunkiem.
Autorzy Exgentic Agent LLM Traces wychodzą z podobnego ograniczenia: benchmark sprowadza wykonanie do wyniku punktowego, podczas gdy ślad ujawnia wybrane narzędzia, rozrost kontekstu oraz wychodzenie z błędów. Dzięki zachowaniu każdego wywołania w standardowym formacie widzą w tym narzędzie do debugowania agenta w odniesieniu do wzorca, odtwarzania kroku z innym modelem lub testowania infrastruktury inferencyjnej pod realnym obciążeniem agentami; jeden z zespołów robi to już z użyciem inference-perf, narzędzia benchmarkowego Kubernetes SIG, a jego wyniki zostaną ogłoszone w późniejszym terminie.
Źródła
- Wspólny wpis Microsoftu i Hugging Face o ThinkingBox
- Zbiór danych ThinkingBox-Bench na Hugging Face
- Środowisko ThinkingBox w dokumentacji OpenEnv
- Kod ThinkingBox na GitHubie
- Dane ThinkingBox na GitHubie
- Exgentic Agent LLM Traces (blog Hugging Face)
- Zbiór danych Exgentic/agent-llm-traces-v2
- Claude Code v2.1.289
- Dziennik zmian Claude Code
- Copilot CLI v1.0.92-4
- SDK GitHub Copilot v1.0.17-preview.4
- MultiMatte (wpis Feyn)
- Model feyninc/multimatte na Hugging Face
- Informacje o wydaniu ChatGPT Enterprise i Edu