ai-powered-markdown-translatorArticol tradus din fr în ro cu gemini-3.8-flash-high.
În noaptea de sâmbătă spre duminică, Microsoft și Hugging Face au conectat ThinkingBox la OpenEnv: acest benchmark rejoacă 507 sarcini de business de câte 20 de ori și evaluează agenții după starea finală a bazei de date, iar repetiția modifică aici clasamentul. Duminică, 4 octombrie, trei autori descriu Exgentic Agent LLM Traces, 10 000 de execuții de agenți în format OpenTelemetry publicate sub organizația Exgentic din Hub. Pe scurt, Claude Code 2.1.289 și Copilot CLI 1.0.92-4 își consolidează măsurile de siguranță, Feyn prezintă MultiMatte, un model de decupare bazat pe SAM 3 de la Meta, iar ChatGPT Enterprise își gestionează pluginurile în Admin console de la 1 octombrie.
Microsoft și Hugging Face conectează ThinkingBox la OpenEnv: 20 de încercări per sarcină, iar clasamentul se schimbă
3 octombrie — Într-un articol prezentat ca fiind comun între Microsoft și Hugging Face, Tuhin Kundu (Microsoft) descrie ThinkingBox, un benchmark care evaluează agenții AI după ceea ce lasă în baza de date, nu după răspunsurile lor. Construit de echipa Microsoft Copilot Studio împreună cu Toloka, acesta nu este nou (articol de cercetare din 20 august, set de date publicat la sfârșitul lunii august): noutatea constă în integrarea sa în OpenEnv, interfața deschisă de medii pentru agenți găzduită de Hugging Face, și în publicarea rezultatelor pentru 18 modele.
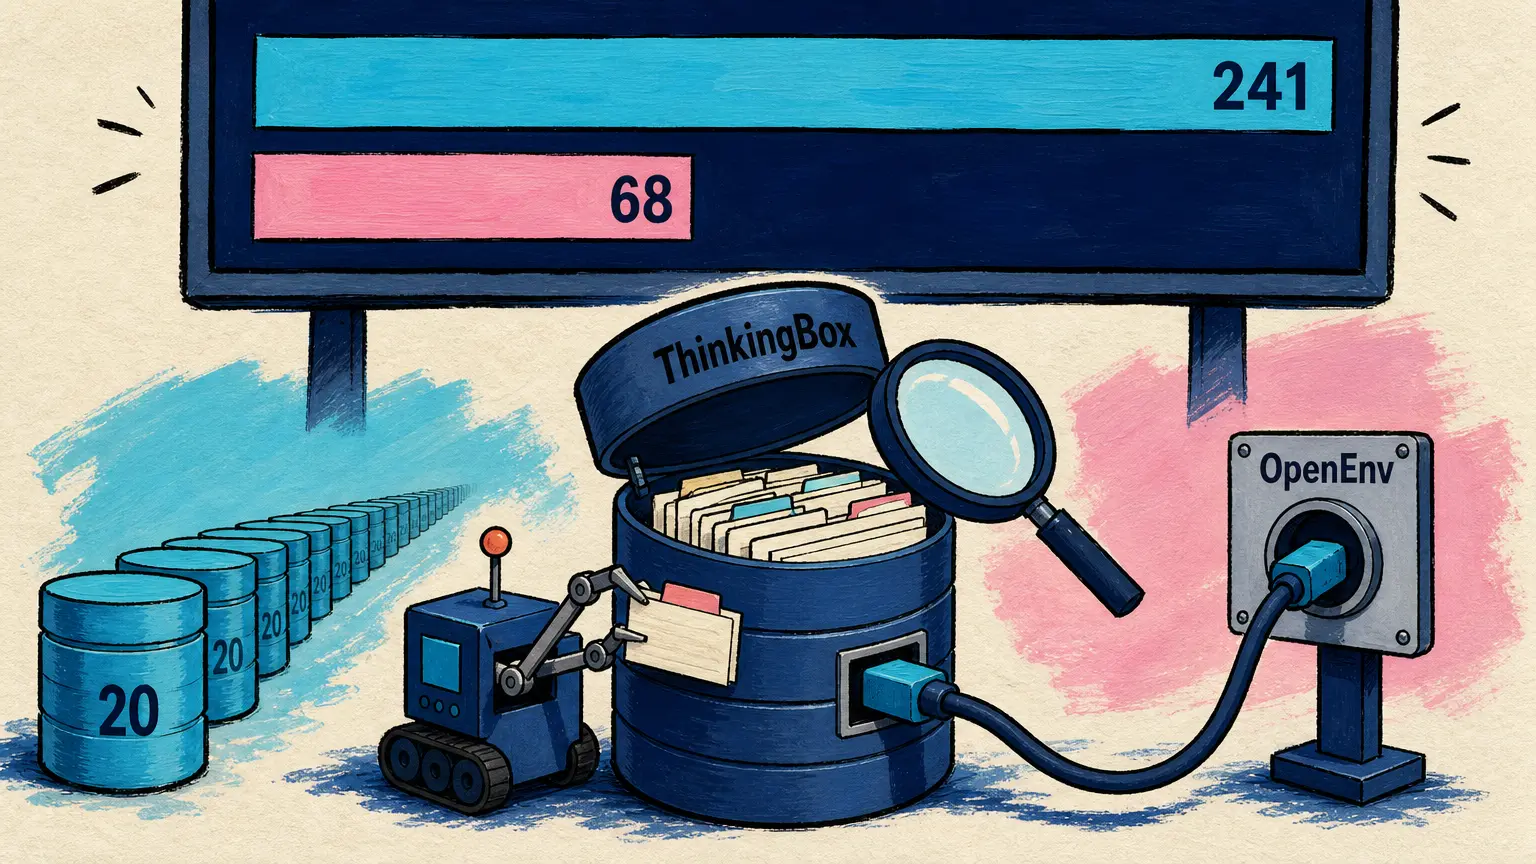
Cele 507 fluxuri de lucru (workflows) de business sintetice sunt rejucate de câte 20 de ori fiecare pornind de la o stare curată, iar evaluatori determiniști compară starea finală a bazei de date cu cea așteptată. Rezultate conform autorilor; costurile lor, estimate pe baza tarifelor de listă de pe OpenRouter (cele de la Anthropic pentru Claude Opus 5.5), reprezintă un indicator comparativ, nu o factură:
| Model evaluat | pass@1 global | Sarcini reușite de 20 de ori din 20 (din 507) | Cost per sarcină fiabilă |
|---|---|---|---|
| Claude Opus 5.5 | 67,16 % | 241 | 7,80 dolari |
| Claude Opus 5 | 66,50 % | 241 | 13,30 dolari |
| GPT-5.4 | 65,36 % | 128 | 6,80 dolari |
| GPT-5.6 Sol | 61,91 % | 82 | 9,76 dolari |
| GPT-6 Astra | 58,31 % | 231 | 7,45 dolari |
| Kimi-K3 (ponderi deschise) | 57,37 % | 68 | 20,68 dolari |
Repetiția schimbă clasamentul: Kimi-K3, cel mai bun model cu ponderi deschise, rezolvă 476 dintre cele 507 sarcini cel puțin o dată, dar numai 68 la fiecare dintre cele 20 de încercări, față de 241 atât pentru Claude Opus 5, cât și pentru Claude Opus 5.5. Potrivit echipei, aproximativ patru eșecuri din cinci țin de utilizarea instrumentelor, mai degrabă decât de raționament. Codul este sub licență MIT, iar datele sub CDLA-Permissive-2.0.
A trajectory is a claim. Database state is the evidence. Repetition is the trust test.
🇷🇴 O traiectorie este o afirmație. Starea bazei de date este dovada. Repetiția este testul de încredere. — Articol de Microsoft și Hugging Face
🔗 Set de date ThinkingBox-Bench · ThinkingBox în OpenEnv
Exgentic Agent LLM Traces: 10 000 de execuții de agenți păstrate în format OpenTelemetry
4 octombrie — Pe blogul comunității Hugging Face, Lena Dankin, Elron Bandel și Michal Shmueli-Scheuer prezintă Exgentic Agent LLM Traces, un set de date publicat sub organizația Exgentic din Hub: 10 000 de execuții de agenți și 242 000 de apeluri de model, fiecare păstrat conform convențiilor GenAI ale OpenTelemetry, cu scorul și costul fiecărei execuții.
Aceste execuții acoperă șase benchmarkuri (SWE-bench, BrowseComp Plus, AppWorld și trei variante de τ²-bench) și până la cinci concepții de agenți. În medie, Claude Opus 4.5 consumă 2,4 milioane de tokenuri per execuție, față de 552 000 pentru GPT-5.2.
Două rezerve: cele cinci modele sunt din generații anterioare (DeepSeek-V3.2, Kimi-K2.5, GPT-5.2, Claude Opus 4.5 și Gemini 3 Pro), iar articolul prezintă ca pe o lansare de astăzi un depozit creat pe 10 iunie, fără licență declarată în fișa sa.
🔗 Articol · Set de date pe Hugging Face
Pe scurt
- Claude Code 2.1.289 — Această versiune cu 27 de modificări corectează patru cazuri în care regulile de permisiune deny și ask nu se aplicau; un plugin instalat de utilizator nu mai poate suprascrie descrierile instrumentelor de conectare ale unui server MCP gestionat, iar alte 18 modificări vizează modurile și pluginurile. 🔗 sursă
- Copilot CLI 1.0.92-4 și SDK Copilot 1.0.17-preview.4 — CLI-ul, aflat în versiune preliminară (ultima versiune stabilă: 1.0.91), adaugă subcomenzile
copilot configpentru a lista, citi, defini și șterge o setare și nu mai transmite variabila de mediuGITHUB_TOKENcătre shell-urile din sandbox, cu excepția cazului în care este configurat explicit; SDK-ul primește hook-urileOnSubagentStartșiOnSubagentStop, pentru a îmbogăți primul prompt al unui sub-agent, apoi pentru a inspecta sau înlocui răspunsul acestuia. 🔗 CLI · 🔗 SDK - MultiMatte de la Feyn — Acest model de decupare este ghidat de text: se indică obiectul de păstrat, modelul elimină restul, cu o mască alfa (alpha matte) care redă mai bine părul și zonele neclare. Construit pe SAM 3 de la Meta, ajustat fin printr-un adaptor LoRA, atinge conform autorilor un scor S-measure de 0,901 pe DIS-VD, față de 0,667 pentru SAM 3; ponderile sale, sub licență Apache 2.0 conform fișei lor, sunt online din 20 august. 🔗 sursă
- Pluginurile ChatGPT Enterprise în Admin console — Pe 1 octombrie, notele de lansare pentru Enterprise și Edu au anunțat că proprietarii și administratorii de spații de lucru ChatGPT Enterprise gestionează acum pluginurile și piețele de aplicații ale acestora (marketplaces) în Admin console, pe paginile Plugins și Marketplaces; aplicațiile rămân în Workspace settings > Apps, cu permisiunile existente. 🔗 sursă
Ce înseamnă acest lucru
ThinkingBox schimbă întrebarea adresată unui agent: nu dacă știe să îndeplinească o sarcină, ci dacă o îndeplinește de fiecare dată. La o singură încercare, Kimi-K3 se află la mai puțin de un punct de GPT-6 Astra; la douăzeci, reușește de fiecare dată doar 68 de sarcini, față de 231. Pentru oricine încredințează unui agent operațiuni care modifică o bază de date, această a doua cifră contează, iar benchmarkul o măsoară pe baza stării finale a bazei de date, nu pe baza a ceea ce agentul susține că a făcut.
Costul urmează aceeași logică. Raportat doar la sarcinile reușite la fiecare încercare, acesta indică GPT-5.4 drept cel mai ieftin (6,80 dolari per sarcină fiabilă), și nu GPT-5.6 Sol, deși acesta este cel mai ieftin per încercare reușită (0,127 dolari); Kimi-K3 ajunge, la rândul său, la 20,68 dolari per sarcină fiabilă, de trei ori mai mult decât GPT-5.4. Aceste sume rămân, amintesc autorii, un indicator comparativ și nu o factură.
Autorii Exgentic Agent LLM Traces pornesc de la o limitare similară: un benchmark reduce o execuție la un scor, în timp ce urma arată instrumentele alese, creșterea contextului și reluările după erori. Păstrând fiecare apel într-un format standard, aceștia văd în acest lucru un mijloc de a depana un agent în raport cu o referință, de a rejuca un pas cu un alt model sau de a testa o infrastructură de inferență sub o sarcină reală de agenți; o echipă face deja acest lucru cu inference-perf, instrumentul de benchmark al SIG Kubernetes, iar rezultatele sale sunt anunțate pentru mai târziu.
Surse
- Articol comun al Microsoft și Hugging Face despre ThinkingBox
- Set de date ThinkingBox-Bench pe Hugging Face
- Mediul ThinkingBox în documentația OpenEnv
- Codul ThinkingBox pe GitHub
- Datele ThinkingBox pe GitHub
- Exgentic Agent LLM Traces (blogul Hugging Face)
- Set de date Exgentic/agent-llm-traces-v2
- Claude Code v2.1.289
- Changelog Claude Code
- Copilot CLI v1.0.92-4
- SDK GitHub Copilot v1.0.17-preview.4
- MultiMatte (articol Feyn)
- Modelul feyninc/multimatte pe Hugging Face
- Note de lansare ChatGPT Enterprise și Edu