ai-powered-markdown-translatorArticolo tradotto dal fr all’it con gemini-3.8-flash-high.
Nella notte tra sabato e domenica, Microsoft e Hugging Face hanno collegato ThinkingBox a OpenEnv: questo benchmark riesegue 507 attività aziendali 20 volte ciascuna e valuta gli agenti sullo stato finale del database, e la ripetizione ne cambia la classifica. Domenica 4 ottobre, tre autori descrivono Exgentic Agent LLM Traces, 10 000 esecuzioni di agenti in formato OpenTelemetry pubblicate sotto l’organizzazione Exgentic dell’Hub. In breve, Claude Code 2.1.289 e Copilot CLI 1.0.92-4 rafforzano i propri sistemi di sicurezza, Feyn presenta MultiMatte, un modello di scontorno basato su SAM 3 di Meta, e ChatGPT Enterprise gestisce i suoi plugin nell’Admin console dal 1° ottobre.
Microsoft e Hugging Face collegano ThinkingBox a OpenEnv: 20 tentativi per attività, e la classifica cambia
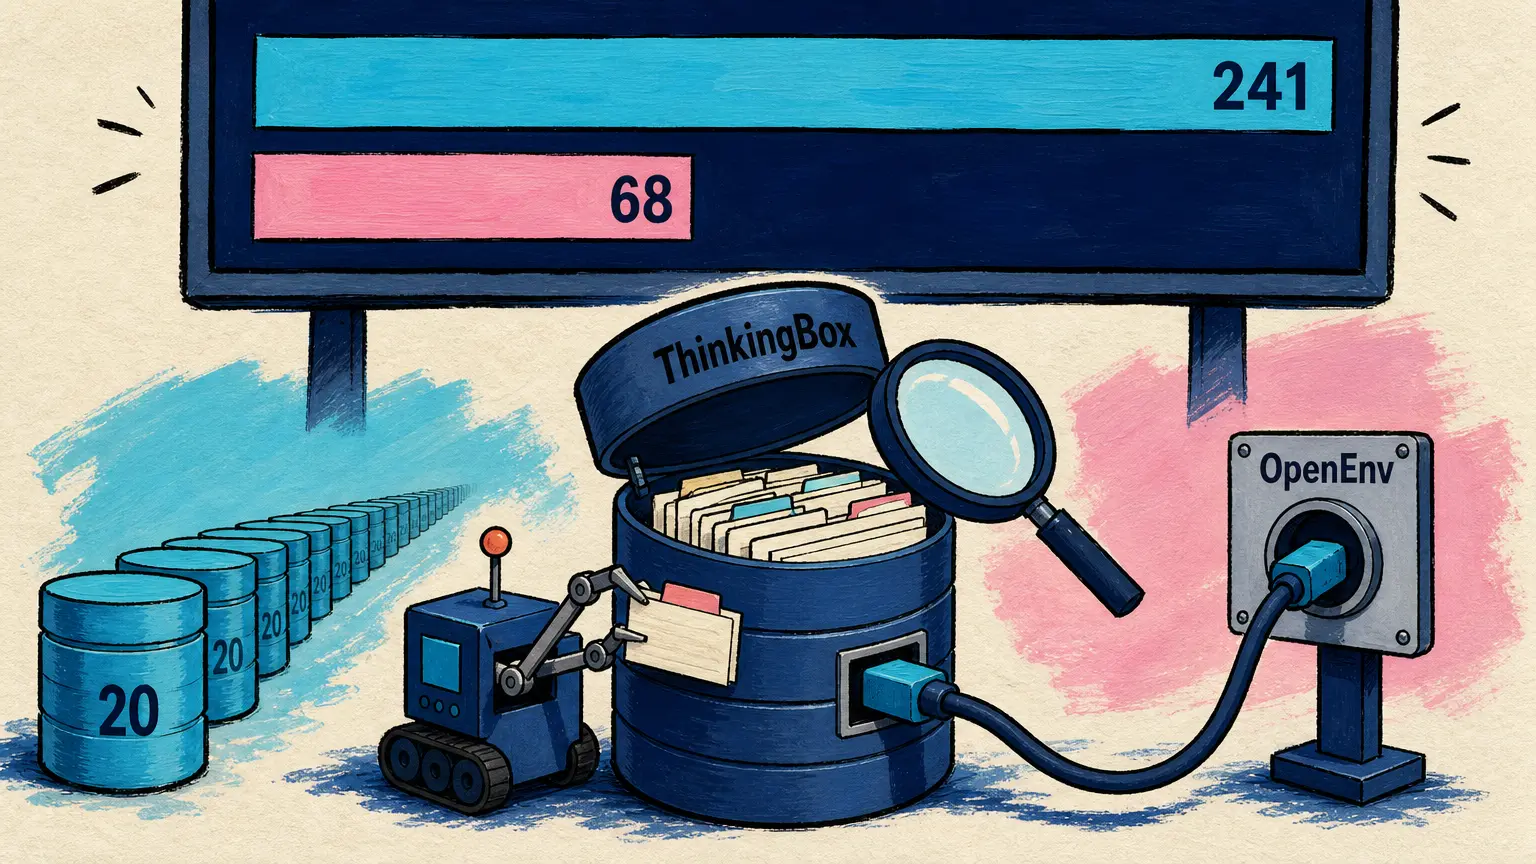
3 ottobre — In un post presentato come congiunto tra Microsoft e Hugging Face, Tuhin Kundu (Microsoft) descrive ThinkingBox, un benchmark che valuta gli agenti IA su ciò che lasciano nel database, non sulle loro risposte. Sviluppato dal team Microsoft Copilot Studio insieme a Toloka, non è nuovo (paper di ricerca del 20 agosto, dataset pubblicato a fine agosto): la novità è il suo passaggio dietro OpenEnv, l’interfaccia aperta di ambienti per agenti ospitata da Hugging Face, e la pubblicazione dei risultati di 18 modelli.
I suoi 507 flussi di lavoro (workflow) aziendali sintetici vengono rieseguiti 20 volte ciascuno a partire da uno stato pulito, e giudici deterministici confrontano lo stato finale del database con quello previsto. Risultati secondo gli autori; i relativi costi, stimati in base ai prezzi di listino di OpenRouter (quelli di Anthropic per Claude Opus 5.5), costituiscono un indice comparativo, non una fattura:
| Modello valutato | pass@1 globale | Attività riuscite 20 volte su 20 (su 507) | Costo per attività affidabile |
|---|---|---|---|
| Claude Opus 5.5 | 67,16 % | 241 | 7,80 dollari |
| Claude Opus 5 | 66,50 % | 241 | 13,30 dollari |
| GPT-5.4 | 65,36 % | 128 | 6,80 dollari |
| GPT-5.6 Sol | 61,91 % | 82 | 9,76 dollari |
| GPT-6 Astra | 58,31 % | 231 | 7,45 dollari |
| Kimi-K3 (pesi aperti) | 57,37 % | 68 | 20,68 dollari |
La ripetizione cambia la classifica: Kimi-K3, miglior modello a pesi aperti, risolve 476 delle 507 attività almeno una volta, ma solo 68 in ciascuno dei 20 tentativi, contro le 241 sia di Claude Opus 5 che di Claude Opus 5.5. Secondo il team, circa quattro fallimenti su cinque sono dovuti all’uso degli strumenti piuttosto che al ragionamento. Il codice è sotto licenza MIT, i dati sotto CDLA-Permissive-2.0.
A trajectory is a claim. Database state is the evidence. Repetition is the trust test.
🇮🇹 Una traiettoria è un’affermazione. Lo stato del database è la prova. La ripetizione è il test di fiducia. — Post di Microsoft e Hugging Face
🔗 Dataset ThinkingBox-Bench · ThinkingBox in OpenEnv
Exgentic Agent LLM Traces: 10 000 esecuzioni di agenti conservate in formato OpenTelemetry
4 ottobre — Sul blog della community di Hugging Face, Lena Dankin, Elron Bandel e Michal Shmueli-Scheuer presentano Exgentic Agent LLM Traces, un dataset pubblicato sotto l’organizzazione Exgentic dell’Hub: 10 000 esecuzioni di agenti e 242 000 chiamate di modello, ciascuna conservata secondo le convenzioni GenAI di OpenTelemetry, con il punteggio e il costo di ogni esecuzione.
Queste esecuzioni coprono sei benchmark (SWE-bench, BrowseComp Plus, AppWorld e tre varianti di τ²-bench) e fino a cinque architetture di agenti. In media, Claude Opus 4.5 consuma 2,4 milioni di token per esecuzione, contro i 552 000 di GPT-5.2.
Due riserve: i cinque modelli appartengono a generazioni precedenti (DeepSeek-V3.2, Kimi-K2.5, GPT-5.2, Claude Opus 4.5 e Gemini 3 Pro), e il post presenta come novità del giorno un repository creato il 10 giugno, privo di licenza dichiarata nella relativa scheda.
🔗 Post · Dataset su Hugging Face
In breve
- Claude Code 2.1.289 — Questa versione da 27 voci corregge quattro casi in cui le regole di autorizzazione deny e ask non venivano applicate; un plugin installato dall’utente non può più riscrivere le descrizioni degli strumenti di connessione di un server MCP gestito, e altre 18 voci riguardano mod e plugin. 🔗 fonte
- Copilot CLI 1.0.92-4 e SDK Copilot 1.0.17-preview.4 — La CLI, in anteprima (ultima versione stabile: 1.0.91), aggiunge i sottocomandi
copilot configper elencare, leggere, definire ed eliminare un’impostazione, e non trasmette più ilGITHUB_TOKENdell’ambiente alle shell della sandbox, salvo configurazione esplicita; l’SDK riceve gli hookOnSubagentStarteOnSubagentStop, per arricchire il primo prompt di un sotto-agente, quindi ispezionare o sostituire la sua risposta. 🔗 CLI · 🔗 SDK - MultiMatte di Feyn — Questo modello di scontorno è guidato dal testo: si nomina l’oggetto da conservare, il modello rimuove il resto, con una maschera alpha (alpha matte) che rende meglio capelli e aree sfocate. Basato su SAM 3 di Meta e perfezionato tramite un adattatore LoRA, raggiunge secondo gli autori una S-measure di 0,901 su DIS-VD, contro 0,667 per SAM 3; i suoi pesi, sotto licenza Apache 2.0 secondo la loro scheda, sono online dal 20 agosto. 🔗 fonte
- Plugin di ChatGPT Enterprise nell’Admin console — Il 1° ottobre, le note di rilascio di Enterprise ed Edu hanno annunciato che i proprietari e gli amministratori di spazi di lavoro ChatGPT Enterprise gestiscono ora i plugin e i relativi marketplace (marketplaces) nell’Admin console, alle pagine Plugins e Marketplaces; le applicazioni rimangono in Workspace settings > Apps, con i permessi esistenti. 🔗 fonte
Cosa significa
ThinkingBox cambia la domanda posta a un agente: non più se sia in grado di svolgere un’attività, ma se la porti a termine ogni volta. Su un solo tentativo, Kimi-K3 si trova a meno di un punto da GPT-6 Astra; su venti, riesce a completare in tutti i casi solo 68 attività, contro 231. Per chi affida a un agente operazioni che modificano un database, è questo secondo dato a contare, e il benchmark lo misura sullo stato finale del database anziché su ciò che l’agente dichiara di aver fatto.
Il costo segue la stessa logica. Rapportato alle sole attività riuscite a ogni tentativo, indica GPT-5.4 come il più economico (6,80 dollari per attività affidabile), e non GPT-5.6 Sol, che pure è il più economico per tentativo riuscito (0,127 dollari); Kimi-K3 costa invece 20,68 dollari per attività affidabile, tre volte più di GPT-5.4. Tali importi restano, ricordano gli autori, un indice comparativo e non una fattura.
Gli autori di Exgentic Agent LLM Traces partono da un limite analogo: un benchmark riduce un’esecuzione a un punteggio, mentre la traccia mostra gli strumenti scelti, la crescita del contesto e i ripristini dopo un errore. Con ogni chiamata conservata in un formato standard, vi intravedono il modo di eseguire il debug di un agente rispetto a un riferimento, rieseguire un passaggio con un altro modello o testare un’infrastruttura di inferenza sotto un carico reale di agenti; un team lo sta già facendo con inference-perf, lo strumento di benchmark del SIG Kubernetes, e i risultati saranno annunciati più avanti.
Fonti
- Post congiunto di Microsoft e Hugging Face su ThinkingBox
- Dataset ThinkingBox-Bench su Hugging Face
- Ambiente ThinkingBox nella documentazione di OpenEnv
- Codice di ThinkingBox su GitHub
- Dati di ThinkingBox su GitHub
- Exgentic Agent LLM Traces (blog di Hugging Face)
- Dataset Exgentic/agent-llm-traces-v2
- Claude Code v2.1.289
- Changelog di Claude Code
- Copilot CLI v1.0.92-4
- SDK GitHub Copilot v1.0.17-preview.4
- MultiMatte (post di Feyn)
- Modello feyninc/multimatte su Hugging Face
- Note di rilascio di ChatGPT Enterprise ed Edu