ai-powered-markdown-translatorمقال مترجم من الفرنسية إلى العربية باستخدام gemini-3.8-flash-high.
في ليلة السبت إلى الأحد، ربطت Microsoft وHugging Face منصة ThinkingBox بـ OpenEnv: تقوم بيئة التقييم هذه بإعادة تشغيل 507 مهام أعمال 20 مرة لكل منها وتقيّم الوكلاء بناءً على الحالة النهائية لقاعدة البيانات، كما يغيّر التكرار الترتيب فيها. ويوم الأحد 4 أكتوبر، استعرض ثلاثة باحثين Exgentic Agent LLM Traces، وهي 10,000 عملية تشغيل للوكلاء بتنسيق OpenTelemetry منشورة تحت منظمة Exgentic على Hub. وفي الأخبار الموجزة، يعزز Claude Code 2.1.289 وCopilot CLI 1.0.92-4 تدابير الحماية الخاصة بهما، وتقدم Feyn نموذج MultiMatte لتفريغ الصور المعتمد على SAM 3 من Meta، وتدير ChatGPT Enterprise إضافاتها في Admin console منذ 1 أكتوبر.
Microsoft وHugging Face تربطان ThinkingBox بـ OpenEnv: 20 محاولة لكل مهمة، والترتيب يتغير
3 أكتوبر — في منشور قُدّم كعمل مشترك بين Microsoft وHugging Face، يصف Tuhin Kundu (من Microsoft) منصة ThinkingBox، وهي بيئة تقييم تحكم على وكلاء الذكاء الاصطناعي بناءً على ما يتركونه في قاعدة البيانات، وليس على إجاباتهم. والمنصة التي طورها فريق Microsoft Copilot Studio بالتعاون مع Toloka ليست جديدة (ورقة بحثية في 20 أغسطس، ومجموعة بيانات نُشرت في أواخر أغسطس): فالجديد هو إتاحتها عبر OpenEnv، وهي الواجهة المفتوحة لبيئات الوكلاء التي تستضيفها Hugging Face، ونشر نتائج 18 نموذجاً.
يُعاد تشغيل تدفقات العمل (workflows) التجارية التركيبية البالغ عددها 507 تدفقات 20 مرة لكل منها من حالة نظيفة، ويقارن حُكّام حتميون الحالة النهائية لقاعدة البيانات بالحالة المتوقعة. وجاءت النتائج وفقاً للمؤلفين؛ علماً بأن تكاليفها، المقدرة استناداً إلى أسعار قائمة OpenRouter (وأسعار Anthropic لنموذج Claude Opus 5.5)، تعد مؤشراً للمقارنة وليست فاتورة فعلية:
| النموذج الخاضع للتقييم | pass@1 الإجمالي | المهام الناجحة 20 مرة من أصل 20 (من 507) | التكلفة لكل مهمة موثوقة |
|---|---|---|---|
| Claude Opus 5.5 | 67,16 % | 241 | 7,80 دولاراً |
| Claude Opus 5 | 66,50 % | 241 | 13,30 دولاراً |
| GPT-5.4 | 65,36 % | 128 | 6,80 دولاراً |
| GPT-5.6 Sol | 61,91 % | 82 | 9,76 دولاراً |
| GPT-6 Astra | 58,31 % | 231 | 7,45 دولاراً |
| Kimi-K3 (أوزان مفتوحة) | 57,37 % | 68 | 20,68 دولاراً |
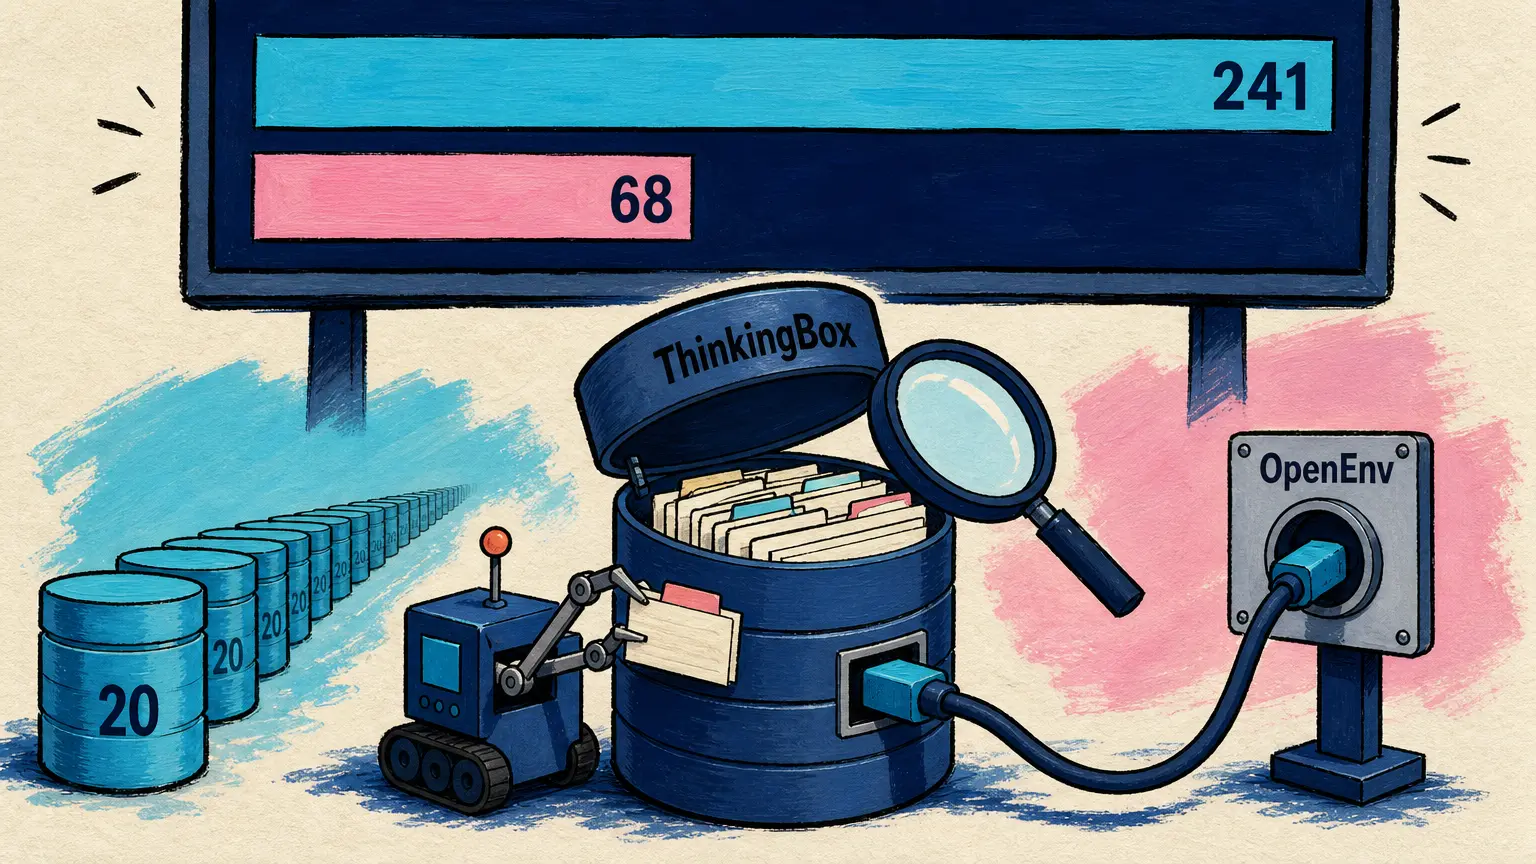
يغيّر التكرار الترتيب: إذ يحل Kimi-K3، أفضل نموذج ذي أوزان مفتوحة، 476 مهمة من أصل 507 مهام مرة واحدة على الأقل، ولكنه ينجح في 68 مهمة فقط في كل محاولة من المحاولات العشرين، مقارنة بـ 241 مهمة لكل من Claude Opus 5 وClaude Opus 5.5. ووفقاً للفريق، فإن نحو أربع حالات فشل من كل خمس حالات تعود إلى استخدام الأدوات بدلاً من الاستدلال. الكود البرمجي متاح بموجب ترخيص MIT، والبيانات بموجب CDLA-Permissive-2.0.
A trajectory is a claim. Database state is the evidence. Repetition is the trust test.
🇸🇦 المسار هو ادعاء. وحالة قاعدة البيانات هي الدليل. والتكرار هو اختبار الثقة. — منشور Microsoft وHugging Face
🔗 مجموعة بيانات ThinkingBox-Bench · ThinkingBox في OpenEnv
Exgentic Agent LLM Traces: 10,000 عملية تشغيل للوكلاء محفوظة بتنسيق OpenTelemetry
4 أكتوبر — على مدونة مجتمع Hugging Face، يقدّم كل من Lena Dankin وElron Bandel وMichal Shmueli-Scheuer مجموعة بيانات Exgentic Agent LLM Traces، المنشورة تحت منظمة Exgentic على Hub: تضم 10,000 عملية تشغيل للوكلاء و242,000 استدعاء للنماذج، وكل منها محفوظ وفقاً لمعايير GenAI الخاصة بـ OpenTelemetry، مع درجة التقييم وتكلفة كل تشغيل.
تغطي عمليات التشغيل هذه ست منصات اختبار (SWE-bench وBrowseComp Plus وAppWorld وثلاثة متغيرات من τ²-bench) وما يصل إلى خمسة تصاميم للوكلاء. وفي المتوسط، يستهلك Claude Opus 4.5 نحو 2.4 مليون توكن لكل عملية تشغيل، مقابل 552,000 لنموذج GPT-5.2.
تحفّظان: النماذج الخمسة تنتمي إلى أجيال سابقة (DeepSeek-V3.2 وKimi-K2.5 وGPT-5.2 وClaude Opus 4.5 وGemini 3 Pro)، ويقدم المنشور مستودعاً أُنشئ في 10 يونيو كإصدار جديد اليوم، دون ترخيص معلن في بطاقته التعريفية.
🔗 المنشور · مجموعة البيانات على Hugging Face
أخبار موجزة
- Claude Code 2.1.289 — يُصلح هذا الإصدار الذي يضم 27 مدخلاً أربع حالات لم تكن تُطبّق فيها قواعد الأذونات deny وask؛ ولم يعد بإمكان أي إضافة يثبتها المستخدم إعادة كتابة أوصاف أدوات الاتصال الخاصة بخادم MCP مُدار، وتتعلق 18 مدخلاً آخر بالتعديلات والإضافات. 🔗 المصدر
- Copilot CLI 1.0.92-4 وSDK Copilot 1.0.17-preview.4 — تضيف واجهة سطر الأوامر (CLI)، في نسختها التجريبية (آخر نسخة مستقرة: 1.0.91)، الأوامر الفرعية
copilot configلسرد أي إعداد وقراءته وتعيينه وحذفه، ولم تعد تمررGITHUB_TOKENالمحيط إلى أصداف بيئة العزل (sandbox)، ما لم يُضبط ذلك صراحةً؛ بينما يتلقى الـ SDK الخطافات (hooks) OnSubagentStartوOnSubagentStop، لإثراء الموجه الأول للوكيل الفرعي، ثم فحص استجابته أو استبدالها. 🔗 CLI · 🔗 SDK - MultiMatte من Feyn — يُوجَّه نموذج تفريغ الصور هذا بواسطة النص: تذكر اسم الكائن المراد الاحتفاظ به، فيقوم النموذج بإزالة الباقي، مع قناع ألفا (alpha matte) يُظهر الشعر والمناطق الضبابية بشكل أفضل. وقد صُمم بالاعتماد على SAM 3 من Meta وجرى ضبطه الدقيق باستخدام مهايئ LoRA، ويحقق وفقاً للمؤلفين مقياس S-measure قدره 0,901 على DIS-VD، مقابل 0,667 لـ SAM 3؛ وأوزانه، المتاحة تحت ترخيص Apache 2.0 وفقاً لبطاقتها، متوفرة على الإنترنت منذ 20 أغسطس. 🔗 المصدر
- إضافات ChatGPT Enterprise في Admin console — في 1 أكتوبر، أعلنت ملاحظات إصدار Enterprise وEdu أن مالكي ومسؤولي مساحات عمل ChatGPT Enterprise بات بإمكانهم الآن إدارة الإضافات ومتاجرها (marketplaces) في Admin console، وتحديداً في صفحتي Plugins وMarketplaces؛ وتبقى التطبيقات في Workspace settings > Apps مع الأذونات الحالية. 🔗 المصدر
ما يعنيه ذلك
تغيّر ThinkingBox السؤال المطروح على الوكيل: لم يعد الأمر يتعلق بما إذا كان قادراً على إنجاز مهمة ما، بل بما إذا كان ينجزها في كل مرة. ففي محاولة واحدة، يفصل بين Kimi-K3 وGPT-6 Astra أقل من نقطة واحدة؛ لكن عبر عشرين محاولة، لا ينجح في كل المرات إلا في 68 مهمة فقط، مقابل 231 مهمة للثاني. وبالنسبة لمن يوكِل إلى وكيل عمليات تُعدّل في قاعدة البيانات، فإن هذا الرقم الثاني هو ما يهم، وتقيسه منصة التقييم بناءً على الحالة النهائية لقاعدة البيانات وليس بناءً على ما يدّعي الوكيل أنه فعله.
وتتبع التكلفة المنطق نفسه. فعند حسابها بناءً على المهام الناجحة في كل محاولة فقط، يتبيّن أن GPT-5.4 هو الأقل تكلفة (6.80 دولاراً لكل مهمة موثوقة)، وليس GPT-5.6 Sol، على الرغم من كونه الأقل تكلفة لكل محاولة ناجحة (0.127 دولار)؛ أما Kimi-K3 فتصل تكلفته إلى 20.68 دولاراً لكل مهمة موثوقة، أي أكثر بثلاثة أضعاف من GPT-5.4. ويذكّر المؤلفون بأن هذه المبالغ تظل مؤشراً للمقارنة وليست فاتورة فعلية.
ينطلق مؤلفو Exgentic Agent LLM Traces من قيد مماثل: تختزل بيئات التقييم عملية التشغيل في مجرد نتيجة رقمية، في حين يُظهر مسار التتبع الأدوات المختارة، وتنامي السياق، والتعافي من الأخطاء. ومع حفظ كل استدعاء بتنسيق قياسي، يرى الباحثون في ذلك وسيلة لتصحيح أخطاء الوكيل بالمقارنة مع مرجع موثوق، أو إعادة تشغيل خطوة ما بنموذج آخر، أو اختبار بنية تحتية للاستدلال تحت حمل تشغيلي حقيقي من الوكلاء؛ ويقوم فريق بالفعل بتطبيق ذلك باستخدام inference-perf، وهي أداة التقييم الخاصة بمجموعة SIG Kubernetes، مع الإعلان عن نتائجها لاحقاً.
المصادر
- منشور مشترك بين Microsoft وHugging Face حول ThinkingBox
- مجموعة بيانات ThinkingBox-Bench على Hugging Face
- بيئة ThinkingBox في وثائق OpenEnv
- كود ThinkingBox البرمجي على GitHub
- بيانات ThinkingBox على GitHub
- Exgentic Agent LLM Traces (مدونة Hugging Face)
- مجموعة بيانات Exgentic/agent-llm-traces-v2
- Claude Code v2.1.289
- سجل تغييرات Claude Code
- Copilot CLI v1.0.92-4
- حزمة SDK لـ GitHub Copilot v1.0.17-preview.4
- MultiMatte (منشور Feyn)
- نموذج feyninc/multimatte على Hugging Face
- ملاحظات إصدار ChatGPT Enterprise وEdu