ai-powered-markdown-translatorArtikel vertaald van fr naar nl met gemini-3.8-flash-high.
In de nacht van zaterdag op zondag hebben Microsoft en Hugging Face ThinkingBox gekoppeld aan OpenEnv: deze benchmark voert 507 zakelijke taken elk 20 keer opnieuw uit en beoordeelt agents op de uiteindelijke staat van de database, en de herhaling verandert hierbij de rangschikking. Op zondag 4 oktober beschrijven drie auteurs Exgentic Agent LLM Traces, 10.000 agent-executies in OpenTelemetry-formaat gepubliceerd onder de Exgentic-organisatie op de Hub. In het kort: Claude Code 2.1.289 en Copilot CLI 1.0.92-4 versterken hun vangrails, Feyn presenteert MultiMatte, een uitsnijdmodel gebouwd op SAM 3 van Meta, en ChatGPT Enterprise beheert sinds 1 oktober zijn plug-ins in de Admin console.
Microsoft en Hugging Face koppelen ThinkingBox aan OpenEnv: 20 pogingen per taak, en het klassement verandert
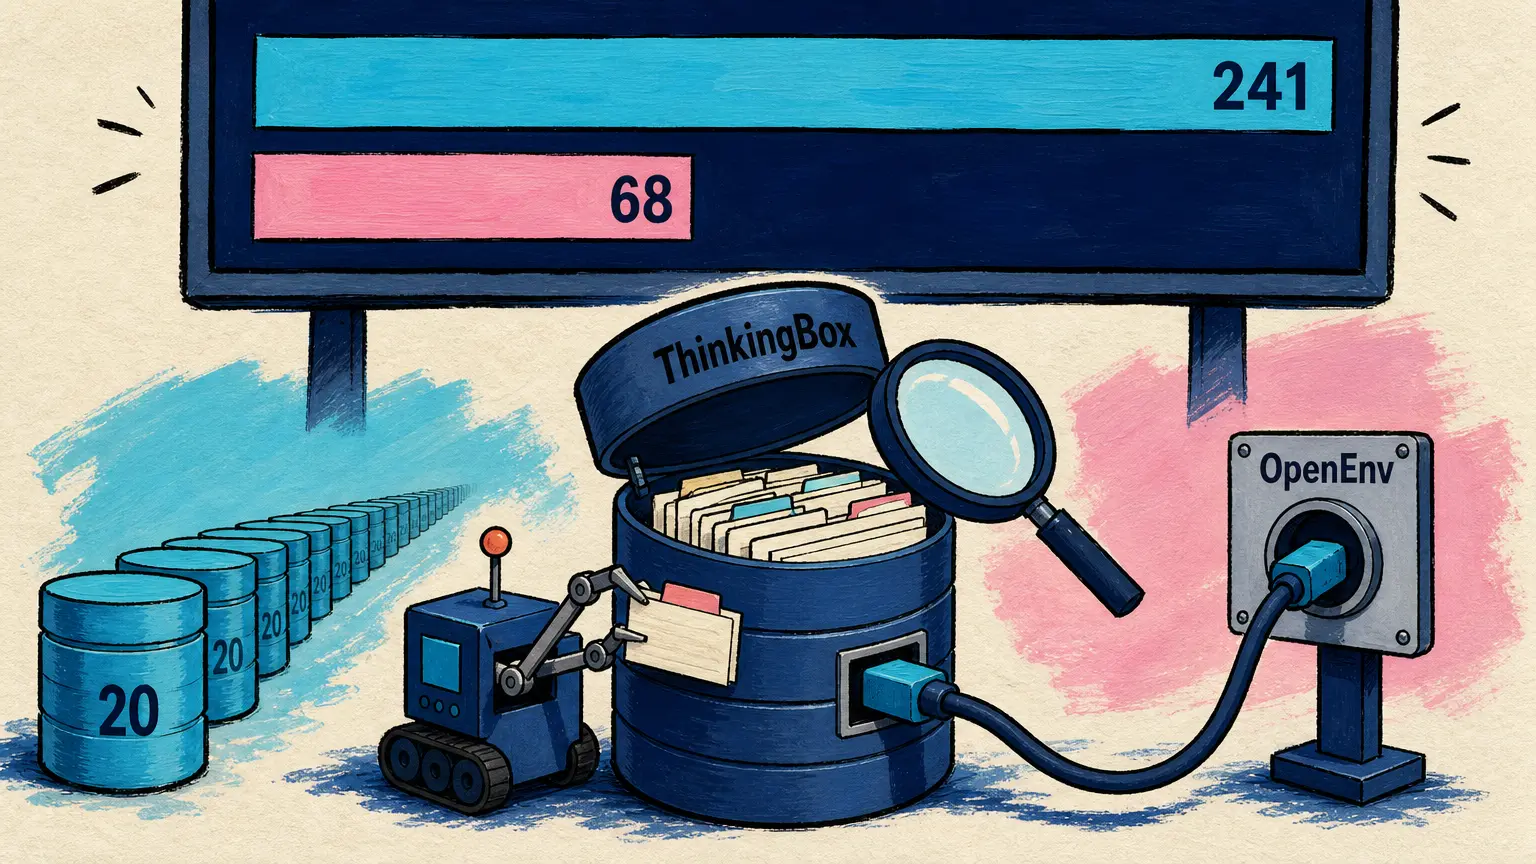
3 oktober — In een blogpost die wordt gepresenteerd als een gezamenlijk bericht van Microsoft en Hugging Face, beschrijft Tuhin Kundu (Microsoft) ThinkingBox, een benchmark die AI-agents beoordeelt op wat ze achterlaten in de database, niet op hun antwoorden. Gebouwd door het team van Microsoft Copilot Studio samen met Toloka, is het niet nieuw (onderzoeksartikel van 20 augustus, dataset eind augustus gepubliceerd): het nieuwe is de integratie met OpenEnv, de open interface van omgevingen voor agents gehost door Hugging Face, en de publicatie van de resultaten van 18 modellen.
De 507 synthetische zakelijke workflows (workflows) worden elk 20 keer opnieuw uitgevoerd vanuit een schone staat, en deterministische beoordelaars vergelijken de uiteindelijke status van de database met de verwachte staat. Resultaten volgens de auteurs; hun kosten, geschat op basis van de catalogusprijzen van OpenRouter (die van Anthropic voor Claude Opus 5.5), zijn een vergelijkende indicatie, geen factuur:
| Geëvalueerd model | Algemene pass@1 | Taken 20 van de 20 keer geslaagd (op 507) | Kosten per betrouwbare taak |
|---|---|---|---|
| Claude Opus 5.5 | 67,16 % | 241 | 7,80 dollar |
| Claude Opus 5 | 66,50 % | 241 | 13,30 dollar |
| GPT-5.4 | 65,36 % | 128 | 6,80 dollar |
| GPT-5.6 Sol | 61,91 % | 82 | 9,76 dollar |
| GPT-6 Astra | 58,31 % | 231 | 7,45 dollar |
| Kimi-K3 (open gewichten) | 57,37 % | 68 | 20,68 dollar |
De herhaling verandert de rangschikking: Kimi-K3, het beste model met open gewichten, lost 476 van de 507 taken minstens één keer op, maar slechts 68 bij elk van de 20 pogingen, vergeleken met 241 voor zowel Claude Opus 5 als Claude Opus 5.5. Volgens het team is ongeveer vier op de vijf mislukkingen te wijten aan het gebruik van tools in plaats van aan het redeneren. De code valt onder de MIT-licentie, de data onder CDLA-Permissive-2.0.
A trajectory is a claim. Database state is the evidence. Repetition is the trust test.
🇳🇱 Een traject is een bewering. De staat van de database is het bewijs. Herhaling is de betrouwbaarheidstest. — Blogpost van Microsoft en Hugging Face
🔗 ThinkingBox-Bench-dataset · ThinkingBox in OpenEnv
Exgentic Agent LLM Traces: 10.000 agent-executies bewaard in OpenTelemetry-formaat
4 oktober — Op de communityblog van Hugging Face presenteren Lena Dankin, Elron Bandel en Michal Shmueli-Scheuer Exgentic Agent LLM Traces, een dataset gepubliceerd onder de Exgentic-organisatie op de Hub: 10.000 agent-executies en 242.000 modelaanroepen, elk bewaard volgens de GenAI-conventies van OpenTelemetry, met de score en de kosten van elke executie.
Deze executies beslaan zes benchmarks (SWE-bench, BrowseComp Plus, AppWorld en drie varianten van τ²-bench) en tot wel vijf agent-ontwerpen. Gemiddeld verbruikt Claude Opus 4.5 2,4 miljoen tokens per executie, tegenover 552.000 voor GPT-5.2.
Twee kanttekeningen: de vijf modellen zijn van eerdere generaties (DeepSeek-V3.2, Kimi-K2.5, GPT-5.2, Claude Opus 4.5 en Gemini 3 Pro), en het bericht presenteert een repository die op 10 juni is aangemaakt als een release van vandaag, zonder vermelde licentie op de informatiepagina.
🔗 Blogpost · Dataset op Hugging Face
In het kort
- Claude Code 2.1.289 — Deze release van 27 punten verhelpt vier gevallen waarin de toestemmingsregels deny en ask niet werden toegepast; een door de gebruiker geïnstalleerde plug-in kan niet langer de beschrijvingen herschrijven van de verbindingstools van een beheerde MCP-server, en 18 andere punten hebben betrekking op mods en plug-ins. 🔗 bron
- Copilot CLI 1.0.92-4 en Copilot SDK 1.0.17-preview.4 — De CLI, in preview (laatste stabiele: 1.0.91), voegt de subcommando’s
copilot configtoe om een instelling weer te geven, te lezen, in te stellen en te verwijderen, en geeft het omringendeGITHUB_TOKENniet langer door aan sandbox-shells, tenzij expliciet geconfigureerd; de SDK ontvangt de hooksOnSubagentStartenOnSubagentStopom de eerste prompt van een subagent te verrijken en vervolgens diens respons te inspecteren of te vervangen. 🔗 CLI · 🔗 SDK - MultiMatte van Feyn — Dit uitsnijdmodel wordt aangestuurd via tekst: men benoemt het object dat behouden moet blijven, het model verwijdert de rest, met een alfamasker (alpha matte) dat haar en onscherpe gebieden beter weergeeft. Gebouwd op SAM 3 van Meta en verfijnd met een LoRA-adapter, behaalt het volgens de auteurs een S-measure van 0,901 op DIS-VD, vergeleken met 0,667 voor SAM 3; de gewichten vallen volgens de modelkaart onder Apache 2.0 en staan sinds 20 augustus online. 🔗 bron
- ChatGPT Enterprise-plug-ins in de Admin console — Op 1 oktober maakten de releasenotes voor Enterprise en Edu bekend dat eigenaren en beheerders van ChatGPT Enterprise-werkruimten voortaan plug-ins en hun marktplaatsen (marketplaces) beheren in de Admin console, op de pagina’s Plugins en Marketplaces; de applicaties blijven onder Workspace settings > Apps, met de bestaande rechten. 🔗 bron
Wat dit betekent
ThinkingBox verandert de vraag die aan een agent wordt gesteld: niet langer of hij een taak kan uitvoeren, maar of hij deze elke keer uitvoert. Bij één poging blijft Kimi-K3 op minder dan een punt afstand van GPT-6 Astra; bij twintig slaagt hij er slechts in om 68 taken telkens goed uit te voeren, vergeleken met 231. Voor wie een agent handelingen toevertrouwt die een database wijzigen, is juist dat tweede getal van belang, en de benchmark meet dit aan de hand van de uiteindelijke status van de database in plaats van wat de agent zegt te hebben gedaan.
De kosten volgen dezelfde logica. Berekend op alleen de taken die bij elke poging zijn geslaagd, wijst dit GPT-5.4 aan als de goedkoopste (6,80 dollar per betrouwbare taak), en niet GPT-5.6 Sol, hoewel die het goedkoopst is per geslaagde poging (0,127 dollar); Kimi-K3 komt daarentegen uit op 20,68 dollar per betrouwbare taak, drie keer zoveel als GPT-5.4. Deze bedragen blijven, zo benadrukken de auteurs, een vergelijkende indicatie en geen factuur.
De auteurs van Exgentic Agent LLM Traces vertrekken vanuit een vergelijkbare beperking: een benchmark reduceert een executie tot een score, terwijl de trace de gekozen tools, de toename van de context en het herstel na fouten laat zien. Doordat elke aanroep in een standaardformaat wordt bewaard, zien zij hierin de mogelijkheid om een agent te debuggen ten opzichte van een referentie, een stap opnieuw uit te voeren met een ander model of een inferentie-infrastructuur te testen onder een reële belasting van agents; een team doet dit al met inference-perf, de benchmarktool van de Kubernetes SIG, en de resultaten daarvan worden later verwacht.
Bronnen
- Gezamenlijke blogpost van Microsoft en Hugging Face over ThinkingBox
- ThinkingBox-Bench-dataset op Hugging Face
- ThinkingBox-omgeving in de documentatie van OpenEnv
- ThinkingBox-code op GitHub
- ThinkingBox-data op GitHub
- Exgentic Agent LLM Traces (Hugging Face-blog)
- Dataset Exgentic/agent-llm-traces-v2
- Claude Code v2.1.289
- Changelog van Claude Code
- Copilot CLI v1.0.92-4
- GitHub Copilot SDK v1.0.17-preview.4
- MultiMatte (blogpost van Feyn)
- Model feyninc/multimatte op Hugging Face
- Releasenotes ChatGPT Enterprise en Edu