ai-powered-markdown-translatorArtículo traducido del fr al es con gemini-3.8-flash-high.
En la noche del sábado al domingo, Microsoft y Hugging Face conectaron ThinkingBox a OpenEnv: este banco de pruebas reproduce 507 tareas empresariales 20 veces cada una y evalúa a los agentes según el estado final de la base de datos, y la repetición altera la clasificación. El domingo 4 de octubre, tres autores describen Exgentic Agent LLM Traces, 10 000 ejecuciones de agentes en formato OpenTelemetry publicadas bajo la organización Exgentic del Hub. En breve, Claude Code 2.1.289 y Copilot CLI 1.0.92-4 refuerzan sus medidas de seguridad, Feyn presenta MultiMatte, un modelo de recorte basado en SAM 3 de Meta, y ChatGPT Enterprise gestiona sus plugins en la Admin console desde el 1 de octubre.
Microsoft y Hugging Face conectan ThinkingBox a OpenEnv: 20 intentos por tarea y la clasificación cambia
3 de octubre — En una publicación presentada como conjunta entre Microsoft y Hugging Face, Tuhin Kundu (Microsoft) describe ThinkingBox, un banco de pruebas que evalúa a los agentes de IA por lo que dejan en la base de datos, no por sus respuestas. Desarrollado por el equipo de Microsoft Copilot Studio junto con Toloka, no es nuevo (artículo de investigación del 20 de agosto, conjunto de datos publicado a finales de agosto): la novedad es su integración detrás de OpenEnv, la interfaz abierta de entornos para agentes alojada por Hugging Face, y la publicación de los resultados de 18 modelos.
Sus 507 flujos de trabajo (workflows) empresariales sintéticos se reproducen 20 veces cada uno desde un estado limpio, y jueces deterministas comparan el estado final de la base con el esperado. Resultados según los autores; sus costes, estimados a partir de las tarifas de catálogo de OpenRouter (las de Anthropic para Claude Opus 5.5), son un índice comparativo, no una factura:
| Modelo evaluado | pass@1 global | Tareas superadas 20 veces de 20 (de 507) | Coste por tarea fiable |
|---|---|---|---|
| Claude Opus 5.5 | 67,16 % | 241 | 7,80 dólares |
| Claude Opus 5 | 66,50 % | 241 | 13,30 dólares |
| GPT-5.4 | 65,36 % | 128 | 6,80 dólares |
| GPT-5.6 Sol | 61,91 % | 82 | 9,76 dólares |
| GPT-6 Astra | 58,31 % | 231 | 7,45 dólares |
| Kimi-K3 (pesos abiertos) | 57,37 % | 68 | 20,68 dólares |
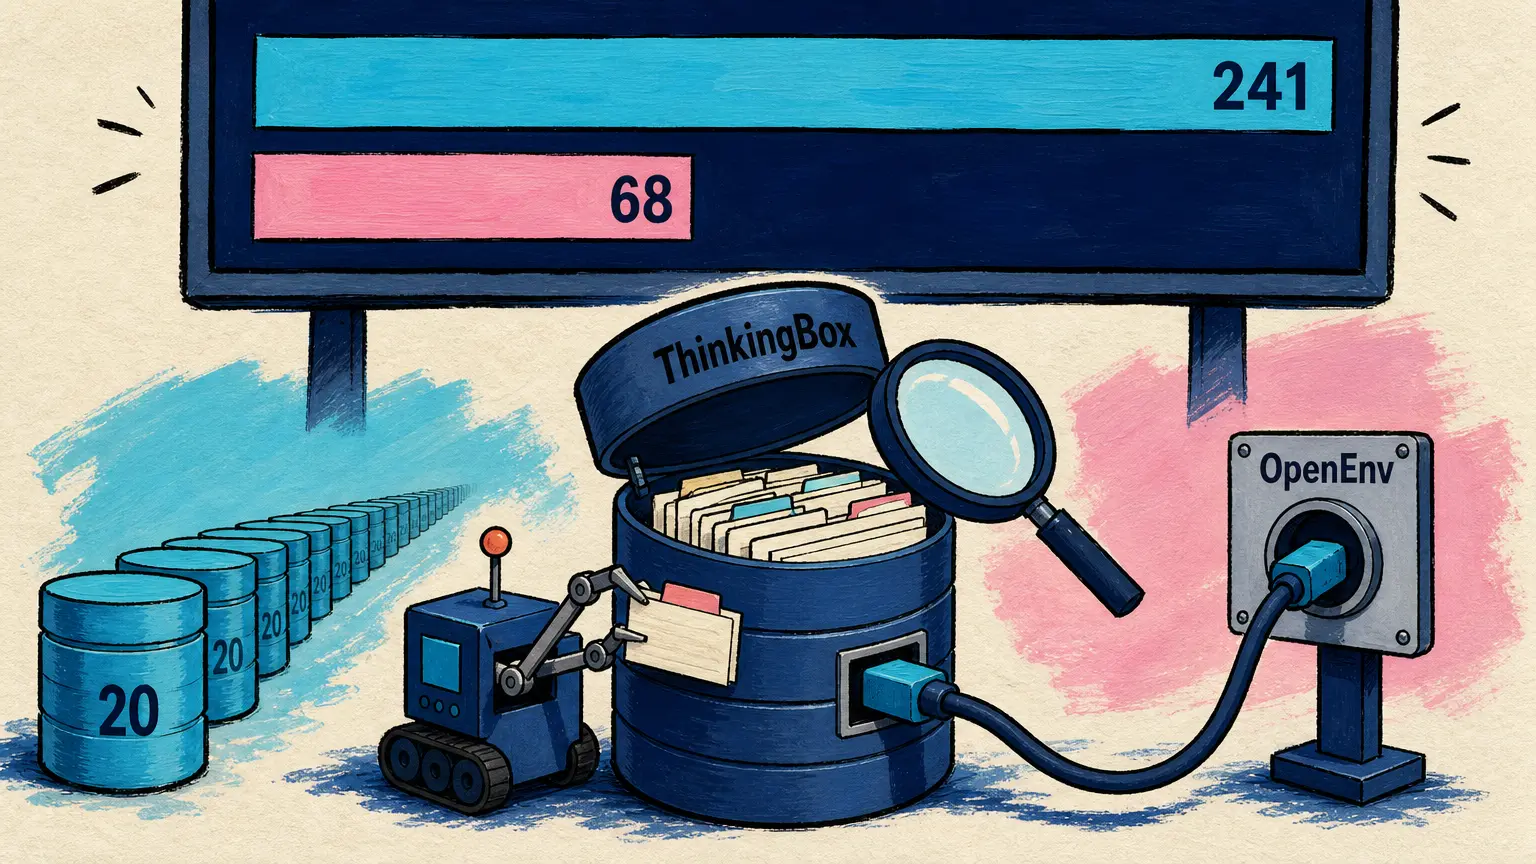
La repetición cambia la clasificación: Kimi-K3, el mejor modelo de pesos abiertos, resuelve 476 de las 507 tareas al menos una vez, pero solo 68 en cada uno de los 20 intentos, frente a 241 tanto para Claude Opus 5 como para Claude Opus 5.5. Según el equipo, aproximadamente cuatro de cada cinco fallos se deben al uso de herramientas más que al razonamiento. El código está bajo licencia MIT y los datos bajo CDLA-Permissive-2.0.
A trajectory is a claim. Database state is the evidence. Repetition is the trust test.
🇪🇸 Una trayectoria es una afirmación. El estado de la base de datos es la prueba. La repetición es la prueba de confianza. — Publicación de Microsoft y Hugging Face
🔗 Conjunto de datos ThinkingBox-Bench · ThinkingBox en OpenEnv
Exgentic Agent LLM Traces: 10 000 ejecuciones de agentes conservadas en formato OpenTelemetry
4 de octubre — En el blog comunitario de Hugging Face, Lena Dankin, Elron Bandel y Michal Shmueli-Scheuer presentan Exgentic Agent LLM Traces, un conjunto de datos publicado bajo la organización Exgentic del Hub: 10 000 ejecuciones de agentes y 242 000 llamadas al modelo, cada una conservada según las convenciones GenAI de OpenTelemetry, con la puntuación y el coste de cada ejecución.
Estas ejecuciones cubren seis bancos de pruebas (SWE-bench, BrowseComp Plus, AppWorld y tres variantes de τ²-bench) y hasta cinco diseños de agente. De media, Claude Opus 4.5 consume 2,4 millones de tokens por ejecución, frente a 552 000 para GPT-5.2.
Dos salvedades: los cinco modelos pertenecen a generaciones anteriores (DeepSeek-V3.2, Kimi-K2.5, GPT-5.2, Claude Opus 4.5 y Gemini 3 Pro), y la publicación presenta como un lanzamiento del día un repositorio creado el 10 de junio, sin licencia declarada en su ficha.
🔗 Publicación · Conjunto de datos en Hugging Face
Breves
- Claude Code 2.1.289 — Esta versión de 27 entradas corrige cuatro casos en los que las reglas de permisos deny y ask no se aplicaban; un plugin instalado por el usuario ya no puede reescribir las descripciones de las herramientas de conexión de un servidor MCP gestionado, y otras 18 entradas se refieren a los mods y los plugins. 🔗 fuente
- Copilot CLI 1.0.92-4 y SDK Copilot 1.0.17-preview.4 — La CLI, en versión preliminar (última estable: 1.0.91), añade los subcomandos
copilot configpara listar, leer, definir y eliminar un ajuste, y ya no transmite elGITHUB_TOKENambiental a las shells del sandbox, salvo configuración explícita; el SDK recibe los hooksOnSubagentStartyOnSubagentStop, para enriquecer el primer prompt de un subagente y luego inspeccionar o sustituir su respuesta. 🔗 CLI · 🔗 SDK - MultiMatte de Feyn — Este modelo de recorte se guía mediante texto: se nombra el objeto que se desea conservar y el modelo elimina el resto, con una máscara alfa (alpha matte) que reproduce mejor el cabello y las zonas desenfocadas. Basado en SAM 3 de Meta y ajustado mediante un adaptador LoRA, alcanza según los autores 0,901 de S-measure en DIS-VD, frente a 0,667 para SAM 3; sus pesos, bajo Apache 2.0 según su ficha, están en línea desde el 20 de agosto. 🔗 fuente
- Plugins de ChatGPT Enterprise en la Admin console — El 1 de octubre, las notas de la versión para Enterprise y Edu anunciaron que los propietarios y administradores de espacios de ChatGPT Enterprise ahora gestionan los plugins y sus mercados (marketplaces) en la Admin console, en las páginas Plugins y Marketplaces; las aplicaciones permanecen en Workspace settings > Apps, con los permisos existentes. 🔗 fuente
Qué significa esto
ThinkingBox cambia la pregunta que se le plantea a un agente: ya no si sabe realizar una tarea, sino si la realiza en cada ocasión. En un solo intento, Kimi-K3 se sitúa a menos de un punto de GPT-6 Astra; en veinte, solo logra superar invariablemente 68 tareas, frente a 231. Para quien confía a un agente operaciones que modifican una base de datos, es esta segunda cifra la que importa, y el banco de pruebas la mide a partir del estado final de la base en lugar de lo que el agente dice haber hecho.
El coste sigue la misma lógica. Calculado únicamente sobre las tareas superadas en cada intento, sitúa a GPT-5.4 como el más económico (6,80 dólares por tarea fiable), y no a GPT-5.6 Sol, a pesar de ser el más barato por intento superado (0,127 dólares); Kimi-K3, por su parte, sale a 20,68 dólares por tarea fiable, tres veces más que GPT-5.4. Estos importes siguen siendo, recuerdan los autores, un índice comparativo y no una factura.
Los autores de Exgentic Agent LLM Traces parten de una limitación similar: un banco de pruebas reduce una ejecución a una puntuación, mientras que la traza muestra las herramientas elegidas, el crecimiento del contexto y las recuperaciones tras un error. Al conservarse cada llamada en un formato estándar, ven en ello la posibilidad de depurar un agente frente a una referencia, reproducir un paso con otro modelo o probar una infraestructura de inferencia bajo una carga real de agentes; un equipo ya lo está haciendo con inference-perf, la herramienta de benchmark del SIG Kubernetes, y sus resultados se anunciarán más adelante.
Fuentes
- Publicación conjunta de Microsoft y Hugging Face sobre ThinkingBox
- Conjunto de datos ThinkingBox-Bench en Hugging Face
- Entorno ThinkingBox en la documentación de OpenEnv
- Código de ThinkingBox en GitHub
- Datos de ThinkingBox en GitHub
- Exgentic Agent LLM Traces (blog de Hugging Face)
- Conjunto de datos Exgentic/agent-llm-traces-v2
- Claude Code v2.1.289
- Registro de cambios de Claude Code
- Copilot CLI v1.0.92-4
- SDK de GitHub Copilot v1.0.17-preview.4
- MultiMatte (publicación de Feyn)
- Modelo feyninc/multimatte en Hugging Face
- Notas de la versión de ChatGPT Enterprise y Edu