ai-powered-markdown-translatorArtigo traduzido do fr para o pt com gemini-3.8-flash-high.
Na madrugada de sábado para domingo, a Microsoft e a Hugging Face conectaram o ThinkingBox ao OpenEnv: este benchmark repete 507 tarefas de negócios 20 vezes cada e avalia os agentes pelo estado final da base de dados, e a repetição altera a classificação. No domingo, 4 de outubro, três autores descrevem o Exgentic Agent LLM Traces, 10 000 execuções de agentes no formato OpenTelemetry publicadas sob a organização Exgentic no Hub. Em notas breves, o Claude Code 2.1.289 e o Copilot CLI 1.0.92-4 reforçam as suas salvaguardas, a Feyn apresenta o MultiMatte, um modelo de recorte baseado no SAM 3 da Meta, e o ChatGPT Enterprise gere os seus plugins na Admin console desde 1 de outubro.
Microsoft e Hugging Face conectam ThinkingBox ao OpenEnv: 20 tentativas por tarefa, e a classificação muda
3 de outubro — Numa publicação apresentada como conjunta entre a Microsoft e a Hugging Face, Tuhin Kundu (Microsoft) descreve o ThinkingBox, um benchmark que avalia os agentes de IA pelo que deixam na base de dados, e não pelas suas respostas. Construído pela equipa do Microsoft Copilot Studio com a Toloka, não é novo (artigo de investigação de 20 de agosto, conjunto de dados publicado no final de agosto): a novidade é a sua integração com o OpenEnv, a interface aberta de ambientes para agentes alojada pela Hugging Face, e a publicação dos resultados de 18 modelos.
Os seus 507 fluxos de trabalho (workflows) de negócios sintéticos são repetidos 20 vezes cada a partir de um estado limpo, e avaliadores determinísticos comparam o estado final da base com o esperado. Resultados segundo os autores; os seus custos, estimados com base nas tarifas de tabela do OpenRouter (as da Anthropic para o Claude Opus 5.5), são um índice comparativo, não uma fatura:
| Modelo avaliado | pass@1 global | Tarefas bem-sucedidas 20 em cada 20 vezes (em 507) | Custo por tarefa fiável |
|---|---|---|---|
| Claude Opus 5.5 | 67,16 % | 241 | 7,80 dólares |
| Claude Opus 5 | 66,50 % | 241 | 13,30 dólares |
| GPT-5.4 | 65,36 % | 128 | 6,80 dólares |
| GPT-5.6 Sol | 61,91 % | 82 | 9,76 dólares |
| GPT-6 Astra | 58,31 % | 231 | 7,45 dólares |
| Kimi-K3 (pesos abertos) | 57,37 % | 68 | 20,68 dólares |
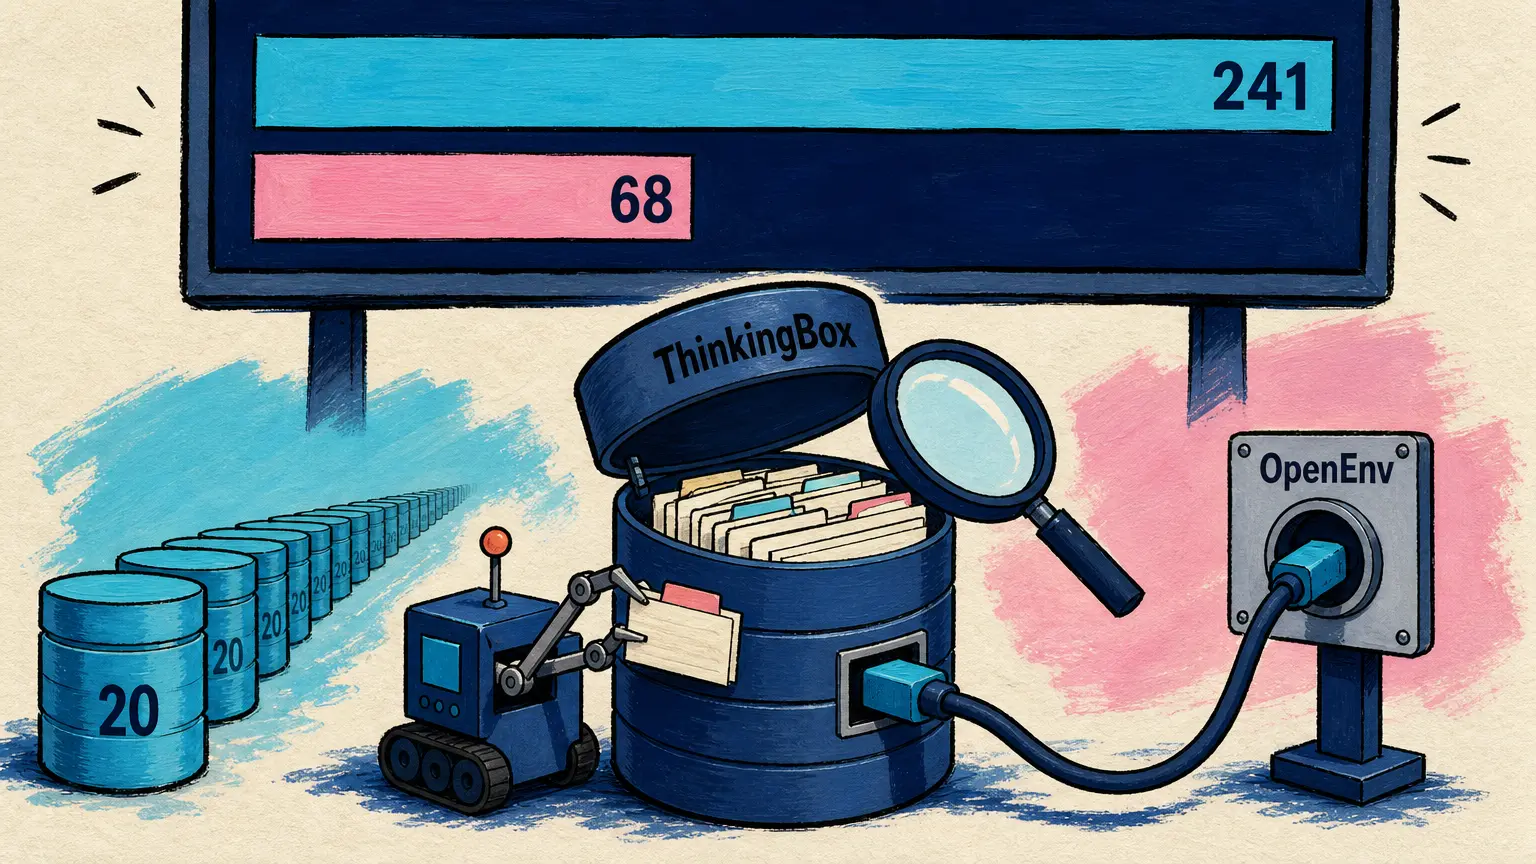
A repetição altera a classificação: o Kimi-K3, o melhor modelo de pesos abertos, resolve 476 das 507 tarefas pelo menos uma vez, mas apenas 68 em cada uma das 20 tentativas, contra 241 tanto para o Claude Opus 5 como para o Claude Opus 5.5. Segundo a equipa, cerca de quatro em cada cinco falhas devem-se ao uso de ferramentas e não ao raciocínio. O código está sob licença MIT, e os dados sob CDLA-Permissive-2.0.
A trajectory is a claim. Database state is the evidence. Repetition is the trust test.
🇵🇹 Uma trajetória é uma afirmação. O estado da base de dados é a prova. A repetição é o teste de confiança. — Publicação da Microsoft e da Hugging Face
🔗 Conjunto de dados ThinkingBox-Bench · ThinkingBox no OpenEnv
Exgentic Agent LLM Traces: 10 000 execuções de agentes preservadas no formato OpenTelemetry
4 de outubro — No blogue comunitário da Hugging Face, Lena Dankin, Elron Bandel e Michal Shmueli-Scheuer apresentam o Exgentic Agent LLM Traces, um conjunto de dados publicado sob a organização Exgentic no Hub: 10 000 execuções de agentes e 242 000 chamadas de modelo, cada uma preservada de acordo com as convenções GenAI do OpenTelemetry, com a pontuação e o custo de cada execução.
Estas execuções cobrem seis benchmarks (SWE-bench, BrowseComp Plus, AppWorld e três variantes do τ²-bench) e até cinco arquiteturas de agentes. Em média, o Claude Opus 4.5 consome 2,4 milhões de tokens por execução, contra 552 000 do GPT-5.2.
Duas ressalvas: os cinco modelos pertencem a gerações anteriores (DeepSeek-V3.2, Kimi-K2.5, GPT-5.2, Claude Opus 4.5 e Gemini 3 Pro), e a publicação apresenta como lançamento do dia um repositório criado a 10 de junho, sem licença declarada no seu cartão descritivo.
🔗 Publicação · Conjunto de dados no Hugging Face
Breves
- Claude Code 2.1.289 — Esta versão com 27 entradas corrige quatro casos em que as regras de permissão deny e ask não se aplicavam; um plugin instalado pelo utilizador já não pode reescrever as descrições das ferramentas de conexão de um servidor MCP gerido, e outras 18 entradas dizem respeito a mods e plugins. 🔗 fonte
- Copilot CLI 1.0.92-4 e SDK Copilot 1.0.17-preview.4 — A CLI, em pré-visualização (última estável: 1.0.91), adiciona os subcomandos
copilot configpara listar, ler, definir e remover uma definição, e já não transmite oGITHUB_TOKENambiente para as shells da sandbox, exceto mediante configuração explícita; o SDK recebe os hooksOnSubagentStarteOnSubagentStop, para enriquecer o primeiro prompt de um subagente e depois inspecionar ou substituir a sua resposta. 🔗 CLI · 🔗 SDK - MultiMatte da Feyn — Este modelo de recorte é guiado por texto: nomeia-se o objeto a manter, o modelo remove o resto, com uma máscara alfa (alpha matte) que reproduz melhor cabelos e áreas desfocadas. Construído sobre o SAM 3 da Meta, ajustado através de um adaptador LoRA, atinge, segundo os autores, 0,901 de S-measure no DIS-VD, contra 0,667 do SAM 3; os seus pesos, sob Apache 2.0 de acordo com a sua ficha, estão online desde 20 de agosto. 🔗 fonte
- Plugins do ChatGPT Enterprise na Admin console — A 1 de outubro, as notas de lançamento Enterprise e Edu anunciaram que os proprietários e administradores de espaços de trabalho ChatGPT Enterprise agora gerem os plugins e os seus mercados (marketplaces) na Admin console, nas páginas Plugins e Marketplaces; as aplicações permanecem em Workspace settings > Apps, com as permissões existentes. 🔗 fonte
O que isto significa
O ThinkingBox muda a pergunta feita a um agente: já não se sabe realizar uma tarefa, mas se a realiza de todas as vezes. Numa tentativa, o Kimi-K3 fica a menos de um ponto do GPT-6 Astra; em vinte, é bem-sucedido em todas as tentativas em apenas 68 tarefas, contra 231. Para quem confia a um agente operações que modificam uma base de dados, é este segundo número que conta, e o benchmark mede-o com base no estado final da base em vez do que o agente diz ter feito.
O custo segue a mesma lógica. Em relação apenas às tarefas bem-sucedidas em cada tentativa, aponta o GPT-5.4 como o mais barato (6,80 dólares por tarefa fiável), e não o GPT-5.6 Sol, apesar de ser o mais barato por tentativa bem-sucedida (0,127 dólares); o Kimi-K3, por sua vez, custa 20,68 dólares por tarefa fiável, três vezes mais do que o GPT-5.4. Estes valores continuam a ser, relembram os autores, um índice comparativo e não uma fatura.
Os autores do Exgentic Agent LLM Traces partem de uma limitação semelhante: um benchmark reduz uma execução a uma pontuação, enquanto o rasto mostra as ferramentas escolhidas, o crescimento do contexto e as recuperações após erro. Com cada chamada preservada num formato padronizado, veem nisso uma forma de depurar um agente face a uma referência, repetir uma etapa com outro modelo ou testar uma infraestrutura de inferência sob uma carga real de agentes; uma equipa já o faz com o inference-perf, a ferramenta de benchmark do SIG Kubernetes, e os seus resultados serão anunciados mais tarde.
Fontes
- Publicação conjunta da Microsoft e da Hugging Face sobre o ThinkingBox
- Conjunto de dados ThinkingBox-Bench no Hugging Face
- Ambiente ThinkingBox na documentação do OpenEnv
- Código do ThinkingBox no GitHub
- Dados do ThinkingBox no GitHub
- Exgentic Agent LLM Traces (blogue da Hugging Face)
- Conjunto de dados Exgentic/agent-llm-traces-v2
- Claude Code v2.1.289
- Changelog do Claude Code
- Copilot CLI v1.0.92-4
- SDK GitHub Copilot v1.0.17-preview.4
- MultiMatte (publicação da Feyn)
- Modelo feyninc/multimatte no Hugging Face
- Notas de lançamento do ChatGPT Enterprise e Edu