ai-powered-markdown-translatorArtikel översatt från fr till sv med gemini-3.8-flash-high.
Natten mellan lördag och söndag anslöt Microsoft och Hugging Face ThinkingBox till OpenEnv: denna testbänk kör om 507 verksamhetsuppgifter 20 gånger vardera och bedömer agenter utifrån databasens sluttillstånd, och upprepningen förändrar rankningen. Söndagen den 4 oktober beskriver tre författare Exgentic Agent LLM Traces, 10 000 agentkörningar i OpenTelemetry-format publicerade under Exgentic-organisationen på Hubben. I korthet förstärker Claude Code 2.1.289 och Copilot CLI 1.0.92-4 sina skyddsräcken, Feyn presenterar MultiMatte, en friläggningsmodell byggd på Metas SAM 3, och ChatGPT Enterprise hanterar sina insticksprogram i Admin console sedan den 1 oktober.
Microsoft och Hugging Face ansluter ThinkingBox till OpenEnv: 20 försök per uppgift, och rankningen ändras
3 oktober — I ett inlägg som presenteras som ett samarbete mellan Microsoft och Hugging Face beskriver Tuhin Kundu (Microsoft) ThinkingBox, en testbänk som bedömer AI-agenter utifrån vad de lämnar efter sig i databasen, inte utifrån deras svar. Den är byggd av Microsoft Copilot Studio-teamet tillsammans med Toloka och är inte ny (forskningsartikel från 20 augusti, dataset publicerat i slutet av augusti): nyheten är integreringen bakom OpenEnv, det öppna gränssnittet för agentmiljöer som driftas av Hugging Face, samt publiceringen av resultat för 18 modeller.
Dess 507 syntetiska affärsarbetsflöden (workflows) körs om 20 gånger vardera från ett rent tillstånd, och deterministiska domare jämför databasens sluttillstånd med det förväntade. Resultat enligt författarna; deras kostnader, uppskattade enligt listpriserna hos OpenRouter (Anthropics priser för Claude Opus 5.5), är ett jämförande index, inte en faktura:
| Utvärderad modell | pass@1 totalt | Lyckade uppgifter 20 av 20 gånger (av 507) | Kostnad per tillförlitlig uppgift |
|---|---|---|---|
| Claude Opus 5.5 | 67,16 % | 241 | 7,80 dollar |
| Claude Opus 5 | 66,50 % | 241 | 13,30 dollar |
| GPT-5.4 | 65,36 % | 128 | 6,80 dollar |
| GPT-5.6 Sol | 61,91 % | 82 | 9,76 dollar |
| GPT-6 Astra | 58,31 % | 231 | 7,45 dollar |
| Kimi-K3 (öppna vikter) | 57,37 % | 68 | 20,68 dollar |
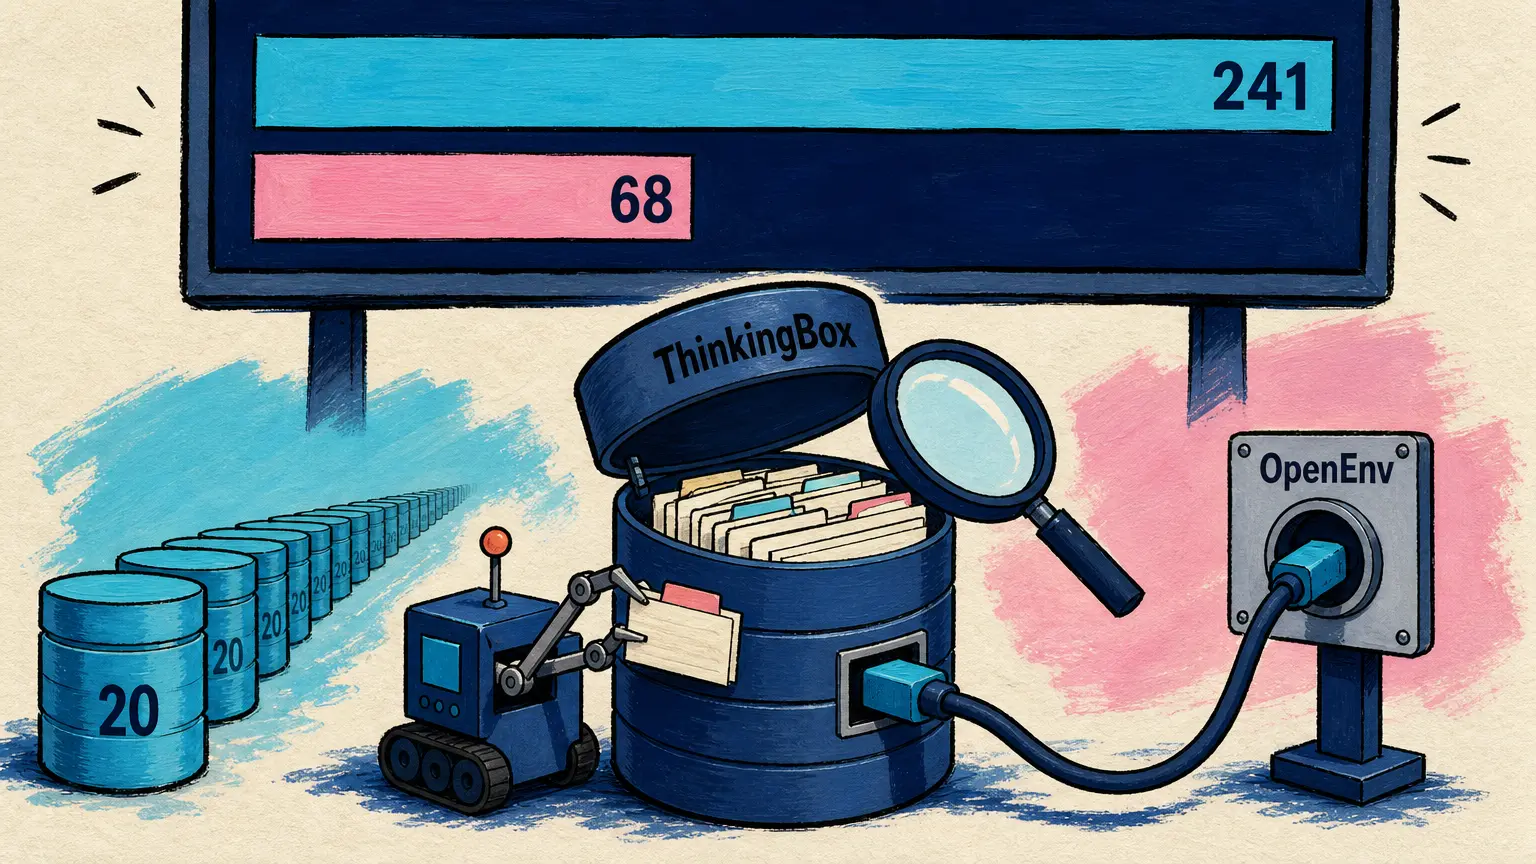
Upprepningen ändrar rankningen: Kimi-K3, den bästa modellen med öppna vikter, löser 476 av de 507 uppgifterna minst en gång, men endast 68 vid vart och ett av de 20 försöken, jämfört med 241 för såväl Claude Opus 5 som Claude Opus 5.5. Enligt teamet beror ungefär fyra av fem misslyckanden på verktygsanvändningen snarare än på resonemanget. Koden är licensierad under MIT, datan under CDLA-Permissive-2.0.
A trajectory is a claim. Database state is the evidence. Repetition is the trust test.
🇸🇪 En bana är ett påstående. Databasens tillstånd är beviset. Upprepning är tillförlitlighetstestet. — Inlägg från Microsoft och Hugging Face
🔗 Datasetet ThinkingBox-Bench · ThinkingBox i OpenEnv
Exgentic Agent LLM Traces: 10 000 agentkörningar bevarade i OpenTelemetry-format
4 oktober — På Hugging Faces communityblogg presenterar Lena Dankin, Elron Bandel och Michal Shmueli-Scheuer Exgentic Agent LLM Traces, ett dataset publicerat under Exgentic-organisationen på Hubben: 10 000 agentkörningar och 242 000 modellanrop, vart och ett bevarat enligt GenAI-konventionerna i OpenTelemetry, med poäng och kostnad för varje körning.
Dessa körningar omfattar sex testbänkar (SWE-bench, BrowseComp Plus, AppWorld och tre varianter av τ²-bench) samt upp till fem agentdesigner. I genomsnitt förbrukar Claude Opus 4.5 2,4 miljoner token per körning, jämfört med 552 000 för GPT-5.2.
Två förbehåll: de fem modellerna tillhör tidigare generationer (DeepSeek-V3.2, Kimi-K2.5, GPT-5.2, Claude Opus 4.5 och Gemini 3 Pro), och inlägget presenterar som en dagsaktuell lansering ett arkiv som skapades den 10 juni, utan någon deklarerad licens på sitt kort.
🔗 Inlägg · Dataset på Hugging Face
I korthet
- Claude Code 2.1.289 — Denna version med 27 ändringspunkter åtgärdar fyra fall där behörighetsreglerna deny och ask inte tillämpades; ett insticksprogram installerat av användaren kan inte längre skriva över verktygsbeskrivningarna för anslutningar från en hanterad MCP-server, och 18 andra punkter berör moddar och insticksprogram. 🔗 källa
- Copilot CLI 1.0.92-4 och Copilot SDK 1.0.17-preview.4 — CLI-verktyget, i förhandsversion (senaste stabila: 1.0.91), lägger till underkommandona
copilot configför att lista, läsa, ställa in och ta bort en inställning, och vidarebefordrar inte längre omgivandeGITHUB_TOKENtill sandlådeskal, såvida det inte uttryckligen konfigurerats; SDK:t får krokarnaOnSubagentStartochOnSubagentStop, för att berika den första prompten för en underagent, och sedan inspektera eller ersätta dess svar. 🔗 CLI · 🔗 SDK - MultiMatte från Feyn — Denna friläggningsmodell styrs av text: man anger namnet på objektet som ska behållas, modellen tar bort resten, med en alfamattning (alpha matte) som bättre återger hår och suddiga områden. Den bygger på Metas SAM 3, finjusterad med en LoRA-adapter, och når enligt författarna ett S-measure på 0,901 på DIS-VD, jämfört med 0,667 för SAM 3; dess vikter, under Apache 2.0 enligt specifikationen, finns tillgängliga online sedan den 20 augusti. 🔗 källa
- ChatGPT Enterprise-insticksprogram i Admin console — Den 1 oktober meddelade versionsanteckningarna för Enterprise och Edu att ägare och administratörer för ChatGPT Enterprise-arbetsytor numera hanterar insticksprogram och deras marknadsplatser (marketplaces) i Admin console, på sidorna Plugins och Marketplaces; applikationer ligger kvar under Workspace settings > Apps, med befintliga behörigheter. 🔗 källa
Vad det innebär
ThinkingBox förändrar frågan som ställs till en agent: inte längre om den kan utföra en uppgift, utan om den utför den varje gång. Vid ett försök ligger Kimi-K3 mindre än en poäng efter GPT-6 Astra; vid tjugo lyckas den varje gång med endast 68 uppgifter, jämfört med 231. För den som anförtror en agent operationer som ändrar en databas är det denna andra siffra som räknas, och testbänken mäter den på databasens sluttillstånd snarare än på vad agenten säger sig ha gjort.
Kostnaden följer samma logik. Sett enbart till de uppgifter som lyckas vid varje försök framstår GPT-5.4 som den billigaste (6,80 dollar per tillförlitlig uppgift), och inte GPT-5.6 Sol, som annars är billigast per lyckat försök (0,127 dollar); Kimi-K3 kostar för sin del 20,68 dollar per tillförlitlig uppgift, tre gånger mer än GPT-5.4. Dessa belopp är, påminner författarna, ett jämförande index och inte en faktura.
Författarna bakom Exgentic Agent LLM Traces utgår från en liknande begränsning: en testbänk reducerar en körning till en poäng, medan spåret visar de valda verktygen, kontextens tillväxt och återhämtningar efter fel. Med varje anrop sparat i ett standardformat ser de möjligheter att felsöka en agent mot en referens, köra om ett steg med en annan modell eller testa en inferensinfrastruktur under verklig agentbelastning; ett team gör redan detta med inference-perf, benchmarkverktyget från Kubernetes SIG, och dess resultat väntas senare.
Källor
- Gemensamt inlägg från Microsoft och Hugging Face om ThinkingBox
- Datasetet ThinkingBox-Bench på Hugging Face
- ThinkingBox-miljön i dokumentationen för OpenEnv
- ThinkingBox-kod på GitHub
- ThinkingBox-data på GitHub
- Exgentic Agent LLM Traces (Hugging Face-bloggen)
- Datasetet Exgentic/agent-llm-traces-v2
- Claude Code v2.1.289
- Ändringslogg för Claude Code
- Copilot CLI v1.0.92-4
- GitHub Copilot SDK v1.0.17-preview.4
- MultiMatte (inlägg från Feyn)
- Modellen feyninc/multimatte på Hugging Face
- Versionsanteckningar för ChatGPT Enterprise och Edu