ai-powered-markdown-translatorArtikel übersetzt aus dem Französischen ins Deutsche mit gemini-3.8-flash-high.
In der Nacht von Samstag auf Sonntag haben Microsoft und Hugging Face ThinkingBox an OpenEnv angebunden: Dieser Benchmark führt 507 geschäftliche Aufgaben jeweils 20-mal aus und bewertet Agenten anhand des finalen Zustands der Datenbank – und diese Wiederholung verändert das Ranking. Am Sonntag, dem 4. Oktober, beschrieben drei Autoren Exgentic Agent LLM Traces: 10.000 Agenten-Ausführungen im OpenTelemetry-Format, veröffentlicht unter der Exgentic-Organisation auf dem Hub. In den Kurzmeldungen verstärken Claude Code 2.1.289 und Copilot CLI 1.0.92-4 ihre Leitplanken, Feyn stellt MultiMatte vor, ein auf SAM 3 von Meta basierendes Freistellungsmodell, und ChatGPT Enterprise verwaltet seine Plugins seit dem 1. Oktober in der Admin console.
Microsoft und Hugging Face binden ThinkingBox an OpenEnv an: 20 Versuche pro Aufgabe, und das Ranking ändert sich
3. Oktober — In einem als gemeinsame Veröffentlichung von Microsoft und Hugging Face vorgestellten Beitrag beschreibt Tuhin Kundu (Microsoft) ThinkingBox: einen Benchmark, der KI-Agenten danach beurteilt, was sie in der Datenbank hinterlassen, und nicht nach ihren Antworten. Entwickelt vom Microsoft Copilot Studio-Team zusammen mit Toloka, ist er nicht neu (Forschungsartikel vom 20. August, Datensatz Ende August veröffentlicht): Das Neue daran ist seine Integration in OpenEnv, die von Hugging Face gehostete offene Schnittstelle für Agentenumgebungen, sowie die Veröffentlichung der Ergebnisse von 18 Modellen.
Seine 507 synthetischen geschäftlichen Workflows (workflows) werden jeweils 20-mal ausgehend von einem sauberen Ausgangszustand wiederholt, und deterministische Evaluatoren vergleichen den Endzustand der Datenbank mit dem erwarteten Zustand. Ergebnisse laut den Autoren; ihre Kosten, geschätzt nach den Listenpreisen von OpenRouter (denen von Anthropic für Claude Opus 5.5), stellen einen Vergleichsindex und keine tatsächliche Rechnung dar:
| Evaluiertes Modell | pass@1 global | 20 von 20 Mal erfolgreiche Aufgaben (von 507) | Kosten pro verlässliche Aufgabe |
|---|---|---|---|
| Claude Opus 5.5 | 67,16 % | 241 | 7,80 Dollar |
| Claude Opus 5 | 66,50 % | 241 | 13,30 Dollar |
| GPT-5.4 | 65,36 % | 128 | 6,80 Dollar |
| GPT-5.6 Sol | 61,91 % | 82 | 9,76 Dollar |
| GPT-6 Astra | 58,31 % | 231 | 7,45 Dollar |
| Kimi-K3 (offene Gewichte) | 57,37 % | 68 | 20,68 Dollar |
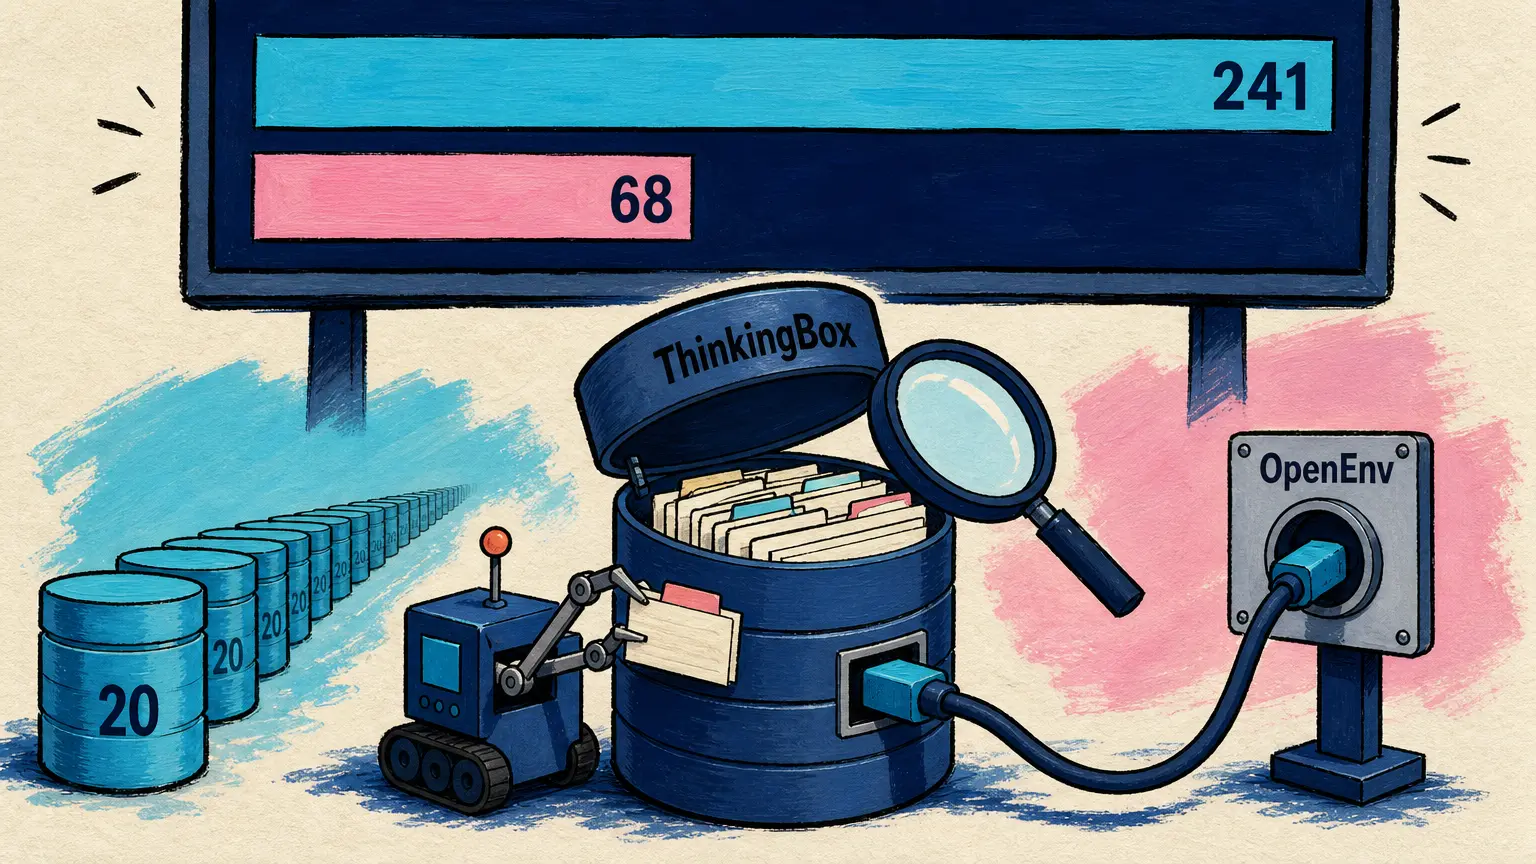
Die Wiederholung verändert das Ranking: Kimi-K3, das beste Modell mit offenen Gewichten, löst 476 der 507 Aufgaben mindestens einmal, jedoch nur 68 bei jedem einzelnen der 20 Versuche – im Vergleich zu 241 sowohl bei Claude Opus 5 als auch bei Claude Opus 5.5. Dem Team zufolge gehen etwa vier von fünf Fehlschlägen eher auf die Nutzung von Tools als auf das logische Schließen (Reasoning) zurück. Der Code steht unter der MIT-Lizenz, die Daten unter CDLA-Permissive-2.0.
A trajectory is a claim. Database state is the evidence. Repetition is the trust test.
🇩🇪 Eine Trajektorie ist eine Behauptung. Der Zustand der Datenbank ist der Beweis. Die Wiederholung ist der Vertrauenstest. — Beitrag von Microsoft und Hugging Face
🔗 ThinkingBox-Bench-Datensatz · ThinkingBox in OpenEnv
Exgentic Agent LLM Traces: 10.000 Agenten-Ausführungen im OpenTelemetry-Format gespeichert
4. Oktober — Im Community-Blog von Hugging Face präsentieren Lena Dankin, Elron Bandel und Michal Shmueli-Scheuer Exgentic Agent LLM Traces, einen Datensatz, der unter der Exgentic-Organisation auf dem Hub veröffentlicht wurde: 10.000 Agenten-Ausführungen und 242.000 Modellaufrufe, jeweils gemäß den GenAI-Konventionen von OpenTelemetry festgehalten, einschließlich der Punktzahl und der Kosten jeder Ausführung.
Diese Ausführungen decken sechs Benchmarks ab (SWE-bench, BrowseComp Plus, AppWorld und drei Varianten von τ²-bench) sowie bis zu fünf Agenten-Architekturen. Im Durchschnitt verbraucht Claude Opus 4.5 2,4 Millionen Tokens pro Ausführung, verglichen mit 552.000 bei GPT-5.2.
Zwei Vorbehalte: Die fünf Modelle stammen aus früheren Generationen (DeepSeek-V3.2, Kimi-K2.5, GPT-5.2, Claude Opus 4.5 und Gemini 3 Pro), und der Beitrag präsentiert ein bereits am 10. Juni erstelltes Repository ohne deklarierte Lizenz auf seiner Modellkarte als heutige Neuerscheinung.
🔗 Beitrag · Datensatz auf Hugging Face
Kurzmeldungen
- Claude Code 2.1.289 — Diese Version mit 27 Einträgen behebt vier Fälle, in denen die Berechtigungsregeln deny und ask nicht angewendet wurden; ein vom Benutzer installiertes Plugin kann die Beschreibungen der Verbindungstools eines verwalteten MCP-Servers nicht mehr überschreiben, und 18 weitere Einträge betreffen Mods und Plugins. 🔗 Quelle
- Copilot CLI 1.0.92-4 und Copilot SDK 1.0.17-preview.4 — Die CLI, als Preview (letzte stabile Version: 1.0.91), fügt die Unterbefehle
copilot confighinzu, um eine Einstellung aufzulisten, zu lesen, zu setzen und zu löschen, und leitet den umgebendenGITHUB_TOKENnicht mehr an Sandbox-Shells weiter, es sei denn, dies ist explizit konfiguriert; das SDK erhält die HooksOnSubagentStartundOnSubagentStop, um den ersten Prompt eines Sub-Agenten anzureichern und anschließend dessen Antwort zu inspizieren oder zu ersetzen. 🔗 CLI · 🔗 SDK - MultiMatte von Feyn — Dieses Freistellungsmodell wird textgesteuert: Man benennt das zu behaltende Objekt, das Modell entfernt den Rest mit einer Alpha-Matte (alpha matte), die Haare und unscharfe Bereiche besser wiedergibt. Basierend auf SAM 3 von Meta und verfeinert durch einen LoRA-Adapter, erreicht es laut den Autoren ein S-Measure von 0,901 auf DIS-VD, verglichen mit 0,667 bei SAM 3; seine Gewichte, laut Modellkarte unter Apache 2.0, sind seit dem 20. August online. 🔗 Quelle
- ChatGPT Enterprise-Plugins in der Admin console — Am 1. Oktober gaben die Enterprise- und Edu-Versionshinweise bekannt, dass Eigentümer und Administratoren von ChatGPT Enterprise-Workspaces Plugins und deren Marktplätze (marketplaces) nun in der Admin console auf den Seiten Plugins und Marketplaces verwalten; Anwendungen verbleiben unter Workspace settings > Apps mit den bestehenden Berechtigungen. 🔗 Quelle
Was das bedeutet
ThinkingBox verändert die Frage, die einem Agenten gestellt wird: nicht mehr, ob er eine Aufgabe erledigen kann, sondern ob er sie jedes Mal erledigt. Bei einem einzigen Versuch liegt Kimi-K3 weniger als einen Punkt hinter GPT-6 Astra; bei zwanzig Versuchen schafft es jedes Mal nur 68 Aufgaben, verglichen mit 231. Für alle, die einem Agenten Operationen anvertrauen, welche eine Datenbank verändern, ist diese zweite Zahl entscheidend – und der Benchmark misst dies am finalen Zustand der Datenbank statt daran, was der Agent vorgibt getan zu haben.
Die Kosten folgen derselben Logik. Bezogen nur auf die Aufgaben, die bei jedem Versuch erfolgreich waren, erweist sich GPT-5.4 als das günstigste Modell (6,80 Dollar pro verlässliche Aufgabe) und nicht GPT-5.6 Sol, das jedoch pro erfolgreichem Versuch am günstigsten ist (0,127 Dollar); Kimi-K3 beläuft sich hingegen auf 20,68 Dollar pro verlässliche Aufgabe, dreimal mehr als GPT-5.4. Diese Beträge bleiben, wie die Autoren betonen, ein Vergleichsindex und keine Rechnung.
Die Autoren von Exgentic Agent LLM Traces gehen von einer ähnlichen Einschränkung aus: Ein Benchmark reduziert eine Ausführung auf einen Score, während der Trace die gewählten Tools, das Anwachsen des Kontexts und Fehlerbehebungen sichtbar macht. Da jeder Aufruf in einem Standardformat gespeichert ist, sehen sie darin eine Möglichkeit, einen Agenten anhand einer Referenz zu debuggen, einen Schritt mit einem anderen Modell erneut auszuführen oder eine Inferenzinfrastruktur unter realer Agentenlast zu testen; ein Team tut dies bereits mit inference-perf, dem Benchmark-Tool der Kubernetes-SIG, und dessen Ergebnisse sollen später bekannt gegeben werden.
Quellen
- Gemeinsamer Beitrag von Microsoft und Hugging Face zu ThinkingBox
- ThinkingBox-Bench-Datensatz auf Hugging Face
- ThinkingBox-Umgebung in der OpenEnv-Dokumentation
- Code von ThinkingBox auf GitHub
- Daten von ThinkingBox auf GitHub
- Exgentic Agent LLM Traces (Hugging Face-Blog)
- Datensatz Exgentic/agent-llm-traces-v2
- Claude Code v2.1.289
- Changelog von Claude Code
- Copilot CLI v1.0.92-4
- GitHub Copilot SDK v1.0.17-preview.4
- MultiMatte (Beitrag von Feyn)
- Modell feyninc/multimatte auf Hugging Face
- Versionshinweise zu ChatGPT Enterprise und Edu