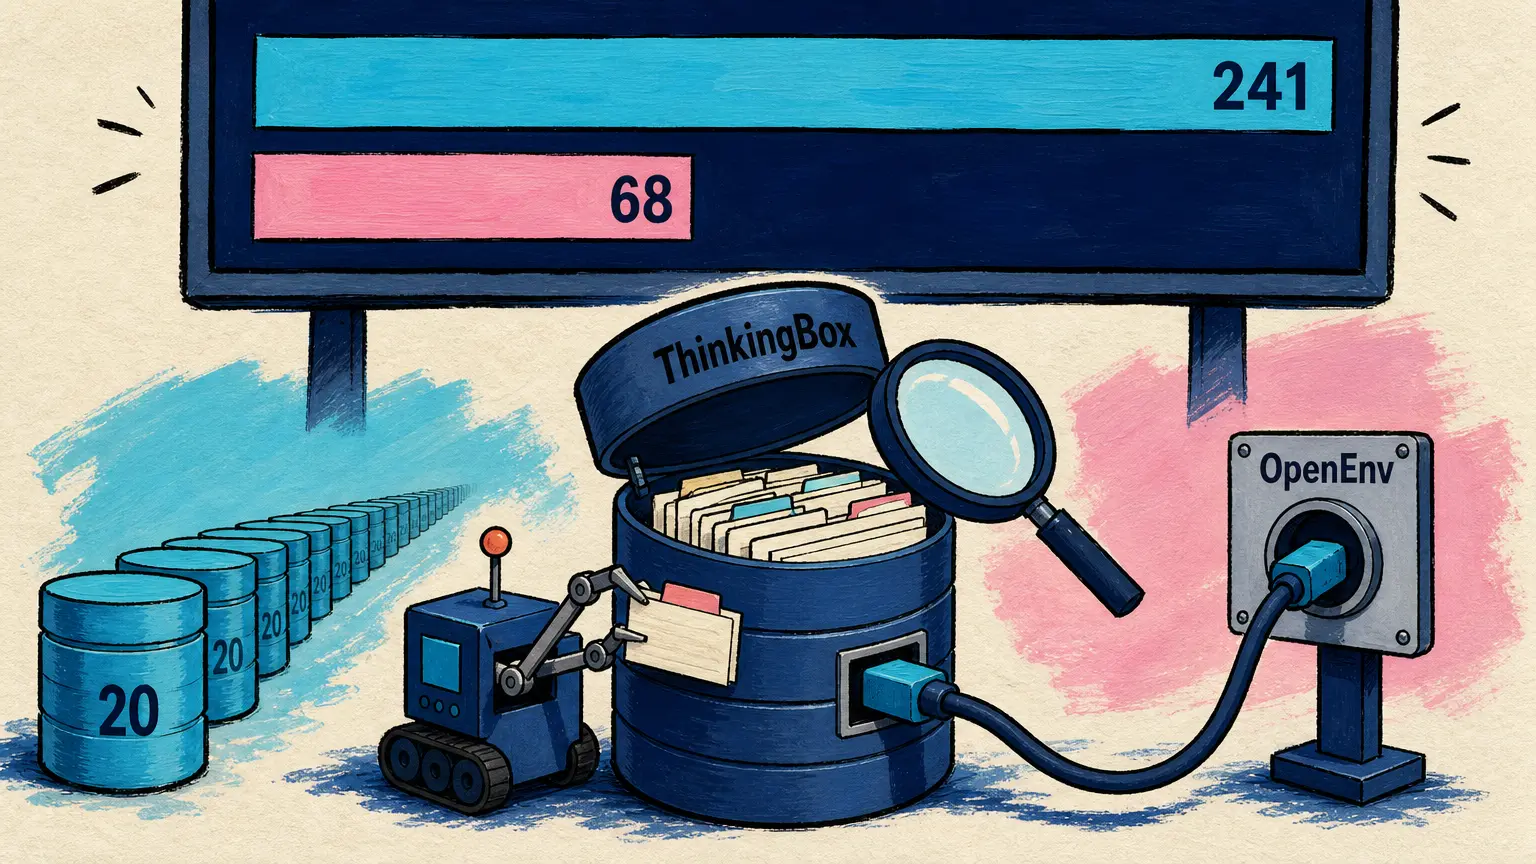
Dans la nuit de samedi à dimanche, Microsoft et Hugging Face ont branché ThinkingBox sur OpenEnv : ce banc rejoue 507 tâches métier 20 fois chacune et juge les agents sur l’état final de la base de données, et la répétition y change le classement. Dimanche 4 octobre, trois auteurs décrivent Exgentic Agent LLM Traces, 10 000 exécutions d’agents au format OpenTelemetry publiées sous l’organisation Exgentic du Hub. En brèves, Claude Code 2.1.289 et Copilot CLI 1.0.92-4 renforcent leurs garde-fous, Feyn présente MultiMatte, un modèle de détourage bâti sur SAM 3 de Meta, et ChatGPT Enterprise gère ses plugins dans l’Admin console depuis le 1er octobre.
Microsoft et Hugging Face branchent ThinkingBox sur OpenEnv : 20 essais par tâche, et le classement change
3 octobre — Dans un billet présenté comme commun à Microsoft et Hugging Face, Tuhin Kundu (Microsoft) décrit ThinkingBox, un banc qui juge les agents d’IA sur ce qu’ils laissent dans la base de données, pas sur leurs réponses. Construit par l’équipe Microsoft Copilot Studio avec Toloka, il n’est pas neuf (article de recherche du 20 août, jeu de données publié fin août) : la nouveauté est son passage derrière OpenEnv, l’interface ouverte d’environnements pour agents hébergée par Hugging Face, et la publication des résultats de 18 modèles.
Ses 507 flux de travail (workflows) métier synthétiques sont rejoués 20 fois chacun depuis un état propre, et des juges déterministes comparent l’état final de la base à celui attendu. Résultats selon les auteurs ; leurs coûts, estimés d’après les tarifs catalogue d’OpenRouter (ceux d’Anthropic pour Claude Opus 5.5), sont un indice comparatif, pas une facture :
| Modèle évalué | pass@1 global | Tâches réussies 20 fois sur 20 (sur 507) | Coût par tâche fiable |
|---|---|---|---|
| Claude Opus 5.5 | 67,16 % | 241 | 7,80 dollars |
| Claude Opus 5 | 66,50 % | 241 | 13,30 dollars |
| GPT-5.4 | 65,36 % | 128 | 6,80 dollars |
| GPT-5.6 Sol | 61,91 % | 82 | 9,76 dollars |
| GPT-6 Astra | 58,31 % | 231 | 7,45 dollars |
| Kimi-K3 (poids ouverts) | 57,37 % | 68 | 20,68 dollars |
La répétition change le classement : Kimi-K3, meilleur modèle à poids ouverts, résout 476 des 507 tâches au moins une fois, mais 68 seulement à chacun des 20 essais, contre 241 pour Claude Opus 5 comme pour Claude Opus 5.5. Selon l’équipe, environ quatre échecs sur cinq tiennent à l’usage des outils plutôt qu’au raisonnement. Le code est sous licence MIT, les données sous CDLA-Permissive-2.0.
A trajectory is a claim. Database state is the evidence. Repetition is the trust test.
🇫🇷 Une trajectoire est une affirmation. L’état de la base de données est la preuve. La répétition est le test de confiance. — Billet de Microsoft et Hugging Face
🔗 Jeu de données ThinkingBox-Bench · ThinkingBox dans OpenEnv
Exgentic Agent LLM Traces : 10 000 exécutions d’agents conservées au format OpenTelemetry
4 octobre — Sur le blog communautaire de Hugging Face, Lena Dankin, Elron Bandel et Michal Shmueli-Scheuer présentent Exgentic Agent LLM Traces, un jeu de données publié sous l’organisation Exgentic du Hub : 10 000 exécutions d’agents et 242 000 appels de modèle, chacun conservé selon les conventions GenAI d’OpenTelemetry, avec le score et le coût de chaque exécution.
Ces exécutions couvrent six bancs (SWE-bench, BrowseComp Plus, AppWorld et trois variantes de τ²-bench) et jusqu’à cinq conceptions d’agent. En moyenne, Claude Opus 4.5 consomme 2,4 millions de tokens par exécution, contre 552 000 pour GPT-5.2.
Deux réserves : les cinq modèles sont de générations antérieures (DeepSeek-V3.2, Kimi-K2.5, GPT-5.2, Claude Opus 4.5 et Gemini 3 Pro), et le billet présente comme une sortie du jour un dépôt créé le 10 juin, sans licence déclarée dans sa fiche.
🔗 Billet · Jeu de données sur Hugging Face
Brèves
- Claude Code 2.1.289 — Cette version de 27 entrées corrige quatre cas où les règles de permission deny et ask ne s’appliquaient pas ; un plugin installé par l’utilisateur ne peut plus réécrire les descriptions des outils de connexion d’un serveur MCP géré, et 18 autres entrées portent sur les mods et les plugins. 🔗 source
- Copilot CLI 1.0.92-4 et SDK Copilot 1.0.17-preview.4 — La CLI, en préversion (dernière stable : 1.0.91), ajoute les sous-commandes
copilot configpour lister, lire, définir et supprimer un réglage, et ne transmet plus leGITHUB_TOKENambiant aux shells du bac à sable, sauf configuration explicite ; le SDK reçoit les hooksOnSubagentStartetOnSubagentStop, pour enrichir le premier prompt d’un sous-agent, puis inspecter ou remplacer sa réponse. 🔗 CLI · 🔗 SDK - MultiMatte de Feyn — Ce modèle de détourage se guide par le texte : on nomme l’objet à garder, le modèle retire le reste, avec un masque alpha (alpha matte) qui rend mieux cheveux et zones floues. Bâti sur SAM 3 de Meta, affiné par un adaptateur LoRA, il atteint selon les auteurs 0,901 de S-measure sur DIS-VD, contre 0,667 pour SAM 3 ; ses poids, sous Apache 2.0 selon leur fiche, sont en ligne depuis le 20 août. 🔗 source
- Plugins de ChatGPT Enterprise dans l’Admin console — Le 1er octobre, les notes de version Enterprise et Edu ont annoncé que les propriétaires et administrateurs d’espaces ChatGPT Enterprise gèrent désormais les plugins et leurs places de marché (marketplaces) dans l’Admin console, pages Plugins et Marketplaces ; les applications restent dans Workspace settings > Apps, avec les permissions existantes. 🔗 source
Ce que ça signifie
ThinkingBox change la question posée à un agent : non plus s’il sait accomplir une tâche, mais s’il l’accomplit à chaque fois. Sur un essai, Kimi-K3 se tient à moins d’un point de GPT-6 Astra ; sur vingt, il ne réussit à tous les coups que 68 tâches, contre 231. Pour qui confie à un agent des opérations qui modifient une base de données, c’est ce second chiffre qui compte, et le banc le mesure sur l’état final de la base plutôt que sur ce que l’agent dit avoir fait.
Le coût suit la même logique. Rapporté aux seules tâches réussies à chaque essai, il désigne GPT-5.4 comme le moins cher (6,80 dollars par tâche fiable), et non GPT-5.6 Sol, pourtant le moins cher par essai réussi (0,127 dollar) ; Kimi-K3 revient, lui, à 20,68 dollars par tâche fiable, trois fois plus que GPT-5.4. Ces montants restent, rappellent les auteurs, un indice comparatif et non une facture.
Les auteurs d’Exgentic Agent LLM Traces partent d’une limite voisine : un banc réduit une exécution à un score, quand la trace montre les outils choisis, la croissance du contexte et les reprises après erreur. Avec chaque appel conservé dans un format standard, ils y voient de quoi déboguer un agent face à une référence, rejouer une étape avec un autre modèle ou tester une infrastructure d’inférence sous une vraie charge d’agents ; une équipe le fait déjà avec inference-perf, l’outil de banc du SIG Kubernetes, et ses résultats sont annoncés plus tard.
Sources
- Billet commun de Microsoft et Hugging Face sur ThinkingBox
- Jeu de données ThinkingBox-Bench sur Hugging Face
- Environnement ThinkingBox dans la documentation d’OpenEnv
- Code de ThinkingBox sur GitHub
- Données de ThinkingBox sur GitHub
- Exgentic Agent LLM Traces (blog Hugging Face)
- Jeu de données Exgentic/agent-llm-traces-v2
- Claude Code v2.1.289
- Changelog de Claude Code
- Copilot CLI v1.0.92-4
- SDK GitHub Copilot v1.0.17-preview.4
- MultiMatte (billet de Feyn)
- Modèle feyninc/multimatte sur Hugging Face
- Notes de version ChatGPT Enterprise et Edu