ai-powered-markdown-translatorलेख का fr से hi में अनुवाद gpt-5.6-sol के साथ किया गया।
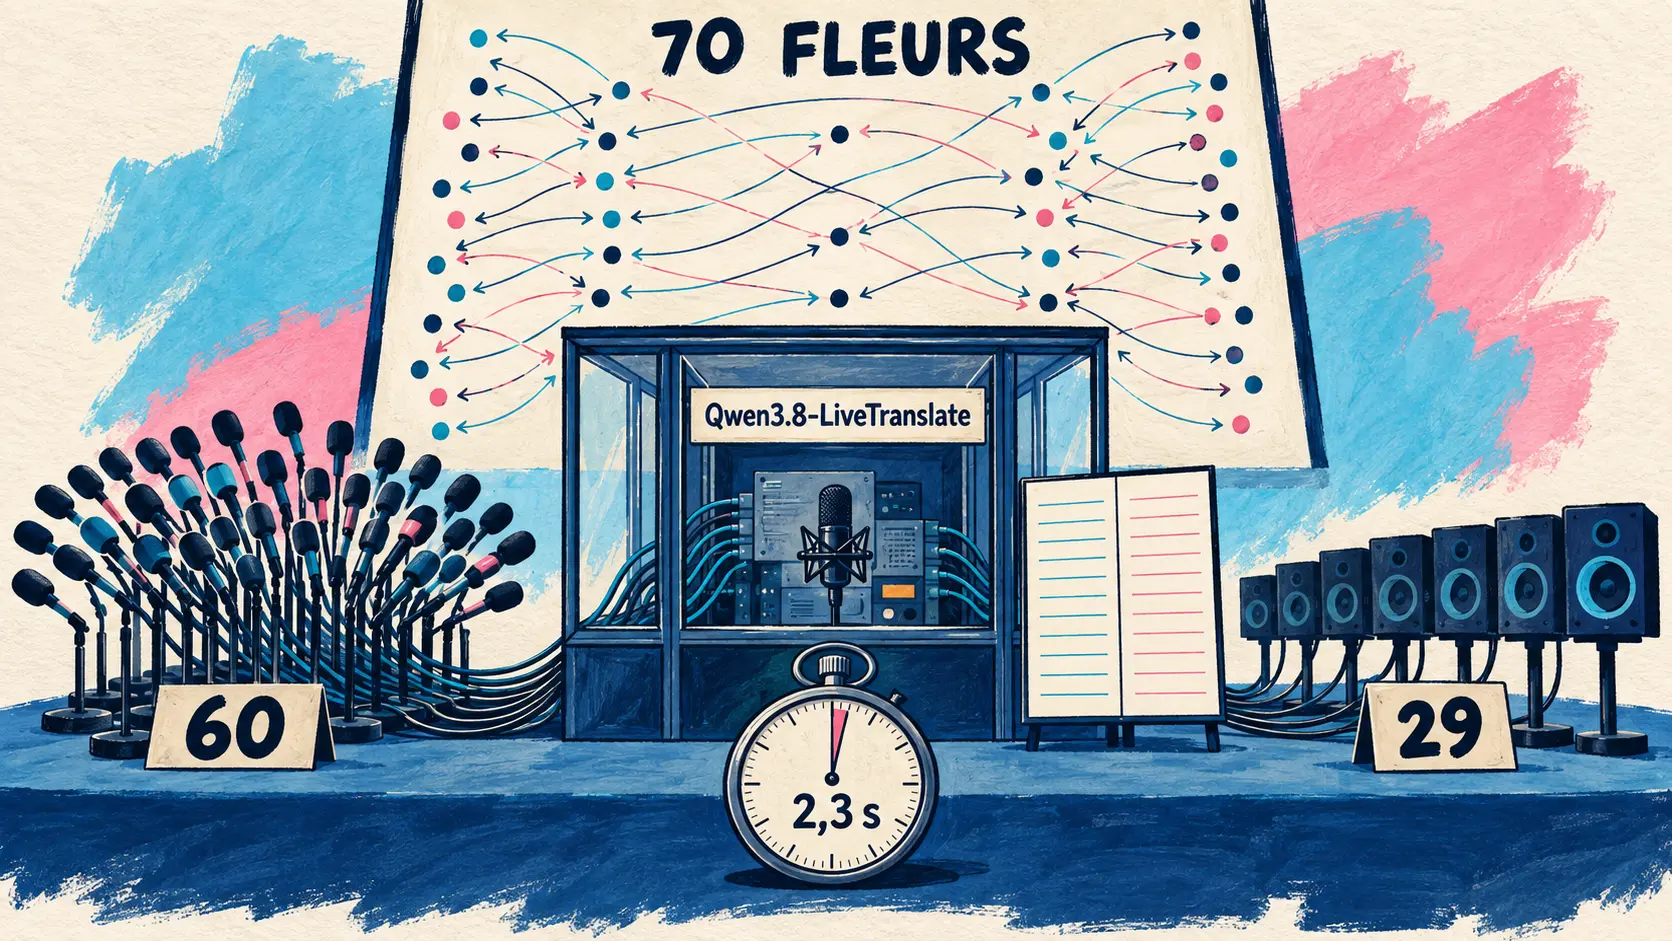
इस शनिवार किसी भी प्रयोगशाला ने खुले वज़न वाला मॉडल प्रकाशित नहीं किया: न नौ दिनों से मौन DeepSeek ने, न Meta, न Ai2 और न Sakana ने। दिन की एकमात्र रिलीज़ एक बंद API मॉडल, Qwen3.8-LiveTranslate है, जो समकालिक दुभाषिया सेवा की विलंबता घटाकर 2.3 सेकंड कर देता है। बाकी सब कुछ व्यावहारिक विशेषज्ञों से आया है: Hugging Face के सामुदायिक ब्लॉग पर ग्यारह लेख, जो मॉडल नहीं बल्कि माप प्रस्तुत करते हैं—उत्पादन में प्रीफ़िक्स कैश, प्रमाणित निर्णय, क्वांटाइज़ेशन की लागत और पुनः-रैंकिंग की गुणवत्ता।
Qwen3.8-LiveTranslate, 2.3 सेकंड से कम में समकालिक दुभाषिया सेवा
19 सितंबर — Qwen ने अपना रियल-टाइम समकालिक दुभाषिया मॉडल Qwen3.8-LiveTranslate प्रस्तुत किया। Interleave आर्किटेक्चर ऑडियो और टेक्स्ट को एक ही परस्पर गुँथी धारा के रूप में संसाधित करता है, जिसमें पहले सुना गया ऑडियो और पहले तैयार किया गया अनुवाद कैश करके दोबारा उपयोग किया जाता है। इससे बेहतर गुणवत्ता के साथ औसत विलंबता (average lagging, LAAL) 2.8 से घटकर 2.3 सेकंड हो जाती है।
यह इंजन हाइब्रिड मिश्रण-विशेषज्ञों (Hybrid-MoE) पर आधारित दो Thinker-Talker मॉड्यूल का समूह है: Thinker वीडियो, ऑडियो, स्रोत टेक्स्ट और अनुवाद को समयानुसार क्रमबद्ध एक ही कारणात्मक अनुक्रम में रखता है; इसके बाद Talker ऐसी आवाज़ संश्लेषित करता है जो मूल वक्ता की ध्वनि-विशेषता बनाए रखती है। इसके साथ तीन क्षमताएँ हैं: रियल-टाइम वक्ता पृथक्करण (real-time speaker separation), समकालिक द्विभाषी प्रदर्शन और लंबे संदर्भ में अर्थ-संदेह निवारण।
भाषाई कवरेज के बारे में लेख और घोषणा संदेश अलग-अलग जानकारी देते हैं: संदेश एक साथ 60 भाषाओं की बात करता है, जबकि लेख ऑडियो इनपुट और टेक्स्ट आउटपुट के लिए 60 भाषाएँ, लेकिन ऑडियो आउटपुट के लिए केवल 29 भाषाएँ बताता है। लेख के आँकड़े ही प्रामाणिक माने गए हैं। मूल्यांकन Omnilingua-MSpeaker पर 14 भाषा-दिशाओं में और सार्वजनिक FLEURS डेटासेट पर 70 दिशाओं में किए गए। मॉडल का उपयोग DashScope के माध्यम से API द्वारा होता है: इसके वज़न खोलने की कोई घोषणा नहीं की गई है।
| मापा गया तत्व | घोषित मान |
|---|---|
| औसत विलंबता (LAAL) | 2.3 s, पिछली पीढ़ी के 2.8 s की तुलना में |
| ऑडियो इनपुट, टेक्स्ट आउटपुट की भाषाएँ | 60 |
| ऑडियो आउटपुट की भाषाएँ | 29 |
| सार्वजनिक बहुभाषी मूल्यांकन | FLEURS, 70 भाषा-दिशाएँ |
| API में मॉडल का नाम | qwen3.8-livetranslate-flash-realtime |
Built on an Interleave architecture, it improves faithfulness, fluency, and conciseness while reducing average lagging (LAAL) from 2.8s to 2.3s across 60 languages.
🇮🇳 Interleave आर्किटेक्चर पर आधारित यह मॉडल 60 भाषाओं में औसत विलंबता (LAAL) को 2.8 s से घटाकर 2.3 s करते हुए विश्वसनीयता, प्रवाह और संक्षिप्तता में सुधार करता है। — X पर @Alibaba_Qwen
🔗 Qwen3.8-LiveTranslate का लेख
खुले मॉडलों का मापन: एक ही दिन प्रकाशित तीन अध्ययन
Hugging Face के सामुदायिक ब्लॉग पर प्रकाशित तीन स्वतंत्र लेख एक ही विषय को तीन दृष्टिकोणों से मापते हैं: वास्तविक परिस्थितियों में एक खुले मॉडल का मूल्य क्या है।
उत्पादन के चौदह दिन: प्रीफ़िक्स कैश ने 27 अरब पैरामीटर वाले मॉडल का भविष्य तय किया
19 सितंबर — 13.9 दिनों तक दो GeForce RTX 5090 कार्डों ने NVFP4 में क्वांटाइज़ किए गए Qwen3.8-27B को उस एजेंट इंजन पर चलाया जिसे Scalably वास्तविक ग्राहकों के लिए संचालित करता है। प्रत्येक आँकड़ा /metrics एंडपॉइंट से पढ़ा गया काउंटर है: 28 097 पूर्ण अनुरोध, 860.6 मिलियन इनपुट टोकन और शून्य परित्याग। प्रॉम्प्ट की माध्यिका 6 466 टोकन और 99वाँ प्रतिशतक 183 800 होने पर प्रीफ़िल के 82.6% टोकन कैश से आते हैं। और डिकोडिंग में दोगुना तेज़ Nex-N2.5-mini वास्तविक निर्णयों को दोबारा चलाने पर अपनी जगह खो बैठा: अस्वीकृत टूल कॉल के बाद वह 20 में से केवल 1 मामले में सँभलता है, जबकि दूसरा मॉडल 20 में से 12 मामलों में।
The short version: on agent traffic the prefix cache decides whether a 27B model keeps up, the scheduler flags matter more than the kernels, and a faster mixture-of-experts checkpoint lost the job on behaviour, not speed.
🇮🇳 संक्षेप में: एजेंट ट्रैफ़िक में प्रीफ़िक्स कैश तय करता है कि 27 अरब पैरामीटर वाला मॉडल माँग की गति बनाए रख पाएगा या नहीं, शेड्यूलर के विकल्प कंप्यूटेशन कर्नेल से अधिक मायने रखते हैं, और विशेषज्ञों के मिश्रण वाला एक तेज़ चेकपॉइंट अपनी गति के कारण नहीं, बल्कि अपने व्यवहार के कारण अपनी जगह खो बैठा। — Hugging Face ब्लॉग पर pavle-scalably
AmberTrace ने 1 350 प्रमाणित निर्णयों पर 19 खुले मॉडलों को अंक दिए
18 सितंबर — जब कोई मॉडल स्वीकार या अस्वीकार करने का निर्णय लेता है, तो प्रश्न केवल यह नहीं होता कि वह कितनी बार गलती करता है, बल्कि यह भी होता है कि गलती किस दिशा में है। AmberTrace Labs ने खुले वज़न वाले 19 मॉडलों का ऐसे 1 350 आइटम पर मूल्यांकन किया, जिनकी सही कार्रवाई प्रमाण द्वारा सत्यापित थी। परिवार के आधार पर समूहीकरण रैंकिंग से अधिक बताता है: रीजनिंग सक्रिय होने पर औसत 0.960; रीजनिंग में सक्षम लेकिन विकल्प बंद होने पर 0.909; रीजनिंग के बिना 0.805। रीजनिंग सक्रिय और निष्क्रिय करने के बीच का अंतर बहुत अलग आकार वाले मॉडलों के बीच के अंतर से अधिक है। एक नमूना, तापमान 0: लेखक अपनी सीमाएँ स्पष्ट करता है।
| मूल्यांकित मॉडल | प्रयोगशाला | समग्र स्कोर | सटीकता | अनुमतिपरक त्रुटि |
|---|---|---|---|---|
| Qwen3.8-27B (रीजनिंग) | Alibaba | 0.974 | 95.5% | 0.0% |
| Muse-Glimmer-30B | Meta | 0.960 | 94.0% | 3.1% |
| OLMo-3-32B-Think | Ai2 | 0.947 | 93.8% | 3.3% |
| Qwen3.8-27B | Alibaba | 0.937 | 91.3% | 6.3% |
🔗 खुले वज़न वाले निर्णय मॉडलों में त्रुटि की दिशा
8 से 2 बिट तक: सटीकता में 1.3 अंक, और प्रकृति में कोई बदलाव नहीं
19 सितंबर — अगले दिन AmberTrace ने यही प्रोटोकॉल एक प्रश्न पर लागू किया: क्वांटाइज़ करने से हम क्या खोते हैं? Qwen3.6-27B को Q8_0 से Q2_K तक छह GGUF स्तरों पर चलाया गया, फिर उन्हीं 1 350 आइटम पर मूल्यांकित किया गया। परिणाम आम धारणा के विपरीत है: सटीकता 8 बिट पर 90.9% से घटकर 2 बिट पर 89.6% होती है, यानी संख्यात्मक परिशुद्धता चार गुना घटाने पर केवल 1.3 अंक की कमी। सबसे रोचक आँकड़ा वह है जो बदलता नहीं: त्रुटियों का चिह्नित झुकाव स्थिर रहता है और निर्धारण गुणांक 0.01 है। क्वांटाइज़ेशन त्रुटियों की संख्या बदलता है, उनकी प्रकृति नहीं। लेखक चेतावनी देता है कि यह प्रारंभिक अध्ययन है।
| क्वांटाइज़ेशन | सटीकता | अनुमतिपरक त्रुटि (महत्त्वपूर्ण पट्टी) | चिह्नित झुकाव |
|---|---|---|---|
| 8 बिट | 90.9% | 5.2% | −0.024 |
| 5 बिट | 91.3% | 4.5% | −0.029 |
| 4 बिट | 90.2% | 6.3% | −0.018 |
| 2 बिट | 89.6% | 6.3% | −0.024 |
🔗 क्वांटाइज़ेशन और निर्णयों की सुरक्षा-दिशा
jev-reranker उम्मीदवार दस्तावेज़ों में से 92% हटाकर भी रैंकिंग सुधारता है
19 सितंबर — Yuichi Tateno ने jev-reranker प्रकाशित किया, जो एक Python लाइब्रेरी है। यह खोज परिणामों को दोबारा क्रमबद्ध करने और विशेष रूप से उन दस्तावेज़ों को हटाने के लिए TypeSafe.AI के संरचित निर्णय मॉडल Jev पर निर्भर करती है जो उत्तर देने में सहायक नहीं होंगे। तर्क टोकन की बचत से आगे जाता है: फ़िल्टरिंग अनुप्रयोग को जनरेशन से पहले निर्णय लेने देती है। NanoHotpotQA पर फ़िल्टरिंग प्रत्येक अनुरोध के लिए केवल 7.62 दस्तावेज़ रखते हुए 0.975 nDCG@10 प्राप्त करती है, जबकि 100 दस्तावेज़ रखने वाली हाइब्रिड खोज का स्कोर 0.833 है: संदर्भ में कमी ही इसे उपयोगी बनाती है।
सबसे रोचक अवलोकन कहीं और है: निर्णय का यही मॉडल उसी दिन एक दूसरे स्वतंत्र लेख में दिखाई देता है, जहाँ Javad Taghia इसे एक अन्य बेंचमार्क पर एजेंट की मेमोरी को दोबारा क्रमबद्ध करने के लिए उपयोग करते हैं।
| रैंकिंग विधि | सीमा | nDCG@10 | प्रत्येक अनुरोध में रखे गए दस्तावेज़ |
|---|---|---|---|
| हाइब्रिड खोज | — | 0.833 | 100 |
| पुनः-रैंकिंग | 0.0 | 0.969 | 100 |
| प्रासंगिकता फ़िल्टरिंग | 0.2 | 0.975 | 7.62 (92.38% हटाए गए) |
Metro-ASR-Small, लैपटॉप प्रोसेसर पर मिस्री अरबी के लिए 61 मिलियन पैरामीटर
19 सितंबर — Whisper-large-v3 में 1.5 अरब पैरामीटर और Meta के OmniASR-LLM में 7 अरब पैरामीटर हैं: सभी को ग्राफ़िक्स कार्ड चाहिए। Metro-ASR-Small में 61.6 मिलियन पैरामीटर हैं, यह 235 MB में समा जाता है और मिस्री अरबी, अंग्रेज़ी तथा दोनों के बीच भाषा-बदलाव का चार प्रोसेसर थ्रेड पर रियल टाइम से 33 से 66 गुना तेज़ लिप्यंतरण करता है—यह तालिका की सीमा है, जिसे लेख का गद्य 50 गुना बताकर पूर्णांकित करता है। यह लेख घोषणा नहीं बल्कि पड़ताल है: जब डेटा और पैरामीटर सीमित हों, तो सटीकता कहाँ से आती है? ध्वनिक मॉडल से उतनी नहीं, जितना समझा जाता है। दूसरा साधन 6.4 GB का वैकल्पिक KenLM भाषा हेड है: ध्वनिक मॉडल से सत्ताईस गुना बड़ा।
| बीम की चौड़ाई | शब्द त्रुटि दर | डिकोडिंग समय |
|---|---|---|
| ग्रीडी डिकोडिंग | 30.0% | 5.9 ms |
| 100 | 24.3% | 128 ms |
| 400 | 24.1% | 351 ms |
🔗 61 मिलियन पैरामीटर वाला CTC मॉडल क्या सीख सकता है और क्या नहीं
Claude Code 2.1.278 ऑटो मोड क्लासिफ़ायर को फिर सर्वर की ओर ले जाता है और उसका शुल्क लेना बंद करता है
19 सितंबर — ऑटो मोड में एक क्लासिफ़ायर संवेदनशील कार्रवाइयों के निष्पादन से पहले उनकी जाँच करता है; अब तक ये सत्यापन प्रति टोकन शुल्क वाले मॉडल कॉल थे। अब सर्वर इन्हें सत्र के अनुरोधों के अंतर्गत बिना अतिरिक्त शुल्क के करता है। यह Claude API, Enterprise, Bedrock, Vertex और Foundry के लिए डिफ़ॉल्ट है तथा /status में Auto mode server पंक्ति के साथ दिखाई देता है। फ़ॉलबैक से सावधान रहें: safeguards फ़ील्ड छोड़ने वाला गेटवे सूचना दिखाने के बाद Claude Code को उसके शुल्क वाले स्थानीय क्लासिफ़ायर पर भेज देता है।
इस बदलाव को इसके वास्तविक स्वरूप में रेखांकित करना आवश्यक है: यह 15 सितंबर के संस्करण 2.1.273 के ठीक उलट है, जिसने Bedrock, Vertex और Foundry पर स्थानीय क्लासिफ़ायर को डिफ़ॉल्ट बनाया था। चार दिनों में वापसी।
We’re changing auto mode to no longer charge for classifier requests in Claude Code. However, this session isn’t eligible.
🇮🇳 हम ऑटो मोड में बदलाव कर रहे हैं ताकि Claude Code में क्लासिफ़ायर अनुरोधों के लिए अब शुल्क न लिया जाए। हालाँकि, यह सत्र इसके लिए पात्र नहीं है। — Claude Code दस्तावेज़, शुल्क वाले फ़ॉलबैक की स्थिति में दिखाई गई सूचना
🔗 Claude Code 2.1.278 रिलीज़ नोट्स
कोडिंग टूल अपडेट हुए: गायब होता API फ़ील्ड और अधिक मज़बूत होता स्यूडो-टर्मिनल
Devin: Azure DevOps Server, MCP पुनः-कनेक्शन और अब null लौटाने वाला total फ़ील्ड
18 सितंबर — Cognition द्वारा प्रकाशित रिलीज़ नोट्स की शृंखला एजेंट इंजन को नहीं, बल्कि प्रशासन और एंटरप्राइज़ कनेक्शनों को प्रभावित करती है। सबसे महत्त्वपूर्ण तथ्य कोई नई सुविधा नहीं, बल्कि एक असंगत बदलाव है: Enterprise API के ऑडिट लॉग की सूची में total फ़ील्ड अब भरा नहीं जाता और null लौटाता है; पृष्ठांकन को has_next_page और end_cursor के माध्यम से किया जाना चाहिए। इस काउंटर पर निर्भर कोई भी कॉलिंग कोड काम करना बंद कर देता है। बाकी बदलाव सुविधाएँ जोड़ते हैं: Azure DevOps Server 2020 और 2022 के कलेक्शन अब व्यक्तिगत एक्सेस टोकन से स्वीकार किए जाते हैं, जबकि पहले केवल क्लाउड संस्करण समर्थित था; प्रत्येक MCP सर्वर को Reconnect कार्रवाई मिलती है, जो अनइंस्टॉल किए बिना प्रमाणीकरण दोबारा चलाती है; ActiveCampaign और Grafana (OAuth) कैटलॉग में शामिल होते हैं; सत्रों को स्रोत के आधार पर फ़िल्टर किया जा सकता है और स्क्रीन रिकॉर्डिंग 60 फ़्रेम प्रति सेकंड तक पहुँचती है।
Gemini CLI: सुरक्षा सुधार के बिना, स्यूडो-टर्मिनल पर केंद्रित nightly
19 सितंबर — Gemini CLI के nightly चैनल ने 03:25 बजे संस्करण v0.62.0-nightly.20260919.gcfbcaa8df प्रकाशित किया, जिसमें पाँच सुधार और कोई सुरक्षा परिवर्तन नहीं है—यह पिछली nightly रिलीज़ की शृंखला से अलग है। दो सुधार स्यूडो-टर्मिनल से संबंधित हैं: ConPTY प्रक्रियाओं के निकास जीवनचक्र का समन्वय—जो स्यूडो-टर्मिनल का Windows कार्यान्वयन है—और फिर टर्मिनल बफ़र की मेमोरी प्रबंधन। अन्य तीन परेशानियाँ ठीक करते हैं: अनुरोध रद्द करते समय दिखाई देने वाले AbortError लॉग, VS Code एक्सटेंशन में तुलना टैब बंद करने पर खो जाने वाला टर्मिनल फ़ोकस और अमान्य एंकर की ओर जाने वाला प्रमाणीकरण दस्तावेज़ लिंक। सार्वजनिक चैनल अपरिवर्तित हैं: stable पर v0.60.0 और preview पर v0.61.0-preview.0।
🔗 19 सितंबर की nightly के रिलीज़ नोट्स
Copilot code review अपनी रिपोर्ट को नया रूप देकर सामान्य उपलब्धता में आया
18 सितंबर — GitHub ने pull request पर Copilot code review द्वारा छोड़ी जाने वाली रिपोर्ट के नए स्वरूप को सामान्य उपलब्धता में जारी किया। सारांश टिप्पणी वर्तमान मूल्यांकन और समीक्षा-प्रयास का स्तर दिखाती है तथा निष्कर्षों को तीन समूहों में बाँटती है, जिनमें प्रत्येक के साथ उसकी गंभीरता और इनलाइन टिप्पणी का लिंक होता है। commits के क्रम में सारांश खुद को दोबारा लिखने के बजाय प्रगति को बनाए रखता है। 11 सितंबर को प्रस्तुत स्वतः-समाधान सुविधा का विस्तार किया गया है: किसी समस्या को खुला रखने का अनुरोध करने वाले उत्तर का पालन किया जाता है, और स्वतः समाधान अपना कारण—Won’t Fix या Incorrect—बताता है; यानी मौन रूप से बंद करने के बजाय तर्कसंगत और चुनौती दिए जा सकने योग्य निर्णय।
| निष्कर्षों का समूह | इसमें क्या शामिल है |
|---|---|
| Open | अनसुलझी समस्याएँ, नए commit द्वारा जोड़े जाने पर new लेबल |
| Resolved since last review | वे समस्याएँ जिनके सुधार को Copilot ने सत्यापित किया |
| Previously missed | नए commit द्वारा न जोड़ी गई समस्याएँ, जो बाद की समीक्षा के दौरान मिलीं |
🔗 Copilot code review, समीक्षा का बेहतर अनुभव
Pika ने अपने नए प्लेटफ़ॉर्म के अनुप्रयोगों को नाम दिए
19 सितंबर — 17 सितंबर को Pika ने अपने उत्पाद को पूरी तरह नया रूप देकर एक रचनात्मक प्लेटफ़ॉर्म बनाने की घोषणा की थी, लेकिन किसी भी सुविधा या मूल्य का उल्लेख नहीं किया था। 18 सितंबर की शाम से 19 सितंबर की सुबह के बीच कंपनी ने संदेशों की एक शृंखला के माध्यम से इस खालीपन को भरा, जिसमें अनुप्रयोगों के नाम एक-एक करके बताए गए। यह सूची पूरी सूची नहीं है: Pika के मुखपृष्ठ पर आठ अनुप्रयोग सूचीबद्ध हैं — Video Studio, Color Grade, Extend Video, Pika Soundtrack, Edit Image, Character Studio, Image Studio और Product Shot — जिनमें Camera Director और Relight Media शामिल नहीं हैं, जिससे पता चलता है कि पेशकश इन क्रमिक घोषणाओं से कहीं व्यापक है।
| घोषित अनुप्रयोग | Pika द्वारा वर्णित कार्यक्षमता |
|---|---|
| Video Studio | शून्य से वीडियो निर्माण, कई शॉट में 3 मिनट तक, ध्वनि सहित |
| Camera Director | अपलोड किए गए दृश्य को अन्य कोणों से फिर बनाता है, गति और अभिनय सुरक्षित रहते हैं |
| Relight Media | किसी क्लिप के प्रकाश का रंग, तीव्रता और दिशा अलग-अलग समायोजित करता है |
🔗 Video Studio · 🔗 Camera Director · 🔗 Relight Media
संक्षिप्त समाचार
- एक सामुदायिक टिप्पणी Accenture को सौंपे गए मूल्यांकन की स्वतंत्रता पर सवाल उठाती है — 18 तारीख को शामिल की गई साझेदारी पर अतिरिक्त जानकारी: टिप्पणी बताती है कि Anthropic सीधे Accenture के काम का वित्तपोषण करेगा और दोनों कंपनियाँ पहले से ही एक व्यावसायिक साझेदारी से जुड़ी हैं, जिसमें Accenture के लगभग 30,000 पेशेवरों को Claude का प्रशिक्षण दिया गया है। 🔗 स्रोत
- Replit ने अपने लेखापरीक्षा लॉग में 65 से अधिक अतिरिक्त घटनाएँ जोड़ीं — Enterprise खातों के प्रशासकों के लिए परियोजनाएँ, कार्यस्थान, परिनियोजन, खाते की सुरक्षा, SSO और SCIM, कनेक्टर, गोपनीय जानकारियाँ और Agent की गतिविधि; न तो कोई विस्तृत सूची है, न ही उपलब्धता की अलग तारीख। 🔗 स्रोत
- Qwen Code v0.24.1 ने पिछले दिन के पूर्वावलोकन को स्थिर संस्करण में बदला — 08:18 UTC पर प्रकाशित इस संस्करण में पहले ही शामिल की जा चुकी v0.24.1-preview.0 की तुलना में केवल छह प्रविष्टियाँ जोड़ी गई हैं: खबर इसकी सामग्री नहीं, बल्कि Playwright ब्राउज़र SDK और कंटेनर में उप-एजेंटों को स्थिर संस्करण में लाना है। 🔗 स्रोत
- Kimi Code 2.0.2 ने पाँच कमियाँ ठीक कीं — 2.0.1 के तेईस घंटे बाद और किसी नई सुविधा के बिना: फिर से शुरू करने के बाद संदेश अब किसी पुरानी स्थिति में नहीं पहुँचते, दोहराव हटा दिए गए हैं और मॉडल बदलने के बाद संपीड़न ठीक कर दिया गया है। 🔗 स्रोत
- Jev के साथ किसी एजेंट की स्मृति को फिर क्रमबद्ध करने से प्रथम स्थान पर पुनर्प्राप्ति 34 से बढ़कर 54 % हुई — 1,986 LoCoMo प्रश्नों पर AtMem के दस सर्वश्रेष्ठ उम्मीदवारों को फिर क्रमबद्ध करने से MRR@5 0.4259 से बढ़कर 0.5868 हो गया, जबकि शीर्ष दस की पुनर्प्राप्ति 0.6495 पर अपरिवर्तित रही। 🔗 स्रोत
- Layer-Feedback Transformer ने 10 मिलियन पैरामीटर पर 4.29 अंक की बढ़त हासिल की, लेकिन समान गणना पर नहीं — पास की परतों को दोबारा चलाने से एक आंतरिक मानक पर मॉडल का प्रदर्शन 32.57 से बढ़कर 36.86 % हो गया, लेकिन इसकी कीमत ब्लॉक निष्पादनों की संख्या में 2.64 गुना वृद्धि रही, जिसे लेखक स्पष्ट रूप से एक सीमा मानता है। 🔗 स्रोत
- AmberTrace गणित और कोड से परे सत्यापन योग्य पुरस्कारों की वकालत करता है — बिना मानक-परीक्षण के एक वैचारिक निबंध: सफलता जैसी दिखने वाली चीज़ को पुरस्कृत करने से ऐसा मॉडल बनता है जो दिखावे को अनुकूलित करता है, और जिन क्षेत्रों में किसी निर्णय के साथ उत्तरदायित्व जुड़ा होता है, वहाँ अब भी सत्यापन योग्य पुरस्कार उपलब्ध नहीं हैं। 🔗 स्रोत
- यह पता लगाने के लिए एक परीक्षण प्रोटोकॉल कि क्या कोई पुराना दस्तावेज़ स्मृति के अद्यतन को रद्द कर सकता है — बिना मापन के एक प्रक्रिया-प्रस्ताव: यदि प्रतिस्थापित दस्तावेज़ को नए समय-चिह्न के साथ फिर आयात किया जाए, तो सबसे हाल में आए दस्तावेज़ को सर्वाधिक अद्यतन मानने वाली प्रणाली उसे चुपचाप फिर से वर्तमान उत्तर बना देती है। 🔗 स्रोत
- एजेंटों और भौतिक दुनिया के बीच अंतरापृष्ठ के रूप में कोड — एक शैक्षणिक सारांश, जो कोड एजेंट के चक्र की तुलना रोबोटिक संचालन के लिए प्रोग्राम बनाने से करता है; इसमें अपनी कोई घोषणा या संख्यात्मक परिणाम नहीं है। 🔗 स्रोत
- Qwen ने Qwen3.8-27B पर आधारित Cerebras का प्रदर्शन साझा किया — Cerebras अनुमान पर किसी तीसरे पक्ष द्वारा बनाया गया व्यक्तिगत वित्त सहायक; यह बधाई के रूप में साझा किया गया संदेश है, उत्पाद की घोषणा नहीं, और इसके मूल विषय को 12 सितंबर को शामिल किया जा चुका था। 🔗 स्रोत
- OpenAI ने अपना Australian Youth Safety Blueprint प्रकाशित किया — ऑस्ट्रेलिया में युवा AI उपयोगकर्ताओं की सुरक्षा के लिए छह स्तंभों वाली रूपरेखा, साक्षरता से लेकर निजता का सम्मान करने वाले आयु सत्यापन तक; कंपनी याद दिलाती है कि 13-17 वर्ष के किशोरों के लिए ChatGPT for Teens अगस्त से देश में उपलब्ध है। 🔗 स्रोत
- iOS के लिए ChatGPT 1.2026.251 ने फ़ोल्डर और लेखन ब्लॉक जोड़े — फ़ाइल चयनकर्ता से फ़ोल्डर बनाना, मसौदे के विकल्पों और प्रतिलिपि कार्रवाइयों वाले लेखन ब्लॉक, साथ ही worktrees और कतारबद्ध prompts पर केंद्रित आठ सुधार। 🔗 स्रोत
इसका क्या अर्थ है
इस दिन का स्वरूप असामान्य है: प्रयोगशालाएँ चुप हैं और व्यावहारिक विशेषज्ञ प्रकाशित कर रहे हैं। न तो DeepSeek ने, जो नौ दिनों से मौन है और जिसकी तीन स्वतंत्र माध्यमों पर जाँच की गई, न Meta ने, न Ai2 ने और न ही Sakana ने कुछ जारी किया। मुक्त मॉडल के क्षेत्र की सभी ग्यारह खोजें एक ही जगह, Hugging Face के सामुदायिक ब्लॉग से आई हैं, और वे कोई मॉडल प्रस्तुत नहीं करतीं: वे मापन करती हैं। चौदह दिनों के ग्राहक ट्रैफ़िक पर एक उपसर्ग कैश, प्रमाण द्वारा सत्यापित 1,350 निर्णय, परिमाणीकरण के छह स्तर और पुनःक्रमबद्ध करने की गुणवत्ता। दिन की एकमात्र मॉडल प्रस्तुति Qwen3.8-LiveTranslate इसके उलट खुले भार के बिना एक API उत्पाद है। इस शनिवार मुक्त पारिस्थितिकी तंत्र ने कच्ची सामग्री नहीं बनाई — उसने मापन उपकरण बनाए।
इन मापनों से निकली बातें एक ही दिशा में जाती हैं, और यह उनकी विविधता से अधिक दिलचस्प है। तीनों मामलों में निर्णायक मानदंड वह नहीं है जिसकी अपेक्षा की गई थी। दोगुना तेज़ मिश्रित-विशेषज्ञ मॉडल अपनी गति के कारण नहीं, बल्कि अपने व्यवहार के कारण पिछड़ता है, क्योंकि अस्वीकार किए गए उपकरण कॉल से वह 20 में से केवल 1 मामले में उबर पाता है। 19 मॉडलों की रैंकिंग दिखाती है कि एक ही मॉडल पर तर्क सक्रिय और निष्क्रिय होने के बीच का अंतर बहुत अलग आकार वाले मॉडलों के बीच के अंतर से अधिक है। और 8 से 2 बिट पर जाने से सटीकता 1.3 अंक घटती है, लेकिन त्रुटियों की दिशा नहीं बदलती। ये तीन अलग-अलग तरीके से बताते हैं कि गति, आकार और संख्यात्मक परिशुद्धता इस बात के खराब भविष्यवक्ता हैं कि कोई मॉडल वास्तव में उत्पादन में क्या करेगा, और ध्यान कहीं और देना चाहिए — इस पर कि वह कैसे सँभलता है, विचार करता है या किस ओर झुकता है।
एक अधिक सूक्ष्म संकेत ध्यान देने योग्य है: निर्णय का वही मॉडल Jev एक ही दिन दो परस्पर असंबंधित लेखों में दिखाई देता है—Yuichi Tateno के यहाँ शोध दस्तावेज़ों को छाँटने के लिए और Javad Taghia के यहाँ किसी एजेंट की स्मृति को फिर क्रमबद्ध करने के लिए—और इसे दो अलग मानकों पर मापा गया है। दो स्वतंत्र लेखकों द्वारा एक ही दिन तीसरे पक्ष के मॉडल को उपकरण के रूप में इस्तेमाल करना, एक साझा आधार-घटक की शुरुआत है। दोनों मामलों में तर्क एक ही है: किसी बाहरी निर्णायक को उत्तर नहीं, बल्कि उत्तर देने से पहले यह निर्णय सौंपना कि क्या रखा जाए — और Tateno के मामले में, जब कुछ भी रखने योग्य न हो तो रुक जाने की क्षमता।
उपकरणों की ओर देखें तो बदलाव कार्यक्षमता से अधिक अनुबंध से जुड़ा है। Claude Code 2.1.278 सर्वर-पक्षीय स्वतः मोड के वर्गीकारक को निःशुल्क करता है और इस अतिरिक्त लागत के लिए शुल्क लेना बंद करता है, जो चार दिन पहले 2.1.273 में लिए गए निर्णय के ठीक उलट है: एक पूर्वनिर्धारित विन्यास आर्थिक चर बन गया है, जिसे इतनी तेज़ी से संशोधित किया जा रहा है। दूसरी ओर Devin अपने लेखापरीक्षा लॉग के total क्षेत्र को भरना बंद कर देता है, और उस पर निर्भर आह्वानकर्ता कोड रुक जाता है — यह बदलाव उपयोगिता संबंधी नई सुविधाओं के बीच रखा गया है, जबकि यह मौजूदा एकीकरणों को तोड़ता है। अंततः Copilot code review किसी टिप्पणी को चुपचाप बंद करने की जगह कारण सहित निर्णय, ठीक नहीं किया जाएगा या गलत, देकर पूर्वावलोकन से बाहर आता है। तीन प्रकाशकों के तीन तरीके यह याद दिलाते हैं कि किसी एजेंट उपकरण का मूल महत्त्व अब उसके पूर्वनिर्धारित मानों, मूल्य निर्धारण और API संबंधी वादों में निहित है।
स्रोत
- Qwen, Qwen3.8-LiveTranslate पर लेख
- X पर Alibaba Qwen, Qwen3.8-LiveTranslate की घोषणा
- दो RTX 5090 पर एजेंट ट्रैफ़िक के चौदह दिन
- AmberTrace Labs, 19 मुक्त मॉडलों में त्रुटि की दिशा
- AmberTrace Labs, परिमाणीकरण और सुरक्षा की दिशा
- jev-reranker, प्रस्तुति और मापन
- Metro-ASR-Small, 61 मिलियन पैरामीटर वाला CTC मॉडल क्या सीखता है
- Claude Code, संस्करण 2.1.278 के प्रकाशन विवरण
- Claude Code दस्तावेज़ीकरण, स्वतः मोड वर्गीकारक का मूल्य निर्धारण
- Devin, प्रकाशन विवरण
- Gemini CLI, 19 सितंबर का nightly
- GitHub, Copilot code review की सामान्य उपलब्धता
- X पर Pika, Camera Director
- Pika, अनुप्रयोग पृष्ठ