ai-powered-markdown-translatorArtigo traduzido do fr para o pt com gpt-5.6-sol.
Neste sábado, nenhum laboratório publicou um modelo com pesos abertos: nem a DeepSeek, em silêncio há nove dias, nem a Meta, nem a Ai2, nem a Sakana. O único lançamento do dia é um modelo de API fechado, o Qwen3.8-LiveTranslate, que reduz a latência da interpretação simultânea para 2,3 segundos. Todo o resto vem dos profissionais: onze artigos no blogue comunitário da Hugging Face, que não apresentam modelos, mas avaliações — cache de prefixos em produção, decisões certificadas, custo da quantização, qualidade de uma reordenação.
Qwen3.8-LiveTranslate, interpretação simultânea abaixo dos 2,3 segundos
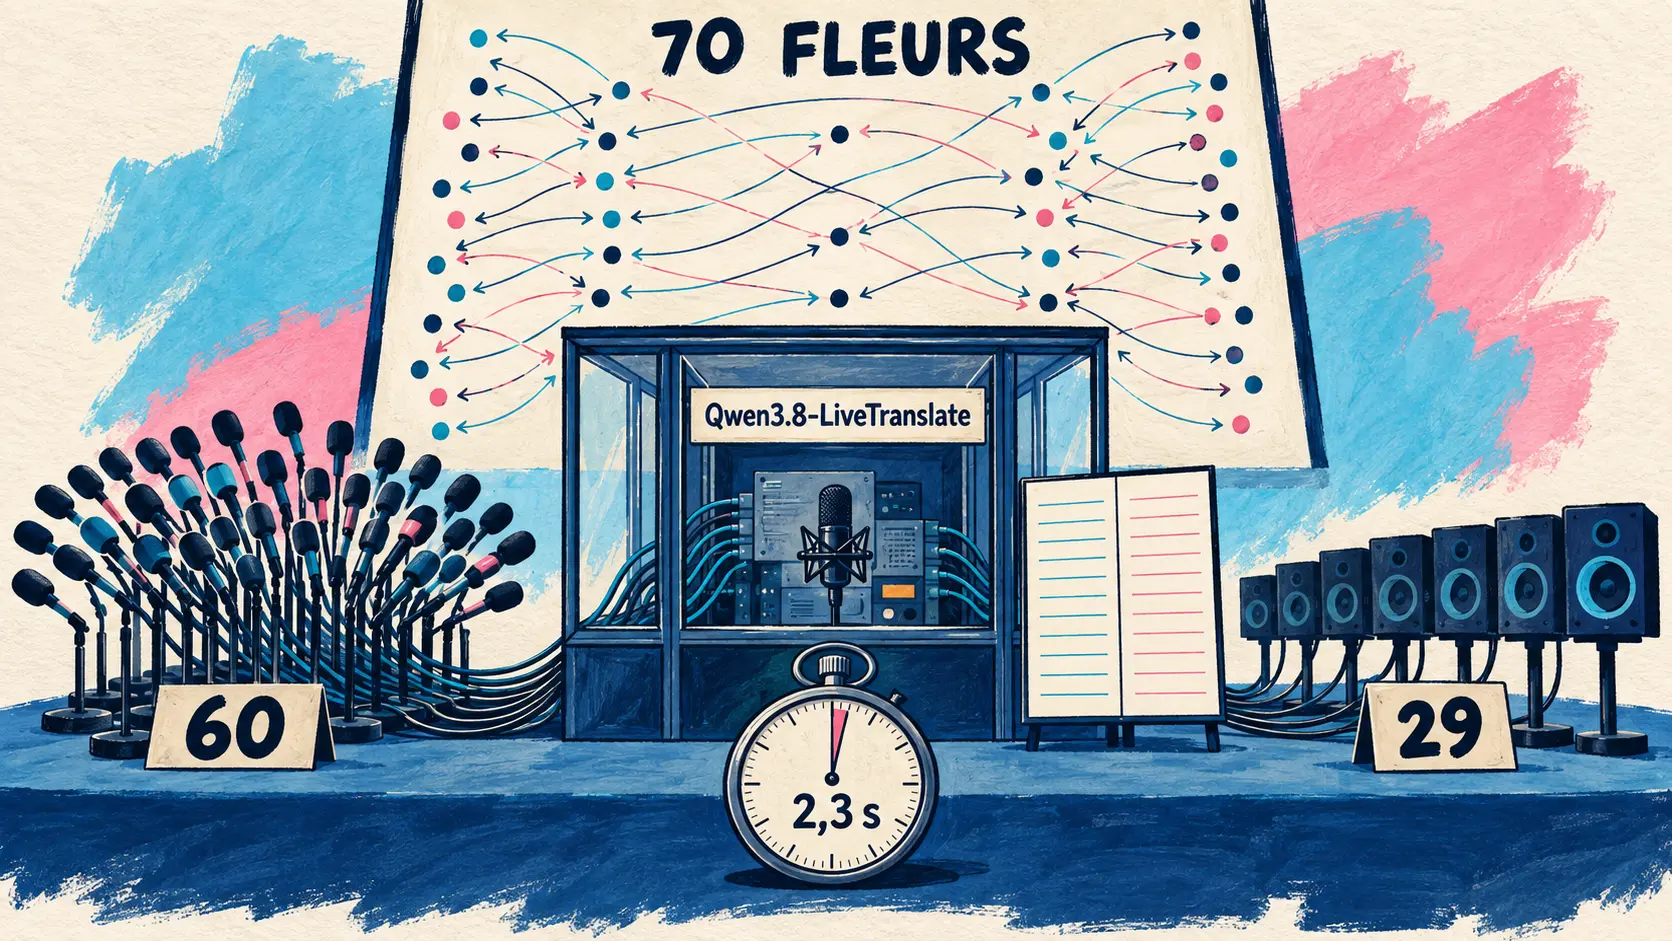
19 de setembro — A Qwen apresentou o Qwen3.8-LiveTranslate, o seu modelo de interpretação simultânea em tempo real. A arquitetura Interleave processa o áudio e o texto como um único fluxo intercalado, no qual o áudio já ouvido e a tradução já produzida são colocados em cache e depois reutilizados, reduzindo a latência média (average lagging, LAAL) de 2,8 para 2,3 segundos, com melhoria da qualidade.
O motor é um conjunto de dois módulos Thinker-Talker baseado numa mistura híbrida de especialistas (Hybrid-MoE): o Thinker organiza vídeo, áudio, texto de origem e tradução numa única sequência causal ordenada no tempo, e o Talker sintetiza depois uma voz que preserva o timbre do locutor original. Três funcionalidades acompanham-no: separação dos locutores em tempo real (real-time speaker separation), apresentação bilingue sincronizada e desambiguação em contexto longo.
Quanto à cobertura linguística, o artigo e a mensagem de anúncio divergem: a segunda fala de 60 idiomas em geral, enquanto o primeiro distingue 60 idiomas como entrada de áudio com saída de texto, mas apenas 29 como saída de áudio. Os números do artigo são os que prevalecem. As avaliações incidem sobre o Omnilingua-MSpeaker, com 14 direções linguísticas, e sobre o conjunto público FLEURS, com 70 direções. O modelo é utilizado por API através do DashScope: não foi anunciada qualquer abertura dos pesos.
| Elemento avaliado | Valor anunciado |
|---|---|
| Latência média (LAAL) | 2,3 s, contra 2,8 s na geração anterior |
| Idiomas na entrada de áudio, saída de texto | 60 |
| Idiomas na saída de áudio | 29 |
| Avaliação multilingue pública | FLEURS, 70 direções linguísticas |
| Nome do modelo na API | qwen3.8-livetranslate-flash-realtime |
Built on an Interleave architecture, it improves faithfulness, fluency, and conciseness while reducing average lagging (LAAL) from 2.8s to 2.3s across 60 languages.
🇵🇹 Baseado numa arquitetura Interleave, melhora a fidelidade, a fluidez e a concisão, reduzindo simultaneamente a latência média (LAAL) de 2,8 s para 2,3 s em 60 idiomas. — @Alibaba_Qwen no X
🔗 Artigo sobre o Qwen3.8-LiveTranslate
Avaliar os modelos abertos: três estudos publicados no mesmo dia
Três artigos independentes, todos publicados no blogue comunitário da Hugging Face, avaliam o mesmo objeto sob três perspetivas: o desempenho de um modelo aberto em condições reais.
Catorze dias de produção: o cache de prefixos decide o destino de um modelo de 27 mil milhões
19 de setembro — Durante 13,9 dias, duas placas GeForce RTX 5090 serviram o Qwen3.8-27B quantizado em NVFP4 ao motor de agentes que a Scalably opera para clientes reais, sendo cada número um contador lido no endpoint /metrics: 28 097 pedidos concluídos, 860,6 milhões de tokens de entrada, zero abandonos. Com prompts medianos de 6 466 tokens e um percentil 99 de 183 800, 82,6% dos tokens de pré-preenchimento vêm do cache. E o Nex-N2.5-mini, duas vezes mais rápido na descodificação, perdeu o lugar numa repetição de decisões reais: só recupera de uma chamada de ferramenta rejeitada em 1 caso em 20, contra 12 em 20.
The short version: on agent traffic the prefix cache decides whether a 27B model keeps up, the scheduler flags matter more than the kernels, and a faster mixture-of-experts checkpoint lost the job on behaviour, not speed.
🇵🇹 Em resumo: no tráfego de agentes, é o cache de prefixos que determina se um modelo de 27 mil milhões consegue acompanhar o ritmo, as opções do escalonador são mais importantes do que os kernels de computação, e um checkpoint de mistura de especialistas mais rápido perdeu o lugar devido ao seu comportamento, não à sua velocidade. — pavle-scalably no blogue da Hugging Face
AmberTrace avalia 19 modelos abertos em 1 350 decisões certificadas
18 de setembro — Quando um modelo decide conceder ou recusar, a questão não é apenas quantas vezes erra, mas em que direção. A AmberTrace Labs avaliou 19 modelos com pesos abertos em 1 350 itens cuja ação correta foi certificada por uma prova. O agrupamento por família revela mais do que a classificação: raciocínio ativado, média de 0,960; capazes de raciocinar, mas com a opção desativada, 0,909; sem raciocínio, 0,805. A diferença entre ativar e desativar o raciocínio supera a diferença entre tamanhos muito distintos. Amostra única, temperatura 0: o autor declara as limitações.
| Modelo avaliado | Laboratório | Pontuação composta | Exatidão | Erro permissivo |
|---|---|---|---|---|
| Qwen3.8-27B (raciocínio) | Alibaba | 0,974 | 95,5% | 0,0% |
| Muse-Glimmer-30B | Meta | 0,960 | 94,0% | 3,1% |
| OLMo-3-32B-Think | Ai2 | 0,947 | 93,8% | 3,3% |
| Qwen3.8-27B | Alibaba | 0,937 | 91,3% | 6,3% |
🔗 A direção do erro nos modelos de decisão com pesos abertos
De 8 para 2 bits: 1,3 ponto de exatidão, sem mudança de natureza
19 de setembro — No dia seguinte, a AmberTrace aplica o mesmo protocolo a uma pergunta: o que se perde com a quantização? O Qwen3.6-27B foi servido em seis níveis GGUF, de Q8_0 a Q2_K, e depois avaliado nos mesmos 1 350 itens. O resultado contradiz a intuição comum: a exatidão passa de 90,9% em 8 bits para 89,6% em 2 bits, uma diferença de 1,3 ponto para uma redução da precisão numérica a um quarto. O valor mais interessante é aquele que não se altera: o viés assinado dos erros permanece estável, com um coeficiente de determinação de 0,01. A quantização altera a quantidade de erros, não a sua natureza. O autor adverte que se trata de um estudo preliminar.
| Quantização | Exatidão | Erro permissivo (faixa crítica) | Viés assinado |
|---|---|---|---|
| 8 bits | 90,9% | 5,2% | −0,024 |
| 5 bits | 91,3% | 4,5% | −0,029 |
| 4 bits | 90,2% | 6,3% | −0,018 |
| 2 bits | 89,6% | 6,3% | −0,024 |
🔗 Quantização e direção da segurança das decisões
jev-reranker descarta 92% dos documentos candidatos e ainda assim melhora a classificação
19 de setembro — Yuichi Tateno publica o jev-reranker, uma biblioteca Python que utiliza o Jev, o modelo de avaliação estruturada da TypeSafe.AI, para reordenar resultados de pesquisa e, sobretudo, descartar os documentos que não ajudarão a responder. O argumento vai além da economia de tokens: a filtragem dá à aplicação uma decisão a tomar antes da geração. No NanoHotpotQA, a filtragem alcança 0,975 de nDCG@10 mantendo apenas 7,62 documentos por consulta, contra 0,833 para a pesquisa híbrida, que mantém 100: é a redução do contexto que torna a abordagem interessante.
A observação mais interessante está noutro ponto: o mesmo modelo de avaliação aparece, nesse mesmo dia, num segundo artigo independente, no qual Javad Taghia reordena a memória de um agente, num banco de ensaio diferente.
| Método de classificação | Limiar | nDCG@10 | Documentos mantidos por consulta |
|---|---|---|---|
| Pesquisa híbrida | — | 0,833 | 100 |
| Reordenação | 0,0 | 0,969 | 100 |
| Filtragem por relevância | 0,2 | 0,975 | 7,62 (92,38% descartados) |
🔗 Apresentação do jev-reranker
Metro-ASR-Small, 61 milhões de parâmetros para árabe egípcio num processador de portátil
19 de setembro — O Whisper-large-v3 tem 1,5 mil milhões de parâmetros, e o OmniASR-LLM da Meta, 7 mil milhões: todos exigem uma placa gráfica. O Metro-ASR-Small tem 61,6 milhões, ocupa 235 MB e transcreve árabe egípcio, inglês e a alternância entre ambos a uma velocidade entre 33 e 66 vezes superior ao tempo real em quatro threads de processador — o intervalo apresentado na tabela, que o texto arredonda para um fator de 50. O artigo não é um anúncio, mas uma investigação: de onde vem a exatidão quando os dados e os parâmetros são limitados? Menos do modelo acústico do que se poderia pensar. O segundo recurso é um modelo de linguagem KenLM de 6,4 GB, opcional: vinte e sete vezes o tamanho do modelo acústico.
| Largura do feixe | Taxa de erro por palavra | Tempo de descodificação |
|---|---|---|
| Descodificação gulosa | 30,0% | 5,9 ms |
| 100 | 24,3% | 128 ms |
| 400 | 24,1% | 351 ms |
🔗 O que um modelo CTC de 61 milhões de parâmetros pode e não pode aprender
Claude Code 2.1.278 transfere novamente o classificador do modo automático para o servidor e deixa de o cobrar
19 de setembro — No modo automático, um classificador inspeciona as ações sensíveis antes da sua execução; até agora, essas verificações eram chamadas de modelo cobradas por token. O servidor passa a efetuá-las no âmbito dos pedidos da sessão, sem cobrar esse custo adicional, por predefinição para a Claude API, Enterprise, Bedrock, Vertex e Foundry, com uma linha Auto mode server em /status. Atenção ao fallback: um gateway que descarte o campo safeguards faz com que o Claude Code passe para o seu classificador local, cobrado, após apresentar um aviso.
A mudança merece ser assinalada como tal: é exatamente o inverso da versão 2.1.273 de 15 de setembro, que tinha imposto o classificador local por predefinição no Bedrock, Vertex e Foundry. Uma inversão em quatro dias.
We’re changing auto mode to no longer charge for classifier requests in Claude Code. However, this session isn’t eligible.
🇵🇹 Estamos a alterar o modo automático para deixar de cobrar pelos pedidos do classificador no Claude Code. No entanto, esta sessão não é elegível. — Documentação do Claude Code, aviso apresentado em caso de fallback cobrado
🔗 Notas de versão do Claude Code 2.1.278
As ferramentas de código são atualizadas: um campo de API desaparece, um pseudoterminal torna-se mais robusto
Devin: Azure DevOps Server, nova ligação MCP e um campo total que passa a devolver null
18 de setembro — A série de notas de versão publicada pela Cognition não altera o motor do agente, mas sim a administração e as ligações empresariais. O facto mais importante não é uma novidade, mas uma quebra de compatibilidade: na lista de registos de auditoria da API Enterprise, o campo total deixou de ser preenchido e devolve null; a paginação deve passar por has_next_page e end_cursor. Todo o código cliente que dependia desse contador deixa de funcionar. O restante é aditivo: as coleções Azure DevOps Server 2020 e 2022 passam a ser aceites através de um token de acesso pessoal, enquanto anteriormente apenas a versão cloud era compatível; cada servidor MCP recebe uma ação Reconnect, que repete a autenticação sem desinstalar; ActiveCampaign e Grafana (OAuth) entram no catálogo; as sessões podem ser filtradas por origem e as gravações de ecrã passam para 60 fotogramas por segundo.
Gemini CLI: uma nightly sem correções de segurança, centrada no pseudoterminal
19 de setembro — O canal nightly do Gemini CLI publica às 03:25 a versão v0.62.0-nightly.20260919.gcfbcaa8df, com cinco correções e nenhuma alteração de segurança — o que rompe com a série de nightlies anteriores. Duas incidem sobre o pseudoterminal: a sincronização do ciclo de vida da saída dos processos ConPTY, a implementação do pseudoterminal no Windows, e depois a gestão de memória do buffer do terminal. As outras três corrigem problemas incómodos: registos AbortError apresentados ao cancelar um pedido, perda de foco do terminal ao fechar um separador de comparação na extensão VS Code e um link para a documentação de autenticação que apontava para uma âncora inválida. Os canais públicos permanecem inalterados, com o stable em v0.60.0 e o preview em v0.61.0-preview.0.
🔗 Notas de versão da nightly de 19 de setembro
Copilot code review reformula o seu relatório e passa a estar disponível em geral
18 de setembro — O GitHub disponibiliza de forma geral uma reformulação do relatório deixado pelo Copilot code review numa pull request. O comentário de síntese apresenta a avaliação atual e o nível de esforço da revisão, distribuindo as conclusões por três grupos, cada um com a sua gravidade e um link para o comentário em linha. À medida que são adicionados commits, a síntese preserva o progresso em vez de ser reescrita. A resolução automática, introduzida em 11 de setembro, é ampliada: uma resposta que peça para manter um problema aberto é respeitada, e uma resolução automática indica o seu motivo, Won’t Fix ou Incorrect — uma decisão fundamentada e contestável, em vez de um encerramento silencioso.
| Grupo de conclusões | Conteúdo |
|---|---|
| Open | Problemas não resolvidos, etiqueta new se tiverem sido introduzidos por um novo commit |
| Resolved since last review | Problemas cuja correção foi validada pelo Copilot |
| Previously missed | Problemas não introduzidos por um novo commit, encontrados numa revisão posterior |
🔗 Copilot code review, uma experiência de revisão melhorada
Pika dá nomes às aplicações da sua nova plataforma
19 de setembro — A 17 de setembro, a Pika anunciou a reformulação completa do seu produto como plataforma criativa, sem mencionar uma única funcionalidade nem um único preço. Entre a noite de 18 e a manhã de 19, a empresa preencheu esse vazio com uma série de mensagens que nomeiam as aplicações uma a uma. Esta lista não é o catálogo: a página inicial da Pika enumera oito aplicações — Video Studio, Color Grade, Extend Video, Pika Soundtrack, Edit Image, Character Studio, Image Studio e Product Shot — das quais não constam Camera Director nem Relight Media, o que indica que a oferta é mais ampla do que estes anúncios sucessivos.
| Aplicação anunciada | Função descrita pela Pika |
|---|---|
| Video Studio | Vídeo a partir do zero, até 3 minutos em vários planos, com som incluído |
| Camera Director | Regenera uma cena carregada a partir de outros ângulos, preservando movimento e atuação |
| Relight Media | Ajusta separadamente a cor, a intensidade e a direção da luz de um clipe |
🔗 Video Studio · 🔗 Camera Director · 🔗 Relight Media
Breves
- Uma nota comunitária contesta a independência da avaliação confiada à Accenture — complemento à parceria abordada no dia 18: a nota salienta que a Anthropic financiará diretamente o trabalho da Accenture e que uma parceria comercial anterior já liga as duas empresas, com cerca de 30 000 profissionais da Accenture formados em Claude. 🔗 fonte
- A Replit alarga os seus registos de auditoria a mais 65 eventos — projetos, espaços de trabalho, implementações, segurança da conta, SSO e SCIM, conectores, segredos e atividade do Agent, para administradores de contas Enterprise; sem lista detalhada nem data de disponibilidade específica. 🔗 fonte
- O Qwen Code v0.24.1 promove a versão de pré-visualização da véspera a estável — publicada às 08:18 UTC, acrescenta apenas seis entradas à v0.24.1-preview.0 já abordada: a novidade é a promoção do SDK para navegador Playwright e dos subagentes em contentores, não o conteúdo. 🔗 fonte
- O Kimi Code 2.0.2 corrige cinco falhas — vinte e três horas após a 2.0.1 e sem qualquer funcionalidade nova: mensagens que deixam de aparecer numa posição antiga após uma retoma, duplicados eliminados, compactação reparada depois de uma mudança de modelo. 🔗 fonte
- Reordenar a memória de um agente com o Jev aumenta a recuperação na primeira posição de 34 para 54 % — em 1 986 perguntas LoCoMo, a reordenação dos dez melhores candidatos do AtMem eleva o MRR@5 de 0,4259 para 0,5868 sem alterar a recuperação nos dez primeiros, que permaneceu em 0,6495. 🔗 fonte
- O Layer-Feedback Transformer ganha 4,29 pontos com 10 milhões de parâmetros, mas não com computação equivalente — voltar a executar as camadas vizinhas faz um modelo passar de 32,57 para 36,86 % num benchmark interno, ao custo de 2,64 vezes mais execuções de blocos, uma limitação que o autor reconhece explicitamente. 🔗 fonte
- A AmberTrace defende recompensas verificáveis para além da matemática e do código — ensaio de posicionamento sem benchmark: recompensar a aparência de sucesso produz um modelo que otimiza essa aparência, e os domínios em que uma decisão implica responsabilidade continuam sem recompensa verificável. 🔗 fonte
- Um protocolo de teste para saber se um documento antigo pode anular uma atualização de memória — proposta de procedimento, sem medição: um documento substituído que regressa através de uma reimportação com uma data e hora recentes volta silenciosamente a ser a resposta atual se o sistema tratar a chegada mais recente como a mais atual. 🔗 fonte
- Código como interface entre os agentes e o mundo físico — síntese pedagógica que aproxima o ciclo de um agente de código da geração de programas para manipulação robótica, sem anúncio nem resultado quantitativo próprio. 🔗 fonte
- A Qwen divulga uma demonstração da Cerebras baseada no Qwen3.8-27B — um assistente de finanças pessoais desenvolvido por terceiros sobre a inferência da Cerebras; uma divulgação de felicitações, não um anúncio de produto, tendo o tema subjacente sido abordado a 12 de setembro. 🔗 fonte
- A OpenAI publica o seu Australian Youth Safety Blueprint — um roteiro de seis pilares para a proteção dos jovens utilizadores de IA na Austrália, desde a literacia até à verificação de idade respeitadora da privacidade; a empresa recorda a disponibilização do ChatGPT for Teens no país desde agosto para jovens dos 13 aos 17 anos. 🔗 fonte
- O ChatGPT para iOS 1.2026.251 acrescenta pastas e blocos de escrita — criação de pastas a partir do seletor de ficheiros, blocos de escrita com variantes de rascunho e ações de cópia, além de oito correções centradas em worktrees e prompts colocados em fila. 🔗 fonte
O que isto significa
O dia tem uma configuração invulgar: os laboratórios mantêm-se em silêncio e os profissionais publicam. Nem a DeepSeek, em silêncio há nove dias e verificada em três superfícies independentes, nem a Meta, nem a Ai2, nem a Sakana lançaram fosse o que fosse. As onze descobertas no domínio dos modelos abertos vêm todas do mesmo lugar, o blogue comunitário da Hugging Face, e não apresentam qualquer modelo: fazem medições. Uma cache de prefixos em catorze dias de tráfego de clientes, 1 350 decisões certificadas por uma prova, seis níveis de quantização, a qualidade de uma reordenação. O único lançamento de modelo do dia, Qwen3.8-LiveTranslate, é, pelo contrário, um produto de API sem pesos abertos. Neste sábado, o ecossistema aberto não produziu matéria-prima — produziu instrumentos de medição.
O que estas medições dizem converge, e isso é mais interessante do que a sua diversidade. Nos três casos, o critério decisivo não é aquele que se esperava. O modelo mixture-of-experts duas vezes mais rápido perde a posição não pela sua velocidade, mas pelo seu comportamento, porque só recupera de uma chamada de ferramenta rejeitada em 1 de cada 20 casos. A classificação de 19 modelos mostra que a diferença entre raciocínio ativado e desativado no mesmo modelo é maior do que a diferença entre tamanhos muito distintos. E descer de 8 para 2 bits custa 1,3 pontos de exatidão sem alterar a direção dos erros. Três formas de dizer que a velocidade, o tamanho e a precisão numérica são maus indicadores do que um modelo realmente fará em produção e que é necessário olhar para outro lado — para a forma como recupera, delibera ou se inclina.
Um sinal mais discreto merece ser assinalado: o mesmo modelo de avaliação, Jev, aparece no mesmo dia em duas publicações sem relação entre si, com Yuichi Tateno para filtrar documentos de investigação e com Javad Taghia para reordenar a memória de um agente, medido em dois benchmarks diferentes. Dois autores independentes que instrumentam um modelo de terceiros no mesmo dia representam o início de um componente partilhado. A lógica é a mesma em ambos os casos: delegar a um avaliador externo não a resposta, mas a decisão sobre o que conservar antes de responder — e, no caso de Tateno, a possibilidade de parar quando nada merece ser conservado.
Do lado das ferramentas, o que muda diz mais respeito ao contrato do que à funcionalidade. O Claude Code 2.1.278 transfere o classificador do modo auto para o lado do servidor e deixa de cobrar este custo adicional, precisamente o contrário do que a versão 2.1.273 decidira quatro dias antes: uma definição predefinida tornou-se uma variável económica, revista a esta velocidade. O Devin, por sua vez, deixa de preencher o campo total dos seus registos de auditoria, e o código que dependia dele deixa de funcionar — uma alteração colocada a meio de novidades ergonómicas, apesar de quebrar integrações existentes. Por fim, o Copilot code review sai da versão de pré-visualização, substituindo o encerramento silencioso de um comentário por uma decisão fundamentada, Won’t Fix ou Incorrect. Três formas, por parte de três editores, de recordar que o essencial de uma ferramenta de agentes reside agora nos seus valores predefinidos, na sua faturação e nas suas garantias de API.
Fontes
- Qwen, publicação sobre o Qwen3.8-LiveTranslate
- Alibaba Qwen no X, anúncio do Qwen3.8-LiveTranslate
- Catorze dias de tráfego de agentes em duas RTX 5090
- AmberTrace Labs, a direção do erro em 19 modelos abertos
- AmberTrace Labs, quantização e direção de segurança
- jev-reranker, apresentação e medições
- Metro-ASR-Small, o que aprende um modelo CTC de 61 milhões de parâmetros
- Claude Code, notas de versão 2.1.278
- Documentação do Claude Code, faturação do classificador do modo auto
- Devin, notas de versão
- Gemini CLI, nightly de 19 de setembro
- GitHub, disponibilidade geral do Copilot code review
- Pika no X, Camera Director
- Pika, página das aplicações