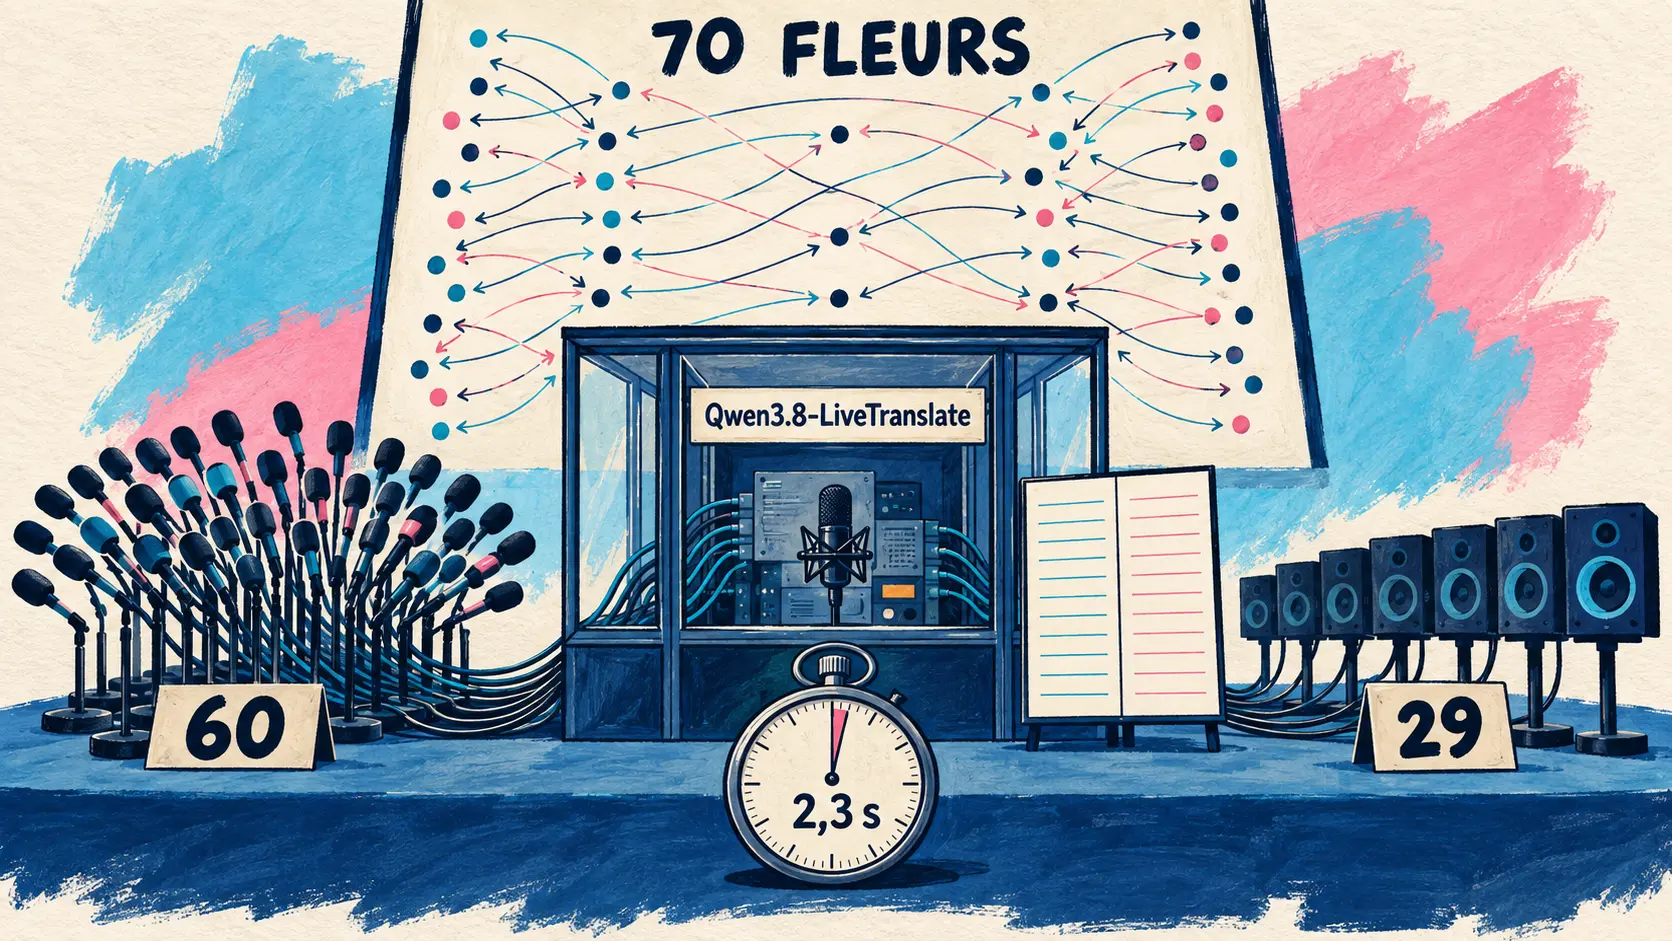
Ce samedi, aucun laboratoire n’a publié de modèle à poids ouverts : ni DeepSeek, muet depuis neuf jours, ni Meta, ni Ai2, ni Sakana. La seule sortie de la journée est un modèle d’API fermé, Qwen3.8-LiveTranslate, qui ramène la latence d’une interprétation simultanée à 2,3 secondes. Tout le reste vient des praticiens : onze billets sur le blog communautaire de Hugging Face, qui ne présentent pas des modèles mais des mesures — cache de préfixe en production, décisions certifiées, coût de la quantification, qualité d’un réordonnancement.
Qwen3.8-LiveTranslate, l’interprétation simultanée sous la barre des 2,3 secondes
19 septembre — Qwen a présenté Qwen3.8-LiveTranslate, son modèle d’interprétation simultanée en temps réel. L’architecture Interleave traite l’audio et le texte comme un seul flux entrelacé, où l’audio déjà entendu et la traduction déjà produite sont mis en cache puis réutilisés, ce qui ramène la latence moyenne (average lagging, LAAL) de 2,8 à 2,3 secondes à qualité améliorée.
Le moteur est un ensemble à deux modules Thinker-Talker fondé sur un mélange d’experts hybride (Hybrid-MoE) : le Thinker range vidéo, audio, texte source et traduction dans une seule séquence causale ordonnée dans le temps, le Talker synthétise ensuite une voix qui conserve le timbre du locuteur d’origine. Trois capacités l’accompagnent : la séparation des locuteurs en temps réel (real-time speaker separation), un affichage bilingue synchronisé et une désambiguïsation en contexte long.
Sur la couverture linguistique, le billet et le message d’annonce divergent : le second parle de 60 langues d’un bloc, le premier distingue 60 langues en entrée audio avec sortie texte, mais 29 seulement en sortie audio. Ce sont les chiffres du billet qui font foi. Les évaluations portent sur Omnilingua-MSpeaker, 14 directions de langues, et sur le jeu public FLEURS, 70 directions. Le modèle s’utilise par API via DashScope : aucune ouverture des poids n’est annoncée.
| Élément mesuré | Valeur annoncée |
|---|---|
| Latence moyenne (LAAL) | 2,3 s, contre 2,8 s pour la génération précédente |
| Langues en entrée audio, sortie texte | 60 |
| Langues en sortie audio | 29 |
| Évaluation multilingue publique | FLEURS, 70 directions de langues |
| Nom du modèle dans l’API | qwen3.8-livetranslate-flash-realtime |
Built on an Interleave architecture, it improves faithfulness, fluency, and conciseness while reducing average lagging (LAAL) from 2.8s to 2.3s across 60 languages.
🇫🇷 Fondé sur une architecture Interleave, il améliore la fidélité, la fluidité et la concision tout en réduisant la latence moyenne (LAAL) de 2,8 s à 2,3 s sur 60 langues. — @Alibaba_Qwen sur X
🔗 Billet Qwen3.8-LiveTranslate
Mesurer les modèles ouverts : trois études publiées le même jour
Trois billets indépendants, tous parus sur le blog communautaire de Hugging Face, mesurent le même objet sous trois angles : ce que vaut un modèle ouvert en conditions réelles.
Quatorze jours de production : le cache de préfixe décide du sort d’un modèle de 27 milliards
19 septembre — Pendant 13,9 jours, deux cartes GeForce RTX 5090 ont servi Qwen3.8-27B quantifié en NVFP4 au moteur d’agents que Scalably exploite pour de vrais clients, chaque chiffre étant un compteur lu sur le point d’accès /metrics : 28 097 requêtes terminées, 860,6 millions de tokens d’entrée, zéro abandon. Avec des prompts médians à 6 466 tokens et un 99e centile à 183 800, 82,6 % des tokens de préremplissage sortent du cache. Et Nex-N2.5-mini, deux fois plus rapide au décodage, a perdu la place sur un rejeu de décisions réelles : il ne se remet d’un appel d’outil rejeté que dans 1 cas sur 20, contre 12 sur 20.
The short version: on agent traffic the prefix cache decides whether a 27B model keeps up, the scheduler flags matter more than the kernels, and a faster mixture-of-experts checkpoint lost the job on behaviour, not speed.
🇫🇷 En résumé : sur du trafic d’agent, c’est le cache de préfixe qui décide si un modèle de 27 milliards tient la cadence, les options de l’ordonnanceur comptent plus que les noyaux de calcul, et un point de contrôle à mélange d’experts plus rapide a perdu la place sur son comportement, pas sur sa vitesse. — pavle-scalably sur le blog Hugging Face
AmberTrace note 19 modèles ouverts sur 1 350 décisions certifiées
18 septembre — Quand un modèle décide d’accorder ou de refuser, la question n’est pas seulement combien de fois il se trompe, mais dans quel sens. AmberTrace Labs a évalué 19 modèles à poids ouverts sur 1 350 items à l’action correcte certifiée par une preuve. Le regroupement par famille dit plus que le classement : raisonnement activé, 0,960 de moyenne ; capables de raisonner mais option coupée, 0,909 ; sans raisonnement, 0,805. L’écart entre activer et désactiver le raisonnement dépasse l’écart entre des tailles très différentes. Échantillon unique, température 0 : l’auteur affiche ses limites.
| Modèle évalué | Laboratoire | Score composite | Exactitude | Erreur permissive |
|---|---|---|---|---|
| Qwen3.8-27B (raisonnement) | Alibaba | 0,974 | 95,5 % | 0,0 % |
| Muse-Glimmer-30B | Meta | 0,960 | 94,0 % | 3,1 % |
| OLMo-3-32B-Think | Ai2 | 0,947 | 93,8 % | 3,3 % |
| Qwen3.8-27B | Alibaba | 0,937 | 91,3 % | 6,3 % |
🔗 La direction de l’erreur dans les modèles de décision à poids ouverts
De 8 à 2 bits : 1,3 point d’exactitude, et pas un changement de nature
19 septembre — Le lendemain, AmberTrace applique le même protocole à une question : que perd-on en quantifiant ? Qwen3.6-27B a été servi à six niveaux GGUF, de Q8_0 à Q2_K, puis évalué sur les mêmes 1 350 items. Le résultat contredit l’intuition courante : l’exactitude passe de 90,9 % en 8 bits à 89,6 % en 2 bits, soit 1,3 point pour une division par quatre de la précision numérique. Le chiffre le plus intéressant est celui qui ne bouge pas : le biais signé des erreurs reste plat, à 0,01 de coefficient de détermination. La quantification change la quantité d’erreurs, pas leur nature. Étude préliminaire, prévient l’auteur.
| Quantification | Exactitude | Erreur permissive (bande critique) | Biais signé |
|---|---|---|---|
| 8 bits | 90,9 % | 5,2 % | −0,024 |
| 5 bits | 91,3 % | 4,5 % | −0,029 |
| 4 bits | 90,2 % | 6,3 % | −0,018 |
| 2 bits | 89,6 % | 6,3 % | −0,024 |
🔗 Quantification et direction de sûreté des décisions
jev-reranker écarte 92 % des documents candidats et améliore quand même le classement
19 septembre — Yuichi Tateno publie jev-reranker, une bibliothèque Python qui s’appuie sur Jev, le modèle de jugement structuré de TypeSafe.AI, pour réordonner des résultats de recherche et surtout écarter les documents qui n’aideront pas à répondre. L’argument dépasse l’économie de tokens : filtrer donne à l’application une décision à prendre avant la génération. Sur NanoHotpotQA, le filtrage atteint 0,975 de nDCG@10 en ne gardant que 7,62 documents par requête, contre 0,833 pour la recherche hybride qui en garde 100 : c’est la réduction du contexte qui fait l’intérêt.
L’observation la plus intéressante est ailleurs : le même modèle de jugement apparaît le jour même dans un second billet indépendant, où Javad Taghia réordonne la mémoire d’un agent, sur un autre banc d’essai.
| Méthode de classement | Seuil | nDCG@10 | Documents conservés par requête |
|---|---|---|---|
| Recherche hybride | — | 0,833 | 100 |
| Réordonnancement | 0,0 | 0,969 | 100 |
| Filtrage de pertinence | 0,2 | 0,975 | 7,62 (92,38 % écartés) |
🔗 Présentation de jev-reranker
Metro-ASR-Small, 61 millions de paramètres pour l’arabe égyptien sur un processeur de portable
19 septembre — Whisper-large-v3 pèse 1,5 milliard de paramètres, OmniASR-LLM de Meta 7 milliards : tous réclament une carte graphique. Metro-ASR-Small en compte 61,6 millions, tient dans 235 Mo et transcrit l’arabe égyptien, l’anglais et leur alternance à 33 à 66 fois le temps réel sur quatre fils de processeur — la fourchette du tableau, que sa prose arrondit à un facteur 50. Le billet n’est pas une annonce mais une enquête : d’où vient l’exactitude quand les données et les paramètres sont contraints ? Moins du modèle acoustique qu’on ne croit. Le second levier est une tête de langue KenLM de 6,4 Go, facultative : vingt-sept fois le modèle acoustique.
| Largeur de faisceau | Taux d’erreur par mot | Temps de décodage |
|---|---|---|
| Décodage glouton | 30,0 % | 5,9 ms |
| 100 | 24,3 % | 128 ms |
| 400 | 24,1 % | 351 ms |
🔗 Ce qu’un modèle CTC de 61 millions de paramètres peut apprendre, et ne peut pas
Claude Code 2.1.278 repasse le classifieur du mode auto côté serveur, et cesse de le facturer
19 septembre — En mode auto, un classifieur inspecte les actions sensibles avant leur exécution ; ces vérifications étaient jusqu’ici des appels de modèle facturés au token. Le serveur les effectue désormais dans le cadre des requêtes de la session, sans facturer ce surcoût, par défaut pour la Claude API, Enterprise, Bedrock, Vertex et Foundry, avec une ligne Auto mode server dans /status. Attention au repli : une passerelle qui abandonne le champ safeguards fait basculer Claude Code sur son classifieur local, facturé, après un avis.
Le mouvement mérite d’être signalé comme tel : c’est l’inverse exact de la 2.1.273 du 15 septembre, qui avait imposé le classifieur local par défaut sur Bedrock, Vertex et Foundry. Un aller-retour en quatre jours.
We’re changing auto mode to no longer charge for classifier requests in Claude Code. However, this session isn’t eligible.
🇫🇷 Nous modifions le mode auto pour ne plus facturer les requêtes du classifieur dans Claude Code. Cette session n’y est toutefois pas éligible. — Documentation Claude Code, avis affiché en cas de repli facturé
🔗 Notes de version Claude Code 2.1.278
Les outils de code se mettent à jour : un champ d’API qui disparaît, un pseudo-terminal qui se durcit
Devin : Azure DevOps Server, reconnexion MCP, et un champ total qui renvoie désormais null
18 septembre — La salve de notes de version publiée par Cognition ne touche pas au moteur de l’agent mais à l’administration et aux connexions d’entreprise. Le fait le plus important n’est pas une nouveauté, c’est une rupture : dans la liste des journaux d’audit de l’API Enterprise, le champ total n’est plus rempli et renvoie null ; la pagination doit passer par has_next_page et end_cursor. Tout code appelant qui se fiait à ce compteur cesse de fonctionner. Le reste est additif : les collections Azure DevOps Server 2020 et 2022 sont acceptées par jeton d’accès personnel, alors que seule la version cloud l’était ; chaque serveur MCP gagne une action Reconnect qui rejoue l’authentification sans désinstaller ; ActiveCampaign et Grafana (OAuth) entrent au catalogue ; les sessions se filtrent par origine et les enregistrements d’écran montent à 60 images par seconde.
Gemini CLI : une nightly sans correctif de sécurité, centrée sur le pseudo-terminal
19 septembre — Le canal nightly de Gemini CLI publie à 03 h 25 la version v0.62.0-nightly.20260919.gcfbcaa8df, avec cinq correctifs et aucun changement de sécurité — ce qui rompt avec la série des nightlies précédentes. Deux visent le pseudo-terminal : la synchronisation du cycle de vie de sortie des processus ConPTY, l’implémentation Windows du pseudo-terminal, puis la gestion mémoire du tampon de terminal. Les trois autres corrigent des irritants : journaux AbortError affichés à l’annulation d’une requête, focus du terminal perdu à la fermeture d’un onglet de comparaison dans l’extension VS Code, lien de documentation d’authentification pointant vers une ancre invalide. Les canaux publics restent inchangés, stable en v0.60.0 et preview en v0.61.0-preview.0.
🔗 Notes de version de la nightly du 19 septembre
Copilot code review refond son compte rendu et passe en disponibilité générale
18 septembre — GitHub fait passer en disponibilité générale une refonte du compte rendu que Copilot code review laisse sur une pull request. Le commentaire de synthèse affiche l’évaluation courante et le niveau d’effort de revue, et répartit les constats en trois groupes, chacun avec sa sévérité et un lien vers le commentaire en ligne. Au fil des commits, la synthèse conserve la progression au lieu de se réécrire. L’auto-résolution, introduite le 11 septembre, est élargie : une réponse demandant de laisser un problème ouvert est honorée, et une résolution automatique indique sa raison, Won’t Fix ou Incorrect — une décision motivée et contestable plutôt qu’une fermeture silencieuse.
| Groupe de constats | Ce qu’il contient |
|---|---|
| Open | Problèmes non traités, étiquette new si introduits par un nouveau commit |
| Resolved since last review | Problèmes dont Copilot a validé la correction |
| Previously missed | Problèmes non introduits par un nouveau commit, trouvés lors d’une revue ultérieure |
🔗 Copilot code review, une expérience de revue améliorée
Pika met des noms sur les applications de sa nouvelle plateforme
19 septembre — Le 17 septembre, Pika annonçait la refonte complète de son produit en plateforme créative, sans citer une seule fonctionnalité ni un seul tarif. Entre le 18 au soir et le 19 au matin, l’entreprise a comblé ce vide par une série de messages qui nomment des applications une par une. Cette liste n’est pas le catalogue : la page d’accueil de Pika énumère huit applications — Video Studio, Color Grade, Extend Video, Pika Soundtrack, Edit Image, Character Studio, Image Studio et Product Shot — où ne figurent ni Camera Director ni Relight Media, ce qui indique que l’offre est plus large que ces annonces successives.
| Application annoncée | Fonction décrite par Pika |
|---|---|
| Video Studio | Vidéo depuis zéro, jusqu’à 3 minutes en plusieurs plans, son inclus |
| Camera Director | Régénère une scène téléversée sous d’autres angles, mouvement et jeu préservés |
| Relight Media | Règle séparément couleur, intensité et direction de la lumière d’un clip |
🔗 Video Studio · 🔗 Camera Director · 🔗 Relight Media
Brèves
- Une note communautaire conteste l’indépendance de l’évaluation confiée à Accenture — complément au partenariat couvert le 18 : la note relève qu’Anthropic financera directement le travail d’Accenture et qu’un partenariat commercial antérieur lie déjà les deux sociétés, avec environ 30 000 professionnels d’Accenture formés à Claude. 🔗 source
- Replit étend ses journaux d’audit à plus de 65 événements supplémentaires — projets, espaces de travail, déploiements, sécurité du compte, SSO et SCIM, connecteurs, secrets et activité de l’Agent, pour les administrateurs de comptes Enterprise ; ni liste détaillée ni date de disponibilité distincte. 🔗 source
- Qwen Code v0.24.1 fait passer en stable la préversion de la veille — publiée à 08:18 UTC, elle n’ajoute que six entrées à la v0.24.1-preview.0 déjà traitée : c’est la promotion du SDK navigateur Playwright et des sous-agents en conteneur qui fait la nouvelle, pas le contenu. 🔗 source
- Kimi Code 2.0.2 corrige cinq défauts — vingt-trois heures après la 2.0.1 et sans fonction nouvelle : messages qui n’atterrissent plus à une position ancienne après une reprise, doublons supprimés, compaction réparée après un changement de modèle. 🔗 source
- Réordonner la mémoire d’un agent avec Jev fait passer le rappel au premier rang de 34 à 54 % — sur 1 986 questions LoCoMo, le réordonnancement des dix meilleurs candidats d’AtMem porte le MRR@5 de 0,4259 à 0,5868 sans changer le rappel à dix, resté à 0,6495. 🔗 source
- Le Layer-Feedback Transformer gagne 4,29 points à 10 millions de paramètres, mais pas à calcul égal — rejouer les couches voisines fait passer un modèle de 32,57 à 36,86 % sur un banc maison, au prix de 2,64 fois plus d’exécutions de blocs, limite que l’auteur reconnaît explicitement. 🔗 source
- AmberTrace plaide pour des récompenses vérifiables au-delà des maths et du code — essai de positionnement sans banc d’essai : récompenser l’apparence du succès produit un modèle qui optimise l’apparence, et les domaines où une décision engage une responsabilité sont restés dépourvus de récompense vérifiable. 🔗 source
- Un protocole de test pour savoir si un vieux document peut annuler une mise à jour de mémoire — proposition de recette, sans mesure : un document remplacé qui revient par réimport avec un horodatage frais redevient silencieusement la réponse courante si le système traite l’arrivée la plus récente comme la plus actuelle. 🔗 source
- Du code comme interface entre les agents et le monde physique — synthèse pédagogique rapprochant la boucle d’un agent de code de la génération de programmes pour la manipulation robotique, sans annonce ni résultat chiffré propre. 🔗 source
- Qwen relaie une démonstration de Cerebras fondée sur Qwen3.8-27B — un assistant de finances personnelles construit par un tiers sur l’inférence Cerebras ; relais de félicitations et non annonce produit, le sujet sous-jacent ayant été traité le 12 septembre. 🔗 source
- OpenAI publie son Australian Youth Safety Blueprint — une feuille de route en six piliers pour la protection des jeunes utilisateurs d’IA en Australie, de la littératie à la vérification de l’âge respectueuse de la vie privée ; l’entreprise rappelle le déploiement de ChatGPT for Teens dans le pays depuis août pour les 13-17 ans. 🔗 source
- ChatGPT pour iOS 1.2026.251 ajoute les dossiers et les blocs d’écriture — création de dossiers depuis le sélecteur de fichiers, blocs d’écriture avec variantes de brouillon et actions de copie, plus huit correctifs centrés sur les worktrees et les prompts mis en file. 🔗 source
Ce que ça signifie
La journée a une forme inhabituelle : les laboratoires se taisent et les praticiens publient. Ni DeepSeek, muet depuis neuf jours et vérifié sur trois surfaces indépendantes, ni Meta, ni Ai2, ni Sakana n’ont sorti quoi que ce soit. Les onze trouvailles du domaine des modèles ouverts viennent toutes du même endroit, le blog communautaire de Hugging Face, et elles ne présentent aucun modèle : elles mesurent. Un cache de préfixe sur quatorze jours de trafic client, 1 350 décisions certifiées par une preuve, six niveaux de quantification, la qualité d’un réordonnancement. La seule sortie de modèle du jour, Qwen3.8-LiveTranslate, est à l’inverse un produit d’API sans poids ouverts. L’écosystème ouvert, ce samedi, n’a pas produit de matière première — il a produit des instruments de mesure.
Ce que ces mesures disent converge, et c’est plus intéressant que leur diversité. Dans les trois cas, le critère qui décide n’est pas celui qu’on attendait. Le modèle à mélange d’experts deux fois plus rapide perd la place non sur sa vitesse mais sur son comportement, parce qu’il ne se remet d’un appel d’outil rejeté que dans 1 cas sur 20. Le classement de 19 modèles montre que l’écart entre raisonnement activé et désactivé sur un même modèle dépasse l’écart entre des tailles très différentes. Et descendre de 8 à 2 bits coûte 1,3 point d’exactitude sans déplacer la direction des erreurs. Trois façons de dire que la vitesse, la taille et la précision numérique sont de mauvais prédicteurs de ce qu’un modèle fera réellement en production, et qu’il faut regarder ailleurs — dans la manière dont il se rattrape, délibère, ou penche.
Un signal plus discret mérite d’être noté : le même modèle de jugement, Jev, apparaît le même jour dans deux billets sans lien entre eux, chez Yuichi Tateno pour filtrer des documents de recherche et chez Javad Taghia pour réordonner la mémoire d’un agent, mesuré sur deux bancs différents. Deux auteurs indépendants qui instrumentent un modèle tiers le même jour, c’est le début d’une brique partagée. La logique est la même dans les deux cas : déléguer à un juge extérieur non pas la réponse, mais la décision de ce qu’on garde avant de répondre — et, chez Tateno, la possibilité de s’arrêter quand rien ne mérite d’être gardé.
Côté outillage, ce qui change relève du contrat plus que de la fonctionnalité. Claude Code 2.1.278 fait passer le classifieur du mode auto côté serveur et cesse de facturer ce surcoût, exactement à l’inverse de ce que la 2.1.273 avait décidé quatre jours plus tôt : un réglage par défaut est devenu une variable économique, qui se révise à cette vitesse. Devin, lui, cesse de remplir le champ total de ses journaux d’audit, et le code appelant qui s’y fiait s’arrête — un changement rangé au milieu de nouveautés ergonomiques, alors qu’il casse des intégrations existantes. Copilot code review, enfin, sort de préversion en remplaçant la fermeture silencieuse d’un commentaire par une décision motivée, Won’t Fix ou Incorrect. Trois manières, chez trois éditeurs, de rappeler que l’essentiel d’un outil d’agent se joue désormais dans ses valeurs par défaut, sa facturation et ses promesses d’API.
Sources
- Qwen, billet Qwen3.8-LiveTranslate
- Alibaba Qwen sur X, annonce de Qwen3.8-LiveTranslate
- Quatorze jours de trafic d’agents sur deux RTX 5090
- AmberTrace Labs, la direction de l’erreur sur 19 modèles ouverts
- AmberTrace Labs, quantification et direction de sûreté
- jev-reranker, présentation et mesures
- Metro-ASR-Small, ce qu’un modèle CTC de 61 millions de paramètres apprend
- Claude Code, notes de version 2.1.278
- Documentation Claude Code, facturation du classifieur du mode auto
- Devin, notes de version
- Gemini CLI, nightly du 19 septembre
- GitHub, Copilot code review en disponibilité générale
- Pika sur X, Camera Director
- Pika, page des applications