ai-powered-markdown-translatorgpt-5.6-sol을 사용하여 프랑스어에서 한국어로 번역된 기사.
이번 토요일에는 어떤 연구소도 오픈 가중치 모델을 공개하지 않았다. 9일째 침묵 중인 DeepSeek도, Meta도, Ai2도, Sakana도 마찬가지다. 이날 유일하게 출시된 모델은 폐쇄형 API 모델인 Qwen3.8-LiveTranslate로, 동시통역 지연 시간을 2.3초까지 줄였다. 나머지는 모두 실무자에게서 나왔다. Hugging Face 커뮤니티 블로그에 게시된 11개의 글은 모델을 소개하는 대신 프로덕션 환경의 프리픽스 캐시, 인증된 의사결정, 양자화 비용, 재순위화 품질에 관한 측정 결과를 제시한다.
Qwen3.8-LiveTranslate, 동시통역 지연 시간을 2.3초 아래로 단축
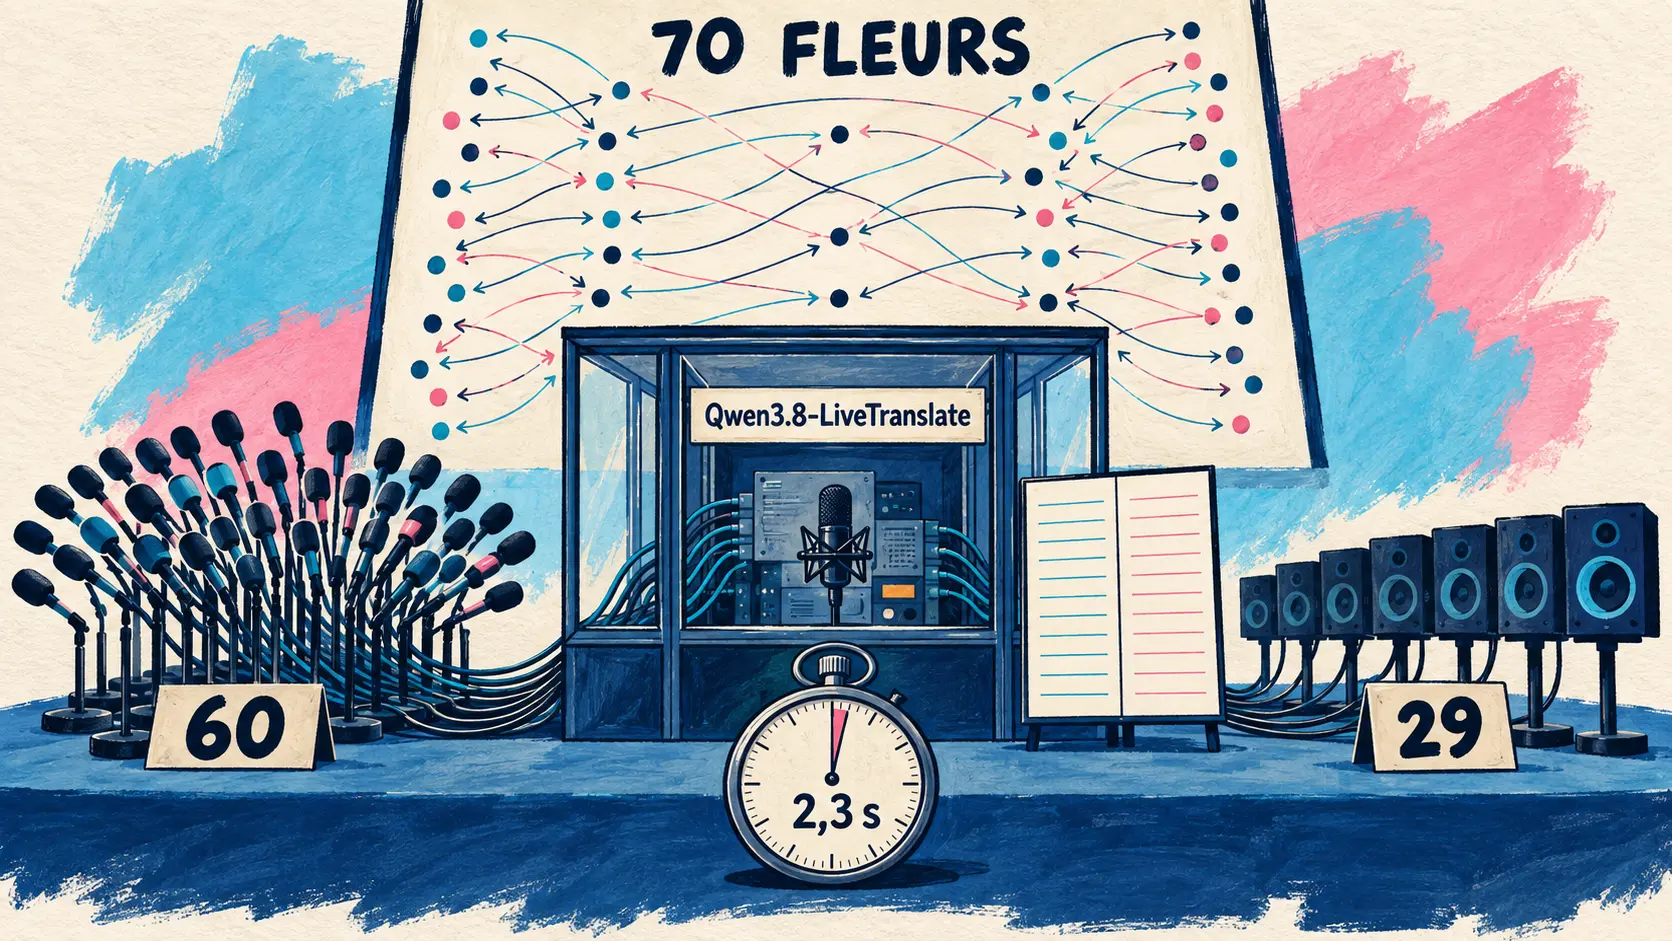
9월 19일 — Qwen은 실시간 동시통역 모델 Qwen3.8-LiveTranslate를 공개했다. Interleave 아키텍처는 오디오와 텍스트를 하나의 교차 스트림으로 처리한다. 이미 들은 오디오와 이미 생성된 번역을 캐시에 저장해 재사용함으로써 품질을 개선하는 동시에 평균 지연 시간(average lagging, LAAL)을 2.8초에서 2.3초로 줄였다.
엔진은 하이브리드 전문가 혼합(Hybrid-MoE)을 기반으로 한 Thinker-Talker의 두 모듈 앙상블이다. Thinker는 비디오, 오디오, 원문 텍스트, 번역을 시간순으로 정렬된 하나의 인과적 시퀀스에 배치하고, Talker는 원 화자의 음색을 유지하는 음성을 합성한다. 여기에 실시간 화자 분리(real-time speaker separation), 동기화된 이중 언어 표시, 긴 문맥에서의 중의성 해소라는 세 가지 기능이 제공된다.
지원 언어 범위에 관해서는 블로그 글과 발표 메시지의 내용이 다르다. 발표 메시지는 60개 언어를 통틀어 언급하지만, 블로그 글은 오디오 입력 및 텍스트 출력은 60개 언어, 오디오 출력은 29개 언어만 지원한다고 구분한다. 기준으로 삼아야 할 수치는 블로그 글의 수치다. 평가는 14개 언어 방향의 Omnilingua-MSpeaker와 70개 언어 방향의 공개 데이터세트 FLEURS에서 수행됐다. 모델은 DashScope를 통해 API로 사용할 수 있으며, 가중치 공개 계획은 발표되지 않았다.
| 측정 항목 | 발표된 수치 |
|---|---|
| 평균 지연 시간(LAAL) | 2.3초, 이전 세대의 2.8초 대비 |
| 오디오 입력 및 텍스트 출력 언어 | 60 |
| 오디오 출력 언어 | 29 |
| 공개 다국어 평가 | FLEURS, 70개 언어 방향 |
| API의 모델 이름 | qwen3.8-livetranslate-flash-realtime |
Built on an Interleave architecture, it improves faithfulness, fluency, and conciseness while reducing average lagging (LAAL) from 2.8s to 2.3s across 60 languages.
🇰🇷 Interleave 아키텍처를 기반으로 충실도, 유창성, 간결성을 개선하는 동시에 60개 언어에서 평균 지연 시간(LAAL)을 2.8초에서 2.3초로 줄였습니다. — @Alibaba_Qwen의 X 게시물
오픈 모델 측정: 같은 날 발표된 세 가지 연구
모두 Hugging Face 커뮤니티 블로그에 게시된 세 편의 독립적인 글이 동일한 대상을 세 가지 관점에서 측정한다. 실제 환경에서 오픈 모델의 성능이 어느 정도인지 살펴본 것이다.
14일간의 프로덕션 운영: 270억 모델의 성패를 가르는 프리픽스 캐시
9월 19일 — 두 대의 GeForce RTX 5090이 13.9일 동안 NVFP4로 양자화된 Qwen3.8-27B를 Scalably가 실제 고객을 대상으로 운영하는 에이전트 엔진에서 제공했다. 모든 수치는 /metrics 엔드포인트에서 읽은 카운터에 기반한다. 완료된 요청은 28,097건, 입력 토큰은 8억 6,060만 개였으며 중단은 한 건도 없었다. 프롬프트 길이의 중앙값은 6,466토큰이고 99번째 백분위수는 183,800토큰인 가운데, 사전 채우기 토큰의 82.6%가 캐시에서 제공됐다. 디코딩 속도가 두 배 빠른 Nex-N2.5-mini는 실제 의사결정을 재현한 테스트에서 자리를 내줬다. 거부된 도구 호출에서 회복한 사례가 20건 중 1건에 불과해, 20건 중 12건을 기록한 상대 모델에 뒤졌다.
The short version: on agent traffic the prefix cache decides whether a 27B model keeps up, the scheduler flags matter more than the kernels, and a faster mixture-of-experts checkpoint lost the job on behaviour, not speed.
🇰🇷 요약하면, 에이전트 트래픽에서는 프리픽스 캐시가 270억 모델이 처리 속도를 유지할 수 있는지를 결정하고, 스케줄러 옵션이 연산 커널보다 더 중요하며, 더 빠른 전문가 혼합 체크포인트는 속도가 아니라 동작 때문에 자리를 내줬습니다. — Hugging Face 블로그의 pavle-scalably
AmberTrace, 인증된 의사결정 1,350건으로 오픈 모델 19개 평가
9월 18일 — 모델이 승인하거나 거부하는 결정을 내릴 때 중요한 것은 오류의 빈도만이 아니라 오류가 어느 방향으로 발생하는가이다. AmberTrace Labs는 올바른 조치가 증명으로 인증된 1,350개 항목에서 오픈 가중치 모델 19개를 평가했다. 순위보다 모델군별 분류가 더 많은 것을 말해준다. 추론 활성화 모델의 평균은 0.960, 추론 기능은 있지만 비활성화한 모델은 0.909, 추론 기능이 없는 모델은 0.805였다. 추론 활성화와 비활성화의 차이는 크기가 크게 다른 모델 사이의 차이보다 컸다. 단일 샘플, 온도 0이라는 한계를 저자도 명시했다.
| 평가 모델 | 연구소 | 종합 점수 | 정확도 | 허용적 오류 |
|---|---|---|---|---|
| Qwen3.8-27B (추론) | Alibaba | 0.974 | 95.5% | 0.0% |
| Muse-Glimmer-30B | Meta | 0.960 | 94.0% | 3.1% |
| OLMo-3-32B-Think | Ai2 | 0.947 | 93.8% | 3.3% |
| Qwen3.8-27B | Alibaba | 0.937 | 91.3% | 6.3% |
8비트에서 2비트로: 정확도 1.3%포인트 감소, 오류의 성격은 불변
9월 19일 — 다음 날 AmberTrace는 동일한 프로토콜을 한 가지 질문에 적용했다. 양자화하면 무엇을 잃는가? Qwen3.6-27B를 Q8_0부터 Q2_K까지 여섯 가지 GGUF 수준으로 제공한 뒤 동일한 1,350개 항목에서 평가했다. 결과는 일반적인 직관과 달랐다. 정확도는 8비트의 90.9%에서 2비트의 89.6%로 낮아졌다. 수치 정밀도가 4분의 1로 줄어드는 동안 감소 폭은 1.3%포인트에 그쳤다. 가장 흥미로운 수치는 변하지 않은 값이다. 오류의 부호 편향은 결정계수 0.01로 평평하게 유지됐다. 양자화는 오류의 양을 바꾸지만 그 성격은 바꾸지 않는다. 저자는 예비 연구라는 점을 경고한다.
| 양자화 | 정확도 | 허용적 오류(임계 구간) | 부호 편향 |
|---|---|---|---|
| 8비트 | 90.9% | 5.2% | −0.024 |
| 5비트 | 91.3% | 4.5% | −0.029 |
| 4비트 | 90.2% | 6.3% | −0.018 |
| 2비트 | 89.6% | 6.3% | −0.024 |
jev-reranker, 후보 문서의 92%를 제외하면서도 순위 품질 개선
9월 19일 — Yuichi Tateno는 검색 결과를 재순위화하고, 특히 답변에 도움이 되지 않는 문서를 제외하기 위해 TypeSafe.AI의 구조화된 판단 모델 Jev를 활용하는 Python 라이브러리 jev-reranker를 공개했다. 그 논거는 토큰 절약을 넘어선다. 필터링을 통해 애플리케이션이 생성 전에 결정을 내릴 수 있기 때문이다. NanoHotpotQA에서 관련성 필터링은 요청당 문서를 7.62개만 유지하면서 nDCG@10 0.975를 기록했다. 문서 100개를 유지한 하이브리드 검색의 0.833보다 높다. 핵심 가치는 문맥 축소에 있다.
가장 흥미로운 관찰은 다른 곳에 있다. 같은 판단 모델이 바로 그날 공개된 또 다른 독립적인 글에도 등장한다. Javad Taghia는 다른 벤치마크에서 이 모델로 에이전트의 메모리를 재순위화한다.
| 순위 지정 방식 | 임곗값 | nDCG@10 | 요청당 유지된 문서 수 |
|---|---|---|---|
| 하이브리드 검색 | — | 0.833 | 100 |
| 재순위화 | 0.0 | 0.969 | 100 |
| 관련성 필터링 | 0.2 | 0.975 | 7.62(92.38% 제외) |
Metro-ASR-Small, 노트북 프로세서에서 이집트 아랍어를 처리하는 6,100만 매개변수 모델
9월 19일 — Whisper-large-v3는 매개변수가 15억 개이고 Meta의 OmniASR-LLM은 70억 개다. 모두 그래픽 카드가 필요하다. Metro-ASR-Small은 매개변수 6,160만 개, 용량 235MB로 이집트 아랍어와 영어, 두 언어의 코드 전환을 프로세서 스레드 네 개에서 실시간보다 33배에서 66배 빠르게 전사한다. 이는 본문에서 50배로 반올림한 표의 범위다. 이 글은 발표가 아니라 탐구다. 데이터와 매개변수가 제한된 상황에서 정확도는 어디에서 오는가? 사람들이 생각하는 것만큼 음향 모델에서 오지는 않는다. 두 번째 수단은 선택 사항인 6.4GB 규모의 KenLM 언어 헤드다. 음향 모델보다 27배 크다.
| 빔 너비 | 단어 오류율 | 디코딩 시간 |
|---|---|---|
| 탐욕적 디코딩 | 30.0% | 5.9ms |
| 100 | 24.3% | 128ms |
| 400 | 24.1% | 351ms |
🔗 매개변수 6,100만 개의 CTC 모델이 학습할 수 있는 것과 학습할 수 없는 것
Claude Code 2.1.278, 자동 모드 분류기를 서버 측으로 되돌리고 비용 청구 중단
9월 19일 — 자동 모드에서는 민감한 작업을 실행하기 전에 분류기가 검사한다. 지금까지 이러한 검사는 토큰 단위로 요금이 부과되는 모델 호출이었다. 이제 서버가 세션 요청의 일부로 이를 처리해 추가 비용을 청구하지 않는다. Claude API, Enterprise, Bedrock, Vertex, Foundry에 기본 적용되며 /status에 Auto mode server라는 줄이 표시된다. 대체 작동에 주의해야 한다. safeguards 필드를 누락하는 게이트웨이를 사용하면 안내 메시지 후 Claude Code가 비용이 청구되는 로컬 분류기로 전환된다.
이 변화는 그 자체로 주목할 만하다. 9월 15일의 2.1.273에서 Bedrock, Vertex, Foundry에 로컬 분류기를 기본으로 강제했던 것과 정확히 반대이기 때문이다. 나흘 만에 원점으로 돌아왔다.
We’re changing auto mode to no longer charge for classifier requests in Claude Code. However, this session isn’t eligible.
🇰🇷 Claude Code에서 분류기 요청에 더 이상 비용을 청구하지 않도록 자동 모드를 변경하고 있습니다. 하지만 이 세션은 해당 변경의 적용 대상이 아닙니다. — Claude Code 문서, 비용이 청구되는 대체 작동 시 표시되는 안내
코딩 도구 업데이트: 사라지는 API 필드와 강화되는 의사 터미널
Devin: Azure DevOps Server, MCP 재연결, 이제 null을 반환하는 total 필드
9월 18일 — Cognition이 공개한 일련의 릴리스 노트는 에이전트 엔진이 아니라 관리와 엔터프라이즈 연결을 다룬다. 가장 중요한 내용은 새로운 기능이 아니라 호환성 단절이다. Enterprise API의 감사 로그 목록에서 total 필드는 더 이상 채워지지 않고 null을 반환한다. 페이지 매김에는 has_next_page과 end_cursor을 사용해야 한다. 이 카운터에 의존하던 모든 호출 코드는 작동을 멈춘다. 나머지는 기능 추가다. 이전에는 클라우드 버전만 지원했지만, 이제 Azure DevOps Server 2020 및 2022 컬렉션을 개인 액세스 토큰으로 연결할 수 있다. 각 MCP 서버에는 제거하지 않고 인증을 다시 수행하는 Reconnect 작업이 추가된다. ActiveCampaign과 Grafana(OAuth)가 카탈로그에 포함되고, 세션을 출처별로 필터링할 수 있으며, 화면 녹화 속도는 초당 60프레임으로 높아진다.
Gemini CLI: 보안 수정 없이 의사 터미널에 초점을 맞춘 nightly
9월 19일 — Gemini CLI의 nightly 채널은 오전 3시 25분에 다섯 가지 수정 사항이 포함된 v0.62.0-nightly.20260919.gcfbcaa8df 버전을 공개했다. 보안 변경 사항은 없다. 이전 nightly 버전들의 흐름과 달라진 점이다. 두 가지는 의사 터미널을 대상으로 한다. Windows 의사 터미널 구현인 ConPTY 프로세스의 종료 수명 주기 동기화와 터미널 버퍼의 메모리 관리다. 나머지 세 가지는 불편 사항을 수정한다. 요청 취소 시 표시되는 AbortError 로그, VS Code 확장 프로그램에서 비교 탭을 닫을 때 사라지는 터미널 포커스, 유효하지 않은 앵커를 가리키는 인증 문서 링크다. 공개 채널은 변경되지 않아 stable은 v0.60.0, preview는 v0.61.0-preview.0을 유지한다.
Copilot code review, 결과 보고서 개편과 함께 정식 출시
9월 18일 — GitHub는 Copilot code review가 pull request에 남기는 결과 보고서의 개편판을 정식 출시했다. 요약 댓글에는 현재 평가와 검토 노력 수준이 표시되며, 발견 사항을 세 그룹으로 나눠 각각 심각도와 인라인 댓글 링크를 제공한다. 커밋이 이어져도 요약은 새로 작성되는 대신 진행 상황을 유지한다. 9월 11일 도입된 자동 해결 기능도 확대됐다. 문제를 열린 상태로 유지해 달라는 답변을 존중하며, 자동으로 해결할 때는 Won’t Fix 또는 Incorrect라는 사유를 표시한다. 말없이 닫는 대신 근거가 있고 이의를 제기할 수 있는 결정이다.
| 발견 사항 그룹 | 포함 내용 |
|---|---|
| Open | 처리되지 않은 문제, 새 커밋에서 발생한 경우 new 레이블 표시 |
| Resolved since last review | Copilot이 수정되었다고 확인한 문제 |
| Previously missed | 새 커밋에서 발생한 문제가 아니며 후속 검토에서 발견된 문제 |
🔗 Copilot code review, 개선된 검토 환경
Pika, 새로운 플랫폼의 애플리케이션 이름을 공개하다
9월 19일 — 9월 17일, Pika는 단 하나의 기능이나 요금도 언급하지 않은 채 자사 제품을 창작 플랫폼으로 전면 개편한다고 발표했다. 18일 저녁부터 19일 아침 사이, 회사는 애플리케이션 이름을 하나씩 공개하는 일련의 메시지로 이 공백을 채웠다. 이 목록이 전체 카탈로그는 아니다. Pika 홈페이지에는 Video Studio, Color Grade, Extend Video, Pika Soundtrack, Edit Image, Character Studio, Image Studio, Product Shot 등 8개 애플리케이션이 나열되어 있지만 Camera Director와 Relight Media는 빠져 있어, 실제 제공 범위가 이번에 잇달아 발표된 항목보다 더 넓다는 점을 보여준다.
| 발표된 애플리케이션 | Pika가 설명한 기능 |
|---|---|
| Video Studio | 처음부터 영상을 제작하며, 여러 장면으로 최대 3분까지 만들 수 있고 사운드도 포함 |
| Camera Director | 업로드한 장면을 다른 각도에서 재생성하며, 움직임과 연기는 그대로 유지 |
| Relight Media | 클립의 빛 색상, 강도, 방향을 각각 조정 |
🔗 Video Studio · 🔗 Camera Director · 🔗 Relight Media
단신
- 커뮤니티 노트가 Accenture에 맡긴 평가의 독립성에 이의를 제기하다 — 18일에 다룬 파트너십의 후속 내용으로, Anthropic이 Accenture의 작업에 직접 자금을 지원하며 이미 양사 사이에 기존 상업적 파트너십이 있고 약 30,000명의 Accenture 전문가가 Claude 교육을 받았다는 점을 지적한다. 🔗 출처
- Replit이 감사 로그에 65개가 넘는 이벤트를 추가하다 — Enterprise 계정 관리자를 대상으로 프로젝트, 작업 공간, 배포, 계정 보안, SSO와 SCIM, 커넥터, 비밀 정보, Agent 활동을 포함하며, 상세 목록이나 별도의 제공 일정은 공개하지 않았다. 🔗 출처
- Qwen Code v0.24.1이 전날의 미리보기 버전을 안정 버전으로 전환하다 — 08:18 UTC에 공개된 이 버전은 이미 다룬 v0.24.1-preview.0에 항목 6개만 추가했다. 새로운 소식은 내용 자체가 아니라 Playwright 브라우저 SDK와 컨테이너 내 하위 Agent가 정식 기능으로 승격됐다는 점이다. 🔗 출처
- Kimi Code 2.0.2가 결함 5개를 수정하다 — 2.0.1 출시 23시간 뒤에 나왔으며 새로운 기능은 없다. 재개 후 메시지가 이전 위치에 표시되던 문제, 중복 항목, 모델 변경 후 compaction이 작동하지 않던 문제가 수정됐다. 🔗 출처
- Jev로 Agent 메모리의 순서를 재조정하자 1위 재현율이 34%에서 54%로 상승하다 — LoCoMo 질문 1,986개에서 AtMem의 상위 후보 10개를 재정렬하자 10위 이내 재현율은 0.6495로 그대로인 채 MRR@5가 0.4259에서 0.5868로 높아졌다. 🔗 출처
- Layer-Feedback Transformer가 매개변수 1,000만 개에서 4.29포인트 향상됐지만, 동일한 연산량에서는 그렇지 않다 — 인접 레이어를 다시 실행하자 자체 벤치마크에서 모델 성능이 32.57%에서 36.86%로 상승했지만 블록 실행 횟수는 2.64배 늘었으며, 저자도 이 한계를 명시적으로 인정한다. 🔗 출처
- AmberTrace가 수학과 코드를 넘어 검증 가능한 보상을 도입해야 한다고 주장하다 — 벤치마크 없는 입장문이다. 성공한 것처럼 보이는 결과에 보상을 주면 모델은 성공의 외양을 최적화하며, 결정에 책임이 따르는 분야에는 여전히 검증 가능한 보상이 없다고 지적한다. 🔗 출처
- 오래된 문서가 메모리 업데이트를 무효화할 수 있는지 확인하는 테스트 프로토콜 — 측정 결과 없이 시험 절차를 제안한다. 교체된 문서가 새로운 타임스탬프와 함께 다시 가져와졌을 때 시스템이 가장 최근에 들어온 문서를 최신 문서로 처리하면, 이 문서는 아무런 경고 없이 다시 현재 답변이 된다. 🔗 출처
- Agent와 물리적 세계 사이의 인터페이스로서의 코드 — 별도의 발표나 자체적인 수치 결과 없이, 코딩 Agent의 루프와 로봇 조작용 프로그램 생성을 연결해 설명한 교육용 종합 글이다. 🔗 출처
- Qwen이 Qwen3.8-27B 기반 Cerebras 시연을 공유하다 — 제3자가 Cerebras 추론 기술로 만든 개인 금융 도우미다. 제품 발표가 아닌 축하 차원의 공유이며, 그 기반이 된 주제는 이미 9월 12일에 다뤘다. 🔗 출처
- OpenAI가 Australian Youth Safety Blueprint를 공개하다 — 호주에서 AI를 사용하는 청소년을 보호하기 위한 6대 축의 로드맵으로, 문해력부터 개인정보 보호형 연령 확인까지 다룬다. 회사는 13~17세를 위한 ChatGPT for Teens를 지난 8월부터 호주에 배포하고 있다고 다시 밝혔다. 🔗 출처
- iOS용 ChatGPT 1.2026.251에 폴더와 글쓰기 블록이 추가되다 — 파일 선택기에서 폴더를 만들 수 있고, 초안 변형과 복사 작업을 제공하는 글쓰기 블록이 추가됐으며, worktree와 대기열에 들어간 prompt를 중심으로 한 수정 8개도 포함됐다. 🔗 출처
이것이 의미하는 것
이날은 이례적인 양상을 보였다. 연구소들은 침묵했고 실무자들이 글을 발표했다. 9일째 소식이 없고 독립적인 세 경로에서 확인된 DeepSeek를 비롯해 Meta, Ai2, Sakana 모두 아무것도 내놓지 않았다. 공개 모델 분야에서 발견된 11건은 모두 같은 곳인 Hugging Face 커뮤니티 블로그에서 나왔으며, 어떤 모델도 소개하지 않고 측정만 수행했다. 14일간의 고객 트래픽에 적용한 prefix cache, 증명으로 인증된 결정 1,350건, 6단계 quantization, 재정렬 품질이 그 대상이었다. 이날 유일하게 출시된 모델인 Qwen3.8-LiveTranslate는 반대로 공개 가중치가 없는 API 제품이다. 이번 토요일, 공개 생태계는 원재료를 생산하지 않고 측정 도구를 만들어냈다.
이 측정 결과들이 말하는 바는 하나로 수렴하며, 그 다양성보다 이 점이 더 흥미롭다. 세 사례 모두 최종 결과를 좌우한 기준은 예상했던 요소가 아니었다. 두 배 빠른 mixture-of-experts 모델은 속도가 아니라 행동 방식 때문에 밀려났다. 거부된 tool call에서 회복한 비율이 20번 중 단 한 번에 불과했기 때문이다. 19개 모델의 순위를 보면 동일한 모델에서 reasoning을 활성화했을 때와 비활성화했을 때의 격차가 크기가 크게 다른 모델 사이의 격차보다 컸다. 또한 8비트에서 2비트로 낮추면 정확도가 1.3포인트 떨어지지만 오류의 방향은 달라지지 않는다. 이는 속도, 크기, 수치 정밀도가 모델이 실제 운영 환경에서 어떻게 행동할지를 예측하는 데 적합하지 않으며, 회복하고 숙고하고 편향되는 방식 등 다른 곳을 살펴봐야 한다는 점을 서로 다른 세 방식으로 보여준다.
더 미묘한 신호도 주목할 만하다. 같은 평가 모델인 Jev가 서로 무관한 두 글에 같은 날 등장했다. Yuichi Tateno는 연구 문서를 걸러내는 데, Javad Taghia는 Agent 메모리를 재정렬하는 데 이를 사용했으며 서로 다른 두 벤치마크에서 측정했다. 독립된 저자 두 명이 같은 날 제3자 모델을 도구로 활용했다는 것은 공유 구성 요소가 형성되기 시작했다는 의미다. 두 사례의 논리는 같다. 외부 평가자에게 답변 자체가 아니라 답변 전에 무엇을 남길지 결정하는 일을 맡기는 것이다. Tateno의 사례에서는 남길 가치가 있는 것이 아무것도 없을 때 중단할 수도 있다.
도구 측면에서 달라진 것은 기능보다 계약에 가깝다. Claude Code 2.1.278은 서버 측 auto mode classifier를 전환하고 이 추가 비용 청구를 중단했다. 이는 불과 나흘 전 2.1.273에서 내린 결정과 정확히 반대다. 기본 설정이 경제적 변수가 됐으며, 이처럼 빠른 속도로 재검토된다. Devin은 감사 로그의 total 필드를 더 이상 채우지 않아, 이 필드에 의존하던 호출 코드가 작동을 멈춘다. 기존 연동을 깨뜨리는 변경임에도 사용성 개선 사항 사이에 포함됐다. 마지막으로 Copilot code review는 댓글을 조용히 닫는 방식 대신 Won’t Fix 또는 Incorrect라는 사유가 있는 결정을 제시하며 미리보기 단계를 벗어났다. 세 공급업체가 서로 다른 세 방식으로 보여주듯, 이제 Agent 도구의 핵심은 기본값, 과금, API 약속에 달려 있다.
출처
- Qwen, Qwen3.8-LiveTranslate 게시물
- X의 Alibaba Qwen, Qwen3.8-LiveTranslate 발표
- RTX 5090 두 대에서 수집한 14일간의 Agent 트래픽
- AmberTrace Labs, 공개 모델 19개의 오류 방향
- AmberTrace Labs, quantization과 안전성 방향
- jev-reranker, 소개 및 측정 결과
- Metro-ASR-Small, 매개변수 6,100만 개의 CTC 모델이 학습하는 것
- Claude Code, 2.1.278 릴리스 노트
- Claude Code 문서, auto mode classifier 과금
- Devin, 릴리스 노트
- Gemini CLI, 9월 19일 nightly
- GitHub, Copilot code review 정식 출시
- X의 Pika, Camera Director
- Pika, 애플리케이션 페이지