ai-powered-markdown-translatorArtikel vertaald van het Frans naar het Nederlands met gpt-5.6-sol.
Deze zaterdag heeft geen enkel laboratorium een model met open gewichten uitgebracht: noch DeepSeek, dat al negen dagen niets van zich laat horen, noch Meta, Ai2 of Sakana. De enige release van de dag is een gesloten API-model, Qwen3.8-LiveTranslate, dat de latentie van simultaanvertolking terugbrengt tot 2,3 seconden. Al het overige komt van mensen uit de praktijk: elf berichten op de communityblog van Hugging Face, die geen modellen presenteren maar metingen — prefix caching in productie, gecertificeerde beslissingen, de kosten van quantization en de kwaliteit van reranking.
Qwen3.8-LiveTranslate, simultaanvertolking onder de grens van 2,3 seconden
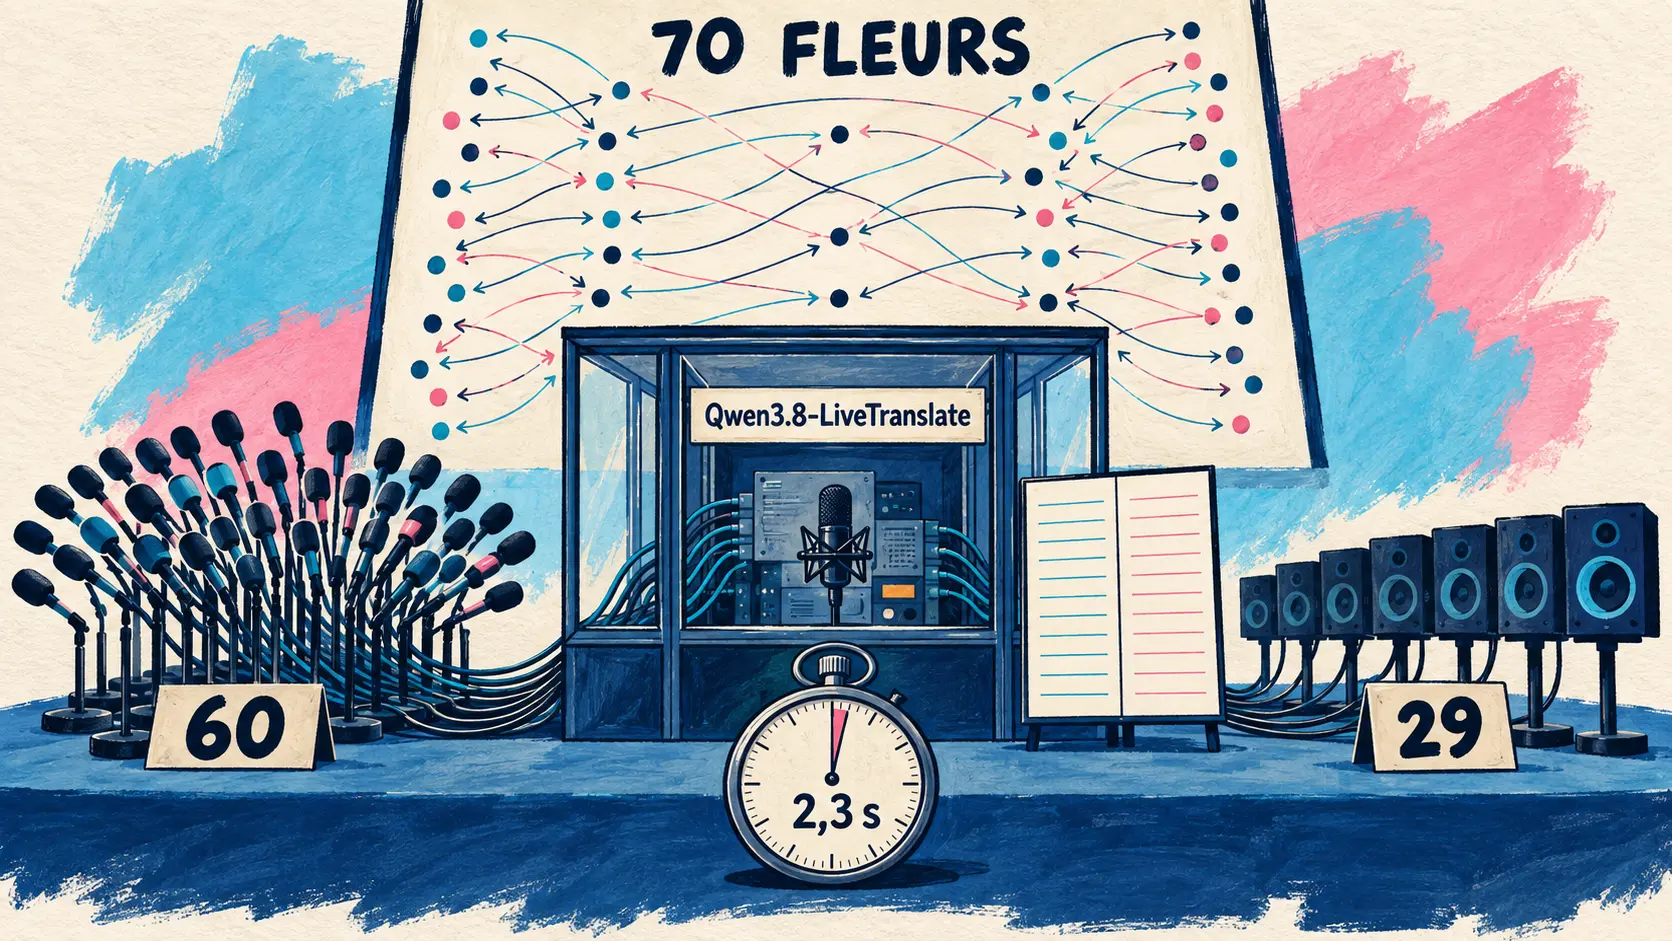
19 september — Qwen heeft Qwen3.8-LiveTranslate gepresenteerd, zijn model voor realtime simultaanvertolking. De Interleave-architectuur verwerkt audio en tekst als één vervlochten stroom, waarin reeds beluisterde audio en reeds geproduceerde vertalingen worden gecachet en vervolgens hergebruikt. Daardoor daalt de gemiddelde latentie (average lagging, LAAL) bij een verbeterde kwaliteit van 2,8 naar 2,3 seconden.
De engine is een geheel van twee Thinker-Talker-modules, gebaseerd op een hybride mixture of experts (Hybrid-MoE): de Thinker plaatst video, audio, brontekst en vertaling in één causale, chronologisch geordende sequentie, waarna de Talker een stem synthetiseert die de klankkleur van de oorspronkelijke spreker behoudt. Het model beschikt daarnaast over drie mogelijkheden: realtime scheiding van sprekers (real-time speaker separation), een gesynchroniseerde tweetalige weergave en disambiguatie in een lange context.
Over de taalondersteuning spreken het blogbericht en de aankondiging elkaar tegen: de aankondiging noemt zonder verdere nuance 60 talen, terwijl het blogbericht onderscheid maakt tussen 60 talen voor audio-invoer met tekstuitvoer en slechts 29 voor audio-uitvoer. De cijfers uit het blogbericht zijn leidend. De evaluaties zijn uitgevoerd op Omnilingua-MSpeaker, in 14 taalrichtingen, en op de openbare dataset FLEURS, in 70 richtingen. Het model is via de DashScope-API te gebruiken: er is geen vrijgave van de gewichten aangekondigd.
| Gemeten onderdeel | Aangekondigde waarde |
|---|---|
| Gemiddelde latentie (LAAL) | 2,3 s, tegenover 2,8 s voor de vorige generatie |
| Talen voor audio-invoer, tekstuitvoer | 60 |
| Talen voor audio-uitvoer | 29 |
| Openbare meertalige evaluatie | FLEURS, 70 taalrichtingen |
| Modelnaam in de API | qwen3.8-livetranslate-flash-realtime |
Built on an Interleave architecture, it improves faithfulness, fluency, and conciseness while reducing average lagging (LAAL) from 2.8s to 2.3s across 60 languages.
🇳🇱 Het is gebaseerd op een Interleave-architectuur en verbetert de getrouwheid, vloeiendheid en beknoptheid, terwijl het de gemiddelde latentie (LAAL) in 60 talen verlaagt van 2,8 s naar 2,3 s. — @Alibaba_Qwen op X
🔗 Blogbericht over Qwen3.8-LiveTranslate
Open modellen meten: drie onderzoeken die op dezelfde dag zijn gepubliceerd
Drie onafhankelijke artikelen, allemaal verschenen op de communityblog van Hugging Face, meten hetzelfde vanuit drie invalshoeken: hoe goed een open model in reële omstandigheden presteert.
Veertien dagen in productie: prefix caching bepaalt het lot van een model met 27 miljard parameters
19 september — Gedurende 13,9 dagen hebben twee GeForce RTX 5090-kaarten de in NVFP4 gequantiseerde Qwen3.8-27B beschikbaar gesteld aan de agent-engine die Scalably voor echte klanten beheert. Elk cijfer is afkomstig van een teller op het toegangspunt /metrics: 28.097 voltooide verzoeken, 860,6 miljoen invoertokens en nul afgebroken verzoeken. Met een mediaan van 6.466 tokens per prompt en een 99e percentiel van 183.800 komt 82,6% van de prefill-tokens uit de cache. En Nex-N2.5-mini, dat twee keer sneller decodeert, verloor zijn plaats bij het opnieuw afspelen van echte beslissingen: het herstelt zich slechts in 1 van de 20 gevallen van een afgewezen toolaanroep, tegenover 12 van de 20.
The short version: on agent traffic the prefix cache decides whether a 27B model keeps up, the scheduler flags matter more than the kernels, and a faster mixture-of-experts checkpoint lost the job on behaviour, not speed.
🇳🇱 Samengevat: bij agentverkeer bepaalt prefix caching of een model met 27 miljard parameters het tempo kan bijhouden, zijn de opties van de scheduler belangrijker dan de compute-kernels, en verloor een sneller mixture-of-experts-checkpoint zijn plaats vanwege zijn gedrag, niet vanwege zijn snelheid. — pavle-scalably op de Hugging Face-blog
AmberTrace beoordeelt 19 open modellen op 1.350 gecertificeerde beslissingen
18 september — Wanneer een model beslist iets toe te staan of te weigeren, is de vraag niet alleen hoe vaak het zich vergist, maar ook in welke richting. AmberTrace Labs heeft 19 modellen met open gewichten geëvalueerd op 1.350 items waarvan de juiste actie door bewijs was gecertificeerd. De indeling per familie zegt meer dan de ranglijst: reasoning ingeschakeld, gemiddeld 0,960; geschikt voor reasoning maar met de optie uitgeschakeld, 0,909; zonder reasoning, 0,805. Het verschil tussen het in- en uitschakelen van reasoning is groter dan het verschil tussen sterk uiteenlopende modelgroottes. Eén sample, temperatuur 0: de auteur vermeldt de beperkingen.
| Geëvalueerd model | Laboratorium | Samengestelde score | Nauwkeurigheid | Permissieve fout |
|---|---|---|---|---|
| Qwen3.8-27B (reasoning) | Alibaba | 0,974 | 95,5% | 0,0% |
| Muse-Glimmer-30B | Meta | 0,960 | 94,0% | 3,1% |
| OLMo-3-32B-Think | Ai2 | 0,947 | 93,8% | 3,3% |
| Qwen3.8-27B | Alibaba | 0,937 | 91,3% | 6,3% |
🔗 De richting van fouten in beslissingsmodellen met open gewichten
Van 8 naar 2 bits: 1,3 procentpunt nauwkeurigheid, zonder wezenlijke verandering
19 september — De volgende dag past AmberTrace hetzelfde protocol toe op één vraag: wat verliezen we door quantization? Qwen3.6-27B werd aangeboden op zes GGUF-niveaus, van Q8_0 tot Q2_K, en vervolgens geëvalueerd op dezelfde 1.350 items. Het resultaat spreekt de gangbare intuïtie tegen: de nauwkeurigheid daalt van 90,9% bij 8 bits naar 89,6% bij 2 bits, oftewel 1,3 procentpunt bij een viervoudige vermindering van de numerieke precisie. Het interessantste cijfer is het cijfer dat niet verandert: de getekende bias van de fouten blijft vlak, met een determinatiecoëfficiënt van 0,01. Quantization verandert de hoeveelheid fouten, niet hun aard. Het gaat om een voorlopig onderzoek, waarschuwt de auteur.
| Quantization | Nauwkeurigheid | Permissieve fout (kritieke band) | Getekende bias |
|---|---|---|---|
| 8 bits | 90,9% | 5,2% | −0,024 |
| 5 bits | 91,3% | 4,5% | −0,029 |
| 4 bits | 90,2% | 6,3% | −0,018 |
| 2 bits | 89,6% | 6,3% | −0,024 |
🔗 Quantization en de veiligheidsrichting van beslissingen
jev-reranker verwijdert 92% van de kandidaatdocumenten en verbetert toch de rangschikking
19 september — Yuichi Tateno publiceert jev-reranker, een Python-library die gebruikmaakt van Jev, het model van TypeSafe.AI voor gestructureerde beoordeling, om zoekresultaten opnieuw te rangschikken en vooral documenten te verwijderen die niet helpen bij het beantwoorden van de vraag. Het argument gaat verder dan het besparen van tokens: filtering geeft de applicatie vóór de generatie een beslissing om te nemen. Op NanoHotpotQA bereikt filtering een nDCG@10 van 0,975 met slechts 7,62 documenten per verzoek, tegenover 0,833 voor hybride zoeken, dat er 100 behoudt: de vermindering van de context maakt het interessant.
De interessantste observatie ligt elders: hetzelfde beoordelingsmodel verschijnt diezelfde dag in een tweede, onafhankelijk artikel, waarin Javad Taghia het geheugen van een agent opnieuw rangschikt op een andere benchmark.
| Rangschikkingsmethode | Drempel | nDCG@10 | Behouden documenten per verzoek |
|---|---|---|---|
| Hybride zoeken | — | 0,833 | 100 |
| Reranking | 0,0 | 0,969 | 100 |
| Relevantiefiltering | 0,2 | 0,975 | 7,62 (92,38% verwijderd) |
🔗 Introductie van jev-reranker
Metro-ASR-Small, 61 miljoen parameters voor Egyptisch-Arabisch op een laptopprocessor
19 september — Whisper-large-v3 telt 1,5 miljard parameters, OmniASR-LLM van Meta 7 miljard: beide vereisen een grafische kaart. Metro-ASR-Small telt 61,6 miljoen parameters, past in 235 MB en transcribeert Egyptisch-Arabisch, Engels en code-switching tussen beide talen met 33 tot 66 keer de realtime snelheid op vier processorthreads — het bereik uit de tabel, dat in de tekst wordt afgerond tot een factor 50. Het artikel is geen aankondiging, maar een onderzoek: waar komt de nauwkeurigheid vandaan wanneer data en parameters beperkt zijn? Minder uit het akoestische model dan men zou denken. De tweede hefboom is een optionele KenLM-taalcomponent van 6,4 GB: zevenentwintig keer zo groot als het akoestische model.
| Beam width | Word error rate | Decodeertijd |
|---|---|---|
| Greedy decoding | 30,0% | 5,9 ms |
| 100 | 24,3% | 128 ms |
| 400 | 24,1% | 351 ms |
🔗 Wat een CTC-model met 61 miljoen parameters wel en niet kan leren
Claude Code 2.1.278 verplaatst de classifier van de automatische modus terug naar de server en rekent hem niet meer aan
19 september — In de automatische modus inspecteert een classifier gevoelige acties voordat ze worden uitgevoerd; deze controles waren tot nu toe modelaanroepen die per token werden aangerekend. De server voert ze voortaan uit als onderdeel van de sessieverzoeken, zonder deze extra kosten aan te rekenen. Dit geldt standaard voor de Claude API, Enterprise, Bedrock, Vertex en Foundry, met een regel Auto mode server in /status. Let op de fallback: een gateway die het veld safeguards verwijdert, laat Claude Code na een melding terugvallen op zijn lokale classifier, waarvoor wel kosten worden aangerekend.
Deze ontwikkeling verdient als zodanig aandacht: het is precies het tegenovergestelde van versie 2.1.273 van 15 september, die de lokale classifier standaard had gemaakt voor Bedrock, Vertex en Foundry. Een volledige ommekeer in vier dagen.
We’re changing auto mode to no longer charge for classifier requests in Claude Code. However, this session isn’t eligible.
🇳🇱 We wijzigen de automatische modus zodat verzoeken van de classifier in Claude Code niet langer worden aangerekend. Deze sessie komt hiervoor echter niet in aanmerking. — Claude Code-documentatie, melding die wordt weergegeven bij een betaalde fallback
🔗 Release notes van Claude Code 2.1.278
Codingtools worden bijgewerkt: een API-veld verdwijnt, een pseudoterminal wordt robuuster
Devin: Azure DevOps Server, opnieuw verbinding maken met MCP en een veld total dat voortaan null retourneert
18 september — De reeks release notes van Cognition verandert niets aan de agent-engine, maar richt zich op beheer en bedrijfsverbindingen. Het belangrijkste feit is geen nieuwe functie, maar een breaking change: in de lijst met auditlogs van de Enterprise API wordt het veld total niet langer ingevuld en retourneert het null; pagination moet voortaan via has_next_page en end_cursor verlopen. Alle aanroepende code die op deze teller vertrouwde, stopt met werken. De rest zijn toevoegingen: collecties van Azure DevOps Server 2020 en 2022 worden met een persoonlijk toegangstoken ondersteund, terwijl voorheen alleen de cloudversie werd ondersteund; elke MCP-server krijgt een actie Reconnect, die de authenticatie opnieuw uitvoert zonder de server te verwijderen; ActiveCampaign en Grafana (OAuth) worden aan de catalogus toegevoegd; sessies kunnen op oorsprong worden gefilterd en schermopnamen gaan naar 60 frames per seconde.
Gemini CLI: een nightly zonder beveiligingsfix, gericht op de pseudoterminal
19 september — Het nightly-kanaal van Gemini CLI publiceert om 03.25 uur versie v0.62.0-nightly.20260919.gcfbcaa8df, met vijf fixes en geen beveiligingswijzigingen — een breuk met de reeks voorgaande nightlies. Twee daarvan zijn gericht op de pseudoterminal: synchronisatie van de exit lifecycle van ConPTY-processen, de Windows-implementatie van de pseudoterminal, en vervolgens het geheugenbeheer van de terminalbuffer. De overige drie verhelpen ergernissen: AbortError-logs die worden weergegeven wanneer een verzoek wordt geannuleerd, verlies van terminalfocus bij het sluiten van een vergelijkingstabblad in de VS Code-extensie en een link naar de authenticatiedocumentatie die naar een ongeldige anchor verwijst. De openbare kanalen blijven ongewijzigd: stable op v0.60.0 en preview op v0.61.0-preview.0.
🔗 Release notes van de nightly van 19 september
Copilot code review vernieuwt zijn rapportage en wordt algemeen beschikbaar
18 september — GitHub maakt een vernieuwde versie van de rapportage die Copilot code review op een pull request achterlaat algemeen beschikbaar. De samenvattende opmerking toont de huidige beoordeling en het niveau van de review-inspanning, en verdeelt de bevindingen over drie groepen, elk met de ernst en een link naar de inline opmerking. Naarmate er commits bijkomen, bewaart de samenvatting de voortgang in plaats van zichzelf te herschrijven. De automatische oplossing, geïntroduceerd op 11 september, wordt uitgebreid: een antwoord waarin wordt gevraagd een probleem open te laten, wordt gerespecteerd, en bij een automatische oplossing wordt de reden vermeld, Won’t Fix of Incorrect — een gemotiveerde en betwistbare beslissing in plaats van een geruisloze sluiting.
| Groep bevindingen | Inhoud |
|---|---|
| Open | Onopgeloste problemen, met het label new als ze door een nieuwe commit zijn geïntroduceerd |
| Resolved since last review | Problemen waarvan Copilot heeft bevestigd dat ze zijn opgelost |
| Previously missed | Problemen die niet door een nieuwe commit zijn geïntroduceerd en bij een latere review zijn gevonden |
🔗 Copilot code review, een verbeterde reviewervaring
Pika geeft de applicaties van zijn nieuwe platform een naam
19 september — Op 17 september kondigde Pika de volledige herziening van zijn product tot een creatief platform aan, zonder ook maar één functie of prijs te noemen. Tussen de avond van 18 september en de ochtend van 19 september vulde het bedrijf deze leemte met een reeks berichten waarin applicaties één voor één bij naam worden genoemd. Deze lijst is niet de catalogus: de homepage van Pika vermeldt acht applicaties — Video Studio, Color Grade, Extend Video, Pika Soundtrack, Edit Image, Character Studio, Image Studio en Product Shot — maar Camera Director en Relight Media ontbreken, wat erop wijst dat het aanbod breder is dan deze opeenvolgende aankondigingen.
| Aangekondigde applicatie | Door Pika beschreven functie |
|---|---|
| Video Studio | Video vanaf nul, tot 3 minuten in meerdere shots, inclusief geluid |
| Camera Director | Genereert een geüploade scène opnieuw vanuit andere hoeken, met behoud van beweging en spel |
| Relight Media | Past kleur, intensiteit en richting van het licht in een clip afzonderlijk aan |
🔗 Video Studio · 🔗 Camera Director · 🔗 Relight Media
Kort nieuws
- Een communityopmerking betwist de onafhankelijkheid van de aan Accenture toevertrouwde evaluatie — aanvulling op het op 18 september besproken partnerschap: de opmerking vermeldt dat Anthropic het werk van Accenture rechtstreeks zal financieren en dat beide bedrijven al door een eerder commercieel partnerschap verbonden zijn, waarbij ongeveer 30.000 professionals van Accenture in Claude zijn opgeleid. 🔗 bron
- Replit breidt zijn auditlogs uit met meer dan 65 extra gebeurtenissen — projecten, werkruimten, implementaties, accountbeveiliging, SSO en SCIM, connectors, secrets en activiteit van de Agent, voor beheerders van Enterprise-accounts; er is noch een gedetailleerde lijst, noch een afzonderlijke beschikbaarheidsdatum. 🔗 bron
- Qwen Code v0.24.1 maakt de previewversie van de vorige dag stabiel — gepubliceerd om 08:18 UTC, voegt deze slechts zes vermeldingen toe aan de al behandelde v0.24.1-preview.0: het nieuws is de promotie van de Playwright-browser-SDK en subagents in containers, niet de inhoud. 🔗 bron
- Kimi Code 2.0.2 verhelpt vijf gebreken — drieëntwintig uur na 2.0.1 en zonder nieuwe functie: berichten die na het hervatten niet langer op een oude positie terechtkomen, verwijderde duplicaten en herstelde compactie na een modelwijziging. 🔗 bron
- Het herordenen van het geheugen van een agent met Jev verhoogt de recall op de eerste plaats van 34 naar 54% — bij 1.986 LoCoMo-vragen verhoogt het herordenen van de tien beste kandidaten van AtMem de MRR@5 van 0,4259 naar 0,5868, zonder de recall op tien te veranderen, die op 0,6495 bleef. 🔗 bron
- De Layer-Feedback Transformer wint 4,29 punten bij 10 miljoen parameters, maar niet bij gelijke rekenkosten — het opnieuw uitvoeren van aangrenzende lagen brengt een model op een intern benchmark van 32,57 naar 36,86%, ten koste van 2,64 keer zoveel blokuitvoeringen, een beperking die de auteur expliciet erkent. 🔗 bron
- AmberTrace pleit voor verifieerbare beloningen buiten wiskunde en code — positionerend essay zonder benchmark: het belonen van de schijn van succes levert een model op dat die schijn optimaliseert, terwijl domeinen waarin een beslissing verantwoordelijkheid met zich meebrengt verstoken zijn gebleven van verifieerbare beloningen. 🔗 bron
- Een testprotocol om vast te stellen of een oud document een geheugenupdate kan terugdraaien — voorgesteld recept, zonder meting: een vervangen document dat opnieuw wordt geïmporteerd met een verse tijdstempel wordt stilzwijgend weer het actuele antwoord als het systeem de meest recente binnenkomst als de meest actuele behandelt. 🔗 bron
- Code als interface tussen agents en de fysieke wereld — educatief overzicht dat de lus van een code-agent vergelijkt met het genereren van programma’s voor robotmanipulatie, zonder eigen aankondiging of cijfermatig resultaat. 🔗 bron
- Qwen deelt een demonstratie van Cerebras op basis van Qwen3.8-27B — een door een derde partij gebouwde assistent voor persoonlijke financiën op Cerebras-inferentie; een feliciterende repost en geen productaankondiging, aangezien het onderliggende onderwerp op 12 september al werd behandeld. 🔗 bron
- OpenAI publiceert zijn Australian Youth Safety Blueprint — een routekaart met zes pijlers voor de bescherming van jonge AI-gebruikers in Australië, van geletterdheid tot privacyvriendelijke leeftijdsverificatie; het bedrijf herinnert eraan dat ChatGPT for Teens sinds augustus in het land beschikbaar is voor 13- tot 17-jarigen. 🔗 bron
- ChatGPT voor iOS 1.2026.251 voegt mappen en schrijfblokken toe — mappen maken vanuit de bestandskiezer, schrijfblokken met conceptvarianten en kopieeracties, plus acht oplossingen die zijn gericht op worktrees en prompts in de wachtrij. 🔗 bron
Wat dit betekent
De dag heeft een ongebruikelijke vorm: de laboratoria zwijgen en de praktijkmensen publiceren. Noch DeepSeek, dat al negen dagen niets van zich laat horen en op drie onafhankelijke kanalen is gecontroleerd, noch Meta, Ai2 of Sakana heeft iets uitgebracht. Alle elf vondsten op het gebied van open modellen komen uit dezelfde bron, de communityblog van Hugging Face, en geen daarvan presenteert een model: ze meten. Een prefixcache over veertien dagen klantverkeer, 1.350 door bewijs gecertificeerde beslissingen, zes kwantisatieniveaus, de kwaliteit van een herordening. De enige modelrelease van de dag, Qwen3.8-LiveTranslate, is daarentegen een API-product zonder open gewichten. Het open ecosysteem heeft deze zaterdag geen grondstoffen geproduceerd — het heeft meetinstrumenten geproduceerd.
Wat deze metingen zeggen, wijst in dezelfde richting, en dat is interessanter dan hun verscheidenheid. In alle drie de gevallen is het doorslaggevende criterium niet het criterium dat werd verwacht. Het twee keer snellere mixture-of-experts-model verliest zijn plek niet door zijn snelheid maar door zijn gedrag, omdat het zich slechts in 1 op de 20 gevallen herstelt van een geweigerde toolaanroep. De rangschikking van 19 modellen laat zien dat het verschil tussen geactiveerd en gedeactiveerd redeneren bij hetzelfde model groter is dan het verschil tussen sterk uiteenlopende formaten. En van 8 naar 2 bits gaan kost 1,3 procentpunt nauwkeurigheid zonder de richting van de fouten te veranderen. Drie manieren om te zeggen dat snelheid, grootte en numerieke precisie slechte voorspellers zijn van wat een model werkelijk in productie zal doen, en dat we elders moeten kijken — naar de manier waarop het zich herstelt, beraadslaagt of neigt.
Een subtieler signaal verdient aandacht: hetzelfde beoordelingsmodel, Jev, verschijnt op dezelfde dag in twee los van elkaar staande artikelen, bij Yuichi Tateno om onderzoeksdocumenten te filteren en bij Javad Taghia om het geheugen van een agent te herordenen, gemeten op twee verschillende benchmarks. Twee onafhankelijke auteurs die op dezelfde dag een model van een derde partij instrumenteren: dat is het begin van een gedeelde bouwsteen. De logica is in beide gevallen dezelfde: aan een externe beoordelaar niet het antwoord delegeren, maar de beslissing over wat behouden blijft voordat er wordt geantwoord — en, bij Tateno, de mogelijkheid om te stoppen wanneer niets het waard is om te behouden.
Wat de tooling betreft, gaat de verandering meer over het contract dan over de functionaliteit. Claude Code 2.1.278 verplaatst de classifier voor de auto-modus naar de server en brengt deze meerkosten niet langer in rekening, precies het tegenovergestelde van wat 2.1.273 vier dagen eerder had besloten: een standaardinstelling is een economische variabele geworden die in dit tempo wordt herzien. Devin vult op zijn beurt het veld total van zijn auditlogs niet langer in, waardoor aanroepende code die erop vertrouwde niet meer werkt — een wijziging die tussen ergonomische vernieuwingen is geplaatst, hoewel ze bestaande integraties breekt. Copilot code review verlaat ten slotte de previewfase door het stilzwijgend sluiten van een opmerking te vervangen door een gemotiveerde beslissing, Won’t Fix of Incorrect. Drie manieren waarop drie leveranciers eraan herinneren dat het wezenlijke van een agenttool voortaan schuilt in zijn standaardwaarden, facturering en API-beloften.
Bronnen
- Qwen, artikel over Qwen3.8-LiveTranslate
- Alibaba Qwen op X, aankondiging van Qwen3.8-LiveTranslate
- Veertien dagen agentverkeer op twee RTX 5090’s
- AmberTrace Labs, de richting van fouten bij 19 open modellen
- AmberTrace Labs, kwantisatie en veiligheidsrichting
- jev-reranker, presentatie en metingen
- Metro-ASR-Small, wat een CTC-model met 61 miljoen parameters leert
- Claude Code, releaseopmerkingen voor 2.1.278
- Claude Code-documentatie, facturering van de classifier voor de auto-modus
- Devin, releaseopmerkingen
- Gemini CLI, nightly van 19 september
- GitHub, algemene beschikbaarheid van Copilot code review
- Pika op X, Camera Director
- Pika, applicatiepagina