ai-powered-markdown-translator使用 gpt-5.6-sol 将文章从法语翻译成中文。
本周六,没有任何实验室发布开放权重模型:已经沉默九天的 DeepSeek 没有,Meta、Ai2 和 Sakana 也没有。当天唯一发布的是闭源 API 模型 Qwen3.8-LiveTranslate,它将同声传译的延迟降至 2.3 秒。其余内容都来自实践者:Hugging Face 社区博客上的十一篇文章没有介绍模型,而是提供评测数据——生产环境中的前缀缓存、经证明验证的决策、量化成本,以及重排序质量。
Qwen3.8-LiveTranslate:同声传译延迟低于 2.3 秒
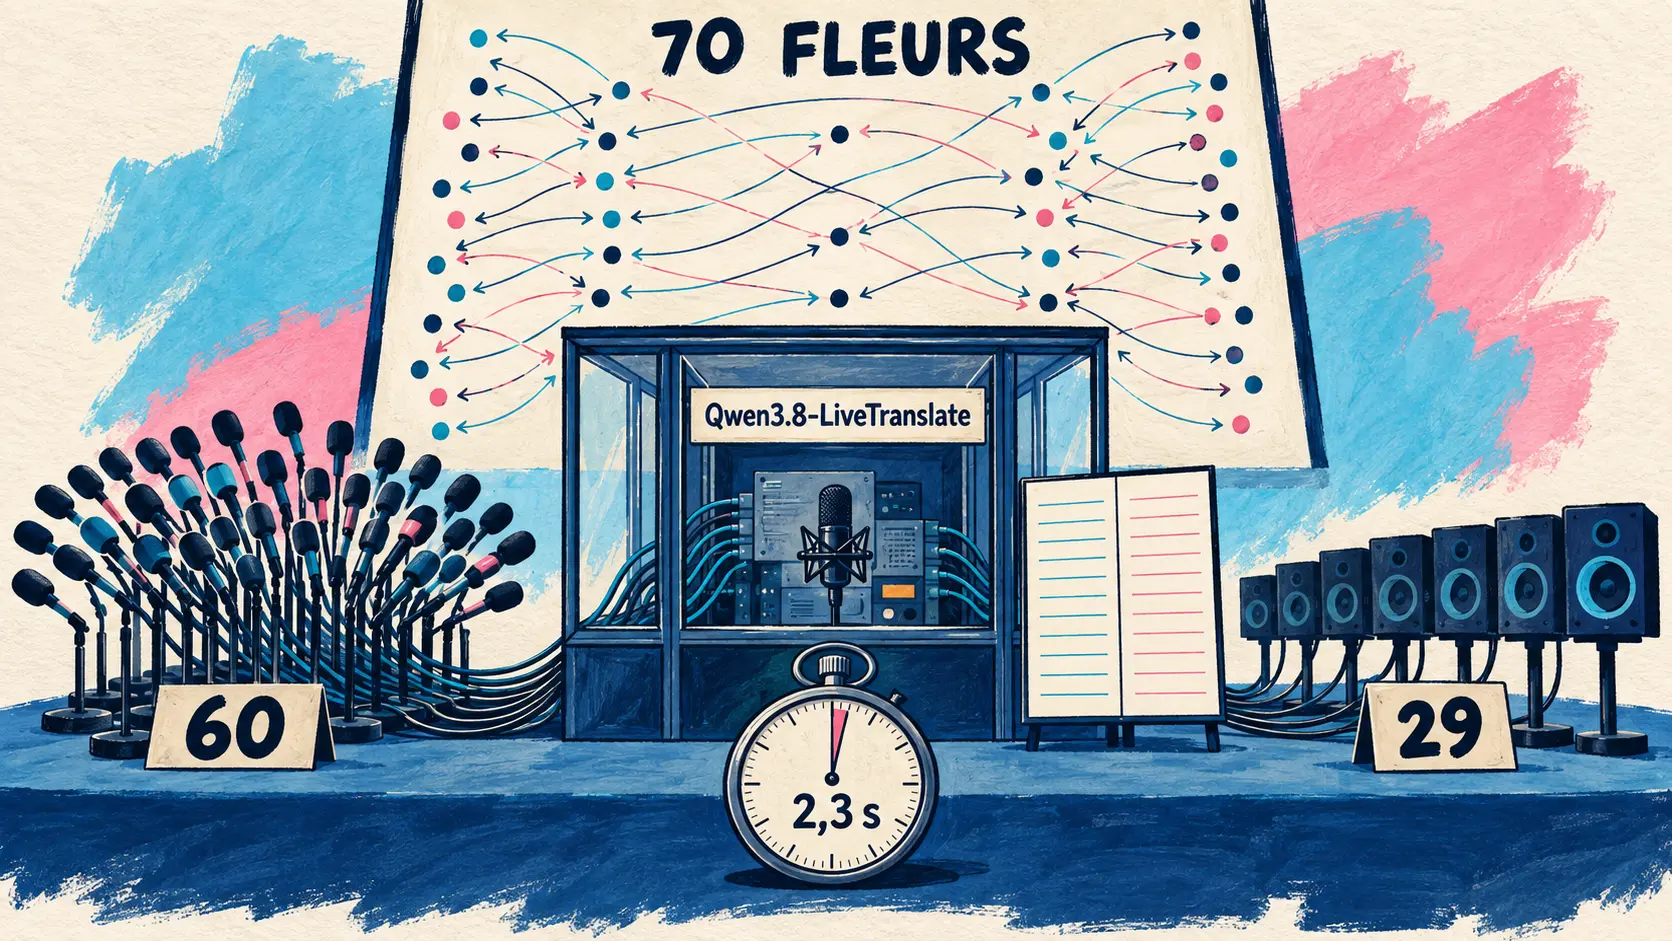
9 月 19 日 — Qwen 发布了实时同声传译模型 Qwen3.8-LiveTranslate。Interleave 架构将音频和文本作为一条交错流处理,缓存并复用已经听取的音频和已经生成的译文,在提高质量的同时,将平均延迟(average lagging,LAAL)从 2.8 秒降至 2.3 秒。
该引擎是基于混合专家模型(Hybrid-MoE)的 Thinker-Talker 双模块系统:Thinker 按时间顺序将视频、音频、源文本和译文排列到同一个因果序列中,随后由 Talker 合成保留原说话者音色的语音。它还具备三项能力:实时说话者分离(real-time speaker separation)、同步双语显示,以及长上下文消歧。
在语言覆盖范围上,博文与公告消息存在差异:后者笼统称支持 60 种语言,前者则明确区分为音频输入、文本输出支持 60 种语言,而音频输出仅支持 29 种语言。应以博文中的数字为准。评估使用 Omnilingua-MSpeaker 的 14 个语言方向,以及公开数据集 FLEURS 的 70 个语言方向。该模型可通过 DashScope API 使用:并未宣布开放权重。
| 评测项目 | 公布数值 |
|---|---|
| 平均延迟(LAAL) | 2.3 秒,上一代为 2.8 秒 |
| 音频输入、文本输出语言 | 60 |
| 音频输出语言 | 29 |
| 公开多语言评估 | FLEURS,70 个语言方向 |
| API 中的模型名称 | qwen3.8-livetranslate-flash-realtime |
Built on an Interleave architecture, it improves faithfulness, fluency, and conciseness while reducing average lagging (LAAL) from 2.8s to 2.3s across 60 languages.
🇨🇳 该模型基于 Interleave 架构,在提高保真度、流畅度和简洁性的同时,将 60 种语言的平均延迟(LAAL)从 2.8 秒降至 2.3 秒。 — @Alibaba_Qwen 在 X 上
衡量开放模型:同一天发布的三项研究
Hugging Face 社区博客上发布的三篇独立文章从三个角度衡量了同一个问题:开放模型在真实环境中的表现究竟如何。
十四天生产运行:前缀缓存决定一个 270 亿参数模型的成败
9 月 19 日 — 在 13.9 天内,两张 GeForce RTX 5090 为 Scalably 面向真实客户运营的智能体引擎提供了经 NVFP4 量化的 Qwen3.8-27B。每个数字均来自对端点 /metrics 计数器的读取:完成 28,097 个请求、处理 8.606 亿个输入 token、零中止。prompt 中位长度为 6,466 个 token,第 99 百分位达到 183,800,82.6% 的预填充 token 来自缓存。而解码速度快一倍的 Nex-N2.5-mini,在真实决策重放中失去了位置:面对被拒绝的工具调用,它仅能在 20 次中恢复 1 次,而前者为 20 次中恢复 12 次。
The short version: on agent traffic the prefix cache decides whether a 27B model keeps up, the scheduler flags matter more than the kernels, and a faster mixture-of-experts checkpoint lost the job on behaviour, not speed.
🇨🇳 简而言之:在智能体流量中,前缀缓存决定一个 270 亿参数模型能否跟上节奏;调度器选项比计算内核更重要;一个速度更快的混合专家检查点最终因行为表现而非速度失去了位置。 — Hugging Face 博客上的 pavle-scalably
AmberTrace 基于 1,350 项经证明验证的决策评测 19 个开放模型
9 月 18 日 — 当模型决定批准或拒绝时,问题不只是它出错了多少次,还包括错误偏向哪个方向。AmberTrace Labs 在 1,350 个正确操作经过证明验证的项目上评估了 19 个开放权重模型。按模型系列分组比排名更能说明问题:启用推理的模型平均得分为 0.960;具备推理能力但关闭该选项的模型为 0.909;不具备推理能力的模型为 0.805。**启用和关闭推理之间的差距,超过了参数规模相差悬殊的模型之间的差距。**单次采样、温度为 0:作者也明确列出了这些局限。
| 受评模型 | 实验室 | 综合得分 | 准确率 | 宽松型错误 |
|---|---|---|---|---|
| Qwen3.8-27B(推理) | Alibaba | 0.974 | 95.5% | 0.0% |
| Muse-Glimmer-30B | Meta | 0.960 | 94.0% | 3.1% |
| OLMo-3-32B-Think | Ai2 | 0.947 | 93.8% | 3.3% |
| Qwen3.8-27B | Alibaba | 0.937 | 91.3% | 6.3% |
从 8 位到 2 位:准确率仅下降 1.3 个百分点,错误性质并未改变
9 月 19 日 — 次日,AmberTrace 使用相同协议研究了一个问题:量化会损失什么?Qwen3.6-27B 以从 Q8_0 到 Q2_K 的六种 GGUF 精度提供服务,随后在相同的 1,350 个项目上接受评估。结果与常见直觉相悖:准确率从 8 位时的 90.9% 降至 2 位时的 89.6%,即数值精度缩小为四分之一,仅损失 1.3 个百分点。最有趣的是保持不变的数字:错误的有符号偏差依然平稳,决定系数为 0.01。量化改变的是错误数量,而不是错误性质。作者提醒,这是一项初步研究。
| 量化精度 | 准确率 | 宽松型错误(关键区间) | 有符号偏差 |
|---|---|---|---|
| 8 位 | 90.9% | 5.2% | −0.024 |
| 5 位 | 91.3% | 4.5% | −0.029 |
| 4 位 | 90.2% | 6.3% | −0.018 |
| 2 位 | 89.6% | 6.3% | −0.024 |
jev-reranker 剔除 92% 的候选文档,排名效果反而提高
9 月 19 日 — Yuichi Tateno 发布了 Python 库 jev-reranker。它基于 TypeSafe.AI 的结构化判断模型 Jev,对搜索结果进行重排序,更重要的是剔除那些无助于回答问题的文档。其价值不止在于节省 token:过滤让应用能够在生成之前先做出决策。在 NanoHotpotQA 上,过滤后每个查询仅保留 7.62 份文档,nDCG@10 达到 0.975;相比之下,保留 100 份文档的混合搜索仅为 0.833:真正有价值之处正是上下文的缩减。
更有趣的观察来自别处:同一个判断模型当天还出现在第二篇独立文章中,Javad Taghia 在另一项基准测试上用它对智能体记忆进行重排序。
| 排名方法 | 阈值 | nDCG@10 | 每个查询保留的文档数 |
|---|---|---|---|
| 混合搜索 | — | 0.833 | 100 |
| 重排序 | 0.0 | 0.969 | 100 |
| 相关性过滤 | 0.2 | 0.975 | 7.62(剔除 92.38%) |
Metro-ASR-Small:6100 万参数,在笔记本电脑处理器上处理埃及阿拉伯语
9 月 19 日 — Whisper-large-v3 拥有 15 亿个参数,Meta 的 OmniASR-LLM 拥有 70 亿个参数:它们都需要显卡。Metro-ASR-Small 仅有 6160 万个参数,占用 235 MB,可在四个处理器线程上以实时速度的 33 至 66 倍转录埃及阿拉伯语、英语及两者的交替语音——这是表格给出的范围,正文将其约为 50 倍。这篇文章不是公告,而是一项调查:当数据和参数受到限制时,准确率从何而来?答案比人们想象的更少取决于声学模型。第二项助力是一个可选的 6.4 GB KenLM 语言头:其大小是声学模型的二十七倍。
| 波束宽度 | 词错误率 | 解码时间 |
|---|---|---|
| 贪心解码 | 30.0% | 5.9 ms |
| 100 | 24.3% | 128 ms |
| 400 | 24.1% | 351 ms |
🔗 一个 6100 万参数的 CTC 模型能学到什么,又学不到什么
Claude Code 2.1.278 将自动模式分类器迁回服务器端,并停止收取相关费用
9 月 19 日 — 在自动模式下,分类器会在敏感操作执行前对其进行检查;此前这些检查属于按 token 计费的模型调用。现在,服务器会在会话请求中执行这些检查,不再收取额外费用;Claude API、Enterprise、Bedrock、Vertex 和 Foundry 默认启用,并在 /status 中显示一行 自动模式服务器。需要注意回退机制:如果网关丢弃字段 safeguards,Claude Code 会在发出通知后切换到收费的本地分类器。
这一变化本身值得特别指出:它与 9 月 15 日发布的 2.1.273 完全相反,后者曾要求 Bedrock、Vertex 和 Foundry 默认使用本地分类器。短短四天便经历了一次往返调整。
We’re changing auto mode to no longer charge for classifier requests in Claude Code. However, this session isn’t eligible.
🇨🇳 我们正在调整自动模式,不再对 Claude Code 中的分类器请求收费。不过,本次会话不符合条件。 — Claude Code 文档,回退到收费模式时显示的通知
编程工具迎来更新:一个 API 字段消失,伪终端得到强化
Devin:Azure DevOps Server、MCP 重新连接,以及如今返回 null 的字段 total
9 月 18 日 — Cognition 发布的这一批发行说明没有改动智能体引擎,而是聚焦管理功能和企业连接。最重要的并非新增功能,而是一项破坏性变更:在 Enterprise API 的审计日志列表中,字段 total 不再填充,现返回 null;分页必须改用 has_next_page 和 end_cursor。任何依赖该计数器的调用代码都会停止工作。其余更新均为增量功能:Azure DevOps Server 2020 和 2022 的集合现在可通过个人访问令牌接入,此前仅支持云版本;每个 MCP 服务器新增 重新连接 操作,无需卸载即可重新执行身份验证;ActiveCampaign 和 Grafana(OAuth)加入目录;会话可按来源筛选,屏幕录制帧率提升至每秒 60 帧。
Gemini CLI:没有安全修复、聚焦伪终端的 nightly 版本
9 月 19 日 — Gemini CLI 的 nightly 渠道于 03:25 发布版本 v0.62.0-nightly.20260919.gcfbcaa8df,包含五项修复,且没有任何安全变更——这与此前连续多个 nightly 版本不同。其中两项针对伪终端:同步 Windows 伪终端实现 ConPTY 的进程退出生命周期,以及处理终端缓冲区的内存管理。另外三项则修复了使用上的不便:取消请求时显示 AbortError 日志、关闭 VS Code 扩展中的对比标签页时终端失去焦点,以及身份验证文档链接指向无效锚点。公开渠道保持不变,stable 版本为 v0.60.0,preview 版本为 v0.61.0-preview.0。
Copilot code review 重做审查摘要并正式全面开放
9 月 18 日 — GitHub 宣布 Copilot code review 在 pull request 中留下的审查摘要改版后正式全面开放。摘要评论会显示当前评估结果和审查工作量级别,并将发现的问题分成三组,每项都附有严重程度和指向行内评论的链接。随着 commit 不断提交,摘要会保留处理进度,而不是重新改写。9 月 11 日推出的自动解决功能也得到扩展:要求保留问题为开放状态的回复会得到遵从;自动解决问题时会注明原因,不予修复或判断有误——这是一项有理由支撑且可提出异议的决定,而不是悄无声息地关闭问题。
| 发现问题分组 | 所含内容 |
|---|---|
| 待处理 | 尚未处理的问题;如果由新 commit 引入,则带有 new 标签 |
| 自上次审查以来已解决 | Copilot 已确认修正的问题 |
| 先前遗漏 | 并非由新 commit 引入、而是在后续审查中发现的问题 |
🔗 Copilot code review:更完善的审查体验
Pika 公布其新平台的应用名称
9 月 19 日 — 9 月 17 日,Pika 宣布将其产品彻底改造为创意平台,但没有提及任何功能或价格。从 18 日晚间到 19 日上午,该公司通过一系列消息填补了这一空白,逐一公布应用名称。这份列表并非完整目录:Pika 首页列出了八款应用——Video Studio、Color Grade、Extend Video、Pika Soundtrack、Edit Image、Character Studio、Image Studio 和 Product Shot——其中既没有 Camera Director,也没有 Relight Media,这表明其产品范围比这些陆续发布的公告更广。
| 已公布的应用 | Pika 描述的功能 |
|---|---|
| Video Studio | 从零生成视频,最长 3 分钟,支持多镜头并包含声音 |
| Camera Director | 从不同角度重新生成上传的场景,同时保留动作和表演 |
| Relight Media | 分别调整片段中光线的颜色、强度和方向 |
🔗 Video Studio · 🔗 Camera Director · 🔗 Relight Media
简讯
- 一则社区注释质疑委托给 Accenture 的评估是否独立 — 这是对 18 日所报道合作的补充:该注释指出,Anthropic 将直接资助 Accenture 的工作,而且两家公司此前已有商业合作关系,约有 30,000 名 Accenture 专业人员接受过 Claude 培训。🔗 来源
- Replit 将审计日志扩展至另外 65 种以上的事件 — 涵盖项目、工作区、部署、账户安全、SSO 和 SCIM、连接器、密钥以及 Agent 活动,面向 Enterprise 账户管理员;既未提供详细列表,也未单独说明上线日期。🔗 来源
- Qwen Code v0.24.1 将前一天的预览版转为稳定版 — 该版本于协调世界时 08:18 发布,与已报道的 v0.24.1-preview.0 相比只增加了六项内容:真正构成新闻的是 Playwright 浏览器 SDK 和容器内子 Agent 转为稳定版,而非具体内容。🔗 来源
- Kimi Code 2.0.2 修复五项缺陷 — 在 2.0.1 发布二十三小时后推出,且没有新增功能:恢复会话后消息不再落到先前的位置、重复项已被移除、切换模型后的上下文压缩得到修复。🔗 来源
- 使用 Jev 对 Agent 的记忆重新排序,将首位召回率从 34% 提高到 54% — 在 1,986 个 LoCoMo 问题上,对 AtMem 的前十名候选项重新排序,使 MRR@5 从 0.4259 提升至 0.5868,而前十名召回率保持不变,仍为 0.6495。🔗 来源
- Layer-Feedback Transformer 在 1,000 万参数规模下提升 4.29 个百分点,但在计算量相同的情况下并无优势 — 重复运行相邻层,使某模型在自建基准上的成绩从 32.57% 提高到 36.86%,代价是区块执行次数增加到 2.64 倍,作者也明确承认了这一局限。🔗 来源
- AmberTrace 主张将可验证奖励扩展到数学与代码之外 — 这是一篇没有基准测试的立场文章:奖励成功的表象,会产生一个优化成功表象的模型;而那些决策会带来责任的领域,至今仍缺乏可验证奖励。🔗 来源
- 一种用于判断旧文档能否撤销记忆更新的测试协议 — 这是一套没有测量结果的建议方案:如果一份已被替换的文档以新时间戳重新导入,而系统将最近到达的内容视为最新内容,它就会悄无声息地再次成为当前答案。🔗 来源
- 以代码作为 Agent 与物理世界之间的接口 — 这篇教学性综述将代码 Agent 的循环与机器人操作的程序生成联系起来,没有发布公告,也没有自身的量化结果。🔗 来源
- Qwen 转发了一项基于 Qwen3.8-27B 的 Cerebras 演示 — 这是第三方基于 Cerebras 推理构建的个人财务助理;此次仅为祝贺性转发,并非产品公告,相关主题已于 9 月 12 日报道。🔗 来源
- OpenAI 发布 Australian Youth Safety Blueprint — 这是一份由六大支柱组成的路线图,旨在保护澳大利亚的年轻 AI 用户,内容从素养教育延伸到尊重隐私的年龄验证;该公司还提到,面向 13 至 17 岁用户的 ChatGPT for Teens 已于 8 月在该国上线。🔗 来源
- iOS 版 ChatGPT 1.2026.251 新增文件夹和写作区块 — 可从文件选择器创建文件夹,写作区块支持草稿变体和复制操作,另有八项主要围绕 worktrees 和排队 prompts 的修复。🔗 来源
这意味着什么
这一天呈现出一种不同寻常的形态:实验室保持沉默,实践者则纷纷发布内容。无论是已经沉寂九天、并经三个独立渠道核查的 DeepSeek,还是 Meta、Ai2 或 Sakana,都没有推出任何东西。开放模型领域的十一项发现全都来自同一个地方——Hugging Face 社区博客,而且没有一项是在介绍模型:它们都在进行测量。十四天客户流量中的前缀缓存、1,350 项经证明认证的决策、六种量化级别、重排序的质量。当天唯一发布的模型 Qwen3.8-LiveTranslate 恰恰相反,是一款不开放权重的 API 产品。这个星期六,开放生态系统没有产出原材料,而是产出了测量工具。
这些测量所得出的结论趋于一致,而这比它们的多样性更有意思。在三个案例中,起决定作用的标准都不是人们原本预期的那个。速度快一倍的混合专家模型失去优势,并非因为速度,而是因为其行为:工具调用遭拒后,它只有二十分之一的概率能够恢复。对 19 个模型的排名显示,在同一个模型上,启用与停用推理造成的差距,大于尺寸相差悬殊的模型之间的差距。将量化精度从 8 位降至 2 位会损失 1.3 个准确率百分点,却不会改变错误的方向。这三种情况共同说明:速度、尺寸和数值精度都无法很好地预测模型在生产环境中的实际表现,必须把目光投向别处——看它如何恢复、如何审议,又倾向于什么。
还有一个更低调的信号值得注意:同一个判断模型 Jev 在同一天出现在两篇彼此无关的文章中,Yuichi Tateno 用它筛选研究文档,Javad Taghia 则用它对 Agent 的记忆重新排序,并分别在两个不同基准上进行了测量。两位独立作者在同一天将同一个第三方模型工具化,这是一种共享构件开始成形的迹象。两个案例的逻辑相同:交由外部裁判决定的不是答案,而是在回答之前应保留什么;在 Tateno 的案例中,当没有任何内容值得保留时,还可以选择停止。
在工具方面,变化更多涉及契约,而非功能。Claude Code 2.1.278 将服务器端自动模式分类器设为默认,并停止收取这项附加费用,这与四天前 2.1.273 的决定完全相反:默认设置已成为一个经济变量,而且调整速度如此之快。Devin 则不再填充其审计日志中的 total 字段,依赖该字段的调用代码因此停止工作——这项变更被放在一系列易用性改进之中,尽管它会破坏现有集成。最后,Copilot code review 结束预览阶段,将无声关闭评论的做法替换为附有理由的决定:Won’t Fix 或 Incorrect。三家厂商以三种方式提醒人们:如今,Agent 工具的关键已体现在其默认值、计费方式和 API 承诺之中。
来源
- Qwen,Qwen3.8-LiveTranslate 博文
- Alibaba Qwen 在 X 上发布 Qwen3.8-LiveTranslate 公告
- 两块 RTX 5090 上十四天的 Agent 流量
- AmberTrace Labs,19 个开放模型的错误方向
- AmberTrace Labs,量化与安全方向
- jev-reranker,介绍与测量结果
- Metro-ASR-Small,一个拥有 6,100 万参数的 CTC 模型学到了什么
- Claude Code,2.1.278 版本说明
- Claude Code 文档,自动模式分类器的计费
- Devin,版本说明
- Gemini CLI,9 月 19 日 nightly 版
- GitHub,Copilot code review 正式发布
- Pika 在 X 上发布 Camera Director
- Pika,应用页面