ai-powered-markdown-translatorArticolo tradotto dal francese all’italiano con gpt-5.6-sol.
Questo sabato nessun laboratorio ha pubblicato modelli a pesi aperti: né DeepSeek, in silenzio da nove giorni, né Meta, né Ai2, né Sakana. L’unica uscita della giornata è un modello API chiuso, Qwen3.8-LiveTranslate, che riduce a 2,3 secondi la latenza dell’interpretazione simultanea. Tutto il resto arriva dai professionisti: undici articoli sul blog della community di Hugging Face, che non presentano modelli ma misurazioni — cache dei prefissi in produzione, decisioni certificate, costo della quantizzazione, qualità del riordinamento.
Qwen3.8-LiveTranslate, l’interpretazione simultanea sotto la soglia dei 2,3 secondi
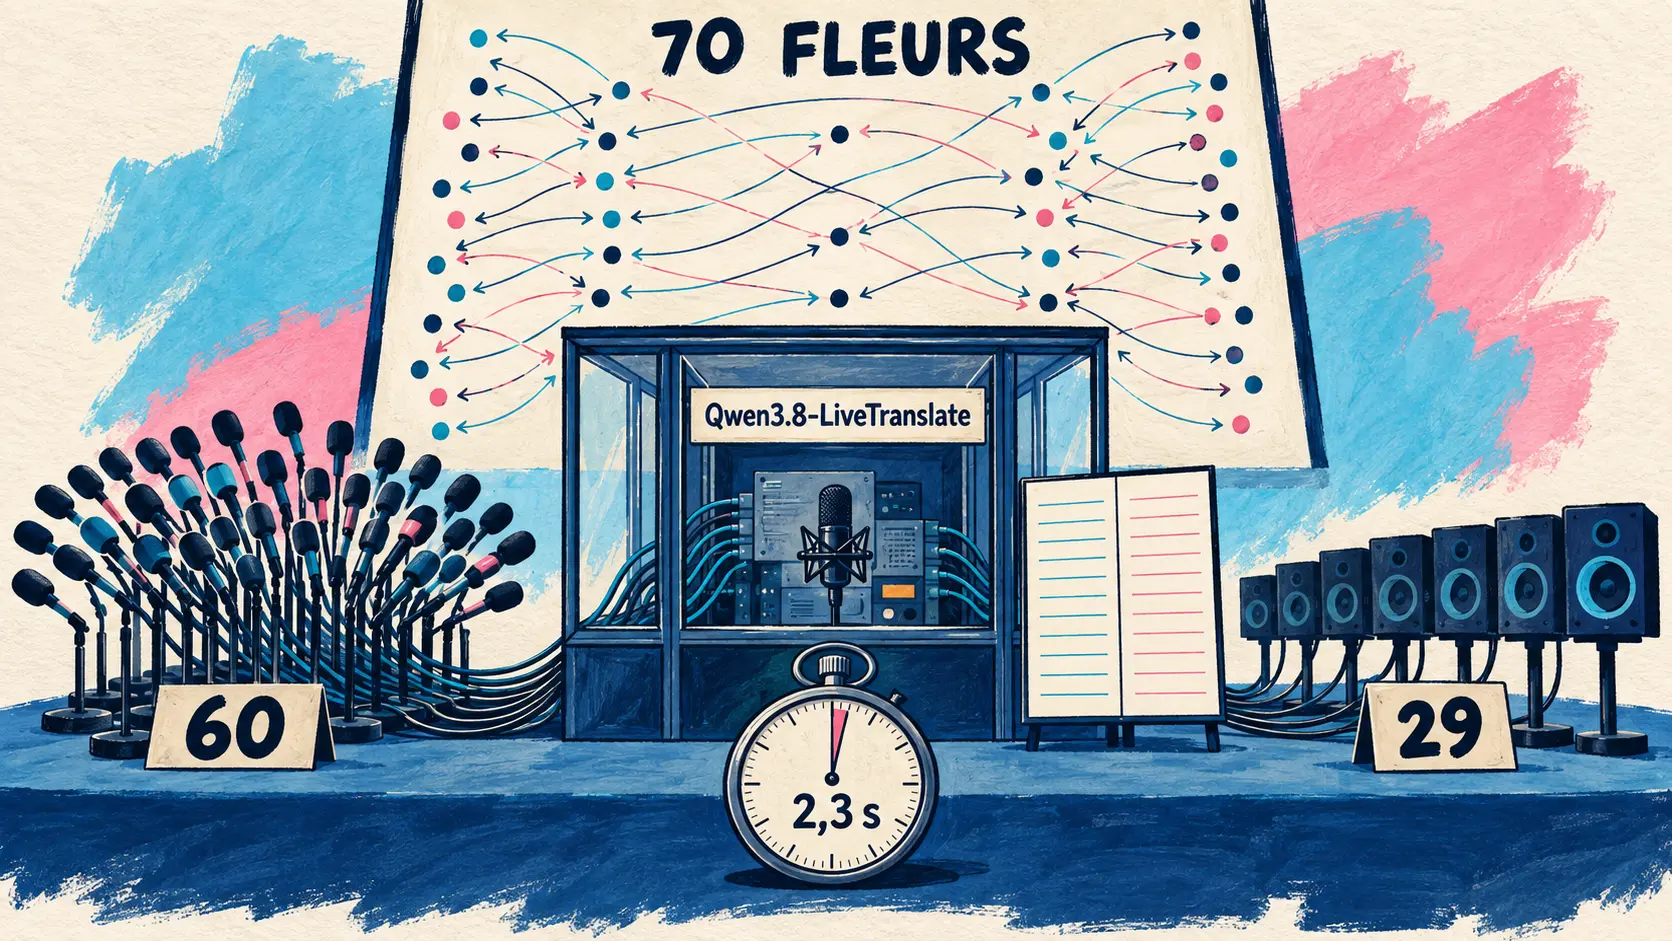
19 settembre — Qwen ha presentato Qwen3.8-LiveTranslate, il suo modello di interpretazione simultanea in tempo reale. L’architettura Interleave tratta audio e testo come un unico flusso interlacciato, nel quale l’audio già ascoltato e la traduzione già prodotta vengono memorizzati nella cache e poi riutilizzati, riducendo la latenza media (average lagging, LAAL) da 2,8 a 2,3 secondi con una qualità migliore.
Il motore è un insieme a due moduli Thinker-Talker basato su un mixture of experts ibrido (Hybrid-MoE): il Thinker dispone video, audio, testo sorgente e traduzione in un’unica sequenza causale ordinata temporalmente; il Talker sintetizza quindi una voce che conserva il timbro del parlante originale. Lo accompagnano tre funzionalità: separazione dei parlanti in tempo reale (real-time speaker separation), visualizzazione bilingue sincronizzata e disambiguazione in contesti lunghi.
Per quanto riguarda la copertura linguistica, l’articolo e il messaggio di annuncio divergono: il secondo parla genericamente di 60 lingue, mentre il primo distingue 60 lingue in ingresso audio con uscita testuale, ma soltanto 29 con uscita audio. Fanno fede i dati dell’articolo. Le valutazioni riguardano Omnilingua-MSpeaker, con 14 direzioni linguistiche, e il dataset pubblico FLEURS, con 70 direzioni. Il modello si utilizza tramite API via DashScope: non è stata annunciata alcuna apertura dei pesi.
| Elemento misurato | Valore annunciato |
|---|---|
| Latenza media (LAAL) | 2,3 s, rispetto ai 2,8 s della generazione precedente |
| Lingue in ingresso audio, uscita testuale | 60 |
| Lingue in uscita audio | 29 |
| Valutazione multilingue pubblica | FLEURS, 70 direzioni linguistiche |
| Nome del modello nell’API | qwen3.8-livetranslate-flash-realtime |
Built on an Interleave architecture, it improves faithfulness, fluency, and conciseness while reducing average lagging (LAAL) from 2.8s to 2.3s across 60 languages.
🇮🇹 Basato su un’architettura Interleave, migliora fedeltà, fluidità e concisione, riducendo al contempo la latenza media (LAAL) da 2,8 s a 2,3 s in 60 lingue. — @Alibaba_Qwen su X
🔗 Articolo su Qwen3.8-LiveTranslate
Misurare i modelli aperti: tre studi pubblicati lo stesso giorno
Tre articoli indipendenti, tutti pubblicati sul blog della community di Hugging Face, misurano lo stesso oggetto da tre prospettive: quanto vale un modello aperto in condizioni reali.
Quattordici giorni di produzione: la cache dei prefissi decide le sorti di un modello da 27 miliardi
19 settembre — Per 13,9 giorni, due schede GeForce RTX 5090 hanno eseguito Qwen3.8-27B quantizzato in NVFP4 per il motore di agenti che Scalably utilizza con clienti reali; ogni dato è stato ricavato da un contatore letto sull’endpoint /metrics: 28.097 richieste completate, 860,6 milioni di token di input, zero abbandoni. Con prompt mediani di 6.466 token e un 99º percentile di 183.800, l’82,6% dei token di prefill proviene dalla cache. E Nex-N2.5-mini, due volte più veloce nella decodifica, ha perso il posto in un replay di decisioni reali: riesce a riprendersi da una chiamata a uno strumento rifiutata soltanto in 1 caso su 20, contro 12 su 20.
The short version: on agent traffic the prefix cache decides whether a 27B model keeps up, the scheduler flags matter more than the kernels, and a faster mixture-of-experts checkpoint lost the job on behaviour, not speed.
🇮🇹 In sintesi: sul traffico degli agenti, è la cache dei prefissi a determinare se un modello da 27 miliardi riesce a reggere il ritmo, le opzioni dello scheduler contano più dei kernel di calcolo e un checkpoint mixture of experts più veloce ha perso il posto per il suo comportamento, non per la sua velocità. — pavle-scalably sul blog di Hugging Face
AmberTrace valuta 19 modelli aperti su 1.350 decisioni certificate
18 settembre — Quando un modello decide se concedere o rifiutare qualcosa, la questione non è soltanto quante volte sbaglia, ma in quale direzione. AmberTrace Labs ha valutato 19 modelli a pesi aperti su 1.350 elementi la cui azione corretta era certificata da una prova. Il raggruppamento per famiglia dice più della classifica: ragionamento attivato, media di 0,960; capaci di ragionare ma con l’opzione disattivata, 0,909; senza ragionamento, 0,805. La differenza tra attivare e disattivare il ragionamento supera quella tra dimensioni molto diverse. Singolo campione, temperatura 0: l’autore dichiara i limiti dello studio.
| Modello valutato | Laboratorio | Punteggio composito | Accuratezza | Errore permissivo |
|---|---|---|---|---|
| Qwen3.8-27B (ragionamento) | Alibaba | 0,974 | 95,5 % | 0,0 % |
| Muse-Glimmer-30B | Meta | 0,960 | 94,0 % | 3,1 % |
| OLMo-3-32B-Think | Ai2 | 0,947 | 93,8 % | 3,3 % |
| Qwen3.8-27B | Alibaba | 0,937 | 91,3 % | 6,3 % |
🔗 La direzione dell’errore nei modelli decisionali a pesi aperti
Da 8 a 2 bit: 1,3 punti di accuratezza, senza alcun cambiamento sostanziale
19 settembre — Il giorno seguente, AmberTrace applica lo stesso protocollo a una domanda: che cosa si perde con la quantizzazione? Qwen3.6-27B è stato eseguito con sei livelli GGUF, da Q8_0 a Q2_K, e poi valutato sugli stessi 1.350 elementi. Il risultato contraddice l’intuizione comune: l’accuratezza passa dal 90,9% a 8 bit all’89,6% a 2 bit, ossia 1,3 punti per una riduzione a un quarto della precisione numerica. Il dato più interessante è quello che non cambia: il bias con segno degli errori rimane stabile, con un coefficiente di determinazione pari a 0,01. La quantizzazione modifica la quantità degli errori, non la loro natura. Si tratta di uno studio preliminare, avverte l’autore.
| Quantizzazione | Accuratezza | Errore permissivo (fascia critica) | Bias con segno |
|---|---|---|---|
| 8 bit | 90,9 % | 5,2 % | −0,024 |
| 5 bit | 91,3 % | 4,5 % | −0,029 |
| 4 bit | 90,2 % | 6,3 % | −0,018 |
| 2 bit | 89,6 % | 6,3 % | −0,024 |
🔗 Quantizzazione e direzione della sicurezza delle decisioni
jev-reranker scarta il 92% dei documenti candidati e migliora comunque la classifica
19 settembre — Yuichi Tateno pubblica jev-reranker, una libreria Python che si basa su Jev, il modello di giudizio strutturato di TypeSafe.AI, per riordinare i risultati di ricerca e, soprattutto, scartare i documenti che non aiuterebbero a rispondere. L’argomentazione va oltre il risparmio di token: il filtraggio offre all’applicazione una decisione da prendere prima della generazione. Su NanoHotpotQA, il filtraggio raggiunge uno 0,975 di nDCG@10 conservando soltanto 7,62 documenti per richiesta, contro lo 0,833 della ricerca ibrida, che ne conserva 100: è la riduzione del contesto a renderlo interessante.
L’osservazione più interessante è altrove: lo stesso modello di giudizio compare lo stesso giorno in un secondo articolo indipendente, nel quale Javad Taghia riordina la memoria di un agente su un altro benchmark.
| Metodo di classificazione | Soglia | nDCG@10 | Documenti conservati per richiesta |
|---|---|---|---|
| Ricerca ibrida | — | 0,833 | 100 |
| Riordinamento | 0,0 | 0,969 | 100 |
| Filtraggio per rilevanza | 0,2 | 0,975 | 7,62 (92,38 % scartati) |
🔗 Presentazione di jev-reranker
Metro-ASR-Small, 61 milioni di parametri per l’arabo egiziano su un processore per portatili
19 settembre — Whisper-large-v3 conta 1,5 miliardi di parametri, OmniASR-LLM di Meta 7 miliardi: entrambi richiedono una scheda grafica. Metro-ASR-Small ne conta 61,6 milioni, occupa 235 MB e trascrive l’arabo egiziano, l’inglese e la loro alternanza a una velocità da 33 a 66 volte superiore al tempo reale su quattro thread della CPU — l’intervallo indicato nella tabella, che il testo arrotonda a un fattore 50. L’articolo non è un annuncio, ma un’indagine: da dove proviene l’accuratezza quando dati e parametri sono limitati? Meno dal modello acustico di quanto si pensi. Il secondo elemento determinante è un language head KenLM opzionale da 6,4 GB: ventisette volte il modello acustico.
| Ampiezza del beam | Tasso di errore per parola | Tempo di decodifica |
|---|---|---|
| Decodifica greedy | 30,0 % | 5,9 ms |
| 100 | 24,3 % | 128 ms |
| 400 | 24,1 % | 351 ms |
🔗 Che cosa può e non può imparare un modello CTC da 61 milioni di parametri
Claude Code 2.1.278 riporta il classificatore della modalità auto sul server e smette di addebitarlo
19 settembre — In modalità auto, un classificatore esamina le azioni sensibili prima che vengano eseguite; finora queste verifiche erano chiamate al modello addebitate per token. Ora il server le esegue nell’ambito delle richieste della sessione, senza addebitare questo costo aggiuntivo, per impostazione predefinita su Claude API, Enterprise, Bedrock, Vertex e Foundry, con una voce Auto mode server in /status. Attenzione al fallback: un gateway che elimina il campo safeguards fa passare Claude Code al classificatore locale, a pagamento, dopo aver mostrato un avviso.
Il cambiamento merita di essere segnalato come tale: è l’esatto contrario della versione 2.1.273 del 15 settembre, che aveva imposto per impostazione predefinita il classificatore locale su Bedrock, Vertex e Foundry. Un’inversione di rotta in quattro giorni.
We’re changing auto mode to no longer charge for classifier requests in Claude Code. However, this session isn’t eligible.
🇮🇹 Stiamo modificando la modalità auto affinché le richieste del classificatore in Claude Code non vengano più addebitate. Questa sessione, tuttavia, non è idonea. — Documentazione di Claude Code, avviso mostrato in caso di fallback a pagamento
🔗 Note di rilascio di Claude Code 2.1.278
Gli strumenti di coding si aggiornano: un campo API che scompare, uno pseudo-terminale che diventa più robusto
Devin: Azure DevOps Server, riconnessione MCP e un campo total che ora restituisce null
18 settembre — La serie di note di rilascio pubblicata da Cognition non riguarda il motore dell’agente, bensì l’amministrazione e le connessioni aziendali. Il fatto più importante non è una novità, ma una breaking change: nell’elenco dei registri di audit dell’API Enterprise, il campo total non viene più compilato e restituisce null; la paginazione deve utilizzare has_next_page e end_cursor. Qualsiasi codice chiamante che faceva affidamento su quel contatore smette di funzionare. Il resto è costituito da aggiunte: le raccolte Azure DevOps Server 2020 e 2022 sono supportate tramite personal access token, mentre prima lo era soltanto la versione cloud; ogni server MCP ottiene un’azione Reconnect che ripete l’autenticazione senza richiedere la disinstallazione; ActiveCampaign e Grafana (OAuth) entrano nel catalogo; le sessioni possono essere filtrate per origine e le registrazioni dello schermo arrivano a 60 fotogrammi al secondo.
Gemini CLI: una nightly senza correzioni di sicurezza, incentrata sullo pseudo-terminale
19 settembre — Il canale nightly di Gemini CLI pubblica alle 03:25 la versione v0.62.0-nightly.20260919.gcfbcaa8df, con cinque correzioni e nessuna modifica alla sicurezza — interrompendo così la serie delle nightly precedenti. Due riguardano lo pseudo-terminale: la sincronizzazione del ciclo di vita dell’uscita dei processi ConPTY, l’implementazione Windows dello pseudo-terminale, e la gestione della memoria del buffer del terminale. Le altre tre risolvono alcuni inconvenienti: log AbortError visualizzati all’annullamento di una richiesta, focus del terminale perso alla chiusura di una scheda di confronto nell’estensione VS Code e link alla documentazione sull’autenticazione che puntava a un’ancora non valida. I canali pubblici rimangono invariati, con la versione stabile v0.60.0 e la preview v0.61.0-preview.0.
🔗 Note di rilascio della nightly del 19 settembre
Copilot code review rinnova il suo resoconto e raggiunge la disponibilità generale
18 settembre — GitHub rende generalmente disponibile una nuova versione del resoconto lasciato da Copilot code review su una pull request. Il commento riepilogativo mostra la valutazione corrente e il livello di impegno della revisione, suddividendo i rilievi in tre gruppi, ciascuno con la propria gravità e un link al commento inline. Con il susseguirsi dei commit, il riepilogo conserva la progressione anziché essere riscritto. La risoluzione automatica, introdotta l’11 settembre, viene ampliata: viene rispettata una risposta che chiede di lasciare aperto un problema e una risoluzione automatica ne indica la motivazione, Won’t Fix o Incorrect — una decisione motivata e contestabile anziché una chiusura silenziosa.
| Gruppo di rilievi | Contenuto |
|---|---|
| Open | Problemi non risolti, etichetta new se introdotti da un nuovo commit |
| Resolved since last review | Problemi la cui correzione è stata convalidata da Copilot |
| Previously missed | Problemi non introdotti da un nuovo commit, individuati durante una revisione successiva |
🔗 Copilot code review, un’esperienza di revisione migliorata
Pika dà un nome alle applicazioni della sua nuova piattaforma
19 settembre — Il 17 settembre, Pika annunciava la completa riprogettazione del suo prodotto come piattaforma creativa, senza citare una sola funzionalità né una sola tariffa. Tra la sera del 18 e la mattina del 19, l’azienda ha colmato questo vuoto con una serie di messaggi che presentano le applicazioni una per una. Questo elenco non è il catalogo: la homepage di Pika elenca otto applicazioni — Video Studio, Color Grade, Extend Video, Pika Soundtrack, Edit Image, Character Studio, Image Studio e Product Shot — tra le quali non figurano né Camera Director né Relight Media, il che indica che l’offerta è più ampia di questi annunci successivi.
| Applicazione annunciata | Funzione descritta da Pika |
|---|---|
| Video Studio | Video da zero, fino a 3 minuti in più inquadrature, audio incluso |
| Camera Director | Rigenera una scena caricata da altre angolazioni, preservando movimento e interpretazione |
| Relight Media | Regola separatamente colore, intensità e direzione della luce di una clip |
🔗 Video Studio · 🔗 Camera Director · 🔗 Relight Media
In breve
- Una nota della comunità contesta l’indipendenza della valutazione affidata ad Accenture — integrazione alla partnership trattata il 18: la nota rileva che Anthropic finanzierà direttamente il lavoro di Accenture e che una precedente partnership commerciale lega già le due società, con circa 30.000 professionisti di Accenture formati su Claude. 🔗 fonte
- Replit estende i suoi log di audit a oltre 65 eventi aggiuntivi — progetti, spazi di lavoro, deployment, sicurezza dell’account, SSO e SCIM, connettori, segreti e attività dell’Agent, per gli amministratori degli account Enterprise; nessun elenco dettagliato né data di disponibilità distinta. 🔗 fonte
- Qwen Code v0.24.1 porta alla versione stabile la preview del giorno precedente — pubblicata alle 08:18 UTC, aggiunge soltanto sei voci alla v0.24.1-preview.0 già trattata: la notizia è la promozione dell’SDK per browser Playwright e dei sotto-agenti in container, non il contenuto. 🔗 fonte
- Kimi Code 2.0.2 corregge cinque difetti — ventitré ore dopo la 2.0.1 e senza nuove funzionalità: messaggi che non finiscono più in una posizione precedente dopo una ripresa, duplicati eliminati, compaction riparata dopo un cambio di modello. 🔗 fonte
- Riordinare la memoria di un agente con Jev porta il richiamo al primo posto dal 34 al 54% — su 1.986 domande LoCoMo, il riordinamento dei dieci migliori candidati di AtMem porta l’MRR@5 da 0,4259 a 0,5868 senza modificare il richiamo a dieci, rimasto a 0,6495. 🔗 fonte
- Il Layer-Feedback Transformer guadagna 4,29 punti con 10 milioni di parametri, ma non a parità di calcolo — rieseguire i layer adiacenti porta un modello dal 32,57 al 36,86% su un benchmark interno, al costo di un numero di esecuzioni dei blocchi 2,64 volte superiore, limite che l’autore riconosce esplicitamente. 🔗 fonte
- AmberTrace sostiene l’uso di ricompense verificabili oltre la matematica e il codice — saggio di posizionamento senza benchmark: ricompensare l’apparenza del successo produce un modello che ottimizza l’apparenza, mentre gli ambiti in cui una decisione comporta una responsabilità sono rimasti privi di ricompense verificabili. 🔗 fonte
- Un protocollo di test per sapere se un vecchio documento può annullare un aggiornamento della memoria — proposta di procedura, senza misurazioni: un documento sostituito che ritorna tramite reimportazione con un timestamp recente torna silenziosamente a essere la risposta corrente se il sistema considera l’elemento arrivato più di recente come quello più aggiornato. 🔗 fonte
- Il codice come interfaccia tra gli agenti e il mondo fisico — sintesi didattica che accosta il ciclo di un agente di coding alla generazione di programmi per la manipolazione robotica, senza annunci né risultati numerici propri. 🔗 fonte
- Qwen rilancia una dimostrazione di Cerebras basata su Qwen3.8-27B — un assistente di finanza personale realizzato da terzi sull’inferenza Cerebras; un rilancio di congratulazioni e non un annuncio di prodotto, poiché l’argomento sottostante era stato trattato il 12 settembre. 🔗 fonte
- OpenAI pubblica il suo Australian Youth Safety Blueprint — una roadmap in sei pilastri per la protezione dei giovani utenti dell’IA in Australia, dall’alfabetizzazione alla verifica dell’età rispettosa della privacy; l’azienda ricorda il lancio di ChatGPT for Teens nel Paese, disponibile da agosto per i ragazzi dai 13 ai 17 anni. 🔗 fonte
- ChatGPT per iOS 1.2026.251 aggiunge cartelle e blocchi di scrittura — creazione di cartelle dal selettore di file, blocchi di scrittura con varianti delle bozze e azioni di copia, oltre a otto correzioni incentrate sui worktree e sui prompt messi in coda. 🔗 fonte
Cosa significa
La giornata ha una forma insolita: i laboratori tacciono e i professionisti pubblicano. Né DeepSeek, silenziosa da nove giorni e verificata su tre canali indipendenti, né Meta, né Ai2, né Sakana hanno pubblicato alcunché. Le undici scoperte nell’ambito dei modelli aperti provengono tutte dallo stesso luogo, il blog della comunità di Hugging Face, e non presentano alcun modello: misurano. Una cache dei prefissi su quattordici giorni di traffico dei clienti, 1.350 decisioni certificate da una prova, sei livelli di quantizzazione, la qualità di un riordinamento. L’unico modello pubblicato nella giornata, Qwen3.8-LiveTranslate, è invece un prodotto API senza pesi aperti. Questo sabato l’ecosistema aperto non ha prodotto materia prima: ha prodotto strumenti di misura.
Ciò che emerge da queste misurazioni converge, ed è più interessante della loro diversità. In tutti e tre i casi, il criterio decisivo non è quello atteso. Il modello mixture-of-experts due volte più veloce perde la posizione non per la sua velocità, ma per il suo comportamento, perché si riprende da una chiamata a uno strumento rifiutata soltanto in 1 caso su 20. La classifica di 19 modelli mostra che la differenza tra ragionamento attivato e disattivato sullo stesso modello supera quella tra dimensioni molto diverse. E scendere da 8 a 2 bit costa 1,3 punti di accuratezza senza modificare la direzione degli errori. Tre modi per dire che velocità, dimensioni e precisione numerica sono cattivi indicatori di ciò che un modello farà davvero in produzione e che bisogna guardare altrove: al modo in cui recupera, delibera o manifesta una tendenza.
Un segnale più discreto merita di essere notato: lo stesso modello di giudizio, Jev, appare nello stesso giorno in due articoli non collegati tra loro, quello di Yuichi Tateno per filtrare documenti di ricerca e quello di Javad Taghia per riordinare la memoria di un agente, misurato su due benchmark diversi. Due autori indipendenti che impiegano un modello di terzi come strumento nello stesso giorno segnano l’inizio di un componente condiviso. La logica è la stessa in entrambi i casi: delegare a un giudice esterno non la risposta, ma la decisione su cosa conservare prima di rispondere — e, nel caso di Tateno, la possibilità di fermarsi quando nulla merita di essere conservato.
Sul fronte degli strumenti, ciò che cambia riguarda più il contratto che le funzionalità. Claude Code 2.1.278 trasferisce il classificatore della modalità auto sul lato server e smette di addebitare questo costo aggiuntivo, esattamente l’opposto di quanto aveva deciso la 2.1.273 quattro giorni prima: un’impostazione predefinita è diventata una variabile economica, che viene rivista con questa rapidità. Devin, da parte sua, smette di compilare il campo total dei suoi log di audit, e il codice chiamante che vi faceva affidamento smette di funzionare: una modifica inserita tra novità ergonomiche, sebbene interrompa integrazioni esistenti. Copilot code review, infine, esce dalla preview sostituendo la chiusura silenziosa di un commento con una decisione motivata, Won’t Fix o Incorrect. Tre modi, da parte di tre fornitori, per ricordare che l’essenziale di uno strumento per agenti si gioca ormai nei suoi valori predefiniti, nella sua fatturazione e nelle sue promesse API.
Fonti
- Qwen, articolo su Qwen3.8-LiveTranslate
- Alibaba Qwen su X, annuncio di Qwen3.8-LiveTranslate
- Quattordici giorni di traffico di agenti su due RTX 5090
- AmberTrace Labs, la direzione dell’errore su 19 modelli aperti
- AmberTrace Labs, quantizzazione e direzione della sicurezza
- jev-reranker, presentazione e misurazioni
- Metro-ASR-Small, cosa apprende un modello CTC da 61 milioni di parametri
- Claude Code, note di rilascio 2.1.278
- Documentazione di Claude Code, fatturazione del classificatore della modalità auto
- Devin, note di rilascio
- Gemini CLI, nightly del 19 settembre
- GitHub, disponibilità generale di Copilot code review
- Pika su X, Camera Director
- Pika, pagina delle applicazioni