ai-powered-markdown-translatorمقال مترجم من الفرنسية إلى العربية باستخدام gpt-5.6-sol.
هذا السبت، لم ينشر أي مختبر نموذجًا بأوزان مفتوحة: لا DeepSeek، الصامت منذ تسعة أيام، ولا Meta، ولا Ai2، ولا Sakana. الإصدار الوحيد لهذا اليوم هو نموذج API مغلق، Qwen3.8-LiveTranslate، يخفض زمن استجابة الترجمة الفورية إلى 2.3 ثانية. أما كل ما تبقى فيأتي من الممارسين: إحدى عشرة تدوينة على مدونة مجتمع Hugging Face، لا تعرض نماذج بل قياسات — تخزين البادئات مؤقتًا في بيئة الإنتاج، وقرارات موثّقة، وتكلفة التكميم، وجودة إعادة الترتيب.
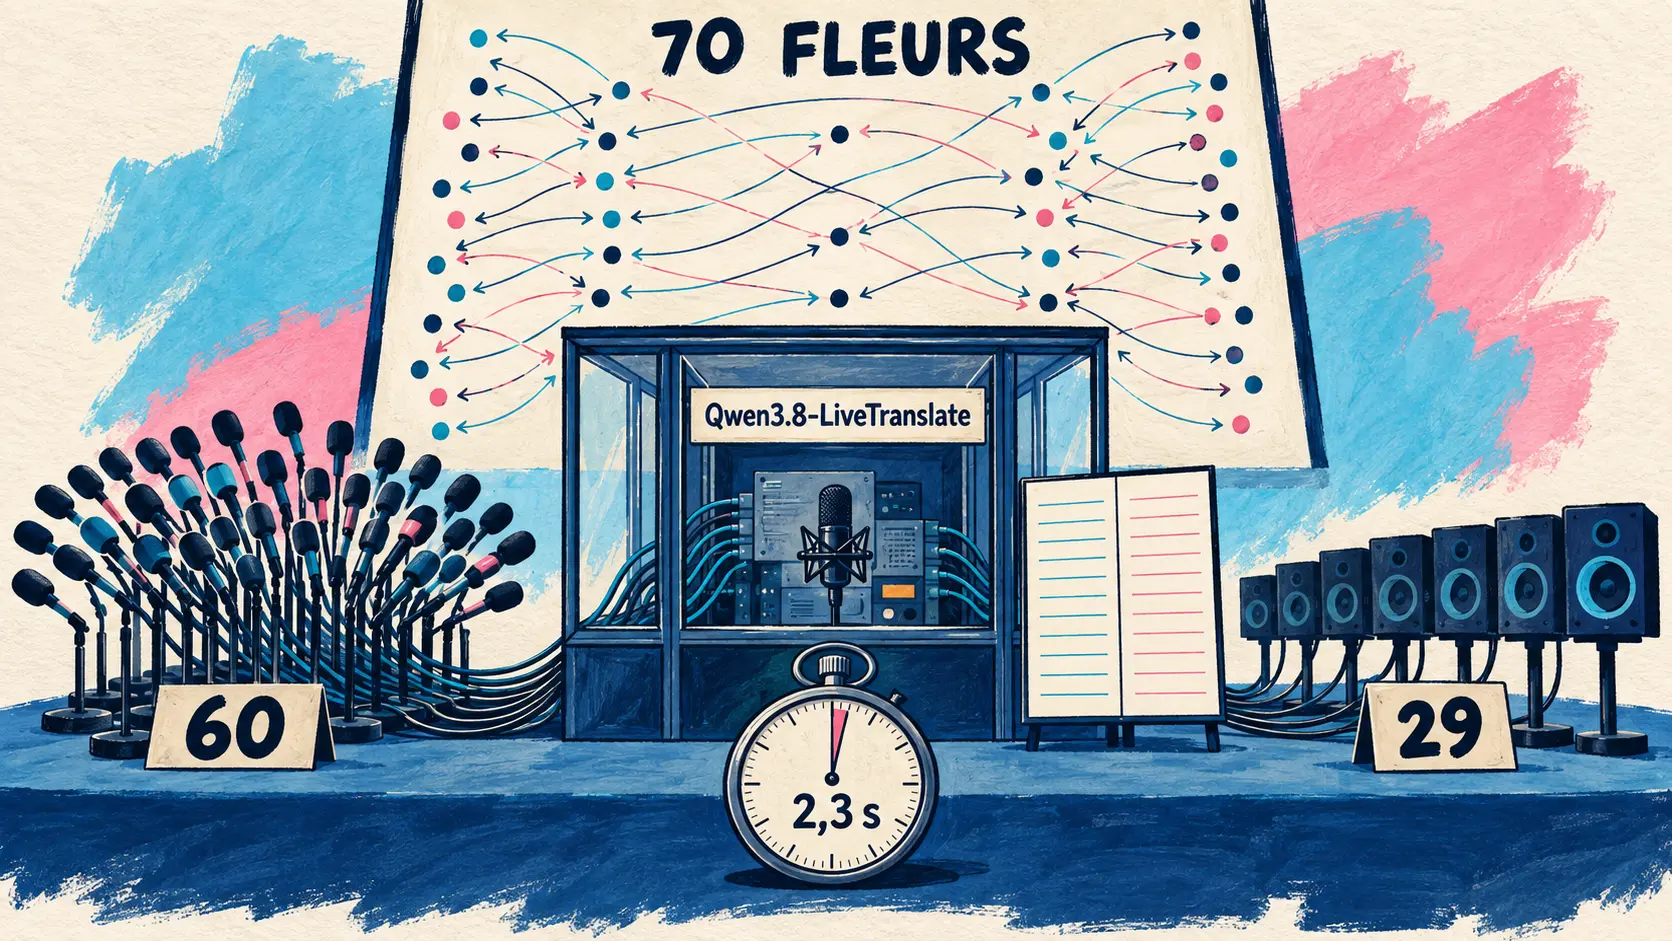
Qwen3.8-LiveTranslate، ترجمة فورية بزمن استجابة يقل عن 2.3 ثانية
19 سبتمبر — كشفت Qwen عن Qwen3.8-LiveTranslate، نموذجها للترجمة الفورية في الوقت الفعلي. تتعامل بنية Interleave مع الصوت والنص كتدفق واحد متداخل، حيث يُخزَّن الصوت المسموع سابقًا والترجمة المُنتجة سابقًا مؤقتًا ثم يُعاد استخدامهما، ما يخفض متوسط زمن الاستجابة (average lagging، LAAL) من 2.8 إلى 2.3 ثانية مع تحسين الجودة.
يتكون المحرك من وحدتي Thinker-Talker ويستند إلى مزيج خبراء هجين (Hybrid-MoE): يرتب Thinker الفيديو والصوت والنص المصدر والترجمة في تسلسل سببي واحد مرتب زمنيًا، ثم يولّد Talker صوتًا يحافظ على خامة صوت المتحدث الأصلي. وترافقه ثلاث قدرات: فصل المتحدثين في الوقت الفعلي (real-time speaker separation)، وعرض ثنائي اللغة متزامن، وإزالة الالتباس ضمن السياقات الطويلة.
في ما يتعلق بالتغطية اللغوية، تختلف التدوينة عن رسالة الإعلان: تتحدث الثانية عن 60 لغة إجمالًا، بينما تميز الأولى بين 60 لغة للإدخال الصوتي مع إخراج نصي، و29 لغة فقط للإخراج الصوتي. وأرقام التدوينة هي المعتمدة. أُجريت التقييمات على Omnilingua-MSpeaker عبر 14 اتجاهًا لغويًا، وعلى مجموعة FLEURS العامة عبر 70 اتجاهًا. يُستخدم النموذج عبر API من خلال DashScope: لم يُعلَن عن فتح أوزانه.
| العنصر المقاس | القيمة المعلنة |
|---|---|
| متوسط زمن الاستجابة (LAAL) | 2.3 ثانية، مقابل 2.8 ثانية للجيل السابق |
| لغات الإدخال الصوتي والإخراج النصي | 60 |
| لغات الإخراج الصوتي | 29 |
| التقييم العام متعدد اللغات | FLEURS، 70 اتجاهًا لغويًا |
| اسم النموذج في API | qwen3.8-livetranslate-flash-realtime |
Built on an Interleave architecture, it improves faithfulness, fluency, and conciseness while reducing average lagging (LAAL) from 2.8s to 2.3s across 60 languages.
🇸🇦 استنادًا إلى بنية Interleave، يحسّن النموذج الدقة والسلاسة والإيجاز، مع خفض متوسط زمن الاستجابة (LAAL) من 2.8 ثانية إلى 2.3 ثانية عبر 60 لغة. — @Alibaba_Qwen على X
🔗 تدوينة Qwen3.8-LiveTranslate
قياس النماذج المفتوحة: ثلاث دراسات نُشرت في اليوم نفسه
تقيس ثلاث تدوينات مستقلة، نُشرت جميعها على مدونة مجتمع Hugging Face، الشيء نفسه من ثلاث زوايا: قيمة النموذج المفتوح في ظروف الاستخدام الفعلية.
أربعة عشر يومًا في بيئة الإنتاج: ذاكرة البادئات المؤقتة تحسم مصير نموذج ذي 27 مليار معامل
19 سبتمبر — على مدى 13.9 يومًا، شغّلت بطاقتا GeForce RTX 5090 نموذج Qwen3.8-27B المكمّم بصيغة NVFP4 لخدمة محرك الوكلاء الذي تديره Scalably لعملاء حقيقيين، وكانت كل قيمة عدادًا مقروءًا من نقطة الوصول /metrics: اكتمل 28 097 طلبًا، وعولج 860.6 مليون token إدخال، من دون أي عملية إلغاء. ومع بلوغ وسيط طول الـprompts نحو 6 466 token والمئين 99 نحو 183 800، تأتي 82.6% من tokens الملء المسبق من الذاكرة المؤقتة. أما Nex-N2.5-mini، الأسرع بمرتين في فك الترميز، فقد خسر مكانه عند إعادة تشغيل قرارات حقيقية: فهو يتعافى من استدعاء أداة مرفوض في حالة واحدة فقط من أصل 20، مقابل 12 من أصل 20.
The short version: on agent traffic the prefix cache decides whether a 27B model keeps up, the scheduler flags matter more than the kernels, and a faster mixture-of-experts checkpoint lost the job on behaviour, not speed.
🇸🇦 الخلاصة: في حركة مرور الوكلاء، تحدد ذاكرة البادئات المؤقتة ما إذا كان نموذج ذو 27 مليار معامل قادرًا على مواكبة الوتيرة، وتهم خيارات المجدول أكثر من نوى الحوسبة، كما أن نقطة تحقق أسرع قائمة على مزيج الخبراء خسرت مكانها بسبب سلوكها، لا سرعتها. — pavle-scalably على مدونة Hugging Face
AmberTrace يقيّم 19 نموذجًا مفتوحًا استنادًا إلى 1 350 قرارًا موثّقًا
18 سبتمبر — عندما يقرر نموذج الموافقة أو الرفض، لا يقتصر السؤال على عدد مرات خطئه، بل يشمل أيضًا اتجاه الخطأ. قيّمت AmberTrace Labs تسعة عشر نموذجًا بأوزان مفتوحة على 1 350 عنصرًا، لكل منها إجراء صحيح موثّق بدليل. يكشف التجميع حسب الفئة أكثر مما يكشفه الترتيب: النماذج مع تفعيل الاستدلال حققت متوسط 0.960؛ والنماذج القادرة على الاستدلال مع تعطيل الخيار حققت 0.909؛ والنماذج من دون استدلال حققت 0.805. الفارق بين تفعيل الاستدلال وتعطيله أكبر من الفارق بين أحجام شديدة الاختلاف. عينة واحدة، ودرجة حرارة 0: يوضح المؤلف حدود دراسته.
| النموذج المُقيَّم | المختبر | الدرجة المركبة | الدقة | الخطأ المتساهل |
|---|---|---|---|---|
| Qwen3.8-27B (استدلال) | Alibaba | 0.974 | 95.5% | 0.0% |
| Muse-Glimmer-30B | Meta | 0.960 | 94.0% | 3.1% |
| OLMo-3-32B-Think | Ai2 | 0.947 | 93.8% | 3.3% |
| Qwen3.8-27B | Alibaba | 0.937 | 91.3% | 6.3% |
🔗 اتجاه الخطأ في نماذج اتخاذ القرار ذات الأوزان المفتوحة
من 8 إلى 2 بت: انخفاض قدره 1.3 نقطة في الدقة، من دون تغير في طبيعة الأخطاء
19 سبتمبر — في اليوم التالي، تطبق AmberTrace البروتوكول نفسه للإجابة عن سؤال: ماذا نخسر عند التكميم؟ جرى تشغيل Qwen3.6-27B بستة مستويات GGUF، من Q8_0 إلى Q2_K، ثم تقييمه على العناصر الـ1 350 نفسها. تخالف النتيجة الحدس الشائع: تنخفض الدقة من 90.9% عند 8 بت إلى 89.6% عند 2 بت، أي بمقدار 1.3 نقطة مقابل خفض الدقة العددية إلى الربع. والرقم الأكثر إثارة للاهتمام هو الذي لا يتغير: يظل الانحياز الموقّع للأخطاء ثابتًا، عند معامل تحديد يبلغ 0.01. يغير التكميم عدد الأخطاء، لا طبيعتها. ويحذر المؤلف من أن الدراسة أولية.
| التكميم | الدقة | الخطأ المتساهل (النطاق الحرج) | الانحياز الموقّع |
|---|---|---|---|
| 8 بت | 90.9% | 5.2% | −0.024 |
| 5 بت | 91.3% | 4.5% | −0.029 |
| 4 بت | 90.2% | 6.3% | −0.018 |
| 2 بت | 89.6% | 6.3% | −0.024 |
🔗 التكميم واتجاه سلامة القرارات
jev-reranker يستبعد 92% من المستندات المرشحة ويحسّن الترتيب رغم ذلك
19 سبتمبر — نشر Yuichi Tateno مكتبة jev-reranker، وهي مكتبة Python تعتمد على Jev، نموذج التقييم المنظم من TypeSafe.AI، لإعادة ترتيب نتائج البحث، ولا سيما لاستبعاد المستندات التي لن تساعد في الإجابة. وتتجاوز الحجة توفير الـtokens: يمنح الترشيح التطبيق قرارًا يتخذه قبل التوليد. على NanoHotpotQA، حقق الترشيح قيمة nDCG@10 تبلغ 0.975 مع الاحتفاظ بـ7.62 مستندًا فقط لكل طلب، مقابل 0.833 للبحث الهجين الذي يحتفظ بـ100 مستند: تقليص السياق هو مصدر الفائدة هنا.
أما الملاحظة الأكثر إثارة للاهتمام فتوجد في موضع آخر: ظهر نموذج التقييم نفسه في اليوم ذاته ضمن تدوينة مستقلة ثانية، حيث استخدم Javad Taghia إعادة الترتيب لذاكرة وكيل، على معيار اختبار مختلف.
| طريقة الترتيب | العتبة | nDCG@10 | المستندات المحتفظ بها لكل طلب |
|---|---|---|---|
| البحث الهجين | — | 0.833 | 100 |
| إعادة الترتيب | 0.0 | 0.969 | 100 |
| ترشيح الصلة | 0.2 | 0.975 | 7.62 (استُبعد 92.38%) |
Metro-ASR-Small، 61 مليون معامل للغة العربية المصرية على معالج حاسوب محمول
19 سبتمبر — يضم Whisper-large-v3 نحو 1.5 مليار معامل، ويضم OmniASR-LLM من Meta نحو 7 مليارات: وكلاهما يتطلب بطاقة رسومية. أما Metro-ASR-Small فيضم 61.6 مليون معامل، ويشغل مساحة 235 ميغابايت، وينسخ العربية المصرية والإنجليزية والتناوب بينهما بسرعة تعادل 33 إلى 66 ضعف الزمن الحقيقي على أربعة خيوط للمعالج — وهو نطاق الجدول الذي يقرّبه النص إلى معامل 50. ليست التدوينة إعلانًا، بل تحقيقًا: من أين تأتي الدقة عندما تكون البيانات والمعاملات محدودة؟ تأتي من النموذج الصوتي بدرجة أقل مما قد يُعتقد. أما الرافعة الثانية فهي رأس لغوي اختياري من KenLM بحجم 6.4 غيغابايت: أي سبعة وعشرون ضعف حجم النموذج الصوتي.
| عرض الحزمة | معدل الخطأ في الكلمات | زمن فك الترميز |
|---|---|---|
| فك ترميز جشع | 30.0% | 5.9 ms |
| 100 | 24.3% | 128 ms |
| 400 | 24.1% | 351 ms |
🔗 ما يمكن لنموذج CTC ذي 61 مليون معامل أن يتعلمه، وما لا يمكنه تعلمه
Claude Code 2.1.278 يعيد مصنّف الوضع التلقائي إلى جانب الخادم ويتوقف عن احتساب رسومه
19 سبتمبر — في الوضع التلقائي، يفحص مصنّف الإجراءات الحساسة قبل تنفيذها؛ وحتى الآن، كانت عمليات التحقق هذه استدعاءات مدفوعة لنموذج وفق عدد الـtokens. ينفذها الخادم الآن ضمن طلبات الجلسة، من دون احتساب هذه التكلفة الإضافية، وذلك افتراضيًا في Claude API وEnterprise وBedrock وVertex وFoundry، مع ظهور سطر خادم الوضع التلقائي في /status. انتبه إلى الرجوع الاحتياطي: إذا أسقطت بوابة الحقل safeguards، ينتقل Claude Code إلى مصنّفه المحلي المدفوع بعد عرض تنبيه.
يجدر التنبيه إلى طبيعة هذا التغيير: إنه النقيض تمامًا لما فعلته النسخة 2.1.273 في 15 سبتمبر، إذ فرضت المصنّف المحلي افتراضيًا على Bedrock وVertex وFoundry. تراجع عن القرار في غضون أربعة أيام.
We’re changing auto mode to no longer charge for classifier requests in Claude Code. However, this session isn’t eligible.
🇸🇦 نحن نعدّل الوضع التلقائي للتوقف عن احتساب رسوم طلبات المصنّف في Claude Code. ومع ذلك، هذه الجلسة غير مؤهلة لذلك. — توثيق Claude Code، التنبيه المعروض عند الرجوع إلى الوضع المدفوع
🔗 ملاحظات إصدار Claude Code 2.1.278
تحديث أدوات البرمجة: اختفاء حقل من API وتشديد متانة الطرفية الزائفة
Devin: Azure DevOps Server، وإعادة اتصال MCP، وحقل total يعيد الآن null
18 سبتمبر — لا تمس دفعة ملاحظات الإصدار التي نشرتها Cognition محرك الوكيل، بل تركز على الإدارة واتصالات المؤسسات. الحقيقة الأهم ليست ميزة جديدة، بل تغييرًا كاسرًا: في قائمة سجلات التدقيق ضمن Enterprise API، لم يعد الحقل total يُملأ، وأصبح يعيد null؛ ويجب تنفيذ ترقيم الصفحات عبر has_next_page وend_cursor. سيتوقف عن العمل أي كود مستدعٍ كان يعتمد على هذا العداد. أما بقية التغييرات فهي إضافية: أصبحت مجموعات Azure DevOps Server 2020 و2022 مدعومة عبر token وصول شخصي، بعدما كان الدعم مقتصرًا على الإصدار السحابي؛ وحصل كل خادم MCP على إجراء إعادة الاتصال الذي يعيد تنفيذ المصادقة من دون إلغاء التثبيت؛ وانضمت ActiveCampaign وGrafana (OAuth) إلى الدليل؛ وأصبح من الممكن ترشيح الجلسات حسب المصدر، وارتفع معدل تسجيلات الشاشة إلى 60 إطارًا في الثانية.
Gemini CLI: إصدار nightly بلا إصلاحات أمنية، يركز على الطرفية الزائفة
19 سبتمبر — نشرت قناة nightly من Gemini CLI في الساعة 03:25 الإصدار v0.62.0-nightly.20260919.gcfbcaa8df، متضمنًا خمسة إصلاحات ومن دون أي تغيير أمني — في خروج عن سلسلة إصدارات nightly السابقة. يستهدف إصلاحان الطرفية الزائفة: مزامنة دورة حياة خروج عمليات ConPTY، وهي آلية تنفيذ الطرفية الزائفة على Windows، ثم إدارة ذاكرة مخزن الطرفية. أما الإصلاحات الثلاثة الأخرى فتعالج مشكلات مزعجة: ظهور سجلات AbortError عند إلغاء طلب، وفقدان تركيز الطرفية عند إغلاق علامة تبويب مقارنة في إضافة VS Code، ورابط توثيق المصادقة الذي يشير إلى مرساة غير صالحة. تظل القنوات العامة بلا تغيير، إذ يستقر الإصدار stable عند v0.60.0 وpreview عند v0.61.0-preview.0.
🔗 ملاحظات إصدار nightly ليوم 19 سبتمبر
Copilot code review يعيد تصميم تقريره ويصبح متاحًا بشكل عام
18 سبتمبر — أتاحت GitHub بشكل عام التصميم الجديد للتقرير الذي يتركه Copilot code review على pull request. يعرض تعليق الملخص التقييم الحالي ومستوى جهد المراجعة، ويوزع الملاحظات على ثلاث مجموعات، لكل منها درجة خطورة ورابط إلى التعليق المضمن. ومع تتابع الـcommits، يحتفظ الملخص بسجل التقدم بدلًا من إعادة كتابة نفسه. كما توسعت ميزة الحل التلقائي التي قُدمت في 11 سبتمبر: يُحترم الرد الذي يطلب إبقاء مشكلة مفتوحة، ويذكر الحل التلقائي سببه، Won’t Fix أو Incorrect — أي قرار مبرر وقابل للاعتراض بدلًا من إغلاق صامت.
| مجموعة الملاحظات | ما تتضمنه |
|---|---|
| Open | مشكلات لم تُعالج، مع وسم new إذا أضافها commit جديد |
| Resolved since last review | مشكلات تحقق Copilot من إصلاحها |
| Previously missed | مشكلات لم يضفها commit جديد، وعُثر عليها في مراجعة لاحقة |
🔗 Copilot code review، تجربة مراجعة محسّنة
Pika تطلق أسماء تطبيقات منصتها الجديدة
19 سبتمبر — في 17 سبتمبر، أعلنت Pika عن إعادة تصميم منتجها بالكامل وتحويله إلى منصة إبداعية، من دون ذكر أي ميزة أو سعر. وبين مساء 18 سبتمبر وصباح 19 سبتمبر، سدّت الشركة هذه الفجوة بسلسلة من المنشورات التي سمّت التطبيقات واحدًا تلو الآخر. وهذه القائمة ليست الكتالوج الكامل: تسرد الصفحة الرئيسية لـPika ثمانية تطبيقات — Video Studio وColor Grade وExtend Video وPika Soundtrack وEdit Image وCharacter Studio وImage Studio وProduct Shot — ولا يظهر فيها Camera Director أو Relight Media، ما يشير إلى أن العرض أوسع من هذه الإعلانات المتتالية.
| التطبيق المُعلن | الوظيفة التي وصفتها Pika |
|---|---|
| Video Studio | إنشاء فيديو من الصفر، تصل مدته إلى 3 دقائق ويتألف من لقطات متعددة، مع تضمين الصوت |
| Camera Director | يعيد توليد مشهد مرفوع من زوايا أخرى، مع الحفاظ على الحركة والأداء |
| Relight Media | يضبط لون الإضاءة وشدتها واتجاهها في مقطع بصورة منفصلة |
🔗 Video Studio · 🔗 Camera Director · 🔗 Relight Media
موجز الأخبار
- ملاحظة مجتمعية تشكك في استقلالية التقييم المُسند إلى Accenture — استكمالًا للشراكة التي جرت تغطيتها في 18 سبتمبر: تشير الملاحظة إلى أن Anthropic ستموّل عمل Accenture مباشرة، وأن شراكة تجارية سابقة تربط الشركتين بالفعل، مع تدريب نحو 30,000 متخصص من Accenture على Claude. 🔗 المصدر
- Replit توسّع سجلات التدقيق لديها بأكثر من 65 حدثًا إضافيًا — تشمل المشاريع ومساحات العمل وعمليات النشر وأمن الحساب وSSO وSCIM والموصلات والأسرار ونشاط Agent، لمسؤولي حسابات Enterprise؛ من دون قائمة تفصيلية أو تاريخ إتاحة منفصل. 🔗 المصدر
- Qwen Code v0.24.1 تنقل نسخة المعاينة الصادرة في اليوم السابق إلى القناة المستقرة — نُشرت عند الساعة 08:18 بتوقيت UTC، ولا تضيف سوى ستة بنود إلى v0.24.1-preview.0 التي سبقت تغطيتها: الخبر هو ترقية SDK المتصفح الخاص بـPlaywright والوكلاء الفرعيين داخل الحاويات، لا المحتوى نفسه. 🔗 المصدر
- Kimi Code 2.0.2 تصلح خمسة عيوب — بعد ثلاث وعشرين ساعة من الإصدار 2.0.1 ومن دون أي ميزة جديدة: لم تعد الرسائل تظهر في موضع قديم بعد الاستئناف، وأُزيلت التكرارات، وأُصلحت عملية الضغط بعد تغيير النموذج. 🔗 المصدر
- إعادة ترتيب ذاكرة وكيل باستخدام Jev ترفع الاستدعاء في المرتبة الأولى من 34 إلى 54٪ — عبر 1,986 سؤالًا من LoCoMo، ترفع إعادة ترتيب أفضل عشرة مرشحين من AtMem قيمة MRR@5 من 0.4259 إلى 0.5868، من دون تغيير الاستدعاء ضمن أفضل عشرة، الذي بقي عند 0.6495. 🔗 المصدر
- Layer-Feedback Transformer يكسب 4.29 نقاط عند 10 ملايين معلمة، لكن ليس عند تساوي الحوسبة — تؤدي إعادة تشغيل الطبقات المجاورة إلى رفع أداء نموذج من 32.57 إلى 36.86٪ على معيار داخلي، مقابل تنفيذ الكتل بمقدار 2.64 مرة أكثر، وهو قيد يقر به المؤلف صراحة. 🔗 المصدر
- AmberTrace تدافع عن المكافآت القابلة للتحقق خارج نطاق الرياضيات والبرمجة — مقال لتحديد الموقف من دون معيار اختباري: مكافأة مظهر النجاح تنتج نموذجًا يحسّن مظهر النجاح، فيما ظلت المجالات التي يرتب فيها القرار مسؤوليةً بلا مكافأة قابلة للتحقق. 🔗 المصدر
- بروتوكول اختبار لمعرفة ما إذا كان مستند قديم يستطيع إلغاء تحديث للذاكرة — وصفة مقترحة من دون قياسات: إذا عاد مستند مستبدَل عبر إعادة الاستيراد بطابع زمني حديث، فإنه يصبح بصمت الإجابة الحالية مجددًا عندما يتعامل النظام مع أحدث وصول بوصفه الأحدث زمنيًا. 🔗 المصدر
- البرمجيات بوصفها واجهة بين الوكلاء والعالم المادي — عرض تعليمي يربط حلقة عمل وكيل برمجي بتوليد البرامج للتحكم الروبوتي، من دون إعلان أو نتيجة رقمية خاصة به. 🔗 المصدر
- Qwen تعيد نشر عرض توضيحي من Cerebras قائم على Qwen3.8-27B — مساعد للتمويل الشخصي بناه طرف ثالث فوق استدلال Cerebras؛ إعادة نشر للتهنئة وليست إعلانًا عن منتج، إذ سبقت تغطية الموضوع الأساسي في 12 سبتمبر. 🔗 المصدر
- OpenAI تنشر Australian Youth Safety Blueprint — خارطة طريق من ست ركائز لحماية مستخدمي الذكاء الاصطناعي الشباب في أستراليا، بدءًا من محو الأمية وصولًا إلى التحقق من العمر مع احترام الخصوصية؛ وتذكّر الشركة بإطلاق ChatGPT for Teens في البلاد منذ أغسطس للفئة العمرية بين 13 و17 عامًا. 🔗 المصدر
- ChatGPT لنظام iOS 1.2026.251 يضيف المجلدات وكتل الكتابة — إنشاء مجلدات من منتقي الملفات، وكتل كتابة تتضمن بدائل للمسودات وإجراءات للنسخ، إلى جانب ثمانية إصلاحات تركز على worktrees والمطالبات الموضوعة في قائمة الانتظار. 🔗 المصدر
ما الذي يعنيه ذلك
اتخذ هذا اليوم شكلًا غير مألوف: صمتت المختبرات ونشر الممارسون. فلم تصدر أي جهة شيئًا، لا DeepSeek التي التزمت الصمت منذ تسعة أيام وجرى التحقق منها عبر ثلاث واجهات مستقلة، ولا Meta، ولا Ai2، ولا Sakana. جاءت الاكتشافات الأحد عشر في مجال النماذج المفتوحة كلها من المكان نفسه، وهو مدونة مجتمع Hugging Face، ولم تعرض أي نموذج: بل قدّمت قياسات. ذاكرة تخزين مؤقت للبادئات عبر أربعة عشر يومًا من حركة عملاء، و1,350 قرارًا معتمدًا بإثبات، وستة مستويات من التكميم، وجودة إعادة ترتيب. أما إصدار النموذج الوحيد في ذلك اليوم، Qwen3.8-LiveTranslate، فهو على العكس منتج API بلا أوزان مفتوحة. لم تنتج المنظومة المفتوحة، في هذا السبت، مادة خام — بل أنتجت أدوات قياس.
تتقارب دلالات هذه القياسات، وهذا أكثر إثارة للاهتمام من تنوعها. ففي الحالات الثلاث، لم يكن المعيار الحاسم هو المتوقع. فقد النموذج القائم على مزيج الخبراء والأسرع بمرتين مكانته، لا بسبب سرعته بل بسبب سلوكه، لأنه لا يتعافى من استدعاء أداة مرفوض إلا في حالة واحدة من أصل 20. ويُظهر ترتيب 19 نموذجًا أن الفارق بين تفعيل الاستدلال وتعطيله في النموذج نفسه يفوق الفارق بين أحجام متباينة جدًا. كما أن الانتقال من 8 بتات إلى بتين يكلّف 1.3 نقطة من الدقة من دون تغيير اتجاه الأخطاء. إنها ثلاث طرق للقول إن السرعة والحجم والدقة العددية مؤشرات ضعيفة لما سيفعله النموذج فعلًا في بيئة الإنتاج، وإنه ينبغي النظر إلى مكان آخر — إلى الطريقة التي يتدارك بها أخطاءه، أو يتروّى، أو ينحاز.
وثمة إشارة أكثر خفوتًا تستحق التنبيه: ظهر نموذج التحكيم نفسه، Jev، في اليوم ذاته ضمن تدوينتين لا صلة بينهما، لدى Yuichi Tateno لتصفية المستندات البحثية ولدى Javad Taghia لإعادة ترتيب ذاكرة وكيل، مع قياسه على معيارين مختلفين. عندما يستخدم مؤلفان مستقلان نموذجًا تابعًا لطرف ثالث كأداة في اليوم نفسه، فتلك بداية لبنة مشتركة. والمنطق واحد في الحالتين: إسناد قرار ما يجب الاحتفاظ به قبل الإجابة إلى حَكَم خارجي، لا إسناد الإجابة نفسها إليه — مع إمكانية التوقف، في حالة Tateno، عندما لا يوجد ما يستحق الاحتفاظ به.
أما في جانب الأدوات، فالتغيير يتعلق بالعقد أكثر مما يتعلق بالوظائف. ينقل Claude Code 2.1.278 مصنّف الوضع التلقائي إلى جانب الخادم ويتوقف عن فرض رسوم على هذه التكلفة الإضافية، في عكس تام لما قرره الإصدار 2.1.273 قبل أربعة أيام: تحوّل إعداد افتراضي إلى متغير اقتصادي يُراجع بهذه السرعة. أما Devin، فيتوقف عن ملء الحقل total في سجلات التدقيق، فتتعطل البرمجيات المستدعية التي كانت تعتمد عليه — وهو تغيير أُدرج وسط تحسينات لسهولة الاستخدام، رغم أنه يعطّل عمليات تكامل قائمة. وأخيرًا، تخرج مراجعة التعليمات البرمجية في Copilot من المعاينة عبر استبدال الإغلاق الصامت لتعليق بقرار معلّل، Won’t Fix أو Incorrect. ثلاث طرق، لدى ثلاثة ناشرين، للتذكير بأن جوهر أداة الوكيل بات يتحدد في قيمها الافتراضية وفوترتها ووعود API التي تقدمها.
المصادر
- Qwen، تدوينة Qwen3.8-LiveTranslate
- Alibaba Qwen على X، إعلان Qwen3.8-LiveTranslate
- أربعة عشر يومًا من حركة الوكلاء على وحدتي RTX 5090
- AmberTrace Labs، اتجاه الخطأ عبر 19 نموذجًا مفتوحًا
- AmberTrace Labs، التكميم واتجاه السلامة
- jev-reranker، العرض والقياسات
- Metro-ASR-Small، ما يتعلمه نموذج CTC يضم 61 مليون معلمة
- Claude Code، ملاحظات إصدار 2.1.278
- وثائق Claude Code، فوترة مصنّف الوضع التلقائي
- Devin، ملاحظات الإصدار
- Gemini CLI، الإصدار الليلي ليوم 19 سبتمبر
- GitHub، الإتاحة العامة لمراجعة التعليمات البرمجية في Copilot
- Pika على X، Camera Director
- Pika، صفحة التطبيقات