ai-powered-markdown-translatorArtículo traducido del fr al es con gpt-5.6-sol.
Este sábado, ningún laboratorio ha publicado un modelo con pesos abiertos: ni DeepSeek, en silencio desde hace nueve días, ni Meta, ni Ai2, ni Sakana. El único lanzamiento del día es un modelo de API cerrado, Qwen3.8-LiveTranslate, que reduce la latencia de una interpretación simultánea a 2,3 segundos. Todo lo demás procede de profesionales: once artículos en el blog comunitario de Hugging Face que no presentan modelos, sino mediciones —caché de prefijos en producción, decisiones certificadas, coste de la cuantización, calidad de una reordenación—.
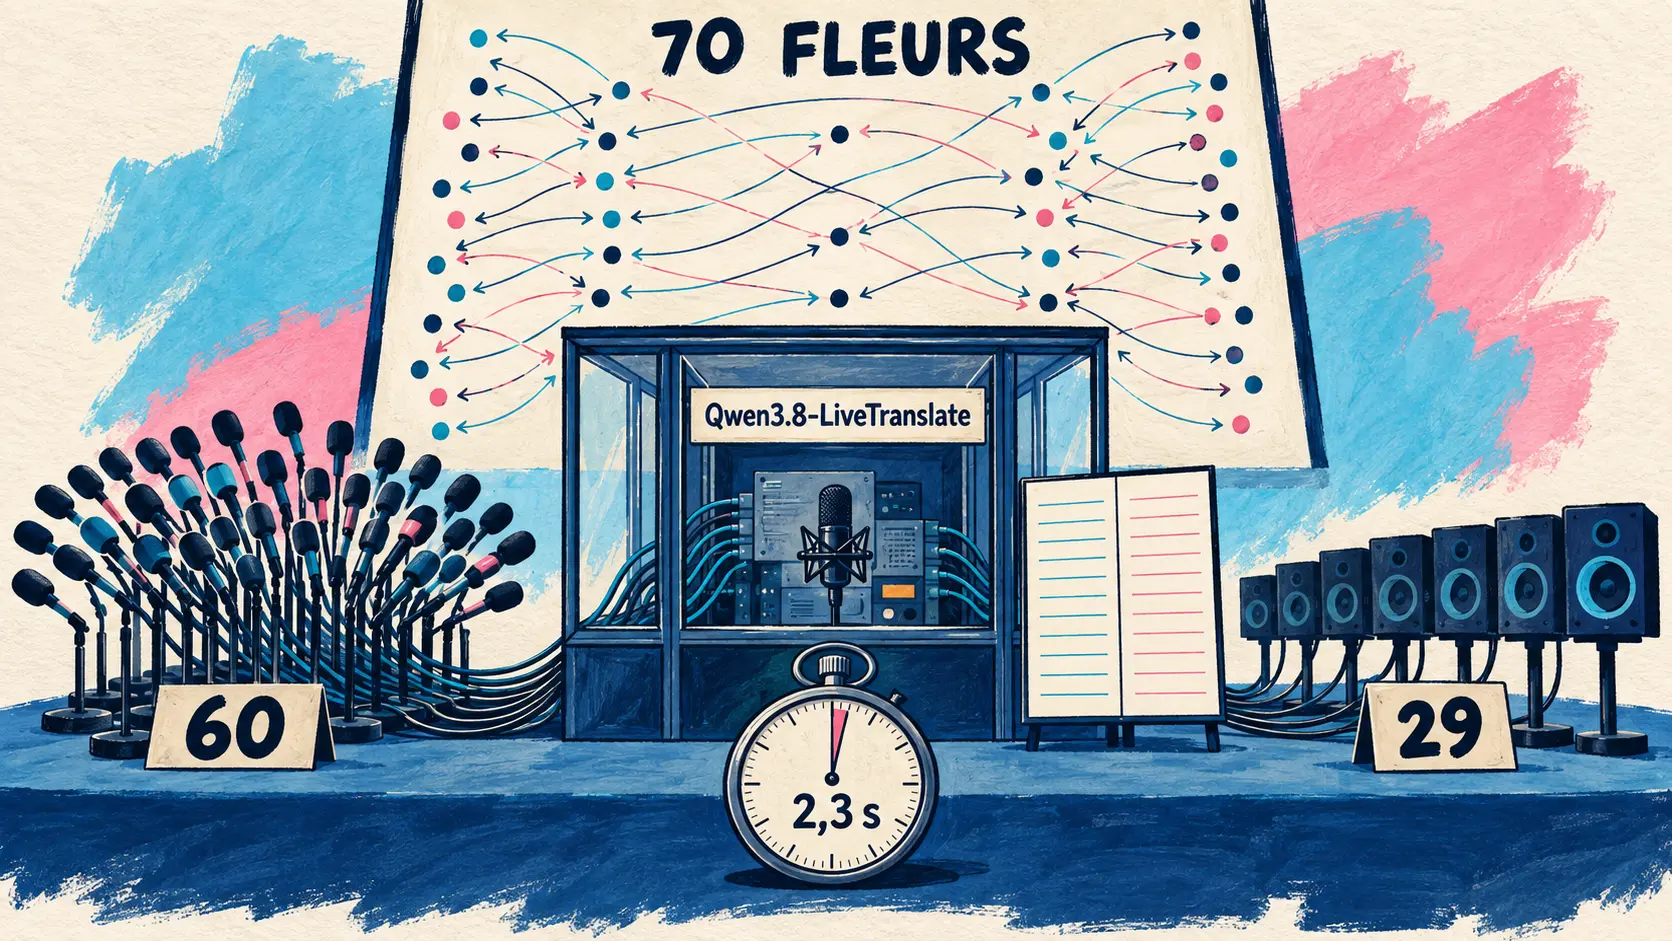
Qwen3.8-LiveTranslate, la interpretación simultánea por debajo de los 2,3 segundos
19 de septiembre — Qwen ha presentado Qwen3.8-LiveTranslate, su modelo de interpretación simultánea en tiempo real. La arquitectura Interleave procesa el audio y el texto como un único flujo entrelazado, en el que el audio ya escuchado y la traducción ya generada se almacenan en caché y después se reutilizan, lo que reduce la latencia media (average lagging, LAAL) de 2,8 a 2,3 segundos con una calidad mejorada.
El motor es un conjunto de dos módulos Thinker-Talker basado en una mezcla de expertos híbrida (Hybrid-MoE): el Thinker organiza el vídeo, el audio, el texto de origen y la traducción en una única secuencia causal ordenada temporalmente; después, el Talker sintetiza una voz que conserva el timbre del hablante original. Lo acompañan tres capacidades: separación de hablantes en tiempo real (real-time speaker separation), visualización bilingüe sincronizada y desambiguación en contextos largos.
En cuanto a la cobertura lingüística, el artículo y el mensaje del anuncio difieren: el segundo habla de 60 idiomas en conjunto, mientras que el primero distingue 60 idiomas de entrada de audio con salida de texto, pero solo 29 con salida de audio. Las cifras válidas son las del artículo. Las evaluaciones se realizan en Omnilingua-MSpeaker, con 14 direcciones lingüísticas, y en el conjunto público FLEURS, con 70 direcciones. El modelo se utiliza mediante API a través de DashScope: no se ha anunciado ninguna apertura de los pesos.
| Elemento medido | Valor anunciado |
|---|---|
| Latencia media (LAAL) | 2,3 s, frente a 2,8 s para la generación anterior |
| Idiomas con entrada de audio y salida de texto | 60 |
| Idiomas con salida de audio | 29 |
| Evaluación multilingüe pública | FLEURS, 70 direcciones lingüísticas |
| Nombre del modelo en la API | qwen3.8-livetranslate-flash-realtime |
Built on an Interleave architecture, it improves faithfulness, fluency, and conciseness while reducing average lagging (LAAL) from 2.8s to 2.3s across 60 languages.
🇪🇸 Basado en una arquitectura Interleave, mejora la fidelidad, la fluidez y la concisión, al tiempo que reduce la latencia media (LAAL) de 2,8 s a 2,3 s en 60 idiomas. — @Alibaba_Qwen en X
🔗 Artículo sobre Qwen3.8-LiveTranslate
Medir los modelos abiertos: tres estudios publicados el mismo día
Tres artículos independientes, todos publicados en el blog comunitario de Hugging Face, miden el mismo objeto desde tres perspectivas: qué valor tiene un modelo abierto en condiciones reales.
Catorce días de producción: la caché de prefijos decide el destino de un modelo de 27.000 millones
19 de septiembre — Durante 13,9 días, dos tarjetas GeForce RTX 5090 ejecutaron Qwen3.8-27B cuantizado en NVFP4 para el motor de agentes que Scalably utiliza con clientes reales, y cada cifra procede de un contador leído en el endpoint /metrics: 28.097 solicitudes completadas, 860,6 millones de tokens de entrada y cero abandonos. Con prompts de una mediana de 6.466 tokens y un percentil 99 de 183.800, el 82,6 % de los tokens de prefill procede de la caché. Y Nex-N2.5-mini, dos veces más rápido en la decodificación, perdió su puesto en una reproducción de decisiones reales: solo se recupera de una llamada a una herramienta rechazada en 1 caso de 20, frente a 12 de 20.
The short version: on agent traffic the prefix cache decides whether a 27B model keeps up, the scheduler flags matter more than the kernels, and a faster mixture-of-experts checkpoint lost the job on behaviour, not speed.
🇪🇸 En resumen: con tráfico de agentes, la caché de prefijos es la que determina si un modelo de 27.000 millones puede mantener el ritmo, las opciones del scheduler importan más que los kernels de cálculo y un checkpoint de mezcla de expertos más rápido perdió su puesto por su comportamiento, no por su velocidad. — pavle-scalably en el blog de Hugging Face
AmberTrace puntúa 19 modelos abiertos en 1.350 decisiones certificadas
18 de septiembre — Cuando un modelo decide conceder o denegar algo, la cuestión no es solo cuántas veces se equivoca, sino en qué sentido. AmberTrace Labs evaluó 19 modelos con pesos abiertos en 1.350 elementos cuya acción correcta estaba certificada mediante una prueba. La agrupación por familia revela más que la clasificación: razonamiento activado, una media de 0,960; modelos capaces de razonar, pero con la opción desactivada, 0,909; sin razonamiento, 0,805. La diferencia entre activar y desactivar el razonamiento supera la existente entre tamaños muy distintos. Una sola muestra, temperatura 0: el autor expone sus limitaciones.
| Modelo evaluado | Laboratorio | Puntuación compuesta | Exactitud | Error permisivo |
|---|---|---|---|---|
| Qwen3.8-27B (razonamiento) | Alibaba | 0,974 | 95,5 % | 0,0 % |
| Muse-Glimmer-30B | Meta | 0,960 | 94,0 % | 3,1 % |
| OLMo-3-32B-Think | Ai2 | 0,947 | 93,8 % | 3,3 % |
| Qwen3.8-27B | Alibaba | 0,937 | 91,3 % | 6,3 % |
🔗 La dirección del error en los modelos de decisión con pesos abiertos
De 8 a 2 bits: 1,3 puntos de exactitud y ningún cambio de naturaleza
19 de septiembre — Al día siguiente, AmberTrace aplica el mismo protocolo a una pregunta: ¿qué se pierde al cuantizar? Qwen3.6-27B se ejecutó en seis niveles GGUF, de Q8_0 a Q2_K, y después se evaluó en los mismos 1.350 elementos. El resultado contradice la intuición habitual: la exactitud pasa del 90,9 % con 8 bits al 89,6 % con 2 bits, es decir, 1,3 puntos por dividir entre cuatro la precisión numérica. La cifra más interesante es la que no cambia: el sesgo con signo de los errores permanece estable, con un coeficiente de determinación de 0,01. La cuantización cambia la cantidad de errores, no su naturaleza. El autor advierte que se trata de un estudio preliminar.
| Cuantización | Exactitud | Error permisivo (franja crítica) | Sesgo con signo |
|---|---|---|---|
| 8 bits | 90,9 % | 5,2 % | −0,024 |
| 5 bits | 91,3 % | 4,5 % | −0,029 |
| 4 bits | 90,2 % | 6,3 % | −0,018 |
| 2 bits | 89,6 % | 6,3 % | −0,024 |
🔗 Cuantización y dirección de seguridad de las decisiones
jev-reranker descarta el 92 % de los documentos candidatos y aun así mejora la clasificación
19 de septiembre — Yuichi Tateno publica jev-reranker, una biblioteca de Python que se apoya en Jev, el modelo de evaluación estructurada de TypeSafe.AI, para reordenar resultados de búsqueda y, sobre todo, descartar los documentos que no ayudarán a responder. El argumento va más allá del ahorro de tokens: el filtrado proporciona a la aplicación una decisión que tomar antes de la generación. En NanoHotpotQA, el filtrado alcanza un nDCG@10 de 0,975 conservando solo 7,62 documentos por consulta, frente a 0,833 para la búsqueda híbrida, que conserva 100: el interés reside en la reducción del contexto.
La observación más interesante está en otra parte: el mismo modelo de evaluación aparece ese mismo día en un segundo artículo independiente, en el que Javad Taghia reordena la memoria de un agente en otro benchmark.
| Método de clasificación | Umbral | nDCG@10 | Documentos conservados por consulta |
|---|---|---|---|
| Búsqueda híbrida | — | 0,833 | 100 |
| Reordenación | 0,0 | 0,969 | 100 |
| Filtrado por relevancia | 0,2 | 0,975 | 7,62 (92,38 % descartados) |
🔗 Presentación de jev-reranker
Metro-ASR-Small, 61 millones de parámetros para árabe egipcio en el procesador de un portátil
19 de septiembre — Whisper-large-v3 tiene 1.500 millones de parámetros y OmniASR-LLM de Meta, 7.000 millones: todos requieren una tarjeta gráfica. Metro-ASR-Small tiene 61,6 millones, ocupa 235 MB y transcribe árabe egipcio, inglés y la alternancia entre ambos a una velocidad de entre 33 y 66 veces el tiempo real en cuatro hilos de procesador —el intervalo de la tabla, que el texto redondea a un factor de 50—. El artículo no es un anuncio, sino una investigación: ¿de dónde procede la exactitud cuando los datos y los parámetros están limitados? Menos del modelo acústico de lo que se cree. La segunda palanca es un modelo de lenguaje KenLM opcional de 6,4 GB: veintisiete veces el tamaño del modelo acústico.
| Ancho del haz | Tasa de error por palabra | Tiempo de decodificación |
|---|---|---|
| Decodificación greedy | 30,0 % | 5,9 ms |
| 100 | 24,3 % | 128 ms |
| 400 | 24,1 % | 351 ms |
🔗 Lo que un modelo CTC de 61 millones de parámetros puede aprender y lo que no
Claude Code 2.1.278 vuelve a trasladar el clasificador del modo auto al servidor y deja de cobrarlo
19 de septiembre — En modo auto, un clasificador inspecciona las acciones sensibles antes de ejecutarlas; hasta ahora, estas comprobaciones eran llamadas al modelo facturadas por token. El servidor las realiza ahora como parte de las solicitudes de la sesión, sin cobrar este coste adicional, de forma predeterminada para Claude API, Enterprise, Bedrock, Vertex y Foundry, con una línea Auto mode server en /status. Atención al fallback: un gateway que descarte el campo safeguards hace que Claude Code pase a utilizar su clasificador local, facturado, después de mostrar un aviso.
El cambio merece señalarse como tal: es exactamente lo contrario de la versión 2.1.273 del 15 de septiembre, que había impuesto de forma predeterminada el clasificador local en Bedrock, Vertex y Foundry. Una ida y vuelta en cuatro días.
We’re changing auto mode to no longer charge for classifier requests in Claude Code. However, this session isn’t eligible.
🇪🇸 Estamos modificando el modo auto para dejar de cobrar por las solicitudes del clasificador en Claude Code. Sin embargo, esta sesión no cumple los requisitos. — Documentación de Claude Code, aviso mostrado en caso de fallback facturado
🔗 Notas de la versión 2.1.278 de Claude Code
Las herramientas de código se actualizan: desaparece un campo de API y se refuerza un pseudoterminal
Devin: Azure DevOps Server, reconexión MCP y un campo total que ahora devuelve null
18 de septiembre — La serie de notas de versión publicada por Cognition no afecta al motor del agente, sino a la administración y a las conexiones empresariales. El hecho más importante no es una novedad, sino un cambio incompatible: en la lista de registros de auditoría de la API Enterprise, el campo total deja de rellenarse y devuelve null; la paginación debe realizarse mediante has_next_page y end_cursor. Todo código cliente que dependiera de este contador deja de funcionar. El resto son incorporaciones: se admiten las colecciones de Azure DevOps Server 2020 y 2022 mediante un token de acceso personal, mientras que antes solo se admitía la versión cloud; cada servidor MCP recibe una acción Reconnect que repite la autenticación sin desinstalarlo; ActiveCampaign y Grafana (OAuth) se incorporan al catálogo; las sesiones pueden filtrarse por origen y las grabaciones de pantalla alcanzan las 60 imágenes por segundo.
Gemini CLI: una nightly sin correcciones de seguridad, centrada en el pseudoterminal
19 de septiembre — El canal nightly de Gemini CLI publica a las 03:25 la versión v0.62.0-nightly.20260919.gcfbcaa8df, con cinco correcciones y ningún cambio de seguridad, lo que rompe con la serie de nightlies anteriores. Dos se centran en el pseudoterminal: la sincronización del ciclo de vida de salida de los procesos ConPTY, la implementación del pseudoterminal para Windows, y la gestión de memoria del búfer del terminal. Las otras tres corrigen molestias: registros AbortError mostrados al cancelar una solicitud, pérdida del foco del terminal al cerrar una pestaña de comparación en la extensión de VS Code y un enlace de la documentación de autenticación que apuntaba a un ancla no válida. Los canales públicos no cambian: stable permanece en v0.60.0 y preview en v0.61.0-preview.0.
🔗 Notas de la versión nightly del 19 de septiembre
Copilot code review rediseña su informe y pasa a disponibilidad general
18 de septiembre — GitHub lleva a disponibilidad general un rediseño del informe que Copilot code review deja en una pull request. El comentario de síntesis muestra la evaluación actual y el nivel de esfuerzo de la revisión, y distribuye los hallazgos en tres grupos, cada uno con su gravedad y un enlace al comentario inline. A medida que se suceden los commits, la síntesis conserva el progreso en vez de reescribirse. La resolución automática, introducida el 11 de septiembre, se amplía: se respeta una respuesta que solicite mantener abierto un problema, y una resolución automática indica su motivo, Won’t Fix o Incorrect —una decisión justificada e impugnable en lugar de un cierre silencioso—.
| Grupo de hallazgos | Contenido |
|---|---|
| Open | Problemas sin resolver, etiqueta new si los ha introducido un nuevo commit |
| Resolved since last review | Problemas cuya corrección ha validado Copilot |
| Previously missed | Problemas no introducidos por un nuevo commit, encontrados durante una revisión posterior |
🔗 Copilot code review, una experiencia de revisión mejorada
Pika pone nombre a las aplicaciones de su nueva plataforma
19 de septiembre — El 17 de septiembre, Pika anunciaba el rediseño completo de su producto para convertirlo en una plataforma creativa, sin citar una sola función ni una sola tarifa. Entre la noche del 18 y la mañana del 19, la empresa llenó ese vacío con una serie de mensajes que nombran las aplicaciones una por una. Esta lista no es el catálogo: la página de inicio de Pika enumera ocho aplicaciones —Video Studio, Color Grade, Extend Video, Pika Soundtrack, Edit Image, Character Studio, Image Studio y Product Shot— entre las que no aparecen ni Camera Director ni Relight Media, lo que indica que la oferta es más amplia que estos anuncios sucesivos.
| Aplicación anunciada | Función descrita por Pika |
|---|---|
| Video Studio | Vídeo desde cero, de hasta 3 minutos en varios planos, con sonido incluido |
| Camera Director | Regenera una escena subida desde otros ángulos, conservando el movimiento y la actuación |
| Relight Media | Ajusta por separado el color, la intensidad y la dirección de la luz de un clip |
🔗 Video Studio · 🔗 Camera Director · 🔗 Relight Media
Breves
- Una nota de la comunidad cuestiona la independencia de la evaluación encomendada a Accenture — complemento de la colaboración cubierta el día 18: la nota señala que Anthropic financiará directamente el trabajo de Accenture y que una colaboración comercial anterior ya vincula a ambas empresas, con unos 30 000 profesionales de Accenture formados en Claude. 🔗 fuente
- Replit amplía sus registros de auditoría con más de 65 eventos adicionales — proyectos, espacios de trabajo, despliegues, seguridad de la cuenta, SSO y SCIM, conectores, secretos y actividad del Agent, para los administradores de cuentas Enterprise; sin lista detallada ni fecha de disponibilidad específica. 🔗 fuente
- Qwen Code v0.24.1 convierte en estable la versión preliminar del día anterior — publicada a las 08:18 UTC, solo añade seis entradas a la v0.24.1-preview.0 ya tratada: la noticia es la promoción a estable del SDK para navegador Playwright y de los subagentes en contenedores, no el contenido. 🔗 fuente
- Kimi Code 2.0.2 corrige cinco defectos — veintitrés horas después de la 2.0.1 y sin ninguna función nueva: los mensajes ya no aparecen en una posición antigua tras reanudar una sesión, se eliminan los duplicados y se repara la compactación después de cambiar de modelo. 🔗 fuente
- Reordenar la memoria de un agente con Jev eleva la recuperación en la primera posición del 34 al 54 % — en 1 986 preguntas de LoCoMo, la reordenación de los diez mejores candidatos de AtMem eleva el MRR@5 de 0,4259 a 0,5868 sin cambiar la recuperación en las diez primeras posiciones, que permanece en 0,6495. 🔗 fuente
- El Layer-Feedback Transformer gana 4,29 puntos con 10 millones de parámetros, pero no con el mismo cómputo — volver a ejecutar las capas vecinas hace que un modelo pase del 32,57 al 36,86 % en un banco de pruebas propio, a costa de 2,64 veces más ejecuciones de bloques, una limitación que el autor reconoce explícitamente. 🔗 fuente
- AmberTrace aboga por recompensas verificables más allá de las matemáticas y el código — ensayo de posicionamiento sin banco de pruebas: recompensar la apariencia del éxito produce un modelo que optimiza la apariencia, y los ámbitos en los que una decisión implica responsabilidad siguen careciendo de una recompensa verificable. 🔗 fuente
- Un protocolo de prueba para saber si un documento antiguo puede anular una actualización de memoria — propuesta de procedimiento, sin mediciones: un documento sustituido que vuelve a importarse con una marca de tiempo reciente se convierte de nuevo silenciosamente en la respuesta actual si el sistema trata la llegada más reciente como la información más actual. 🔗 fuente
- El código como interfaz entre los agentes y el mundo físico — síntesis pedagógica que relaciona el bucle de un agente de código con la generación de programas para la manipulación robótica, sin anuncio ni resultado cuantificado propio. 🔗 fuente
- Qwen difunde una demostración de Cerebras basada en Qwen3.8-27B — un asistente de finanzas personales creado por un tercero sobre la inferencia de Cerebras; una felicitación difundida, no un anuncio de producto, pues el tema subyacente ya se trató el 12 de septiembre. 🔗 fuente
- OpenAI publica su Australian Youth Safety Blueprint — una hoja de ruta de seis pilares para proteger a los jóvenes usuarios de IA en Australia, desde la alfabetización hasta una verificación de edad respetuosa con la privacidad; la empresa recuerda el despliegue de ChatGPT for Teens en el país desde agosto para jóvenes de 13 a 17 años. 🔗 fuente
- ChatGPT para iOS 1.2026.251 añade carpetas y bloques de escritura — creación de carpetas desde el selector de archivos, bloques de escritura con variantes de borrador y acciones de copia, además de ocho correcciones centradas en los worktrees y los prompts en cola. 🔗 fuente
Qué significa
La jornada presenta una forma inusual: los laboratorios callan y los profesionales publican. Ni DeepSeek, en silencio desde hace nueve días y verificado en tres superficies independientes, ni Meta, ni Ai2, ni Sakana han publicado nada. Los once hallazgos del ámbito de los modelos abiertos proceden todos del mismo lugar, el blog comunitario de Hugging Face, y no presentan ningún modelo: miden. Una caché de prefijos sobre catorce días de tráfico de clientes, 1 350 decisiones certificadas mediante una prueba, seis niveles de cuantificación, la calidad de una reordenación. El único lanzamiento de modelo del día, Qwen3.8-LiveTranslate, es, por el contrario, un producto de API sin pesos abiertos. Este sábado, el ecosistema abierto no ha producido materia prima: ha producido instrumentos de medición.
Lo que dicen estas mediciones converge, y resulta más interesante que su diversidad. En los tres casos, el criterio decisivo no es el que se esperaba. El modelo mixture-of-experts dos veces más rápido pierde su puesto no por su velocidad, sino por su comportamiento, porque solo se recupera de una llamada a una herramienta rechazada en 1 de cada 20 casos. La clasificación de 19 modelos muestra que la diferencia entre el razonamiento activado y desactivado en un mismo modelo supera la diferencia entre tamaños muy distintos. Y bajar de 8 a 2 bits cuesta 1,3 puntos de exactitud sin cambiar la dirección de los errores. Tres formas de decir que la velocidad, el tamaño y la precisión numérica son malos predictores de lo que un modelo hará realmente en producción, y que hay que mirar a otra parte: cómo se recupera, delibera o se inclina.
Una señal más discreta merece atención: el mismo modelo de evaluación, Jev, aparece el mismo día en dos entradas sin relación entre sí, en la de Yuichi Tateno para filtrar documentos de investigación y en la de Javad Taghia para reordenar la memoria de un agente, medido en dos bancos de pruebas diferentes. Que dos autores independientes instrumenten el mismo día un modelo de terceros es el comienzo de un componente compartido. La lógica es la misma en ambos casos: delegar en un evaluador externo no la respuesta, sino la decisión de qué conservar antes de responder y, en el caso de Tateno, la posibilidad de detenerse cuando nada merece conservarse.
En cuanto a las herramientas, lo que cambia tiene más que ver con el contrato que con la funcionalidad. Claude Code 2.1.278 pasa el clasificador del modo auto al lado del servidor y deja de cobrar este coste adicional, exactamente lo contrario de lo que había decidido la versión 2.1.273 cuatro días antes: una configuración predeterminada se ha convertido en una variable económica que se revisa a esa velocidad. Devin, por su parte, deja de rellenar el campo total de sus registros de auditoría, y el código que lo invocaba y dependía de él deja de funcionar: un cambio incluido entre novedades ergonómicas, aunque rompe integraciones existentes. Copilot code review, por último, sale de la versión preliminar sustituyendo el cierre silencioso de un comentario por una decisión motivada, Won’t Fix o Incorrect. Tres maneras, por parte de tres proveedores, de recordar que lo esencial de una herramienta de agentes se juega ahora en sus valores predeterminados, su facturación y sus promesas de API.
Fuentes
- Qwen, entrada sobre Qwen3.8-LiveTranslate
- Alibaba Qwen en X, anuncio de Qwen3.8-LiveTranslate
- Catorce días de tráfico de agentes en dos RTX 5090
- AmberTrace Labs, la dirección del error en 19 modelos abiertos
- AmberTrace Labs, cuantificación y dirección de seguridad
- jev-reranker, presentación y mediciones
- Metro-ASR-Small, lo que aprende un modelo CTC de 61 millones de parámetros
- Claude Code, notas de la versión 2.1.278
- Documentación de Claude Code, facturación del clasificador del modo auto
- Devin, notas de la versión
- Gemini CLI, nightly del 19 de septiembre
- GitHub, disponibilidad general de Copilot code review
- Pika en X, Camera Director
- Pika, página de aplicaciones