ai-powered-markdown-translatorArtikel översatt från franska till svenska med gpt-5.6-sol.
Denna lördag publicerade inget laboratorium någon modell med öppna vikter: varken DeepSeek, som varit tyst i nio dagar, Meta, Ai2 eller Sakana. Dagens enda lansering är en sluten API-modell, Qwen3.8-LiveTranslate, som sänker latensen för simultantolkning till 2,3 sekunder. Allt annat kommer från praktiker: elva inlägg på Hugging Faces communityblogg som inte presenterar modeller utan mätningar — prefixcache i produktion, certifierade beslut, kostnaden för kvantisering och kvaliteten på omrangering.
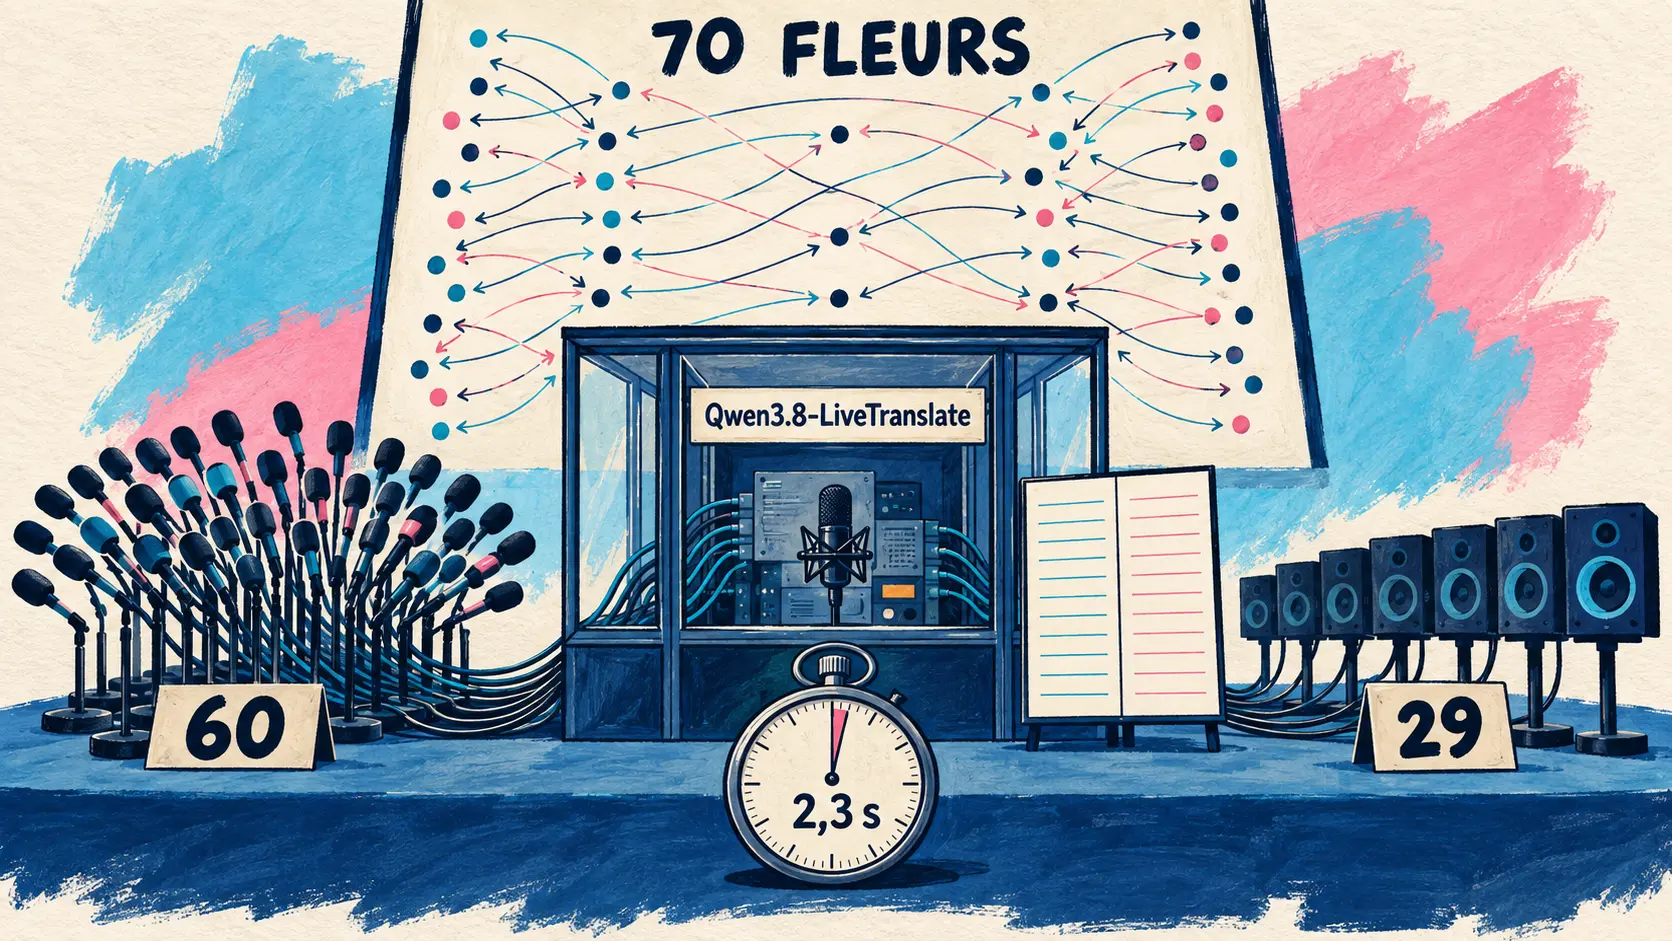
Qwen3.8-LiveTranslate, simultantolkning under 2,3 sekunder
19 september — Qwen presenterade Qwen3.8-LiveTranslate, sin modell för simultantolkning i realtid. Interleave-arkitekturen behandlar ljud och text som ett enda sammanflätat flöde, där ljud som redan hörts och översättning som redan producerats cachelagras och sedan återanvänds, vilket sänker den genomsnittliga latensen (average lagging, LAAL) från 2,8 till 2,3 sekunder samtidigt som kvaliteten förbättras.
Motorn är ett system med två Thinker-Talker-moduler baserat på en hybridblandning av experter (Hybrid-MoE): Thinker ordnar video, ljud, källtext och översättning i en enda kausal sekvens i tidsordning, varefter Talker syntetiserar en röst som bevarar den ursprungliga talarens klang. Tre funktioner kompletterar detta: talarseparering i realtid (real-time speaker separation), en synkroniserad tvåspråkig visning och disambiguering med lång kontext.
När det gäller språkstödet skiljer sig blogginlägget och lanseringsmeddelandet åt: det senare talar om 60 språk utan åtskillnad, medan det förra skiljer mellan 60 språk för ljudindata med textutdata och endast 29 för ljudutdata. Det är siffrorna i blogginlägget som gäller. Utvärderingarna omfattar Omnilingua-MSpeaker, 14 språkriktningar, och den offentliga datasamlingen FLEURS, 70 riktningar. Modellen används via API genom DashScope: ingen publicering av vikterna har tillkännagivits.
| Uppmätt komponent | Angivet värde |
|---|---|
| Genomsnittlig latens (LAAL) | 2,3 s, jämfört med 2,8 s för föregående generation |
| Språk för ljudindata, textutdata | 60 |
| Språk för ljudutdata | 29 |
| Offentlig flerspråkig utvärdering | FLEURS, 70 språkriktningar |
| Modellnamn i API:et | qwen3.8-livetranslate-flash-realtime |
Built on an Interleave architecture, it improves faithfulness, fluency, and conciseness while reducing average lagging (LAAL) from 2.8s to 2.3s across 60 languages.
🇸🇪 Den bygger på en Interleave-arkitektur och förbättrar troheten, flytet och koncisheten samtidigt som den minskar den genomsnittliga latensen (LAAL) från 2,8 s till 2,3 s för 60 språk. — @Alibaba_Qwen på X
🔗 Inlägg om Qwen3.8-LiveTranslate
Att mäta öppna modeller: tre studier publicerade samma dag
Tre oberoende inlägg, samtliga publicerade på Hugging Faces communityblogg, mäter samma företeelse ur tre perspektiv: hur väl en öppen modell fungerar under verkliga förhållanden.
Fjorton dagar i produktion: prefixcachen avgör ödet för en modell med 27 miljarder parametrar
19 september — Under 13,9 dagar körde två GeForce RTX 5090-kort Qwen3.8-27B, kvantiserad i NVFP4, åt den agentmotor som Scalably driver för riktiga kunder. Varje siffra är ett mätvärde avläst vid åtkomstpunkten /metrics: 28 097 slutförda förfrågningar, 860,6 miljoner indatatokens och noll avbrott. Med en medianlängd för prompts på 6 466 tokens och en 99:e percentil på 183 800 kommer 82,6 % av förifyllnadens tokens från cachen. Och Nex-N2.5-mini, som är dubbelt så snabb vid avkodning, förlorade sin plats vid en återuppspelning av verkliga beslut: den återhämtar sig efter ett avvisat verktygsanrop i endast 1 av 20 fall, jämfört med 12 av 20.
The short version: on agent traffic the prefix cache decides whether a 27B model keeps up, the scheduler flags matter more than the kernels, and a faster mixture-of-experts checkpoint lost the job on behaviour, not speed.
🇸🇪 Sammanfattningsvis: för agenttrafik är det prefixcachen som avgör om en modell med 27 miljarder parametrar håller takten, schemaläggarens alternativ spelar större roll än beräkningskärnorna, och en snabbare kontrollpunkt med en blandning av experter förlorade sin plats på grund av sitt beteende, inte sin hastighet. — pavle-scalably på Hugging Face-bloggen
AmberTrace betygsätter 19 öppna modeller utifrån 1 350 certifierade beslut
18 september — När en modell beslutar att godkänna eller avslå är frågan inte bara hur ofta den har fel, utan i vilken riktning. AmberTrace Labs utvärderade 19 modeller med öppna vikter på 1 350 objekt där den korrekta åtgärden certifierats genom ett bevis. Grupperingen efter familj säger mer än rankningen: resonemang aktiverat, 0,960 i genomsnitt; modeller som kan resonera men där alternativet är avstängt, 0,909; utan resonemang, 0,805. Skillnaden mellan aktiverat och inaktiverat resonemang är större än skillnaden mellan mycket olika modellstorlekar. Ett enda stickprov, temperatur 0: författaren redovisar studiens begränsningar.
| Utvärderad modell | Laboratorium | Sammansatt poäng | Träffsäkerhet | Tillåtande fel |
|---|---|---|---|---|
| Qwen3.8-27B (resonemang) | Alibaba | 0,974 | 95,5 % | 0,0 % |
| Muse-Glimmer-30B | Meta | 0,960 | 94,0 % | 3,1 % |
| OLMo-3-32B-Think | Ai2 | 0,947 | 93,8 % | 3,3 % |
| Qwen3.8-27B | Alibaba | 0,937 | 91,3 % | 6,3 % |
🔗 Felriktningen i beslutsmodeller med öppna vikter
Från 8 till 2 bitar: 1,3 procentenheters träffsäkerhet och ingen förändring i karaktär
19 september — Dagen därpå tillämpar AmberTrace samma protokoll på en fråga: vad förlorar man på kvantisering? Qwen3.6-27B kördes med sex GGUF-nivåer, från Q8_0 till Q2_K, och utvärderades sedan på samma 1 350 objekt. Resultatet går emot den vanliga intuitionen: träffsäkerheten sjunker från 90,9 % med 8 bitar till 89,6 % med 2 bitar, alltså 1,3 procentenheter när den numeriska precisionen delas med fyra. Den intressantaste siffran är den som inte förändras: felens teckenbestämda bias förblir oförändrad, med en determinationskoefficient på 0,01. Kvantiseringen förändrar antalet fel, inte deras karaktär. Författaren varnar för att studien är preliminär.
| Kvantisering | Träffsäkerhet | Tillåtande fel (kritiskt intervall) | Teckenbestämd bias |
|---|---|---|---|
| 8 bitar | 90,9 % | 5,2 % | −0,024 |
| 5 bitar | 91,3 % | 4,5 % | −0,029 |
| 4 bitar | 90,2 % | 6,3 % | −0,018 |
| 2 bitar | 89,6 % | 6,3 % | −0,024 |
🔗 Kvantisering och säkerhetsriktningen i beslut
jev-reranker sållar bort 92 % av kandidatdokumenten och förbättrar ändå rankningen
19 september — Yuichi Tateno publicerar jev-reranker, ett Python-bibliotek som använder Jev, TypeSafe.AI:s modell för strukturerad bedömning, för att rangordna om sökresultat och framför allt sålla bort dokument som inte hjälper till att besvara frågan. Argumentet handlar om mer än att spara tokens: filtreringen ger applikationen ett beslut att fatta före genereringen. På NanoHotpotQA når filtreringen 0,975 i nDCG@10 när endast 7,62 dokument per förfrågan behålls, jämfört med 0,833 för hybridsökningen som behåller 100: det är minskningen av kontexten som gör metoden intressant.
Den mest intressanta observationen finns på annat håll: samma bedömningsmodell förekommer samma dag i ett andra, oberoende inlägg, där Javad Taghia rangordnar om en agents minne på en annan benchmark.
| Rankningsmetod | Tröskelvärde | nDCG@10 | Dokument som behålls per förfrågan |
|---|---|---|---|
| Hybridsökning | — | 0,833 | 100 |
| Omrangering | 0,0 | 0,969 | 100 |
| Relevansfiltrering | 0,2 | 0,975 | 7,62 (92,38 % bortsorterade) |
🔗 Presentation av jev-reranker
Metro-ASR-Small, 61 miljoner parametrar för egyptisk arabiska på en bärbar dators processor
19 september — Whisper-large-v3 har 1,5 miljarder parametrar och Metas OmniASR-LLM 7 miljarder: båda kräver ett grafikkort. Metro-ASR-Small har 61,6 miljoner, ryms på 235 MB och transkriberar egyptisk arabiska, engelska och kodväxling mellan dem 33 till 66 gånger snabbare än realtid på fyra processortrådar — intervallet i tabellen, som texten avrundar till en faktor på 50. Inlägget är inte ett tillkännagivande utan en undersökning: varifrån kommer träffsäkerheten när data och parametrar är begränsade? I mindre utsträckning från den akustiska modellen än man kan tro. Den andra hävstången är en valfri KenLM-språkmodul på 6,4 GB: tjugosju gånger större än den akustiska modellen.
| Strålbredd | Ordfelfrekvens | Avkodningstid |
|---|---|---|
| Girig avkodning | 30,0 % | 5,9 ms |
| 100 | 24,3 % | 128 ms |
| 400 | 24,1 % | 351 ms |
🔗 Vad en CTC-modell med 61 miljoner parametrar kan och inte kan lära sig
Claude Code 2.1.278 flyttar tillbaka autolägets klassificerare till serversidan och slutar ta betalt för den
19 september — I autoläget granskar en klassificerare känsliga åtgärder innan de utförs; dessa kontroller var tidigare modellanrop som debiterades per token. Servern utför dem nu inom ramen för sessionens förfrågningar utan att debitera denna extra kostnad, som standard för Claude API, Enterprise, Bedrock, Vertex och Foundry, med raden Auto mode server i /status. Se upp med reservlösningen: en gateway som utelämnar fältet safeguards får Claude Code att växla till sin lokala, debiterade klassificerare efter att ett meddelande visats.
Förändringen är värd att framhålla för vad den är: den är raka motsatsen till version 2.1.273 från den 15 september, som hade gjort den lokala klassificeraren till standard på Bedrock, Vertex och Foundry. En helomvändning på fyra dagar.
We’re changing auto mode to no longer charge for classifier requests in Claude Code. However, this session isn’t eligible.
🇸🇪 Vi ändrar autoläget så att förfrågningar till klassificeraren i Claude Code inte längre debiteras. Den här sessionen är dock inte berättigad till detta. — Claude Code-dokumentationen, meddelande som visas vid återgång till debiterad klassificering
🔗 Versionsinformation för Claude Code 2.1.278
Kodverktygen uppdateras: ett API-fält försvinner och en pseudoterminal blir robustare
Devin: Azure DevOps Server, återanslutning av MCP och ett fält total som nu returnerar null
18 september — Serien av versionsanteckningar som Cognition publicerade berör inte agentmotorn utan administration och företagsanslutningar. Det viktigaste är ingen nyhet utan en brytande förändring: i listan över granskningsloggar i Enterprise API fylls fältet total inte längre i utan returnerar null; sidindelningen måste ske via has_next_page och end_cursor. All anropande kod som förlitade sig på denna räknare slutar fungera. Resten är tillägg: samlingar i Azure DevOps Server 2020 och 2022 stöds via personliga åtkomsttokens, medan endast molnversionen stöddes tidigare; varje MCP-server får åtgärden Reconnect, som upprepar autentiseringen utan avinstallation; ActiveCampaign och Grafana (OAuth) läggs till i katalogen; sessioner kan filtreras efter ursprung och skärminspelningar höjs till 60 bilder per sekund.
🔗 Versionsinformation för Devin
Gemini CLI: en nightly utan säkerhetskorrigeringar, med fokus på pseudoterminalen
19 september — Gemini CLI:s nightly-kanal publicerar klockan 03.25 version v0.62.0-nightly.20260919.gcfbcaa8df, med fem korrigeringar och inga säkerhetsändringar — ett avbrott från raden av föregående nightly-versioner. Två gäller pseudoterminalen: synkronisering av livscykeln när ConPTY-processer avslutas, Windows-implementeringen av pseudoterminalen, och därefter minneshanteringen av terminalbufferten. De tre övriga rättar mindre irritationsmoment: loggar av typen AbortError som visas när en förfrågan avbryts, terminalfokus som förloras när en jämförelseflik stängs i VS Code-tillägget samt en länk i autentiseringsdokumentationen som pekar på ett ogiltigt ankare. De offentliga kanalerna är oförändrade, med stable på v0.60.0 och preview på v0.61.0-preview.0.
🔗 Versionsinformation för nightly-versionen den 19 september
Copilot code review gör om sin sammanfattning och blir allmänt tillgänglig
18 september — GitHub gör en omarbetning av den sammanfattning som Copilot code review lämnar på en pull request allmänt tillgänglig. Sammanfattningskommentaren visar den aktuella bedömningen och granskningsinsatsens nivå samt delar upp iakttagelserna i tre grupper, var och en med allvarlighetsgrad och en länk till kommentaren i koden. Allt eftersom nya commits tillkommer bevarar sammanfattningen förloppet i stället för att skrivas om. Den automatiska lösningen, som infördes den 11 september, utökas: ett svar som ber att ett problem ska lämnas öppet respekteras, och en automatisk lösning anger sin orsak, Won’t Fix eller Incorrect — ett motiverat beslut som kan bestridas i stället för en tyst stängning.
| Grupp av iakttagelser | Innehåll |
|---|---|
| Open | Oåtgärdade problem, etiketten new om de införts genom en ny commit |
| Resolved since last review | Problem vars korrigering Copilot har verifierat |
| Previously missed | Problem som inte införts genom en ny commit och som hittats vid en senare granskning |
🔗 Copilot code review, en förbättrad granskningsupplevelse
Pika namnger applikationerna på sin nya plattform
19 september — Den 17 september tillkännagav Pika en fullständig omarbetning av sin produkt till en kreativ plattform, utan att nämna en enda funktion eller ett enda pris. Mellan kvällen den 18:e och morgonen den 19:e fyllde företaget denna lucka med en serie meddelanden där applikationerna namnges en efter en. Denna lista är inte katalogen: Pikas startsida räknar upp åtta applikationer — Video Studio, Color Grade, Extend Video, Pika Soundtrack, Edit Image, Character Studio, Image Studio och Product Shot — där varken Camera Director eller Relight Media finns med, vilket tyder på att utbudet är bredare än dessa successiva tillkännagivanden.
| Tillkännagiven applikation | Funktion som Pika beskriver |
|---|---|
| Video Studio | Video från grunden, upp till 3 minuter i flera tagningar, inklusive ljud |
| Camera Director | Återskapar en uppladdad scen från andra vinklar, med rörelser och skådespeleri bevarade |
| Relight Media | Justerar färg, intensitet och riktning för ljuset i ett klipp var för sig |
🔗 Video Studio · 🔗 Camera Director · 🔗 Relight Media
Kortnyheter
- En community-anteckning ifrågasätter oberoendet i utvärderingen som anförtrotts Accenture — ett tillägg till partnerskapet som behandlades den 18:e: anteckningen påpekar att Anthropic direkt kommer att finansiera Accentures arbete och att ett tidigare kommersiellt partnerskap redan knyter samman de två företagen, med omkring 30 000 Accenture-medarbetare utbildade i Claude. 🔗 källa
- Replit utökar sina granskningsloggar med över 65 ytterligare händelser — projekt, arbetsytor, driftsättningar, kontosäkerhet, SSO och SCIM, anslutningar, hemligheter och Agent-aktivitet, för administratörer av Enterprise-konton; varken någon detaljerad lista eller något separat tillgänglighetsdatum anges. 🔗 källa
- Qwen Code v0.24.1 gör gårdagens förhandsversion stabil — den publicerades 08:18 UTC och lägger bara till sex poster till den redan behandlade v0.24.1-preview.0: det är uppgraderingen av Playwrights webbläsar-SDK och underagenter i containrar som är nyheten, inte innehållet. 🔗 källa
- Kimi Code 2.0.2 åtgärdar fem fel — tjugotre timmar efter 2.0.1 och utan nya funktioner: meddelanden hamnar inte längre på en gammal position efter ett återupptagande, dubbletter har tagits bort och komprimeringen har reparerats efter ett modellbyte. 🔗 källa
- Att rangordna om en agents minne med Jev höjer återkallningen på första plats från 34 till 54 % — för 1 986 LoCoMo-frågor höjer omrangordningen av AtMems tio bästa kandidater MRR@5 från 0,4259 till 0,5868 utan att förändra återkallningen bland de tio bästa, som ligger kvar på 0,6495. 🔗 källa
- Layer-Feedback Transformer vinner 4,29 procentenheter vid 10 miljoner parametrar, men inte vid samma beräkningsmängd — att köra närliggande lager på nytt höjer en modell från 32,57 till 36,86 % på ett internt test, till priset av 2,64 gånger fler blockkörningar, en begränsning som författaren uttryckligen medger. 🔗 källa
- AmberTrace argumenterar för verifierbara belöningar bortom matematik och kod — en positionerande essä utan benchmark: att belöna skenet av framgång skapar en modell som optimerar skenet, och områden där ett beslut medför ansvar har förblivit utan verifierbar belöning. 🔗 källa
- Ett testprotokoll för att ta reda på om ett gammalt dokument kan upphäva en minnesuppdatering — ett föreslaget tillvägagångssätt, utan mätning: ett ersatt dokument som återkommer genom återimport med en färsk tidsstämpel blir i tysthet åter det aktuella svaret om systemet behandlar den senaste ankomsten som den mest aktuella. 🔗 källa
- Kod som gränssnitt mellan agenter och den fysiska världen — en pedagogisk sammanfattning som jämför loopen hos en kodagent med programgenerering för robotmanipulation, utan något eget tillkännagivande eller kvantifierat resultat. 🔗 källa
- Qwen vidarebefordrar en Cerebras-demonstration baserad på Qwen3.8-27B — en assistent för privatekonomi som byggts av en tredje part på Cerebras inferensplattform; ett gratulationsinlägg och inte ett produkttillkännagivande, eftersom det underliggande ämnet behandlades den 12 september. 🔗 källa
- OpenAI publicerar sin Australian Youth Safety Blueprint — en färdplan med sex pelare för att skydda unga AI-användare i Australien, från kunskap till integritetsbevarande åldersverifiering; företaget påminner om att ChatGPT for Teens har varit tillgängligt i landet sedan augusti för 13–17-åringar. 🔗 källa
- ChatGPT för iOS 1.2026.251 lägger till mappar och skrivblock — möjlighet att skapa mappar från filväljaren, skrivblock med utkastvarianter och kopieringsåtgärder samt åtta korrigeringar inriktade på worktrees och köade prompts. 🔗 källa
Vad det innebär
Dagen har en ovanlig form: laboratorierna tiger och praktikerna publicerar. Varken DeepSeek, som varit tyst i nio dagar och kontrollerats på tre oberoende ytor, eller Meta, Ai2 eller Sakana har släppt någonting. De elva fynden inom öppna modeller kommer alla från samma ställe, Hugging Faces communityblogg, och de presenterar ingen modell: de mäter. En prefixcache för fjorton dagars kundtrafik, 1 350 beslut verifierade med bevis, sex kvantiseringsnivåer, kvaliteten på en omrangordning. Dagens enda modellsläpp, Qwen3.8-LiveTranslate, är tvärtom en API-produkt utan öppna vikter. Det öppna ekosystemet producerade denna lördag inget råmaterial — det producerade mätinstrument.
Det dessa mätningar säger pekar åt samma håll, och det är mer intressant än deras mångfald. I samtliga tre fall är det avgörande kriteriet inte det man väntade sig. Modellen med mixture-of-experts som är dubbelt så snabb tappar sin plats inte på grund av hastigheten utan på grund av sitt beteende, eftersom den bara återhämtar sig från ett avvisat verktygsanrop i 1 fall av 20. Rangordningen av 19 modeller visar att skillnaden mellan aktiverat och inaktiverat resonerande i samma modell överstiger skillnaden mellan modeller av mycket olika storlek. Och att gå från 8 till 2 bitar kostar 1,3 procentenheter i exakthet utan att ändra felens riktning. Tre sätt att säga att hastighet, storlek och numerisk precision är dåliga indikatorer på vad en modell faktiskt kommer att göra i produktion, och att man måste titta någon annanstans — på hur den återhämtar sig, överväger eller lutar.
En mer diskret signal förtjänar att uppmärksammas: samma bedömningsmodell, Jev, förekommer samma dag i två orelaterade inlägg, hos Yuichi Tateno för att filtrera forskningsdokument och hos Javad Taghia för att rangordna om en agents minne, uppmätt på två olika benchmark. Två oberoende författare som använder en tredjepartsmodell som instrument samma dag är början på en gemensam byggsten. Logiken är densamma i båda fallen: att delegera till en extern bedömare, inte svaret, utan beslutet om vad som ska behållas innan svaret ges — och, hos Tateno, möjligheten att stanna när ingenting är värt att behålla.
På verktygssidan handlar förändringarna mer om kontraktet än om funktionaliteten. Claude Code 2.1.278 flyttar klassificeraren för auto mode till serversidan och slutar debitera denna merkostnad, raka motsatsen till vad 2.1.273 beslutade fyra dagar tidigare: en standardinställning har blivit en ekonomisk variabel som omprövas i denna takt. Devin slutar i sin tur att fylla i fältet total i sina granskningsloggar, och anropande kod som förlitade sig på det slutar fungera — en ändring som placerats bland ergonomiska nyheter trots att den bryter befintliga integrationer. Copilot code review lämnar slutligen förhandsversionen genom att ersätta den tysta stängningen av en kommentar med ett motiverat beslut, Won’t Fix eller Incorrect. Tre sätt för tre leverantörer att påminna om att det väsentliga i ett agentverktyg numera avgörs av dess standardvärden, prissättning och API-löften.
Källor
- Qwen, inlägg om Qwen3.8-LiveTranslate
- Alibaba Qwen på X, tillkännagivande av Qwen3.8-LiveTranslate
- Fjorton dagars agenttrafik på två RTX 5090
- AmberTrace Labs, felens riktning hos 19 öppna modeller
- AmberTrace Labs, kvantisering och säkerhetsriktning
- jev-reranker, presentation och mätningar
- Metro-ASR-Small, vad en CTC-modell med 61 miljoner parametrar lär sig
- Claude Code, versionsinformation för 2.1.278
- Claude Code-dokumentation, debitering för klassificeraren i auto mode
- Devin, versionsinformation
- Gemini CLI, nightly-versionen den 19 september
- GitHub, Copilot code review allmänt tillgänglig
- Pika på X, Camera Director
- Pika, applikationssidan