ai-powered-markdown-translatorArtykuł przetłumaczony z francuskiego na polski za pomocą gpt-5.6-sol.
W tę sobotę żadne laboratorium nie opublikowało modelu z otwartymi wagami: ani milczący od dziewięciu dni DeepSeek, ani Meta, Ai2 czy Sakana. Jedyną premierą dnia jest zamknięty model dostępny przez API, Qwen3.8-LiveTranslate, który zmniejsza opóźnienie tłumaczenia symultanicznego do 2,3 sekundy. Cała reszta pochodzi od praktyków: jedenaście wpisów na blogu społeczności Hugging Face, które nie prezentują modeli, lecz pomiary — cache prefiksów w środowisku produkcyjnym, certyfikowane decyzje, koszt kwantyzacji i jakość ponownego szeregowania.
Qwen3.8-LiveTranslate: tłumaczenie symultaniczne z opóźnieniem poniżej 2,3 sekundy
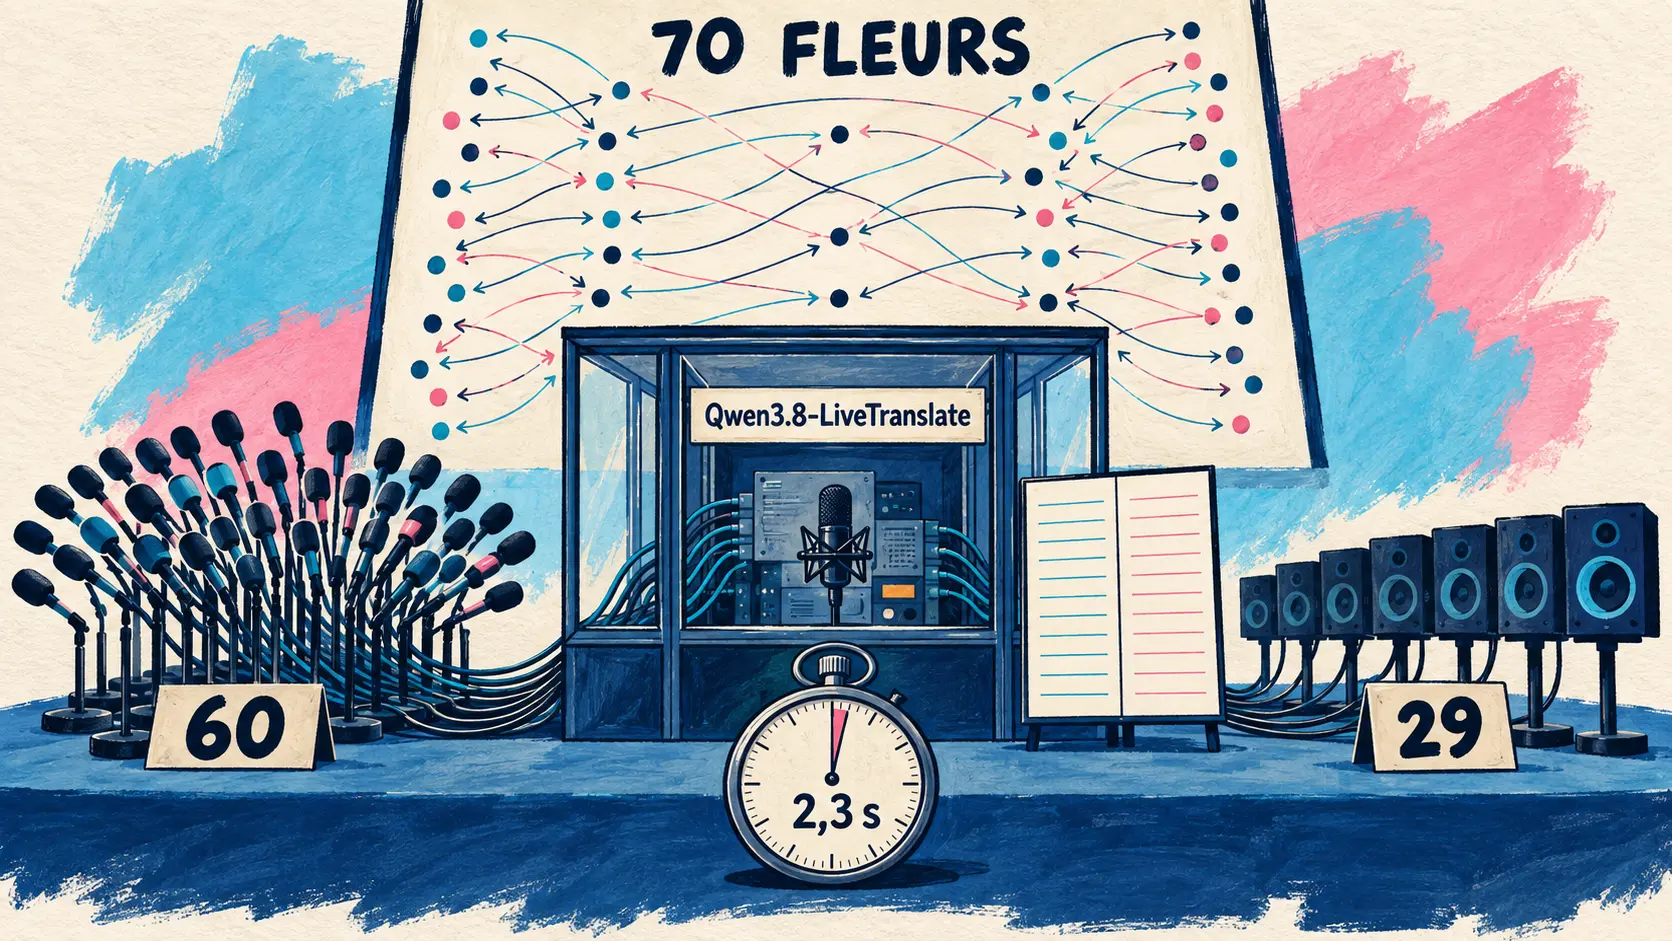
19 września — Qwen zaprezentował Qwen3.8-LiveTranslate, swój model tłumaczenia symultanicznego w czasie rzeczywistym. Architektura Interleave przetwarza dźwięk i tekst jako jeden przeplatany strumień, w którym odsłuchany już dźwięk i wygenerowane już tłumaczenie są umieszczane w cache, a następnie ponownie wykorzystywane, co zmniejsza średnie opóźnienie (average lagging, LAAL) z 2,8 do 2,3 sekundy przy jednoczesnej poprawie jakości.
Silnik jest dwumodułowym systemem Thinker-Talker opartym na hybrydowej mieszance ekspertów (Hybrid-MoE): Thinker układa obraz, dźwięk, tekst źródłowy i tłumaczenie w jedną uporządkowaną czasowo sekwencję przyczynową, po czym Talker syntetyzuje głos zachowujący barwę głosu pierwotnego mówcy. Towarzyszą temu trzy funkcje: rozdzielanie mówców w czasie rzeczywistym (real-time speaker separation), zsynchronizowany widok dwujęzyczny oraz rozstrzyganie niejednoznaczności w długim kontekście.
W kwestii obsługiwanych języków wpis i komunikat zapowiadający są rozbieżne: drugi mówi ogólnie o 60 językach, natomiast pierwszy rozróżnia 60 języków dla wejścia audio z wyjściem tekstowym, ale tylko 29 dla wyjścia audio. Za wiążące uznajemy dane z wpisu. Oceny przeprowadzono na Omnilingua-MSpeaker dla 14 kierunków językowych oraz na publicznym zbiorze FLEURS dla 70 kierunków. Model jest dostępny przez API za pośrednictwem DashScope: nie zapowiedziano udostępnienia wag.
| Mierzony element | Ogłoszona wartość |
|---|---|
| Średnie opóźnienie (LAAL) | 2,3 s wobec 2,8 s w poprzedniej generacji |
| Języki wejścia audio, wyjście tekstowe | 60 |
| Języki wyjścia audio | 29 |
| Publiczna ocena wielojęzyczna | FLEURS, 70 kierunków językowych |
| Nazwa modelu w API | qwen3.8-livetranslate-flash-realtime |
Built on an Interleave architecture, it improves faithfulness, fluency, and conciseness while reducing average lagging (LAAL) from 2.8s to 2.3s across 60 languages.
🇵🇱 Model oparty na architekturze Interleave poprawia wierność, płynność i zwięzłość, a zarazem zmniejsza średnie opóźnienie (LAAL) z 2,8 s do 2,3 s w 60 językach. — @Alibaba_Qwen na X
🔗 Wpis o Qwen3.8-LiveTranslate
Pomiar modeli otwartych: trzy badania opublikowane tego samego dnia
Trzy niezależne wpisy, opublikowane na blogu społeczności Hugging Face, mierzą ten sam przedmiot z trzech perspektyw: jak sprawdza się model otwarty w rzeczywistych warunkach.
Czternaście dni w środowisku produkcyjnym: cache prefiksów przesądza o losie modelu z 27 miliardami parametrów
19 września — Przez 13,9 dnia dwie karty GeForce RTX 5090 obsługiwały model Qwen3.8-27B skwantyzowany do NVFP4 w silniku agentowym używanym przez Scalably dla prawdziwych klientów, a każda liczba pochodziła z licznika odczytanego w punkcie dostępowym /metrics: ukończono 28 097 żądań, przetworzono 860,6 miliona tokenów wejściowych i nie odnotowano żadnego przerwania. Przy medianie długości promptów wynoszącej 6 466 tokenów i 99. percentylu na poziomie 183 800, 82,6% tokenów etapu prefill pochodzi z cache. Nex-N2.5-mini, dwukrotnie szybszy podczas dekodowania, przegrał jednak w odtwarzaniu rzeczywistych decyzji: po odrzuconym wywołaniu narzędzia odzyskuje sprawność tylko w 1 przypadku na 20, wobec 12 na 20.
The short version: on agent traffic the prefix cache decides whether a 27B model keeps up, the scheduler flags matter more than the kernels, and a faster mixture-of-experts checkpoint lost the job on behaviour, not speed.
🇵🇱 Podsumowując: w ruchu agentowym to cache prefiksów przesądza, czy model z 27 miliardami parametrów dotrzyma tempa, opcje harmonogramu mają większe znaczenie niż jądra obliczeniowe, a szybszy checkpoint oparty na mieszance ekspertów stracił miejsce przez swoje zachowanie, a nie szybkość. — pavle-scalably na blogu Hugging Face
AmberTrace ocenia 19 modeli otwartych na podstawie 1350 certyfikowanych decyzji
18 września — Gdy model decyduje o przyznaniu lub odmowie, istotne jest nie tylko to, jak często się myli, lecz także w którą stronę. AmberTrace Labs oceniło 19 modeli z otwartymi wagami na 1350 pozycjach, dla których prawidłowe działanie zostało potwierdzone dowodem. Grupowanie według rodziny mówi więcej niż ranking: modele z włączonym rozumowaniem uzyskały średnio 0,960; modele zdolne do rozumowania, lecz z wyłączoną tą opcją — 0,909; modele bez rozumowania — 0,805. Różnica między włączeniem a wyłączeniem rozumowania przewyższa różnicę między modelami o bardzo różnych rozmiarach. Jedna próbka, temperatura 0: autor otwarcie wskazuje ograniczenia badania.
| Oceniany model | Laboratorium | Wynik złożony | Dokładność | Błąd liberalny |
|---|---|---|---|---|
| Qwen3.8-27B (rozumowanie) | Alibaba | 0,974 | 95,5% | 0,0% |
| Muse-Glimmer-30B | Meta | 0,960 | 94,0% | 3,1% |
| OLMo-3-32B-Think | Ai2 | 0,947 | 93,8% | 3,3% |
| Qwen3.8-27B | Alibaba | 0,937 | 91,3% | 6,3% |
🔗 Kierunek błędu w modelach decyzyjnych z otwartymi wagami
Od 8 do 2 bitów: 1,3 punktu dokładności bez zmiany charakteru błędów
19 września — Następnego dnia AmberTrace stosuje ten sam protokół, by odpowiedzieć na pytanie: co tracimy przez kwantyzację? Qwen3.6-27B uruchomiono na sześciu poziomach GGUF, od Q8_0 do Q2_K, a następnie oceniono na tych samych 1350 pozycjach. Wynik przeczy powszechnej intuicji: dokładność spada z 90,9% przy 8 bitach do 89,6% przy 2 bitach, czyli o 1,3 punktu przy czterokrotnym zmniejszeniu precyzji numerycznej. Najciekawsza jest wartość, która się nie zmienia: obciążenie kierunkowe błędów pozostaje płaskie, ze współczynnikiem determinacji wynoszącym 0,01. Kwantyzacja zmienia liczbę błędów, ale nie ich charakter. Autor zastrzega, że to badanie wstępne.
| Kwantyzacja | Dokładność | Błąd liberalny (pasmo krytyczne) | Obciążenie kierunkowe |
|---|---|---|---|
| 8 bitów | 90,9% | 5,2% | −0,024 |
| 5 bitów | 91,3% | 4,5% | −0,029 |
| 4 bity | 90,2% | 6,3% | −0,018 |
| 2 bity | 89,6% | 6,3% | −0,024 |
🔗 Kwantyzacja a bezpieczny kierunek decyzji
jev-reranker odrzuca 92% dokumentów kandydujących, a mimo to poprawia ranking
19 września — Yuichi Tateno publikuje jev-reranker, bibliotekę Python wykorzystującą Jev, model ustrukturyzowanej oceny firmy TypeSafe.AI, do ponownego szeregowania wyników wyszukiwania, a przede wszystkim do odrzucania dokumentów, które nie pomogą w udzieleniu odpowiedzi. Argument wykracza poza oszczędność tokenów: filtrowanie daje aplikacji możliwość podjęcia decyzji przed etapem generowania. W NanoHotpotQA filtrowanie osiąga nDCG@10 na poziomie 0,975 przy zachowaniu zaledwie 7,62 dokumentu na żądanie, wobec 0,833 dla wyszukiwania hybrydowego zachowującego 100 dokumentów: największą zaletą jest właśnie redukcja kontekstu.
Najciekawsze spostrzeżenie pojawia się gdzie indziej: ten sam model oceniający występuje tego samego dnia w drugim, niezależnym wpisie, w którym Javad Taghia ponownie szereguje pamięć agenta na innym benchmarku.
| Metoda szeregowania | Próg | nDCG@10 | Dokumenty zachowane na żądanie |
|---|---|---|---|
| Wyszukiwanie hybrydowe | — | 0,833 | 100 |
| Ponowne szeregowanie | 0,0 | 0,969 | 100 |
| Filtrowanie trafności | 0,2 | 0,975 | 7,62 (odrzucono 92,38%) |
Metro-ASR-Small: 61 milionów parametrów do egipskiego języka arabskiego na procesorze laptopa
19 września — Whisper-large-v3 ma 1,5 miliarda parametrów, a OmniASR-LLM firmy Meta — 7 miliardów: oba wymagają karty graficznej. Metro-ASR-Small ma 61,6 miliona parametrów, mieści się w 235 MB i transkrybuje egipski język arabski, angielski oraz naprzemienne użycie obu języków od 33 do 66 razy szybciej niż w czasie rzeczywistym na czterech wątkach procesora — taki zakres podaje tabela, choć tekst zaokrągla go do współczynnika 50. Wpis nie jest zapowiedzią, lecz analizą: skąd bierze się dokładność przy ograniczonych danych i liczbie parametrów? W mniejszym stopniu z modelu akustycznego, niż można by sądzić. Drugim czynnikiem jest opcjonalny model językowy KenLM o rozmiarze 6,4 GB: dwadzieścia siedem razy większy od modelu akustycznego.
| Szerokość wiązki | Współczynnik błędów słów | Czas dekodowania |
|---|---|---|
| Dekodowanie zachłanne | 30,0% | 5,9 ms |
| 100 | 24,3% | 128 ms |
| 400 | 24,1% | 351 ms |
🔗 Czego może, a czego nie może nauczyć się model CTC z 61 milionami parametrów
Claude Code 2.1.278 przenosi klasyfikator trybu automatycznego z powrotem na serwer i przestaje naliczać za niego opłaty
19 września — W trybie automatycznym klasyfikator sprawdza działania wrażliwe przed ich wykonaniem; dotychczas kontrole te były wywołaniami modelu rozliczanymi za token. Serwer przeprowadza je teraz w ramach żądań sesji bez naliczania dodatkowych opłat, domyślnie w Claude API, Enterprise, Bedrock, Vertex i Foundry, z wierszem Auto mode server w /status. Uwaga na mechanizm rezerwowy: brama, która odrzuca pole safeguards, po wyświetleniu ostrzeżenia przełącza Claude Code na jego lokalny, płatny klasyfikator.
Warto odnotować ten zwrot jako taki: to dokładne przeciwieństwo wersji 2.1.273 z 15 września, która narzuciła domyślne używanie lokalnego klasyfikatora w Bedrock, Vertex i Foundry. Zmiana tam i z powrotem w ciągu czterech dni.
We’re changing auto mode to no longer charge for classifier requests in Claude Code. However, this session isn’t eligible.
🇵🇱 Zmieniamy tryb automatyczny, aby nie naliczać już opłat za żądania klasyfikatora w Claude Code. Ta sesja nie spełnia jednak warunków. — Dokumentacja Claude Code, komunikat wyświetlany przy płatnym przełączeniu awaryjnym
🔗 Informacje o wydaniu Claude Code 2.1.278
Aktualizacje narzędzi do kodowania: znikające pole API i wzmacniany pseudoterminal
Devin: Azure DevOps Server, ponowne łączenie MCP i pole total, które zwraca teraz null
18 września — Seria informacji o wydaniach opublikowana przez Cognition nie dotyczy silnika agenta, lecz administracji i połączeń korporacyjnych. Najważniejszym faktem nie jest nowa funkcja, ale niekompatybilna zmiana: na liście dzienników audytu Enterprise API pole total nie jest już wypełniane i zwraca null; paginacja musi korzystać z has_next_page i end_cursor. Każdy kod wywołujący, który polegał na tym liczniku, przestaje działać. Pozostałe zmiany są addytywne: kolekcje Azure DevOps Server 2020 i 2022 są obsługiwane za pomocą osobistego tokena dostępu, podczas gdy wcześniej obsługiwana była tylko wersja chmurowa; każdy serwer MCP otrzymuje działanie Reconnect, które ponownie przeprowadza uwierzytelnianie bez odinstalowywania; ActiveCampaign i Grafana (OAuth) trafiają do katalogu; sesje można filtrować według pochodzenia, a nagrania ekranu osiągają 60 klatek na sekundę.
Gemini CLI: wydanie nightly bez poprawki zabezpieczeń, skupione na pseudoterminalu
19 września — Kanał nightly Gemini CLI publikuje o 03:25 wersję v0.62.0-nightly.20260919.gcfbcaa8df z pięcioma poprawkami i bez żadnych zmian zabezpieczeń — co odróżnia ją od serii wcześniejszych wydań nightly. Dwie poprawki dotyczą pseudoterminalu: synchronizacji cyklu życia wyjścia procesów ConPTY, windowsowej implementacji pseudoterminalu, oraz zarządzania pamięcią bufora terminala. Pozostałe trzy usuwają niedogodności: dzienniki AbortError wyświetlane po anulowaniu żądania, utratę fokusu terminala po zamknięciu karty porównania w rozszerzeniu VS Code oraz link do dokumentacji uwierzytelniania prowadzący do nieprawidłowej kotwicy. Kanały publiczne pozostają bez zmian: stable w wersji v0.60.0, a preview w wersji v0.61.0-preview.0.
🔗 Informacje o wydaniu nightly z 19 września
Copilot code review przebudowuje podsumowanie i osiąga ogólną dostępność
18 września — GitHub udostępnia ogólnie przebudowane podsumowanie pozostawiane przez Copilot code review w pull request. Komentarz podsumowujący pokazuje bieżącą ocenę i poziom nakładu pracy podczas przeglądu oraz dzieli ustalenia na trzy grupy, każdą z określeniem wagi problemu i linkiem do komentarza w kodzie. W miarę kolejnych commitów podsumowanie zachowuje historię postępów, zamiast pisać się od nowa. Automatyczne rozwiązywanie, wprowadzone 11 września, zostaje rozszerzone: odpowiedź z prośbą o pozostawienie problemu otwartego jest respektowana, a automatyczne rozwiązanie podaje swoją przyczynę — Won’t Fix lub Incorrect — zapewniając uzasadnioną decyzję, którą można zakwestionować, zamiast cichego zamknięcia.
| Grupa ustaleń | Zawartość |
|---|---|
| Open | Nierozwiązane problemy, z etykietą new, jeśli zostały wprowadzone przez nowy commit |
| Resolved since last review | Problemy, których poprawienie Copilot zatwierdził |
| Previously missed | Problemy niewprowadzone przez nowy commit, znalezione podczas późniejszego przeglądu |
🔗 Copilot code review: ulepszony proces przeglądu
Pika nadaje nazwy aplikacjom na swojej nowej platformie
19 września — 17 września Pika ogłosiła całkowite przekształcenie swojego produktu w platformę kreatywną, nie wymieniając ani jednej funkcji ani żadnej ceny. Między wieczorem 18 września a rankiem 19 września firma wypełniła tę lukę serią wiadomości, w których kolejno nazywa poszczególne aplikacje. Ta lista nie jest katalogiem: strona główna Pika wymienia osiem aplikacji — Video Studio, Color Grade, Extend Video, Pika Soundtrack, Edit Image, Character Studio, Image Studio i Product Shot — bez Camera Director ani Relight Media, co wskazuje, że oferta jest szersza niż wynika z tych kolejnych zapowiedzi.
| Zapowiedziana aplikacja | Funkcja opisana przez Pika |
|---|---|
| Video Studio | Wideo tworzone od zera, do 3 minut w wielu ujęciach, z dźwiękiem |
| Camera Director | Ponownie generuje przesłaną scenę pod innymi kątami, zachowując ruch i grę aktorską |
| Relight Media | Pozwala oddzielnie regulować kolor, intensywność i kierunek światła w klipie |
🔗 Video Studio · 🔗 Camera Director · 🔗 Relight Media
W skrócie
- Notatka społecznościowa podważa niezależność oceny powierzonej Accenture — uzupełnienie informacji o partnerstwie opisanym 18 września: w notatce wskazano, że Anthropic będzie bezpośrednio finansować pracę Accenture, a obie firmy łączy już wcześniejsze partnerstwo handlowe, w ramach którego około 30 000 specjalistów Accenture przeszkolono w zakresie Claude. 🔗 źródło
- Replit rozszerza swoje dzienniki audytu o ponad 65 dodatkowych zdarzeń — dotyczących projektów, obszarów roboczych, wdrożeń, bezpieczeństwa konta, SSO i SCIM, konektorów, sekretów oraz aktywności Agenta, przeznaczonych dla administratorów kont Enterprise; bez szczegółowej listy ani odrębnej daty dostępności. 🔗 źródło
- Qwen Code v0.24.1 przenosi do wersji stabilnej wydanie poglądowe z poprzedniego dnia — opublikowana o 08:18 UTC wersja dodaje jedynie sześć wpisów do omówionej już v0.24.1-preview.0: wiadomością jest awans SDK przeglądarki Playwright i subagentów w kontenerach, a nie sama zawartość. 🔗 źródło
- Kimi Code 2.0.2 naprawia pięć usterek — dwadzieścia trzy godziny po wersji 2.0.1 i bez nowych funkcji: wiadomości nie trafiają już po wznowieniu do poprzedniej pozycji, usunięto duplikaty, a kompakcję naprawiono po zmianie modelu. 🔗 źródło
- Zmiana kolejności pamięci agenta za pomocą Jev zwiększa odsetek trafień na pierwszym miejscu z 34 do 54% — w przypadku 1 986 pytań LoCoMo ponowne uszeregowanie dziesięciu najlepszych kandydatów AtMem zwiększa MRR@5 z 0,4259 do 0,5868 bez zmiany odsetka trafień w pierwszej dziesiątce, który pozostał na poziomie 0,6495. 🔗 źródło
- Layer-Feedback Transformer zyskuje 4,29 punktu przy 10 milionach parametrów, ale nie przy takim samym nakładzie obliczeniowym — ponowne przetwarzanie sąsiednich warstw podnosi wynik modelu z 32,57 do 36,86% na autorskim benchmarku, kosztem 2,64 raza większej liczby wykonań bloków, co autor wyraźnie uznaje za ograniczenie. 🔗 źródło
- AmberTrace opowiada się za weryfikowalnymi nagrodami poza matematyką i kodem — esej programowy bez benchmarku: nagradzanie pozorów sukcesu prowadzi do powstania modelu, który optymalizuje te pozory, a dziedziny, w których decyzja wiąże się z odpowiedzialnością, pozostają pozbawione weryfikowalnej nagrody. 🔗 źródło
- Protokół testowy pozwalający sprawdzić, czy stary dokument może unieważnić aktualizację pamięci — propozycja procedury bez pomiarów: zastąpiony dokument, który powraca w wyniku ponownego importu ze świeżym znacznikiem czasu, po cichu ponownie staje się bieżącą odpowiedzią, jeśli system uznaje najnowszy moment pojawienia się za oznakę największej aktualności. 🔗 źródło
- Kod jako interfejs między agentami a światem fizycznym — dydaktyczne omówienie zestawiające pętlę agenta kodującego z generowaniem programów do manipulacji robotycznej, bez własnej zapowiedzi ani wyników liczbowych. 🔗 źródło
- Qwen udostępnia demonstrację Cerebras opartą na Qwen3.8-27B — asystenta finansów osobistych zbudowanego przez podmiot zewnętrzny na inferencji Cerebras; gratulacyjne udostępnienie, a nie zapowiedź produktu, ponieważ temat źródłowy omówiono już 12 września. 🔗 źródło
- OpenAI publikuje swój Australian Youth Safety Blueprint — sześciopunktową mapę drogową ochrony młodych użytkowników AI w Australii, od edukacji po chroniącą prywatność weryfikację wieku; firma przypomina, że ChatGPT for Teens jest dostępny w tym kraju od sierpnia dla osób w wieku 13–17 lat. 🔗 źródło
- ChatGPT dla iOS 1.2026.251 dodaje foldery i bloki pisania — tworzenie folderów z poziomu selektora plików, bloki pisania z wariantami wersji roboczych i opcjami kopiowania, a także osiem poprawek skupionych na worktrees i promptach umieszczonych w kolejce. 🔗 źródło
Co to oznacza
Ten dzień ma nietypowy przebieg: laboratoria milczą, a praktycy publikują. Ani DeepSeek, milczący od dziewięciu dni i sprawdzony w trzech niezależnych kanałach, ani Meta, Ai2 czy Sakana nie opublikowały niczego. Wszystkie jedenaście znalezisk z dziedziny modeli otwartych pochodzi z jednego miejsca — społecznościowego bloga Hugging Face — i żadne nie przedstawia modelu: wszystkie dokonują pomiarów. Pamięć podręczna prefiksów analizowana na podstawie czternastu dni ruchu klientów, 1 350 decyzji poświadczonych dowodem, sześć poziomów kwantyzacji, jakość ponownego uszeregowania. Jedyny wydany tego dnia model, Qwen3.8-LiveTranslate, jest natomiast produktem API bez otwartych wag. W tę sobotę otwarty ekosystem nie wytworzył surowca — wytworzył narzędzia pomiarowe.
Wnioski z tych pomiarów są zbieżne, a to ciekawsze niż ich różnorodność. We wszystkich trzech przypadkach decydujące kryterium nie jest tym, którego oczekiwano. Dwukrotnie szybszy model typu mixture-of-experts przegrywa nie ze względu na szybkość, lecz zachowanie, ponieważ po odrzuconym wywołaniu narzędzia odzyskuje sprawność tylko w 1 przypadku na 20. Ranking 19 modeli pokazuje, że różnica między włączonym a wyłączonym rozumowaniem w tym samym modelu przewyższa różnicę między modelami o bardzo odmiennych rozmiarach. Z kolei zejście z 8 do 2 bitów kosztuje 1,3 punktu dokładności, nie zmieniając kierunku błędów. To trzy sposoby wyrażenia tego samego: szybkość, rozmiar i precyzja numeryczna są słabymi wskaźnikami tego, jak model rzeczywiście zachowa się w środowisku produkcyjnym, i trzeba patrzeć gdzie indziej — na sposób, w jaki naprawia błędy, prowadzi rozumowanie lub wykazuje skłonności.
Warto odnotować bardziej dyskretny sygnał: ten sam model oceniający, Jev, pojawia się tego samego dnia w dwóch niepowiązanych wpisach — u Yuichiego Tateno do filtrowania dokumentów badawczych oraz u Javada Taghii do zmiany kolejności pamięci agenta — i jest mierzony na dwóch różnych benchmarkach. Dwóch niezależnych autorów wykorzystujących tego samego dnia zewnętrzny model jako narzędzie pomiarowe to początek wspólnego elementu infrastruktury. W obu przypadkach logika jest taka sama: powierzyć zewnętrznemu sędziemu nie udzielenie odpowiedzi, lecz decyzję o tym, co zachować przed jej udzieleniem — a u Tateno także możliwość zatrzymania się, gdy nic nie zasługuje na zachowanie.
Po stronie narzędzi zmienia się bardziej kontrakt niż funkcjonalność. Claude Code 2.1.278 przenosi klasyfikator trybu auto na stronę serwera i przestaje naliczać opłatę za ten dodatkowy koszt, dokładnie odwrotnie niż zdecydowano w wersji 2.1.273 cztery dni wcześniej: ustawienie domyślne stało się zmienną ekonomiczną, która jest korygowana w takim tempie. Devin z kolei przestaje wypełniać pole total w swoich dziennikach audytu, przez co zależny od niego kod wywołujący przestaje działać — zmianę tę umieszczono pośród ulepszeń ergonomicznych, choć psuje istniejące integracje. Copilot code review natomiast wychodzi z wersji poglądowej, zastępując ciche zamknięcie komentarza uzasadnioną decyzją: Won’t Fix lub Incorrect. Trzej dostawcy na trzy sposoby przypominają, że sedno narzędzia agentowego tkwi obecnie w jego wartościach domyślnych, sposobie naliczania opłat i zobowiązaniach dotyczących API.
Źródła
- Qwen, wpis o Qwen3.8-LiveTranslate
- Alibaba Qwen na X, zapowiedź Qwen3.8-LiveTranslate
- Czternaście dni ruchu agentów na dwóch RTX 5090
- AmberTrace Labs, kierunek błędu w 19 otwartych modelach
- AmberTrace Labs, kwantyzacja i kierunek bezpieczeństwa
- jev-reranker, prezentacja i pomiary
- Metro-ASR-Small, czego uczy się model CTC z 61 milionami parametrów
- Claude Code, informacje o wersji 2.1.278
- Dokumentacja Claude Code, naliczanie opłat za klasyfikator trybu auto
- Devin, informacje o wersji
- Gemini CLI, wydanie nightly z 19 września
- GitHub, ogólna dostępność Copilot code review
- Pika na X, Camera Director
- Pika, strona aplikacji