ai-powered-markdown-translatorArticol tradus din fr în ro cu gpt-5.6-sol.
În această sâmbătă, niciun laborator nu a publicat vreun model cu ponderi deschise: nici DeepSeek, tăcut de nouă zile, nici Meta, nici Ai2, nici Sakana. Singura lansare a zilei este un model API închis, Qwen3.8-LiveTranslate, care reduce latența interpretării simultane la 2,3 secunde. Tot restul vine de la practicieni: unsprezece articole pe blogul comunității Hugging Face, care nu prezintă modele, ci măsurători — cache de prefix în producție, decizii certificate, costul cuantizării, calitatea unei rerangări.
Qwen3.8-LiveTranslate, interpretare simultană sub pragul de 2,3 secunde
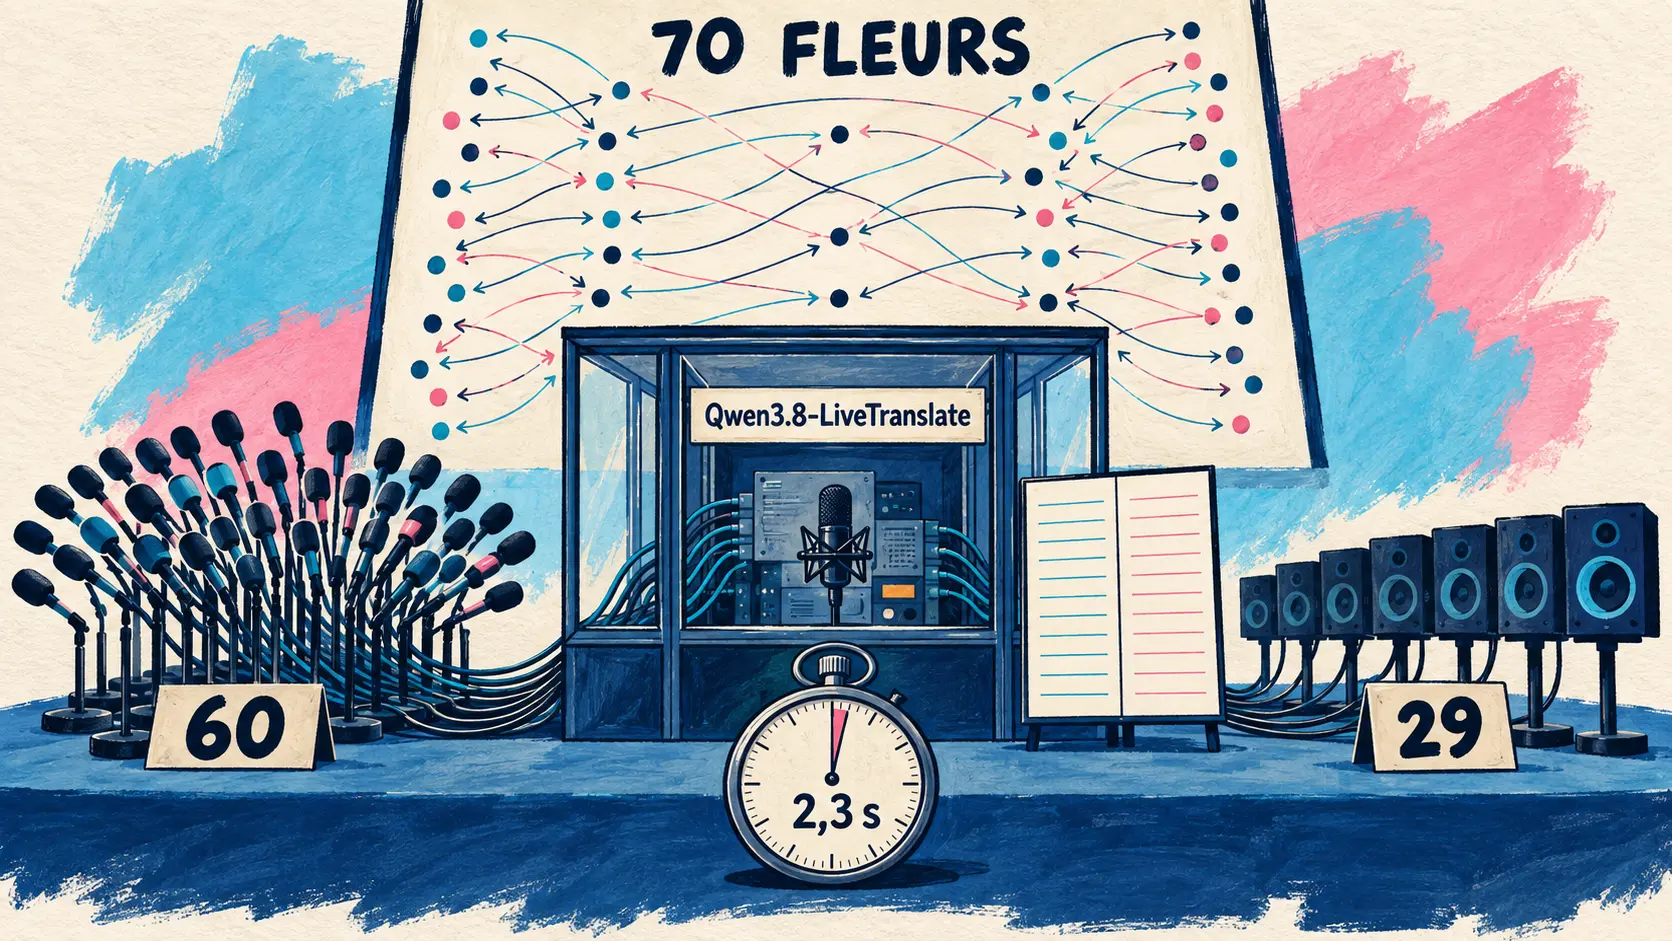
19 septembrie — Qwen a prezentat Qwen3.8-LiveTranslate, modelul său de interpretare simultană în timp real. Arhitectura Interleave tratează conținutul audio și textul ca pe un singur flux întrețesut, în care conținutul audio deja auzit și traducerea deja produsă sunt stocate în cache și apoi reutilizate, ceea ce reduce latența medie (average lagging, LAAL) de la 2,8 la 2,3 secunde, îmbunătățind totodată calitatea.
Motorul este un ansamblu cu două module Thinker-Talker, bazat pe un amestec hibrid de experți (Hybrid-MoE): Thinker așază conținutul video, audio, textul-sursă și traducerea într-o singură secvență cauzală ordonată în timp, iar Talker sintetizează apoi o voce care păstrează timbrul vorbitorului original. Este însoțit de trei capabilități: separarea vorbitorilor în timp real (real-time speaker separation), un afișaj bilingv sincronizat și dezambiguizarea în context lung.
În privința acoperirii lingvistice, articolul și mesajul de anunț diferă: cel din urmă vorbește în bloc despre 60 de limbi, iar primul distinge între 60 de limbi pentru intrarea audio cu ieșire text și numai 29 pentru ieșirea audio. Cifrele din articol sunt cele de referință. Evaluările vizează Omnilingua-MSpeaker, cu 14 direcții lingvistice, și setul public FLEURS, cu 70 de direcții. Modelul se utilizează prin API via DashScope: nu este anunțată nicio deschidere a ponderilor.
| Element măsurat | Valoare anunțată |
|---|---|
| Latență medie (LAAL) | 2,3 s, față de 2,8 s pentru generația precedentă |
| Limbi pentru intrare audio, ieșire text | 60 |
| Limbi pentru ieșire audio | 29 |
| Evaluare multilingvă publică | FLEURS, 70 de direcții lingvistice |
| Numele modelului în API | qwen3.8-livetranslate-flash-realtime |
Built on an Interleave architecture, it improves faithfulness, fluency, and conciseness while reducing average lagging (LAAL) from 2.8s to 2.3s across 60 languages.
🇷🇴 Bazat pe o arhitectură Interleave, acesta îmbunătățește fidelitatea, fluența și concizia, reducând totodată latența medie (LAAL) de la 2,8 s la 2,3 s pentru 60 de limbi. — @Alibaba_Qwen pe X
🔗 Articolul despre Qwen3.8-LiveTranslate
Măsurarea modelelor deschise: trei studii publicate în aceeași zi
Trei articole independente, toate apărute pe blogul comunității Hugging Face, măsoară același obiect din trei unghiuri: cât valorează un model deschis în condiții reale.
Paisprezece zile de producție: cache-ul de prefix decide soarta unui model de 27 de miliarde
19 septembrie — Timp de 13,9 zile, două plăci GeForce RTX 5090 au servit Qwen3.8-27B cuantizat în NVFP4 motorului de agenți pe care Scalably îl operează pentru clienți reali, fiecare cifră fiind un contor citit la endpoint-ul /metrics: 28 097 de cereri finalizate, 860,6 milioane de tokeni de intrare, zero abandonuri. Cu prompturi mediane de 6 466 de tokeni și percentila 99 la 183 800, 82,6 % dintre tokenii de preumplere provin din cache. Iar Nex-N2.5-mini, de două ori mai rapid la decodare, și-a pierdut locul într-o reluare a unor decizii reale: își revine după un apel de instrument respins în numai 1 caz din 20, față de 12 din 20.
The short version: on agent traffic the prefix cache decides whether a 27B model keeps up, the scheduler flags matter more than the kernels, and a faster mixture-of-experts checkpoint lost the job on behaviour, not speed.
🇷🇴 Pe scurt: în traficul de agenți, cache-ul de prefix decide dacă un model de 27 de miliarde poate ține ritmul, opțiunile planificatorului contează mai mult decât nucleele de calcul, iar un checkpoint mai rapid cu amestec de experți și-a pierdut locul din cauza comportamentului său, nu a vitezei. — pavle-scalably pe blogul Hugging Face
AmberTrace evaluează 19 modele deschise pe 1 350 de decizii certificate
18 septembrie — Când un model decide să aprobe sau să refuze, întrebarea nu este doar de câte ori greșește, ci și în ce sens. AmberTrace Labs a evaluat 19 modele cu ponderi deschise pe 1 350 de itemi a căror acțiune corectă era certificată printr-o dovadă. Gruparea pe familii spune mai multe decât clasamentul: raționament activat, medie de 0,960; capabile de raționament, dar cu opțiunea dezactivată, 0,909; fără raționament, 0,805. Diferența dintre activarea și dezactivarea raționamentului depășește diferența dintre dimensiuni foarte diferite. Un singur eșantion, temperatură 0: autorul își prezintă limitele.
| Model evaluat | Laborator | Scor compozit | Acuratețe | Eroare permisivă |
|---|---|---|---|---|
| Qwen3.8-27B (raționament) | Alibaba | 0,974 | 95,5 % | 0,0 % |
| Muse-Glimmer-30B | Meta | 0,960 | 94,0 % | 3,1 % |
| OLMo-3-32B-Think | Ai2 | 0,947 | 93,8 % | 3,3 % |
| Qwen3.8-27B | Alibaba | 0,937 | 91,3 % | 6,3 % |
🔗 Direcția erorii în modelele decizionale cu ponderi deschise
De la 8 la 2 biți: 1,3 puncte de acuratețe și nicio schimbare de natură
19 septembrie — A doua zi, AmberTrace aplică același protocol unei întrebări: ce se pierde prin cuantizare? Qwen3.6-27B a fost servit la șase niveluri GGUF, de la Q8_0 la Q2_K, apoi evaluat pe aceiași 1 350 de itemi. Rezultatul contrazice intuiția obișnuită: acuratețea scade de la 90,9 % la 8 biți la 89,6 % la 2 biți, adică 1,3 puncte pentru reducerea de patru ori a preciziei numerice. Cifra cea mai interesantă este cea care nu se schimbă: biasul cu semn al erorilor rămâne constant, cu un coeficient de determinare de 0,01. Cuantizarea schimbă cantitatea erorilor, nu natura lor. Este un studiu preliminar, avertizează autorul.
| Cuantizare | Acuratețe | Eroare permisivă (bandă critică) | Bias cu semn |
|---|---|---|---|
| 8 biți | 90,9 % | 5,2 % | −0,024 |
| 5 biți | 91,3 % | 4,5 % | −0,029 |
| 4 biți | 90,2 % | 6,3 % | −0,018 |
| 2 biți | 89,6 % | 6,3 % | −0,024 |
🔗 Cuantizarea și direcția siguranței deciziilor
jev-reranker elimină 92 % dintre documentele candidate și îmbunătățește totuși clasamentul
19 septembrie — Yuichi Tateno publică jev-reranker, o bibliotecă Python care se bazează pe Jev, modelul de evaluare structurată al TypeSafe.AI, pentru a reranga rezultatele căutării și, mai ales, pentru a elimina documentele care nu vor ajuta la formularea răspunsului. Argumentul depășește economisirea de tokeni: filtrarea oferă aplicației o decizie de luat înaintea generării. Pe NanoHotpotQA, filtrarea atinge 0,975 nDCG@10, păstrând numai 7,62 documente per cerere, față de 0,833 pentru căutarea hibridă, care păstrează 100: reducerea contextului este cea care prezintă interes.
Cea mai interesantă observație se află în altă parte: același model de evaluare apare în aceeași zi într-un al doilea articol independent, în care Javad Taghia reranghează memoria unui agent, pe un alt benchmark.
| Metodă de clasare | Prag | nDCG@10 | Documente păstrate per cerere |
|---|---|---|---|
| Căutare hibridă | — | 0,833 | 100 |
| Rerangare | 0,0 | 0,969 | 100 |
| Filtrarea relevanței | 0,2 | 0,975 | 7,62 (92,38 % eliminate) |
Metro-ASR-Small, 61 de milioane de parametri pentru araba egipteană pe procesorul unui laptop
19 septembrie — Whisper-large-v3 are 1,5 miliarde de parametri, iar OmniASR-LLM de la Meta are 7 miliarde: toate necesită o placă grafică. Metro-ASR-Small are 61,6 milioane, încape în 235 Mo și transcrie araba egipteană, engleza și alternarea lor de 33 până la 66 de ori mai rapid decât timpul real, pe patru fire ale procesorului — intervalul din tabel, pe care textul îl rotunjește la un factor de 50. Articolul nu este un anunț, ci o investigație: de unde provine acuratețea atunci când datele și parametrii sunt limitați? Mai puțin din modelul acustic decât s-ar crede. Al doilea factor este un cap de limbaj KenLM de 6,4 Go, opțional: de douăzeci și șapte de ori mai mare decât modelul acustic.
| Lățimea fasciculului | Rata de eroare per cuvânt | Timp de decodare |
|---|---|---|
| Decodare greedy | 30,0 % | 5,9 ms |
| 100 | 24,3 % | 128 ms |
| 400 | 24,1 % | 351 ms |
🔗 Ce poate și ce nu poate învăța un model CTC cu 61 de milioane de parametri
Claude Code 2.1.278 mută din nou clasificatorul modului auto pe server și încetează să-l taxeze
19 septembrie — În modul auto, un clasificator inspectează acțiunile sensibile înainte de executarea lor; până acum, aceste verificări erau apeluri de model taxate per token. Serverul le efectuează acum în cadrul cererilor sesiunii, fără a taxa acest cost suplimentar, în mod implicit pentru Claude API, Enterprise, Bedrock, Vertex și Foundry, cu o linie Auto mode server în /status. Atenție la fallback: un gateway care elimină câmpul safeguards face ca Claude Code să treacă la clasificatorul său local, taxat, după afișarea unei notificări.
Mișcarea merită semnalată ca atare: este exact opusul versiunii 2.1.273 din 15 septembrie, care impusese implicit clasificatorul local pe Bedrock, Vertex și Foundry. O revenire în numai patru zile.
We’re changing auto mode to no longer charge for classifier requests in Claude Code. However, this session isn’t eligible.
🇷🇴 Modificăm modul auto astfel încât cererile clasificatorului din Claude Code să nu mai fie taxate. Totuși, această sesiune nu este eligibilă. — Documentația Claude Code, notificare afișată în cazul unui fallback taxat
🔗 Notele de versiune Claude Code 2.1.278
Instrumentele de programare se actualizează: un câmp API care dispare, un pseudo-terminal care devine mai robust
Devin: Azure DevOps Server, reconectare MCP și un câmp total care returnează acum null
18 septembrie — Seria de note de versiune publicată de Cognition nu modifică motorul agentului, ci administrarea și conexiunile enterprise. Cel mai important aspect nu este o funcționalitate nouă, ci o incompatibilitate: în lista jurnalelor de audit din API-ul Enterprise, câmpul total nu mai este completat și returnează null; paginarea trebuie să folosească has_next_page și end_cursor. Orice cod apelant care se baza pe acest contor încetează să funcționeze. Restul sunt adăugiri: colecțiile Azure DevOps Server 2020 și 2022 sunt acceptate prin token de acces personal, în timp ce anterior era acceptată numai versiunea cloud; fiecare server MCP primește o acțiune Reconnect, care reia autentificarea fără dezinstalare; ActiveCampaign și Grafana (OAuth) intră în catalog; sesiunile pot fi filtrate după origine, iar înregistrările de ecran ajung la 60 de cadre pe secundă.
Gemini CLI: o versiune nightly fără remediere de securitate, axată pe pseudo-terminal
19 septembrie — Canalul nightly al Gemini CLI publică la ora 03:25 versiunea v0.62.0-nightly.20260919.gcfbcaa8df, cu cinci remedieri și nicio modificare de securitate — ceea ce întrerupe seria versiunilor nightly precedente. Două vizează pseudo-terminalul: sincronizarea ciclului de viață la ieșirea proceselor ConPTY, implementarea Windows a pseudo-terminalului, apoi gestionarea memoriei bufferului terminalului. Celelalte trei corectează inconveniente: jurnale AbortError afișate la anularea unei cereri, focusul terminalului pierdut la închiderea unei file de comparație din extensia VS Code și un link către documentația de autentificare care indica o ancoră nevalidă. Canalele publice rămân neschimbate, stable la v0.60.0 și preview la v0.61.0-preview.0.
🔗 Notele de versiune pentru nightly din 19 septembrie
Copilot code review își reproiectează raportul și devine disponibil la scară generală
18 septembrie — GitHub lansează pentru disponibilitate generală o reproiectare a raportului lăsat de Copilot code review într-un pull request. Comentariul de sinteză afișează evaluarea curentă și nivelul efortului de review și distribuie constatările în trei grupuri, fiecare având severitatea sa și un link către comentariul inline. Pe măsură ce se adaugă commituri, sinteza păstrează progresul în loc să fie rescrisă. Rezolvarea automată, introdusă pe 11 septembrie, este extinsă: un răspuns care solicită ca o problemă să rămână deschisă este respectat, iar o rezolvare automată își indică motivul, Won’t Fix sau Incorrect — o decizie motivată și contestabilă, în locul unei închideri silențioase.
| Grup de constatări | Ce conține |
|---|---|
| Open | Probleme nerezolvate, cu eticheta new dacă au fost introduse de un commit nou |
| Resolved since last review | Probleme a căror remediere a fost validată de Copilot |
| Previously missed | Probleme neintroduse de un commit nou, găsite în timpul unui review ulterior |
🔗 Copilot code review, o experiență de review îmbunătățită
Pika denumește aplicațiile noii sale platforme
19 septembrie — Pe 17 septembrie, Pika anunța refacerea completă a produsului său ca platformă creativă, fără să menționeze vreo funcționalitate sau vreun tarif. Între seara de 18 și dimineața de 19, compania a umplut acest gol printr-o serie de mesaje care denumesc aplicațiile una câte una. Această listă nu este catalogul: pagina principală Pika enumeră opt aplicații — Video Studio, Color Grade, Extend Video, Pika Soundtrack, Edit Image, Character Studio, Image Studio și Product Shot — printre care nu apar nici Camera Director, nici Relight Media, ceea ce indică faptul că oferta este mai amplă decât aceste anunțuri succesive.
| Aplicație anunțată | Funcție descrisă de Pika |
|---|---|
| Video Studio | Videoclip creat de la zero, cu o durată de până la 3 minute, în mai multe cadre, cu sunet inclus |
| Camera Director | Regenerează o scenă încărcată din alte unghiuri, păstrând mișcarea și interpretarea |
| Relight Media | Reglează separat culoarea, intensitatea și direcția luminii dintr-un clip |
🔗 Video Studio · 🔗 Camera Director · 🔗 Relight Media
Pe scurt
- O notă a comunității contestă independența evaluării încredințate companiei Accenture — completare la parteneriatul prezentat pe 18: nota arată că Anthropic va finanța direct activitatea Accenture și că un parteneriat comercial anterior leagă deja cele două companii, aproximativ 30.000 de profesioniști Accenture fiind instruiți să utilizeze Claude. 🔗 sursă
- Replit își extinde jurnalele de audit cu peste 65 de evenimente suplimentare — proiecte, spații de lucru, implementări, securitatea contului, SSO și SCIM, conectori, secrete și activitatea Agentului, pentru administratorii conturilor Enterprise; fără o listă detaliată sau o dată de disponibilitate distinctă. 🔗 sursă
- Qwen Code v0.24.1 trece la versiunea stabilă previzualizarea din ziua precedentă — publicată la 08:18 UTC, aceasta adaugă doar șase intrări la v0.24.1-preview.0, deja prezentată: noutatea este promovarea SDK-ului pentru browser Playwright și a subagenților din containere, nu conținutul. 🔗 sursă
- Kimi Code 2.0.2 corectează cinci defecte — la douăzeci și trei de ore după 2.0.1 și fără funcții noi: mesajele nu mai ajung într-o poziție veche după o reluare, duplicatele au fost eliminate, iar compactarea a fost reparată după schimbarea modelului. 🔗 sursă
- Reordonarea memoriei unui agent cu Jev crește rata de regăsire pe primul loc de la 34 la 54% — pentru 1.986 de întrebări LoCoMo, reordonarea celor mai buni zece candidați ai AtMem crește MRR@5 de la 0,4259 la 0,5868 fără a modifica rata de regăsire în primele zece poziții, care a rămas la 0,6495. 🔗 sursă
- Layer-Feedback Transformer câștigă 4,29 puncte la 10 milioane de parametri, dar nu la același volum de calcul — reluarea straturilor învecinate crește performanța unui model de la 32,57 la 36,86% pe un benchmark intern, cu prețul unui număr de 2,64 ori mai mare de execuții ale blocurilor, limită pe care autorul o recunoaște explicit. 🔗 sursă
- AmberTrace pledează pentru recompense verificabile dincolo de matematică și cod — eseu de poziționare fără benchmark: recompensarea aparenței succesului produce un model care optimizează aparența, iar domeniile în care o decizie implică o responsabilitate au rămas lipsite de recompense verificabile. 🔗 sursă
- Un protocol de testare pentru a afla dacă un document vechi poate anula o actualizare a memoriei — propunere de procedură, fără măsurători: un document înlocuit care revine prin reimportare cu un marcaj temporal recent redevine în mod silențios răspunsul curent dacă sistemul tratează cea mai recentă sosire drept cea mai actuală. 🔗 sursă
- Codul ca interfață între agenți și lumea fizică — sinteză pedagogică ce apropie bucla unui agent de cod de generarea programelor pentru manipularea robotică, fără un anunț sau rezultate numerice proprii. 🔗 sursă
- Qwen redistribuie o demonstrație Cerebras bazată pe Qwen3.8-27B — un asistent pentru finanțe personale construit de un terț pe inferența Cerebras; o redistribuire cu felicitări, nu un anunț de produs, subiectul de bază fiind prezentat pe 12 septembrie. 🔗 sursă
- OpenAI își publică Australian Youth Safety Blueprint — o foaie de parcurs cu șase piloni pentru protejarea tinerilor utilizatori de AI din Australia, de la alfabetizare la verificarea vârstei care respectă viața privată; compania reamintește lansarea ChatGPT for Teens în țară începând din august pentru persoanele cu vârste între 13 și 17 ani. 🔗 sursă
- ChatGPT pentru iOS 1.2026.251 adaugă dosare și blocuri de scriere — crearea dosarelor din selectorul de fișiere, blocuri de scriere cu variante de ciornă și acțiuni de copiere, plus opt remedieri axate pe worktrees și prompturile puse în coadă. 🔗 sursă
Ce înseamnă acest lucru
Ziua are o formă neobișnuită: laboratoarele tac, iar practicienii publică. Nici DeepSeek, tăcut de nouă zile și verificat pe trei suprafețe independente, nici Meta, nici Ai2 și nici Sakana nu au lansat nimic. Toate cele unsprezece descoperiri din domeniul modelelor deschise provin din același loc, blogul comunității Hugging Face, și nu prezintă niciun model: ele măsoară. Un cache de prefix pe parcursul a paisprezece zile de trafic al clienților, 1.350 de decizii certificate printr-o dovadă, șase niveluri de cuantizare, calitatea unei reordonări. Singura lansare de model a zilei, Qwen3.8-LiveTranslate, este, dimpotrivă, un produs API fără ponderi deschise. Ecosistemul deschis, în această sâmbătă, nu a produs materie primă — a produs instrumente de măsură.
Concluziile acestor măsurători converg, iar acest lucru este mai interesant decât diversitatea lor. În toate cele trei cazuri, criteriul decisiv nu este cel așteptat. Modelul mixture-of-experts de două ori mai rapid își pierde locul nu din cauza vitezei, ci a comportamentului său, deoarece își revine după un apel de instrument respins doar într-un caz din 20. Clasamentul celor 19 modele arată că diferența dintre raționarea activată și cea dezactivată pe același model depășește diferența dintre dimensiuni foarte diferite. Iar reducerea de la 8 la 2 biți costă 1,3 puncte de acuratețe fără să schimbe direcția erorilor. Trei moduri de a spune că viteza, dimensiunea și precizia numerică sunt predictori slabi pentru ceea ce va face efectiv un model în producție și că trebuie privit în altă parte — la felul în care se redresează, deliberează sau manifestă o înclinație.
Un semnal mai discret merită remarcat: același model de evaluare, Jev, apare în aceeași zi în două articole fără legătură între ele, la Yuichi Tateno pentru filtrarea documentelor de cercetare și la Javad Taghia pentru reordonarea memoriei unui agent, măsurată pe două benchmarkuri diferite. Doi autori independenți care instrumentează în aceeași zi un model terț reprezintă începutul unei componente comune. Logica este aceeași în ambele cazuri: delegarea către un evaluator extern nu a răspunsului, ci a deciziei privind ce se păstrează înainte de a răspunde — și, în cazul lui Tateno, posibilitatea de a se opri atunci când nimic nu merită păstrat.
În privința instrumentelor, schimbarea ține mai mult de contract decât de funcționalitate. Claude Code 2.1.278 mută clasificatorul modului auto pe partea de server și încetează să mai taxeze acest cost suplimentar, exact invers față de ceea ce decisese 2.1.273 cu patru zile mai devreme: o setare implicită a devenit o variabilă economică, revizuită cu această rapiditate. Devin, la rândul său, nu mai completează câmpul total din jurnalele sale de audit, iar codul apelant care se baza pe acesta se oprește — o schimbare plasată printre noutăți ergonomice, deși întrerupe integrări existente. În cele din urmă, Copilot code review iese din previzualizare înlocuind închiderea tăcută a unui comentariu cu o decizie motivată, Won’t Fix sau Incorrect. Trei moduri prin care trei furnizori ne reamintesc că esențialul unui instrument pentru agenți se află acum în valorile sale implicite, în tarifare și în promisiunile API-ului său.
Surse
- Qwen, articol despre Qwen3.8-LiveTranslate
- Alibaba Qwen pe X, anunțul Qwen3.8-LiveTranslate
- Paisprezece zile de trafic al agenților pe două RTX 5090
- AmberTrace Labs, direcția erorii la 19 modele deschise
- AmberTrace Labs, cuantizarea și direcția siguranței
- jev-reranker, prezentare și măsurători
- Metro-ASR-Small, ce învață un model CTC cu 61 de milioane de parametri
- Claude Code, notele versiunii 2.1.278
- Documentația Claude Code, tarifarea clasificatorului modului auto
- Devin, note de versiune
- Gemini CLI, versiunea nightly din 19 septembrie
- GitHub, disponibilitatea generală a Copilot code review
- Pika pe X, Camera Director
- Pika, pagina aplicațiilor