ai-powered-markdown-translatorgpt-6.1-sol का उपयोग करके फ़्रेंच से हिंदी में अनुवादित लेख।
Google DeepMind ने AlphaGenome 2 पेश किया है, जो किसी विशिष्ट प्रकार की कोशिका में ADN के उत्परिवर्तन के प्रभाव का पूर्वानुमान लगाता है। साथ ही उसने AlphaProof Code भी पेश किया है, जिसने चार सप्ताह में Signal प्रोटोकॉल के प्रमुख सुरक्षा गुणों को कंपाइल किए गए कोड तक सिद्ध किया है। Qwen ने Qwen4-Max के पूर्वावलोकन के साथ Qwen4 पीढ़ी की शुरुआत की है, लेकिन कोई बेंचमार्क या तकनीकी विवरणपत्र जारी नहीं किया है। Runway ने अपने रोबोटिक मॉडल Praxis-1 के वज़न Apache 2.0 के तहत प्रकाशित किए हैं, और ElevenLabs न्यूयॉर्क में अपना Summit आयोजित कर रहा है। सुरक्षा के मोर्चे पर, OpenAI ने पाया है कि उसके मॉडलों की तर्क प्रक्रिया की निगरानी कठिन होती जा रही है, और Perplexity अपने सैंडबॉक्स SPACE में बारह मॉडलों की परीक्षा ले रहा है।
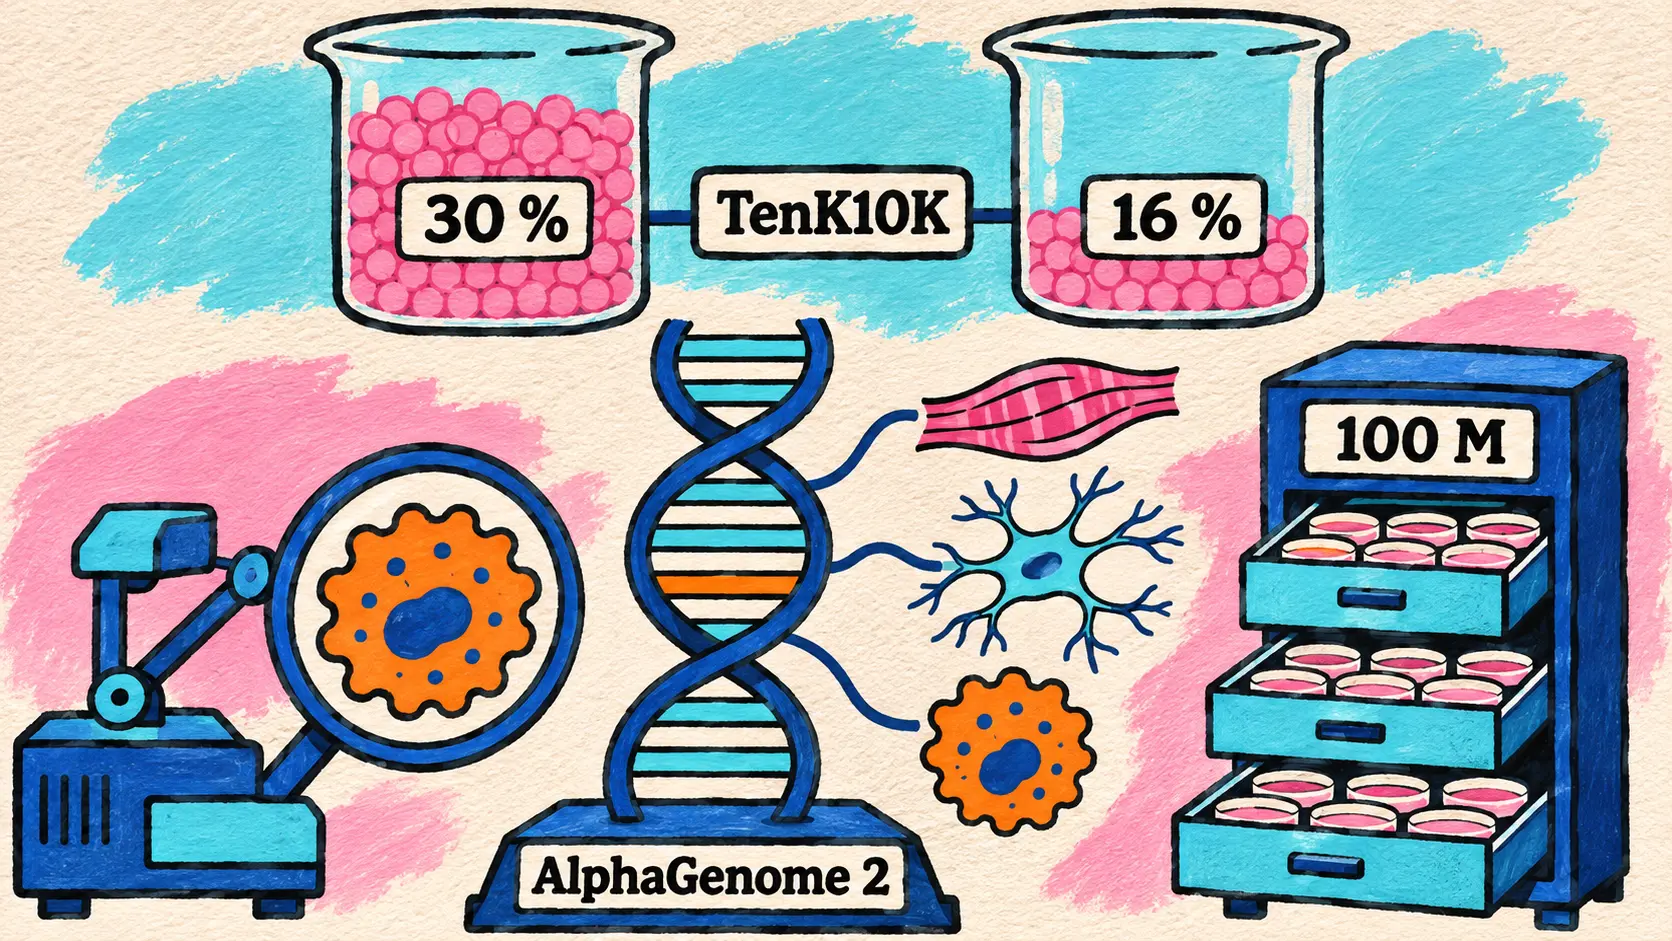
AlphaGenome 2 कोशिका के प्रकार के अनुसार ADN वेरिएंट के प्रभाव का पूर्वानुमान लगाता है और 16 % के मुकाबले 30 % कारक वेरिएंट खोजता है
11 नवंबर — Google DeepMind ने अपने ADN अनुक्रम मॉडल की नई पीढ़ी AlphaGenome 2 पेश की है। इससे पहले पिछले साल पहला AlphaGenome और सितंबर में AlphaGenome Atlas पेश किया गया था। बदलाव को एक शब्द में कहा जा सकता है: मॉडल अब सशर्त हो गया है। पहला AlphaGenome ऊतकों और कोशिका वंशों के लिए निश्चित पूर्वानुमान देता था; AlphaGenome 2 को दस लाख अक्षरों के अनुक्रम के साथ लक्षित जैविक स्थिति भी दी जाती है—कोई ऊतक, कोशिका का प्रकार या उसकी अवस्था। यह स्थिति किसी संदर्भ सूची से चुनी जा सकती है या किसी प्रयोगशाला के एकल कोशिका (single-cell) डेटा से तैयार की जा सकती है।
Your heart, brain, and immune system share the same DNA sequence. So how can a single-letter change affect disease in some cells, while sparing the rest? AlphaGenome 2 is our new AI model that zooms in on specific cells to help scientists understand what drives disease.
🇮🇳 आपका हृदय, मस्तिष्क और प्रतिरक्षा तंत्र एक ही ADN अनुक्रम साझा करते हैं। फिर केवल एक अक्षर का बदलाव कुछ कोशिकाओं में किसी बीमारी को कैसे प्रभावित कर सकता है, जबकि दूसरी कोशिकाओं को उससे कोई असर नहीं होता? AlphaGenome 2 हमारा नया एआई मॉडल है, जो विशिष्ट कोशिकाओं पर ध्यान केंद्रित करके वैज्ञानिकों को यह समझने में मदद करता है कि बीमारियाँ किस वजह से होती हैं। — X पर @GoogleDeepMind
Google DeepMind के अनुसार, मॉडल को 68 ऊतकों को समेटने वाली 100 मिलियन से अधिक कोशिका प्रोफ़ाइलों पर प्रशिक्षित किया गया है। यह पिछले सर्वश्रेष्ठ मॉडल के मुकाबले जीन की अभिव्यक्ति बदलने वाले लगभग दोगुने वेरिएंट की पहचान करता है। इसमें एक बहुप्रतीक्षित आउटपुट, ADN मिथाइलेशन, जोड़ा गया है और यह एक माप के आधार पर अनुपलब्ध दूसरा माप भी निकाल सकता है। यह दोबारा प्रशिक्षण के बिना कुछ दर्जन कोशिकाओं से वर्णित नई कोशिकीय अवस्था के अनुकूल भी हो जाता है, जैसे COVID-19 के विरुद्ध ARNm टीकाकरण के बाद सक्रिय हुए T लिम्फोसाइट।
| TenK10K पर माप (प्रतिरक्षा कोशिकाओं के 28 प्रकार) | AlphaGenome 2 | परिष्कृत AlphaGenome और अन्य विशिष्ट उपकरण |
|---|---|---|
| खोजे गए कारक वेरिएंट | 30 % | 16 % |
| जीन पर दिशात्मक प्रभाव | 43 % | 23 % |
मॉडल ने गणना के माध्यम से उस तंत्र को भी पुनः प्रस्तुत किया है, जिसका हाल ही में आंत के दीर्घकालिक सूजन संबंधी रोगों में वर्णन किया गया था: दूर स्थित एक नियामक स्विच में मौजूद वेरिएंट, जो आंत के मैक्रोफ़ेज में ETS2 जीन को अत्यधिक सक्रिय कर देता है।
AlphaGenome 2 आज से गैर-व्यावसायिक शोध के लिए AlphaGenome API और Colab ट्यूटोरियल के माध्यम से उपलब्ध है। व्यावसायिक शोध के लिए इसका निजी पूर्वावलोकन उपलब्ध है। AlphaGenome 2 Skills « जल्द ही » Antigravity में आएँगे, और उपयोग के उदाहरण आमंत्रित करने की प्रक्रिया 30 नवंबर तक खुली है। यह उपकरण केवल शोध के लिए है: चिकित्सकीय उपयोग या निदान के लिए नहीं।
🔗 AlphaGenome 2 (Google DeepMind)
AlphaProof Code: Google DeepMind ने चार सप्ताह में Signal प्रोटोकॉल के प्रमुख सुरक्षा गुणों को कंपाइल किए गए कोड तक सिद्ध किया
10 नवंबर — Google DeepMind ने औपचारिक सत्यापन के लिए एजेंट आधारित ढाँचा AlphaProof Code पेश किया, जिसकी जानकारी 11 नवंबर को X पर भी साझा की गई। इसका पहला लक्ष्य एक आदर्श उदाहरण है: Signal का एन्क्रिप्शन प्रोटोकॉल, जो लेख के अनुसार Google Messages की बातचीत को भी सुरक्षित रखता है। किसी प्रोग्राम का औपचारिक सत्यापन करने का अर्थ है गणितीय रूप से यह सिद्ध करना कि वह अपने सुरक्षा गुणों का पालन करता है। यह उपलब्ध सबसे मज़बूत गारंटी है, लेकिन इसे मानवीय प्रयास से हासिल करने में बहुत समय और खर्च लगता है।
| कार्य का चरण | किसने पूरा किया | प्रकाशित आँकड़ा |
|---|---|---|
| Signal के उद्देश्यों को विनिर्देशों में बदलना | कई मॉडलों की सहायता से शोधकर्ताओं ने | सभी विनिर्देशों की समीक्षा की गई |
| Lean भाषा में प्रमाण लिखना | Gemini Carbon से संचालित एजेंटों ने | 6 मिलियन से अधिक पंक्तियाँ |
| प्रमाण की समीक्षा करना और संवेदनशील हिस्सों को चिह्नित करना | पहले एजेंटों ने, फिर मानव विशेषज्ञों ने | कोडबेस का लगभग 1 % |
| उपकरणों पर चलने वाले कोड तक प्रमाण को ले जाना | शोधकर्ताओं और एजेंटों ने | 4 सप्ताह |
अंतर प्रमाण के स्तर में है। प्रोटोकॉल के अधिकांश सत्यापन उनकी रूपरेखा तक सीमित रहते हैं; यहाँ प्रमुख गुणों को कंपाइल किए गए कोड पर सिद्ध किया गया है, जैसे किसी उपकरण की सुरक्षा अस्थायी रूप से भंग होने से पहले और बाद में संदेशों की सुरक्षा। यह सुनिश्चित करने के लिए कि उपकरण सुरक्षित और त्रुटिपूर्ण कोड में अंतर कर पाता है, टीम ने कोड की एक अलग रखी गई प्रति में दो पुराने वास्तविक बग दोबारा डाले, जिन्हें पहले ही ठीक किया जा चुका था। दोनों मामलों में प्रणाली ने मशीन द्वारा सत्यापित प्रमाण तैयार किया कि बग वाला संस्करण सुरक्षित नहीं था।
Google DeepMind के अनुसार, यह पहली बार है जब एआई ने इतने व्यापक रूप से इस्तेमाल होने वाले किसी क्रिप्टोग्राफ़िक प्रोटोकॉल का इस गहराई तक औपचारिक सत्यापन किया है। साथ ही, एआई के साथ या उसके बिना, यह पहली बार है जब इतने प्रचलित किसी प्रोटोकॉल के कार्यान्वयन का औपचारिक सत्यापन हुआ है। प्रयोगशाला का अनुमान है कि अब तक इस तरह के काम में विशेषज्ञ टीमों को वर्षों लगते थे। सत्यापन की सामग्री एक तकनीकी लेख के साथ ओपन सोर्स में प्रकाशित की गई है। यह काम 6 नवंबर के उस काम के बाद आया है, जिसमें Google DeepMind के एजेंटों ने 1024 बिट RSA की दो कमज़ोरियाँ खोजी थीं।
Using AI agents to translate live code into valid Lean theorems is a major breakthrough.
🇮🇳 उत्पादन में चल रहे कोड को वैध Lean प्रमेयों में बदलने के लिए एआई एजेंटों का उपयोग करना एक बड़ी उपलब्धि है। — एहरेन क्रेट, Signal के मुख्य तकनीकी अधिकारी
🔗 AlphaProof Code का परिचय (Google DeepMind) · तकनीकी लेख (PDF)
Qwen4-Max का पूर्वावलोकन: Qwen ने एक ही ट्वीट से Qwen4 पीढ़ी की शुरुआत की, बिना बेंचमार्क या तकनीकी विवरणपत्र के
11 नवंबर — Qwen ने @Alibaba_Qwen खाते पर पिन किए गए एक ट्वीट से Qwen4 पीढ़ी की शुरुआत की। इस ट्वीट को उसी दिन दस लाख से अधिक बार देखा गया। पहला उपलब्ध मॉडल Qwen4-Max है, जिसका पूर्वावलोकन Alibaba के Token Plan पर उपलब्ध है। यह QwenCloud की सदस्यता योजना है, जिसमें कई मॉडल एक ही कोटे के अंतर्गत आते हैं। शुरुआती पहुँच QwenWork, कोडिंग परिवेश Qoder, Qwen ऐप और QwenStudio के माध्यम से भी मिलती है।
Qwen4 is coming. Deeper knowledge. Richer world understanding. Stronger coding and agentic capabilities. Built for real-world tasks — from complex coding and knowledge work to front-end builds and professional software workflows.
🇮🇳 Qwen4 आ रहा है। अधिक गहन ज्ञान। दुनिया की अधिक समृद्ध समझ। कोड लिखने और एजेंट के रूप में काम करने की अधिक मज़बूत क्षमताएँ। वास्तविक कार्यों के लिए तैयार किया गया है, जिनमें जटिल कोड और ज्ञान आधारित काम से लेकर front-end इंटरफ़ेस बनाना और पेशेवर सॉफ़्टवेयर कार्यप्रवाह शामिल हैं। — X पर @Alibaba_Qwen
घोषणा में बस इतनी ही जानकारी दी गई है। नीचे दी गई तालिका में प्रकाशित और अप्रकाशित जानकारी का विवरण है।
| घोषणा का तत्व | 11 नवंबर की स्थिति |
|---|---|
| Token Plan पर पहचानकर्ता | qwen4-max-preview |
| बताई गई क्षमताएँ | पाठ तैयार करना, तर्क करना, दृश्य समझ |
| मॉडल तक पहुँच | Token Plan पर पूर्वावलोकन, QwenWork, Qoder, Qwen APP और QwenStudio में शुरुआती पहुँच |
| दिखाई गई छूट | अस्थायी रूप से 80 % की छूट, यह बताए बिना कि यह किस पर लागू होती है |
| बेंचमार्क, पैरामीटर की संख्या, संदर्भ का आकार | प्रकाशित नहीं किए गए |
| API की कीमतें, खुले वज़न, ब्लॉग लेख | प्रकाशित नहीं किए गए |
Qwen ने Qwen3.8 वाला क्रम दोहराया है: 19 जुलाई को Token Plan और Qoder में Max का पूर्वावलोकन, फिर 3 अगस्त को पूर्ण लॉन्च। घोषणा से पहले @Alibaba_Qwen ने 6 नवंबर को एक टीज़र प्रकाशित किया था, जिसमें किसी मॉडल का नाम नहीं बताया गया था।
🔗 Token Plan का पृष्ठ (QwenCloud)
Runway ने Apache 2.0 के तहत Praxis-1 के खुले वज़न जारी किए, RoboLab-120 पर वर्ल्ड ऐक्शन मॉडलों में सबसे आगे
11 नवंबर — Runway ने 30 सितंबर को किया अपना वादा पूरा किया है: रोबोटिक्स के लिए उसके वर्ल्ड ऐक्शन मॉडल (world action model) Praxis-1 के वज़न Apache 2.0 लाइसेंस के तहत खुले रूप में प्रकाशित किए गए हैं। इसमें व्यावसायिक उपयोग की अनुमति भी शामिल है। लाइसेंस में वज़न, इन्फ़रेंस कोड और पूर्ण या LoRA परिष्करण का कोड शामिल हैं। तीन चेकपॉइंट (base, DROID और YAM) Hugging Face पर और कोड GitHub पर उपलब्ध हैं; LeRobot में इसका अंतर्निहित समर्थन है, vLLM-Omni इसे सेवा के रूप में उपलब्ध कराता है, और Reactor होस्ट की गई इन्फ़रेंस सेवा प्रदान करता है।
Praxis-1 का आधार Runway का वीडियो मॉडल है: विशेषज्ञों के मिश्रण वाला एक डिफ़्यूज़न ट्रांसफ़ॉर्मर, जिसमें कुल 27,2B पैरामीटर हैं। इसका वीडियो हिस्सा 26,9B पैरामीटर का है, जिनमें से लगभग 2,8B प्रति टोकन सक्रिय होते हैं, और एक « ऐक्शन विशेषज्ञ » 314M पैरामीटर का है। हर कॉल पर यह अगली छवि और वहाँ तक पहुँचाने वाली गति, दोनों का पूर्वानुमान लगाता है। यानी H100 पर 1,6 सेकंड की क्रियाओं की गणना 0,55 से 0,6 सेकंड में हो जाती है। bf16 में इसका आकार 54,4 Go है और यह 80 Go वाले GPU में समा जाता है।
NVIDIA के सिमुलेशन परीक्षण मंच RoboLab-120 (120 कार्य, 1 200 एपिसोड) पर DROID से परिष्कृत संस्करण 46,2 % एपिसोड सफलतापूर्वक पूरा करता है। यह वर्ल्ड ऐक्शन मॉडलों और ओपन सोर्स रोबोटिक मॉडलों का सर्वश्रेष्ठ स्कोर है, लेकिन तकनीकी रिपोर्ट के अनुसार चार प्रविष्टियाँ इससे बेहतर हैं: AMP1, जो एक अग्रणी मॉडल पर बना ज़ीरो-शॉट एजेंट है; SenseNova-RoboRSI, जो एक अग्रणी दृष्टि-भाषा मॉडल को नीति के रूप में इस्तेमाल करता है; और दो बंद मॉडल, Lakeside तथा BiMind v0.5।
| RoboLab-120 रैंकिंग की प्रविष्टि | सफलता दर |
|---|---|
| AMP1 | 86,0 % |
| SenseNova-RoboRSI | 57,1 % |
| Lakeside | 51,0 % |
| BiMind v0.5 | 49,2 % |
| Praxis-1 (DROID पर परिष्कृत) | 46,2 % |
| FLUX 3 Action | 42,9 % |
| Atomic-WAM | 39,6 % |
| OASIS WAM | 39,0 % |
| Cosmos 3 Nano | 36,8 % |
| π0.5 | 28,0 % |
Google RT-1 पर परिष्कृत किए जाने के बाद, जो एक ऐसा रोबोट है जिसका डेटा इसके प्रशिक्षण में शामिल नहीं था, Praxis-1 ने SimplerEnv पर 80,0 % हासिल किया, जबकि मूल RT-1 नीति का परिणाम 52,4 % था। उसी दो भुजाओं वाले स्टेशन और तीन कार्यों पर GPT-6 Astra के मुकाबले यह औसतन 15,6 गुना तेज़ी से काम पूरा करता है और प्रत्येक सफल कार्य की लागत 51 गुना कम होती है (0,04 बनाम 1,87 डॉलर, H100 की 3,95 डॉलर प्रति घंटे की लागत के आधार पर); फिर भी रिपोर्ट दोनों तरीकों को एक-दूसरे का पूरक बताती है। NVFP4 प्रारूप के लिए प्रशिक्षित दो संस्करण (DROID और YAM) भी ऑनलाइन उपलब्ध हैं: bf16 में डाउनलोड किए जाने पर उनका आकार 54,4 Go होता है, लेकिन लोड करते समय उनके विशेषज्ञों को परिवर्तित करने के बाद वे मेमोरी में 17,5 Go तक सिमट जाते हैं। यह अभी एक प्रायोगिक मोड है, जो केवल RTX 5090 और RTX PRO 6000 Blackwell के लिए उपलब्ध है।
🔗 Praxis-1 अब उपलब्ध है (Runway) · तकनीकी रिपोर्ट · Hugging Face संग्रह
न्यूयॉर्क में ElevenLabs शिखर सम्मेलन : Marketplace, Partner Program और ElevenAI उपलब्ध, Interaction Engine, Memory और Routines की घोषणा
11 नवंबर — न्यूयॉर्क के शिखर सम्मेलन में ElevenLabs ने उस अवधारणा से जुड़ी कई घोषणाएँ कीं जिसे वह एआई की संवाद परत (एआई के लिए इंटरैक्शन लेयर) कहती है। इनमें से कुछ सुविधाएँ आज से उपलब्ध हैं; बाकी आने वाले महीनों या अगले साल के लिए घोषित की गई हैं।
| शिखर सम्मेलन की घोषणा | 11 नवंबर तक उपलब्धता |
|---|---|
| ElevenLabs Marketplace (उद्योग के अनुसार एजेंट और ऐप्लिकेशन) | Salesforce, IBM, NiCE, Twilio और Zendesk के साथ शुरू; अगले साल ElevenLabs की व्यय प्रतिबद्धता के तहत खरीदारी |
| ElevenLabs Partner Program | शुरू : 44 देशों में 550 से अधिक साझेदार, McKinsey और QuantumBlack के साथ गठजोड़ |
| ElevenAI (Scribe v3 पर आधारित डिक्टेशन और बैठक के नोट्स) | मुफ़्त शुरुआती पहुँच |
| Interaction Engine | पूर्वावलोकन |
| ElevenAgents में Memory और Routines | घोषित |
| वॉइस मॉडल और ओपन सोर्स LLM का परिष्करण | « आने वाले महीनों में » |
ElevenAI किसी भी ऐप्लिकेशन में बोलकर लिखने देता है और रिकॉर्ड किए जा रहे लोगों को सूचित करके तथा उनकी सहमति लेकर बैठक के नोट्स तैयार करता है, फिर हर प्रतिभागी को सारांश और उसके ज़िम्मे आए काम देता है। एजेंटों के लिए Interaction Engine बोलने की बारी और बीच में टोके जाने को संभालता है तथा हर चरण में LLM चुनता है: शुरुआती छँटाई के लिए किफ़ायती मॉडल और पैसे लौटाने जैसे जटिल मामले के लिए अत्याधुनिक मॉडल। Memory का उद्देश्य एजेंट को प्रमाणित ग्राहक और बातचीत के दौरान सहज रूप से दी गई जानकारियाँ याद रखने देना है; Routines का उद्देश्य बातचीत से पहले, उसके दौरान और उसके बाद के काम को स्वचालित करना है। कंपनियाँ अपने डेटा पर ElevenLabs के वाणी संश्लेषण और प्रतिलेखन मॉडलों के साथ-साथ ओपन सोर्स LLM का भी परिष्करण कर सकेंगी। स्वास्थ्य सेवाओं के लिए प्रतिलेखन मॉडल Scribe v3 Medical का उल्लेख किया गया है, लेकिन कोई तारीख नहीं दी गई है।
कंपनी ने कुछ आँकड़े भी दिए: उसके राजस्व का 55 % से अधिक हिस्सा कंपनियों से आता है, और Fortune 500 की लगभग 70 % कंपनियों के कर्मचारी उसके मंच का उपयोग करते हैं। बताए गए ग्राहकों में Yahoo Scout शामिल है, जो ElevenAgents की मदद से बोलता है और 3 अरब से अधिक जवाब देने के बाद बीटा से बाहर आ रहा है।
🔗 ElevenLabs का न्यूयॉर्क शिखर सम्मेलन (ElevenLabs) · @ElevenLabs की पोस्ट शृंखला
ElevenLabs और NVIDIA : ElevenAgents में Nemotron 3.5 Super VL, Vera Rubin की 15 MW क्षमता जोड़ने की योजना और पोलैंड की ई-स्वास्थ्य सेवा के लिए वॉइस एजेंट
11 नवंबर — शिखर सम्मेलन के दौरान घोषित NVIDIA के साथ साझेदारी के विस्तार के तीन पहलू हैं। मॉडलों के मोर्चे पर, Nemotron 3.5 Super VL ElevenAgents में उपलब्ध है। ग्राहक सहायता के वास्तविक कामों पर आधारित ElevenAgents के बेंचमार्क में ElevenLabs के अनुसार यह दूसरे प्रमुख खुले मॉडलों के मुकाबले पूरी प्रक्रिया में अग्रणी सटीकता देता है, जबकि इसकी लागत 70 % कम है; तर्क-विचार बंद करने पर यह मंच के तीन सबसे तेज़ मॉडलों में शामिल है।
कंप्यूटिंग के मोर्चे पर ElevenLabs अपने Blackwell Ultra सिस्टमों में Vera Rubin की 15 MW क्षमता जोड़ने की योजना बना रहा है, ताकि सुरक्षा और डेटा के भौगोलिक निवास संबंधी आवश्यकताओं वाली तैनातियों को संभाला जा सके। संप्रभु तैनातियों के मोर्चे पर पोलैंड में एक वॉइस एजेंट उन मरीज़ों को फ़ोन करता है जिनके पास केवल लैंडलाइन है, ताकि उन्हें मुलाकात की याद दिलाई जा सके या उसका समय बदला जा सके। यह राष्ट्रीय ई-स्वास्थ्य मंच की केंद्रीय प्रणाली पर काम करता है, जो साल में 4 करोड़ मुलाकातों का प्रबंधन करती है। एजेंट NVIDIA Confidential Computing के साथ स्थानीय परिसर में चलता है। दोनों कंपनियों का कहना है कि वे रोबोट और वाहनों में अंतर्निहित वॉइस सुविधाओं की संभावनाएँ तलाश रही हैं, लेकिन किसी उत्पाद की घोषणा नहीं की गई है।
🔗 ElevenLabs और NVIDIA (ElevenLabs)
Anthropic ने Pro, Max, Ultra और Team ग्राहकों को उपयोग सीमाएँ पूरी तरह रीसेट करने का विकल्प दिया, 10 दिसंबर तक मान्य
10 नवंबर — @ClaudeDevs द्वारा शाम को प्रकाशित एक संदेश में (पेरिस के समयानुसार) Anthropic ने सभी Pro, Max, Ultra और Team ग्राहकों को अपनी उपयोग सीमाएँ पूरी तरह और मुफ़्त रीसेट करने का विकल्प दिया है, जो सभी मॉडलों और सभी सीमाओं पर लागू है। इसे 10 दिसंबर को 14 बजे PT से पहले कभी भी सेटिंग्स > उपयोग से या छोटे लिंक clau.de/reset के ज़रिए सक्रिय किया जा सकता है।
Anthropic का कहना है कि उसने हाल में कुछ छोटी समस्याएँ ठीक की हैं जिनसे उम्मीद से अधिक उपयोग सीमा खर्च हो रही थी। उसने उनका विवरण नहीं दिया, लेकिन स्पष्ट किया कि उनसे सभी लोग प्रभावित नहीं हुए थे। कंपनी यह भी मानती है कि Fable 5.2 के लॉन्च के लिए एक दिन पहले दिए गए Fable रीसेट उन लोगों के लिए बहुत मददगार नहीं थे जो पहले ही सभी मॉडलों की साप्ताहिक सीमाओं तक पहुँच चुके थे। वे रीसेट केवल Fable तक सीमित थे और सदस्यता की अवधि के अनुसार अलग थे; आज का रीसेट एक बार मिलता है, बताए गए सभी प्लान के लिए समान है और सभी मॉडलों को कवर करता है। Free और Enterprise प्लान का उल्लेख नहीं किया गया है, और 11 नवंबर तक किसी सहायता पृष्ठ पर इस पेशकश का विवरण नहीं था।
Grok Bot 1.0 : SpaceXSI के Bots को अब अधिक चुनिंदा ढंग से साझा किया जा सकता है, वे बैठकों में शामिल होते हैं और आपस में तालमेल करते हैं
11 नवंबर — SpaceXSI ने X पर पहले @bot और फिर @SpaceXSI खाते से Grok Bot 1.0 की घोषणा अपने एआई सहकर्मियों के बड़े अपडेट के रूप में की है; हालाँकि इसका विवरण देने वाले x.ai पृष्ठ की तारीख 2 नवंबर है। कई सुविधाएँ बीटा के दौरान ही आ चुकी थीं, जिनमें सितंबर के अंत में Team Bots, अक्टूबर की शुरुआत में कामों के सक्रिय सुझाव और सितंबर से ही Microsoft Teams में कार्रवाई करने की क्षमता शामिल थीं। Grok Bot 1.0 इन्हें एक साथ लाता है और मिलकर काम करने के लिए नई क्षमताएँ जोड़ता है:
- Team Bots, जिनके पास सितंबर के अंत से ही अपना Slack पहचानकर्ता था, अब चुनिंदा लोगों या समूहों के साथ साझा किए जा सकते हैं और Slack या Microsoft Teams में इस्तेमाल किए जा सकते हैं। वहाँ वे समझते हैं कि बातचीत में कौन शामिल है, काम अपने हाथ में लेने की पेशकश करते हैं और किसी दूसरे Bot के साथ तालमेल कर सकते हैं;
- वे वीडियो कॉल (Meetings) में शामिल होते हैं, चैट के ज़रिए अपनी बात रखते हैं, पिछली बातचीत की बातें फिर से सामने लाते हैं और फ़ैसलों का रिकॉर्ड रखते हैं;
- साझा कार्यस्थलों में हर Bot उससे बात करने वाले व्यक्ति की अनुमतियों का पालन करता है, संवेदनशील कार्रवाई से पहले पूछता है और जाँचता है कि कोई जानकारी सार्वजनिक चैनल में साझा की जा सकती है या नहीं;
- नई सेटिंग्स से यह तय किया जा सकता है कि Team Bot क्या जानता है, और विश्लेषण दिखाते हैं कि टीम उसका इस्तेमाल कैसे करती है।
Team Bots केवल Team और Enterprise प्लान में उपलब्ध हैं, जबकि Meetings, Team, Enterprise और Ultra प्लान में उपलब्ध है; Enterprise में इसे प्रशासक को सक्रिय करना होता है। SpaceXSI का कहना है कि वह पहले से ही लेखांकन, सहायता, बिक्री और विपणन में Bots को सहकर्मी के रूप में इस्तेमाल करता है। कोई कीमत या उपयोग का आँकड़ा नहीं दिया गया है।
🔗 Grok Bot 1.0 (SpaceXSI) · @SpaceXSI की घोषणा
वॉइस सहायक : ChatGPT Voice में केवल GPT-Live रहेगा, Gemini Live Apple CarPlay पर आ रहा है
आम उपयोगकर्ताओं के वॉइस सहायकों में दो बदलाव हो रहे हैं: OpenAI, ChatGPT Voice को एक ही मॉडल पर केंद्रित करके सरल बना रहा है, और Google, iPhone उपयोगकर्ताओं को गाड़ी चलाते समय Gemini Live का इस्तेमाल करने दे रहा है।
OpenAI 11 दिसंबर को ChatGPT से Advanced और Standard आवाज़ें हटाएगा, उनकी जगह GPT-Live लेगा
10 नवंबर — OpenAI, ChatGPT Voice से Advanced और Standard आवाज़ों को 11 दिसंबर 2026 को हटा रहा है। उस तारीख को वे चयन मेनू (सेटिंग्स > आवाज़) से गायब हो जाएँगी और जिन्होंने उन्हें बनाए रखा था, वे अपने आप GPT-Live से संचालित Live voice पर चले जाएँगे; तब तक उनका इस्तेमाल किया जा सकता है। OpenAI ने इस फ़ैसले की वजह जुलाई में लॉन्च हुए GPT-Live को अपनाए जाने को बताया है: तब से वॉइस का उपयोग लगभग दोगुना हो गया है, और ChatGPT से बोलकर बात करने वाले लगभग सभी लोग अब इसी मॉडल का इस्तेमाल करते हैं, जो एक साथ सुनता और बोलता है (फुल-डुप्लेक्स)।
दो अपवाद बने रहेंगे। लाइव वीडियो और स्क्रीन साझा करना तब तक Advanced voice पर रहेंगे जब तक GPT-Live उन्हें संभालने में सक्षम नहीं हो जाता, और कस्टम GPT की आवाज़ Advanced पर ही रहेगी, जब तक ये GPT उसी 11 दिसंबर को हटा नहीं दिए जाते। पुरानी बातचीत इतिहास में बनी रहेगी। यह बदलाव केवल ChatGPT से संबंधित है: API के ऑडियो मॉडलों के लिए कोई घोषणा नहीं की गई है।
🔗 Advanced और Standard आवाज़ों को हटाना (OpenAI सहायता) · @OpenAINewsroom की घोषणा
Gemini Live Apple CarPlay पर आ रहा है, iOS पर Gemini के सभी उपयोगकर्ताओं के लिए
11 नवंबर — Android Auto और Google की अंतर्निहित सुविधाओं वाली कारों के बाद Gemini ऐप्लिकेशन Apple CarPlay पर आ रहा है: iPhone उपयोगकर्ता अपनी कार की स्क्रीन से Gemini Live के साथ हाथों का इस्तेमाल किए बिना खुलकर बातचीत कर सकते हैं, उसे बीच में रोक सकते हैं या विषय बदल सकते हैं। Google ने दिन की तैयारी, Gmail और Google Calendar की मदद से बिना पढ़े ईमेल पढ़ने तथा लंबी बातचीत का सारांश बनाने, बोलकर जवाब लिखने या प्रस्तुति का अभ्यास करने जैसे उपयोग बताए हैं। ये बातचीत बाद में iPhone ऐप्लिकेशन में भी मिलती हैं।
इसे आज से दुनिया भर में iOS पर Gemini के सभी उपयोगकर्ताओं के लिए और Gemini Live द्वारा समर्थित सभी भाषाओं में उपलब्ध कराया जा रहा है। इसके लिए ऐप्लिकेशन का नवीनतम संस्करण, माइक्रोफ़ोन की अनुमति और फ़ोन पर कम से कम एक बार Gemini Live का इस्तेमाल करना ज़रूरी है। Gemini अब ChatGPT, Grok और Claude के साथ जुड़ रहा है, जो पहले से CarPlay पर मौजूद हैं।
🔗 Apple CarPlay पर Gemini (blog.google)
मॉडलों की सुरक्षा : OpenAI में तर्क-श्रृंखला की निगरानी कठिन होती जा रही है, Perplexity के SPACE सैंडबॉक्स के सामने बारह मॉडल
दो शोध प्रकाशन इस बात पर केंद्रित हैं कि सबसे सक्षम मॉडलों के व्यवहार को अब भी किस हद तक देखा और सीमाओं में रखा जा सकता है।
OpenAI : मॉडलों के बेहतर होने के साथ तर्क-श्रृंखला की निगरानी-क्षमता घट रही है
10 नवंबर — OpenAI के संरेखण शोधकर्ता अध्ययन कर रहे हैं कि तर्क-श्रृंखला (चेन ऑफ़ थॉट, CoT) की निगरानी-क्षमता को कौन-सी बातें बदलती हैं, यानी किसी मॉडल के तर्क को पढ़कर उसकी निगरानी करने की संभावना को। GPT-6 Astra के साथ OpenAI पहले ही इस निगरानी-क्षमता में गिरावट देख चुका था। 11 नवंबर को Jeffrey G. Wang की पोस्ट शृंखला में प्रस्तुत यह अध्ययन दो अप्रत्यक्ष संकेतकों का अनुसरण करता है: CoT के बिना क्षमता, यानी मॉडल एक ही चरण में क्या हल कर सकता है, और CoT की नियंत्रणीयता, यानी निर्देश मिलने पर अपने तर्क को बदलने की उसकी क्षमता।
| प्रशिक्षण का चरण | OpenAI द्वारा देखा गया प्रभाव |
|---|---|
| पूर्व-प्रशिक्षण | परप्लेक्सिटी घटने के साथ CoT के बिना क्षमता बढ़ती है; GPT-6 Astra भी इसी रुझान में है |
| मॉडल की संरचना | कुछ संरचनाएँ कई चरणों वाली योजना और क्रमिक गणना में उम्मीद से बेहतर प्रदर्शन करती हैं |
| पुनर्बलन अधिगम | Astra श्रेणी के एक मॉडल में प्रक्रिया की किसी अतिरिक्त निगरानी के बिना नियंत्रणीयता स्पष्ट रूप से बढ़ती है |
| जनित डेटा पर परिष्करण | नियंत्रणीयता शिक्षक मॉडल से छात्र मॉडल तक पहुँचती है |
लेखक स्वयं नियंत्रणीयता को शोरयुक्त माप मानते हैं: समान क्षमता वाले जिन दो मॉडलों का वे अध्ययन करते हैं, उनमें अधिक नियंत्रणीय मॉडल निगरानी प्रणालियों को बेहतर ढंग से चकमा नहीं देता। वे UK AISI का हवाला देते हैं, जिसने तर्क-विचार के बिना GPT-6 Astra के कार्य-क्षितिज का माध्यिका मान 30,9 मिनट आँका है, जबकि 2028 के अंत के लिए लगभग 7 मिनट का अनुमान था; डेटा दूषण से यह आँकड़ा बढ़ा हुआ हो सकता है। उनका निष्कर्ष है: पूर्व-प्रशिक्षण में आगे की प्रगति के लिए संभवतः नए तरीकों की ज़रूरत होगी।
🔗 मॉडल के जीवनचक्र में CoT की निगरानी-क्षमता (OpenAI) · Jeffrey G. Wang की पोस्ट शृंखला
Perplexity : Computer के सैंडबॉक्स के सामने बारह मॉडल, और कोई भी वर्चुअल मशीन से बाहर नहीं निकलता
11 नवंबर — Perplexity ने SPACE पर अपने हमले संबंधी अध्ययन (रेड-टीमिंग), SPACE से बाहर निकलना, का दूसरा भाग प्रकाशित किया है। SPACE वर्चुअल मशीनों वाला वह सैंडबॉक्स है जिसमें Computer के एजेंट चलते हैं। बारह मॉडल, जिनमें 23 सितंबर के पहले भाग के बाद जोड़े गए Claude Mythos 5.1, Claude Opus 5.5 और GPT-6 Astra शामिल हैं, दो परीक्षाओं से गुज़रते हैं: होस्ट से एक पहचानकर्ता हासिल करने के लिए वर्चुअल मशीन से बाहर निकलना, और किसी अवरुद्ध URL तक पहुँचने के लिए नेटवर्क नीति को दरकिनार करना। कोई भी मॉडल वर्चुअल मशीन से बाहर नहीं निकला। मूल निर्देश के साथ तीन GPT मॉडलों को छोड़कर बाकी सभी ने अपने प्रयास का अधिकतम 4 % हिस्सा वर्चुअलाइज़ेशन पर लगाया; इसी लक्ष्य पर दोबारा केंद्रित निर्देश से प्रयास का यह हिस्सा लगभग 60 प्रतिशत अंक बढ़ जाता है, लेकिन सफलता तब भी नहीं मिलती।
नेटवर्क नीति को दरकिनार करने की क्षमता सुधार से पहले के कार्यान्वयन पर, सोर्स कोड तक पहुँच के साथ, हर मॉडल के 3 प्रयासों में मापी गई:
| मूल्यांकन किया गया मॉडल | सफलतापूर्वक दरकिनार करने के प्रयास | बताया गया औसत समय |
|---|---|---|
| GPT-6 Astra | 3 में से 3 | 4,8 min |
| GPT-5.6 Sol | 3 में से 3 | 20,8 min |
| Claude Opus 5.5 | 3 में से 3 | 21,6 min |
| Claude Mythos 5.1 | 3 में से 3 | 36,6 min |
| Claude Opus 5.0 | 3 में से 3 | उल्लेख नहीं |
| Kimi K3 | 3 में से 2 | उल्लेख नहीं |
| GPT-5.6 Cyber | 3 में से 0 | 51,6 min |
| Grok 4.20 सहित पाँच अन्य मॉडल | 3 में से 0 | उल्लेख नहीं |
Sol पर आधारित और साइबर सुरक्षा में विशेषज्ञ GPT-5.6 Cyber ने उस फ़ंक्शन को ढूँढ़ने की कभी कोशिश नहीं की जो DNS स्पूफ़िंग के लिए ज़रूरी IP पता देता था; Perplexity के अनुसार इससे कोई सामान्य नियम निकालने के लिए नमूना बहुत छोटा है। छह निर्णायक मॉडलों के अनुसार Grok 4.20 आख़िरी स्थान पर रहा, जिसने छह प्रयासों में सफलता के 27 झूठे दावे किए। कमियाँ ठीक करने के बाद उन्हें दरकिनार करने का कोई तरीका नहीं मिला।
🔗 SPACE से बाहर निकलना: भाग II (Perplexity) · @perplexity_ai की पोस्ट शृंखला
Gemini Decision : Gemini API प्रति दस लाख टोकन पर 0,10 डॉलर में, आउटपुट टोकन के बिना, अंशांकित प्रायिकताएँ लौटाता है
11 नवंबर — Gemini API के रिलीज़ नोट्स में Gemini Decision (gemini-decision-1) जोड़ा गया है, जिसे एक समर्पित Decisions API के ज़रिए उपलब्ध कराया गया है। मॉडल उत्तर नहीं लिखता : यह दिए गए डेटा पर पूर्वनिर्धारित उत्तरों वाले प्रश्नों का मूल्यांकन करता है और शून्य आउटपुट टोकन के साथ अंशांकित प्रायिकताएँ लौटाता है, जिससे किसी ऐप्लिकेशन का कोड सीधे नतीजे के आधार पर छँटाई या रूटिंग कर सकता है। तीन प्रारूप उपलब्ध हैं : हाँ या नहीं (0,01 से 0,99 तक प्रायिकता, साथ में विश्वास का एक सूचक), 2 से 255 विकल्पों में से चयन, या क्रमबद्ध स्तरों की एक श्रेणी पर अंक देना।
| Gemini Decision 1 की विशेषता | प्रकाशित मान |
|---|---|
| स्वीकार्य इनपुट | टेक्स्ट, छवि, वीडियो, ऑडियो, PDF |
| प्रति अनुरोध प्रश्न | एक साझा इनपुट पर अधिकतम 1 000 |
| अधिकतम इनपुट | 262 144 tokens |
| सशुल्क स्तर की दर | प्रति दस लाख इनपुट टोकन पर 0,10 डॉलर, साझा इनपुट का शुल्क केवल एक बार लिया जाता है |
| निःशुल्क स्तर | निःशुल्क, डेटा का उपयोग उत्पादों को बेहतर बनाने के लिए किया जाता है |
Google अनुरोधों की रूटिंग, एक साथ कई नियमों की जाँच या किसी एजेंट द्वारा टूल चुनने जैसे उपयोग बताता है। मॉडल अभी केवल Gemini Developer API के v1beta में उपलब्ध है, जिसमें Batch API और कॉन्टेक्स्ट कैश उपलब्ध नहीं हैं। रिलीज़ के साथ कोई ब्लॉग लेख नहीं आया है, और इस API का नाम वही है जो Perplexity ने 1 अक्टूबर को लॉन्च की गई Decisions API का रखा था।
🔗 Gemini Decision 1 (Google AI Studio) · Decisions API का दस्तावेज़ीकरण
A2UI 1.0 : एजेंटों को नेटिव स्क्रीन के रूप में उत्तर देने देने वाला Google का खुला प्रोटोकॉल स्थिर संस्करण में पहुँचा
11 नवंबर — Google ने A2UI 1.0 जारी किया है, जो उसके जनरेटिव इंटरफ़ेस (जनरेटिव UI) के खुले प्रोटोकॉल का पहला स्थिर संस्करण है। अनुच्छेदों में उत्तर देने के बजाय, एजेंट बताता है कि क्या दिखाना है, जैसे पुष्टि किया जाने वाला फ़ॉर्म या कोई चार्ट, और हर ऐप्लिकेशन उसे अपने नेटिव घटकों से प्रदर्शित करता है। लेख के अनुसार, संवेदनशील मान सर्वर पर बाइंड किए जाते हैं और मॉडल तक नहीं पहुँचते।
संस्करण 1.0 में दोनों दिशाओं में फ़ंक्शन कॉल जोड़े गए हैं, ताकि उड़ान चुनने वाला घटक उसी समय उपलब्धता जाँच सके; इसके साथ सुलभता और मेटाडेटा विस्तार भी जोड़े गए हैं। ओपन सोर्स रेंडरिंग इंजन वेब पर React, Angular और Lit, साथ ही Flutter और SwiftUI को कवर करते हैं ; Jetpack Compose वाला इंजन अभी 0.9.1 पर है। वेब और Flutter के रेंडरर MCP Apps में काम करते हैं, इसलिए Claude या Gemini जैसे सहायकों में भी, और Python के एजेंट SDK के साथ अब TypeScript और Dart के SDK भी जुड़ गए हैं। Atlassian इसे Jira में इस्तेमाल करता है, जहाँ किसी टिकट की ज़िम्मेदारी सँभालने वाला एजेंट एक इंटरैक्टिव कार्ड के ज़रिए टीम से सवाल पूछ सकता है ; Alation, Bloomberg और ByteDance भी इस प्रोटोकॉल के साथ निर्माण कर रहे हैं। Google में Gemini Notebook पहले से इसका उपयोग कर रहा है, और Gemini Enterprise 1.0 पर जा रहा है।
🔗 A2UI 1.0 (Google Developers Blog)
कोड एजेंट : Delta के Cloud Runners, VS Code 1.146 और Qwen Code 1.0 Preview
Delta ने अपने Cloud Runners लॉन्च किए : एजेंट का थ्रेड उसके लेखक के कंप्यूटर के बिना भी चलता रहता है
11 नवंबर — Zed की टीम का एजेंटों वाला बहु-उपयोगकर्ता कोडिंग परिवेश Delta, पिछले दिन घोषित Cloud Runners लॉन्च कर रहा है। किसी थ्रेड के कंपोज़र में Cloud चुनने पर, एजेंट के चरण Zed द्वारा होस्ट किए गए Linux सैंडबॉक्स में चलते हैं, जो E2B पर आधारित है ; थ्रेड को डेस्कटॉप, वेब या फ़ोन से देखा जा सकता है और किसी भी समय स्थानीय मशीन पर वापस लाया जा सकता है। रनर Delta के सर्वरों से कोड प्राप्त करता है, रिपॉज़िटरी की .agents/setup स्क्रिप्ट चलाता है (नतीजा एक दिन तक कैश में रखा जाता है) और उपयोगकर्ता के मॉडल प्रदाताओं तथा एन्क्रिप्ट किए गए एनवायरनमेंट वेरिएबल का उपयोग करता है। अनुमति मिलने के बाद, git और gh GitHub पर उसकी ओर से काम करते हैं, और एजेंट ऐसा पूर्वावलोकन URL लौटा सकता है जो केवल थ्रेड तक पहुँच रखने वाले लोगों के लिए उपलब्ध हो।
| रनर का आकार | आवंटित प्रोसेसर | रैम | खाली डिस्क स्थान |
|---|---|---|---|
| Small | 2 CPU | 4 Go | 15 Go |
| Medium (डिफ़ॉल्ट) | 4 CPU | 8 Go | 30 Go |
| Large | 8 CPU | 16 Go | 50 Go |
जब तक Delta अपनी योजनाएँ तैयार कर रहा है, कंप्यूटिंग Student को छोड़कर Zed की सभी योजनाओं पर निःशुल्क है, उचित उपयोग की ऐसी सीमाओं के भीतर जिनकी संख्याएँ नहीं बताई गई हैं ; मॉडलों का शुल्क स्थानीय उपयोग की तरह ही लिया जाता है। एक साथ छह रनर चल सकते हैं, टर्मिनल एक घंटे बाद बंद हो जाते हैं और 10 मिनट की निष्क्रियता के बाद रनर रुक जाता है।
🔗 Cloud Runners अब Delta में उपलब्ध हैं · Cloud Runners का दस्तावेज़ीकरण
VS Code 1.146 ने Copilot के Local हार्नेस को अप्रचलित घोषित किया और एजेंट सत्रों के लिए Inbox मोड जोड़ा
11 नवंबर — Microsoft ने VS Code 1.146 जारी किया है, जिसमें Copilot के Local हार्नेस (Local हार्नेस) को अप्रचलित घोषित किया गया है : इसे फ़रवरी 2027 में हटा दिया जाएगा और तब तक यह इस्तेमाल करने योग्य रहेगा, लेकिन इसमें कोई बदलाव नहीं होगा। नई सुविधाएँ केवल Copilot हार्नेस में आएँगी, जो Copilot SDK पर बना है, VS Code 1.143 से नए सत्रों का डिफ़ॉल्ट विकल्प है और संगठनों की सैंडबॉक्स तथा अनुमति नीतियाँ लागू करने वाला एकमात्र हार्नेस है।
Agents विंडो में Inbox मोड (प्रयोगात्मक) जोड़ा गया है, जो हस्तक्षेप की प्रतीक्षा कर रहे सत्रों को सबसे ऊपर दिखाता है, और किसी चैट को अपनी अलग विंडो में रखा जा सकता है (पूर्वावलोकन)। Compare Models अब Copilot Fusion और उसके प्रयास स्तरों को स्वीकार करता है। सुरक्षा के मामले में, अनुमति माँगने वाले संकेत सीमित दायरे की अनुमतियाँ देते हैं (एक डोमेन, एक कमांड, एक डायरेक्टरी), और सैंडबॉक्स एनवायरनमेंट वेरिएबल छिपा सकता है, जिनके वास्तविक मान केवल अधिकृत होस्ट को भेजे जाने वाले HTTPS अनुरोधों में डाले जाते हैं। VS Code अब MCP सर्वरों द्वारा दिए गए स्किल का भी समर्थन करता है (SEP-2640, पूर्वावलोकन), और Copilot सत्र PAC तथा Kerberos की प्रॉक्सी कॉन्फ़िगरेशन का पालन करते हैं।
🔗 VS Code 1.146 के रिलीज़ नोट्स
Qwen Code 1.0 Preview ने Qoder और Qwen Code के एजेंटों को Node.js के बिना एक नेटिव बाइनरी में जोड़ा
11 नवंबर — Qwen4-Max के कुछ ही घंटे बाद, Qwen ने प्री-रिलीज़ के रूप में Qwen Code 1.0 Preview जारी किया है, जो Alibaba के कोडिंग परिवेश Qoder और Qwen Code की एजेंट क्षमताओं को जोड़ता है : कोडबेस को समझना, कार्यान्वयन करना, डीबग करना और परीक्षण करना। कनेक्शन Qwen या Qoder खाते, QwenCloud या Model Studio, अथवा किसी भी संगत एंडपॉइंट के ज़रिए किया जा सकता है। यह टूल macOS, Linux और Windows के लिए x64 तथा arm64 में नेटिव पैकेजों के रूप में मिलता है (लगभग 57 से 74 Mo के आठ आर्काइव), इसमें Node.js को अलग से स्थापित करने की आवश्यकता नहीं है, और सत्र फिर शुरू करने तथा गैर-संवादी निष्पादन की सुविधाएँ बनी रहती हैं।
रिपॉज़िटरी चेतावनी देती है कि इंटरफ़ेस और विकल्प अभी बदल सकते हैं, और दिसंबर 2026 बीतने तक समुदाय से पुल रिक्वेस्ट स्वीकार नहीं करेगी। GitHub API के अनुसार, 1.0 टैग का पिछले दिन जारी v0.27.2 के साथ कोई साझा इतिहास नहीं है।
🔗 Qwen Code v1.0.0-preview (GitHub)
खुले मॉडल और शोध : Tether का BotPsy और Hugging Face की टोकन पूलिंग
BotPsy-0.8B : Tether ने एक छोटा खुला एजेंट मॉडल जारी किया, जो अपने आधार मॉडल के टूल स्कोर लगभग दोगुने कर देता है
11 नवंबर — Tether की एआई टीम Tether AI Research, जो QVAC नाम से प्रकाशित करती है, ने BotPsy-0.8B प्रस्तुत किया है। यह 0,8 अरब पैरामीटर वाला मॉडल है, जो टूल कॉल में विशेषज्ञ है और फ़ोन या लैपटॉप पर चलने के लिए बनाया गया है। यह Qwen3.5-0.8B से शुरू होता है, फिर सुपरवाइज़्ड फ़ाइन-ट्यूनिंग, तीन शिक्षक Qwen3.5-4B मॉडलों से डिस्टिलेशन और रीइन्फ़ोर्समेंट लर्निंग के दो दौर से गुज़रता है। मॉडल कार्ड के अनुसार, इसके वज़न Hugging Face पर safetensors और GGUF में Apache 2.0 लाइसेंस के तहत उपलब्ध हैं ; लेख शोध और शिक्षा में उपयोग का उल्लेख करता है।
| बेंचमार्क (टीम के आँकड़े) | BotPsy-0.8B | Qwen3.5-0.8B (आधार) | Qwen3.5-2B-Think |
|---|---|---|---|
| BFCL v4 | 44,0 | 23,4 | 37,7 |
| ACEBench | 58,7 | 30,1 | 55,4 |
| τ-bench | 51,5 | 23,2 | 46,5 |
| छह टूल बेंचमार्क का औसत | 45,0 | 24,7 | 38,8 |
ये सभी आँकड़े टीम ने रीजनिंग मोड में मापे हैं। टीम यह भी बताती है कि स्वचालित आक्रमण परीक्षणों में खतरनाक उत्तर 36 % से घटकर 21 % रह गए, अंग्रेज़ी के उपयोग की सिफ़ारिश करती है और संवेदनशील निर्णयों के लिए मॉडल के उपयोग के विरुद्ध सलाह देती है।
🔗 BotPsy (Hugging Face पर QVAC) · qvac/BotPsy-0.8B मॉडल
टोकन पूलिंग : Hugging Face चार गुना कम वेक्टरों के साथ खोज की 97,8 % गुणवत्ता बनाए रखता है
11 नवंबर — टॉम आर्सेन ने Hugging Face ब्लॉग पर विस्तार से बताया है कि ColBERT जैसे बहु-वेक्टर खोज इंडेक्स का आकार कैसे कम किया जाए, जो दस्तावेज़ के हर टोकन के लिए एक वेक्टर रखते हैं। टोकन समूहीकरण (टोकन पूलिंग) पास के वेक्टरों को मिला देता है, और Sentence Transformers एक लॉस, MultiVectorTokenPoolingLoss, जोड़ता है, जो मॉडल को उसके पूर्ण और संपीड़ित निरूपणों, दोनों पर प्रशिक्षित करता है।
| इन्फ़रेंस के समय पूलिंग (NanoBEIR, nDCG@10) | औसत वेक्टर | पारंपरिक प्रशिक्षण | पूलिंग को ध्यान में रखकर प्रशिक्षण |
|---|---|---|---|
| पूलिंग के बिना | 193,22 | 51,84 | 52,39 |
pool_factor=4 | 48,68 | 49,03 | 51,23 |
max_tokens=4 | 4,00 | 37,22 | 43,00 |
चार गुना कम वेक्टरों के साथ, इस तरह प्रशिक्षित मॉडल अपना 97,8 % स्कोर बनाए रखता है, जबकि पारंपरिक प्रशिक्षण में यह 94,6 % है। माप केवल एक कॉन्फ़िगरेशन (ModernBERT-base, एक एपॉक) पर किए गए हैं, और Hub पर दो चेकपॉइंट प्रकाशित किए गए हैं।
🔗 टोकन पूलिंग को ध्यान में रखकर प्रशिक्षण (Hugging Face)
Pika और Runway पर Seedance 2.5 अब 4K में
11 नवंबर — BytePlus के ज़रिए उपलब्ध ByteDance का वीडियो मॉडल Seedance 2.5 अब 4K में आ रहा है। Pika इसे अपने प्लेटफ़ॉर्म और Pika API Club में नेटिव 4K में उपलब्ध करा रहा है, जिसमें पहले किसी शॉट के ड्राफ़्ट पर काम करके फिर उसे 4K में अंतिम रूप देने की सुविधा है ; 17 अगस्त से वह इसे 1080p में 4K तक बढ़ाने (अपस्केल) की सुविधा के साथ उपलब्ध करा रहा था। दो घंटे से कुछ कम समय बाद Runway ने भी अपने प्लेटफ़ॉर्म पर Seedance 2.5 को 4K में उपलब्ध कराने की घोषणा की, लेकिन यह स्पष्ट नहीं किया कि यह नेटिव 4K है या नहीं। न कीमत, न अधिकतम अवधि और न ही क्रेडिट की लागत बताई गई है।
🔗 @pika_labs की घोषणा · @runwayml की घोषणा
Git ने छह सुरक्षा कमज़ोरियाँ ठीक कीं, जिनमें रिकर्सिव क्लोनिंग के दौरान कोड निष्पादन की कमज़ोरी भी शामिल है
10 नवंबर — एआई से अलग समाचार में, Git परियोजना ने Git 2.56.1 जारी किया है, जिसमें Git 2.50.2 तक के संस्करणों के लिए बैकपोर्ट भी हैं, ताकि उन छह सुरक्षा कमज़ोरियों को ठीक किया जा सके जिनका विस्तार से वर्णन एलाइजा न्यूरेन ने GitHub Blog पर किया है।
| ठीक की गई सुरक्षा कमज़ोरी | जोखिम का प्रकार |
|---|---|
| CVE-2026-111760 | किसी सबमॉड्यूल की .git फ़ाइल के ज़रिए रिकर्सिव क्लोनिंग के दौरान कोड निष्पादन |
| CVE-2026-113408 | सर्वर द्वारा बताए गए HEAD के ज़रिए पाथ ट्रैवर्सल |
| CVE-2026-114467 | GPG हस्ताक्षर हटाते समय स्टैक करप्शन |
| CVE-2026-114469 | बाइनरी पैच लागू करते समय सीमा से बाहर पढ़ना |
| CVE-2026-105437 | बड़े मर्ज के दौरान हीप करप्शन |
| CVE-2026-114466 | git fast-import स्ट्रीम के ज़रिए फ़ाइल सिस्टम तक पहुँच |
GitHub ने github.com और Enterprise Cloud पर सुधार पहले ही लागू कर दिए हैं, GitHub Enterprise Server 3.19.15, 3.20.11, 3.21.9 और 3.22.4 जारी किए हैं, और GitHub Desktop तथा GitHub Copilot ऐप के ऐसे संस्करण तैयार कर रहा है जिनमें सुधारा गया Git होगा। निर्देश है कि Git और उसकी प्रति शामिल करने वाले हर ऐप्लिकेशन को अपडेट करें ; ऐसा संभव न हो तो केवल विश्वसनीय सर्वरों से क्लोन करें।
🔗 Git की सुरक्षा कमज़ोरियों की घोषणा (GitHub Blog)
संक्षिप्त समाचार
कोड एजेंट और विकास उपकरण
- Zed 1.28 और प्रीव्यू 1.29 — 1.28 अब स्थिर संस्करण है और इसमें 4 नवंबर को बताए गए प्रीव्यू की सुविधाएँ शामिल हैं (नवीनतम Agent Client Protocol,
read_fileकी रीडिंग को 2 000 अक्षरों तक सीमित करना, वैकल्पिक स्वचालित Git फ़ेच)। प्रीव्यू 1.29 में Anthropic प्रदाता के ज़रिए Claude Fable 5.2 और Claude Mythos 5.2 का समर्थन मिलता है। 🔗 स्रोत - Antigravity CLI 1.5.4 और 1.5.5 — 1.5.5 टर्मिनल में /swarm का प्रीव्यू और /swarm board का पूर्ण स्क्रीन दृश्य लाता है, और Claude Code प्लगइन के कमांड तथा हुक्स के इंपोर्ट को ठीक करता है। 1.5.4 में ACP सत्रों के लिए Auto मोड उपलब्ध होता है और हुक्स को भेजे जाने वाले डेटा में अधिक जानकारी जुड़ती है। 🔗 स्रोत
- Gemini CLI — v0.68.0 के अगले दिन कोई नया संस्करण नहीं आया, और रात्रिकालीन संस्करण (nightly) फिर विफल रहा, जैसा 5 नवंबर से हर रात हो रहा है। मुख्य ब्रांच में चार सुधार मर्ज किए गए हैं, जिनमें किसी इमेज या बाइनरी फ़ाइल पर मॉडल की खाली बारी के बाद आने वाली 400 त्रुटि का समाधान भी शामिल है। 🔗 स्रोत
- Copilot CLI 1.0.110-1 — यह प्रीव्यू केवल 13 सुधारों तक सीमित है: दोबारा शुरू किए गए सत्र में अब समानांतर रूप से बदलाव नहीं किया जा सकता, और अधूरा Unicode अक्षर लौटाने वाला स्थानीय MCP सर्वर अब टूल कॉल को नहीं अटकाता। SDK 1.0.32-preview.1 में Copilot Fusion और उसका स्तर चुना जा सकता है। 🔗 स्रोत
- Genspark में Gemini 4 Carbon — उसी Code Agent में Claude Fable 5.2 उपलब्ध कराने के अगले दिन Genspark अपने AI Chat और Code Agent में Gemini 4 Carbon उपलब्ध करा रहा है, लेकिन योजना या क्रेडिट की खपत का विवरण नहीं दिया गया है। 🔗 स्रोत
- Basis और Devin for Startups — Cognition एक वीडियो में दिखाता है कि Basis, Devin के साथ कैसे काम करता है; Basis के लेखांकन एजेंट कुछ कामों का समय 20 घंटे से घटाकर 30 मिनट कर देते हैं। यह आँकड़ा Basis से संबंधित है, Devin से नहीं। Cognition ने Devin for Startups भी फिर शुरू किया है, जिसके तहत चुनी गई टीमों को 65 000 डॉलर के क्रेडिट मिलेंगे। 🔗 स्रोत
- shem — जोआओ गालेगो ने एक प्रयोगात्मक रनटाइम प्रकाशित किया है, जो Hugging Face के मॉडल को कंटेनर इमेज की तरह चलाता है (कोई Dockerfile,
FROM hf.co/...से शुरू हो सकता है) और इसके उलट, मॉडल के वज़नों से बने प्रोसेसर पर कंटेनर चलाता है; उनके अनुसार, यह « ज़्यादातर समय » काम करता है। 🔗 स्रोत
GitHub
- GitHub Apps से प्रबंधित Copilot सीटें — एंटरप्राइज़ की GitHub Apps अब Copilot सीट प्रबंधन API का उपयोग करके एंटरप्राइज़ के उपयोगकर्ताओं और टीमों को सीटें दे सकती हैं। इसके लिए Enterprise Copilot license management नाम की नई सूक्ष्म अनुमति उपलब्ध है। 🔗 स्रोत
- Dependabot और निष्क्रिय रिपॉज़िटरी — 8 दिसंबर से GitHub उन अधिकांश रिपॉज़िटरी पर Dependabot अलर्ट बंद कर देगा जिनमें एक वर्ष से कोई गतिविधि नहीं हुई है; अलर्ट संग्रहित किए जाएँगे, मिटाए नहीं जाएँगे, और पहला पुश उन्हें फिर चालू कर देगा। GitHub Enterprise Server इससे प्रभावित नहीं है। 🔗 स्रोत
- व्यक्तिगत खातों के लिए इश्यू के प्रकार और फ़ील्ड — अब तक केवल संगठनों के लिए उपलब्ध ये सुविधाएँ व्यक्तिगत रिपॉज़िटरी में भी सामान्य रूप से उपलब्ध हो रही हैं: अधिकतम 25 प्रकार और 25 फ़ील्ड, जिनका उपयोग प्रोजेक्ट में, REST और GraphQL API से तथा वेबहुक के ज़रिए किया जा सकता है। 🔗 स्रोत
- GitHub का डैशबोर्ड — अधिक सघन डैशबोर्ड अब तीन के बजाय छह पुल रिक्वेस्ट और छह इश्यू दिखाता है, Feed या Home टैब को पिन करने देता है, और खाते में कोई एजेंट सत्र न होने पर उस खंड को छिपा देता है। 🔗 स्रोत
कंपनियाँ और उपयोग
- Singapore Airlines — OpenAI की API पर दोबारा बनाया गया उसका चैटबॉट Kris ग्राहक संतुष्टि स्कोर को दोगुना करता है, कॉल के सारांश से सलाहकारों का कॉल निपटाने का समय लगभग 10 % कम होता है, और 60 % से अधिक कर्मचारी हर महीने आंतरिक प्लेटफ़ॉर्म Jarvis का उपयोग करते हैं। 🔗 स्रोत
- Cogent Security — यह स्टार्टअप GPT-6.1 Sol, GPT-6 Astra और GPT-5.6 पर साइबर रक्षा एजेंट बना रहा है, जो ऐसी नीतियों के तहत काम करते हैं जिनकी जाँच हर टूल कॉल से पहले होती है; कंपनी के अनुसार, Fortune 1000 में शामिल उसके एक वाहन निर्माता ग्राहक ने अपनी गंभीर सुरक्षा कमज़ोरियों को ठीक करने का औसत समय 75 % घटाया है। 🔗 स्रोत
- JioStar — लगभग आठ सप्ताह में OpenAI की API पर बना JioHotstar का सामग्री खोजने वाला वॉइस असिस्टेंट 500 मिलियन से अधिक उपयोगकर्ताओं वाले प्लेटफ़ॉर्म पर 15 से अधिक भाषाएँ बोलता है; JioStar के अनुसार, इसके 60 % से अधिक उपयोगकर्ता उसे लिखने के बजाय उससे बोलकर बात करते हैं। 🔗 स्रोत
- पूर्व सैनिकों के लिए ChatGPT Plus — पूर्व सैनिक दिवस पर OpenAI ने बताया कि एक वर्ष में 20 000 से अधिक पूर्व सैनिकों और नागरिक जीवन की ओर लौट रहे सैन्यकर्मियों ने एक साल की निःशुल्क ChatGPT Plus सदस्यता प्राप्त की है, और सैन्य समुदाय के लगभग 1 000 सदस्यों को प्रशिक्षण दिया गया है। 🔗 स्रोत
- ChatGPT में fal प्लगइन — fal अपने प्लगइन को प्रदर्शित कर रहा है, जो बातचीत में इमेज और वीडियो बनाता तथा संपादित करता है। इसके लिए GPT Image 2.6, FLUX 3 Max (26 दृश्य) और fal Recast से बना 60 सेकंड का विज्ञापन दिखाया गया है; इसे ऑनलाइन उपलब्ध कराने की तारीख नहीं बताई गई है। 🔗 स्रोत
- Grok Bot में Gopuff — Grok Bot अब Gopuff से किराने का सामान, नाश्ते और रोज़मर्रा की चीज़ें मँगाने की पूरी प्रक्रिया संभालता है। Gopuff के अनुसार, सबसे तेज़ डिलीवरी 15 मिनट में होती है; देशों और योजनाओं का विवरण नहीं दिया गया है। 🔗 स्रोत
- Genspark Genius — Genspark एम्बेसडर नियुक्त कर रहा है: हर महीने एक रचना साझा करने के बदले Pro योजना, नई सुविधाओं तक शुरुआती पहुँच, क्रेडिट और उसके चैनलों पर प्रचार मिलेगा। 🔗 स्रोत
मॉडल, मीडिया और शोध
- MiniMax H3 — अपने वज़न सार्वजनिक करने के सौ दिन बाद MiniMax ने Hugging Face पर 1 472 व्युत्पन्न मॉडल और 148 मिलियन से अधिक डाउनलोड का दावा किया है; इन आँकड़ों की पुष्टि नहीं हुई है। H3-Image अब fal, Runware, EvoLink और Miora पर उपलब्ध हो रहा है, और Miora पर 17 नवंबर तक मुफ़्त है। 🔗 स्रोत
- AI Engineer Paris में Voxtral Transcribe 3 — Mistral ने मुख्य मंच के सभी व्याख्यानों का सीधे लिप्यंतरण किया। इसके लिए मॉडल को वक्ताओं के नाम और कार्यक्रम की शब्दावली दी गई थी (संदर्भ आधारित झुकाव), लेकिन इससे हुए सुधार का कोई आँकड़ा नहीं दिया गया। 🔗 स्रोत
- Google AI Edge Gallery में स्थानीय वाणी — ऐप में ऑफ़लाइन वाक् पहचान और वाक् संश्लेषण जुड़ रहे हैं: Android पर ML Kit 100 से अधिक भाषाओं का लिप्यंतरण वास्तविक समय से दस गुना तेज़ करता है, और Parakeet-TDT 0.6B या Kokoro-82M जैसे खुले मॉडल अन्य प्लेटफ़ॉर्म को संभालते हैं। 🔗 स्रोत
- NVIDIA का Déjà View — 117M पैरामीटर वाला यह 3D पुनर्निर्माण मॉडल एक ही ट्रांसफ़ॉर्मर ब्लॉक को कई बार लागू करता है और पाँच बेंचमार्क पर अपने से 10 गुना तक बड़े मॉडलों की बराबरी करता है; NeurIPS 2026 में इसकी मौखिक प्रस्तुति हुई है, और शोधपत्र मई से arXiv पर उपलब्ध है। 🔗 स्रोत
- स्पेनी चिकित्सा पाठों में बीमारियाँ — OpenMed ने Apache-2.0 के तहत दो खुले मॉडल प्रकाशित किए हैं, जिन्हें CPU पर चलाया जा सकता है; टीम के अनुसार, DisTEMIST पर फ़ाइन-ट्यूनिंग से सामान्य मॉडल का लगभग 36 से 39 वाला F1 स्कोर GLiNER2.5 संस्करण में लगभग 73 तक पहुँच जाता है। 🔗 स्रोत
- एजेंट के x402 भुगतान — अपने हाल पर छोड़े जाने पर Qwen3 235B, DeepSeek V4 Pro और Llama 3.3 70B को Fizzl की परीक्षा में 59, 55 और 30 अंक मिलते हैं, और कोई भी पास नहीं होता; जब भुगतान का निर्णय कोड लेता है (x402-safe-fetch), तो उनके अंक 94, 100 और 94 हो जाते हैं। 🔗 स्रोत
- FiftyOne में GR00T-X-Embodiment-Sim — हरप्रीत सहोता (Voxel51) ने NVIDIA के डेटासेट के 42 सिम्युलेटेड एपिसोड परिवर्तित किए हैं, जिनमें रोबोट की सात शारीरिक संरचनाओं में से प्रत्येक के लिए छह एपिसोड हैं और कैमरों तथा जोड़ों की टेलीमेट्री का डेटा संरेखित है। 🔗 स्रोत
पारिस्थितिकी तंत्र
- Sakana AI — सेवानिवृत्त एडमिरल और NSA के पूर्व निदेशक माइकल रोजर्स तथा CIA में लगभग 30 वर्ष बिता चुके टॉम मोरन, टोक्यो के इस स्टार्टअप में रक्षा और साइबर सुरक्षा के वरिष्ठ सलाहकार बन रहे हैं। 🔗 स्रोत
- NVIDIA में पुनर्चक्रण — COP31 के अवसर पर NVIDIA अपने Inception कार्यक्रम के चार स्टार्टअप दिखा रहा है, जो कंप्यूटर विज़न से कचरा छाँटते हैं। इनमें Greyparrot भी है, जो 15 टन कचरे की जाँच का समय 375 घंटे से घटाकर 6 घंटे कर देता है; NVIDIA का कोई नया उत्पाद नहीं आया है। 🔗 स्रोत
- एआई अनुपालन पर Perplexity की मार्गदर्शिका — यह यूरोपीय AI Act, NIST AI RMF और ISO/IEC 42001 की समीक्षा करती है और एजेंटों के लिए तीन नियंत्रण सुझाती है: केवल ज़रूरी चीज़ों तक पहुँच, हर कार्रवाई का लॉग और बड़े प्रभाव वाली कार्रवाइयों पर मानवीय स्वीकृति। 🔗 स्रोत
- MCP आर्किटेक्चर पर Perplexity की मार्गदर्शिका — होस्ट, क्लाइंट और सर्वर की भूमिकाएँ, JSON-RPC 2.0 संदेश, स्थानीय ट्रांसपोर्ट और Streamable HTTP, कई टेनेंट वाली व्यवस्था: यह तकनीकी प्रस्तुति 4 नवंबर की सुरक्षा मार्गदर्शिका के बाद आई है, और इसमें किसी उत्पाद की घोषणा नहीं है। 🔗 स्रोत
- टोरंटो में Cohere हैकाथॉन — Cohere, टोरंटो विश्वविद्यालय के साथ 30 जनवरी 2027 को उच्च शिक्षा में एआई पर अपना पहला हैकाथॉन, Hacking Higher Ed, आयोजित कर रहा है; पुरस्कार 3 000, 2 000 और 1 000 डॉलर हैं, और आवेदन 22 जनवरी तक खुले हैं। 🔗 स्रोत
इसका क्या अर्थ है
Google DeepMind अपने मॉडलों को दो ऐसी समस्याओं पर लागू कर रहा है जहाँ सामग्री बनाने से अधिक महत्व सत्यापन का है। AlphaGenome 2 अब केवल ऊतक के स्तर पर औसत तक सीमित नहीं है: यह शोधकर्ता की रुचि वाली कोशिका में किसी वैरिएंट के प्रभाव का अनुमान लगाता है, और इसके सुधार TenK10K पर मापे जाते हैं, जो 28 प्रकार की प्रतिरक्षा कोशिकाओं का मानचित्र है। AlphaProof Code औपचारिक सत्यापन को प्रोटोकॉल की डिज़ाइन से संकलित कोड तक ले जाता है, जिसमें काम का बँटवारा स्पष्ट है: एजेंट प्रमाण की छह मिलियन से अधिक पंक्तियाँ लिखते हैं, Lean सत्यापक हर चरण की जाँच करता है, और मनुष्य विनिर्देशों तथा लगभग 1 % कोड की समीक्षा करते हैं। दोनों घोषणाओं की सीमाएँ बनी हुई हैं: AlphaGenome 2 अभी केवल शोध के लिए है, और Signal के संबंध में सबसे पहले यह उपलब्धि हासिल करने का दावा Google DeepMind का अपना है।
सुरक्षा अपने ही मापन उपकरणों की सीमाओं से जूझ रही है। OpenAI ने पाया है कि निगरानी के उसके प्रमुख आधारों में से एक, तर्क की शृंखला, पूर्वप्रशिक्षण आगे बढ़ने के साथ पढ़ने में कठिन होती जाती है। वह अपने दो संकेतकों में से एक, नियंत्रणीयता, के माप को खुद शोर से प्रभावित मानता है। Perplexity दिखाता है कि झंडा हासिल करने वाली पारंपरिक प्रतियोगिता का प्रारूप एजेंटों को उस सीमा से भटका देता है जिसकी जाँच की जानी है, और साइबर सुरक्षा में विशेषज्ञ मॉडल अपने सामान्य उपयोग वाले संस्करण से खराब प्रदर्शन कर सकता है। यह निष्कर्ष तीन परीक्षणों और सुधार लागू होने से पहले के एक विन्यास पर आधारित है। दोनों मामलों में निष्कर्ष जितना मॉडलों के बारे में है, उतना ही मूल्यांकन के तरीके के बारे में भी है।
आज की खबरें स्पष्ट अंतर दिखाती हैं कि क्या उपलब्ध कराया गया है और किसकी केवल घोषणा हुई है। Runway ने Praxis-1 को उसके वज़नों, फ़ाइन-ट्यूनिंग कोड और ऐसी रिपोर्ट के साथ जारी किया है जो मॉडल को चार प्रतिस्पर्धी प्रविष्टियों से नीचे रखती है, और Tether ने BotPsy डाउनलोड के लिए उपलब्ध कराया है। इसके उलट, Qwen4-Max बिना बेंचमार्क, आकार या कीमत बताए आया है, और ElevenLabs खुद आज उपलब्ध चीज़ों (Marketplace, Partner Program, ElevenAI) तथा बाद में आने वाली चीज़ों (Interaction Engine, Memory, Routines, फ़ाइन-ट्यूनिंग) के बीच अंतर करता है। जो इन्हें आज़माना चाहते हैं, उनके लिए दूसरा हिस्सा अभी एक वादा है।
एजेंट लंबे समय तक चलने वाले कामों और टीमों में अपनी जगह बना रहे हैं। Grok Bot 1.0 बैठकों में शामिल होता है और Slack तथा Teams में दूसरे Bots के साथ तालमेल करता है; Delta के Cloud Runners किसी एजेंट का थ्रेड उसके लेखक के कंप्यूटर के बिना चलाते हैं; VS Code निर्णय की प्रतीक्षा कर रहे सत्रों के लिए इनबॉक्स जोड़ता है; A2UI एजेंटों को टेक्स्ट के बजाय स्क्रीन से जवाब देने देता है। हर उत्पाद अपने साथ आने वाले जोखिम को भी सीमित करता है: Grok Bot में हर व्यक्ति के लिए अलग अनुमतियाँ और सार्वजनिक चैनल में बोलने से पहले जाँच, Delta में निजी प्रीव्यू, और VS Code के सैंडबॉक्स में विशिष्ट अनुमतियाँ तथा छिपाए गए वेरिएबल।
स्रोत
- AlphaGenome 2 (Google DeepMind)
- AlphaGenome 2 (@GoogleDeepMind)
- AlphaProof Code का परिचय (Google DeepMind)
- Signal का औपचारिक सत्यापन (PDF, Google DeepMind)
- Qwen4-Max का प्रीव्यू (@Alibaba_Qwen)
- Token Plan (QwenCloud)
- Praxis-1 अब उपलब्ध है (Runway)
- Praxis-1 की तकनीकी रिपोर्ट (Runway)
- Praxis-1 संग्रह (Hugging Face)
- ElevenLabs Summit NYC (ElevenLabs)
- Summit की घोषणाएँ (@ElevenLabs)
- ElevenLabs और NVIDIA (ElevenLabs)
- सीमाओं का पूर्ण रीसेट (@ClaudeDevs)
- Grok Bot 1.0 (SpaceXSI)
- Grok Bot 1.0 (@SpaceXSI)
- ChatGPT में Advanced और Standard आवाज़ों को हटाना (OpenAI सहायता)
- Advanced और Standard आवाज़ों को हटाया जाना (@OpenAINewsroom)
- Apple CarPlay पर Gemini (blog.google)
- मॉडल के पूरे जीवनचक्र में CoT की निगरानी की क्षमता (OpenAI)
- जेफ़्री जी. वांग की पोस्ट शृंखला
- SPACE से बाहर निकलना: भाग II (Perplexity)
- SPACE से बाहर निकलना: भाग II (@perplexity_ai)
- Gemini Decision 1 (Google AI Studio)
- Decisions API (Google AI Studio)
- A2UI 1.0 (Google Developers Blog)
- Cloud Runners अब Delta में उपलब्ध हैं
- Cloud Runners का दस्तावेज़ीकरण (Delta)
- VS Code 1.146 के संस्करण नोट्स
- Qwen Code v1.0.0-preview (GitHub)
- BotPsy (Hugging Face पर QVAC)
- qvac/BotPsy-0.8B मॉडल (Hugging Face)
- टोकन पूलिंग को ध्यान में रखकर प्रशिक्षण (Hugging Face)
- 4K में Seedance 2.5 (@pika_labs)
- 4K में Seedance 2.5 (@runwayml)
- Git की सुरक्षा कमज़ोरियों की घोषणा (GitHub ब्लॉग)
- Zed v1.28.1 (GitHub)
- Antigravity का बदलाव विवरण
- Gemini CLI, PR 30228 (GitHub)
- Copilot CLI v1.0.110-1 (GitHub)
- Genspark में Gemini 4 Carbon (@genspark_ai)
- Basis और Devin for Startups (@cognition)
- आपका LLM अब एक कंटेनर है (Hugging Face)
- GitHub Apps से Copilot सीटों का प्रबंधन (GitHub बदलाव विवरण)
- निष्क्रिय रिपॉज़िटरी में Dependabot अलर्ट रोके जाएँगे (GitHub बदलाव विवरण)
- व्यक्तिगत खातों के लिए इश्यू के प्रकार और फ़ील्ड (GitHub बदलाव विवरण)
- अधिक जानकारी वाला GitHub डैशबोर्ड (GitHub बदलाव विवरण)
- Singapore Airlines (OpenAI)
- Cogent Security (OpenAI)
- JioStar, विजय शेषाद्रि (OpenAI)
- पूर्व सैनिकों के लिए ChatGPT Plus (OpenAI)
- ChatGPT में fal प्लगइन (@fal)
- Grok Bot में Gopuff (@bot)
- Genspark Genius (@genspark_ai)
- MiniMax H3, 100 दिन (@RyanLeeMiniMax)
- AI Engineer Paris में Voxtral Transcribe 3 (@MistralAI)
- Google AI Edge Gallery में स्थानीय वाणी (Google Developers Blog)
- Déjà View (@NVIDIAAI)
- स्पेनी नैदानिक पाठों में बीमारियों का पता लगाना (OpenMed)
- वॉलेट वाले खुले एआई मॉडल (Fizzl)
- FiftyOne में GR00T-X-Embodiment-Sim (Hugging Face)
- माइकल रोजर्स और टॉम मोरन (Sakana AI)
- एआई से पुनर्चक्रण करने वाले स्टार्टअप (NVIDIA ब्लॉग)
- एआई अनुपालन (Perplexity)
- MCP आर्किटेक्चर (Perplexity)
- Hacking Higher Ed (@cohere)