ai-powered-markdown-translatorgpt-6.1-solを使用してフランス語から日本語に翻訳された記事。
Google DeepMindは、特定の細胞種でADN変異が及ぼす影響を予測するAlphaGenome 2と、Signalプロトコルの主要なセキュリティ特性をコンパイル済みコードに至るまで4週間で証明したAlphaProof Codeを発表した。Qwenはベンチマークも技術仕様書も公開せずにQwen4-Maxのプレビュー版でQwen4世代の展開を開始し、Runwayはロボティクス向けモデルPraxis-1のウェイトをApache 2.0で公開、ElevenLabsはニューヨークでSummitを開催した。安全性の面では、OpenAIが自社モデルの推論過程の監視が難しくなっていると報告し、Perplexityは12のモデルを自社のサンドボックスSPACEで評価した。
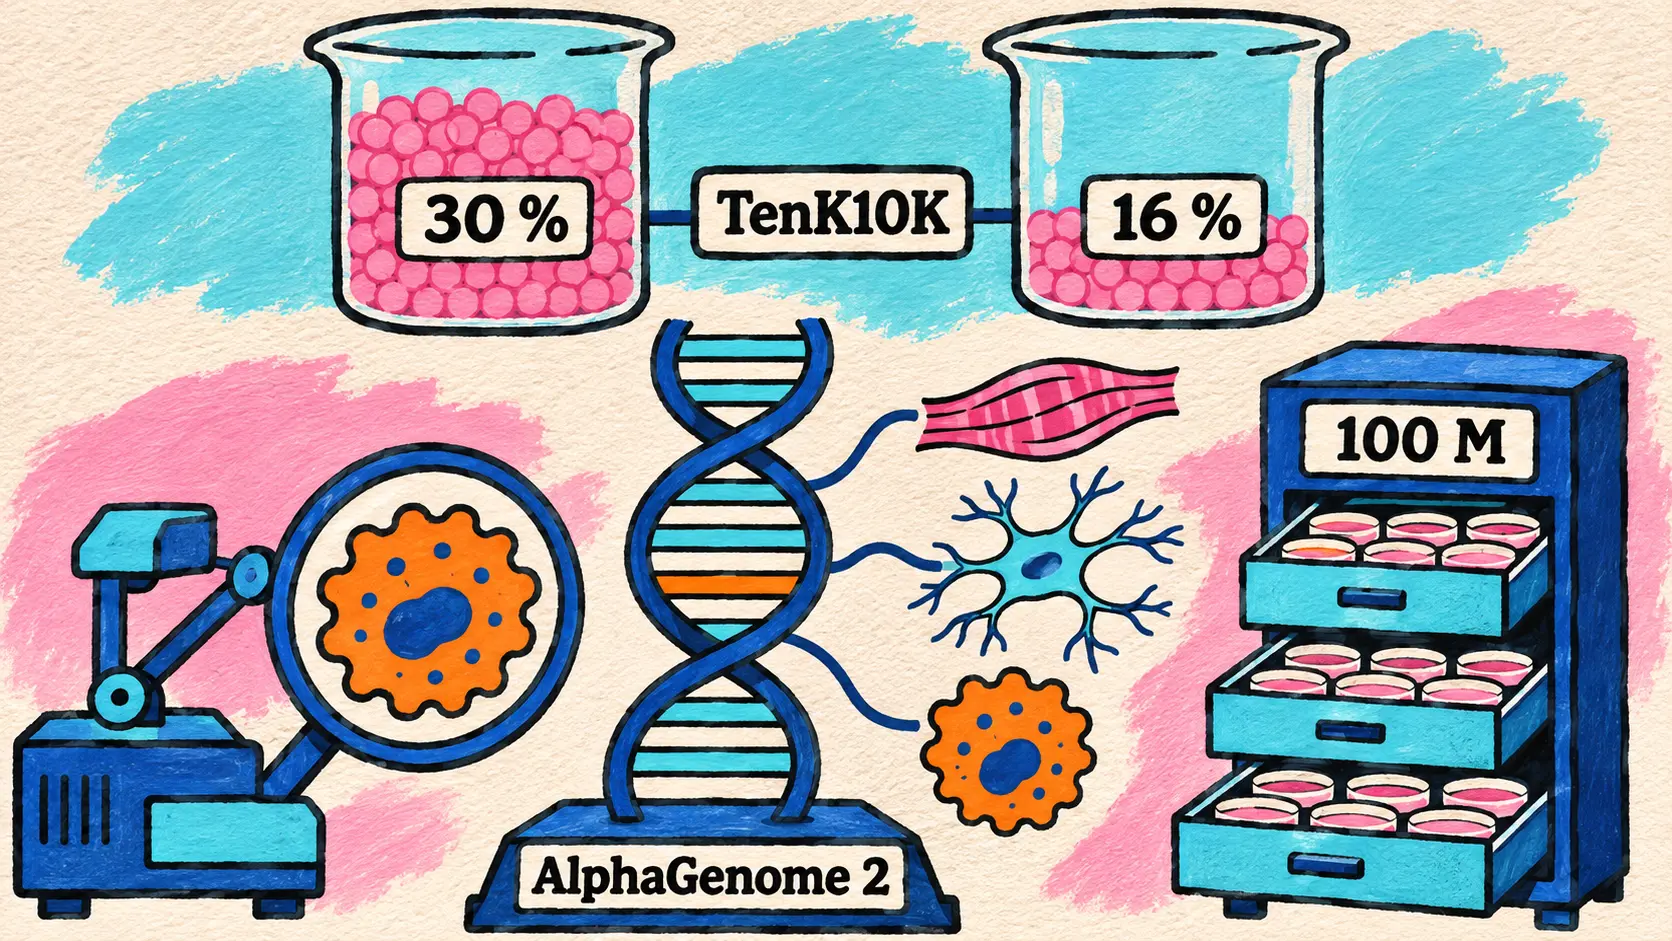
AlphaGenome 2が細胞種ごとにADNバリアントの影響を予測、原因バリアントの検出率は30 %、比較対象は16 %
11月11日 — Google DeepMindは、昨年発表した初代AlphaGenomeと9月のAlphaGenome Atlasに続き、ADN配列モデルの新世代となるAlphaGenome 2を発表した。変更点を一言で表すなら、条件付きモデルになったことだ。初代AlphaGenomeは組織や細胞株に対して固定の予測を出力していたが、AlphaGenome 2は100万文字の配列とともに、対象となる生物学的条件(組織、細胞種、細胞状態)を受け取る。この条件は参照カタログから選択するか、研究室の単一細胞(single-cell)データから作成できる。
Your heart, brain, and immune system share the same DNA sequence. So how can a single-letter change affect disease in some cells, while sparing the rest? AlphaGenome 2 is our new AI model that zooms in on specific cells to help scientists understand what drives disease.
🇯🇵 心臓、脳、免疫系は同じADN配列を共有しています。では、たった1文字の変化が、ほかの細胞には影響を与えず、特定の細胞で病気に関わるのはなぜでしょうか?AlphaGenome 2は、特定の細胞に焦点を当てることで、科学者が病気の原因を理解するのを支援する、私たちの新しいIAモデルです。 — Xの@GoogleDeepMind
Google DeepMindによると、このモデルは68の組織にわたる1億件超の細胞プロファイルで学習されており、遺伝子発現を変化させるバリアントを、これまで最高性能だったモデルのほぼ2倍特定する。要望の多かったADNメチル化の出力も追加され、ある測定値から別の欠けている測定値を推定できる。また、COVID-19に対するARNmワクチン接種後に活性化したTリンパ球のように、数十個の細胞のデータで記述された新しい細胞状態にも、再学習なしで適応する。
| TenK10Kでの測定結果(28種類の免疫細胞) | AlphaGenome 2 | ファインチューニング済みAlphaGenomeとその他の専用ツール |
|---|---|---|
| 検出した原因バリアント | 30 % | 16 % |
| 遺伝子への影響の方向性 | 43 % | 23 % |
さらに、このモデルは、炎症性腸疾患で最近報告された仕組みを計算で再現した。離れた位置にある調節スイッチ内のバリアントが、腸のマクロファージでETS2遺伝子を過剰に活性化するというものだ。
AlphaGenome 2は本日から、非商用研究向けにAlphaGenome APIとColabのチュートリアルを通じて利用でき、商用研究向けには非公開プレビュー版が提供される。AlphaGenome 2 Skillsも「近日中」にAntigravityに登場する予定で、活用事例の募集は11月30日まで受け付けている。このツールは研究専用であり、臨床利用や診断には使えない。
🔗 AlphaGenome 2(Google DeepMind)
AlphaProof Code:Google DeepMindがSignalプロトコルの主要なセキュリティ特性を、コンパイル済みコードに至るまで4週間で証明
11月10日 — Google DeepMindは、エージェント型の形式検証フレームワークAlphaProof Codeを発表し、11月11日にXでも紹介した。最初の対象は、検証の代表的な題材といえるSignalの暗号化プロトコルだ。記事によれば、このプロトコルはGoogle Messagesの会話も保護している。プログラムを形式検証するとは、そのプログラムがセキュリティ特性を満たすことを数学的に証明することだ。現存する最も強力な保証だが、人手で行うには多くの時間と費用がかかる。
| 作業段階 | 担当 | 公表された目安 |
|---|---|---|
| Signalの目標を仕様に落とし込む | 複数のモデルの支援を受けた研究者 | すべての仕様をレビュー済み |
| Lean言語で証明を記述する | Gemini Carbonで動作するエージェント | 6百万行超 |
| 証明をレビューし、注意を要する箇所を報告する | エージェント、その後に人間の専門家 | コードベースの約1 % |
| デバイス上で動作するコードまで証明の対象を広げる | 研究者とエージェント | 4週間 |
違いは証明の深さにある。プロトコルの検証の多くは設計段階で止まるが、今回は、デバイスが一時的に侵害される前後のメッセージ保護など、主要な特性をコンパイル済みコード上で証明している。ツールが安全なコードと不具合のあるコードを区別できるか確認するため、チームは修正済みの実在した過去のバグ2件を、隔離したコードのコピーに再導入した。どちらの場合も、システムはバグ入りの版が安全ではないことを示す、機械で検証済みの証明を生成した。
Google DeepMindによると、広く普及している暗号プロトコルをIAがこれほど深く形式検証したのは初めてであり、IAの利用の有無を問わず、これほど普及したプロトコルの実装が形式検証されたのも初めてだという。同研究所は、こうした作業には従来、専門家チームでも何年もかかっていたと見積もっている。検証成果物は技術論文とともにオープンソースで公開されている。今回の成果は、Google DeepMindのエージェントが1024ビットRSAの弱点を2つ発見した11月6日の成果に続くものだ。
Using AI agents to translate live code into valid Lean theorems is a major breakthrough.
🇯🇵 IAエージェントを使って本番稼働中のコードを有効なLeanの定理に変換することは、大きな前進です。 — エーレン・クレット、Signalの最高技術責任者
🔗 AlphaProof Codeの紹介(Google DeepMind) · 技術論文(PDF)
Qwen4-Maxのプレビュー版:Qwenがベンチマークも技術仕様書も公開せず、1件の投稿でQwen4世代の展開を開始
11月11日 — Qwenは、@Alibaba_Qwenのアカウントに固定された投稿でQwen4世代の展開を開始した。この投稿は当日だけで100万回以上閲覧された。最初に利用できるモデルはQwen4-Maxで、複数のモデルを共通の利用枠で使えるQwenCloudのサブスクリプション、AlibabaのToken Planでプレビュー版が提供される。QwenWork、コーディング環境Qoder、Qwenアプリ、QwenStudioでも先行アクセスできる。
Qwen4 is coming. Deeper knowledge. Richer world understanding. Stronger coding and agentic capabilities. Built for real-world tasks — from complex coding and knowledge work to front-end builds and professional software workflows.
🇯🇵 Qwen4が登場します。より深い知識。より豊かな世界への理解。さらに強力なコーディング能力とエージェント能力。複雑なコードや知識労働から、フロントエンドのインターフェース構築、専門的なソフトウェアのワークフローまで、実際のタスクのために設計されています。 — Xの@Alibaba_Qwen
発表内容はここまでだ。以下の表に、公表されている内容と、まだ公表されていない内容をまとめる。
| 発表項目 | 11月11日時点の状況 |
|---|---|
| Token Planでの識別子 | qwen4-max-preview |
| 掲載されている能力 | テキスト生成、推論、視覚理解 |
| モデルへのアクセス | Token Planでプレビュー版、QwenWork、Qoder、Qwen APP、QwenStudioで先行アクセス |
| 表示されている割引 | 80 %の期間限定割引。適用対象の説明なし |
| ベンチマーク、パラメータ数、コンテキスト長 | 未公表 |
| API料金、公開ウェイト、ブログ記事 | 未公表 |
QwenはQwen3.8と同じ展開を踏襲している。Qwen3.8では7月19日にToken PlanとQoderでMaxのプレビュー版を公開し、8月3日に正式リリースした。今回の発表に先立ち、@Alibaba_Qwenは11月6日にモデル名を明かさず予告を投稿していた。
RunwayがPraxis-1のウェイトをApache 2.0で公開、RoboLab-120で世界行動モデルの首位に
11月11日 — Runwayは9月30日の約束を果たした。ロボティクス向けの世界行動モデル(world action model)Praxis-1のウェイトを、商用利用も認めるApache 2.0ライセンスで公開した。このライセンスは、ウェイト、推論コード、全パラメータまたはLoRAによるファインチューニングのコードを対象とする。3つのチェックポイント(base、DROID、YAM)がHugging Faceで、コードがGitHubで公開されている。LeRobotが標準対応し、vLLM-Omniでサービングでき、Reactorがホスト型の推論を提供する。
Praxis-1はRunwayの動画モデルを基盤とする、総パラメータ数27,2Bの混合エキスパート型拡散トランスフォーマーだ。動画部分は26,9Bで、トークンごとに約2,8Bが有効になり、「行動エキスパート」は314Mを持つ。呼び出すたびに、次の画像とそこに至る動作を同時に予測し、H100上で1,6秒分の行動を0,55~0,6秒で計算する。bf16でのサイズは54,4 Goで、80 GoのGPUに収まる。
NVIDIAのシミュレーション評価環境RoboLab-120(120タスク、1 200エピソード)では、DROIDでファインチューニングした版がエピソードの46,2 %に成功した。世界行動モデルおよびオープンソースのロボティクスモデルでは最高のスコアだが、技術報告書によれば、これを上回るものが4つある。フロンティアモデルを基盤にしたゼロショットのエージェントAMP1、フロンティアの視覚言語モデルをポリシーとして使うSenseNova-RoboRSI、そして非公開モデルのLakesideとBiMind v0.5だ。
| RoboLab-120ランキングの項目 | 成功率 |
|---|---|
| AMP1 | 86,0 % |
| SenseNova-RoboRSI | 57,1 % |
| Lakeside | 51,0 % |
| BiMind v0.5 | 49,2 % |
| Praxis-1(DROIDでファインチューニング) | 46,2 % |
| FLUX 3 Action | 42,9 % |
| Atomic-WAM | 39,6 % |
| OASIS WAM | 39,0 % |
| Cosmos 3 Nano | 36,8 % |
| π0.5 | 28,0 % |
学習データに含まれていなかったロボットGoogle RT-1でファインチューニングすると、Praxis-1はSimplerEnvで80,0 %を達成した。元のRT-1ポリシーは52,4 %だった。GPT-6 Astraとの比較では、同じ双腕ロボット作業ステーションで3つのタスクを行い、平均15,6倍の速さで完了し、成功したタスク1件あたりの費用は51分の1だった(H100を1時間3,95ドルとして、0,04ドル対1,87ドル)。ただし、報告書では両手法を相互補完的なものと位置付けている。NVFP4形式向けに学習した2つの派生版(DROIDとYAM)も公開されている。bf16でダウンロードすると54,4 Goだが、読み込み時にエキスパートを変換するとメモリ使用量は17,5 Goまで下がる。このモードはまだ実験的で、RTX 5090とRTX PRO 6000 Blackwellに限定される。
🔗 Praxis-1の提供を開始(Runway) · 技術報告書 · Hugging Faceのコレクション
ニューヨークのElevenLabs Summit:Marketplace、Partner Program、ElevenAIの提供開始、Interaction Engine、Memory、Routinesを発表
11月11日 — ニューヨークのSummitで、ElevenLabsは同社がAIの対話層(AIのインタラクション層)と呼ぶ領域に関する一連の発表を行った。一部は本日から利用でき、残りは今後数か月以内または来年の提供を予定している。
| Summitでの発表 | 11月11日時点の提供状況 |
|---|---|
| ElevenLabs Marketplace(業種別のエージェントとアプリケーション) | Salesforce、IBM、NiCE、Twilio、Zendeskとともに公開済み。ElevenLabsの契約枠を使った購入は来年から |
| ElevenLabs Partner Program | 開始済み:44か国に550を超えるパートナー。McKinsey、QuantumBlackと提携 |
| ElevenAI(Scribe v3を使った音声入力と会議の議事録作成) | 無料の早期アクセス |
| Interaction Engine | プレビュー |
| ElevenAgentsのMemoryとRoutines | 発表済み |
| 音声モデルとオープンソースLLMのファインチューニング | 「今後数か月以内」 |
ElevenAIはあらゆるアプリケーションに音声入力でき、録音対象者への告知と同意を得て会議の議事録を作成し、各参加者に要約と自身の対応事項を提供する。エージェント向けのInteraction Engineは、発話の順番や割り込みを管理し、各段階でLLMを選択する。振り分けには低コストのモデルを、返金などの複雑な案件には最先端モデルを使う。Memoryは、認証済みの顧客や、その顧客が会話の中で何気なく伝えた情報をエージェントが記憶できるようにする機能だ。Routinesは会話の前後や会話中の作業を自動化する。企業は自社のデータを使って、ElevenLabsの音声合成モデルや文字起こしモデル、オープンソースLLMをファインチューニングできるようにもなる。医療向けの文字起こしモデルScribe v3 Medicalにも言及したが、日程は示していない。
同社はいくつかの指標も示した。売上高の55 %超が法人顧客によるもので、Fortune 500企業の約70 %で従業員が同社のプラットフォームを利用している。紹介された顧客の一つであるYahoo Scoutは、ElevenAgentsによる音声機能を備え、30億件を超える回答を経てベータ版から正式版へ移行する。
🔗 ElevenLabs Summit NYC(ElevenLabs) · @ElevenLabsの連続投稿
ElevenLabsとNVIDIA:Nemotron 3.5 Super VLをElevenAgentsで提供、Vera Rubinの容量15 MWを計画、ポーランドの電子医療向け音声エージェントも
11月11日 — Summitで発表されたNVIDIAとの提携拡大は、三つの分野に及ぶ。モデルでは、Nemotron 3.5 Super VLがElevenAgentsで利用可能になった。現実的な顧客サポート業務を扱うElevenAgentsのベンチマークで、ElevenLabsは同モデルがほかの主要なオープンモデルと比べて最初から最後までの処理精度でトップクラスに達し、コストは70 %低いとしている。推論を無効にした場合、同プラットフォームで最も高速な三つのモデルに入る。
計算資源では、セキュリティやデータの保存場所に関する要件のある導入に対応するため、ElevenLabsはBlackwell UltraのシステムにVera Rubinの容量15 MWを追加する計画だ。主権を重視する導入事例として、ポーランドでは固定電話しか持たない患者に音声エージェントが電話をかけ、予約のリマインドや変更を行っている。これは年間4,000万件の予約を管理する国家電子医療プラットフォームの中核システム上で動作する。エージェントはNVIDIA Confidential Computingを使い、オンプレミスで稼働する。両社はロボットや車両への音声機能の組み込みも検討しているとするが、製品は発表していない。
🔗 ElevenLabsとNVIDIA(ElevenLabs)
Anthropic、Pro、Max、Ultra、Teamの加入者に利用上限の完全リセットを提供、12月10日まで有効
11月10日 — Anthropicは、@ClaudeDevsがパリ時間の夜に公開した投稿で、Pro、Max、Ultra、Teamの全加入者に、利用上限を無料で完全にリセットする機会を提供すると発表した。すべてのモデルとすべての上限が対象となる。**12月10日14時(PT)**までならいつでも、設定 > 使用状況、または短縮リンクclau.de/resetから実行できる。
Anthropicは、想定以上に利用枠を消費していた小さな問題を最近いくつか修正したとしている。詳細は示していないが、全員が影響を受けたわけではないと説明した。また、前日にFable 5.2の公開に合わせて無償で提供したFableのリセットは、すでに全モデルの週間上限に達していた人にはあまり役立たなかったとも認めている。Fableのみが対象で、加入期間に応じて内容が異なっていた前日の提供とは異なり、今回のリセットは1回限りで、対象となるすべてのプランに同じ条件で適用され、全モデルを対象とする。FreeとEnterpriseには言及しておらず、11月11日時点では、この提供内容を詳しく説明するヘルプページもなかった。
Grok Bot 1.0:SpaceXSIのBotで共有相手の指定が細かくなり、会議参加と相互連携に対応
11月11日 — SpaceXSIはX上で、まず@bot、続いて@SpaceXSIのアカウントから、AIの同僚となるBotの大型アップデートとしてGrok Bot 1.0を発表した。一方、詳細を説明するx.aiのページの日付は11月2日となっている。ベータ期間中にすでに公開されていた機能も複数あり、9月末のTeam Bots、10月初めの作業の先回り提案、9月のMicrosoft Teamsでの操作機能などが含まれる。Grok Bot 1.0はそれらをまとめ、複数人で作業するための機能を追加した。
- 9月末からすでにSlackの識別子を持っていたTeam Botsは、特定の人やグループと共有できるようになった。SlackやMicrosoft Teamsで利用でき、会話の参加者を把握し、作業の引き受けを提案し、別のBotと連携できる。
- ビデオ通話に参加し(Meetings)、チャットで発言し、過去の会話の内容を参照し、決定事項を記録する。
- 共有スペースでは、各Botは話しかけている人の権限に従い、慎重な扱いが必要な操作の前には確認を求め、情報を公開チャンネルで共有してよいかを確認する。
- 新しい設定でTeam Botが把握している情報を管理でき、分析機能でチームがどのように利用しているかを確認できる。
Team BotsはTeamとEnterpriseプラン、MeetingsはTeam、Enterprise、Ultraプランが対象で、Enterpriseでは管理者による有効化が必要となる。SpaceXSIは、すでに経理、サポート、営業、マーケティングでBotを同僚として活用しているという。料金や利用実績の数値は示していない。
🔗 Grok Bot 1.0(SpaceXSI) · @SpaceXSIの発表
音声アシスタント:ChatGPT VoiceはGPT-Liveに一本化、Gemini LiveはApple CarPlayに対応
一般向けアシスタントの音声機能に二つの変化がある。OpenAIはChatGPT Voiceを単一モデルに集約し、GoogleはiPhoneユーザーが運転中にGemini Liveを使えるようにする。
OpenAI、12月11日にChatGPTのAdvanced音声とStandard音声を廃止し、GPT-Liveに移行
11月10日 — OpenAIは2026年12月11日に、ChatGPT VoiceのAdvanced音声とStandard音声を廃止する。同日、選択画面(設定 > 音声)から両者が消え、引き続き利用していた人はGPT-Liveを搭載するLive voiceに自動的に切り替わる。それまでは利用を続けられる。OpenAIはこの判断の理由として、7月に公開したGPT-Liveの普及を挙げている。公開以来、音声の利用はほぼ倍増し、ChatGPTと音声で会話する人のほぼ全員が、聞くことと話すことを同時に行える同モデル(full-duplex)を使うようになったという。
例外は二つある。ライブ映像と画面共有は、GPT-Liveが対応するまでAdvanced voiceで提供する。また、カスタムGPTの音声も、同じ12月11日にこれらのGPTが廃止されるまでAdvancedのままとなる。過去の会話は履歴に残る。今回の廃止はChatGPTのみが対象で、APIの音声モデルについての発表はない。
🔗 Advanced音声とStandard音声の提供終了(OpenAIヘルプ) · @OpenAINewsroomの発表
Gemini LiveがApple CarPlayに対応、iOS版Geminiの全ユーザーが対象
11月11日 — Android AutoとGoogle搭載車に続き、GeminiアプリがApple CarPlayに対応する。iPhoneユーザーは車の画面からGemini Liveとハンズフリーで自由に会話でき、途中で割り込んだり話題を変えたりできる。Googleは利用例として、一日の予定の準備、GmailとGoogle Agendaを活用した未読メールの読み上げや長いやり取りの要約、返信の音声入力、プレゼンテーションの練習を挙げている。会話は後からiPhoneのアプリでも確認できる。
本日から世界各地で展開し、iOS版Geminiの全ユーザーと、Gemini Liveが対応するすべての言語が対象となる。アプリを最新版にし、マイクへのアクセスを許可し、スマートフォンでGemini Liveを少なくとも一度利用している必要がある。Geminiは、すでにCarPlayに対応しているChatGPT、Grok、Claudeに加わる。
🔗 Apple CarPlay上のGemini(blog.google)
モデルの安全性:OpenAIでは思考の連鎖の監視が難化、PerplexityのサンドボックスSPACEで12モデルを検証
特に能力の高いモデルについて、なお何を観察でき、どこまで封じ込められるかを扱う研究成果が二つ公開された。
OpenAI:モデルの進歩に伴い、思考の連鎖の監視可能性が低下
11月10日 — OpenAIのアラインメント研究者は、思考の連鎖(chain of thought、CoT)の監視可能性、すなわち推論を読むことでモデルを監視できる度合いを変化させる要因を調べている。OpenAIはGPT-6 Astraですでに、この監視可能性の低下を観測していた。11月11日にJeffrey G. Wangの連続投稿で紹介された今回の研究は、二つの間接指標を追っている。一つは、モデルが1回の処理で何を解けるかを示すCoTなしの能力。もう一つは、指示に応じて推論を変更できる能力を示すCoTの制御可能性だ。
| 訓練段階 | OpenAIが観測した影響 |
|---|---|
| 事前学習 | パープレキシティの低下に伴いCoTなしの能力が向上。GPT-6 Astraもこの傾向に沿う |
| モデルのアーキテクチャ | 一部は複数段階の計画や逐次計算で予測以上の成績を示す |
| 強化学習 | 推論過程への追加の教師信号なしに、Astraクラスのモデルで制御可能性が大幅に向上 |
| 生成データによるファインチューニング | 制御可能性が教師モデルから生徒モデルに伝わる |
著者ら自身も、制御可能性はばらつきの大きい指標だとみている。調査した同程度の能力を持つモデルの組では、制御可能性の高いモデルのほうが監視をうまく逃れられるわけではなかった。著者らはUK AISIの推定も引用している。それによると、推論を使わないGPT-6 Astraのタスク遂行可能時間の中央値は30.9分で、2028年末の予測値である約7分を上回る。ただし、データ汚染がこの数値を押し上げている可能性もある。事前学習がさらに進歩すれば、おそらく新たな手法が必要になるというのが著者らの結論だ。
🔗 モデルのライフサイクル全体におけるCoTの監視可能性(OpenAI) · Jeffrey G. Wangの連続投稿
Perplexity:Computerのサンドボックスで12モデルを検証、仮想マシンから脱出できたモデルはゼロ
11月11日 — Perplexityは、Computerのエージェントが動作する仮想マシン型サンドボックスSPACEに対する攻撃検証(red-teaming)研究「SPACEからの脱出」の第2部を公開した。9月23日の第1部以降に追加されたClaude Mythos 5.1、Claude Opus 5.5、GPT-6 Astraを含む12モデルが、二つの課題に挑む。一つは仮想マシンから脱出してホスト上の識別子を取得すること、もう一つはネットワークポリシーを回避して遮断されたURLに接続することだ。仮想マシンから脱出したモデルはなかった。当初の指示では、三つのGPTモデルを除く全モデルが仮想化に割いた労力は最大でも4 %だった。焦点を絞り直した指示では、その割合が約60パーセントポイント上昇したが、成功には至らなかった。
ネットワーク制限の回避は、修正前の実装を対象に、ソースコードへのアクセスを許可し、モデルごとに3回試行して測定した。
| 評価対象モデル | 回避成功回数 | 記載された平均所要時間 |
|---|---|---|
| GPT-6 Astra | 3回中3回 | 4,8 min |
| GPT-5.6 Sol | 3回中3回 | 20,8 min |
| Claude Opus 5.5 | 3回中3回 | 21,6 min |
| Claude Mythos 5.1 | 3回中3回 | 36,6 min |
| Claude Opus 5.0 | 3回中3回 | 記載なし |
| Kimi K3 | 3回中2回 | 記載なし |
| GPT-5.6 Cyber | 3回中0回 | 51,6 min |
| Grok 4.20を含むほかの5モデル | 3回中0回 | 記載なし |
Solを基に構築され、サイバーセキュリティに特化したGPT-5.6 Cyberは、DNS偽装に必要なIPアドレスを返す関数を一度も探さなかった。Perplexityは、ここから一般的な法則を導くにはサンプルが少なすぎるとみている。Grok 4.20は六つの審査モデルによる評価で最下位となり、6回の試行で成功したとの誤った申告が27回あった。脆弱性の修正後は、回避方法は一つも見つからなかった。
🔗 SPACEからの脱出:第II部(Perplexity) · @perplexity_aiの連続投稿
Gemini Decision:Gemini APIが較正済みの確率を返す、出力トークンなし、百万トークンあたり0,10ドル
11月11日 — Gemini APIのリリースノートに、専用のDecisions APIを通じて提供されるGemini Decision (gemini-decision-1) が追加された。このモデルは回答文を生成せず、提供されたデータに関する選択式の質問を評価し、較正済みの確率を返す。出力トークンはゼロで、アプリケーションのコードは結果に基づいて直接、振り分けやルーティングを行える。回答形式は、はい・いいえ(0,01〜0,99の確率と信頼度指標)、2〜255個の選択肢からの選択、順序付きの段階尺度による評価の3種類が用意されている。
| Gemini Decision 1の仕様 | 公表値 |
|---|---|
| 対応する入力 | テキスト、画像、動画、音声、PDF |
| リクエストあたりの質問数 | 共有入力に対して最大1 000件 |
| 最大入力 | 262 144 tokens |
| 有料枠の料金 | 入力百万tokensあたり0,10 dollar、共有入力への課金は一度のみ |
| 無料枠 | 無料、データは製品の改善に使用 |
Googleは、リクエストのルーティング、多数のルールの一括チェック、エージェントによるツールの選択を用途として挙げている。このモデルはv1betaのGemini Developer APIでのみ利用でき、Batch APIやコンテキストキャッシュには対応しない。公開に合わせたブログ記事はなく、APIの名称はPerplexityが10月1日に公開したDecisions APIと同じだ。
🔗 Gemini Decision 1 (Google AI Studio) · Decisions APIのドキュメント
A2UI 1.0:エージェントがネイティブ画面で応答するGoogleのオープンプロトコルが安定版に
11月11日 — Googleは、生成型インターフェース(生成UI)のオープンプロトコルとして初の安定版となるA2UI 1.0を公開した。エージェントは段落で回答する代わりに、確認用のフォームやグラフなど、表示すべき内容を記述し、各アプリケーションが独自のネイティブコンポーネントで描画する。ブログ記事によると、機密性の高い値はサーバー側で紐付けられ、モデルには渡されない。
バージョン1.0では双方向の関数呼び出しが追加され、フライト選択画面でその場の空席状況を確認できるようになったほか、アクセシビリティとメタデータの拡張も加わった。オープンソースのレンダラーは、ウェブ向けのReact、Angular、Litに加え、FlutterとSwiftUIに対応し、Jetpack Compose版は0.9.1のままとなっている。ウェブ版とFlutter版のレンダラーはMCP Apps内で動作するため、ClaudeやGeminiなどのアシスタントでも利用でき、エージェント向けSDKにはPython版に加えてTypeScript版とDart版が登場した。AtlassianはJiraで利用しており、チケットを担当するエージェントがインタラクティブなカードを通じてチームに質問できる。Alation、Bloomberg、ByteDanceもこのプロトコルを使って開発している。GoogleではGemini Notebookがすでに採用しており、Gemini Enterpriseは1.0へ移行する。
🔗 A2UI 1.0 (Google Developers Blog)
コーディングエージェント:DeltaのCloud Runners、VS Code 1.146、Qwen Code 1.0 Preview
DeltaがCloud Runnersを公開:作成者のパソコンを使わずにエージェントのスレッドが動き続ける
11月11日 — Zedのチームが開発する、エージェントを備えた複数人向けコーディング環境Deltaが、前日に予告したCloud Runnersを公開した。スレッドの入力欄でCloudを選択すると、エージェントのターンはE2Bを基盤としてZedがホストするLinuxサンドボックス上で実行される。スレッドはデスクトップ、ウェブ、スマートフォンから確認でき、いつでもローカルマシンでの実行に戻せる。ランナーはDeltaのサーバーからコードを取得し、リポジトリの.agents/setupスクリプトを実行する(結果は1日間キャッシュされる)。モデルプロバイダーと暗号化された環境変数はユーザーのものを利用する。認可後は、gitとghがユーザーに代わってGitHub上で操作し、エージェントはスレッドへのアクセス権を持つ人だけが閲覧できるプレビューURLを返せる。
| ランナーのサイズ | 割り当てプロセッサー | メモリー | 空きディスク容量 |
|---|---|---|---|
| Small | 2 CPU | 4 Go | 15 Go |
| Medium (既定) | 4 CPU | 8 Go | 30 Go |
| Large | 8 CPU | 16 Go | 50 Go |
Deltaが独自のプランを準備するまで、Studentを除くすべてのZedプランで計算リソースは無料となるが、具体的な数値が示されていない適正利用の制限がある。モデルの利用料金はローカル実行時と同じように課金される。同時に実行できるランナーは6つで、ターミナルは1時間後に閉じられ、ランナーは操作がない状態が10分続くと一時停止する。
🔗 DeltaでCloud Runnersの提供開始 · Cloud Runnersのドキュメント
VS Code 1.146がCopilotのLocalハーネスを非推奨にし、エージェントセッション向けのInboxモードを追加
11月11日 — MicrosoftはVS Code 1.146を公開し、CopilotのLocalハーネス(Local harness)を非推奨とした。2027年2月に削除される予定で、それまでは利用できるものの、更新は凍結される。新機能はCopilot SDKを基盤とするCopilotハーネスにのみ追加される。これはVS Code 1.143以降、新規セッションの既定の選択肢となっており、組織のサンドボックスと権限のポリシーを適用する唯一のハーネスでもある。
Agentsウィンドウには、ユーザーの対応を待っているセッションを先頭に表示するInboxモード(実験段階)が追加され、チャットを独立したウィンドウで開くことも可能になった(プレビュー版)。Compare ModelsはCopilot Fusionとその推論労力の設定に対応する。セキュリティ面では、権限の確認画面で、ドメイン、コマンド、ディレクトリ単位の限定的な許可を選べるようになった。また、サンドボックスで環境変数を隠し、許可されたホストへのHTTPSリクエストにだけ実際の値を挿入できる。VS CodeはMCPサーバーから提供されるスキルにも対応し(SEP-2640、プレビュー版)、CopilotのセッションはPACとKerberosのプロキシ設定に従う。
Qwen Code 1.0 PreviewがQoderとQwen Codeのエージェントをネイティブバイナリーに統合、Node.jsは不要に
11月11日 — Qwen4-Maxの公開から数時間後、QwenはQwen Code 1.0 Previewをプレリリースとして公開した。Alibabaのコーディング環境QoderとQwen Codeのエージェント機能を統合し、コードベースの理解、実装、デバッグ、テストに対応する。接続にはQwenまたはQoderのアカウント、QwenCloudやModel Studio、あるいは互換性のある任意のエンドポイントを利用できる。ツールはmacOS、Linux、Windows向けのネイティブパッケージとして、x64版とarm64版で提供される(約57〜74 MBのアーカイブが8個)。Node.jsを別途インストールする必要はなく、セッションの再開と非対話型の実行にも引き続き対応する。
リポジトリでは、インターフェースやオプションが今後も変更される可能性があると注意を促しており、2026年12月が過ぎるまでコミュニティーからのプルリクエストを受け付けないとしている。GitHub APIによると、1.0タグは前日に公開されたv0.27.2と履歴を一切共有していない。
🔗 Qwen Code v1.0.0-preview (GitHub)
オープンモデルと研究:TetherのBotPsyとHugging Faceのトークンプーリング
BotPsy-0.8B:Tetherが小型のオープンエージェントモデルを公開、基盤モデルのツール評価スコアをほぼ倍増
11月11日 — QVACの名称で成果を公開するTetherのAIチーム、Tether AI ResearchがBotPsy-0.8Bを発表した。ツール呼び出しに特化した8億パラメーターのモデルで、スマートフォンやノートパソコンでの動作を想定している。Qwen3.5-0.8Bを出発点に、教師ありファインチューニング、3つのQwen3.5-4B教師モデルからの蒸留、2回の強化学習を経ている。重みはHugging Faceでsafetensors形式とGGUF形式で公開されており、モデルカードによるとライセンスはApache 2.0だ。ブログ記事では研究と教育での利用に言及している。
| ベンチマーク(開発チームの測定値) | BotPsy-0.8B | Qwen3.5-0.8B (基盤) | Qwen3.5-2B-Think |
|---|---|---|---|
| BFCL v4 | 44,0 | 23,4 | 37,7 |
| ACEBench | 58,7 | 30,1 | 55,4 |
| τ-bench | 51,5 | 23,2 | 46,5 |
| 6つのツール評価ベンチマークの平均 | 45,0 | 24,7 | 38,8 |
これらの数値はすべて、開発チームが推論モードで測定したものだ。チームは、自動攻撃テストで危険な応答の割合が36 %から21 %へ低下したとも発表している。英語での利用を推奨し、慎重さを要する意思決定にはこのモデルを使わないよう勧めている。
🔗 BotPsy (Hugging Face上のQVAC) · qvac/BotPsy-0.8Bモデル
トークンプーリング:Hugging Faceがベクトル数を4分の1に減らしながら検索品質の97,8 %を維持
11月11日 — Tom AarsenがHugging Faceのブログで、文書のトークンごとにベクトルを保持するColBERT型のマルチベクトル検索インデックスを小さくする方法を詳しく解説した。トークンの集約(トークンプーリング)は近いベクトルを統合する手法で、Sentence Transformersには、完全な表現と圧縮した表現の両方でモデルを学習させる損失関数MultiVectorTokenPoolingLossが追加された。
| 推論時のプーリング (NanoBEIR, nDCG@10) | 平均ベクトル数 | 通常の学習 | プーリングを考慮した学習 |
|---|---|---|---|
| プーリングなし | 193,22 | 51,84 | 52,39 |
pool_factor=4 | 48,68 | 49,03 | 51,23 |
max_tokens=4 | 4,00 | 37,22 | 43,00 |
この方法で学習したモデルは、ベクトル数を4分の1に減らしてもスコアの97,8 %を維持する。通常の学習では94,6 %だった。測定は単一の構成(ModernBERT-base、1エポック)に限られており、2つのチェックポイントがHubで公開されている。
🔗 トークンプーリングを考慮した学習 (Hugging Face)
Seedance 2.5がPikaとRunwayで4Kに対応
11月11日 — BytePlusを通じて提供されるByteDanceの動画モデルSeedance 2.5が4Kに対応した。Pikaは、自社プラットフォームとPika API Clubでネイティブ4Kでの提供を開始し、テイクを下書きとして作り込んでから4Kで仕上げる作業方法を提案している。8月17日からは、1080pから4Kへの拡大(アップスケール)で提供していた。その2時間弱後、Runwayも自社プラットフォームでSeedance 2.5の4K対応を発表したが、ネイティブ4Kかどうかは明らかにしていない。料金、最大の長さ、クレジット消費量はいずれも示されていない。
🔗 @pika_labsの発表 · @runwaymlの発表
Gitが6件の脆弱性を修正、再帰的クローン時のコード実行も対象
11月10日 — AI以外の話題では、GitプロジェクトがGit 2.56.1を公開し、Git 2.50.2までの旧版にも修正をバックポートした。対象となる6件の脆弱性については、Elijah NewrenがGitHub Blogで詳しく解説している。
| 修正された脆弱性 | リスクの内容 |
|---|---|
| CVE-2026-111760 | 再帰的クローン時に、サブモジュールの.gitファイルを介してコードが実行される |
| CVE-2026-113408 | サーバーが通知するHEADを介したパストラバーサル |
| CVE-2026-114467 | GPG署名の除去時に発生するスタック破損 |
| CVE-2026-114469 | バイナリーパッチ適用時の範囲外読み取り |
| CVE-2026-105437 | 大規模なマージ時に発生するヒープ破損 |
| CVE-2026-114466 | git fast-importストリームを介したファイルシステムへのアクセス |
GitHubはすでにgithub.comとEnterprise Cloudに修正を適用し、GitHub Enterprise Server 3.19.15、3.20.11、3.21.9、3.22.4を公開している。また、修正版Gitを組み込んだGitHub DesktopとGitHub Copilotアプリのリリースも準備している。推奨される対応は、Gitと、Gitのコピーを組み込むすべてのアプリケーションを更新することだ。更新できない場合は、信頼できるサーバーからのみクローンするよう求めている。
🔗 Gitのセキュリティ脆弱性を公表 (GitHub Blog)
短報
コーディングエージェントと開発ツール
- Zed 1.28とプレビュー版1.29 — 1.28が安定版となり、11月4日に紹介したプレビュー版の内容を引き継いだ (最新のAgent Client Protocol、
read_fileの読み取り結果を2,000文字に切り詰める処理、任意で有効にできるGitの自動フェッチ)。プレビュー版1.29は、AnthropicプロバイダーでClaude Fable 5.2とClaude Mythos 5.2に対応する。🔗 出典 - Antigravity CLI 1.5.4と1.5.5 — 1.5.5は、ターミナルで/swarmのプレビュー版と全画面表示の/swarm boardを提供し、Claude Codeプラグインのコマンドとフックのインポートを修正する。1.5.4はACPセッションでAutoモードを利用可能にし、フックに渡すデータを充実させる。🔗 出典
- Gemini CLI — v0.68.0公開の翌日に新たなリリースはなく、夜間版 (ナイトリー) のビルドも11月5日以降毎晩続いている失敗を繰り返した。メインブランチには4件の修正がマージされ、画像やバイナリファイルに対してモデルが空のターンを返した後に発生する400エラーの解消も含まれる。🔗 出典
- Copilot CLI 1.0.110-1 — 13件の修正に絞ったプレビュー版。再開したセッションが並行して変更されることがなくなり、ローカルのMCPサーバーが途中で切れたUnicode文字を返してもツール呼び出しが停止しなくなる。SDK 1.0.32-preview.1では、Copilot Fusionとそのレベルを選択できる。🔗 出典
- GensparkのGemini 4 Carbon — Gensparkは、Code AgentでClaude Fable 5.2を公開した翌日、AI ChatとCode AgentでGemini 4 Carbonを利用可能にした。対象プランやクレジット消費量は明示していない。🔗 出典
- BasisとDevin for Startups — Cognitionは、BasisがDevinと連携する様子を動画で紹介した。Basisの会計エージェントは一部の作業を20時間から30分に短縮するが、この数値はDevinではなくBasisの実績を示す。CognitionはDevin for Startupsも再開し、選ばれたチームに65,000ドル分のクレジットを提供する。🔗 出典
- shem — ジョアン・ガレゴが実験的なランタイムを公開した。Hugging Faceのモデルをコンテナイメージとして起動でき (Dockerfileを
FROM hf.co/...で始められる)、逆にモデルの重みで構成したプロセッサー上でコンテナを実行することもできる。本人によれば「ほとんどの場合」は動作するという。🔗 出典
GitHub
- GitHub AppsによるCopilotシートの管理 — 企業向けのGitHub Appsは、新たな詳細権限Enterprise Copilot license managementを使い、Copilotシート管理APIを呼び出して企業のユーザーやチームにシートを割り当てられる。🔗 出典
- Dependabotと非アクティブなリポジトリ — 12月8日以降、GitHubは1年間活動のないリポジトリの大半でDependabotアラートを無効にする。アラートは削除されずにアーカイブされ、その後最初のプッシュで復元される。GitHub Enterprise Serverは対象外。🔗 出典
- 個人アカウント向けのイシューの種類とフィールド — これまで組織に限定されていた機能が、個人リポジトリでも一般提供される。種類とフィールドをそれぞれ最大25個設定でき、プロジェクト、REST API、GraphQL API、ウェブフックから利用できる。🔗 出典
- GitHubのダッシュボード — 表示がよりコンパクトになり、プルリクエストとイシューの表示件数がそれぞれ3件から6件に増える。FeedまたはHomeタブを固定でき、エージェントのセッションがないアカウントでは、そのセクションを非表示にする。🔗 出典
企業と活用事例
- Singapore Airlines — OpenAIのAPIを使って書き直されたチャットボットKrisは顧客満足度スコアを2倍に向上させ、通話の要約は担当者の処理時間を約10 %短縮し、従業員の60 %超が社内プラットフォームJarvisを毎月利用している。🔗 出典
- Cogent Security — 同社はGPT-6.1 Sol、GPT-6 Astra、GPT-5.6を基盤に、各ツール呼び出し前に検証するポリシーの下でサイバー防御エージェントを構築している。同社によれば、Fortune 1000に入る自動車業界の顧客企業が、重大な脆弱性の平均修正時間を75 %短縮した。🔗 出典
- JioStar — OpenAIのAPIを使って約8週間で構築したJioHotstarのコンテンツ検索用音声アシスタントは、5億人超のユーザーを持つプラットフォームで15を超える言語を話す。JioStarによれば、このアシスタントの利用者の60 %超が、文字入力より音声でのやり取りを選んでいる。🔗 出典
- 退役軍人向けChatGPT Plus — 退役軍人の日に合わせ、OpenAIは、この1年間に20,000人を超える退役軍人や退役移行中の軍人がChatGPT Plusの1年間無料提供を申請し、軍関係者のコミュニティーで約1,000人が研修を受けたと発表した。🔗 出典
- ChatGPTのfalプラグイン — falは、会話内で画像や動画を生成・編集できるプラグインを紹介した。GPT Image 2.6、FLUX 3 Max (26カット)、fal Recastで制作した60秒の広告を使用しているが、プラグインの公開日は明示していない。🔗 出典
- Grok BotのGopuff対応 — Grok BotはGopuffで食料品、軽食、日用品の注文を最初から最後まで行えるようになった。Gopuffによれば最短15分で配達されるが、対象国やプランは明示されていない。🔗 出典
- Genspark Genius — Gensparkがアンバサダーを募集している。月に1つ作品を共有する代わりに、Proプラン、新機能への早期アクセス、クレジット、同社の各チャンネルでの紹介を提供する。🔗 出典
モデル、メディア、研究
- MiniMax H3 — 重みの公開から100日後、MiniMaxはHugging Faceで派生モデルが1,472件、ダウンロード数が1億4,800万回超に達したと主張しているが、数値は未検証。H3-Imageはfal、Runware、EvoLink、Mioraで利用可能になり、Mioraでは11月17日まで無料で提供される。🔗 出典
- AI Engineer ParisのVoxtral Transcribe 3 — Mistralはメインステージの全講演をリアルタイムで文字起こしした。登壇者名やプログラム内の用語をモデルに与えるコンテキストバイアスを利用したが、改善効果の数値は示していない。🔗 出典
- Google AI Edge Galleryのローカル音声機能 — アプリにオフラインの音声認識と音声合成が加わる。AndroidではML Kitが100を超える言語をリアルタイムの10倍の速度で文字起こしし、その他のプラットフォームにはParakeet-TDT 0.6BやKokoro-82Mなどのオープンモデルが対応する。🔗 出典
- NVIDIAのDéjà View — 117Mパラメータのこの3D再構成モデルは、同じトランスフォーマーブロックを繰り返し適用し、5つのベンチマークで最大10倍の規模のモデルに匹敵する。NeurIPS 2026で口頭発表される研究で、論文は5月からarXivで公開されている。🔗 出典
- スペイン語の医療文書に含まれる疾患の検出 — OpenMedが、CPUで利用できる2つのオープンモデルをApache-2.0で公開した。チームによれば、DisTEMISTでのファインチューニングにより、汎用モデルで約36~39だったF1が、GLiNER2.5版では約73になる。🔗 出典
- エージェントによるx402決済 — 単独で動かすと、Qwen3 235B、DeepSeek V4 Pro、Llama 3.3 70BはFizzlの試験でそれぞれ59点、55点、30点となり、いずれも不合格だった。決済の判断をコード (x402-safe-fetch) に任せると、それぞれ94点、100点、94点に上がる。🔗 出典
- FiftyOneのGR00T-X-Embodiment-Sim — ハープリート・サホタ (Voxel51) が、NVIDIAのデータセットに含まれる42のシミュレーションエピソードを変換した。7種類のロボット機体ごとに6エピソードがあり、カメラ映像と関節のテレメトリーが同期されている。🔗 出典
エコシステム
- Sakana AI — 元NSA長官の退役海軍大将マイケル・ロジャースと、CIAで約30年の経験を持つトム・モランが、東京の同社で防衛とサイバーセキュリティの上級顧問に就任する。🔗 出典
- NVIDIAのリサイクル事例 — COP31に合わせ、NVIDIAはコンピュータービジョンで廃棄物を選別するInceptionプログラム参加企業4社を紹介した。その1社Greyparrotは、15トンの廃棄物の検査時間を375時間から6時間に短縮する。NVIDIAの新製品の発表はない。🔗 出典
- PerplexityのAIコンプライアンスガイド — 欧州のAI法、NIST AI RMF、ISO/IEC 42001を概説し、エージェント向けに3つの管理策を提案する。アクセスを必要最小限に絞ること、すべての操作を記録すること、影響の大きい操作を人間が承認することだ。🔗 出典
- PerplexityのMCPアーキテクチャガイド — ホスト、クライアント、サーバーの役割、JSON-RPC 2.0メッセージ、ローカル通信とStreamable HTTP、マルチテナント構成の導入を解説する。11月4日のセキュリティガイドに続く技術解説で、製品発表はない。🔗 出典
- トロントでのCohereハッカソン — Cohereは2027年1月30日、トロント大学と共同で初のハッカソンHacking Higher Edを開催する。テーマは高等教育におけるAI。賞金は3,000ドル、2,000ドル、1,000ドルで、応募締め切りは1月22日。🔗 出典
これが意味すること
Google DeepMindは、生成よりも検証が重要となる2つの問題にモデルを適用している。AlphaGenome 2は組織ごとの平均にとどまらず、研究者が関心を持つ細胞で遺伝子変異が及ぼす影響を予測する。その改善幅は、28種類の免疫細胞のマップであるTenK10Kで測定される。AlphaProof Codeは、形式検証の対象をプロトコル設計からコンパイル済みコードへと移す。役割分担は明確で、エージェントが600万行を超える証明を書き、Leanの検証器が各段階を確認し、人間が仕様とコードの約1 %をレビューする。両発表には限界も残る。AlphaGenome 2は引き続き研究用途に限定され、Signalに関して初であるという主張はGoogle DeepMindによるものだ。
安全性の取り組みは、その測定手段自体の壁に突き当たっている。OpenAIは、監視の柱の1つである推論の連鎖が、事前学習の進展とともに読み取りにくくなることを確認し、2つの指標のうちの1つである制御可能性についても、ノイズが多いと自ら評価している。Perplexityは、パッチ適用前の構成で行った3回の試行で、従来のキャプチャー・ザ・フラッグ形式が検証対象の境界からエージェントの注意をそらし、サイバーセキュリティに特化したモデルが汎用版を下回る場合もあることを示した。いずれの場合も、結論はモデル自体と同じくらい、評価の方法にも関わっている。
この日の動きでは、提供済みのものと発表段階のものが明確に分かれる。RunwayはPraxis-1を重み、ファインチューニング用コード、競合する4つの評価対象を下回る結果を示す報告書とともに公開し、TetherはBotPsyをダウンロード可能にした。一方、Qwen4-Maxはベンチマーク、モデル規模、価格を示さずに登場し、ElevenLabs自身も、現在利用できるもの (Marketplace、Partner Program、ElevenAI) と今後提供するもの (Interaction Engine、Memory、Routines、ファインチューニング) を区別している。試したい人にとって、後者はまだ約束の段階にある。
エージェントは継続的な稼働とチームでの利用に定着しつつある。Grok Bot 1.0は会議に参加し、SlackやTeamsで他のBotと連携する。DeltaのCloud Runnersは、作成者のコンピューターがなくてもエージェントのスレッドを実行し続ける。VS Codeは判断待ちのセッションをまとめる受信トレイを追加し、A2UIはエージェントがテキストの代わりに画面で応答できるようにする。各社は、それぞれの機能が生むリスクにも制約を設けている。Grok Botは個人ごとの権限と公開チャンネルで発言する前の確認、Deltaは非公開のプレビュー、VS Codeはサンドボックス内で対象を絞った権限付与と変数のマスキングを採用する。
出典
- AlphaGenome 2 (Google DeepMind)
- AlphaGenome 2 (@GoogleDeepMind)
- AlphaProof Codeの紹介 (Google DeepMind)
- Signalの形式検証 (PDF、Google DeepMind)
- Qwen4-Maxのプレビュー版 (@Alibaba_Qwen)
- Token Plan (QwenCloud)
- Praxis-1が利用可能に (Runway)
- Praxis-1の技術報告書 (Runway)
- Praxis-1コレクション (Hugging Face)
- ElevenLabsのニューヨークサミット (ElevenLabs)
- サミットでの発表 (@ElevenLabs)
- ElevenLabsとNVIDIA (ElevenLabs)
- 利用上限の完全リセット (@ClaudeDevs)
- Grok Bot 1.0 (SpaceXSI)
- Grok Bot 1.0 (@SpaceXSI)
- ChatGPTでのAdvancedおよびStandard音声の提供終了 (OpenAIヘルプ)
- AdvancedおよびStandard音声の提供終了 (@OpenAINewsroom)
- Apple CarPlayでのGemini (blog.google)
- モデルのライフサイクル全体におけるCoTの監視可能性 (OpenAI)
- ジェフリー・ジー・ワンのスレッド
- SPACEからの脱出:第2部 (Perplexity)
- SPACEからの脱出:第2部 (@perplexity_ai)
- Gemini Decision 1 (Google AI Studio)
- Decisions API (Google AI Studio)
- A2UI 1.0 (Google開発者ブログ)
- Cloud RunnersがDeltaに登場
- Cloud Runnersのドキュメント (Delta)
- VS Code 1.146のリリースノート
- Qwen Code v1.0.0-preview (GitHub)
- BotPsy (Hugging FaceのQVAC)
- qvac/BotPsy-0.8Bモデル (Hugging Face)
- トークンプーリングを考慮した学習 (Hugging Face)
- 4K対応のSeedance 2.5 (@pika_labs)
- 4K対応のSeedance 2.5 (@runwayml)
- Gitのセキュリティ脆弱性を発表 (GitHubブログ)
- Zed v1.28.1 (GitHub)
- Antigravityの変更履歴
- Gemini CLI、PR 30228 (GitHub)
- Copilot CLI v1.0.110-1 (GitHub)
- GensparkのGemini 4 Carbon (@genspark_ai)
- BasisとDevin for Startups (@cognition)
- あなたのLLMがコンテナに (Hugging Face)
- GitHub AppsによるCopilotシートの管理 (GitHub変更履歴)
- 非アクティブなリポジトリでDependabotアラートを一時停止 (GitHub変更履歴)
- 個人アカウント向けのイシューの種類とフィールド (GitHub変更履歴)
- 情報量が増えたGitHubのダッシュボード (GitHub変更履歴)
- Singapore Airlines (OpenAI)
- Cogent Security (OpenAI)
- JioStar、ヴィジャイ・セシャドリ (OpenAI)
- 退役軍人向けChatGPT Plus (OpenAI)
- ChatGPTのfalプラグイン (@fal)
- Grok BotのGopuff対応 (@bot)
- Genspark Genius (@genspark_ai)
- MiniMax H3の100日間 (@RyanLeeMiniMax)
- AI Engineer ParisのVoxtral Transcribe 3 (@MistralAI)
- Google AI Edge Galleryのローカル音声機能 (Google開発者ブログ)
- Déjà View (@NVIDIAAI)
- スペイン語の臨床文書から疾患を検出 (OpenMed)
- ウォレットを持つオープンAIモデル (Fizzl)
- FiftyOneのGR00T-X-Embodiment-Sim (Hugging Face)
- マイケル・ロジャースとトム・モラン (Sakana AI)
- AIを活用するリサイクル分野の新興企業 (NVIDIAブログ)
- AIコンプライアンス (Perplexity)
- MCPアーキテクチャ (Perplexity)
- Hacking Higher Ed (@cohere)