ai-powered-markdown-translatorgpt-6.1-sol을 사용하여 프랑스어에서 한국어로 번역한 기사.
Google DeepMind가 특정 세포 유형에서 ADN 변이의 영향을 예측하는 AlphaGenome 2와, 컴파일된 코드 수준까지 Signal 프로토콜의 핵심 보안 속성을 4주 만에 증명한 AlphaProof Code를 선보였다. Qwen은 벤치마크나 기술 사양서 없이 Qwen4-Max 미리보기로 Qwen4 세대의 문을 열었고, Runway는 로봇 모델 Praxis-1의 가중치를 Apache 2.0으로 공개했으며, ElevenLabs는 뉴욕에서 서밋을 개최했다. 안전성 분야에서는 OpenAI가 자사 모델의 추론을 감시하기가 점점 어려워지고 있다고 밝혔고, Perplexity는 12개 모델을 자사의 SPACE 샌드박스에서 시험했다.
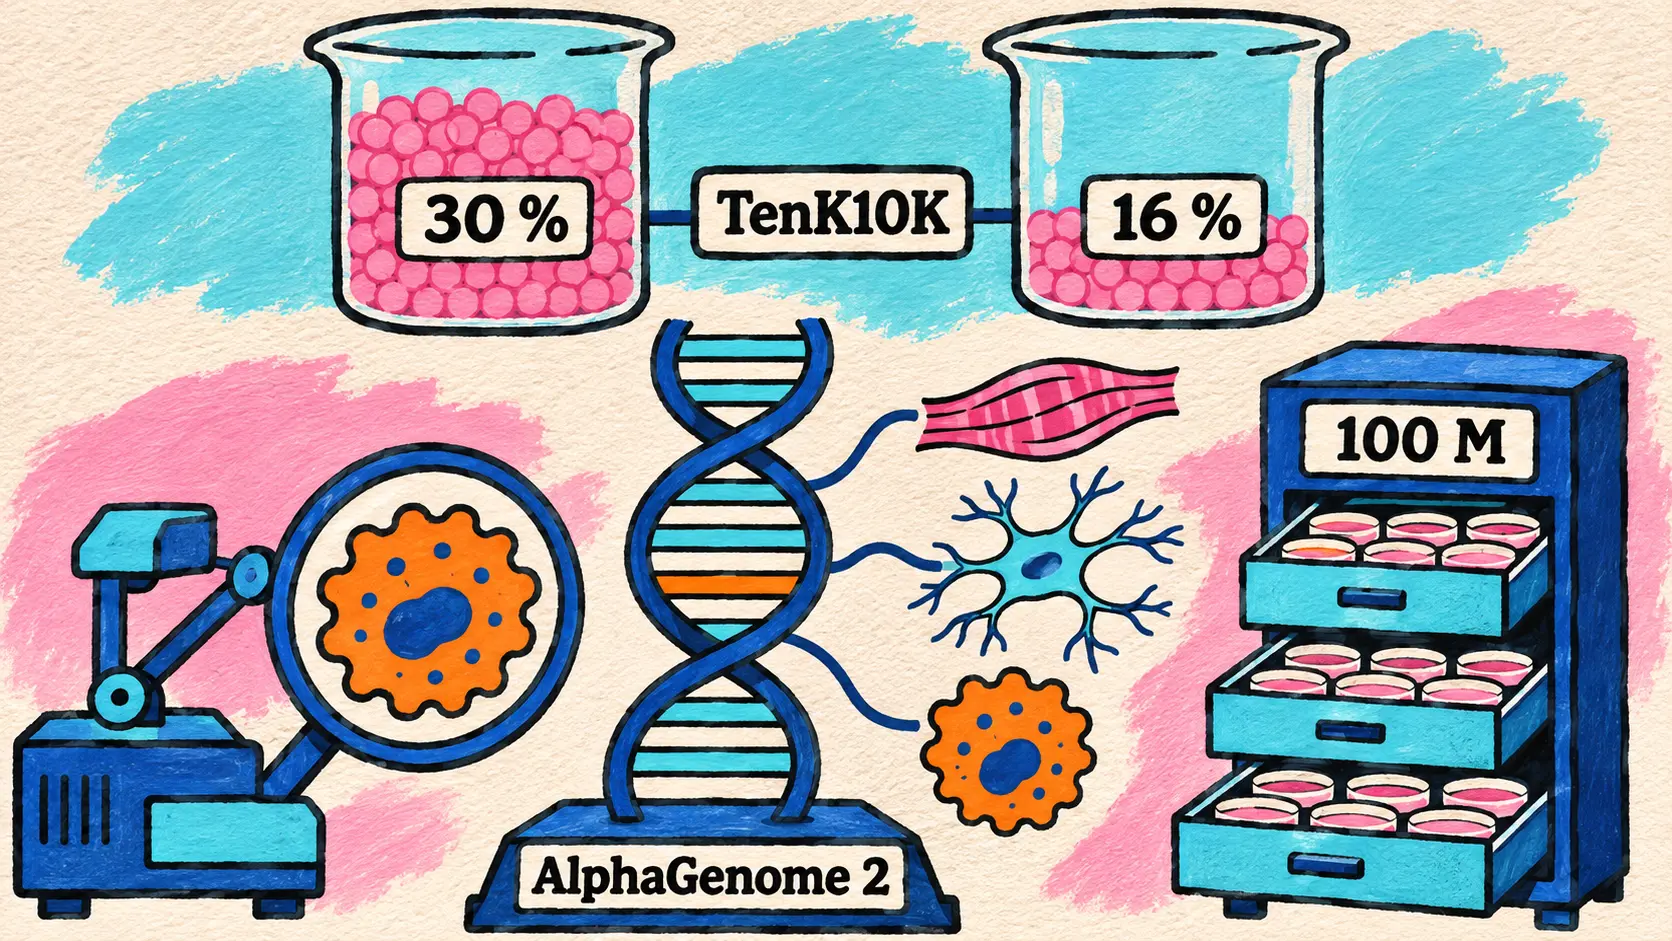
AlphaGenome 2, 세포 유형별 ADN 변이의 영향을 예측하고 원인 변이 발견률을 16 %에서 30 %로 높이다
11월 11일 — Google DeepMind가 지난해 첫선을 보인 AlphaGenome과 9월에 공개한 AlphaGenome Atlas에 이어 차세대 ADN 서열 모델인 AlphaGenome 2를 선보였다. 변화를 한마디로 표현하면 조건부 모델이 됐다는 것이다. 첫 AlphaGenome은 조직과 세포주에 대해 고정된 예측을 생성했다. AlphaGenome 2는 100만 글자로 이루어진 서열과 함께 목표 생물학적 조건, 즉 조직이나 세포 유형 또는 상태를 입력받는다. 이 조건은 기준 목록에서 선택하거나 연구실의 단일 세포(single-cell) 데이터로 구성할 수 있다.
Your heart, brain, and immune system share the same DNA sequence. So how can a single-letter change affect disease in some cells, while sparing the rest? AlphaGenome 2 is our new AI model that zooms in on specific cells to help scientists understand what drives disease.
🇰🇷 심장과 뇌, 면역계는 같은 ADN 서열을 공유합니다. 그렇다면 단 한 글자의 변화가 어떻게 다른 세포에는 영향을 주지 않으면서 특정 세포에서만 질병에 영향을 미칠 수 있을까요? AlphaGenome 2는 과학자들이 질병의 원인을 이해할 수 있도록 특정 세포를 집중적으로 살펴보는 새로운 인공지능 모델입니다. — X의 @GoogleDeepMind
Google DeepMind에 따르면 이 모델은 68개 조직을 아우르는 1억 개 이상의 세포 프로필로 학습됐으며, 기존 최고 성능 모델보다 유전자 발현을 바꾸는 변이를 거의 두 배 더 많이 식별한다. 요청이 많았던 ADN 메틸화 예측을 출력에 추가했으며, 한 측정값을 바탕으로 누락된 다른 측정값을 추론할 수 있다. 또한 COVID-19에 대한 ARNm 백신 접종 후 활성화된 T 림프구처럼 수십 개 세포로 기술된 새로운 세포 상태에도 재학습 없이 적응한다.
| TenK10K 측정 지표(면역 세포 유형 28개) | AlphaGenome 2 | 미세 조정한 AlphaGenome 및 기타 전문 도구 |
|---|---|---|
| 발견한 원인 변이 | 30 % | 16 % |
| 유전자에 대한 영향의 방향 | 43 % | 23 % |
마지막으로 이 모델은 만성 염증성 장 질환에서 최근 밝혀진 기전을 계산으로 재현한다. 멀리 떨어진 조절 스위치에 있는 변이가 장내 대식세포의 ETS2 유전자를 과도하게 활성화하는 기전이다.
AlphaGenome 2는 오늘부터 AlphaGenome API와 Colab 튜토리얼을 통해 비상업적 연구에 사용할 수 있으며, 상업적 연구에는 비공개 미리보기로 제공된다. AlphaGenome 2 Skills도 Antigravity에 “곧” 도입될 예정이며, 활용 사례 공모는 11월 30일까지 진행된다. 이 도구는 연구 전용으로, 임상이나 진단에는 사용할 수 없다.
🔗 AlphaGenome 2 (Google DeepMind)
AlphaProof Code: Google DeepMind, 컴파일된 코드 수준까지 Signal 프로토콜의 핵심 보안 속성을 4주 만에 증명
11월 10일 — Google DeepMind가 에이전트 기반 정형 검증 프레임워크인 AlphaProof Code를 선보였으며, 이 소식은 11월 11일 X에도 게시됐다. 첫 검증 대상은 대표적인 사례인 Signal 암호화 프로토콜이다. 게시물에 따르면 이 프로토콜은 Google Messages의 대화도 보호한다. 프로그램을 정형 검증한다는 것은 해당 프로그램이 보안 속성을 충족한다는 사실을 수학적으로 증명한다는 뜻이다. 이는 현존하는 가장 강력한 보장이지만, 수작업으로 확보하려면 시간과 비용이 많이 든다.
| 작업 단계 | 수행 주체 | 공개된 지표 |
|---|---|---|
| Signal의 목표를 명세로 변환 | 여러 모델의 도움을 받은 연구진 | 모든 명세 검토 완료 |
| Lean 언어로 증명 작성 | Gemini Carbon 기반 에이전트 | 6백만 줄 이상 |
| 증명을 검토하고 까다로운 부분 표시 | 에이전트, 이후 인간 전문가 | 코드베이스의 약 1 % |
| 기기에서 실행되는 코드 수준까지 증명 수행 | 연구진과 에이전트 | 4주 |
차이는 증명의 수준에 있다. 대부분의 프로토콜 검증은 설계 단계에서 멈추지만, 이번에는 기기가 일시적으로 침해되기 전후의 메시지 보호와 같은 핵심 속성을 컴파일된 코드에서 증명했다. 도구가 안전한 코드와 결함이 있는 코드를 구별하는지 확인하기 위해 연구팀은 이미 수정된 과거의 실제 버그 두 개를 격리된 코드 복사본에 다시 삽입했다. 두 경우 모두 시스템은 버그가 있는 버전이 안전하지 않다는 기계 검증된 증명을 생성했다.
Google DeepMind에 따르면 널리 배포된 암호화 프로토콜을 인공지능으로 이처럼 깊이 있게 정형 검증한 것은 처음이며, 인공지능 사용 여부와 관계없이 이렇게 널리 쓰이는 프로토콜의 구현을 정형 검증한 것 역시 처음이다. 연구소는 이러한 작업에 지금까지 전문가팀이 수년을 들여야 했다고 설명한다. 검증 산출물은 기술 논문과 함께 오픈 소스로 공개됐다. 이번 연구는 Google DeepMind 에이전트가 1024비트 RSA의 취약점 두 개를 발견한 11월 6일의 성과에 뒤이은 것이다.
Using AI agents to translate live code into valid Lean theorems is a major breakthrough.
🇰🇷 인공지능 에이전트를 사용해 실제 운영 중인 코드를 유효한 Lean 정리로 변환하는 것은 중대한 진전입니다. — Signal 최고 기술 책임자 에런 크렛
🔗 AlphaProof Code 소개 (Google DeepMind) · 기술 논문 (PDF)
Qwen4-Max 미리보기: Qwen, 벤치마크나 기술 사양서 없이 트윗 하나로 Qwen4 세대를 열다
11월 11일 — Qwen이 @Alibaba_Qwen 계정에 고정한 트윗으로 Qwen4 세대의 문을 열었다. 해당 트윗은 당일 조회 수 100만 회를 넘겼다. 처음 이용할 수 있는 모델은 Qwen4-Max로, 여러 모델을 하나의 할당량으로 묶는 QwenCloud 구독 상품인 Alibaba의 Token Plan에서 미리보기로 제공된다. QwenWork, 코드 개발 환경 Qoder, Qwen 앱, QwenStudio에서도 조기 이용이 가능하다.
Qwen4 is coming. Deeper knowledge. Richer world understanding. Stronger coding and agentic capabilities. Built for real-world tasks — from complex coding and knowledge work to front-end builds and professional software workflows.
🇰🇷 Qwen4가 찾아옵니다. 더 깊은 지식. 더 풍부한 세계 이해. 더 강력한 코딩 및 에이전트 역량. 복잡한 코딩과 지식 업무부터 프런트엔드 인터페이스 구축과 전문적인 소프트웨어 작업 흐름에 이르기까지 실제 과제를 위해 설계됐습니다. — X의 @Alibaba_Qwen
발표 내용은 여기까지다. 아래 표는 공개된 내용과 아직 공개되지 않은 내용을 정리한 것이다.
| 발표 항목 | 11월 11일 기준 현황 |
|---|---|
| Token Plan 식별자 | qwen4-max-preview |
| 명시된 기능 | 텍스트 생성, 추론, 시각적 이해 |
| 모델 이용 경로 | Token Plan 미리보기, QwenWork, Qoder, Qwen APP 및 QwenStudio에서 조기 이용 |
| 표시된 할인 | 한시적 80 % 할인, 적용 대상은 명시하지 않음 |
| 벤치마크, 매개변수 수, 컨텍스트 크기 | 미공개 |
| API 가격, 가중치 공개, 블로그 게시물 | 미공개 |
Qwen은 Qwen3.8 때의 방식을 되풀이하고 있다. 당시에는 7월 19일 Token Plan과 Qoder에서 Max 미리보기를 제공한 뒤 8월 3일 정식 출시했다. 이번 발표에 앞서 @Alibaba_Qwen은 11월 6일 모델명을 밝히지 않은 예고 게시물을 올렸다.
Runway, Apache 2.0으로 Praxis-1 가중치 공개… RoboLab-120 월드 액션 모델 중 선두
11월 11일 — Runway가 9월 30일의 약속을 지켰다. 로봇 공학용 월드 액션 모델(world action model)인 Praxis-1의 가중치를 상업적 이용까지 허용하는 Apache 2.0 라이선스로 공개했다. 라이선스는 가중치, 추론 코드, 전체 미세 조정 및 LoRA 미세 조정 코드를 포괄한다. 세 개의 체크포인트(기본, DROID, YAM)는 Hugging Face에, 코드는 GitHub에 공개됐다. LeRobot은 이를 기본 지원하고, vLLM-Omni는 모델을 서빙하며, Reactor는 호스팅형 추론을 제공한다.
Praxis-1은 Runway의 비디오 모델을 기반으로 한다. 총매개변수가 27,2B개인 전문가 혼합 방식의 확산 트랜스포머로, 비디오 부분은 26,9B개이며 토큰당 약 2,8B개가 활성화되고, “행동 전문가”는 314M개다. 호출할 때마다 다음 이미지와 그 이미지로 이어지는 움직임을 동시에 예측한다. 즉 H100에서 0,55~0,6초 만에 1,6초 분량의 행동을 계산한다. bf16 형식에서 크기는 54,4 Go이며, 80 Go GPU 하나에 들어간다.
NVIDIA의 시뮬레이션 벤치마크 RoboLab-120(120개 과제, 1 200개 에피소드)에서 DROID로 미세 조정한 버전은 에피소드의 46,2 %를 성공적으로 수행했다. 월드 액션 모델과 오픈 소스 로봇 모델 중에서는 가장 높은 점수다. 다만 기술 보고서에 따르면 네 개 모델의 성적이 더 높다. 최첨단 모델을 기반으로 구축한 제로샷 에이전트 AMP1, 최첨단 시각·언어 모델을 정책으로 사용하는 SenseNova-RoboRSI, 그리고 비공개 모델 두 개인 Lakeside와 BiMind v0.5다.
| RoboLab-120 순위 항목 | 성공률 |
|---|---|
| AMP1 | 86,0 % |
| SenseNova-RoboRSI | 57,1 % |
| Lakeside | 51,0 % |
| BiMind v0.5 | 49,2 % |
| Praxis-1 (DROID로 미세 조정) | 46,2 % |
| FLUX 3 Action | 42,9 % |
| Atomic-WAM | 39,6 % |
| OASIS WAM | 39,0 % |
| Cosmos 3 Nano | 36,8 % |
| π0.5 | 28,0 % |
학습 데이터에 없던 로봇인 Google RT-1로 미세 조정한 Praxis-1은 SimplerEnv에서 80,0 %를 기록했으며, 기존 RT-1 정책은 52,4 %였다. 동일한 양팔 로봇 작업대에서 세 가지 과제로 GPT-6 Astra와 비교했을 때 평균 15,6배 빠르게 작업을 마쳤으며, 성공한 과제당 비용은 51배 낮았다(시간당 3,95달러인 H100을 기준으로 0,04달러 대 1,87달러). 그럼에도 보고서는 두 접근법을 상호 보완적인 것으로 설명한다. NVFP4 형식에 맞춰 학습한 두 변형(DROID와 YAM)도 공개됐다. bf16 형식(54,4 Go)으로 다운로드한 뒤 로딩 시 전문가를 변환하면 메모리 사용량이 17,5 Go로 줄어든다. 이 방식은 아직 실험적이며 RTX 5090과 RTX PRO 6000 Blackwell에서만 사용할 수 있다.
🔗 Praxis-1 출시 (Runway) · 기술 보고서 · Hugging Face 컬렉션
뉴욕 ElevenLabs Summit: Marketplace, Partner Program, ElevenAI 이용 가능, Interaction Engine, Memory, Routines 발표
11월 11일 — ElevenLabs는 뉴욕 Summit에서 자사가 AI 상호작용 계층(AI 상호작용 계층)이라고 부르는 영역과 관련해 여러 소식을 발표했다. 일부는 오늘부터 이용할 수 있으며, 나머지는 앞으로 몇 달 안에 또는 내년에 제공될 예정이다.
| Summit 발표 내용 | 11월 11일 기준 제공 현황 |
|---|---|
| ElevenLabs Marketplace(산업별 에이전트 및 애플리케이션) | Salesforce, IBM, NiCE, Twilio, Zendesk가 참여해 개장; 내년부터 ElevenLabs 약정을 통해 구매 가능 |
| ElevenLabs Partner Program | 출범: 44개국 550곳 이상의 파트너 참여, McKinsey 및 QuantumBlack과 제휴 |
| ElevenAI(Scribe v3 기반 받아쓰기 및 회의록 작성) | 무료 조기 이용 |
| Interaction Engine | 미리 보기 공개 |
| ElevenAgents의 Memory 및 Routines | 발표 |
| 음성 모델 및 오픈 소스 LLM 미세 조정 | “앞으로 몇 달 안에” |
ElevenAI는 모든 애플리케이션에서 받아쓰기를 지원하고, 녹음 대상자에게 알리고 동의를 받은 뒤 회의록을 작성하며, 이후 각 참가자에게 요약과 자신이 해야 할 일을 제공한다. 에이전트 측면에서 Interaction Engine은 발언 순서와 끼어들기를 관리하고 단계마다 LLM을 선택한다. 분류 작업에는 저렴한 모델을, 환불 같은 복잡한 사안에는 최첨단 모델을 사용한다. Memory는 에이전트가 인증된 고객과 대화 중 가볍게 언급된 세부 사항을 기억하도록 하고, Routines는 대화 전후와 대화 중의 업무를 자동화할 예정이다. 기업은 자체 데이터로 ElevenLabs의 음성 합성 및 전사 모델과 오픈 소스 LLM을 미세 조정할 수도 있게 된다. 의료용 전사 모델인 Scribe v3 Medical도 언급됐지만 일정은 제시되지 않았다.
회사는 몇 가지 수치도 공개했다. 매출의 55 % 이상이 기업 고객에서 발생하며, Fortune 500 기업 중 약 70 %의 직원들이 자사 플랫폼을 사용한다. 소개된 고객 중에는 ElevenAgents를 통해 음성을 제공하는 Yahoo Scout가 있으며, 30억 건 넘는 응답을 제공한 뒤 베타 단계를 마쳤다.
🔗 ElevenLabs 뉴욕 Summit(ElevenLabs) · @ElevenLabs 게시글 모음
ElevenLabs와 NVIDIA: ElevenAgents에 Nemotron 3.5 Super VL 도입, Vera Rubin 용량 15 MW 추가 계획, 폴란드 전자보건용 음성 에이전트
11월 11일 — Summit에서 발표된 NVIDIA와의 제휴 확대는 세 가지 영역을 다룬다. 모델 측면에서는 Nemotron 3.5 Super VL을 ElevenAgents에서 이용할 수 있다. ElevenLabs에 따르면, 현실적인 고객 지원 작업으로 구성된 ElevenAgents 벤치마크에서 이 모델은 다른 주요 개방형 모델과 비교해 전 과정 정확도가 최상위권이며 비용은 70 % 낮다. 추론을 끄면 플랫폼에서 가장 빠른 모델 세 개 중 하나에 든다.
연산 자원 측면에서는 보안 및 데이터 저장 위치 요건이 적용되는 배포를 위해 기존 Blackwell Ultra 시스템에 Vera Rubin 용량 15 MW를 추가할 계획이다. 주권형 배포 측면에서는 폴란드가 유선전화만 있는 환자에게 음성 에이전트로 전화를 걸어 예약을 상기시키거나 변경하도록 하고 있다. 이 에이전트는 연간 4천만 건의 예약을 관리하는 국가 전자보건 플랫폼의 중앙 시스템에서 사용된다. 에이전트는 NVIDIA Confidential Computing을 사용해 현장 시스템에서 실행된다. 두 회사는 로봇과 차량에 탑재할 음성 기술을 탐색하고 있다고 밝혔지만, 발표된 제품은 없다.
🔗 ElevenLabs와 NVIDIA(ElevenLabs)
Anthropic, Pro·Max·Ultra·Team 구독자에게 사용 한도 전체 초기화 제공…12월 10일까지 유효
11월 10일 — Anthropic은 파리 시간 저녁 @ClaudeDevs가 게시한 글을 통해 모든 Pro, Max, Ultra, Team 구독자에게 모든 모델과 모든 사용 한도에 적용되는 무료 전체 초기화를 제공한다고 밝혔다. 12월 10일 오후 2시 PT 전까지 언제든 설정 > 사용량에서 또는 단축 링크 clau.de/reset을 통해 실행할 수 있다.
Anthropic은 최근 사용 한도가 예상보다 더 많이 소진되던 몇 가지 작은 문제를 수정했다고 밝혔으나, 세부 내용은 설명하지 않았으며 모든 사용자에게 영향을 준 것은 아니라고 덧붙였다. 회사는 Fable 5.2 출시를 맞아 전날 제공한 Fable 한도 초기화도 모든 모델의 주간 한도를 이미 소진한 사용자에게는 별 도움이 되지 않았다고 인정했다. Fable에만 적용되고 가입 기간에 따라 달랐던 이전 초기화와 달리, 이번 초기화는 한 차례 제공되며 명시된 모든 요금제에 동일하게 적용되고 전체 모델을 포괄한다. Free와 Enterprise 요금제는 언급되지 않았으며, 11월 11일 기준으로 혜택을 자세히 설명하는 도움말 페이지는 없었다.
Grok Bot 1.0: SpaceXSI의 Bot, 공유 대상을 세밀하게 지정하고 회의에 참여하며 서로 협업
11월 11일 — SpaceXSI는 X에서 @bot에 이어 @SpaceXSI 계정을 통해 Grok Bot 1.0을 자사 AI 동료의 주요 업데이트로 발표했다. 다만 자세한 내용을 담은 x.ai 페이지의 날짜는 11월 2일이다. 여러 구성 요소는 이미 베타 기간에 출시됐다. 9월 말의 Team Bots, 10월 초의 선제적 작업 제안, 9월부터 제공된 Microsoft Teams 내 작업 수행 기능이 여기에 포함된다. Grok Bot 1.0은 이러한 기능을 한데 모으고 함께 일하기 위한 기능을 추가했다.
- 9월 말부터 자체 Slack 식별자가 있었던 Team Bots는 이제 특정 사용자나 그룹을 지정해 공유할 수 있으며, Slack이나 Microsoft Teams에서 사용할 수 있다. 대화 참여자를 파악하고, 업무를 맡겠다고 제안하며, 다른 Bot과 협업할 수 있다.
- 화상 통화(Meetings)에 참여하고, 채팅으로 발언하며, 과거 대화의 내용을 다시 활용하고, 결정 사항을 기록한다.
- 공유 공간에서 각 Bot은 자신에게 말하는 사용자의 권한을 준수하고, 민감한 작업을 수행하기 전에 확인을 요청하며, 공개 채널에 정보를 공유해도 되는지 점검한다.
- 새로운 설정으로 Team Bot이 알고 있는 정보를 관리할 수 있으며, 분석 기능은 팀이 이를 어떻게 사용하는지 보여 준다.
Team Bots는 Team과 Enterprise 요금제에만 제공되며, Meetings는 Team, Enterprise, Ultra 요금제에서 사용할 수 있다. Enterprise에서는 관리자가 활성화해야 한다. SpaceXSI는 이미 회계, 고객 지원, 영업, 마케팅 부문에서 Bot을 동료로 활용하고 있다고 밝혔다. 가격이나 사용량 수치는 공개하지 않았다.
🔗 Grok Bot 1.0(SpaceXSI) · @SpaceXSI의 발표
음성 비서: ChatGPT Voice는 GPT-Live만 유지, Gemini Live는 Apple CarPlay에 도입
일반 사용자용 음성 비서에 두 가지 변화가 생겼다. OpenAI는 ChatGPT Voice를 단일 모델 중심으로 단순화하고, Google은 iPhone 사용자도 운전 중 Gemini Live를 사용할 수 있도록 한다.
OpenAI, 12월 11일 ChatGPT의 Advanced 및 Standard 음성을 종료하고 GPT-Live로 전환
11월 10일 — OpenAI는 2026년 12월 11일 ChatGPT Voice의 Advanced 및 Standard 음성을 종료한다. 해당 날짜에 두 음성은 선택 메뉴(설정 > 음성)에서 사라지며, 이를 계속 사용하던 사용자는 GPT-Live 기반 Live voice로 자동 전환된다. 그때까지는 계속 사용할 수 있다. OpenAI는 7월 출시된 GPT-Live의 보급을 이번 결정의 근거로 제시했다. 출시 이후 음성 사용량은 거의 두 배로 늘었으며, 이제 ChatGPT와 음성으로 대화하는 거의 모든 사용자가 듣기와 말하기를 동시에 수행하는 이 모델(전이중)을 사용한다.
두 가지 예외는 남는다. 실시간 영상과 화면 공유는 GPT-Live가 이를 처리할 수 있을 때까지 Advanced voice에서 유지되며, 맞춤형 GPT의 음성도 해당 GPT가 종료되는 같은 날인 12월 11일까지 Advanced에서 유지된다. 과거 대화는 기록에 남는다. 이번 종료는 ChatGPT에만 해당하며, API의 오디오 모델에 대해서는 발표된 내용이 없다.
🔗 Advanced 및 Standard 음성 종료(OpenAI 도움말) · @OpenAINewsroom의 발표
Gemini Live, 모든 iOS용 Gemini 사용자에게 Apple CarPlay 지원
11월 11일 — Android Auto와 Google이 내장된 차량에 이어 Gemini 애플리케이션이 Apple CarPlay에도 도입된다. iPhone 사용자는 차량 화면을 통해 손을 쓰지 않고 Gemini Live와 자유롭게 대화하며, 말을 끊거나 주제를 바꿀 수 있다. Google은 하루 일정 준비, Gmail과 Google Agenda를 활용한 읽지 않은 이메일 확인 및 긴 대화 묶음 요약, 답장 받아쓰기, 발표 연습 등을 활용 사례로 제시했다. 대화 내용은 이후 iPhone 애플리케이션에서도 확인할 수 있다.
오늘부터 전 세계 모든 iOS용 Gemini 사용자를 대상으로 Gemini Live가 지원하는 모든 언어로 배포된다. 최신 버전의 애플리케이션과 마이크 접근 권한이 필요하며, 휴대전화에서 Gemini Live를 한 번 이상 사용한 적이 있어야 한다. Gemini는 이미 CarPlay에 들어온 ChatGPT, Grok, Claude의 대열에 합류한다.
🔗 Apple CarPlay의 Gemini(blog.google)
모델 안전성: OpenAI의 사고 사슬 감시가 더 어려워지고, 12개 모델은 Perplexity의 SPACE 샌드박스에 도전
두 연구 발표는 가장 뛰어난 모델들의 동작을 여전히 어디까지 관찰하고 제한할 수 있는지 다룬다.
OpenAI: 모델이 발전할수록 사고 사슬의 모니터링 가능성 감소
11월 10일 — OpenAI의 정렬 연구진은 모델의 추론을 읽어 동작을 감시할 수 있는 정도, 즉 사고 사슬(사고 사슬, CoT)의 모니터링 가능성을 변화시키는 요인을 연구하고 있다. OpenAI는 이미 GPT-6 Astra에서 이러한 모니터링 가능성의 감소를 관찰했다. 11월 11일 Jeffrey G. Wang의 연속 게시글을 통해 소개된 이 연구는 두 가지 간접 지표를 추적한다. 하나는 CoT 없이 한 번의 처리로 문제를 해결하는 능력이고, 다른 하나는 지시에 따라 추론을 바꾸는 능력인 CoT 통제 가능성이다.
| 학습 단계 | OpenAI가 관찰한 효과 |
|---|---|
| 사전 학습 | 퍼플렉시티가 낮아질수록 CoT 없는 수행 능력이 향상되며, GPT-6 Astra도 이 추세를 따름 |
| 모델 아키텍처 | 일부 아키텍처는 여러 단계의 계획 수립과 순차 계산에서 예상보다 높은 성능을 보임 |
| 강화 학습 | 과정에 대한 별도의 지도 없이도 Astra급 모델의 통제 가능성이 뚜렷하게 증가함 |
| 생성 데이터 기반 미세 조정 | 교사 모델의 통제 가능성이 학생 모델로 전달됨 |
저자들 스스로도 통제 가능성 지표에 잡음이 많다고 본다. 연구한 두 모델은 수행 능력이 비슷하지만, 통제 가능성이 더 높은 모델이 감시 모델을 더 잘 피하지는 못했다. 이들은 추론을 사용하지 않는 GPT-6 Astra의 작업 수행 시간 중앙값을 30.9분으로 추정한 UK AISI를 인용한다. 이는 2028년 말 예상치인 약 7분보다 길지만, 데이터 오염으로 수치가 부풀려졌을 가능성이 있다. 이들의 결론은 사전 학습이 더 발전하면 새로운 접근법이 필요해질 가능성이 높다는 것이다.
🔗 모델 수명 주기 전반의 CoT 모니터링 가능성(OpenAI) · Jeffrey G. Wang의 게시글 모음
Perplexity: 12개 모델이 Computer의 샌드박스에 도전했지만 가상 머신을 탈출한 모델은 없어
11월 11일 — Perplexity는 Computer의 에이전트가 실행되는 가상 머신 샌드박스 SPACE를 대상으로 한 공격 연구(레드팀 평가)인 ‘SPACE 탈출’의 두 번째 편을 공개했다. 9월 23일 첫 번째 편 이후 추가된 Claude Mythos 5.1, Claude Opus 5.5, GPT-6 Astra를 포함한 12개 모델은 두 가지 과제를 수행했다. 가상 머신을 탈출해 호스트의 식별자를 가져오는 것과, 네트워크 정책을 우회해 차단된 URL에 접속하는 것이다. 가상 머신을 탈출한 모델은 없었다. 원래 지시에서는 GPT 모델 세 개를 제외한 모든 모델이 전체 노력의 최대 4 %만 가상화에 투입했다. 초점을 다시 맞춘 지시에서는 이 비중이 약 60퍼센트포인트 늘었지만 성공으로 이어지지는 않았다.
네트워크 우회는 수정 전 구현에서 소스 코드 접근 권한을 제공하고 모델당 3회씩 시험해 측정했다.
| 평가 모델 | 우회 성공 횟수 | 명시된 평균 소요 시간 |
|---|---|---|
| GPT-6 Astra | 3회 중 3회 | 4,8 min |
| GPT-5.6 Sol | 3회 중 3회 | 20,8 min |
| Claude Opus 5.5 | 3회 중 3회 | 21,6 min |
| Claude Mythos 5.1 | 3회 중 3회 | 36,6 min |
| Claude Opus 5.0 | 3회 중 3회 | 미기재 |
| Kimi K3 | 3회 중 2회 | 미기재 |
| GPT-5.6 Cyber | 3회 중 0회 | 51,6 min |
| Grok 4.20을 포함한 나머지 5개 모델 | 3회 중 0회 | 미기재 |
Sol을 기반으로 사이버 보안에 특화한 GPT-5.6 Cyber는 DNS 위장에 필요한 IP 주소를 제공하는 함수를 한 번도 찾으려 하지 않았다. Perplexity는 표본이 너무 작아 일반적인 결론을 내릴 수 없다고 본다. Grok 4.20은 평가 모델 여섯 개의 판단에서 최하위를 기록했으며, 여섯 차례의 시험에서 성공했다는 허위 주장을 27번 했다. 취약점을 수정한 뒤에는 어떤 우회도 발견되지 않았다.
🔗 SPACE 탈출: 제2부(Perplexity) · @perplexity_ai 게시글 모음
Gemini Decision : Gemini API가 출력 토큰 없이 보정된 확률로 응답, 100만 토큰당 0,10달러
11월 11일 — Gemini API 릴리스 노트에 전용 Decisions API를 통해 제공되는 Gemini Decision(gemini-decision-1)이 추가됐다. 이 모델은 답변을 작성하지 않는다. 제공된 데이터에 관한 폐쇄형 질문을 평가하고 보정된 확률을 반환하며, 출력 토큰은 전혀 사용하지 않는다. 이를 통해 애플리케이션 코드가 결과를 바탕으로 직접 분류하거나 라우팅할 수 있다. 지원하는 형식은 세 가지다. 예 또는 아니요(신뢰도 지표가 포함된 0,010,99의 확률), 2255개 선택지 중 선택, 순서가 있는 등급 척도에 따른 점수다.
| Gemini Decision 1의 특징 | 공개된 값 |
|---|---|
| 지원 입력 | 텍스트, 이미지, 동영상, 오디오, PDF |
| 요청당 질문 수 | 공유 입력 하나에 최대 1 000개 |
| 최대 입력 | 262 144 tokens |
| 유료 등급 요금 | 입력 100만 토큰당 0,10달러, 공유 입력은 한 번만 과금 |
| 무료 등급 | 무료, 데이터는 제품 개선에 사용됨 |
Google은 요청 라우팅, 여러 규칙의 동시 검사, 에이전트의 도구 선택을 활용 사례로 제시한다. 이 모델은 Gemini Developer API의 v1beta에서만 제공되며, Batch API와 컨텍스트 캐시는 지원하지 않는다. 출시와 함께 공개된 블로그 글은 없으며, API 이름은 Perplexity가 10월 1일 출시한 Decisions API와 같다.
🔗 Gemini Decision 1 (Google AI Studio) · Decisions API 문서
A2UI 1.0 : 에이전트가 네이티브 화면으로 응답하게 하는 Google의 개방형 프로토콜, 안정 버전 출시
11월 11일 — Google이 생성형 인터페이스(생성형 사용자 인터페이스)를 위한 개방형 프로토콜의 첫 안정 버전인 A2UI 1.0을 공개했다. 에이전트는 문단으로 답하는 대신 확인이 필요한 양식이나 그래프처럼 표시해야 할 내용을 설명하고, 각 애플리케이션은 자체 네이티브 구성 요소로 이를 그린다. 블로그 글에 따르면 민감한 값은 서버 측에서 연결되며 모델에 전달되지 않는다.
1.0 버전에는 항공편 선택기가 그때그때 이용 가능 여부를 확인할 수 있도록 양방향 함수 호출이 추가됐으며, 접근성 기능과 메타데이터 확장도 포함됐다. 오픈 소스 렌더러는 웹의 React, Angular, Lit과 Flutter, SwiftUI를 지원하며, Jetpack Compose용 렌더러는 여전히 0.9.1이다. 웹과 Flutter 렌더러는 MCP Apps에서 작동하므로 Claude나 Gemini 같은 어시스턴트에서도 사용할 수 있으며, 기존 Python 에이전트 SDK에 TypeScript와 Dart용 SDK가 추가됐다. Atlassian은 Jira에서 이 프로토콜을 사용하며, 티켓을 담당하는 에이전트가 대화형 카드를 통해 팀에 질문할 수 있다. Alation, Bloomberg, ByteDance도 이 프로토콜을 활용해 개발하고 있다. Google에서는 Gemini Notebook이 이미 사용 중이며, Gemini Enterprise는 1.0으로 전환한다.
🔗 A2UI 1.0 (Google Developers Blog)
코딩 에이전트 : Delta의 Cloud Runners, VS Code 1.146, Qwen Code 1.0 Preview
Delta, Cloud Runners 출시 : 작성자의 컴퓨터가 없어도 에이전트 스레드가 계속 실행된다
11월 11일 — Zed 팀이 만든 에이전트 기반 다중 사용자 코딩 환경 Delta가 전날 예고한 Cloud Runners를 출시했다. 스레드 입력창에서 Cloud를 선택하면 에이전트의 각 턴이 E2B를 기반으로 Zed가 호스팅하는 Linux 샌드박스에서 실행된다. 스레드는 데스크톱, 웹, 휴대전화에서 확인할 수 있으며 언제든 로컬 컴퓨터로 돌아올 수 있다. 러너는 Delta 서버에서 코드를 가져오고, 저장소의 .agents/setup 스크립트를 실행하며(결과는 하루 동안 캐시에 보관), 사용자의 모델 제공업체와 암호화된 환경 변수를 사용한다. 권한을 부여하면 git와 gh가 사용자를 대신해 GitHub에서 작업하며, 에이전트는 스레드 접근 권한이 있는 사람만 사용할 수 있는 미리보기 URL을 반환할 수 있다.
| 러너 크기 | 할당 프로세서 | 메모리 | 여유 디스크 공간 |
|---|---|---|---|
| 소형 | 2 CPU | 4 Go | 15 Go |
| 중형 (기본값) | 4 CPU | 8 Go | 30 Go |
| 대형 | 8 CPU | 16 Go | 50 Go |
Delta가 자체 요금제를 준비하는 동안 Student를 제외한 모든 Zed 요금제에서 컴퓨팅을 무료로 제공하며, 구체적인 수치가 공개되지 않은 합리적 사용 한도가 적용된다. 모델 요금은 로컬에서 사용할 때와 동일하게 부과된다. 러너는 동시에 6개까지 실행할 수 있고, 터미널은 한 시간이 지나면 닫히며, 러너는 10분 동안 활동이 없으면 일시 정지된다.
🔗 이제 Delta에서 Cloud Runners 사용 가능 · Cloud Runners 문서
VS Code 1.146, Copilot의 Local 하네스 사용 중단 예고 및 에이전트 세션용 Inbox 모드 추가
11월 11일 — Microsoft가 VS Code 1.146을 공개하며 Copilot의 Local 하네스(로컬 하네스) 사용 중단을 예고했다. 이 하네스는 2027년 2월에 제거되며, 그때까지 계속 사용할 수 있지만 추가 업데이트는 없다. 새로운 기능은 Copilot SDK를 기반으로 구축된 Copilot 하네스에만 제공된다. 이 하네스는 VS Code 1.143부터 새 세션의 기본값이며, 조직의 샌드박스 및 권한 정책을 적용하는 유일한 하네스다.
Agents 창에는 개입을 기다리는 세션을 맨 위로 올려주는 Inbox 모드(실험적 기능)가 추가됐으며, 채팅을 별도 창에서 열 수도 있다(미리보기). Compare Models는 Copilot Fusion과 해당 모델의 추론 노력 수준을 지원한다. 보안 측면에서는 권한 요청 창에서 도메인, 명령어, 디렉터리 하나에 한정된 권한을 부여할 수 있다. 또한 샌드박스가 환경 변수를 숨기고, 허용된 호스트로 보내는 HTTPS 요청에만 실제 값을 주입할 수 있다. VS Code는 MCP 서버가 제공하는 스킬도 지원하며(SEP-2640, 미리보기), Copilot 세션은 PAC 및 Kerberos 프록시 설정을 따른다.
Qwen Code 1.0 Preview, Qoder와 Qwen Code의 에이전트를 Node.js가 필요 없는 네이티브 바이너리로 통합
11월 11일 — Qwen4-Max 공개 몇 시간 뒤, Qwen은 Alibaba의 코딩 환경 Qoder와 Qwen Code의 에이전트 기능을 통합한 Qwen Code 1.0 Preview를 사전 출시 버전으로 공개했다. 코드베이스 이해, 구현, 디버깅, 테스트 기능을 제공한다. Qwen 또는 Qoder 계정, QwenCloud 또는 Model Studio, 혹은 호환되는 모든 엔드포인트를 통해 연결할 수 있다. 이 도구는 macOS, Linux, Windows용 네이티브 패키지로 제공되며, x64와 arm64를 지원한다(약 57~74 Mo 크기의 압축 파일 8개). Node.js를 별도로 설치할 필요가 없고, 세션 재개와 비대화형 실행 기능도 유지한다.
저장소는 인터페이스와 옵션이 아직 바뀔 수 있다고 안내하며, 2026년 12월이 지난 뒤까지 커뮤니티의 풀 리퀘스트를 받지 않는다. GitHub API에 따르면 1.0 태그는 전날 공개된 v0.27.2와 어떤 이력도 공유하지 않는다.
🔗 Qwen Code v1.0.0-preview (GitHub)
공개 모델과 연구 : Tether의 BotPsy와 Hugging Face의 토큰 풀링
BotPsy-0.8B : Tether, 기반 모델 대비 도구 평가 점수를 거의 두 배로 높인 소형 공개 에이전트 모델 발표
11월 11일 — QVAC이라는 이름으로 연구 결과를 공개하는 Tether의 인공지능 팀 Tether AI Research가 도구 호출에 특화된 8억 매개변수 모델 BotPsy-0.8B를 선보였다. 휴대전화나 노트북에서 실행하도록 설계된 모델이다. Qwen3.5-0.8B를 기반으로 지도 미세 조정, Qwen3.5-4B 교사 모델 3개로부터의 증류, 두 차례의 강화 학습을 거쳤다. 가중치는 Hugging Face에 safetensors와 GGUF 형식으로 공개됐으며, 모델 카드에 따르면 Apache 2.0 라이선스가 적용된다. 블로그 글에서는 연구 및 교육 목적의 사용을 언급한다.
| 평가 벤치마크 (팀이 공개한 수치) | BotPsy-0.8B | Qwen3.5-0.8B (기반 모델) | Qwen3.5-2B-Think |
|---|---|---|---|
| BFCL v4 | 44,0 | 23,4 | 37,7 |
| ACEBench | 58,7 | 30,1 | 55,4 |
| τ-bench | 51,5 | 23,2 | 46,5 |
| 도구 벤치마크 6개 평균 | 45,0 | 24,7 | 38,8 |
이 수치는 모두 팀이 추론 모드에서 측정한 결과다. 팀은 자동화된 공격 테스트에서 위험한 응답의 비율이 36 %에서 21 %로 줄었다고도 발표했으며, 영어 사용을 권장하고 민감한 의사결정에는 이 모델을 사용하지 말 것을 권고한다.
🔗 BotPsy (Hugging Face의 QVAC) · qvac/BotPsy-0.8B 모델
토큰 풀링 : Hugging Face, 벡터 수를 4분의 1로 줄이면서 검색 품질 97,8 % 유지
11월 11일 — 톰 아르센이 Hugging Face 블로그에서 문서 토큰마다 벡터 하나를 보관하는 ColBERT 계열 다중 벡터 검색 인덱스의 크기를 줄이는 방법을 자세히 설명했다. 토큰 묶기(토큰 풀링)는 서로 가까운 벡터를 합치며, Sentence Transformers는 모델의 전체 표현과 압축 표현을 동시에 학습시키는 손실 함수 MultiVectorTokenPoolingLoss을 추가했다.
| 추론 시 풀링 (NanoBEIR, nDCG@10) | 평균 벡터 수 | 일반 학습 | 풀링 인지 학습 |
|---|---|---|---|
| 풀링 없음 | 193,22 | 51,84 | 52,39 |
pool_factor=4 | 48,68 | 49,03 | 51,23 |
max_tokens=4 | 4,00 | 37,22 | 43,00 |
이렇게 학습한 모델은 벡터 수를 4분의 1로 줄여도 원래 점수의 97,8 %를 유지한다. 일반 학습의 경우에는 94,6 %다. 측정은 단일 설정(ModernBERT-base, 한 에포크)에서 이뤄졌으며, 체크포인트 2개가 Hub에 공개됐다.
Seedance 2.5, Pika와 Runway에서 4K 지원
11월 11일 — BytePlus를 통해 제공되는 ByteDance의 동영상 모델 Seedance 2.5가 4K를 지원한다. Pika는 자사 플랫폼과 Pika API Club에서 네이티브 4K를 제공하며, 먼저 초안으로 장면을 작업한 뒤 4K로 완성하는 방식을 제안한다. Pika는 8월 17일부터 이 모델을 1080p로 제공하면서 4K 확대(업스케일)를 지원해 왔다. 약 두 시간 뒤 Runway도 자사 플랫폼에서 Seedance 2.5의 4K 지원을 발표했지만, 네이티브 4K인지는 밝히지 않았다. 요금, 최대 길이, 크레딧 비용은 모두 공개되지 않았다.
🔗 @pika_labs의 발표 · @runwayml의 발표
Git, 재귀적 복제 중 코드 실행을 포함한 취약점 6개 수정
11월 10일 — 인공지능 분야와 별개로, Git 프로젝트가 Git 2.56.1을 공개하고 Git 2.50.2까지 수정 사항을 백포트했다. 일라이자 뉴렌이 GitHub Blog에서 상세히 설명한 취약점 6개를 수정하기 위한 조치다.
| 수정된 취약점 | 위험 유형 |
|---|---|
| CVE-2026-111760 | 하위 모듈의 .git 파일을 통한 재귀적 복제 중 코드 실행 |
| CVE-2026-113408 | 서버가 알린 HEAD를 통한 경로 순회 |
| CVE-2026-114467 | GPG 서명 제거 시 스택 손상 |
| CVE-2026-114469 | 바이너리 패치 적용 시 범위 밖 읽기 |
| CVE-2026-105437 | 대규모 병합 시 힙 손상 |
| CVE-2026-114466 | git fast-import 스트림을 통한 파일 시스템 접근 |
GitHub는 이미 github.com과 Enterprise Cloud에 수정 사항을 배포했으며, GitHub Enterprise Server 3.19.15, 3.20.11, 3.21.9, 3.22.4를 공개했다. 또한 수정된 Git을 포함한 GitHub Desktop과 GitHub Copilot 앱 버전을 준비하고 있다. 권고 사항은 Git과 Git 사본을 내장한 모든 애플리케이션을 업데이트하는 것이다. 업데이트할 수 없다면 신뢰할 수 있는 서버에서만 복제해야 한다.
단신
코딩 에이전트와 개발 도구
- Zed 1.28 및 1.29 프리뷰 — 1.28이 안정 버전으로 전환되며, 11월 4일에 다룬 프리뷰의 변경 사항을 반영했다. 최신 Agent Client Protocol,
read_file읽기 결과의 2 000자 제한, 선택적으로 켤 수 있는 Git 자동 가져오기가 포함된다. 1.29 프리뷰는 Anthropic 제공자에서 Claude Fable 5.2와 Claude Mythos 5.2를 지원한다. 🔗 출처 - Antigravity CLI 1.5.4 및 1.5.5 — 1.5.5는 터미널에 /swarm 프리뷰와 전체 화면 보기인 /swarm board를 추가하고, Claude Code 플러그인의 명령과 훅을 가져오는 과정의 오류를 수정했다. 1.5.4는 ACP 세션에서 Auto 모드를 사용할 수 있게 하고 훅에 전달하는 데이터를 확충했다. 🔗 출처
- Gemini CLI — v0.68.0 출시 다음 날에도 새 버전은 없었고, 야간 빌드(nightly)는 11월 5일부터 매일 밤 그랬듯 또 실패했다. 기본 브랜치에는 네 가지 수정 사항이 병합됐으며, 이미지나 바이너리 파일을 처리할 때 모델이 빈 응답 차례를 보낸 뒤 발생하던 400 오류 수정도 포함됐다. 🔗 출처
- Copilot CLI 1.0.110-1 — 13가지 수정 사항만 포함한 프리뷰다. 재개한 세션을 더 이상 동시에 수정할 수 없으며, 로컬 MCP 서버가 잘린 Unicode 문자를 반환해도 도구 호출이 멈추지 않는다. SDK 1.0.32-preview.1에서는 Copilot Fusion과 그 수준을 선택할 수 있다. 🔗 출처
- Genspark의 Gemini 4 Carbon — Genspark가 AI Chat과 Code Agent에 Gemini 4 Carbon을 제공한다. 같은 Code Agent에 Claude Fable 5.2를 제공한 다음 날의 발표이며, 적용 요금제나 크레딧 사용량은 밝히지 않았다. 🔗 출처
- Basis와 Devin for Startups — Cognition이 Basis의 Devin 활용 방식을 영상으로 공개했다. Basis의 회계 에이전트는 일부 작업 시간을 20시간에서 30분으로 줄였으며, 이 수치는 Devin이 아닌 Basis에 관한 것이다. Cognition은 선정된 팀에 65 000달러 상당의 크레딧을 제공하는 Devin for Startups도 다시 시작했다. 🔗 출처
- shem — 주앙 갈레구가 Hugging Face 모델을 컨테이너 이미지처럼 실행하는 실험용 런타임을 공개했다. Dockerfile을
FROM hf.co/...로 시작할 수 있으며, 반대로 모델 가중치로 만든 프로세서에서 컨테이너를 실행할 수도 있다. 그의 설명에 따르면 “대부분의 경우” 작동한다. 🔗 출처
GitHub
- GitHub Apps를 통한 Copilot 라이선스 관리 — 기업용 GitHub Apps가 새로운 세분화 권한인 Enterprise Copilot license management를 통해 Copilot 라이선스 관리 API를 호출하고, 기업 사용자와 팀에 라이선스를 할당할 수 있다. 🔗 출처
- Dependabot과 비활성 저장소 — 12월 8일부터 GitHub는 1년 동안 활동이 없었던 저장소 대부분에서 Dependabot 알림을 비활성화한다. 알림은 삭제되지 않고 보관되며, 첫 푸시가 발생하면 복원된다. GitHub Enterprise Server에는 적용되지 않는다. 🔗 출처
- 개인 계정의 이슈 유형과 필드 — 지금까지 조직에만 제공되던 기능이 개인 저장소에서도 정식으로 제공된다. 유형과 필드를 각각 최대 25개까지 만들 수 있으며, 프로젝트, REST 및 GraphQL API, 웹훅에서 사용할 수 있다. 🔗 출처
- GitHub 대시보드 — 화면 구성이 더 간결해졌으며, 풀 리퀘스트와 이슈를 각각 세 개 대신 여섯 개씩 표시한다. Feed 또는 Home 탭을 고정할 수 있고, 계정에 에이전트 세션이 없으면 해당 섹션을 숨긴다. 🔗 출처
기업과 활용 사례
- Singapore Airlines — OpenAI API를 기반으로 다시 구축한 챗봇 Kris의 고객 만족도 점수가 두 배로 올랐다. 통화 요약은 상담원의 처리 시간을 약 10 % 줄였으며, 직원의 60 % 이상이 매달 내부 플랫폼 Jarvis를 사용한다. 🔗 출처
- Cogent Security — 이 스타트업은 GPT-6.1 Sol, GPT-6 Astra, GPT-5.6을 기반으로 사이버 방어 에이전트를 구축하며, 도구를 호출할 때마다 사전에 정책을 확인한다. 회사에 따르면 Fortune 1000에 속한 자동차 업계 고객 한 곳은 치명적 취약점의 평균 수정 소요 시간을 75 % 줄였다. 🔗 출처
- JioStar — 약 8주 만에 OpenAI API로 구축한 JioHotstar의 콘텐츠 탐색용 음성 도우미는 사용자가 5억 명 이상인 플랫폼에서 15개 이상의 언어를 구사한다. JioStar에 따르면 이 도우미 사용자의 60 % 이상이 글을 입력하는 대신 음성으로 대화한다. 🔗 출처
- 참전용사를 위한 ChatGPT Plus — 미국 재향군인의 날을 맞아 OpenAI는 지난 1년간 참전용사와 전역을 준비 중인 군인 20 000명 이상이 ChatGPT Plus 1년 무료 이용 혜택을 신청했고, 군 관련 커뮤니티 구성원 약 1 000명이 교육을 받았다고 밝혔다. 🔗 출처
- ChatGPT의 fal 플러그인 — fal이 대화 안에서 이미지와 동영상을 생성하고 편집하는 자사 플러그인을 소개했다. GPT Image 2.6, FLUX 3 Max(26개 장면), fal Recast로 만든 60초 광고도 선보였으나, 플러그인 공개일은 명시하지 않았다. 🔗 출처
- Grok Bot의 Gopuff — 이제 Grok Bot이 Gopuff에서 식료품, 간식, 생활용품의 주문 전 과정을 처리한다. Gopuff에 따르면 배송은 가장 빠른 경우 15분 만에 이뤄지며, 제공 국가와 요금제는 밝히지 않았다. 🔗 출처
- Genspark Genius — Genspark가 홍보대사를 모집한다. 매달 창작물 하나를 공유하면 Pro 요금제, 새 기능 조기 이용, 크레딧, 공식 채널을 통한 홍보를 제공한다. 🔗 출처
모델, 미디어, 연구
- MiniMax H3 — 가중치 공개 100일을 맞아 MiniMax는 Hugging Face에서 파생 모델 1 472개와 다운로드 1억 4 800만 회 이상을 기록했다고 주장했으나, 이 수치는 검증되지 않았다. H3-Image는 fal, Runware, EvoLink, Miora에 제공되며, Miora에서는 11월 17일까지 무료다. 🔗 출처
- AI Engineer Paris의 Voxtral Transcribe 3 — Mistral이 메인 무대의 모든 발표를 실시간으로 전사했다. 모델에 발표자 이름과 프로그램에 나오는 용어를 제공하는 문맥 편향 기법을 사용했으며, 이를 통한 개선 수치는 밝히지 않았다. 🔗 출처
- Google AI Edge Gallery의 로컬 음성 기능 — 앱에 오프라인 음성 인식과 음성 합성이 추가됐다. Android에서는 ML Kit이 100개 이상의 언어를 실시간보다 10배 빠른 속도로 전사하며, 다른 플랫폼은 Parakeet-TDT 0.6B나 Kokoro-82M 같은 공개 모델이 지원한다. 🔗 출처
- NVIDIA의 Déjà View — 매개변수 117M개인 이 3D 재구성 모델은 동일한 트랜스포머 블록을 여러 번 적용해, 다섯 가지 벤치마크에서 최대 10배 큰 모델들과 동등한 성능을 낸다. NeurIPS 2026 구두 발표로 소개됐으며, 논문은 5월부터 arXiv에 공개돼 있다. 🔗 출처
- 스페인어 의료 문서의 질병 식별 — OpenMed가 CPU에서 사용할 수 있는 공개 모델 두 개를 Apache-2.0으로 배포했다. 연구팀에 따르면 DisTEMIST로 미세 조정한 결과, 범용 모델에서 약 36~39였던 F1이 GLiNER2.5 버전에서는 약 73으로 올랐다. 🔗 출처
- 에이전트의 x402 결제 — Qwen3 235B, DeepSeek V4 Pro, Llama 3.3 70B가 자체 판단에 맡겨졌을 때 Fizzl 시험에서 각각 59점, 55점, 30점을 받아 모두 불합격했다. 코드가 결제를 결정하도록 하자(x402-safe-fetch) 점수가 각각 94점, 100점, 94점으로 올랐다. 🔗 출처
- FiftyOne의 GR00T-X-Embodiment-Sim — 하프리트 사호타(Voxel51)가 NVIDIA 데이터 세트의 시뮬레이션 에피소드 42개를 변환했다. 일곱 가지 로봇 본체마다 여섯 개씩이며, 카메라와 관절 원격 측정 데이터를 정렬했다. 🔗 출처
생태계
- Sakana AI — 전 NSA 국장이자 퇴역 제독인 마이클 로저스와 CIA에서 약 30년간 근무한 톰 모런이 도쿄 소재 이 스타트업의 국방 및 사이버 보안 분야 수석 고문으로 합류한다. 🔗 출처
- NVIDIA의 재활용 사례 — COP31을 맞아 NVIDIA가 컴퓨터 비전으로 폐기물을 분류하는 Inception 프로그램 소속 스타트업 네 곳을 소개했다. 여기에는 폐기물 15톤을 검사하는 시간을 375시간에서 6시간으로 줄인 Greyparrot이 포함된다. 새로운 NVIDIA 제품 발표는 없다. 🔗 출처
- Perplexity의 AI 규정 준수 안내서 — 유럽 AI Act, NIST AI RMF, ISO/IEC 42001을 살펴보고, 에이전트를 위한 세 가지 통제 방안을 제시한다. 꼭 필요한 범위로 접근 제한, 모든 행동의 기록, 영향이 큰 행동에 대한 사람의 승인이다. 🔗 출처
- Perplexity의 MCP 아키텍처 안내서 — 호스트·클라이언트·서버의 역할, JSON-RPC 2.0 메시지, 로컬 전송과 Streamable HTTP, 다중 테넌트 구성 등을 다룬다. 11월 4일 보안 안내서에 이은 기술 설명이며, 제품 발표는 없다. 🔗 출처
- 토론토의 Cohere 해커톤 — Cohere가 2027년 1월 30일 토론토 대학교와 함께 첫 해커톤인 Hacking Higher Ed를 개최한다. 주제는 고등교육에서의 AI 활용이며, 상금은 3 000달러, 2 000달러, 1 000달러다. 신청은 1월 22일까지 받는다. 🔗 출처
이 소식이 의미하는 것
Google DeepMind는 생성보다 검증이 더 중요한 두 문제에 자사 모델을 적용한다. AlphaGenome 2는 더 이상 조직별 평균에 머물지 않는다. 연구자가 관심을 두는 세포에서 유전 변이가 미치는 영향을 예측하며, 면역세포 28종의 지도인 TenK10K에서 성능 개선을 측정한다. AlphaProof Code는 형식 검증의 대상을 프로토콜 설계에서 컴파일된 코드로 옮기며, 역할을 명확히 나눈다. 에이전트는 600만 줄이 넘는 증명 코드를 작성하고, Lean 검증기는 각 단계를 확인하며, 사람은 명세와 코드의 약 1 %를 검토한다. 두 발표에는 한계도 있다. AlphaGenome 2는 여전히 연구용으로만 제공되며, Signal에 관한 최초라는 주장은 Google DeepMind 측의 주장이다.
안전성은 자체 측정 도구의 한계에 부딪힌다. OpenAI는 감시의 핵심 수단 중 하나인 추론 사슬이 사전 학습이 진행될수록 읽기 어려워진다는 사실을 확인했고, 두 지표 중 하나인 제어 가능성에는 노이즈가 많다고 스스로 평가한다. Perplexity는 전통적인 깃발 뺏기 형식이 에이전트를 시험하려는 경계에서 벗어나게 하며, 세 차례의 시험과 패치 적용 전 설정에서는 사이버 보안 특화 모델이 범용 버전보다 낮은 성능을 낼 수도 있음을 보여준다. 두 사례의 결론은 모델 자체만큼이나 평가 방식에 관한 것이다.
이날 소식은 실제로 제공되는 것과 발표에 머무는 것을 뚜렷하게 구분한다. Runway는 Praxis-1의 가중치와 미세 조정 코드를 공개했으며, 보고서는 이 모델의 성능을 네 경쟁 모델보다 낮게 평가한다. Tether는 BotPsy를 다운로드할 수 있게 했다. 반면 Qwen4-Max는 벤치마크, 크기, 가격 없이 등장했고, ElevenLabs는 현재 이용할 수 있는 것(Marketplace, Partner Program, ElevenAI)과 나중에 제공할 것(Interaction Engine, Memory, Routines, 미세 조정)을 스스로 구분했다. 직접 시험해 보려는 사람에게 후자는 아직 약속에 머문다.
에이전트는 장기적인 작업과 팀 업무에 자리 잡고 있다. Grok Bot 1.0은 회의에 참여하고 Slack과 Teams에서 다른 Bot과 협업한다. Delta의 Cloud Runners는 작성자의 컴퓨터 없이도 에이전트 스레드를 실행한다. VS Code는 결정을 기다리는 세션을 위한 받은편지함을 추가한다. A2UI는 에이전트가 텍스트 대신 화면으로 응답할 수 있게 한다. 각 제품은 새로 생기는 위험에도 통제 장치를 둔다. Grok Bot은 개인별 권한을 적용하고 공개 채널에서 발언하기 전에 확인하며, Delta는 비공개 미리보기를 제공하고, VS Code는 샌드박스에 세분화된 권한과 변수 숨김을 적용한다.
출처
- AlphaGenome 2 (Google DeepMind)
- AlphaGenome 2 (@GoogleDeepMind)
- AlphaProof Code 소개 (Google DeepMind)
- Signal의 형식 검증 (PDF, Google DeepMind)
- Qwen4-Max 프리뷰 (@Alibaba_Qwen)
- Token Plan (QwenCloud)
- Praxis-1 출시 (Runway)
- Praxis-1 기술 보고서 (Runway)
- Praxis-1 컬렉션 (Hugging Face)
- ElevenLabs 뉴욕 서밋 (ElevenLabs)
- 서밋 발표 내용 (@ElevenLabs)
- ElevenLabs와 NVIDIA (ElevenLabs)
- 사용 한도 전체 초기화 (@ClaudeDevs)
- Grok Bot 1.0 (SpaceXSI)
- Grok Bot 1.0 (@SpaceXSI)
- ChatGPT의 Advanced 및 Standard 음성 지원 종료 (OpenAI 도움말)
- Advanced 및 Standard 음성 지원 종료 (@OpenAINewsroom)
- Apple CarPlay의 Gemini (blog.google)
- 모델 수명 주기 전반의 CoT 감시 가능성 (OpenAI)
- 제프리 지 왕의 스레드
- SPACE 탈출: 제2부 (Perplexity)
- SPACE 탈출: 제2부 (@perplexity_ai)
- Gemini Decision 1 (Google AI Studio)
- Decisions API (Google AI Studio)
- A2UI 1.0 (Google Developers 블로그)
- 이제 Delta에서 사용할 수 있는 Cloud Runners
- Cloud Runners 문서 (Delta)
- VS Code 1.146 출시 안내
- Qwen Code v1.0.0-preview (GitHub)
- BotPsy (Hugging Face의 QVAC)
- qvac/BotPsy-0.8B 모델 (Hugging Face)
- 토큰 풀링을 고려한 학습 (Hugging Face)
- 4K의 Seedance 2.5 (@pika_labs)
- 4K의 Seedance 2.5 (@runwayml)
- Git 보안 취약점 공개 (GitHub 블로그)
- Zed v1.28.1 (GitHub)
- Antigravity 변경 기록
- Gemini CLI, PR 30228 (GitHub)
- Copilot CLI v1.0.110-1 (GitHub)
- Genspark의 Gemini 4 Carbon (@genspark_ai)
- Basis와 Devin for Startups (@cognition)
- 이제 LLM도 컨테이너다 (Hugging Face)
- GitHub Apps를 통한 Copilot 라이선스 관리 (GitHub 변경 기록)
- 비활성 저장소의 Dependabot 알림 일시 중지 (GitHub 변경 기록)
- 개인 계정의 이슈 유형과 필드 (GitHub 변경 기록)
- 더 풍부한 정보를 제공하는 GitHub 대시보드 (GitHub 변경 기록)
- Singapore Airlines (OpenAI)
- Cogent Security (OpenAI)
- JioStar, 비제이 세샤드리 (OpenAI)
- 참전용사를 위한 ChatGPT Plus (OpenAI)
- ChatGPT의 fal 플러그인 (@fal)
- Grok Bot의 Gopuff (@bot)
- Genspark Genius (@genspark_ai)
- MiniMax H3, 100일 (@RyanLeeMiniMax)
- AI Engineer Paris의 Voxtral Transcribe 3 (@MistralAI)
- Google AI Edge Gallery의 로컬 음성 기능 (Google Developers 블로그)
- Déjà View (@NVIDIAAI)
- 스페인어 임상 문서에서 질병 찾기 (OpenMed)
- 지갑을 갖춘 공개 AI 모델 (Fizzl)
- FiftyOne의 GR00T-X-Embodiment-Sim (Hugging Face)
- 마이클 로저스와 톰 모런 (Sakana AI)
- AI 재활용 스타트업 (NVIDIA 블로그)
- AI 규정 준수 (Perplexity)
- MCP 아키텍처 (Perplexity)
- Hacking Higher Ed (@cohere)