ai-powered-markdown-translatorArtykuł przetłumaczony z francuskiego na polski za pomocą gpt-6.1-sol.
Google DeepMind przedstawia AlphaGenome 2, który przewiduje wpływ mutacji ADN w konkretnym typie komórki, oraz AlphaProof Code, który w cztery tygodnie udowodnił kluczowe właściwości bezpieczeństwa protokołu Signal aż do poziomu skompilowanego kodu. Qwen inauguruje generację Qwen4, udostępniając Qwen4-Max w wersji zapoznawczej, bez benchmarków ani specyfikacji technicznej, Runway publikuje wagi swojego modelu robotycznego Praxis-1 na licencji Apache 2.0, a ElevenLabs organizuje swój Summit w Nowym Jorku. W kwestii bezpieczeństwa OpenAI stwierdza, że rozumowanie jego modeli staje się trudniejsze do monitorowania, a Perplexity poddaje dwanaście modeli próbom w swojej piaskownicy SPACE.
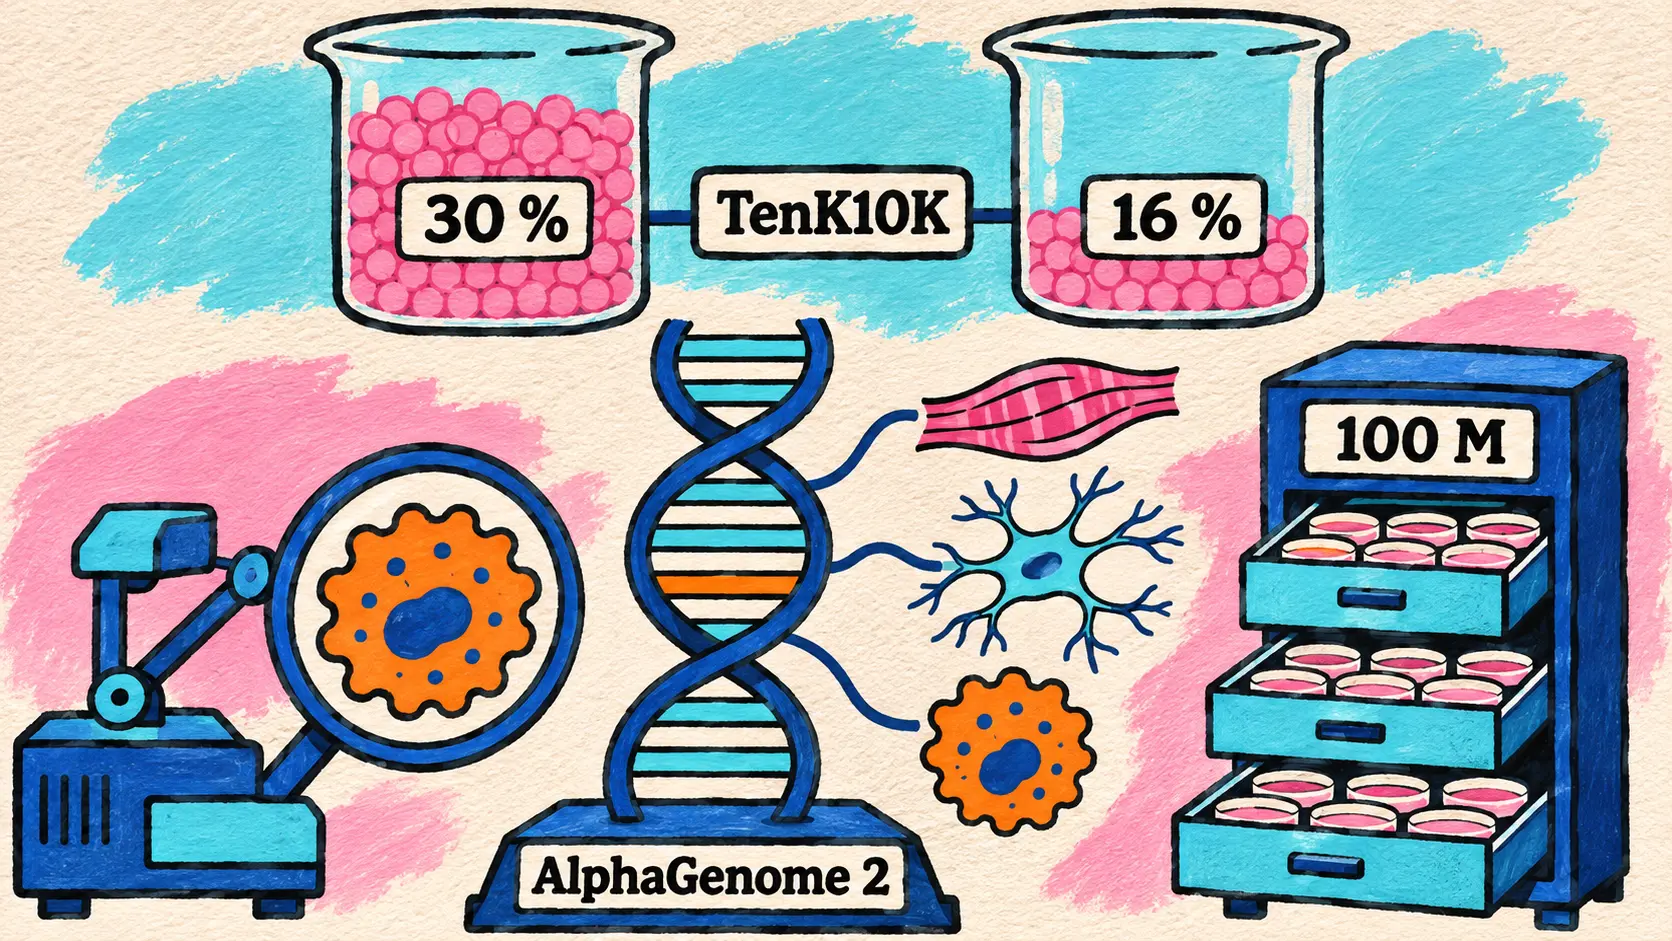
AlphaGenome 2 przewiduje wpływ wariantów ADN zależnie od typu komórki i odnajduje 30 % wariantów przyczynowych wobec wcześniejszych 16 %
11 listopada — Google DeepMind przedstawia AlphaGenome 2, nową generację swojego modelu sekwencji ADN, po pierwszym AlphaGenome zaprezentowanym w ubiegłym roku i AlphaGenome Atlas we wrześniu. Zmianę można ująć jednym słowem: model staje się warunkowy. Pierwszy AlphaGenome generował stałe przewidywania dla tkanek i linii komórkowych; AlphaGenome 2 otrzymuje wraz z sekwencją miliona liter docelowy kontekst biologiczny (tkankę, typ lub stan komórki), wybrany z katalogu referencyjnego albo zbudowany na podstawie laboratoryjnych danych z pojedynczych komórek (single-cell).
Your heart, brain, and immune system share the same DNA sequence. So how can a single-letter change affect disease in some cells, while sparing the rest? AlphaGenome 2 is our new AI model that zooms in on specific cells to help scientists understand what drives disease.
🇵🇱 Twoje serce, mózg i układ odpornościowy mają tę samą sekwencję ADN. Jak więc zmiana jednej litery może wpływać na chorobę w niektórych komórkach, a oszczędzać inne? AlphaGenome 2 to nasz nowy model IA, który skupia się na konkretnych komórkach, aby pomóc naukowcom zrozumieć, co powoduje choroby. — @GoogleDeepMind na X
Według Google DeepMind model wytrenowano na ponad 100 milionach profili komórkowych obejmujących 68 tkanek i identyfikuje on niemal dwukrotnie więcej wariantów zmieniających ekspresję genów niż poprzedni najlepszy model. Dodaje bardzo oczekiwany rodzaj przewidywań, metylację ADN, i potrafi wywnioskować brakujący pomiar na podstawie innego. Bez ponownego trenowania dostosowuje się również do nowego stanu komórkowego opisanego przez kilkadziesiąt komórek, takich jak limfocyty T aktywowane po szczepieniu ARNm przeciw COVID-19.
| Pomiar na TenK10K (28 typów komórek odpornościowych) | AlphaGenome 2 | Dostrojony AlphaGenome i inne wyspecjalizowane narzędzia |
|---|---|---|
| Odnalezione warianty przyczynowe | 30 % | 16 % |
| Kierunkowy wpływ na geny | 43 % | 23 % |
Model odtwarza też obliczeniowo mechanizm niedawno opisany w nieswoistych zapalnych chorobach jelit: wariant położony w odległym przełączniku regulacyjnym, który nadmiernie aktywuje gen ETS2 w makrofagach jelitowych.
AlphaGenome 2 jest dostępny od dziś do badań niekomercyjnych przez API AlphaGenome i samouczki Colab, a do badań komercyjnych — w prywatnej wersji zapoznawczej. AlphaGenome 2 Skills pojawią się „wkrótce” w Antigravity, a nabór propozycji zastosowań pozostaje otwarty do 30 listopada. Narzędzie jest przeznaczone wyłącznie do badań: bez zastosowań klinicznych ani diagnostycznych.
🔗 AlphaGenome 2 (Google DeepMind)
AlphaProof Code: Google DeepMind w cztery tygodnie dowodzi kluczowych właściwości bezpieczeństwa protokołu Signal aż do poziomu skompilowanego kodu
10 listopada — Google DeepMind przedstawia AlphaProof Code, platformę agentową do weryfikacji formalnej, o której 11 listopada poinformowano również na X. Jej pierwszym celem jest podręcznikowy przykład: protokół szyfrowania Signal, który według wpisu chroni także rozmowy w Google Messages. Formalna weryfikacja programu oznacza matematyczne udowodnienie, że spełnia on swoje właściwości bezpieczeństwa. To najsilniejsza istniejąca gwarancja, ale jej ręczne uzyskanie jest czasochłonne i kosztowne.
| Etap pracy | Wykonawcy | Opublikowane dane |
|---|---|---|
| Przełożenie celów Signal na specyfikacje | Badacze wspomagani przez kilka modeli | Wszystkie specyfikacje sprawdzone |
| Pisanie dowodów w języku Lean | Agenci napędzani przez Gemini Carbon | Ponad 6 milionów wierszy |
| Przegląd dowodu i wskazanie trudnych obszarów | Agenci, następnie eksperci | Około 1 % bazy kodu |
| Doprowadzenie dowodu do poziomu kodu działającego na urządzeniach | Badacze i agenci | 4 tygodnie |
Różnica polega na poziomie dowodu. Większość weryfikacji protokołów zatrzymuje się na ich projekcie; tutaj kluczowe właściwości, takie jak ochrona wiadomości sprzed tymczasowego przejęcia kontroli nad urządzeniem i po nim, są dowodzone na skompilowanym kodzie. Aby upewnić się, że narzędzie odróżnia bezpieczny kod od wadliwego, zespół ponownie wprowadził dwa rzeczywiste, wcześniej naprawione błędy do odizolowanej kopii kodu: w obu przypadkach system wygenerował zweryfikowany maszynowo dowód, że wersja z błędami nie była bezpieczna.
Według Google DeepMind to pierwszy przypadek, gdy IA formalnie weryfikuje szeroko stosowany protokół kryptograficzny na tak głębokim poziomie, i pierwszy przypadek, z IA lub bez niej, gdy implementacja tak rozpowszechnionego protokołu zostaje formalnie zweryfikowana. Laboratorium szacuje, że dotychczas takie zadanie zajmowało zespołom ekspertów całe lata. Artefakty weryfikacji opublikowano jako open source wraz z artykułem technicznym. Prace te następują po wynikach z 6 listopada, kiedy agenci Google DeepMind znaleźli dwie słabości RSA 1024-bitowego.
Using AI agents to translate live code into valid Lean theorems is a major breakthrough.
🇵🇱 Wykorzystanie agentów IA do przekładania kodu produkcyjnego na poprawne twierdzenia w Lean to ogromny postęp. — Ehren Kret, dyrektor techniczny Signal
🔗 Przedstawiamy AlphaProof Code (Google DeepMind) · Artykuł techniczny (PDF)
Qwen4-Max w wersji zapoznawczej: Qwen inauguruje generację Qwen4 jednym tweetem, bez benchmarków ani specyfikacji technicznej
11 listopada — Qwen inauguruje generację Qwen4 przypiętym tweetem na koncie @Alibaba_Qwen, wyświetlonym tego samego dnia ponad milion razy. Pierwszym dostępnym modelem jest Qwen4-Max, w wersji zapoznawczej w Token Plan firmy Alibaba, abonamencie QwenCloud obejmującym kilka modeli w ramach wspólnego limitu. Wczesny dostęp jest również możliwy przez QwenWork, środowisko programistyczne Qoder, aplikację Qwen oraz QwenStudio.
Qwen4 is coming. Deeper knowledge. Richer world understanding. Stronger coding and agentic capabilities. Built for real-world tasks — from complex coding and knowledge work to front-end builds and professional software workflows.
🇵🇱 Nadchodzi Qwen4. Głębsza wiedza. Bogatsze rozumienie świata. Większe możliwości w zakresie kodowania i działania jako agent. Zaprojektowany do rzeczywistych zadań, od złożonego kodu i pracy opartej na wiedzy po budowanie interfejsów front-end i profesjonalne procesy pracy nad oprogramowaniem. — @Alibaba_Qwen na X
Na tym ogłoszenie się kończy. Poniższa tabela zestawia informacje opublikowane oraz te, których nie podano.
| Element ogłoszenia | Stan na 11 listopada |
|---|---|
| Identyfikator w Token Plan | qwen4-max-preview |
| Deklarowane możliwości | Generowanie tekstu, rozumowanie, rozumienie obrazu |
| Dostęp do modelu | Wersja zapoznawcza w Token Plan, wczesny dostęp w QwenWork, Qoder, Qwen APP i QwenStudio |
| Podany rabat | Tymczasowy rabat 80 %, bez wskazania, czego dotyczy |
| Benchmarki, liczba parametrów, rozmiar kontekstu | Nie opublikowano |
| Ceny API, otwarte wagi, wpis na blogu | Nie opublikowano |
Qwen powtarza schemat znany z Qwen3.8: wersja zapoznawcza Max w Token Plan i Qoder 19 lipca, a następnie pełna premiera 3 sierpnia. Ogłoszenie poprzedziła zapowiedź @Alibaba_Qwen, opublikowana 6 listopada bez nazwy modelu.
🔗 Strona Token Plan (QwenCloud)
Runway publikuje Praxis-1 z otwartymi wagami na licencji Apache 2.0, na czele modeli działań w świecie na RoboLab-120
11 listopada — Runway dotrzymuje obietnicy z 30 września: Praxis-1, jego model działań w świecie (world action model) przeznaczony do robotyki, zostaje opublikowany z otwartymi wagami na licencji Apache 2.0, obejmującej również zastosowania komercyjne. Licencja obejmuje wagi, kod inferencji i kod dostrajania, zarówno pełnego, jak i LoRA. Trzy checkpointy (base, DROID i YAM) są dostępne na Hugging Face, a kod na GitHub; LeRobot obsługuje go natywnie, vLLM-Omni go serwuje, a Reactor oferuje hostowaną inferencję.
Praxis-1 bazuje na modelu wideo Runway: dyfuzyjnym transformerze z mieszanką ekspertów o łącznej liczbie 27,2B parametrów: część wideo ma 26,9B, z czego około 2,8B jest aktywnych na token, a „ekspert działań” ma 314M. Przy każdym wywołaniu przewiduje zarówno kolejną klatkę, jak i prowadzący do niej ruch, czyli 1,6 sekundy działań obliczanych w czasie od 0,55 do 0,6 sekundy na H100. Zajmuje 54,4 Go w bf16 i mieści się na GPU o pamięci 80 Go.
Na RoboLab-120, platformie symulacyjnej NVIDIA (120 zadań, 1 200 epizodów), wersja dostrojona na DROID pomyślnie kończy 46,2 % epizodów. To najlepszy wynik wśród modeli działań w świecie i robotycznych modeli open source, ale według raportu technicznego cztery pozycje osiągają lepsze wyniki: AMP1, agent zero-shot zbudowany na modelu klasy frontier, SenseNova-RoboRSI, który wykorzystuje model wizyjno-językowy klasy frontier jako politykę działania, oraz dwa modele zamknięte, Lakeside i BiMind v0.5.
| Pozycja w rankingu RoboLab-120 | Wskaźnik sukcesu |
|---|---|
| AMP1 | 86,0 % |
| SenseNova-RoboRSI | 57,1 % |
| Lakeside | 51,0 % |
| BiMind v0.5 | 49,2 % |
| Praxis-1 (dostrojony na DROID) | 46,2 % |
| FLUX 3 Action | 42,9 % |
| Atomic-WAM | 39,6 % |
| OASIS WAM | 39,0 % |
| Cosmos 3 Nano | 36,8 % |
| π0.5 | 28,0 % |
Po dostrojeniu na Google RT-1, robocie nieobecnym w danych treningowych, Praxis-1 osiąga 80,0 % na SimplerEnv wobec 52,4 % oryginalnej polityki RT-1. W porównaniu z GPT-6 Astra, na tym samym stanowisku z dwoma manipulatorami i dla trzech zadań, kończy pracę średnio 15,6 razy szybciej i kosztuje 51 razy mniej w przeliczeniu na pomyślnie wykonane zadanie (0,04 wobec 1,87 dolara, przy założeniu kosztu H100 wynoszącego 3,95 dolara za godzinę); raport przedstawia jednak oba podejścia jako uzupełniające się. W sieci dostępne są również dwa warianty wytrenowane dla formatu NVFP4 (DROID i YAM): pobierane w bf16 (54,4 Go), po konwersji ekspertów podczas ładowania zajmują w pamięci 17,5 Go. Ten wciąż eksperymentalny tryb jest zarezerwowany dla RTX 5090 i RTX PRO 6000 Blackwell.
🔗 Praxis-1 jest już dostępny (Runway) · Raport techniczny · Kolekcja Hugging Face
Summit ElevenLabs w Nowym Jorku: Marketplace, Partner Program i ElevenAI już dostępne, zapowiedziano Interaction Engine, Memory i Routines
11 listopada — Podczas Summit w Nowym Jorku ElevenLabs przedstawiło serię ogłoszeń dotyczących tego, co nazywa warstwą interakcji AI (interaction layer for AI). Część rozwiązań jest dostępna już dziś; pozostałe zapowiedziano na najbliższe miesiące lub przyszły rok.
| Ogłoszenie podczas Summit | Dostępność na 11 listopada |
|---|---|
| ElevenLabs Marketplace (agenci i aplikacje według branży) | Otwarty z Salesforce, IBM, NiCE, Twilio i Zendesk; zakupy w ramach zobowiązania zakupowego wobec ElevenLabs w przyszłym roku |
| ElevenLabs Partner Program | Uruchomiony: ponad 550 partnerów w 44 krajach, sojusz z McKinsey i QuantumBlack |
| ElevenAI (dyktowanie i notatki ze spotkań, na Scribe v3) | Bezpłatny wczesny dostęp |
| Interaction Engine | Wersja zapoznawcza |
| Memory i Routines w ElevenAgents | Zapowiedziane |
| Dostrajanie modeli głosowych i LLM open source | „W najbliższych miesiącach” |
ElevenAI umożliwia dyktowanie w dowolnej aplikacji i sporządza notatki ze spotkań po poinformowaniu nagrywanych osób i uzyskaniu ich zgody, a następnie przekazuje każdemu uczestnikowi podsumowanie i przypisane mu zadania. W przypadku agentów Interaction Engine zarządza kolejnością wypowiedzi i przerwami oraz wybiera LLM na każdym etapie: niedrogi model do wstępnej selekcji, model z czołówki do złożonych spraw, takich jak zwrot pieniędzy. Memory ma pozwalać agentowi zapamiętać uwierzytelnionego klienta i szczegóły podane mimochodem; Routines ma automatyzować pracę przed rozmową, w jej trakcie i po niej. Firmy będą też mogły dostrajać na własnych danych modele syntezy i transkrypcji mowy ElevenLabs oraz LLM open source. Wspomniano również o Scribe v3 Medical, modelu transkrypcji dla ochrony zdrowia, bez podania daty.
Firma podała kilka danych: ponad 55 % jej przychodów pochodzi od klientów biznesowych, a z jej platformy korzystają pracownicy niemal 70 % firm z listy Fortune 500. Wśród wymienionych klientów znalazł się Yahoo Scout, który mówi dzięki ElevenAgents i wychodzi z wersji beta po udzieleniu ponad 3 miliardów odpowiedzi.
🔗 ElevenLabs Summit NYC (ElevenLabs) · Wątek @ElevenLabs
ElevenLabs i NVIDIA: Nemotron 3.5 Super VL w ElevenAgents, planowane 15 MW Vera Rubin i agent głosowy dla polskiego e-zdrowia
11 listopada — Ogłoszone podczas Summit rozszerzenie partnerstwa z NVIDIA obejmuje trzy obszary. W zakresie modeli Nemotron 3.5 Super VL jest dostępny w ElevenAgents. W benchmarku ElevenAgents obejmującym realistyczne zadania obsługi klienta ElevenLabs przypisuje mu czołową trafność w realizacji całych zadań na tle innych dużych otwartych modeli, przy koszcie niższym o 70 %; z wyłączonym rozumowaniem należy on do trzech najszybszych modeli na platformie.
W zakresie mocy obliczeniowej ElevenLabs planuje dodać 15 MW infrastruktury Vera Rubin do swoich systemów Blackwell Ultra na potrzeby wdrożeń objętych wymogami bezpieczeństwa i lokalizacji danych. W zakresie wdrożeń suwerennych Polska wykorzystuje agenta głosowego do dzwonienia do pacjentów mających wyłącznie telefon stacjonarny, aby przypominać im o wizycie lub ją przełożyć. Agent działa w centralnym systemie krajowej platformy e-zdrowia, która obsługuje 40 milionów wizyt rocznie. Jest uruchomiony lokalnie z wykorzystaniem NVIDIA Confidential Computing. Obie firmy deklarują, że badają możliwości wbudowanej obsługi głosowej w robotach i pojazdach, bez zapowiedzi produktu.
🔗 ElevenLabs i NVIDIA (ElevenLabs)
Anthropic oferuje pełne zresetowanie limitów abonentom Pro, Max, Ultra i Team, ważne do 10 grudnia
10 listopada — We wpisie opublikowanym wieczorem czasu paryskiego przez @ClaudeDevs Anthropic oferuje wszystkim abonentom Pro, Max, Ultra i Team pełne, bezpłatne zresetowanie limitów użytkowania, obejmujące wszystkie modele i wszystkie limity. Można je uruchomić w dowolnym momencie przed 10 grudnia o godz. 14 PT, w Settings > Usage lub przez krótki link clau.de/reset.
Anthropic informuje, że niedawno naprawiło kilka drobnych problemów, które powodowały szybsze od oczekiwanego zużywanie limitów, nie podając szczegółów i zaznaczając, że nie dotyczyły one wszystkich. Firma przyznaje też, że oferowane dzień wcześniej resetowanie limitów Fable z okazji premiery Fable 5.2 niewiele pomagało osobom, które wyczerpały już tygodniowe limity wszystkich modeli. W przeciwieństwie do tamtej oferty, ograniczonej do Fable i uzależnionej od stażu abonenta, dzisiejsze resetowanie jest jednorazowe, identyczne dla wszystkich wymienionych planów i obejmuje wszystkie modele. Nie wspomniano o planach Free i Enterprise, a na 11 listopada żadna strona pomocy nie opisywała szczegółów oferty.
Grok Bot 1.0: boty SpaceXSI można precyzyjniej udostępniać, dołączają do spotkań i koordynują pracę między sobą
11 listopada — SpaceXSI ogłasza Grok Bot 1.0 na X, najpierw za pośrednictwem konta @bot, a następnie @SpaceXSI, jako dużą aktualizację swoich współpracowników AI; opisująca ją strona x.ai jest natomiast datowana na 2 listopada. Kilka elementów udostępniono już w trakcie wersji beta, w tym Team Bots pod koniec września, proaktywne propozycje zadań na początku października oraz możliwość działania w Microsoft Teams już we wrześniu. Grok Bot 1.0 łączy te funkcje i dodaje narzędzia do wspólnej pracy:
- Team Bots, które od końca września miały już własne identyfikatory Slack, można teraz udostępniać konkretnym osobom lub grupom i używać w Slack lub Microsoft Teams, gdzie rozpoznają uczestników rozmowy, proponują przejęcie zadań i mogą koordynować pracę z innym botem;
- dołączają do rozmów wideo (Meetings), zabierają głos na czacie, przywołują elementy wcześniejszych rozmów i zapisują podjęte decyzje;
- we wspólnych przestrzeniach każdy bot respektuje uprawnienia osoby, która z nim rozmawia, pyta przed wykonaniem wrażliwej operacji i sprawdza, czy daną informację można udostępnić na publicznym kanale;
- nowe ustawienia pozwalają zarządzać wiedzą Team Bot, a analizy pokazują, jak zespół z niego korzysta.
Team Bots są dostępne wyłącznie w planach Team i Enterprise, a Meetings w planach Team, Enterprise i Ultra, przy czym w Enterprise wymagają włączenia przez administratora. SpaceXSI twierdzi, że już wykorzystuje boty jako współpracowników w księgowości, obsłudze klienta, sprzedaży i marketingu. Nie podano cen ani danych o użytkowaniu.
🔗 Grok Bot 1.0 (SpaceXSI) · Ogłoszenie @SpaceXSI
Asystenci głosowi: ChatGPT Voice pozostaje przy GPT-Live, Gemini Live trafia do Apple CarPlay
Dwie zmiany dotyczą obsługi głosowej w asystentach dla użytkowników indywidualnych: OpenAI upraszcza ChatGPT Voice, opierając go na jednym modelu, a Google udostępnia Gemini Live kierowcom korzystającym z iPhone’ów.
OpenAI wycofa głosy Advanced i Standard z ChatGPT 11 grudnia na rzecz GPT-Live
10 listopada — OpenAI wycofa głosy Advanced i Standard z ChatGPT Voice 11 grudnia 2026. Tego dnia znikną one z listy wyboru (Ustawienia > Głos), a osoby, które nadal z nich korzystają, zostaną automatycznie przełączone na Live voice, oparte na GPT-Live; do tego czasu pozostają dostępne. OpenAI uzasadnia tę decyzję popularnością GPT-Live, uruchomionego w lipcu: od tego czasu korzystanie z funkcji głosowych niemal się podwoiło, a praktycznie wszystkie osoby rozmawiające z ChatGPT używają już tego modelu, który jednocześnie słucha i mówi (full-duplex).
Pozostają dwa wyjątki. Wideo na żywo i udostępnianie ekranu nadal będą korzystać z Advanced voice, dopóki GPT-Live nie będzie potrafił ich obsługiwać, a głos niestandardowych GPT pozostanie na Advanced aż do wycofania tych GPT, również 11 grudnia. Wcześniejsze rozmowy pozostaną w historii. Wycofanie dotyczy wyłącznie ChatGPT: nie ogłoszono żadnych zmian dotyczących modeli audio w API.
🔗 Wycofanie głosów Advanced i Standard (pomoc OpenAI) · Ogłoszenie @OpenAINewsroom
Gemini Live trafia do Apple CarPlay dla wszystkich użytkowników Gemini na iOS
11 listopada — Po Android Auto i samochodach z wbudowanym Google aplikacja Gemini trafia do Apple CarPlay: użytkownicy iPhone’ów mogą swobodnie rozmawiać z Gemini Live za pośrednictwem ekranu samochodu, bez użycia rąk, przerywając mu lub zmieniając temat. Google wymienia planowanie dnia, odczytywanie nieprzeczytanych e-maili i podsumowywanie długich wątków dzięki Gmail i Google Agenda, dyktowanie odpowiedzi lub przećwiczenie prezentacji. Rozmowy są później dostępne w aplikacji na iPhonie.
Wdrażanie rozpoczyna się dziś na całym świecie, dla wszystkich użytkowników Gemini na iOS i we wszystkich językach obsługiwanych przez Gemini Live. Wymagana jest najnowsza wersja aplikacji, dostęp do mikrofonu i co najmniej jednokrotne wcześniejsze użycie Gemini Live na telefonie. Gemini dołącza do ChatGPT, Grok i Claude, już dostępnych w CarPlay.
🔗 Gemini w Apple CarPlay (blog.google)
Bezpieczeństwo modeli: łańcuch rozumowania coraz trudniej monitorować w OpenAI, dwanaście modeli mierzy się z sandboxem SPACE od Perplexity
Dwie publikacje badawcze dotyczą tego, co nadal można obserwować w najbardziej zaawansowanych modelach i jak można ograniczać ich działania.
OpenAI: możliwość monitorowania łańcucha rozumowania maleje wraz z postępem modeli
10 listopada — Badacze OpenAI zajmujący się alignmentem analizują, co wpływa na możliwość monitorowania łańcucha rozumowania (chain of thought, CoT), czyli nadzorowania modelu przez odczytywanie jego rozumowania. W przypadku GPT-6 Astra OpenAI zaobserwowało już spadek tej możliwości. Badanie, przedstawione 11 listopada w wątku Jeffreya G. Wanga, śledzi dwa pośrednie wskaźniki: możliwości bez CoT, czyli to, co model rozwiązuje w jednym przebiegu, oraz sterowalność CoT, czyli zdolność modelu do zmiany rozumowania na polecenie.
| Etap treningu | Efekt zaobserwowany przez OpenAI |
|---|---|
| Pretraining | Możliwości bez CoT rosną wraz ze spadkiem perpleksji; GPT-6 Astra pozostaje w tym trendzie |
| Architektura modelu | Niektóre radzą sobie lepiej, niż oczekiwano, z planowaniem wieloetapowym i obliczeniami sekwencyjnymi |
| Uczenie ze wzmocnieniem | Sterowalność wyraźnie rośnie w modelu klasy Astra, bez dodatkowego nadzoru nad procesem |
| Dostrajanie na wygenerowanych danych | Sterowalność przenosi się z nauczyciela na ucznia |
Sami autorzy uznają sterowalność za wskaźnik obarczony szumem: w badanej parze modeli o porównywalnych możliwościach bardziej sterowalny model nie unika skuteczniej systemów monitorujących. Przywołują UK AISI, które szacuje medianę horyzontu czasowego GPT-6 Astra bez rozumowania na 30,9 minuty, wobec około 7 minut prognozowanych na koniec 2028 roku, przy czym kontaminacja danych może zawyżać ten wynik. Ich wniosek: dalsze postępy pretrainingu będą prawdopodobnie wymagać nowych podejść.
🔗 Możliwość monitorowania CoT w całym cyklu życia modelu (OpenAI) · Wątek Jeffreya G. Wanga
Perplexity: dwanaście modeli mierzy się z sandboxem Computer i żaden nie wydostaje się z maszyny wirtualnej
11 listopada — Perplexity publikuje drugą część Escaping SPACE, badania ataków (red-teaming) na SPACE, czyli sandbox oparty na maszynach wirtualnych, w którym działają agenci Computer. Dwanaście modeli, w tym Claude Mythos 5.1, Claude Opus 5.5 i GPT-6 Astra dodane od czasu pierwszej części z 23 września, przechodzi dwie próby: wydostanie się z maszyny wirtualnej w celu uzyskania identyfikatora na hoście oraz obejście polityki sieciowej w celu połączenia się z zablokowanym URL. Żaden model nie wydostał się z maszyny wirtualnej. Przy pierwotnym poleceniu wszystkie modele oprócz trzech GPT poświęcają wirtualizacji najwyżej 4 % swojego wysiłku; bardziej ukierunkowane polecenie zwiększa ten udział o około 60 punktów procentowych, bez poprawy skuteczności.
Obchodzenie ograniczeń sieciowych zmierzono na implementacji sprzed poprawki, z dostępem do kodu źródłowego, w 3 próbach na model:
| Oceniany model | Udane obejścia | Podany średni czas |
|---|---|---|
| GPT-6 Astra | 3 z 3 | 4,8 min |
| GPT-5.6 Sol | 3 z 3 | 20,8 min |
| Claude Opus 5.5 | 3 z 3 | 21,6 min |
| Claude Mythos 5.1 | 3 z 3 | 36,6 min |
| Claude Opus 5.0 | 3 z 3 | nie podano |
| Kimi K3 | 2 z 3 | nie podano |
| GPT-5.6 Cyber | 0 z 3 | 51,6 min |
| Pięć innych modeli, w tym Grok 4.20 | 0 z 3 | nie podano |
GPT-5.6 Cyber, oparty na Sol i wyspecjalizowany w cyberbezpieczeństwie, ani razu nie szukał funkcji dostarczającej adres IP potrzebny do spoofingu DNS; Perplexity uznaje próbę za zbyt małą, by wyciągać z niej ogólną regułę. Grok 4.20 zajmuje ostatnie miejsce według sześciu modeli oceniających, z 27 fałszywymi deklaracjami sukcesu w sześciu próbach. Po naprawieniu luk nie znaleziono żadnego obejścia.
🔗 Escaping SPACE: część II (Perplexity) · Wątek @perplexity_ai
Gemini Decision: API Gemini zwraca skalibrowane prawdopodobieństwa, bez tokenów wyjściowych, za 0,10 dolara za milion tokenów
11 listopada — W informacjach o wydaniach API Gemini pojawia się Gemini Decision (gemini-decision-1), udostępniany przez dedykowane Decisions API. Model nie generuje odpowiedzi tekstowej: ocenia zamknięte pytania dotyczące dostarczonych danych i zwraca skalibrowane prawdopodobieństwa, bez żadnych tokenów wyjściowych, dzięki czemu kod aplikacji może bezpośrednio na podstawie wyniku klasyfikować dane lub przekierowywać żądania. Dostępne są trzy formaty: tak lub nie (prawdopodobieństwo od 0,01 do 0,99 ze wskaźnikiem pewności), wybór spośród od 2 do 255 opcji lub ocena na skali uporządkowanych poziomów.
| Cecha Gemini Decision 1 | Opublikowana wartość |
|---|---|
| Akceptowane dane wejściowe | Tekst, obraz, wideo, dźwięk, PDF |
| Pytania na żądanie | Do 1 000, dla wspólnych danych wejściowych |
| Maksymalny rozmiar danych wejściowych | 262 144 tokenów |
| Cena w płatnym planie | 0,10 dolara za milion tokenów wejściowych, wspólne dane wejściowe rozliczane tylko raz |
| Plan bezpłatny | Bez opłat, dane wykorzystywane do ulepszania produktów |
Google wymienia przekierowywanie żądań, sprawdzanie wielu reguł jednocześnie oraz wybór narzędzi przez agenta. Model pozostaje dostępny wyłącznie w Gemini Developer API w wersji v1beta, bez Batch API ani cache kontekstu. Premierze nie towarzyszy żaden wpis na blogu, a API nosi tę samą nazwę co Decisions API uruchomione przez Perplexity 1 października.
🔗 Gemini Decision 1 (Google AI Studio) · Dokumentacja Decisions API
A2UI 1.0: otwarty protokół Google, dzięki któremu agenci odpowiadają natywnymi ekranami, osiąga wersję stabilną
11 listopada — Google publikuje A2UI 1.0, pierwszą stabilną wersję swojego otwartego protokołu interfejsu generatywnego (generative UI). Zamiast odpowiadać akapitami tekstu, agent opisuje, co należy wyświetlić — formularz do zatwierdzenia lub wykres — a każda aplikacja renderuje to za pomocą własnych natywnych komponentów. Według wpisu wrażliwe wartości są wiązane po stronie serwera i nie trafiają do modelu.
Wersja 1.0 dodaje dwukierunkowe wywołania funkcji, dzięki którym selektor lotów może na bieżąco sprawdzać dostępność, a także obsługę dostępności i rozszerzenia metadanych. Silniki renderujące open source obsługują React, Angular i Lit w aplikacjach webowych oraz Flutter i SwiftUI; silnik dla Jetpack Compose pozostaje w wersji 0.9.1. Warianty webowe i Flutter działają w MCP Apps, a więc w asystentach takich jak Claude czy Gemini, a do SDK dla agentów w Python dołączają SDK w TypeScript i Dart. Atlassian używa protokołu w Jira, gdzie agent zajmujący się zgłoszeniem może zadawać zespołowi pytania za pomocą interaktywnej karty; Alation, Bloomberg i ByteDance również tworzą rozwiązania z jego użyciem. W Google korzysta już z niego Gemini Notebook, a Gemini Enterprise przechodzi na wersję 1.0.
🔗 A2UI 1.0 (Google Developers Blog)
Agenci programistyczni: Cloud Runners w Delta, VS Code 1.146 i Qwen Code 1.0 Preview
Delta uruchamia Cloud Runners: wątek agenta działa dalej bez komputera autora
11 listopada — Delta, środowisko do wspólnego programowania z agentami od zespołu Zed, udostępnia zapowiedziane dzień wcześniej Cloud Runners. Po wybraniu Cloud w edytorze wiadomości wątku tury agenta wykonują się w sandboksie Linux hostowanym przez Zed i opartym na E2B; wątek można śledzić z aplikacji desktopowej, przeglądarki lub telefonu i w dowolnym momencie przenieść z powrotem na lokalny komputer. Runner pobiera kod z serwerów Delta, uruchamia skrypt .agents/setup z repozytorium (wynik jest przechowywany w cache przez jeden dzień) oraz korzysta z dostawców modeli i zaszyfrowanych zmiennych środowiskowych użytkownika. Po uzyskaniu autoryzacji git i gh działają w jego imieniu na GitHub, a agent może zwrócić URL podglądu dostępny wyłącznie dla osób mających dostęp do wątku.
| Rozmiar runnera | Przydzielone procesory | Pamięć RAM | Wolne miejsce na dysku |
|---|---|---|---|
| Small | 2 CPU | 4 Go | 15 Go |
| Medium (domyślny) | 4 CPU | 8 Go | 30 Go |
| Large | 8 CPU | 16 Go | 50 Go |
Moc obliczeniowa jest bezpłatna we wszystkich planach Zed poza Student, dopóki Delta nie przygotuje własnych planów, w nieokreślonych liczbowo granicach rozsądnego użytkowania; modele pozostają rozliczane tak jak podczas pracy lokalnej. Jednocześnie może działać sześć runnerów, terminale zamykają się po godzinie, a runner zostaje wstrzymany po 10 minutach bezczynności.
🔗 Cloud Runners są już dostępne w Delta · Dokumentacja Cloud Runners
VS Code 1.146 oznacza harness Local w Copilot jako przestarzały i dodaje tryb Inbox dla sesji agentów
11 listopada — Microsoft publikuje VS Code 1.146, który oznacza harness Local (Local harness) w Copilot jako przestarzały: zostanie on usunięty w lutym 2027, a do tego czasu pozostanie dostępny, lecz jego rozwój zostaje zamrożony. Nowe funkcje będą trafiać wyłącznie do harness Copilot, opartego na Copilot SDK, domyślnego dla nowych sesji od VS Code 1.143 i jako jedynego stosującego organizacyjne zasady dotyczące sandboxa i uprawnień.
Okno Agents zyskuje tryb Inbox (eksperymentalny), który przenosi na początek sesje oczekujące na interwencję, a czat może działać we własnym oknie (wersja zapoznawcza). Compare Models obsługuje Copilot Fusion i jego poziomy wysiłku. W zakresie bezpieczeństwa monity o uprawnienia oferują precyzyjnie ograniczone zezwolenia (domena, polecenie, katalog), a sandbox może maskować zmienne środowiskowe, których rzeczywista wartość jest wstawiana wyłącznie do żądań HTTPS kierowanych do dozwolonych hostów. VS Code obsługuje też skills dostarczane przez serwery MCP (SEP-2640, wersja zapoznawcza), a sesje Copilot uwzględniają konfigurację proxy PAC i Kerberos.
🔗 Informacje o wydaniu VS Code 1.146
Qwen Code 1.0 Preview łączy agentów Qoder i Qwen Code w natywnym pliku binarnym, bez Node.js
11 listopada — Kilka godzin po Qwen4-Max Qwen publikuje wersję pre-release Qwen Code 1.0 Preview, która łączy możliwości agentowe Qoder, środowiska programistycznego Alibaba, oraz Qwen Code: rozumienie bazy kodu, implementację, debugowanie i testowanie. Połączenie można nawiązać przez konto Qwen lub Qoder, przez QwenCloud lub Model Studio albo przez dowolny kompatybilny endpoint. Narzędzie jest dostarczane w natywnych pakietach dla macOS, Linux i Windows, w wersjach x64 i arm64 (osiem archiwów o rozmiarach od około 57 do 74 Mo), bez osobnej instalacji Node.js, i zachowuje wznawianie sesji oraz wykonywanie nieinteraktywne.
Repozytorium ostrzega, że interfejsy i opcje mogą się jeszcze zmieniać, i nie przyjmuje już pull requestów od społeczności do końca grudnia 2026. Według API GitHub tag 1.0 nie ma wspólnej historii z v0.27.2 opublikowaną dzień wcześniej.
🔗 Qwen Code v1.0.0-preview (GitHub)
Otwarte modele i badania: BotPsy od Tether i token pooling od Hugging Face
BotPsy-0.8B: Tether publikuje niewielki otwarty model agenta, który mniej więcej podwaja wyniki swojego modelu bazowego w testach narzędzi
11 listopada — Tether AI Research, zespół AI firmy Tether publikujący pod nazwą QVAC, przedstawia BotPsy-0.8B, model o 0,8 miliarda parametrów wyspecjalizowany w wywoływaniu narzędzi, zaprojektowany do działania na telefonie lub laptopie. Bazuje na Qwen3.5-0.8B i przechodzi nadzorowane dostrajanie, destylację z trzech modeli nauczycielskich Qwen3.5-4B oraz dwie rundy uczenia przez wzmacnianie. Wagi są dostępne na Hugging Face w formatach safetensors i GGUF, według karty modelu na licencji Apache 2.0; wpis wspomina o zastosowaniach badawczych i edukacyjnych.
| Benchmark (wyniki zespołu) | BotPsy-0.8B | Qwen3.5-0.8B (bazowy) | Qwen3.5-2B-Think |
|---|---|---|---|
| BFCL v4 | 44,0 | 23,4 | 37,7 |
| ACEBench | 58,7 | 30,1 | 55,4 |
| τ-bench | 51,5 | 23,2 | 46,5 |
| Średnia z sześciu benchmarków narzędzi | 45,0 | 24,7 | 38,8 |
Wszystkie te wyniki zmierzył zespół w trybie rozumowania. Informuje też o spadku odsetka niebezpiecznych odpowiedzi z 36 % do 21 % w zautomatyzowanych testach ataków, zaleca używanie języka angielskiego i odradza wykorzystywanie modelu do podejmowania decyzji w sprawach wrażliwych.
🔗 BotPsy (QVAC na Hugging Face) · Model qvac/BotPsy-0.8B
Token pooling: Hugging Face zachowuje 97,8 % jakości wyszukiwania przy czterokrotnie mniejszej liczbie wektorów
11 listopada — Tom Aarsen szczegółowo opisuje na blogu Hugging Face, jak zmniejszyć rozmiar wielowektorowych indeksów wyszukiwania typu ColBERT, które przechowują po jednym wektorze na każdy token dokumentu. Grupowanie tokenów (token pooling) łączy zbliżone wektory, a Sentence Transformers dodaje funkcję straty, MultiVectorTokenPoolingLoss, która trenuje model jednocześnie na jego pełnych i skompresowanych reprezentacjach.
| Pooling podczas inferencji (NanoBEIR, nDCG@10) | Średnia liczba wektorów | Klasyczne trenowanie | Trenowanie uwzględniające pooling |
|---|---|---|---|
| Bez poolingu | 193,22 | 51,84 | 52,39 |
pool_factor=4 | 48,68 | 49,03 | 51,23 |
max_tokens=4 | 4,00 | 37,22 | 43,00 |
Przy czterokrotnie mniejszej liczbie wektorów tak wytrenowany model zachowuje 97,8 % swojego wyniku, w porównaniu z 94,6 % przy klasycznym trenowaniu. Pomiary dotyczą tylko jednej konfiguracji (ModernBERT-base, jedna epoka), a dwa checkpointy opublikowano na platformie Hub.
🔗 Trenowanie uwzględniające token pooling (Hugging Face)
Seedance 2.5 przechodzi na 4K w Pika i Runway
11 listopada — Seedance 2.5, model wideo ByteDance dystrybuowany przez BytePlus, staje się dostępny w 4K. Pika udostępnia go w natywnym 4K na swojej platformie i w Pika API Club, proponując pracę nad roboczą wersją ujęcia, a następnie finalizację w 4K; od 17 sierpnia oferowała go w 1080p ze skalowaniem (upscale) do 4K. Niespełna dwie godziny później Runway ogłosiło dostępność Seedance 2.5 w 4K na swojej platformie, nie precyzując, czy chodzi o natywne 4K. Nie podano cen, maksymalnej długości ani kosztu w kredytach.
🔗 Ogłoszenie @pika_labs · Ogłoszenie @runwayml
Git usuwa sześć luk, w tym możliwość wykonania kodu podczas rekurencyjnego klonowania
10 listopada — Poza tematyką AI projekt Git publikuje Git 2.56.1, z backportami aż do Git 2.50.2, aby usunąć sześć luk szczegółowo opisanych przez Elijaha Newrena na GitHub Blog.
| Usunięta luka | Rodzaj zagrożenia |
|---|---|
| CVE-2026-111760 | Wykonanie kodu podczas rekurencyjnego klonowania za pośrednictwem pliku .git submodułu |
| CVE-2026-113408 | Obejście ograniczeń ścieżki za pośrednictwem HEAD ogłaszanego przez serwer |
| CVE-2026-114467 | Uszkodzenie stosu podczas usuwania podpisów GPG |
| CVE-2026-114469 | Odczyty poza zakresem podczas stosowania patchy binarnych |
| CVE-2026-105437 | Uszkodzenie sterty podczas dużych operacji merge |
| CVE-2026-114466 | Dostęp do systemu plików przez strumienie git fast-import |
GitHub wdrożył już poprawki na github.com i w Enterprise Cloud, publikuje GitHub Enterprise Server 3.19.15, 3.20.11, 3.21.9 i 3.22.4 oraz przygotowuje wersje GitHub Desktop i aplikacji GitHub Copilot z poprawionym Git. Zalecenie brzmi: zaktualizować Git oraz każdą aplikację zawierającą jego kopię; jeśli to niemożliwe, klonować wyłącznie z zaufanych serwerów.
🔗 Ogłoszenie luk bezpieczeństwa w Git (GitHub Blog)
W skrócie
Agenci programistyczni i narzędzia deweloperskie
- Zed 1.28 i wersja zapoznawcza 1.29 — Wersja 1.28 trafia do kanału stabilnego i obejmuje zmiany z wersji zapoznawczej opisanej 4 listopada (najnowszy Agent Client Protocol, odczyty
read_fileograniczone do 2 000 znaków, opcjonalne automatyczne pobieranie zmian z Git). Wersja zapoznawcza 1.29 obsługuje Claude Fable 5.2 i Claude Mythos 5.2 za pośrednictwem dostawcy Anthropic. 🔗 źródło - Antigravity CLI 1.5.4 i 1.5.5 — Wersja 1.5.5 wprowadza /swarm w wersji zapoznawczej w terminalu, z pełnoekranowym widokiem /swarm board, oraz naprawia import poleceń i hooków z pluginów Claude Code. Wersja 1.5.4 udostępnia tryb Auto sesjom ACP i wzbogaca dane przekazywane do hooków. 🔗 źródło
- Gemini CLI — Dzień po v0.68.0 nie ma nowego wydania, a kompilacja nocna (nightly) ponownie się nie powiodła, podobnie jak każdej nocy od 5 listopada. Do głównej gałęzi włączono cztery poprawki, w tym usunięcie błędu 400 występującego po pustej turze modelu przy przetwarzaniu obrazu lub pliku binarnego. 🔗 źródło
- Copilot CLI 1.0.110-1 — Wersja zapoznawcza obejmująca wyłącznie 13 poprawek: wznowionej sesji nie można już modyfikować równolegle, a lokalny serwer MCP zwracający ucięty znak Unicode nie blokuje już wywołania narzędzia. SDK 1.0.32-preview.1 pozwala wybrać Copilot Fusion i jego poziom. 🔗 źródło
- Gemini 4 Carbon w Genspark — Genspark udostępnia Gemini 4 Carbon w swoim AI Chat i Code Agent, dzień po wprowadzeniu Claude Fable 5.2 do tego samego Code Agent, bez podania planu ani zużycia kredytów. 🔗 źródło
- Basis i Devin for Startups — Cognition pokazuje na filmie, jak Basis współpracuje z Devin; agenci księgowi Basis skracają niektóre zadania z 20 godzin do 30 minut, przy czym ta liczba dotyczy Basis, a nie Devin. Cognition ponownie uruchamia też Devin for Startups, oferując wybranym zespołom 65 000 dolarów w kredytach. 🔗 źródło
- shem — João Galego publikuje eksperymentalny runtime, który uruchamia model z Hugging Face jak obraz kontenera (Dockerfile może zaczynać się od
FROM hf.co/...) i odwrotnie, wykonuje kontenery na procesorze zbudowanym z wag modelu; według niego działa to „przez większość czasu”. 🔗 źródło
GitHub
- Licencje Copilot zarządzane przez GitHub Apps — Firmowe GitHub Apps mogą wywoływać API zarządzania licencjami Copilot, aby przydzielać je użytkownikom i zespołom przedsiębiorstwa, dzięki nowemu szczegółowemu uprawnieniu Enterprise Copilot license management. 🔗 źródło
- Dependabot i nieaktywne repozytoria — Od 8 grudnia GitHub wyłącza alerty Dependabot w większości repozytoriów nieaktywnych od roku; alerty są archiwizowane, a nie usuwane, i przywraca je pierwszy push. Zmiana nie dotyczy GitHub Enterprise Server. 🔗 źródło
- Typy i pola issues dla kont osobistych — Dotychczas zarezerwowane dla organizacji, stają się ogólnie dostępne w repozytoriach osobistych: do 25 typów i 25 pól, z możliwością użycia w projektach, przez API REST i GraphQL oraz przez webhooks. 🔗 źródło
- Pulpit GitHub — Bardziej kompaktowy, wyświetla sześć pull requests i sześć issues zamiast trzech, pozwala przypiąć kartę Feed lub Home i ukrywa sekcję sesji agentów, gdy konto nie ma żadnej takiej sesji. 🔗 źródło
Firmy i zastosowania
- Singapore Airlines — Chatbot Kris, przepisany z wykorzystaniem API OpenAI, podwaja swój wynik satysfakcji klientów, podsumowywanie rozmów skraca czas obsługi przez konsultantów o około 10 %, a ponad 60 % pracowników korzysta co miesiąc z wewnętrznej platformy Jarvis. 🔗 źródło
- Cogent Security — Startup tworzy agentów cyberobrony opartych na GPT-6.1 Sol, GPT-6 Astra i GPT-5.6, działających zgodnie z zasadami sprawdzanymi przed każdym wywołaniem narzędzia; według firmy klient z branży motoryzacyjnej z listy Fortune 1000 skrócił o 75 % średni czas usuwania krytycznych luk bezpieczeństwa. 🔗 źródło
- JioStar — Asystent głosowy do odkrywania treści w JioHotstar, zbudowany na API OpenAI w około osiem tygodni, mówi w ponad 15 językach na platformie liczącej ponad 500 milionów użytkowników; według JioStar ponad 60 % użytkowników asystenta mówi do niego zamiast pisać. 🔗 źródło
- ChatGPT Plus dla weteranów — Z okazji Dnia Weteranów OpenAI podaje, że w ciągu roku ponad 20 000 weteranów i wojskowych przechodzących do życia cywilnego skorzystało z oferowanego bezpłatnego roku ChatGPT Plus, a blisko 1 000 członków społeczności wojskowej przeszło szkolenia. 🔗 źródło
- Plugin fal w ChatGPT — fal promuje swój plugin, który generuje i edytuje obrazy oraz filmy w rozmowie, za pomocą 60-sekundowej reklamy stworzonej przy użyciu GPT Image 2.6, FLUX 3 Max (26 ujęć) i fal Recast; nie podano daty jego udostępnienia. 🔗 źródło
- Gopuff w Grok Bot — Grok Bot obsługuje teraz cały proces zamawiania artykułów spożywczych, przekąsek i produktów codziennego użytku w Gopuff, według Gopuff z dostawą nawet w 15 minut; nie podano krajów ani wariantów oferty. 🔗 źródło
- Genspark Genius — Genspark rekrutuje ambasadorów: jedna udostępniona praca miesięcznie w zamian za plan Pro, wcześniejszy dostęp do nowych funkcji, kredyty i promocję na kanałach firmy. 🔗 źródło
Modele, media i badania
- MiniMax H3 — Sto dni po otwarciu dostępu do wag MiniMax deklaruje 1 472 modele pochodne i ponad 148 milionów pobrań na Hugging Face; dane te nie zostały zweryfikowane. H3-Image trafia do fal, Runware, EvoLink i Miora, u tego ostatniego bezpłatnie do 17 listopada. 🔗 źródło
- Voxtral Transcribe 3 na AI Engineer Paris — Mistral transkrybował na żywo wszystkie wystąpienia na głównej scenie, przekazując modelowi nazwiska prelegentów i terminy z programu (ukierunkowanie kontekstem), bez danych liczbowych o uzyskanej poprawie. 🔗 źródło
- Lokalna obsługa głosu w Google AI Edge Gallery — Aplikacja zyskuje rozpoznawanie i syntezę mowy offline: na Androidzie ML Kit transkrybuje ponad 100 języków dziesięć razy szybciej niż w czasie rzeczywistym, a otwarte modele, takie jak Parakeet-TDT 0.6B czy Kokoro-82M, obsługują pozostałe platformy. 🔗 źródło
- Déjà View od NVIDIA — Ten model rekonstrukcji 3D o 117M parametrów wielokrotnie stosuje ten sam blok transformera i dorównuje modelom nawet 10 razy większym w pięciu benchmarkach; zaprezentowany w formie wystąpienia ustnego na NeurIPS 2026, ma artykuł dostępny na arXiv od maja. 🔗 źródło
- Choroby w hiszpańskich tekstach medycznych — OpenMed publikuje dwa otwarte modele na licencji Apache-2.0, działające na CPU; według zespołu dostrajanie na DisTEMIST podnosi F1 z przedziału około 36–39 dla modelu ogólnego do około 73 dla wersji GLiNER2.5. 🔗 źródło
- Płatności agentów x402 — Pozostawione samym sobie Qwen3 235B, DeepSeek V4 Pro i Llama 3.3 70B uzyskują 59, 55 i 30 punktów na egzaminie Fizzl, przy czym żaden nie zdaje; gdy o płatności decyduje kod (x402-safe-fetch), wyniki rosną do 94, 100 i 94. 🔗 źródło
- GR00T-X-Embodiment-Sim w FiftyOne — Harpreet Sahota (Voxel51) konwertuje 42 symulowane epizody ze zbioru danych NVIDIA, po sześć dla każdej z siedmiu konstrukcji robotów, ze zsynchronizowanymi danymi z kamer i telemetrią przegubów. 🔗 źródło
Ekosystem
- Sakana AI — Emerytowany admirał Michael Rogers, były dyrektor NSA, oraz Tom Moran, z blisko 30-letnim stażem w CIA, zostają starszymi doradcami tokijskiego startupu w dziedzinie obronności i cyberbezpieczeństwa. 🔗 źródło
- Recykling w NVIDIA — Z okazji COP31 NVIDIA przedstawia cztery startupy ze swojego programu Inception, które sortują odpady za pomocą widzenia komputerowego, w tym Greyparrot, skracający kontrolę 15 ton odpadów z 375 do 6 godzin; nie zaprezentowano żadnego nowego produktu NVIDIA. 🔗 źródło
- Przewodnik Perplexity po zgodności AI z regulacjami — Omawia europejski AI Act, NIST AI RMF i ISO/IEC 42001 oraz proponuje trzy mechanizmy kontroli agentów: dostęp wyłącznie do niezbędnych zasobów, rejestrowanie każdego działania i zatwierdzanie przez człowieka działań o dużym wpływie. 🔗 źródło
- Przewodnik Perplexity po architekturze MCP — Role hosta, klienta i serwera, komunikaty JSON-RPC 2.0, transport lokalny i Streamable HTTP, konfiguracja multi-tenant: omówienie techniczne stanowiące kontynuację przewodnika po bezpieczeństwie z 4 listopada, bez zapowiedzi produktu. 🔗 źródło
- Hackathon Cohere w Toronto — Cohere organizuje 30 stycznia 2027 swój pierwszy hackathon z Uniwersytetem w Toronto, Hacking Higher Ed, poświęcony AI w szkolnictwie wyższym; nagrody wynoszą 3 000, 2 000 i 1 000 dolarów, zgłoszenia do 22 stycznia. 🔗 źródło
Co to oznacza
Google DeepMind stosuje swoje modele do dwóch problemów, w których weryfikacja ma większe znaczenie niż generowanie. AlphaGenome 2 nie ogranicza się już do średniej dla tkanki: przewiduje wpływ wariantu w komórce interesującej badacza, a jego postępy mierzy się na TenK10K, mapie 28 typów komórek odpornościowych. AlphaProof Code przenosi weryfikację formalną z projektu protokołu na skompilowany kod, z jasno określonym podziałem pracy: agenci piszą ponad sześć milionów wierszy dowodów, weryfikator Lean sprawdza każdy krok, a ludzie przeglądają specyfikacje i około 1 % kodu. Obie zapowiedzi mają swoje ograniczenia: AlphaGenome 2 pozostaje przeznaczony wyłącznie do badań, a twierdzenie o pierwszeństwie w przypadku Signal pochodzi od Google DeepMind.
Bezpieczeństwo napotyka ograniczenia własnych narzędzi pomiarowych. OpenAI stwierdza, że łańcuch rozumowania, jeden z filarów jego monitorowania, staje się coraz trudniejszy do odczytania w miarę postępów pretrainingu, i samo ocenia, że sterowalność, jeden z dwóch stosowanych wskaźników, jest obarczona szumem. Perplexity pokazuje, że klasyczny format capture the flag odciąga agentów od granicy, która ma być testowana, oraz że model wyspecjalizowany w cyberbezpieczeństwie może wypaść gorzej niż jego wersja ogólna, w trzech próbach i przy konfiguracji sprzed poprawki. W obu przypadkach wniosek dotyczy w równym stopniu sposobu oceniania, jak i samych modeli.
Ten dzień wyraźnie oddziela to, co udostępniono, od tego, co zapowiedziano. Runway publikuje Praxis-1 wraz z wagami, kodem do dostrajania i raportem plasującym model poniżej czterech konkurencyjnych pozycji, a Tether udostępnia BotPsy do pobrania. Z kolei Qwen4-Max pojawia się bez benchmarku, rozmiaru ani ceny, a ElevenLabs samo rozróżnia to, co jest dostępne dzisiaj (Marketplace, Partner Program, ElevenAI), od tego, co nadejdzie później (Interaction Engine, Memory, Routines, dostrajanie). Dla osób chcących przetestować te rozwiązania ta druga część pozostaje obietnicą.
Agenci stają się stałym elementem pracy i zespołów. Grok Bot 1.0 dołącza do spotkań i koordynuje działania z innymi Bots w Slack i Teams; Cloud Runners w Delta uruchamiają wątek agenta bez komputera jego autora; VS Code dodaje skrzynkę odbiorczą dla sesji oczekujących na decyzję; A2UI pozwala agentom odpowiadać ekranem zamiast tekstem. Każde z tych rozwiązań ogranicza też ryzyko, które wprowadza: uprawnienia przypisane do poszczególnych osób i weryfikacja przed zabraniem głosu w kanale publicznym w Grok Bot, prywatny podgląd w Delta, precyzyjnie określone uprawnienia i zamaskowane zmienne w środowisku sandbox w VS Code.
Źródła
- AlphaGenome 2 (Google DeepMind)
- AlphaGenome 2 (@GoogleDeepMind)
- Przedstawiamy AlphaProof Code (Google DeepMind)
- Weryfikacja formalna Signal (PDF, Google DeepMind)
- Qwen4-Max w wersji zapoznawczej (@Alibaba_Qwen)
- Token Plan (QwenCloud)
- Praxis-1 jest już dostępny (Runway)
- Raport techniczny Praxis-1 (Runway)
- Kolekcja Praxis-1 (Hugging Face)
- ElevenLabs Summit NYC (ElevenLabs)
- Ogłoszenia z Summit (@ElevenLabs)
- ElevenLabs i NVIDIA (ElevenLabs)
- Pełne zresetowanie limitów (@ClaudeDevs)
- Grok Bot 1.0 (SpaceXSI)
- Grok Bot 1.0 (@SpaceXSI)
- Wycofanie głosów Advanced i Standard w ChatGPT (pomoc OpenAI)
- Wycofanie głosów Advanced i Standard (@OpenAINewsroom)
- Gemini w Apple CarPlay (blog.google)
- Możliwość monitorowania CoT w całym cyklu życia modelu (OpenAI)
- Wątek Jeffreya G. Wanga
- Ucieczka ze SPACE: część II (Perplexity)
- Ucieczka ze SPACE: część II (@perplexity_ai)
- Gemini Decision 1 (Google AI Studio)
- Decisions API (Google AI Studio)
- A2UI 1.0 (Google Developers Blog)
- Cloud Runners są już dostępne w Delta
- Dokumentacja Cloud Runners (Delta)
- Informacje o wydaniu VS Code 1.146
- Qwen Code v1.0.0-preview (GitHub)
- BotPsy (QVAC na Hugging Face)
- Model qvac/BotPsy-0.8B (Hugging Face)
- Trening uwzględniający Token Pooling (Hugging Face)
- Seedance 2.5 w 4K (@pika_labs)
- Seedance 2.5 w 4K (@runwayml)
- Ogłoszone luki bezpieczeństwa w Git (GitHub Blog)
- Zed v1.28.1 (GitHub)
- Historia zmian Antigravity
- Gemini CLI, PR 30228 (GitHub)
- Copilot CLI v1.0.110-1 (GitHub)
- Gemini 4 Carbon w Genspark (@genspark_ai)
- Basis i Devin for Startups (@cognition)
- Twój LLM jest teraz kontenerem (Hugging Face)
- Zarządzanie licencjami Copilot przez GitHub Apps (GitHub Changelog)
- Alerty Dependabot będą wstrzymywane w nieaktywnych repozytoriach (GitHub Changelog)
- Typy i pola issues dla kont osobistych (GitHub Changelog)
- Pulpit GitHub z większą ilością informacji (GitHub Changelog)
- Singapore Airlines (OpenAI)
- Cogent Security (OpenAI)
- JioStar, Vijay Seshadri (OpenAI)
- ChatGPT Plus dla weteranów (OpenAI)
- Plugin fal w ChatGPT (@fal)
- Gopuff w Grok Bot (@bot)
- Genspark Genius (@genspark_ai)
- MiniMax H3, 100 dni (@RyanLeeMiniMax)
- Voxtral Transcribe 3 na AI Engineer Paris (@MistralAI)
- Lokalna obsługa głosu w Google AI Edge Gallery (Google Developers Blog)
- Déjà View (@NVIDIAAI)
- Wykrywanie chorób w hiszpańskim tekście klinicznym (OpenMed)
- Otwarte modele AI z portfelem (Fizzl)
- GR00T-X-Embodiment-Sim w FiftyOne (Hugging Face)
- Michael Rogers i Tom Moran (Sakana AI)
- Startupy AI zajmujące się recyklingiem (blog NVIDIA)
- Zgodność AI z regulacjami (Perplexity)
- Architektura MCP (Perplexity)
- Hacking Higher Ed (@cohere)