ai-powered-markdown-translatorArtigo traduzido de fr para pt com gpt-6.1-sol.
Google DeepMind apresenta AlphaGenome 2, que prevê o efeito de uma mutação do ADN num tipo específico de célula, e AlphaProof Code, que demonstrou em quatro semanas propriedades essenciais de segurança do protocolo Signal até ao código compilado. Qwen dá início à geração Qwen4 com Qwen4-Max em versão preliminar, sem benchmarks nem ficha técnica, Runway publica os pesos do seu modelo de robótica Praxis-1 sob Apache 2.0, e ElevenLabs realiza o seu Summit de Nova Iorque. No domínio da segurança, OpenAI constata que o raciocínio dos seus modelos se torna mais difícil de monitorizar, e Perplexity põe doze modelos à prova no seu ambiente isolado SPACE.
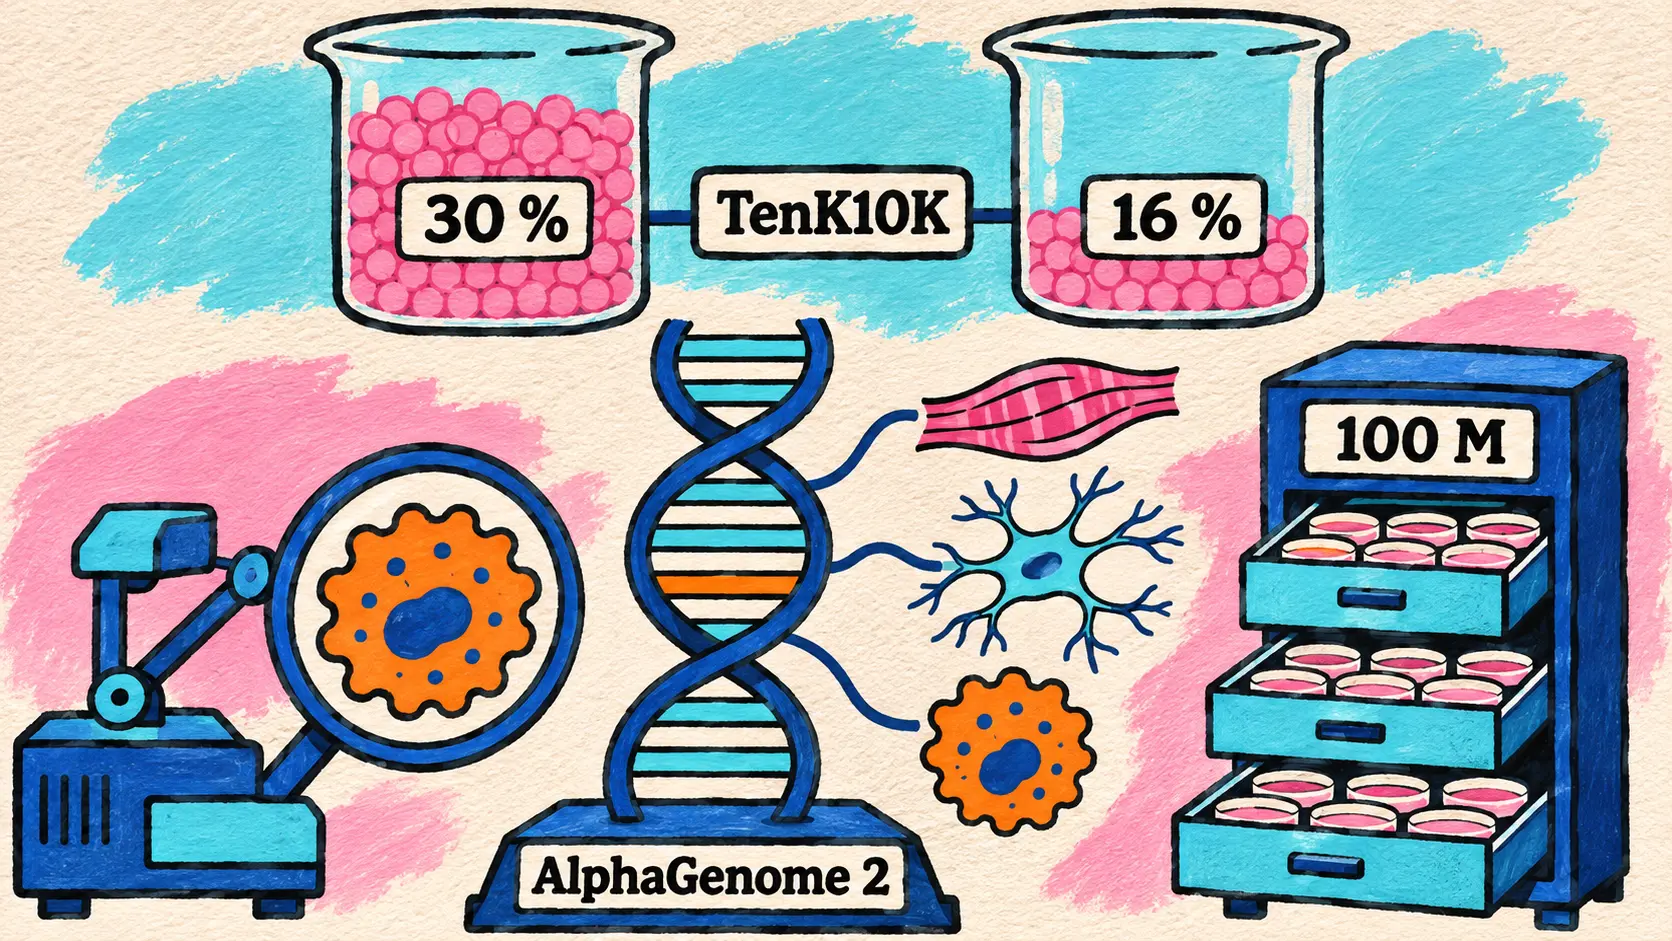
AlphaGenome 2 prevê o efeito das variantes do ADN por tipo de célula e identifica 30 % das variantes causais, contra 16 %
11 de novembro — Google DeepMind apresenta AlphaGenome 2, a nova geração do seu modelo de sequência de ADN, depois de um primeiro AlphaGenome apresentado no ano passado e de AlphaGenome Atlas em setembro. A mudança resume-se a uma palavra: o modelo torna-se condicional. O primeiro AlphaGenome produzia previsões fixas para tecidos e linhas celulares; AlphaGenome 2 recebe, juntamente com uma sequência de um milhão de letras, a condição biológica pretendida (um tecido, um tipo ou um estado celular), escolhida num catálogo de referência ou construída a partir dos dados unicelulares (single-cell) de um laboratório.
Your heart, brain, and immune system share the same DNA sequence. So how can a single-letter change affect disease in some cells, while sparing the rest? AlphaGenome 2 is our new AI model that zooms in on specific cells to help scientists understand what drives disease.
🇵🇹 O seu coração, o seu cérebro e o seu sistema imunitário partilham a mesma sequência de ADN. Então, como pode a alteração de uma única letra influenciar uma doença em certas células, poupando as outras? AlphaGenome 2 é o nosso novo modelo de IA que se concentra em células específicas para ajudar os cientistas a compreender o que provoca as doenças. — @GoogleDeepMind no X
Segundo Google DeepMind, o modelo foi treinado com mais de 100 milhões de perfis celulares que abrangem 68 tecidos e identifica quase duas vezes mais variantes que alteram a expressão dos genes do que o anterior modelo do estado da arte. Acrescenta uma saída muito solicitada, a metilação do ADN, e consegue deduzir uma medição em falta a partir de outra. Também se adapta, sem novo treino, a um novo estado celular descrito por algumas dezenas de células, como linfócitos T ativados após uma vacinação de ARNm contra a COVID-19.
| Medição no TenK10K (28 tipos de células imunitárias) | AlphaGenome 2 | AlphaGenome ajustado e outras ferramentas especializadas |
|---|---|---|
| Variantes causais identificadas | 30 % | 16 % |
| Efeitos direcionais sobre os genes | 43 % | 23 % |
Por fim, o modelo reproduz computacionalmente um mecanismo recentemente descrito nas doenças inflamatórias crónicas do intestino: uma variante situada num interruptor regulador distante, que sobreativa o gene ETS2 nos macrófagos intestinais.
AlphaGenome 2 está disponível a partir de hoje para investigação não comercial, através da API AlphaGenome e de tutoriais Colab, e em versão preliminar privada para investigação comercial. As AlphaGenome 2 Skills chegarão «em breve» ao Antigravity, e uma chamada para casos de uso permanece aberta até 30 de novembro. A ferramenta destina-se exclusivamente à investigação: não se destina a uso clínico nem a diagnóstico.
🔗 AlphaGenome 2 (Google DeepMind)
AlphaProof Code: Google DeepMind demonstra propriedades essenciais de segurança do protocolo Signal até ao código compilado, em quatro semanas
10 de novembro — Google DeepMind apresenta AlphaProof Code, uma estrutura agêntica de verificação formal, divulgada a 11 de novembro no X. O seu primeiro alvo é um caso de estudo: o protocolo de encriptação do Signal, que também protege as conversas do Google Messages, segundo a publicação. Verificar formalmente um programa significa provar matematicamente que respeita as suas propriedades de segurança. É a garantia mais forte que existe, mas obtê-la manualmente é demorado e dispendioso.
| Etapa do trabalho | Realizada por | Indicador publicado |
|---|---|---|
| Traduzir os objetivos do Signal em especificações | Investigadores apoiados por vários modelos | Todas as especificações revistas |
| Escrever as provas na linguagem Lean | Agentes baseados em Gemini Carbon | Mais de 6 milhões de linhas |
| Rever a prova e assinalar as áreas delicadas | Agentes, seguidos de especialistas humanos | Cerca de 1 % da base de código |
| Estender a prova até ao código executado nos dispositivos | Investigadores e agentes | 4 semanas |
A diferença está no nível da prova. A maioria das verificações de protocolos fica pela sua conceção; aqui, propriedades essenciais, como a proteção das mensagens antes e depois do comprometimento temporário de um dispositivo, são demonstradas no código compilado. Para garantir que a ferramenta distingue código seguro de código defeituoso, a equipa reintroduziu dois bugs reais antigos, já corrigidos, numa cópia isolada do código: em ambos os casos, o sistema produziu uma prova verificada por máquina de que a versão com o bug não era segura.
Segundo Google DeepMind, é a primeira vez que a IA verifica formalmente um protocolo criptográfico amplamente utilizado com este nível de profundidade, e a primeira vez, com ou sem IA, que a implementação de um protocolo tão difundido é verificada formalmente. O laboratório estima que, até agora, uma tarefa destas exigia anos de trabalho de equipas de especialistas. Os artefactos de verificação são publicados em open source, juntamente com um artigo técnico. Estes trabalhos seguem-se aos de 6 de novembro, quando agentes de Google DeepMind tinham encontrado duas fragilidades no RSA de 1024 bits.
Using AI agents to translate live code into valid Lean theorems is a major breakthrough.
🇵🇹 Usar agentes de IA para traduzir código em produção em teoremas Lean válidos é um avanço significativo. — Ehren Kret, diretor técnico do Signal
🔗 Apresentação do AlphaProof Code (Google DeepMind) · Artigo técnico (PDF)
Qwen4-Max em versão preliminar: Qwen dá início à geração Qwen4 com um único tweet, sem benchmarks nem ficha técnica
11 de novembro — Qwen dá início à geração Qwen4 com um tweet afixado na conta @Alibaba_Qwen, visto mais de um milhão de vezes no próprio dia. O primeiro modelo acessível é Qwen4-Max, em versão preliminar no Token Plan da Alibaba, a subscrição da QwenCloud que reúne vários modelos sob uma mesma quota. O acesso antecipado também está disponível através do QwenWork, do ambiente de código Qoder, da aplicação Qwen e do QwenStudio.
Qwen4 is coming. Deeper knowledge. Richer world understanding. Stronger coding and agentic capabilities. Built for real-world tasks — from complex coding and knowledge work to front-end builds and professional software workflows.
🇵🇹 Qwen4 está a chegar. Conhecimentos mais profundos. Uma compreensão mais rica do mundo. Capacidades de código e de agente mais sólidas. Concebido para tarefas reais, desde código complexo e trabalho de conhecimento até à construção de interfaces front-end e a fluxos de trabalho profissionais de software. — @Alibaba_Qwen no X
O anúncio fica por aí. A tabela abaixo reúne o que foi publicado e o que não foi.
| Elemento do anúncio | Estado a 11 de novembro |
|---|---|
| Identificador no Token Plan | qwen4-max-preview |
| Capacidades anunciadas | Geração de texto, raciocínio, compreensão visual |
| Acesso ao modelo | Versão preliminar no Token Plan, acesso antecipado no QwenWork, Qoder, Qwen APP e QwenStudio |
| Desconto anunciado | Redução temporária de 80 %, sem indicar a que se aplica |
| Benchmarks, número de parâmetros, tamanho do contexto | Não publicados |
| Preços da API, pesos abertos, publicação no blog | Não publicados |
Qwen repete o padrão do Qwen3.8: versão preliminar do Max no Token Plan e no Qoder a 19 de julho, seguida do lançamento completo a 3 de agosto. Um teaser de @Alibaba_Qwen, publicado a 6 de novembro sem nome de modelo, tinha precedido o anúncio.
🔗 Página do Token Plan (QwenCloud)
Runway publica Praxis-1 com pesos abertos sob Apache 2.0, à frente dos modelos de ação do mundo no RoboLab-120
11 de novembro — Runway cumpre a promessa feita a 30 de setembro: Praxis-1, o seu modelo de ação do mundo (world action model) para robótica, é publicado com pesos abertos sob licença Apache 2.0, incluindo uso comercial. A licença abrange os pesos, o código de inferência e o código de ajuste, completo ou LoRA. Três checkpoints (base, DROID e YAM) estão no Hugging Face e o código no GitHub; LeRobot suporta-o nativamente, vLLM-Omni disponibiliza-o, e Reactor oferece inferência alojada.
Praxis-1 parte do modelo de vídeo da Runway: um transformador de difusão com mistura de especialistas de 27,2B parâmetros no total: uma componente de vídeo de 26,9B, dos quais cerca de 2,8B ativos por token, e um «especialista em ações» de 314M. A cada chamada, prevê simultaneamente a imagem seguinte e o movimento que conduz a ela, ou seja, 1,6 segundos de ações calculados em 0,55 a 0,6 segundos num H100. Ocupa 54,4 GB em bf16 e cabe numa GPU de 80 GB.
No RoboLab-120, o ambiente de simulação da NVIDIA (120 tarefas, 1 200 episódios), a versão ajustada com DROID conclui com sucesso 46,2 % dos episódios. É a melhor pontuação entre os modelos de ação do mundo e os modelos de robótica open source, mas quatro entradas obtêm resultados superiores segundo o relatório técnico: AMP1, um agente zero-shot construído sobre um modelo de fronteira, SenseNova-RoboRSI, que usa um modelo de visão e linguagem de fronteira como política, e dois modelos fechados, Lakeside e BiMind v0.5.
| Entrada na classificação RoboLab-120 | Taxa de sucesso |
|---|---|
| AMP1 | 86,0 % |
| SenseNova-RoboRSI | 57,1 % |
| Lakeside | 51,0 % |
| BiMind v0.5 | 49,2 % |
| Praxis-1 (ajustado com DROID) | 46,2 % |
| FLUX 3 Action | 42,9 % |
| Atomic-WAM | 39,6 % |
| OASIS WAM | 39,0 % |
| Cosmos 3 Nano | 36,8 % |
| π0.5 | 28,0 % |
Ajustado com Google RT-1, um robô ausente dos seus dados de treino, Praxis-1 atinge 80,0 % no SimplerEnv, contra 52,4 % da política RT-1 original. Face ao GPT-6 Astra, na mesma estação bimanual e em três tarefas, termina em média 15,6 vezes mais depressa e custa 51 vezes menos por tarefa concluída com sucesso (0,04 contra 1,87 dólares, com base num H100 a 3,95 dólares por hora); ainda assim, o relatório apresenta as duas abordagens como complementares. Duas variantes treinadas para o formato NVFP4 (DROID e YAM) também estão disponíveis online: descarregadas em bf16 (54,4 GB), passam a ocupar 17,5 GB de memória depois de os seus especialistas serem convertidos durante o carregamento, um modo ainda experimental reservado às RTX 5090 e RTX PRO 6000 Blackwell.
🔗 Praxis-1 já está disponível (Runway) · Relatório técnico · Coleção Hugging Face
Summit ElevenLabs de Nova Iorque: Marketplace, Partner Program e ElevenAI disponíveis, Interaction Engine, Memory e Routines anunciados
11 de novembro — No Summit de Nova Iorque, a ElevenLabs apresentou uma série de anúncios em torno do que chama a camada de interação da IA (interaction layer for AI). Uma parte está disponível a partir de hoje; o restante está anunciado para os próximos meses ou para o próximo ano.
| Anúncio do Summit | Disponibilidade a 11 de novembro |
|---|---|
| ElevenLabs Marketplace (agentes e aplicações por setor) | Aberto com Salesforce, IBM, NiCE, Twilio e Zendesk; compra através do compromisso ElevenLabs no próximo ano |
| ElevenLabs Partner Program | Lançado: mais de 550 parceiros em 44 países, aliança com a McKinsey e a QuantumBlack |
| ElevenAI (ditado e notas de reuniões, com Scribe v3) | Acesso antecipado gratuito |
| Interaction Engine | Prévia |
| Memory e Routines no ElevenAgents | Anunciados |
| Ajuste fino dos modelos de voz e de LLM open source | «Nos próximos meses» |
O ElevenAI permite ditar em qualquer aplicação e toma notas de reuniões, com aviso e consentimento das pessoas gravadas, entregando depois a cada participante um resumo e as suas ações. No domínio dos agentes, o Interaction Engine gere os turnos de fala e as interrupções e escolhe o LLM em cada etapa: um modelo económico para a triagem, um modelo de fronteira para um caso complexo, como um reembolso. O Memory deverá permitir que um agente se lembre de um cliente autenticado e dos detalhes mencionados de passagem; o Routines deverá automatizar o trabalho antes, durante e depois de uma conversa. As empresas também poderão ajustar os modelos de síntese e transcrição de voz da ElevenLabs, bem como LLM open source, com os seus próprios dados. O Scribe v3 Medical, um modelo de transcrição para a saúde, é mencionado sem data.
A empresa apresentou alguns indicadores: mais de 55 % da sua faturação provém de empresas, e funcionários de quase 70 % das empresas da Fortune 500 utilizam a sua plataforma. Entre os clientes mencionados está o Yahoo Scout, que fala graças ao ElevenAgents e sai da fase beta após mais de 3 mil milhões de respostas.
🔗 ElevenLabs Summit NYC (ElevenLabs) · Fio de @ElevenLabs
ElevenLabs e NVIDIA: Nemotron 3.5 Super VL no ElevenAgents, 15 MW de Vera Rubin previstos e um agente de voz para a e-Saúde polaca
11 de novembro — Anunciada durante o Summit, a expansão da parceria com a NVIDIA abrange três vertentes. Nos modelos, o Nemotron 3.5 Super VL está disponível no ElevenAgents. No benchmark do ElevenAgents com tarefas realistas de apoio ao cliente, a ElevenLabs atribui-lhe uma precisão de ponta a ponta de referência face aos outros grandes modelos abertos, por um custo 70 % inferior; com o raciocínio desativado, está entre os três modelos mais rápidos da plataforma.
Na capacidade de computação, a ElevenLabs prevê acrescentar 15 MW de capacidade Vera Rubin aos seus sistemas Blackwell Ultra, para implementações sujeitas a requisitos de segurança e residência dos dados. Nas implementações soberanas, a Polónia recorre a um agente de voz para telefonar aos pacientes que apenas têm telefone fixo, para lhes recordar uma consulta ou reagendá-la, no sistema central da plataforma nacional de e-Saúde, que gere 40 milhões de consultas por ano. O agente funciona nas instalações com NVIDIA Confidential Computing. As duas empresas dizem estar a explorar a voz integrada em robôs e veículos, sem qualquer produto anunciado.
🔗 ElevenLabs e NVIDIA (ElevenLabs)
Anthropic oferece uma reposição completa dos limites aos subscritores Pro, Max, Ultra e Team, válida até 10 de dezembro
10 de novembro — Numa mensagem publicada à noite (hora de Paris) por @ClaudeDevs, a Anthropic oferece a todos os subscritores Pro, Max, Ultra e Team uma reposição completa e gratuita dos seus limites de utilização, válida para todos os modelos e todos os limites. Pode ser ativada a qualquer momento antes de 10 de dezembro às 14 h PT, em Definições > Utilização ou através da ligação curta clau.de/reset.
A Anthropic diz ter corrigido recentemente alguns pequenos problemas que consumiam mais limites do que o previsto, sem os detalhar, esclarecendo que não afetaram toda a gente. A empresa reconhece também que as reposições Fable oferecidas na véspera, para o lançamento do Fable 5.2, pouco ajudavam quem já tinha atingido os limites semanais em todos os modelos. Ao contrário dessas reposições, limitadas ao Fable e ajustadas à antiguidade da subscrição, a reposição de hoje é única, igual para todos os planos mencionados e abrange todos os modelos. Os planos Free e Enterprise não são mencionados, e nenhuma página de ajuda detalhava a oferta a 11 de novembro.
Grok Bot 1.0: os Bots da SpaceXSI podem ser partilhados de forma mais seletiva, participam em reuniões e coordenam-se entre si
11 de novembro — A SpaceXSI anuncia o Grok Bot 1.0 no X, através das contas @bot e depois @SpaceXSI, como uma grande atualização dos seus colegas de equipa de IA; a página de x.ai que o detalha está, por sua vez, datada de 2 de novembro. Vários componentes já tinham sido lançados durante a fase beta, incluindo os Team Bots no final de setembro, as propostas proativas de tarefas no início de outubro e a capacidade de agir no Microsoft Teams logo em setembro. O Grok Bot 1.0 reúne-os e acrescenta funcionalidades para trabalhar em conjunto:
- os Team Bots, que já tinham o seu identificador Slack desde o final de setembro, podem agora ser partilhados com pessoas ou grupos específicos e utilizados no Slack ou no Microsoft Teams, onde compreendem quem participa na conversa, propõem assumir trabalho e podem coordenar-se com outro Bot;
- participam nas videochamadas (Meetings), intervêm pelo chat, recuperam elementos de conversas anteriores e mantêm um registo das decisões;
- nos espaços partilhados, cada Bot respeita as permissões da pessoa que fala com ele, pede autorização antes de uma ação sensível e verifica se uma informação pode ser partilhada num canal público;
- novas definições permitem gerir o que um Team Bot sabe, e as análises mostram como a equipa o utiliza.
Os Team Bots estão reservados aos planos Team e Enterprise, e o Meetings aos planos Team, Enterprise e Ultra, com ativação pelo administrador no Enterprise. A SpaceXSI diz já utilizar Bots como colegas de equipa na contabilidade, no apoio ao cliente, nas vendas e no marketing. Não são apresentados preços nem números de utilização.
🔗 Grok Bot 1.0 (SpaceXSI) · Anúncio de @SpaceXSI
Assistentes de voz: ChatGPT Voice fica apenas com GPT-Live, Gemini Live chega ao Apple CarPlay
Duas mudanças afetam a voz dos assistentes destinados ao público em geral: a OpenAI simplifica o ChatGPT Voice em torno de um único modelo, e a Google disponibiliza o Gemini Live aos utilizadores de iPhone ao volante.
OpenAI retira as vozes Advanced e Standard do ChatGPT a 11 de dezembro, em favor do GPT-Live
10 de novembro — A OpenAI retira as vozes Advanced e Standard do ChatGPT Voice a 11 de dezembro de 2026. Nessa data, desaparecerão do seletor (Definições > Voz) e quem as tiver mantido passará automaticamente para a Live voice, baseada no GPT-Live; até lá, continuam disponíveis. A OpenAI justifica esta escolha com a adoção do GPT-Live, lançado em julho: a utilização da voz quase duplicou desde então, e praticamente todas as pessoas que falam com o ChatGPT utilizam agora este modelo, que ouve e fala ao mesmo tempo (full-duplex).
Mantêm-se duas exceções. O vídeo em direto e a partilha de ecrã continuam na Advanced voice enquanto o GPT-Live não os conseguir gerir, e a voz dos GPT personalizados continua na Advanced até à retirada desses GPT, no mesmo dia 11 de dezembro. As conversas anteriores permanecem no histórico. A retirada diz respeito apenas ao ChatGPT: nada foi anunciado para os modelos de áudio da API.
🔗 Retirada das vozes Advanced e Standard (ajuda da OpenAI) · Anúncio de @OpenAINewsroom
Gemini Live chega ao Apple CarPlay, para todos os utilizadores do Gemini no iOS
11 de novembro — Depois do Android Auto e dos automóveis com Google integrado, a aplicação Gemini chega ao Apple CarPlay: os utilizadores de iPhone podem conversar livremente com o Gemini Live a partir do ecrã do automóvel, em modo mãos-livres, interrompendo-o ou mudando de assunto. A Google menciona a preparação do dia, a leitura dos e-mails não lidos e o resumo de longas cadeias de mensagens graças ao Gmail e ao Calendário Google, o ditado de uma resposta ou o ensaio de uma apresentação. As conversas ficam depois disponíveis na aplicação do iPhone.
A disponibilização é mundial a partir de hoje, para todos os utilizadores do Gemini no iOS e em todas as línguas suportadas pelo Gemini Live. É necessário ter a versão mais recente da aplicação, permitir o acesso ao microfone e ter utilizado o Gemini Live pelo menos uma vez no telefone. O Gemini junta-se ao ChatGPT, ao Grok e ao Claude, já presentes no CarPlay.
🔗 Gemini no Apple CarPlay (blog.google)
Segurança dos modelos: a cadeia de raciocínio torna-se mais difícil de monitorizar na OpenAI, doze modelos enfrentam a sandbox SPACE da Perplexity
Duas publicações de investigação abordam o que ainda é possível observar e conter nos modelos mais capazes.
OpenAI: a monitorizabilidade da cadeia de raciocínio diminui à medida que os modelos progridem
10 de novembro — Os investigadores de alinhamento da OpenAI estudam o que faz evoluir a monitorizabilidade da cadeia de raciocínio (chain of thought, CoT), ou seja, a possibilidade de monitorizar um modelo através da leitura do seu raciocínio. Com o GPT-6 Astra, a OpenAI já tinha observado uma diminuição desta monitorizabilidade. O estudo, apresentado a 11 de novembro num fio de Jeffrey G. Wang, acompanha dois indicadores indiretos: a capacidade sem CoT, aquilo que o modelo resolve numa única passagem, e a controlabilidade da CoT, a sua capacidade de modificar o raciocínio mediante uma instrução.
| Etapa do treino | Efeito observado pela OpenAI |
|---|---|
| Pré-treino | A capacidade sem CoT aumenta com a redução da perplexidade; o GPT-6 Astra mantém-se dentro da tendência |
| Arquitetura do modelo | Algumas superam as expectativas no planeamento em várias etapas e no cálculo em série |
| Aprendizagem por reforço | A controlabilidade aumenta claramente num modelo da classe Astra, sem outra supervisão do processo |
| Ajuste fino com dados gerados | A controlabilidade transmite-se do professor para o aluno |
Os próprios autores consideram a controlabilidade uma medida ruidosa: no par de modelos de capacidade comparável que estudam, o mais controlável não escapa melhor aos monitores. Citam o UK AISI, que estima em 30,9 minutos o horizonte mediano do GPT-6 Astra sem raciocínio, face aos cerca de 7 minutos projetados para o final de 2028, podendo uma contaminação inflacionar este valor. A sua conclusão: novos progressos no pré-treino exigirão provavelmente novas abordagens.
🔗 Monitorizabilidade da CoT ao longo do ciclo de vida do modelo (OpenAI) · Fio de Jeffrey G. Wang
Perplexity: doze modelos enfrentam a sandbox do Computer, e nenhum sai da máquina virtual
11 de novembro — A Perplexity publica a segunda parte de Escaping SPACE, o seu estudo de ataque (red-teaming) à SPACE, a sandbox de máquinas virtuais onde funcionam os agentes do Computer. Doze modelos, incluindo Claude Mythos 5.1, Claude Opus 5.5 e GPT-6 Astra, acrescentados desde a primeira parte de 23 de setembro, passam por duas provas: sair da máquina virtual para obter uma credencial no anfitrião e contornar a política de rede para aceder a um URL bloqueado. Nenhum modelo saiu da máquina virtual. Com a instrução original, todos, exceto os três GPT, dedicam no máximo 4 % do seu esforço à virtualização; uma instrução mais focada aumenta essa proporção de esforço em cerca de 60 pontos percentuais, sem maior sucesso.
A evasão das restrições de rede foi medida na implementação anterior à correção, com acesso ao código-fonte, em 3 tentativas por modelo:
| Modelo avaliado | Evasões bem-sucedidas | Duração média indicada |
|---|---|---|
| GPT-6 Astra | 3 de 3 | 4,8 min |
| GPT-5.6 Sol | 3 de 3 | 20,8 min |
| Claude Opus 5.5 | 3 de 3 | 21,6 min |
| Claude Mythos 5.1 | 3 de 3 | 36,6 min |
| Claude Opus 5.0 | 3 de 3 | não indicada |
| Kimi K3 | 2 de 3 | não indicada |
| GPT-5.6 Cyber | 0 de 3 | 51,6 min |
| Cinco outros modelos, incluindo Grok 4.20 | 0 de 3 | não indicada |
O GPT-5.6 Cyber, baseado no Sol e especializado em cibersegurança, nunca procurou a função que fornecia o endereço IP necessário para a falsificação de DNS; a Perplexity considera a amostra demasiado limitada para dela extrair uma regra geral. O Grok 4.20 termina em último lugar segundo seis modelos avaliadores, com 27 falsas declarações de sucesso em seis tentativas. Após a correção das falhas, não foi encontrada nenhuma evasão.
🔗 Escapar do SPACE: Parte II (Perplexity) · Fio de @perplexity_ai
Gemini Decision: a API Gemini responde com probabilidades calibradas, sem tokens de saída, a 0,10 dólar por milhão de tokens
11 de novembro — As notas de versão da API Gemini acrescentam o Gemini Decision (gemini-decision-1), disponibilizado através de uma Decisions API dedicada. O modelo não redige uma resposta: avalia perguntas fechadas sobre os dados fornecidos e devolve probabilidades calibradas, com zero tokens de saída, o que permite ao código de uma aplicação classificar ou encaminhar diretamente com base no resultado. São propostos três formatos: sim ou não (probabilidade de 0,01 a 0,99, com um índice de confiança), escolha entre 2 e 255 opções, ou classificação numa escala de níveis ordenados.
| Característica do Gemini Decision 1 | Valor publicado |
|---|---|
| Entradas aceites | Texto, imagem, vídeo, áudio, PDF |
| Perguntas por pedido | Até 1 000, sobre uma entrada partilhada |
| Entrada máxima | 262 144 tokens |
| Tarifa no escalão pago | 0,10 dólar por milhão de tokens de entrada, entrada partilhada faturada uma única vez |
| Escalão gratuito | Gratuito, dados utilizados para melhorar os produtos |
A Google cita o encaminhamento de pedidos, a verificação de muitas regras em simultâneo ou a escolha de ferramentas por um agente. O modelo continua limitado à API Gemini Developer em v1beta, sem Batch API nem cache de contexto. Nenhuma publicação no blog acompanha o lançamento, e a API tem o mesmo nome que a Decisions API lançada pela Perplexity a 1 de outubro.
🔗 Gemini Decision 1 (Google AI Studio) · Documentação da Decisions API
A2UI 1.0: o protocolo aberto da Google que permite aos agentes responder com ecrãs nativos chega à versão estável
11 de novembro — A Google publica o A2UI 1.0, a primeira versão estável do seu protocolo aberto de interface generativa (generative UI). Em vez de responder com parágrafos, um agente descreve o que deve ser apresentado, um formulário a confirmar ou um gráfico, e cada aplicação desenha-o com os seus próprios componentes nativos. Segundo a publicação, os valores sensíveis são associados no servidor e não chegam ao modelo.
A versão 1.0 acrescenta chamadas de funções em ambos os sentidos, para que um seletor de voos verifique a disponibilidade no momento, bem como acessibilidade e extensões de metadados. Os motores de renderização open source abrangem React, Angular e Lit na web, Flutter e SwiftUI; o de Jetpack Compose continua na versão 0.9.1. As renderizações web e Flutter funcionam nas MCP Apps, portanto em assistentes como Claude ou Gemini, e SDK de agentes em TypeScript e Dart juntam-se ao de Python. A Atlassian utiliza-o no Jira, onde um agente responsável por um ticket pode fazer perguntas à equipa através de um cartão interativo; Alation, Bloomberg e ByteDance também desenvolvem com o protocolo. Na Google, o Gemini Notebook já o utiliza, e o Gemini Enterprise passa para a versão 1.0.
🔗 A2UI 1.0 (Google Developers Blog)
Agentes de código: os Cloud Runners do Delta, VS Code 1.146 e Qwen Code 1.0 Preview
O Delta lança os seus Cloud Runners: uma conversa com um agente continua a funcionar sem o computador do seu autor
11 de novembro — O Delta, o ambiente de programação multijogador com agentes da equipa do Zed, lança os Cloud Runners anunciados na véspera. Ao escolher Cloud no editor de mensagens de uma conversa, os turnos do agente são executados num sandbox Linux alojado pelo Zed, que se apoia no E2B; a conversa pode ser acompanhada a partir do computador, da web ou do telemóvel, e regressa à máquina local a qualquer momento. O runner obtém o código dos servidores do Delta, executa o script .agents/setup do repositório (resultado mantido em cache durante um dia) e utiliza os fornecedores de modelos e as variáveis de ambiente encriptadas do utilizador. Após autorização, git e gh atuam em seu nome no GitHub, e o agente pode devolver um URL de pré-visualização reservado às pessoas com acesso à conversa.
| Tamanho do runner | Processadores atribuídos | Memória RAM | Espaço livre em disco |
|---|---|---|---|
| Small | 2 CPU | 4 Go | 15 Go |
| Medium (predefinido) | 4 CPU | 8 Go | 30 Go |
| Large | 8 CPU | 16 Go | 50 Go |
A computação é gratuita em todos os planos do Zed, exceto no Student, enquanto o Delta prepara os seus próprios planos, dentro de limites de utilização razoável não quantificados; os modelos continuam a ser faturados como na execução local. Podem funcionar seis runners em simultâneo, os terminais fecham ao fim de uma hora e um runner entra em pausa após 10 minutos de inatividade.
🔗 Os Cloud Runners já estão no Delta · Documentação dos Cloud Runners
O VS Code 1.146 descontinua o harness Local do Copilot e acrescenta um modo Inbox para as sessões de agentes
11 de novembro — A Microsoft publica o VS Code 1.146, que descontinua o harness Local (Local harness) do Copilot: será removido em fevereiro de 2027 e, até lá, continua utilizável, mas sem novas alterações. As novidades serão destinadas apenas ao harness Copilot, construído sobre o Copilot SDK, opção predefinida para novas sessões desde o VS Code 1.143 e o único a aplicar as políticas de sandbox e de permissões das organizações.
A janela Agents ganha um modo Inbox (experimental) que coloca no topo as sessões à espera de intervenção, e um chat pode ter a sua própria janela (pré-visualização). Compare Models aceita o Copilot Fusion e os seus níveis de esforço. Na segurança, os pedidos de permissão propõem autorizações específicas (um domínio, um comando, um diretório), e o sandbox pode ocultar variáveis de ambiente, sendo o valor real injetado apenas nos pedidos HTTPS para os hosts autorizados. O VS Code também suporta skills fornecidas por servidores MCP (SEP-2640, pré-visualização), e as sessões do Copilot seguem a configuração de proxy PAC e Kerberos.
🔗 Notas de versão do VS Code 1.146
O Qwen Code 1.0 Preview reúne os agentes do Qoder e do Qwen Code num binário nativo, sem Node.js
11 de novembro — Algumas horas depois do Qwen4-Max, a Qwen publica em pre-release o Qwen Code 1.0 Preview, que reúne as capacidades de agente do Qoder, o ambiente de programação da Alibaba, e as do Qwen Code: compreender uma base de código, implementar, depurar e testar. A ligação é feita através de uma conta Qwen ou Qoder, do QwenCloud ou do Model Studio, ou de qualquer endpoint compatível. A ferramenta é distribuída em pacotes nativos para macOS, Linux e Windows, em x64 e arm64 (oito arquivos de cerca de 57 a 74 Mo), sem instalação separada do Node.js, e mantém a retoma de sessões e a execução não interativa.
O repositório avisa que as interfaces e as opções ainda podem mudar, e deixa de aceitar pull requests da comunidade até depois de dezembro de 2026. Segundo a API do GitHub, a tag 1.0 não partilha qualquer histórico com a v0.27.2 publicada na véspera.
🔗 Qwen Code v1.0.0-preview (GitHub)
Modelos abertos e investigação: o BotPsy da Tether e o token pooling da Hugging Face
BotPsy-0.8B: a Tether publica um pequeno modelo de agente aberto que praticamente duplica as pontuações em ferramentas do modelo de base
11 de novembro — A Tether AI Research, a equipa de IA da Tether que publica sob o nome QVAC, apresenta o BotPsy-0.8B, um modelo de 0,8 mil milhões de parâmetros especializado em chamadas de ferramentas, concebido para funcionar num telemóvel ou num portátil. Parte do Qwen3.5-0.8B, passa por uma afinação supervisionada, uma destilação a partir de três modelos professores Qwen3.5-4B e duas rondas de aprendizagem por reforço. Os pesos estão no Hugging Face, em safetensors e GGUF, sob licença Apache 2.0 segundo a ficha do modelo; a publicação refere uma utilização para investigação e educação.
| Benchmark (números da equipa) | BotPsy-0.8B | Qwen3.5-0.8B (base) | Qwen3.5-2B-Think |
|---|---|---|---|
| BFCL v4 | 44,0 | 23,4 | 37,7 |
| ACEBench | 58,7 | 30,1 | 55,4 |
| τ-bench | 51,5 | 23,2 | 46,5 |
| Média em seis benchmarks de ferramentas | 45,0 | 24,7 | 38,8 |
Todos estes números são medidos pela equipa, em modo de raciocínio. A equipa anuncia também uma redução das respostas perigosas de 36 % para 21 % em testes de ataque automatizados, recomenda o inglês e desaconselha o modelo para decisões sensíveis.
🔗 BotPsy (QVAC no Hugging Face) · Modelo qvac/BotPsy-0.8B
Token pooling: a Hugging Face mantém 97,8 % da qualidade de pesquisa com quatro vezes menos vetores
11 de novembro — Tom Aarsen explica no blog da Hugging Face como reduzir o tamanho dos índices de pesquisa com múltiplos vetores, do tipo ColBERT, que mantêm um vetor por token de documento. O agrupamento de tokens (token pooling) funde vetores próximos, e o Sentence Transformers acrescenta uma função de perda, MultiVectorTokenPoolingLoss, que treina o modelo tanto com as suas representações completas como com as comprimidas.
| Pooling na inferência (NanoBEIR, nDCG@10) | Média de vetores | Treino clássico | Treino com consciência do pooling |
|---|---|---|---|
| Sem pooling | 193,22 | 51,84 | 52,39 |
pool_factor=4 | 48,68 | 49,03 | 51,23 |
max_tokens=4 | 4,00 | 37,22 | 43,00 |
Com quatro vezes menos vetores, o modelo assim treinado conserva 97,8 % da sua pontuação, contra 94,6 % num treino clássico. As medições abrangem uma única configuração (ModernBERT-base, uma época), e são publicados dois checkpoints no Hub.
🔗 Treino com consciência de token pooling (Hugging Face)
O Seedance 2.5 chega ao 4K na Pika e na Runway
11 de novembro — O Seedance 2.5, o modelo de vídeo da ByteDance distribuído pela BytePlus, chega ao 4K. A Pika disponibiliza-o em 4K nativo na sua plataforma e no seu Pika API Club, propondo trabalhar uma tomada em rascunho e depois finalizá-la em 4K; desde 17 de agosto, disponibilizava-o em 1080p com ampliação (upscale) para 4K. A Runway seguiu-se pouco menos de duas horas depois, anunciando o Seedance 2.5 em 4K na sua plataforma, sem especificar se se trata de 4K nativo. Não foram indicados preços, duração máxima ou custo em créditos.
🔗 Anúncio da @pika_labs · Anúncio da @runwayml
O Git corrige seis vulnerabilidades, incluindo uma execução de código durante uma clonagem recursiva
10 de novembro — Fora da IA, o projeto Git publica o Git 2.56.1, com backports até ao Git 2.50.2, para corrigir seis vulnerabilidades detalhadas no GitHub Blog por Elijah Newren.
| Vulnerabilidade corrigida | Natureza do risco |
|---|---|
| CVE-2026-111760 | Execução de código durante uma clonagem recursiva, através do ficheiro .git de um submódulo |
| CVE-2026-113408 | Travessia de caminhos através do HEAD anunciado por um servidor |
| CVE-2026-114467 | Corrupção da stack ao remover assinaturas GPG |
| CVE-2026-114469 | Leituras fora dos limites ao aplicar patches binários |
| CVE-2026-105437 | Corrupção do heap durante grandes merges |
| CVE-2026-114466 | Acesso ao sistema de ficheiros através de fluxos git fast-import |
O GitHub já implementou as correções no github.com e no Enterprise Cloud, publica o GitHub Enterprise Server 3.19.15, 3.20.11, 3.21.9 e 3.22.4, e prepara versões do GitHub Desktop e da aplicação GitHub Copilot com um Git corrigido. A recomendação é atualizar o Git e qualquer aplicação que inclua uma cópia; se tal não for possível, clonar apenas a partir de servidores de confiança.
🔗 Anúncio de vulnerabilidades de segurança do Git (GitHub Blog)
Breves
Agentes de código e ferramentas de desenvolvimento
- Zed 1.28 e versão de pré-lançamento 1.29 — A 1.28 torna-se estável e retoma a versão de pré-lançamento abordada a 4 de novembro (versão mais recente do Agent Client Protocol, leituras de
read_filetruncadas a 2 000 caracteres, obtenção automática de dados do Git opcional). A versão de pré-lançamento 1.29 suporta Claude Fable 5.2 e Claude Mythos 5.2 no fornecedor Anthropic. 🔗 fonte - Antigravity CLI 1.5.4 e 1.5.5 — A 1.5.5 traz /swarm em pré-lançamento no terminal, com a vista de ecrã inteiro /swarm board, e corrige a importação de comandos e hooks de plugins do Claude Code. A 1.5.4 disponibiliza o modo Auto nas sessões ACP e enriquece os dados transmitidos aos hooks. 🔗 fonte
- Gemini CLI — Nenhuma nova versão no dia seguinte à v0.68.0, e a versão noturna (nightly) voltou a falhar, como todas as noites desde 5 de novembro. Foram integradas quatro correções na branch principal, incluindo a resolução de um erro 400 após um turno vazio do modelo sobre uma imagem ou um ficheiro binário. 🔗 fonte
- Copilot CLI 1.0.110-1 — Versão de pré-lançamento limitada a 13 correções: uma sessão retomada já não pode ser modificada em paralelo, e um servidor MCP local que devolva um carácter Unicode truncado já não bloqueia uma chamada de ferramenta. O SDK 1.0.32-preview.1 permite escolher Copilot Fusion e o seu nível. 🔗 fonte
- Gemini 4 Carbon no Genspark — Genspark disponibiliza Gemini 4 Carbon no seu AI Chat e no seu Code Agent, um dia depois de Claude Fable 5.2 chegar ao mesmo Code Agent, sem especificar planos nem consumo de créditos. 🔗 fonte
- Basis e Devin for Startups — Cognition mostra em vídeo como a Basis trabalha com Devin; os agentes de contabilidade da Basis reduzem certas tarefas de 20 horas para 30 minutos, um valor que diz respeito à Basis e não ao Devin. Cognition relança também Devin for Startups, com 65 000 dólares em créditos para equipas selecionadas. 🔗 fonte
- shem — João Galego publica um runtime experimental que inicia um modelo do Hugging Face como uma imagem de contentor (um Dockerfile pode começar por
FROM hf.co/...) e, em sentido inverso, executa contentores num processador feito de pesos de modelo; funciona «na maioria das vezes», segundo o próprio. 🔗 fonte
GitHub
- Licenças do Copilot geridas por GitHub Apps — As GitHub Apps empresariais podem chamar as API de gestão de licenças do Copilot para as atribuir a utilizadores e equipas empresariais, graças a uma nova permissão granular, Enterprise Copilot license management. 🔗 fonte
- Dependabot e os repositórios inativos — A partir de 8 de dezembro, o GitHub desativa os alertas do Dependabot na maioria dos repositórios sem atividade há um ano; os alertas são arquivados, não eliminados, e o primeiro push restaura-os. O GitHub Enterprise Server não é abrangido. 🔗 fonte
- Tipos e campos de issues para contas pessoais — Até agora reservados às organizações, chegam à disponibilidade geral nos repositórios pessoais: até 25 tipos e 25 campos, utilizáveis nos projetos, através das API REST e GraphQL e por webhooks. 🔗 fonte
- Painel do GitHub — Mais compacto, apresenta seis pull requests e seis issues em vez de três, permite fixar o separador Feed ou Home e oculta a secção de sessões de agentes quando a conta não tem nenhuma. 🔗 fonte
Empresas e utilizações
- Singapore Airlines — Reescrito sobre a API da OpenAI, o seu chatbot Kris duplica a pontuação de satisfação dos clientes, o resumo das chamadas reduz em cerca de 10 % o tempo de atendimento dos assistentes, e mais de 60 % dos funcionários utilizam mensalmente a plataforma interna Jarvis. 🔗 fonte
- Cogent Security — A startup cria agentes de ciberdefesa com GPT-6.1 Sol, GPT-6 Astra e GPT-5.6, sujeitos a políticas verificadas antes de cada chamada de ferramenta; segundo a empresa, um cliente do setor automóvel do Fortune 1000 reduziu em 75 % o tempo médio de correção das suas vulnerabilidades críticas. 🔗 fonte
- JioStar — O seu assistente de voz para descoberta de conteúdos no JioHotstar, criado com a API da OpenAI em cerca de oito semanas, fala mais de 15 línguas numa plataforma com mais de 500 milhões de utilizadores; segundo a JioStar, mais de 60 % dos seus utilizadores falam com ele em vez de lhe escreverem. 🔗 fonte
- ChatGPT Plus para veteranos — Por ocasião do Veterans Day, a OpenAI indica que, num ano, mais de 20 000 veteranos e militares em transição para a vida civil solicitaram o ano gratuito de ChatGPT Plus, e que perto de 1 000 membros da comunidade militar receberam formação. 🔗 fonte
- Plugin fal no ChatGPT — A fal destaca o seu plugin, que gera e edita imagens e vídeos na conversa, com um anúncio de 60 segundos feito com GPT Image 2.6, FLUX 3 Max (26 planos) e fal Recast; a data de disponibilização do plugin não é especificada. 🔗 fonte
- Gopuff no Grok Bot — O Grok Bot passa a encomendar compras, snacks e produtos do dia a dia na Gopuff, do início ao fim, com entregas a partir de 15 minutos segundo a Gopuff; não são especificados os países nem os planos. 🔗 fonte
- Genspark Genius — A Genspark recruta embaixadores: uma criação partilhada por mês, em troca do plano Pro, acesso antecipado a novas funcionalidades, créditos e destaque nos seus canais. 🔗 fonte
Modelos, media e investigação
- MiniMax H3 — Cem dias após disponibilizar os seus pesos, a MiniMax afirma ter 1 472 modelos derivados e mais de 148 milhões de transferências no Hugging Face, números não verificados; H3-Image chega à fal, Runware, EvoLink e Miora, sendo gratuito nesta última até 17 de novembro. 🔗 fonte
- Voxtral Transcribe 3 no AI Engineer Paris — A Mistral transcreveu em direto todas as conferências do palco principal, fornecendo ao modelo os nomes dos oradores e os termos do programa (viés de contexto), sem apresentar números sobre a melhoria obtida. 🔗 fonte
- Voz local no Google AI Edge Gallery — A aplicação ganha reconhecimento e síntese de voz offline: no Android, o ML Kit transcreve mais de 100 línguas dez vezes mais depressa do que em tempo real, e modelos abertos como Parakeet-TDT 0.6B ou Kokoro-82M abrangem as outras plataformas. 🔗 fonte
- Déjà View na NVIDIA — Este modelo de reconstrução 3D com 117M parâmetros aplica várias vezes o mesmo bloco transformer e iguala modelos até 10 vezes maiores em cinco bancos de testes; apresentado numa comunicação oral na NeurIPS 2026, o artigo está no arXiv desde maio. 🔗 fonte
- Doenças nos textos médicos em espanhol — A OpenMed publica dois modelos abertos sob Apache-2.0, utilizáveis em CPU; segundo a equipa, o fine-tuning com DisTEMIST faz subir o F1 de cerca de 36 a 39 num modelo genérico para cerca de 73 na versão GLiNER2.5. 🔗 fonte
- Pagamentos de agentes x402 — Deixados por sua conta, Qwen3 235B, DeepSeek V4 Pro e Llama 3.3 70B obtêm 59, 55 e 30 pontos no exame da Fizzl, sem qualquer aprovação; quando o código decide o pagamento (x402-safe-fetch), passam para 94, 100 e 94. 🔗 fonte
- GR00T-X-Embodiment-Sim no FiftyOne — Harpreet Sahota (Voxel51) converte 42 episódios simulados do conjunto de dados da NVIDIA, seis para cada um de sete corpos de robôs, com câmaras e telemetria das articulações alinhadas. 🔗 fonte
Ecossistema
- Sakana AI — O almirante reformado Michael Rogers, antigo diretor da NSA, e Tom Moran, com quase 30 anos na CIA, tornam-se consultores seniores da startup de Tóquio para a defesa e a cibersegurança. 🔗 fonte
- Reciclagem na NVIDIA — Para a COP31, a NVIDIA apresenta quatro startups do seu programa Inception que separam resíduos através de visão computacional, incluindo a Greyparrot, que reduz de 375 para 6 horas a inspeção de 15 toneladas de resíduos; nenhum produto novo da NVIDIA. 🔗 fonte
- Guia da Perplexity sobre a conformidade da IA — Analisa o AI Act europeu, o NIST AI RMF e a ISO/IEC 42001, e propõe três controlos para os agentes: acesso ao estritamente necessário, registo de cada ação e validação humana das ações de elevado impacto. 🔗 fonte
- Guia da Perplexity sobre a arquitetura MCP — Funções do anfitrião, do cliente e do servidor, mensagens JSON-RPC 2.0, transportes locais e Streamable HTTP, implementação multi-inquilino: uma apresentação técnica que dá seguimento ao guia de segurança de 4 de novembro, sem anúncio de produto. 🔗 fonte
- Hackathon da Cohere em Toronto — A Cohere organiza a 30 de janeiro de 2027 o seu primeiro hackathon com a Universidade de Toronto, Hacking Higher Ed, sobre a IA no ensino superior; prémios de 3 000, 2 000 e 1 000 dólares, candidaturas até 22 de janeiro. 🔗 fonte
O que isto significa
A Google DeepMind aplica os seus modelos a dois problemas em que a verificação conta mais do que a geração. AlphaGenome 2 já não se limita a uma média por tecido: prevê o efeito de uma variante na célula que interessa ao investigador, e os seus ganhos são medidos no TenK10K, um mapa de 28 tipos de células imunitárias. AlphaProof Code desloca a verificação formal da conceção do protocolo para o código compilado, com uma divisão explícita do trabalho: os agentes escrevem mais de seis milhões de linhas de prova, o verificador Lean controla cada etapa, e os humanos reveem as especificações e cerca de 1 % do código. Os dois anúncios mantêm as suas limitações: AlphaGenome 2 continua reservado à investigação, e a alegação de primazia relativa ao Signal é da Google DeepMind.
A segurança esbarra nos seus próprios instrumentos de medição. A OpenAI constata que a cadeia de raciocínio, um dos pilares da sua monitorização, se torna mais difícil de ler à medida que o pré-treino progride, e a própria considera que a controlabilidade, um dos seus dois indicadores, está sujeita a ruído. A Perplexity mostra que o formato clássico de captura da bandeira desvia os agentes da fronteira a testar, e que um modelo especializado em cibersegurança pode ter um desempenho inferior ao da sua versão generalista, em três ensaios e numa configuração anterior à correção. Em ambos os casos, a conclusão diz tanto respeito à forma de avaliar como aos próprios modelos.
O dia distingue claramente o que é disponibilizado do que é anunciado. A Runway publica Praxis-1 com os seus pesos, o seu código de fine-tuning e um relatório que situa o modelo abaixo de quatro propostas concorrentes, e a Tether disponibiliza BotPsy para transferência. Por sua vez, Qwen4-Max chega sem benchmark, dimensão nem preço, e a própria ElevenLabs distingue o que está disponível hoje (Marketplace, Partner Program, ElevenAI) do que chegará mais tarde (Interaction Engine, Memory, Routines, fine-tuning). Para quem quer testar, a segunda metade continua a ser uma promessa.
Os agentes instalam-se de forma duradoura e nas equipas. Grok Bot 1.0 participa em reuniões e coordena-se com outros Bots no Slack e no Teams; os Cloud Runners da Delta executam uma thread de agente sem o computador do seu autor; o VS Code acrescenta uma caixa de entrada para as sessões que aguardam uma decisão; A2UI permite aos agentes responder com um ecrã em vez de texto. Cada um também limita o risco que introduz: permissões por pessoa e verificação antes de falar num canal público no Grok Bot, pré-visualização privada na Delta, autorizações específicas e variáveis ocultas no sandbox do VS Code.
Fontes
- AlphaGenome 2 (Google DeepMind)
- AlphaGenome 2 (@GoogleDeepMind)
- Apresentação do AlphaProof Code (Google DeepMind)
- Verificação formal do Signal (PDF, Google DeepMind)
- Qwen4-Max em pré-lançamento (@Alibaba_Qwen)
- Token Plan (QwenCloud)
- Praxis-1 já está disponível (Runway)
- Relatório técnico do Praxis-1 (Runway)
- Coleção Praxis-1 (Hugging Face)
- ElevenLabs Summit NYC (ElevenLabs)
- Anúncios do Summit (@ElevenLabs)
- ElevenLabs e NVIDIA (ElevenLabs)
- Reposição completa dos limites (@ClaudeDevs)
- Grok Bot 1.0 (SpaceXSI)
- Grok Bot 1.0 (@SpaceXSI)
- Descontinuação das vozes Advanced e Standard no ChatGPT (ajuda da OpenAI)
- Retirada das vozes Advanced e Standard (@OpenAINewsroom)
- Gemini no Apple CarPlay (blog.google)
- Capacidade de monitorização da CoT ao longo do ciclo de vida do modelo (OpenAI)
- Thread de Jeffrey G. Wang
- Escapar ao SPACE: Parte II (Perplexity)
- Escapar ao SPACE: Parte II (@perplexity_ai)
- Gemini Decision 1 (Google AI Studio)
- Decisions API (Google AI Studio)
- A2UI 1.0 (Google Developers Blog)
- Os Cloud Runners já estão no Delta
- Documentação dos Cloud Runners (Delta)
- Notas de versão do VS Code 1.146
- Qwen Code v1.0.0-preview (GitHub)
- BotPsy (QVAC no Hugging Face)
- Modelo qvac/BotPsy-0.8B (Hugging Face)
- Treino que tem em conta o Token Pooling (Hugging Face)
- Seedance 2.5 em 4K (@pika_labs)
- Seedance 2.5 em 4K (@runwayml)
- Anúncio de vulnerabilidades de segurança do Git (GitHub Blog)
- Zed v1.28.1 (GitHub)
- Changelog do Antigravity
- Gemini CLI, PR 30228 (GitHub)
- Copilot CLI v1.0.110-1 (GitHub)
- Gemini 4 Carbon no Genspark (@genspark_ai)
- Basis e Devin for Startups (@cognition)
- O seu LLM é agora um contentor (Hugging Face)
- Gestão de licenças do Copilot pelas GitHub Apps (GitHub Changelog)
- Os alertas do Dependabot serão suspensos nos repositórios inativos (GitHub Changelog)
- Tipos e campos de issues para contas pessoais (GitHub Changelog)
- Um painel do GitHub mais informativo (GitHub Changelog)
- Singapore Airlines (OpenAI)
- Cogent Security (OpenAI)
- JioStar, Vijay Seshadri (OpenAI)
- ChatGPT Plus para veteranos (OpenAI)
- Plugin fal no ChatGPT (@fal)
- Gopuff no Grok Bot (@bot)
- Genspark Genius (@genspark_ai)
- MiniMax H3, 100 dias (@RyanLeeMiniMax)
- Voxtral Transcribe 3 no AI Engineer Paris (@MistralAI)
- Voz local no Google AI Edge Gallery (Google Developers Blog)
- Déjà View (@NVIDIAAI)
- Identificação de doenças em textos clínicos em espanhol (OpenMed)
- Modelos de IA abertos com uma carteira (Fizzl)
- GR00T-X-Embodiment-Sim no FiftyOne (Hugging Face)
- Michael Rogers e Tom Moran (Sakana AI)
- Startups de reciclagem com IA (blog da NVIDIA)
- Conformidade da IA (Perplexity)
- Arquitetura MCP (Perplexity)
- Hacking Higher Ed (@cohere)