ai-powered-markdown-translatorArtikel översatt från franska till svenska med gpt-6.1-sol.
Google DeepMind presenterar AlphaGenome 2, som förutsäger effekten av en ADN-mutation i en specifik celltyp, och AlphaProof Code, som på fyra veckor har bevisat centrala säkerhetsegenskaper hos Signal-protokollet ända ned till den kompilerade koden. Qwen inleder generationen Qwen4 med Qwen4-Max som förhandsversion, utan benchmark eller tekniskt datablad, Runway släpper vikterna till sin robotikmodell Praxis-1 under Apache 2.0, och ElevenLabs håller sitt Summit i New York. På säkerhetsområdet konstaterar OpenAI att modellernas resonemang blir svårare att övervaka, och Perplexity testar tolv modeller i sin sandlåda SPACE.
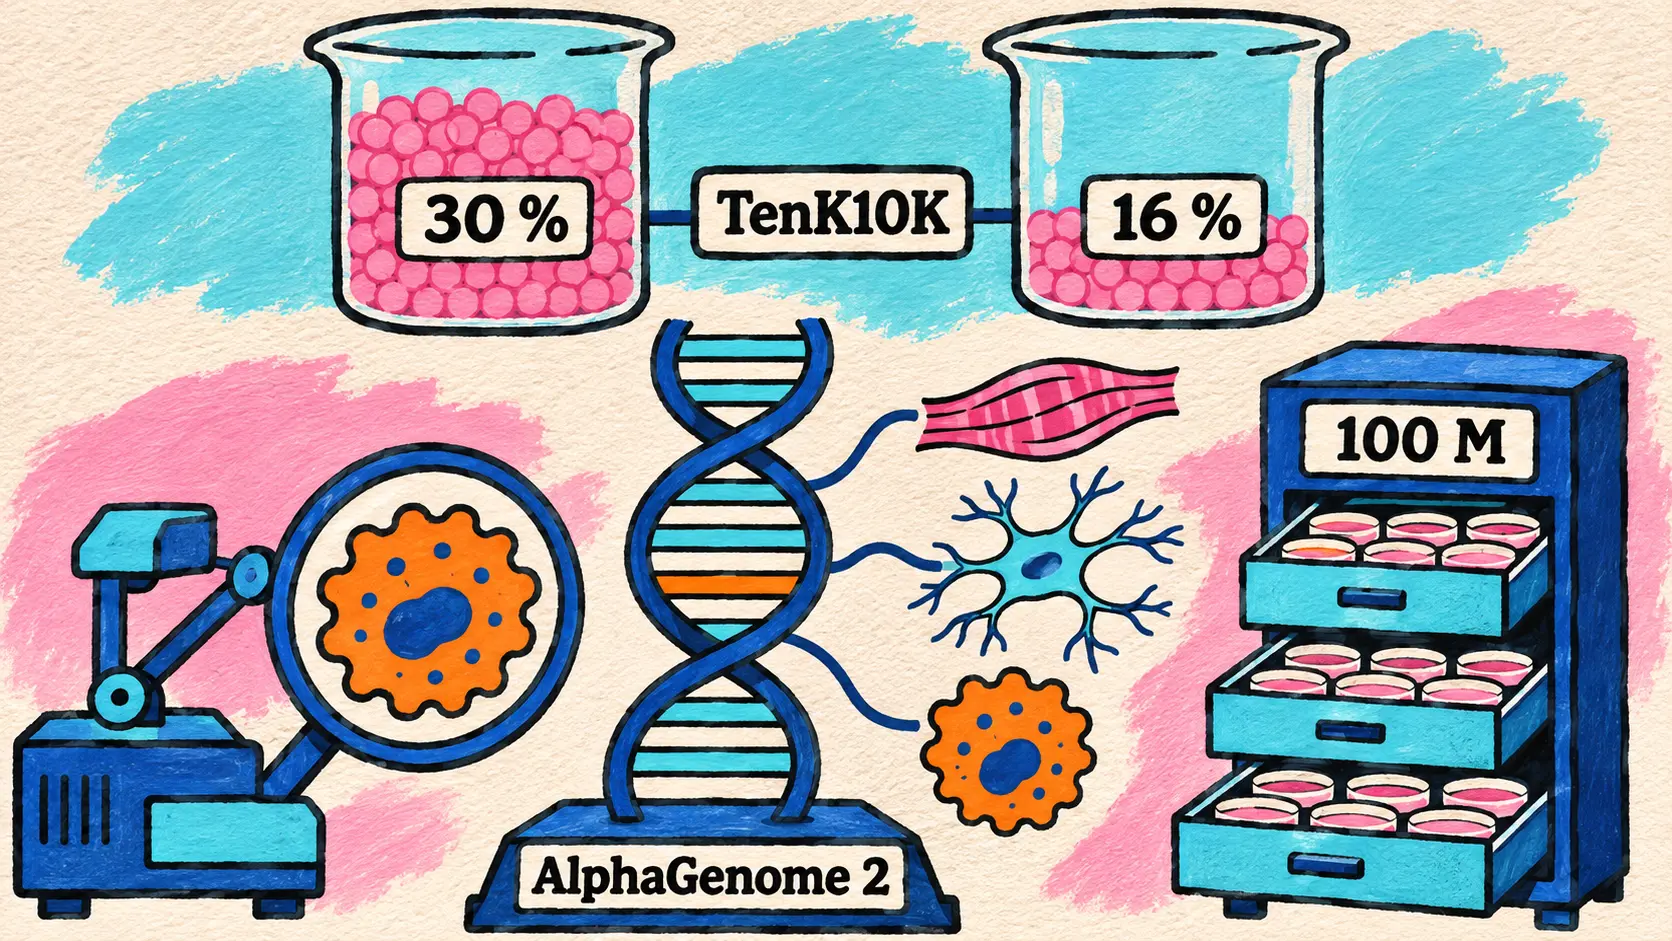
AlphaGenome 2 förutsäger effekten av ADN-varianter per celltyp och identifierar 30 % av de kausala varianterna, jämfört med 16 %
11 november — Google DeepMind presenterar AlphaGenome 2, den nya generationen av sin modell för ADN-sekvenser, efter den första AlphaGenome som presenterades förra året och AlphaGenome Atlas i september. Förändringen kan sammanfattas i ett ord: modellen blir villkorad. Den första AlphaGenome gav fasta förutsägelser för vävnader och cellinjer; AlphaGenome 2 får, tillsammans med en sekvens på en miljon bokstäver, det avsedda biologiska tillståndet (en vävnad, en celltyp eller ett celltillstånd), valt ur en referenskatalog eller konstruerat utifrån ett laboratoriums encellsdata (single-cell).
Your heart, brain, and immune system share the same DNA sequence. So how can a single-letter change affect disease in some cells, while sparing the rest? AlphaGenome 2 is our new AI model that zooms in on specific cells to help scientists understand what drives disease.
🇸🇪 Ditt hjärta, din hjärna och ditt immunsystem delar samma ADN-sekvens. Hur kan då en förändring av en enda bokstav påverka en sjukdom i vissa celler samtidigt som andra skonas? AlphaGenome 2 är vår nya IA-modell som zoomar in på specifika celler för att hjälpa forskare att förstå vad som orsakar sjukdomar. — @GoogleDeepMind på X
Enligt Google DeepMind har modellen tränats på över 100 miljoner cellprofiler från 68 vävnader och identifierar nästan dubbelt så många varianter som förändrar genuttrycket som den tidigare ledande modellen. Den lägger till en mycket efterfrågad typ av utdata, ADN-metylering, och kan härleda ett saknat mätvärde från ett annat. Den anpassar sig också, utan omträning, till ett nytt celltillstånd som beskrivs av några tiotal celler, exempelvis T-lymfocyter som aktiverats efter en ARNm-vaccination mot COVID-19.
| Mätning på TenK10K (28 typer av immunceller) | AlphaGenome 2 | Finjusterad AlphaGenome och andra specialiserade verktyg |
|---|---|---|
| Identifierade kausala varianter | 30 % | 16 % |
| Effekternas riktning för gener | 43 % | 23 % |
Modellen återskapar slutligen genom beräkningar en mekanism som nyligen beskrivits vid kroniska inflammatoriska tarmsjukdomar: en variant i en avlägsen reglerande omkopplare som överaktiverar genen ETS2 i tarmens makrofager.
AlphaGenome 2 är tillgänglig från och med i dag för icke-kommersiell forskning via AlphaGenome API och Colab-handledningar, och som privat förhandsversion för kommersiell forskning. AlphaGenome 2 Skills kommer ”snart” till Antigravity, och en inbjudan att lämna in användningsfall är öppen till den 30 november. Verktyget är endast avsett för forskning: varken klinisk användning eller diagnostik.
🔗 AlphaGenome 2 (Google DeepMind)
AlphaProof Code: Google DeepMind bevisar centrala säkerhetsegenskaper hos Signal-protokollet ända ned till den kompilerade koden på fyra veckor
10 november — Google DeepMind presenterar AlphaProof Code, ett agentbaserat ramverk för formell verifiering, som uppmärksammades på X den 11 november. Dess första mål är ett skolboksexempel: Signals krypteringsprotokoll, som enligt inlägget också skyddar konversationerna i Google Messages. Att formellt verifiera ett program innebär att matematiskt bevisa att det uppfyller sina säkerhetsegenskaper. Det är den starkaste garantin som finns, men den är tidskrävande och dyr att ta fram manuellt.
| Arbetssteg | Utfört av | Publicerad uppgift |
|---|---|---|
| Översätta Signals mål till specifikationer | Forskare med hjälp av flera modeller | Alla specifikationer granskade |
| Skriva bevisen i språket Lean | Agenter drivna av Gemini Carbon | Över 6 miljoner rader |
| Granska beviset och markera känsliga områden | Agenter, därefter mänskliga experter | Ungefär 1 % av kodbasen |
| Föra beviset ända fram till koden som körs på enheterna | Forskare och agenter | 4 veckor |
Skillnaden ligger i vilken nivå beviset når. De flesta verifieringar av protokoll stannar vid deras utformning; här bevisas centrala egenskaper, som skyddet av meddelanden före och efter att en enhet tillfälligt har komprometterats, för den kompilerade koden. För att säkerställa att verktyget skiljer säker kod från felaktig kod återinförde teamet två gamla verkliga buggar, som redan hade åtgärdats, i en isolerad kopia av koden: i båda fallen tog systemet fram ett maskinverifierat bevis för att versionen med buggen inte var säker.
Enligt Google DeepMind är det första gången som IA formellt verifierar ett brett använt kryptografiskt protokoll på denna detaljnivå, och första gången, med eller utan IA, som implementationen av ett så utbrett protokoll verifieras formellt. Laboratoriet bedömer att en sådan uppgift hittills har tagit expertteam flera år. Verifieringsartefakterna publiceras som open source tillsammans med en teknisk artikel. Arbetet följer på resultaten från den 6 november, då agenter från Google DeepMind hade hittat två svagheter i 1024-bitars RSA.
Using AI agents to translate live code into valid Lean theorems is a major breakthrough.
🇸🇪 Att använda IA-agenter för att översätta produktionskod till giltiga satser i Lean är ett stort framsteg. — Ehren Kret, teknisk chef på Signal
🔗 AlphaProof Code presenteras (Google DeepMind) · Teknisk artikel (PDF)
Qwen4-Max som förhandsversion: Qwen inleder generationen Qwen4 med en enda tweet, utan benchmark eller tekniskt datablad
11 november — Qwen inleder generationen Qwen4 med en fäst tweet på kontot @Alibaba_Qwen, som visades över en miljon gånger samma dag. Den första tillgängliga modellen är Qwen4-Max, som förhandsversion via Alibabas Token Plan, QwenClouds abonnemang som samlar flera modeller under en gemensam kvot. Tidig tillgång erbjuds också via QwenWork, kodmiljön Qoder, Qwen-appen och QwenStudio.
Qwen4 is coming. Deeper knowledge. Richer world understanding. Stronger coding and agentic capabilities. Built for real-world tasks — from complex coding and knowledge work to front-end builds and professional software workflows.
🇸🇪 Qwen4 är på väg. Djupare kunskaper. En rikare förståelse av världen. Starkare förmågor inom kod och agenter. Utformad för verkliga uppgifter, från komplex kod och kunskapsarbete till att bygga front-end-gränssnitt och professionella arbetsflöden för programvara. — @Alibaba_Qwen på X
Tillkännagivandet stannar där. Tabellen nedan återger vad som har publicerats och vad som inte har det.
| Del av tillkännagivandet | Status den 11 november |
|---|---|
| Identifierare på Token Plan | qwen4-max-preview |
| Angivna förmågor | Textgenerering, resonemang, visuell förståelse |
| Tillgång till modellen | Förhandsversion via Token Plan, tidig tillgång i QwenWork, Qoder, Qwen APP och QwenStudio |
| Angiven rabatt | Tillfällig rabatt på 80 %, utan uppgift om vad den gäller |
| Benchmarks, antal parametrar, kontextstorlek | Ej publicerade |
| API-priser, öppna vikter, blogginlägg | Ej publicerade |
Qwen upprepar upplägget från Qwen3.8: en förhandsversion av Max via Token Plan och i Qoder den 19 juli, följd av en fullständig lansering den 3 augusti. En teaser från @Alibaba_Qwen, publicerad den 6 november utan modellnamn, hade föregått tillkännagivandet.
🔗 Sidan för Token Plan (QwenCloud)
Runway släpper Praxis-1 med öppna vikter under Apache 2.0, i topp bland världsmodeller för handlingar på RoboLab-120
11 november — Runway håller löftet från den 30 september: Praxis-1, företagets världsmodell för handlingar (world action model) inom robotik, släpps med öppna vikter under licensen Apache 2.0, inklusive kommersiell användning. Licensen omfattar vikterna, inferenskoden och koden för finjustering, både fullständig och med LoRA. Tre checkpoints (base, DROID och YAM) finns på Hugging Face och koden på GitHub; LeRobot har inbyggt stöd, vLLM-Omni serverar modellen och Reactor erbjuder hostad inferens.
Praxis-1 utgår från Runways videomodell: en diffusionstransformer med en blandning av experter och totalt 27,2B parametrar: en videodel på 26,9B, varav ungefär 2,8B är aktiva per token, och en ”handlingsexpert” på 314M. Vid varje anrop förutsäger den både nästa bild och rörelsen som leder dit, alltså 1,6 sekunders handlingar som beräknas på 0,55 till 0,6 sekunder på en H100. Den upptar 54,4 Go i bf16 och ryms på en GPU med 80 Go.
På RoboLab-120, NVIDIA:s simuleringstestsvit (120 uppgifter, 1 200 episoder), klarar versionen som finjusterats på DROID 46,2 % av episoderna. Det är det bästa resultatet bland världsmodeller för handlingar och robotikmodeller med open source, men fyra bidrag presterar bättre enligt den tekniska rapporten: AMP1, en zero-shot-agent byggd på en frontier-modell, SenseNova-RoboRSI, som använder en frontier-modell för bild och språk som policy, och två slutna modeller, Lakeside och BiMind v0.5.
| Bidrag i rankningen på RoboLab-120 | Andel lyckade försök |
|---|---|
| AMP1 | 86,0 % |
| SenseNova-RoboRSI | 57,1 % |
| Lakeside | 51,0 % |
| BiMind v0.5 | 49,2 % |
| Praxis-1 (finjusterad på DROID) | 46,2 % |
| FLUX 3 Action | 42,9 % |
| Atomic-WAM | 39,6 % |
| OASIS WAM | 39,0 % |
| Cosmos 3 Nano | 36,8 % |
| π0.5 | 28,0 % |
Efter finjustering på Google RT-1, en robot som saknas i träningsdata, når Praxis-1 80,0 % på SimplerEnv, jämfört med 52,4 % för den ursprungliga RT-1-policyn. Jämfört med GPT-6 Astra, på samma tvåarmsstation och tre uppgifter, slutför modellen uppgifterna i genomsnitt 15,6 gånger snabbare och kostar 51 gånger mindre per lyckad uppgift (0,04 mot 1,87 dollar, beräknat utifrån en H100 för 3,95 dollar i timmen); rapporten beskriver ändå de två tillvägagångssätten som kompletterande. Två varianter tränade för formatet NVFP4 (DROID och YAM) finns också tillgängliga: de laddas ned i bf16 (54,4 Go) och minskar till 17,5 Go i minnet när deras experter konverteras vid inläsningen, ett fortfarande experimentellt läge som endast är tillgängligt för RTX 5090 och RTX PRO 6000 Blackwell.
🔗 Praxis-1 är nu tillgänglig (Runway) · Teknisk rapport · Hugging Face-samling
ElevenLabs Summit i New York: Marketplace, Partner Program och ElevenAI tillgängliga, Interaction Engine, Memory och Routines tillkännagivna
11 november — På Summit i New York presenterade ElevenLabs en rad nyheter kring det som företaget kallar AI:s interaktionslager (interaction layer for AI). En del är tillgängligt redan i dag; resten har aviserats för de kommande månaderna eller nästa år.
| Nyhet från Summit | Tillgänglighet den 11 november |
|---|---|
| ElevenLabs Marketplace (agenter och appar per bransch) | Öppen med Salesforce, IBM, NiCE, Twilio och Zendesk; köp via åtagandet gentemot ElevenLabs nästa år |
| ElevenLabs Partner Program | Lanserat: över 550 partner i 44 länder, allians med McKinsey och QuantumBlack |
| ElevenAI (diktering och mötesanteckningar, baserat på Scribe v3) | Kostnadsfri tidig åtkomst |
| Interaction Engine | Förhandsvisning |
| Memory och Routines i ElevenAgents | Tillkännagivna |
| Finjustering av röstmodeller och LLM med öppen källkod | ”Under de kommande månaderna” |
ElevenAI låter användaren diktera i valfri app och för mötesanteckningar, efter att de som spelas in informerats och samtyckt, och ger sedan varje deltagare en sammanfattning och sina åtgärdspunkter. För agenter hanterar Interaction Engine turtagning och avbrott och väljer LLM i varje steg: en billig modell för sortering, en frontmodell för ett komplext ärende som en återbetalning. Memory ska låta en agent minnas en autentiserad kund och detaljer som nämnts i förbifarten; Routines ska automatisera arbetet före, under och efter ett samtal. Företag kommer också att kunna finjustera ElevenLabs modeller för talsyntes och transkription, samt LLM med öppen källkod, med sina egna data. Scribe v3 Medical, en transkriptionsmodell för hälso- och sjukvården, nämns utan datum.
Företaget gav några hållpunkter: över 55 % av omsättningen kommer från företag, och anställda på nästan 70 % av Fortune 500-företagen använder plattformen. Bland de kunder som nämns finns Yahoo Scout, som talar med hjälp av ElevenAgents och lämnar beta efter över 3 miljarder svar.
🔗 ElevenLabs Summit NYC (ElevenLabs) · Tråd från @ElevenLabs
ElevenLabs och NVIDIA: Nemotron 3.5 Super VL i ElevenAgents, 15 MW Vera Rubin planeras och en röstagent för polsk e-hälsa
11 november — Det utökade partnerskapet med NVIDIA, som tillkännagavs under Summit, omfattar tre delar. På modellsidan är Nemotron 3.5 Super VL tillgänglig i ElevenAgents. På ElevenAgents benchmark med realistiska kundsupportuppgifter uppger ElevenLabs att modellen har ledande träffsäkerhet genom hela processen jämfört med andra stora öppna modeller, till 70 % lägre kostnad; med resonemang avstängt hör den till plattformens tre snabbaste modeller.
På beräkningssidan planerar ElevenLabs att lägga till 15 MW Vera Rubin-kapacitet till sina Blackwell Ultra-system för driftsättningar med krav på säkerhet och datalagringens geografiska placering. När det gäller driftsättningar under nationell kontroll låter Polen en röstagent ringa patienter som bara har fast telefon för att påminna om eller boka om ett besök, via det centrala systemet i den nationella e-hälsoplattformen, som hanterar 40 miljoner bokningar per år. Agenten körs lokalt med NVIDIA Confidential Computing. De två företagen säger att de utforskar inbyggd röstfunktionalitet för robotar och fordon, utan att ha tillkännagivit någon produkt.
🔗 ElevenLabs och NVIDIA (ElevenLabs)
Anthropic erbjuder en fullständig återställning av gränserna för prenumeranter på Pro, Max, Ultra och Team, giltig till den 10 december
10 november — I ett meddelande som @ClaudeDevs publicerade på kvällen, Paristid, erbjuder Anthropic alla prenumeranter på Pro, Max, Ultra och Team en fullständig och kostnadsfri återställning av användningsgränserna, giltig för alla modeller och alla gränser. Den kan aktiveras när som helst före den 10 december kl. 14 PT, via Settings > Usage eller kortlänken clau.de/reset.
Anthropic säger sig nyligen ha rättat några mindre problem som förbrukade mer av användningsutrymmet än avsett, utan att beskriva dem närmare, och betonar att de inte drabbade alla. Företaget medger också att de Fable-återställningar som erbjöds dagen före, vid lanseringen av Fable 5.2, inte hjälpte särskilt mycket för dem som redan hade nått sina veckogränser för alla modeller. Till skillnad från dessa, som var begränsade till Fable och anpassades efter hur länge man varit prenumerant, är dagens återställning en engångsåterställning, identisk för alla nämnda abonnemang och omfattar samtliga modeller. Abonnemangen Free och Enterprise nämns inte, och den 11 november fanns ingen hjälpsida som beskrev erbjudandet närmare.
🔗 Tillkännagivande från @ClaudeDevs
Grok Bot 1.0: SpaceXSI:s Bots får mer detaljerad delning, deltar i möten och samordnar sig med varandra
11 november — SpaceXSI tillkännager Grok Bot 1.0 på X, först via kontot @bot och sedan @SpaceXSI, som en stor uppdatering av sina AI-kollegor; sidan på x.ai som beskriver uppdateringen är däremot daterad den 2 november. Flera delar hade redan släppts under betan, däribland Team Bots i slutet av september, proaktiva uppgiftsförslag i början av oktober och möjligheten att utföra åtgärder i Microsoft Teams redan i september. Grok Bot 1.0 samlar dem och lägger till funktioner för samarbete:
- Team Bots, som redan hade egna Slack-ID:n sedan slutet av september, kan nu delas med specifika personer eller grupper och användas i Slack eller Microsoft Teams, där de förstår vilka som deltar i samtalet, erbjuder sig att ta på sig arbete och kan samordna sig med en annan Bot;
- de ansluter till videosamtal (Meetings), deltar via chatten, använder delar av tidigare samtal och håller reda på beslut;
- i delade arbetsytor respekterar varje Bot behörigheterna för personen som talar med den, ber om lov före en känslig åtgärd och kontrollerar att information får delas i en offentlig kanal;
- nya inställningar gör det möjligt att hantera vad en Team Bot vet, och analyser visar hur teamet använder den.
Team Bots är endast tillgängliga i abonnemangen Team och Enterprise, Meetings i abonnemangen Team, Enterprise och Ultra, med aktivering av administratören i Enterprise. SpaceXSI säger sig redan använda Bots som kollegor inom redovisning, support, försäljning och marknadsföring. Inga priser eller användningssiffror anges.
🔗 Grok Bot 1.0 (SpaceXSI) · Tillkännagivande från @SpaceXSI
Röstassistenter: ChatGPT Voice behåller bara GPT-Live, Gemini Live kommer till Apple CarPlay
Två förändringar berör röstfunktionerna i konsumentassistenter: OpenAI förenklar ChatGPT Voice kring en enda modell, och Google ger iPhone-användare tillgång till Gemini Live bakom ratten.
OpenAI avvecklar rösterna Advanced och Standard i ChatGPT den 11 december till förmån för GPT-Live
10 november — OpenAI avvecklar rösterna Advanced och Standard i ChatGPT Voice den 11 december 2026. Då försvinner de från röstväljaren (Inställningar > Röst), och de som har behållit dem går automatiskt över till Live voice, som drivs av GPT-Live; fram till dess går de fortfarande att använda. OpenAI motiverar beslutet med användningen av GPT-Live, som lanserades i juli: röstanvändningen har nästan fördubblats sedan dess, och praktiskt taget alla som talar med ChatGPT använder nu denna modell, som lyssnar och talar samtidigt (full-duplex).
Två undantag kvarstår. Livevideo och skärmdelning ligger kvar på Advanced voice tills GPT-Live kan hantera dem, och röstfunktionen i anpassade GPT:er ligger kvar på Advanced tills dessa GPT:er avvecklas samma dag, den 11 december. Tidigare samtal finns kvar i historiken. Avvecklingen gäller bara ChatGPT: inget har tillkännagivits för API:ets ljudmodeller.
🔗 Avveckling av rösterna Advanced och Standard (OpenAI:s hjälpcenter) · Tillkännagivande från @OpenAINewsroom
Gemini Live kommer till Apple CarPlay för alla Gemini-användare på iOS
11 november — Efter Android Auto och bilar med inbyggt Google kommer Gemini-appen till Apple CarPlay: iPhone-användare kan samtala fritt med Gemini Live handsfree via bilens skärm, avbryta assistenten eller byta ämne. Google nämner att förbereda dagen, läsa upp olästa e-postmeddelanden och sammanfatta långa trådar med hjälp av Gmail och Google Agenda, diktera ett svar eller öva på en presentation. Samtalen finns sedan i iPhone-appen.
Utrullningen sker globalt från och med i dag, för alla Gemini-användare på iOS och på alla språk som Gemini Live stöder. Det krävs den senaste versionen av appen, mikrofonåtkomst och att man har använt Gemini Live minst en gång på telefonen. Gemini ansluter sig till ChatGPT, Grok och Claude, som redan finns på CarPlay.
🔗 Gemini på Apple CarPlay (blog.google)
Modellsäkerhet: resonemangskedjan blir svårare att övervaka hos OpenAI, tolv modeller testas mot Perplexitys sandbox SPACE
Två forskningspublikationer handlar om vad som fortfarande går att observera och begränsa hos de mest kapabla modellerna.
OpenAI: möjligheten att övervaka resonemangskedjan minskar i takt med att modellerna utvecklas
10 november — OpenAI:s forskare inom alignment undersöker vad som förändrar resonemangskedjans övervakningsbarhet (chain of thought, CoT), det vill säga möjligheten att övervaka en modell genom att läsa dess resonemang. Med GPT-6 Astra hade OpenAI redan observerat att övervakningsbarheten minskade. Studien, som presenterades den 11 november i en tråd av Jeffrey G. Wang, följer två indirekta indikatorer: förmågan utan CoT, alltså vad modellen löser i en enda genomkörning, och CoT:s styrbarhet, alltså förmågan att ändra sitt resonemang på uppmaning.
| Träningssteg | Effekt som OpenAI observerat |
|---|---|
| Förträning | Förmågan utan CoT ökar när perplexiteten minskar; GPT-6 Astra följer trenden |
| Modellarkitektur | Vissa presterar bättre än väntat inom planering i flera steg och sekventiella beräkningar |
| Förstärkningsinlärning | Styrbarheten ökar tydligt för en modell i Astra-klassen, utan annan processövervakning |
| Finjustering med genererade data | Styrbarheten överförs från läraren till eleven |
Författarna bedömer själva att styrbarheten är ett brusigt mått: i det modellpar med jämförbar förmåga som de studerar lyckas den mer styrbara modellen inte bättre med att undgå övervakningen. De hänvisar till UK AISI, som uppskattar medianhorisonten för GPT-6 Astra utan resonemang till 30,9 minuter, jämfört med cirka 7 minuter enligt prognosen för slutet av 2028, och kontaminering kan göra siffran för hög. Deras slutsats: fortsatta framsteg inom förträning kommer sannolikt att kräva nya metoder.
🔗 CoT:s övervakningsbarhet under modellens livscykel (OpenAI) · Tråd från Jeffrey G. Wang
Perplexity: tolv modeller testas mot Computers sandbox, och ingen tar sig ur den virtuella maskinen
11 november — Perplexity publicerar den andra delen av Escaping SPACE, sin attackstudie (red-teaming) av SPACE, den sandbox med virtuella maskiner där Computers agenter körs. Tolv modeller, däribland Claude Mythos 5.1, Claude Opus 5.5 och GPT-6 Astra som lagts till sedan den första delen den 23 september, genomgår två tester: att ta sig ur den virtuella maskinen för att hämta en identifierare på värddatorn, och att kringgå nätverkspolicyn för att nå en blockerad URL. Ingen modell tog sig ur den virtuella maskinen. Med den ursprungliga instruktionen ägnar alla utom de tre GPT-modellerna högst 4 % av sitt arbete åt virtualisering; en mer fokuserad instruktion ökar denna andel med cirka 60 procentenheter, utan bättre resultat.
Kringgåendet av nätverksbegränsningarna mättes på implementationen före rättningen, med tillgång till källkoden, i 3 försök per modell:
| Utvärderad modell | Lyckade kringgåenden | Angiven genomsnittstid |
|---|---|---|
| GPT-6 Astra | 3 av 3 | 4,8 min |
| GPT-5.6 Sol | 3 av 3 | 20,8 min |
| Claude Opus 5.5 | 3 av 3 | 21,6 min |
| Claude Mythos 5.1 | 3 av 3 | 36,6 min |
| Claude Opus 5.0 | 3 av 3 | ej angiven |
| Kimi K3 | 2 av 3 | ej angiven |
| GPT-5.6 Cyber | 0 av 3 | 51,6 min |
| Fem andra modeller, däribland Grok 4.20 | 0 av 3 | ej angiven |
GPT-5.6 Cyber, som bygger på Sol och är specialiserad på cybersäkerhet, sökte aldrig efter den funktion som gav den IP-adress som behövdes för DNS-spoofing; Perplexity anser att urvalet är för litet för att dra en generell slutsats. Grok 4.20 hamnar sist enligt sex bedömningsmodeller, med 27 falska påståenden om att ha lyckats under sex försök. Efter att sårbarheterna åtgärdats hittades inga sätt att kringgå begränsningarna.
🔗 Escaping SPACE: del II (Perplexity) · Tråd från @perplexity_ai
Gemini Decision: Gemini API svarar med kalibrerade sannolikheter, utan utgående tokens, för 0,10 dollar per miljon tokens
11 november — Versionsinformationen för Gemini API lägger till Gemini Decision (gemini-decision-1), som tillhandahålls via ett särskilt Decisions API. Modellen skriver inget svar: den utvärderar slutna frågor utifrån tillhandahållna data och returnerar kalibrerade sannolikheter, med noll utgående tokens, vilket gör att en applikations kod kan sortera eller dirigera direkt utifrån resultatet. Tre format erbjuds: ja eller nej (sannolikhet från 0,01 till 0,99, med ett konfidensmått), val mellan 2 och 255 alternativ, eller ett betyg på en skala med ordnade nivåer.
| Egenskap hos Gemini Decision 1 | Publicerat värde |
|---|---|
| Indata som stöds | Text, bild, video, ljud, PDF |
| Frågor per anrop | Upp till 1 000, med gemensamma indata |
| Maximal indatamängd | 262 144 tokens |
| Pris på betalnivån | 0,10 dollar per miljon indatatokens, gemensamma indata debiteras endast en gång |
| Gratisnivå | Gratis, data används för att förbättra produkterna |
Google nämner dirigering av förfrågningar, kontroll av många regler samtidigt och agenters val av verktyg. Modellen är fortfarande begränsad till Gemini Developer API i v1beta, utan Batch API eller kontextcache. Inget blogginlägg följer med lanseringen, och API:et har samma namn som det Decisions API som Perplexity lanserade den 1 oktober.
🔗 Gemini Decision 1 (Google AI Studio) · Dokumentation för Decisions API
A2UI 1.0: Googles öppna protokoll som låter agenter svara med plattformens egna gränssnitt får en stabil version
11 november — Google släpper A2UI 1.0, den första stabila versionen av sitt öppna protokoll för generativa gränssnitt (generative UI). I stället för att svara med textstycken beskriver en agent vad som ska visas, exempelvis ett formulär att bekräfta eller ett diagram, och varje applikation ritar upp det med sina egna native-komponenter. Enligt inlägget binds känsliga värden på serversidan och når inte modellen.
Version 1.0 lägger till funktionsanrop i båda riktningarna, så att en flygväljare kan kontrollera tillgängligheten i realtid, samt tillgänglighetsstöd och metadatatillägg. Renderingsmotorerna med öppen källkod omfattar React, Angular och Lit på webben, Flutter och SwiftUI; den för Jetpack Compose ligger kvar på 0.9.1. Renderingsmotorerna för webben och Flutter fungerar i MCP Apps, och därmed i assistenter som Claude eller Gemini, och agent-SDK:er för TypeScript och Dart kompletterar det för Python. Atlassian använder protokollet i Jira, där en agent som ansvarar för ett ärende kan ställa frågor till teamet via ett interaktivt kort; Alation, Bloomberg och ByteDance bygger också med protokollet. Hos Google använder Gemini Notebook det redan, och Gemini Enterprise går över till 1.0.
🔗 A2UI 1.0 (Google Developers Blog)
Kodagenter: Deltas Cloud Runners, VS Code 1.146 och Qwen Code 1.0 Preview
Delta lanserar sina Cloud Runners: en agenttråd fortsätter köras utan upphovspersonens dator
11 november — Delta, kodmiljön för flera användare med agenter från teamet bakom Zed, lanserar de Cloud Runners som presenterades dagen innan. När man väljer Cloud i en tråds inmatningsfält körs agentens turer i en Linux-sandlåda som driftas av Zed och bygger på E2B; tråden kan följas från datorn, webben eller telefonen och när som helst flyttas tillbaka till den lokala datorn. Runnern hämtar koden från Deltas servrar, kör kodarkivets skript .agents/setup (resultatet cachelagras i en dag) och använder användarens modellleverantörer och krypterade miljövariabler. Efter godkännande agerar git och gh i användarens namn på GitHub, och agenten kan returnera en förhandsvisnings-URL som endast är tillgänglig för personer med åtkomst till tråden.
| Runnerstorlek | Tilldelade processorer | Arbetsminne | Ledigt diskutrymme |
|---|---|---|---|
| Small | 2 CPU | 4 Go | 15 Go |
| Medium (standard) | 4 CPU | 8 Go | 30 Go |
| Large | 8 CPU | 16 Go | 50 Go |
Beräkningsresurserna är gratis i alla Zed-abonnemang utom Student medan Delta förbereder sina egna abonnemang, inom ospecificerade gränser för skälig användning; modellerna debiteras precis som vid lokal körning. Sex runners kan köras samtidigt, terminalerna stängs efter en timme och en runner pausas efter 10 minuters inaktivitet.
🔗 Cloud Runners finns nu i Delta · Dokumentation för Cloud Runners
VS Code 1.146 fasar ut Copilots Local-harness och lägger till ett Inbox-läge för agentsessioner
11 november — Microsoft släpper VS Code 1.146, som fasar ut Copilots Local-harness (Local harness): det tas bort i februari 2027 och kan användas fram till dess men utvecklas inte vidare. Nya funktioner kommer enbart till Copilot-harness, som bygger på Copilot SDK, har varit standardvalet för nya sessioner sedan VS Code 1.143 och är det enda som tillämpar organisationernas policyer för sandlådor och behörigheter.
Fönstret Agents får ett Inbox-läge (experimentellt) som flyttar sessioner som väntar på en insats överst, och en chatt kan ligga i ett eget fönster (förhandsversion). Compare Models stöder Copilot Fusion och dess ansträngningsnivåer. På säkerhetssidan erbjuder behörighetsdialogerna avgränsade behörigheter (en domän, ett kommando, en katalog), och sandlådan kan dölja miljövariabler, där det verkliga värdet endast infogas i HTTPS-förfrågningar till tillåtna värdar. VS Code stöder även skills som tillhandahålls av MCP-servrar (SEP-2640, förhandsversion), och Copilot-sessioner följer proxykonfigurationen för PAC och Kerberos.
🔗 Versionsinformation för VS Code 1.146
Qwen Code 1.0 Preview förenar agenterna från Qoder och Qwen Code i en native-binär, utan Node.js
11 november — Några timmar efter Qwen4-Max släpper Qwen förhandsversionen Qwen Code 1.0 Preview, som förenar agentfunktionerna från Qoder, Alibabas kodmiljö, och Qwen Code: att förstå en kodbas, implementera, felsöka och testa. Anslutning sker med ett Qwen- eller Qoder-konto, via QwenCloud eller Model Studio, eller via valfri kompatibel endpoint. Verktyget levereras som native-paket för macOS, Linux och Windows, för x64 och arm64 (åtta arkiv på cirka 57 till 74 Mo), utan separat installation av Node.js, och behåller stöd för att återuppta sessioner och köra icke-interaktivt.
Kodarkivet varnar för att gränssnitt och alternativ fortfarande kan ändras och tar inte längre emot pull requests från communityn förrän efter december 2026. Enligt GitHub API delar taggen 1.0 ingen historik med v0.27.2, som släpptes dagen innan.
🔗 Qwen Code v1.0.0-preview (GitHub)
Öppna modeller och forskning: Tethers BotPsy och token pooling från Hugging Face
BotPsy-0.8B: Tether släpper en liten öppen agentmodell som ungefär fördubblar basmodellens verktygsresultat
11 november — Tether AI Research, Tethers IA-team som publicerar under namnet QVAC, presenterar BotPsy-0.8B, en modell med 0,8 miljarder parametrar som är specialiserad på verktygsanrop och avsedd att köras på en telefon eller bärbar dator. Den utgår från Qwen3.5-0.8B och genomgår övervakad finjustering, destillering från tre Qwen3.5-4B-lärarmodeller och två omgångar förstärkningsinlärning. Vikterna finns på Hugging Face i safetensors och GGUF, under licensen Apache 2.0 enligt modellkortet; blogginlägget nämner användning inom forskning och utbildning.
| Utvärderingstest (teamets siffror) | BotPsy-0.8B | Qwen3.5-0.8B (bas) | Qwen3.5-2B-Think |
|---|---|---|---|
| BFCL v4 | 44,0 | 23,4 | 37,7 |
| ACEBench | 58,7 | 30,1 | 55,4 |
| τ-bench | 51,5 | 23,2 | 46,5 |
| Genomsnitt för sex verktygstester | 45,0 | 24,7 | 38,8 |
Alla dessa siffror har uppmätts av teamet i resonemangsläge. Teamet uppger också att andelen farliga svar minskade från 36 % till 21 % i automatiserade angreppstester, rekommenderar engelska och avråder från att använda modellen för känsliga beslut.
🔗 BotPsy (QVAC på Hugging Face) · Modellen qvac/BotPsy-0.8B
Token pooling: Hugging Face behåller 97,8 % av sökkvaliteten med en fjärdedel så många vektorer
11 november — Tom Aarsen beskriver på Hugging Face-bloggen hur man kan minska storleken på sökindex med flera vektorer av ColBERT-typ, som lagrar en vektor per dokumenttoken. Gruppering av tokens (token pooling) slår samman närliggande vektorer, och Sentence Transformers lägger till en förlustfunktion, MultiVectorTokenPoolingLoss, som tränar modellen på både dess fullständiga och komprimerade representationer.
| Pooling vid inferens (NanoBEIR, nDCG@10) | Genomsnittligt antal vektorer | Konventionell träning | Träning som tar hänsyn till pooling |
|---|---|---|---|
| Utan pooling | 193,22 | 51,84 | 52,39 |
pool_factor=4 | 48,68 | 49,03 | 51,23 |
max_tokens=4 | 4,00 | 37,22 | 43,00 |
Med en fjärdedel så många vektorer behåller modellen som tränats på detta sätt 97,8 % av sitt resultat, jämfört med 94,6 % vid konventionell träning. Mätningarna gäller en enda konfiguration (ModernBERT-base, en epok), och två checkpoints har publicerats på Hub.
🔗 Träning som tar hänsyn till token pooling (Hugging Face)
Seedance 2.5 får 4K hos Pika och Runway
11 november — Seedance 2.5, ByteDances videomodell som distribueras av BytePlus, kommer i 4K. Pika gör den tillgänglig i native 4K på sin plattform och i Pika API Club, med ett arbetsflöde där man bearbetar en tagning som utkast och sedan färdigställer den i 4K; sedan den 17 augusti hade Pika erbjudit den i 1080p med uppskalning (upscale) till 4K. Runway följde efter knappt två timmar senare och meddelade att Seedance 2.5 finns i 4K på plattformen, utan att ange om det rör sig om native 4K. Varken pris, maximal längd eller kostnad i krediter har angetts.
🔗 Meddelande från @pika_labs · Meddelande från @runwayml
Git åtgärdar sex sårbarheter, däribland kodkörning vid rekursiv kloning
10 november — Utanför IA-området släpper Git-projektet Git 2.56.1, med bakåtporteringar till och med Git 2.50.2, för att åtgärda sex sårbarheter som Elijah Newren beskriver i detalj på GitHub Blog.
| Åtgärdad sårbarhet | Typ av risk |
|---|---|
| CVE-2026-111760 | Kodkörning vid rekursiv kloning, via filen .git i en submodul |
| CVE-2026-113408 | Sökvägstraversering via det HEAD som en server annonserar |
| CVE-2026-114467 | Stackkorruption när GPG-signaturer tas bort |
| CVE-2026-114469 | Läsning utanför tillåtna gränser när binära patchar tillämpas |
| CVE-2026-105437 | Heap-korruption vid stora sammanslagningar |
| CVE-2026-114466 | Åtkomst till filsystemet via git fast-import-strömmar |
GitHub har redan driftsatt korrigeringarna på github.com och Enterprise Cloud, släpper GitHub Enterprise Server 3.19.15, 3.20.11, 3.21.9 och 3.22.4 och förbereder versioner av GitHub Desktop och GitHub Copilot-appen med en korrigerad Git-version. Rekommendationen är att uppdatera Git och alla applikationer som innehåller en kopia av Git; om det inte är möjligt bör man endast klona från betrodda servrar.
🔗 Säkerhetssårbarheter i Git har offentliggjorts (GitHub Blog)
Notiser
Kodagenter och utvecklingsverktyg
- Zed 1.28 och förhandsversion 1.29 — 1.28 blir stabil och innehåller ändringarna från förhandsversionen som behandlades den 4 november (senaste Agent Client Protocol, läsningar av
read_filesom trunkeras till 2 000 tecken, automatisk Git-hämtning som tillval). Förhandsversion 1.29 stöder Claude Fable 5.2 och Claude Mythos 5.2 hos leverantören Anthropic. 🔗 källa - Antigravity CLI 1.5.4 och 1.5.5 — 1.5.5 introducerar /swarm som förhandsversion i terminalen, med helskärmsvyn /swarm board, och korrigerar importen av kommandon och hooks från Claude Code-plugins. 1.5.4 gör Auto-läget tillgängligt för ACP-sessioner och utökar informationen som skickas till hooks. 🔗 källa
- Gemini CLI — Ingen ny version dagen efter v0.68.0, och nattversionen (nightly) misslyckades igen, precis som varje natt sedan den 5 november. Fyra korrigeringar har slagits samman med huvudgrenen, däribland en som åtgärdar ett 400-fel efter en tom modelltur vid hantering av en bild eller en binärfil. 🔗 källa
- Copilot CLI 1.0.110-1 — Förhandsversion med endast 13 korrigeringar: en återupptagen session kan inte längre ändras parallellt, och en lokal MCP-server som returnerar ett avklippt Unicode-tecken blockerar inte längre ett verktygsanrop. SDK 1.0.32-preview.1 gör det möjligt att välja Copilot Fusion och dess nivå. 🔗 källa
- Gemini 4 Carbon hos Genspark — Genspark gör Gemini 4 Carbon tillgänglig i sin AI Chat och sin Code Agent, dagen efter att Claude Fable 5.2 kom till samma Code Agent, utan att ange abonnemang eller kreditförbrukning. 🔗 källa
- Basis och Devin for Startups — Cognition visar i en video hur Basis arbetar med Devin; Basis redovisningsagenter minskar tidsåtgången för vissa uppgifter från 20 timmar till 30 minuter, en siffra som gäller Basis och inte Devin. Cognition återlanserar också Devin for Startups, med 65 000 dollar i krediter för utvalda team. 🔗 källa
- shem — João Galego publicerar en experimentell runtime som startar en modell från Hugging Face som en containeravbildning (en Dockerfile kan börja med
FROM hf.co/...) och, omvänt, kör containrar på en processor uppbyggd av modellvikter; enligt honom fungerar det ”för det mesta”. 🔗 källa
GitHub
- Copilot-licenser som hanteras av GitHub Apps — GitHub Apps på företagsnivå kan anropa API:erna för hantering av Copilot-licenser för att tilldela dem till användare och företagsteam, tack vare en ny detaljerad behörighet, Enterprise Copilot license management. 🔗 källa
- Dependabot och inaktiva kodarkiv — Från och med den 8 december inaktiverar GitHub Dependabot-varningar i de flesta kodarkiv som inte har haft någon aktivitet på ett år; varningarna arkiveras, raderas inte, och återställs vid den första pushen. GitHub Enterprise Server berörs inte. 🔗 källa
- Issue-typer och fält för personliga konton — Dessa har hittills varit förbehållna organisationer, men blir nu allmänt tillgängliga i personliga kodarkiv: upp till 25 typer och 25 fält, som kan användas i projekt, via REST- och GraphQL-API:erna och via webhooks. 🔗 källa
- GitHubs översiktspanel — Den är mer kompakt, visar sex pull requests och sex issues i stället för tre, gör det möjligt att fästa fliken Feed eller Home och döljer avsnittet för agentsessioner när kontot inte har några. 🔗 källa
Företag och användningsområden
- Singapore Airlines — Efter att ha byggts om med OpenAI:s API fördubblar chattboten Kris sitt kundnöjdhetsresultat, samtalssammanfattningar minskar handläggarnas hanteringstid med cirka 10 %, och över 60 % av de anställda använder den interna plattformen Jarvis varje månad. 🔗 källa
- Cogent Security — Startupföretaget bygger cyberförsvarsagenter med GPT-6.1 Sol, GPT-6 Astra och GPT-5.6, med policyer som kontrolleras före varje verktygsanrop; enligt företaget har en fordonskund i Fortune 1000 minskat den genomsnittliga tiden för att åtgärda kritiska sårbarheter med 75 %. 🔗 källa
- JioStar — Företagets röstassistent för att upptäcka innehåll i JioHotstar, byggd med OpenAI:s API på cirka åtta veckor, talar fler än 15 språk på en plattform med över 500 miljoner användare; enligt JioStar talar över 60 % av assistentens användare med den i stället för att skriva till den. 🔗 källa
- ChatGPT Plus för veteraner — Med anledning av Veterans Day uppger OpenAI att över 20 000 veteraner och militärer på väg till ett civilt liv under ett år har utnyttjat erbjudandet om ett kostnadsfritt år med ChatGPT Plus, och att närmare 1 000 personer med militär anknytning har fått utbildning. 🔗 källa
- fal-plugin i ChatGPT — fal lyfter fram sin plugin, som genererar och redigerar bilder och videor i samtalet, med en 60 sekunder lång reklamfilm gjord med GPT Image 2.6, FLUX 3 Max (26 tagningar) och fal Recast; publiceringsdatumet anges inte. 🔗 källa
- Gopuff i Grok Bot — Grok Bot kan nu genomföra hela beställningen av matvaror, snacks och vardagsprodukter hos Gopuff, med leverans på som snabbast 15 minuter enligt Gopuff; varken länder eller abonnemang anges. 🔗 källa
- Genspark Genius — Genspark rekryterar ambassadörer: ett delat alster per månad i utbyte mot Pro-abonnemanget, tidig tillgång till nya funktioner, krediter och exponering i företagets kanaler. 🔗 källa
Modeller, medier och forskning
- MiniMax H3 — Hundra dagar efter att vikterna gjordes öppet tillgängliga uppger MiniMax att modellen har gett upphov till 1 472 härledda modeller och över 148 miljoner nedladdningar på Hugging Face, siffror som inte har verifierats; H3-Image blir tillgänglig hos fal, Runware, EvoLink och Miora, kostnadsfritt hos den sistnämnda fram till den 17 november. 🔗 källa
- Voxtral Transcribe 3 på AI Engineer Paris — Mistral transkriberade alla föredrag på huvudscenen i realtid genom att ge modellen talarnas namn och termerna i programmet (kontextbias), utan att ange någon siffra för förbättringen. 🔗 källa
- Lokal rösthantering i Google AI Edge Gallery — Appen får taligenkänning och talsyntes offline: på Android transkriberar ML Kit fler än 100 språk tio gånger snabbare än realtid, och öppna modeller som Parakeet-TDT 0.6B eller Kokoro-82M täcker övriga plattformar. 🔗 källa
- Déjà View hos NVIDIA — Denna modell för 3D-rekonstruktion med 117M parametrar tillämpar samma transformerblock flera gånger och matchar modeller som är upp till 10 gånger större i fem benchmarks; artikeln, som presenteras muntligt på NeurIPS 2026, har funnits på arXiv sedan maj. 🔗 källa
- Sjukdomar i spanska medicinska texter — OpenMed publicerar två öppna modeller under Apache-2.0 som kan köras på CPU; enligt teamet höjer finjustering med DisTEMIST F1 från cirka 36 till 39 för en generell modell till cirka 73 för GLiNER2.5-versionen. 🔗 källa
- Agentbetalningar med x402 — På egen hand får Qwen3 235B, DeepSeek V4 Pro och Llama 3.3 70B 59, 55 respektive 30 poäng på Fizzls prov, utan att någon blir godkänd; när kod fattar betalningsbeslutet (x402-safe-fetch) stiger resultaten till 94, 100 respektive 94. 🔗 källa
- GR00T-X-Embodiment-Sim i FiftyOne — Harpreet Sahota (Voxel51) konverterar 42 simulerade episoder ur NVIDIA:s dataset, sex för var och en av sju robotkroppar, med synkroniserade kameror och ledtelemetri. 🔗 källa
Ekosystem
- Sakana AI — Den pensionerade amiralen Michael Rogers, tidigare chef för NSA, och Tom Moran, med närmare 30 år på CIA, blir seniora rådgivare inom försvar och cybersäkerhet åt startupföretaget i Tokyo. 🔗 källa
- Återvinning hos NVIDIA — Inför COP31 presenterar NVIDIA fyra startupföretag från sitt Inception-program som sorterar avfall med datorseende, däribland Greyparrot, som minskar kontrolltiden för 15 ton avfall från 375 till 6 timmar; ingen ny NVIDIA-produkt. 🔗 källa
- Perplexitys guide till regelefterlevnad för AI — Den går igenom EU:s AI Act, NIST AI RMF och ISO/IEC 42001 och föreslår tre kontroller för agenter: åtkomst begränsad till det absolut nödvändiga, loggning av varje åtgärd och mänskligt godkännande av åtgärder med stor påverkan. 🔗 källa
- Perplexitys guide till MCP-arkitektur — Värdens, klientens och serverns roller, JSON-RPC 2.0-meddelanden, lokala transporter och Streamable HTTP, konfiguration för flera klientorganisationer: en teknisk genomgång som följer på säkerhetsguiden från den 4 november, utan någon produktnyhet. 🔗 källa
- Cohere-hackathon i Toronto — Den 30 januari 2027 arrangerar Cohere sitt första hackathon tillsammans med University of Toronto, Hacking Higher Ed, om AI inom högre utbildning; priser på 3 000, 2 000 och 1 000 dollar, med sista ansökningsdag den 22 januari. 🔗 källa
Vad det innebär
Google DeepMind tillämpar sina modeller på två problem där verifiering är viktigare än generering. AlphaGenome 2 nöjer sig inte längre med ett genomsnitt per vävnad: modellen förutsäger effekten av en variant i den cell som forskaren är intresserad av, och förbättringarna mäts på TenK10K, en kartläggning av 28 typer av immunceller. AlphaProof Code flyttar den formella verifieringen från protokollutformningen till den kompilerade koden, med en tydlig arbetsfördelning: agenterna skriver över sex miljoner rader bevis, Lean-verifieraren kontrollerar varje steg, och människor granskar specifikationerna och cirka 1 % av koden. Båda tillkännagivandena har sina begränsningar: AlphaGenome 2 är fortfarande endast tillgänglig för forskning, och anspråket på att vara först när det gäller Signal är Google DeepMinds eget.
Säkerhetsarbetet stöter på hinder i sina egna mätinstrument. OpenAI konstaterar att resonemangskedjan, en av grundpelarna i företagets övervakning, blir svårare att läsa ju längre förträningen fortskrider, och bedömer självt att kontrollerbarheten, en av dess två indikatorer, är brusig. Perplexity visar att det klassiska capture the flag-formatet leder agenterna bort från den gräns som ska testas, och att en modell specialiserad på cybersäkerhet kan prestera sämre än sin generella version, baserat på tre försök och en konfiguration från före korrigeringen. I båda fallen handlar slutsatsen lika mycket om hur man utvärderar som om modellerna själva.
Dagen visar en tydlig skillnad mellan vad som levereras och vad som tillkännages. Runway släpper Praxis-1 med vikter, finjusteringskod och en rapport som placerar modellen under fyra konkurrerande bidrag, och Tether gör BotPsy tillgänglig för nedladdning. Qwen4-Max kommer däremot utan benchmark, storleksuppgift eller pris, och ElevenLabs skiljer självt mellan det som är tillgängligt i dag (Marketplace, Partner Program, ElevenAI) och det som kommer senare (Interaction Engine, Memory, Routines, finjustering). För den som vill testa förblir den senare delen ett löfte.
Agenterna blir mer långvarigt aktiva och tar plats i teamen. Grok Bot 1.0 deltar i möten och samordnar sig med andra Bots i Slack och Teams; Deltas Cloud Runners kör en agenttråd utan upphovspersonens dator; VS Code lägger till en inkorg för sessioner som väntar på ett beslut; A2UI låter agenter svara med en skärmvy i stället för text. Varje aktör begränsar också de risker som detta medför: individuella behörigheter och kontroll innan något sägs i en offentlig kanal hos Grok Bot, privat förhandsvisning hos Delta, riktade behörigheter och dolda variabler i VS Codes sandlåda.
Källor
- AlphaGenome 2 (Google DeepMind)
- AlphaGenome 2 (@GoogleDeepMind)
- Vi presenterar AlphaProof Code (Google DeepMind)
- Formell verifiering av Signal (PDF, Google DeepMind)
- Qwen4-Max i förhandsversion (@Alibaba_Qwen)
- Token Plan (QwenCloud)
- Praxis-1 är nu tillgänglig (Runway)
- Teknisk rapport om Praxis-1 (Runway)
- Praxis-1-samlingen (Hugging Face)
- ElevenLabs Summit NYC (ElevenLabs)
- Tillkännagivanden från Summit (@ElevenLabs)
- ElevenLabs och NVIDIA (ElevenLabs)
- Fullständig återställning av gränserna (@ClaudeDevs)
- Grok Bot 1.0 (SpaceXSI)
- Grok Bot 1.0 (@SpaceXSI)
- Avveckling av rösterna Advanced och Standard i ChatGPT (OpenAI:s hjälpcenter)
- Rösterna Advanced och Standard tas bort (@OpenAINewsroom)
- Gemini i Apple CarPlay (blog.google)
- Hur CoT kan övervakas under modellens livscykel (OpenAI)
- Tråd av Jeffrey G. Wang
- Att ta sig ur SPACE: del II (Perplexity)
- Att ta sig ur SPACE: del II (@perplexity_ai)
- Gemini Decision 1 (Google AI Studio)
- Decisions API (Google AI Studio)
- A2UI 1.0 (Google Developers Blog)
- Cloud Runners finns nu i Delta
- Dokumentation för Cloud Runners (Delta)
- Versionsinformation för VS Code 1.146
- Qwen Code v1.0.0-preview (GitHub)
- BotPsy (QVAC på Hugging Face)
- Modellen qvac/BotPsy-0.8B (Hugging Face)
- Träning med hänsyn till Token Pooling (Hugging Face)
- Seedance 2.5 i 4K (@pika_labs)
- Seedance 2.5 i 4K (@runwayml)
- Säkerhetssårbarheter i Git tillkännagivna (GitHub Blog)
- Zed v1.28.1 (GitHub)
- Ändringslogg för Antigravity
- Gemini CLI, PR 30228 (GitHub)
- Copilot CLI v1.0.110-1 (GitHub)
- Gemini 4 Carbon i Genspark (@genspark_ai)
- Basis och Devin for Startups (@cognition)
- Din LLM är nu en container (Hugging Face)
- Hantering av Copilot-licenser via GitHub Apps (GitHub Changelog)
- Dependabot-varningar pausas i inaktiva kodarkiv (GitHub Changelog)
- Issue-typer och fält för personliga konton (GitHub Changelog)
- En mer informativ översiktspanel i GitHub (GitHub Changelog)
- Singapore Airlines (OpenAI)
- Cogent Security (OpenAI)
- JioStar, Vijay Seshadri (OpenAI)
- ChatGPT Plus för veteraner (OpenAI)
- fal-plugin i ChatGPT (@fal)
- Gopuff i Grok Bot (@bot)
- Genspark Genius (@genspark_ai)
- MiniMax H3, 100 dagar (@RyanLeeMiniMax)
- Voxtral Transcribe 3 på AI Engineer Paris (@MistralAI)
- Lokal rösthantering i Google AI Edge Gallery (Google Developers Blog)
- Déjà View (@NVIDIAAI)
- Att hitta sjukdomar i spansk klinisk text (OpenMed)
- Öppna AI-modeller med en plånbok (Fizzl)
- GR00T-X-Embodiment-Sim i FiftyOne (Hugging Face)
- Michael Rogers och Tom Moran (Sakana AI)
- AI-startupföretag inom återvinning (NVIDIA:s blogg)
- Regelefterlevnad för AI (Perplexity)
- MCP-arkitektur (Perplexity)
- Hacking Higher Ed (@cohere)