ai-powered-markdown-translatorArtículo traducido del fr al es con gpt-6.1-sol.
Google DeepMind presenta AlphaGenome 2, que predice el efecto de una mutación del ADN en un tipo de célula concreto, y AlphaProof Code, que ha demostrado en cuatro semanas propiedades de seguridad clave del protocolo Signal hasta el código compilado. Qwen inaugura la generación Qwen4 con Qwen4-Max en versión preliminar, sin benchmark ni ficha técnica, Runway publica los pesos de su modelo robótico Praxis-1 bajo Apache 2.0, y ElevenLabs celebra su Summit de Nueva York. En materia de seguridad, OpenAI constata que el razonamiento de sus modelos se vuelve más difícil de supervisar, y Perplexity pone a prueba doce modelos en su entorno aislado SPACE.
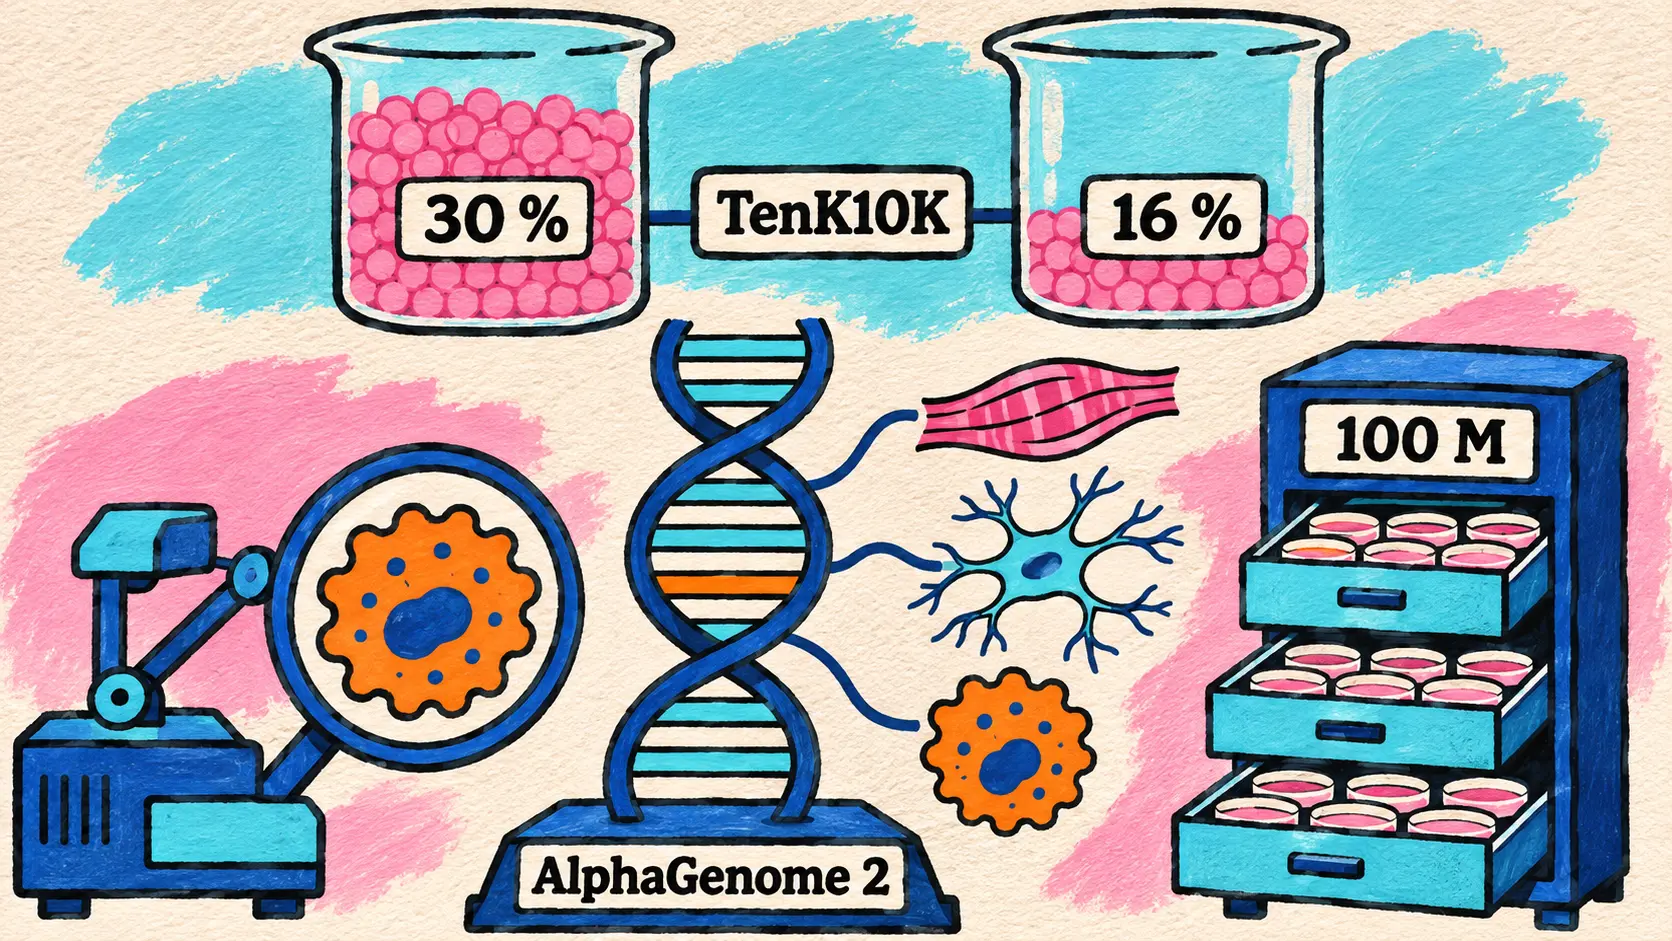
AlphaGenome 2 predice el efecto de las variantes del ADN por tipo de célula e identifica el 30 % de las variantes causales, frente al 16 %
11 de noviembre — Google DeepMind presenta AlphaGenome 2, la nueva generación de su modelo de secuencias de ADN, tras un primer AlphaGenome presentado el año pasado y AlphaGenome Atlas en septiembre. El cambio se resume en una palabra: el modelo se vuelve condicional. El primer AlphaGenome generaba predicciones fijas para tejidos y líneas celulares; AlphaGenome 2 recibe, junto con una secuencia de un millón de letras, la condición biológica de interés (un tejido, un tipo o un estado celular), elegida de un catálogo de referencia o construida a partir de los datos unicelulares (single-cell) de un laboratorio.
Your heart, brain, and immune system share the same DNA sequence. So how can a single-letter change affect disease in some cells, while sparing the rest? AlphaGenome 2 is our new AI model that zooms in on specific cells to help scientists understand what drives disease.
🇪🇸 Tu corazón, tu cerebro y tu sistema inmunitario comparten la misma secuencia de ADN. Entonces, ¿cómo puede el cambio de una sola letra influir en una enfermedad en ciertas células y dejar intactas las demás? AlphaGenome 2 es nuestro nuevo modelo de IA que se centra en células concretas para ayudar a los científicos a comprender qué provoca las enfermedades. — @GoogleDeepMind en X
Según Google DeepMind, el modelo se ha entrenado con más de 100 millones de perfiles celulares que abarcan 68 tejidos, e identifica casi el doble de variantes que modifican la expresión de los genes que el anterior modelo del estado del arte. Añade una salida muy solicitada, la metilación del ADN, y puede deducir una medición ausente a partir de otra. También se adapta, sin reentrenamiento, a un nuevo estado celular descrito mediante unas pocas decenas de células, como los linfocitos T activados tras una vacunación con ARNm contra la COVID-19.
| Medición en TenK10K (28 tipos de células inmunitarias) | AlphaGenome 2 | AlphaGenome ajustado y otras herramientas especializadas |
|---|---|---|
| Variantes causales identificadas | 30 % | 16 % |
| Efectos direccionales sobre los genes | 43 % | 23 % |
Por último, el modelo reproduce mediante cálculo un mecanismo descrito recientemente en las enfermedades inflamatorias intestinales crónicas: una variante situada en un interruptor regulador distante, que sobreactiva el gen ETS2 en los macrófagos intestinales.
AlphaGenome 2 está disponible desde hoy para la investigación no comercial, a través de la API AlphaGenome y tutoriales de Colab, y en versión preliminar privada para la investigación comercial. Las AlphaGenome 2 Skills llegarán «pronto» a Antigravity, y la convocatoria de casos de uso permanece abierta hasta el 30 de noviembre. La herramienta está reservada a la investigación: sin uso clínico ni diagnóstico.
🔗 AlphaGenome 2 (Google DeepMind)
AlphaProof Code: Google DeepMind demuestra propiedades de seguridad clave del protocolo Signal hasta el código compilado, en cuatro semanas
10 de noviembre — Google DeepMind presenta AlphaProof Code, un marco agéntico de verificación formal, difundido el 11 de noviembre en X. Su primer objetivo es un caso de manual: el protocolo de cifrado de Signal, que también protege las conversaciones de Google Messages según la publicación. Verificar formalmente un programa consiste en demostrar matemáticamente que cumple sus propiedades de seguridad. Es la garantía más sólida que existe, pero obtenerla a mano requiere mucho tiempo y resulta costoso.
| Etapa del trabajo | Realizada por | Dato publicado |
|---|---|---|
| Traducir los objetivos de Signal en especificaciones | Investigadores asistidos por varios modelos | Todas las especificaciones revisadas |
| Escribir las pruebas en el lenguaje Lean | Agentes impulsados por Gemini Carbon | Más de 6 millones de líneas |
| Revisar la prueba y señalar las partes delicadas | Agentes, después expertos humanos | Aproximadamente el 1 % de la base de código |
| Llevar la prueba hasta el código que se ejecuta en los dispositivos | Investigadores y agentes | 4 semanas |
La diferencia radica en el nivel de la prueba. La mayoría de las verificaciones de protocolos se detienen en su diseño; aquí, propiedades clave, como la protección de los mensajes antes y después de que un dispositivo se vea comprometido temporalmente, se demuestran sobre el código compilado. Para asegurarse de que la herramienta distingue un código seguro de uno defectuoso, el equipo reintrodujo dos antiguos bugs reales, ya corregidos, en una copia aislada del código: en ambos casos, el sistema produjo una prueba verificada por máquina de que la versión con bugs no era segura.
Según Google DeepMind, es la primera vez que la IA verifica formalmente un protocolo criptográfico ampliamente desplegado con esta profundidad, y la primera vez, con o sin IA, que se verifica formalmente la implementación de un protocolo tan extendido. El laboratorio estima que, hasta ahora, una tarea así requería años de trabajo de equipos de expertos. Los artefactos de verificación se publican en open source junto con un artículo técnico. Estos trabajos siguen a los del 6 de noviembre, cuando agentes de Google DeepMind habían encontrado dos debilidades del RSA de 1024 bits.
Using AI agents to translate live code into valid Lean theorems is a major breakthrough.
🇪🇸 Usar agentes de IA para traducir código en producción a teoremas válidos de Lean es un avance importante. — Ehren Kret, director de tecnología de Signal
🔗 Presentamos AlphaProof Code (Google DeepMind) · Artículo técnico (PDF)
Qwen4-Max en versión preliminar: Qwen inaugura la generación Qwen4 con un solo tweet, sin benchmark ni ficha técnica
11 de noviembre — Qwen inaugura la generación Qwen4 con un tweet fijado en la cuenta @Alibaba_Qwen, visto más de un millón de veces ese mismo día. El primer modelo accesible es Qwen4-Max, en versión preliminar en el Token Plan de Alibaba, la suscripción de QwenCloud que reúne varios modelos bajo una misma cuota. El acceso anticipado también está disponible a través de QwenWork, el entorno de código Qoder, la aplicación Qwen y QwenStudio.
Qwen4 is coming. Deeper knowledge. Richer world understanding. Stronger coding and agentic capabilities. Built for real-world tasks — from complex coding and knowledge work to front-end builds and professional software workflows.
🇪🇸 Qwen4 está llegando. Conocimientos más profundos. Una comprensión del mundo más rica. Capacidades de código y de agente más sólidas. Diseñado para tareas reales, desde código complejo y trabajo del conocimiento hasta la creación de interfaces front-end y flujos de trabajo de software profesionales. — @Alibaba_Qwen en X
El anuncio termina ahí. La tabla siguiente recoge lo que se ha publicado y lo que no.
| Elemento del anuncio | Estado a 11 de noviembre |
|---|---|
| Identificador en el Token Plan | qwen4-max-preview |
| Capacidades anunciadas | Generación de texto, razonamiento, comprensión visual |
| Acceso al modelo | Versión preliminar en el Token Plan, acceso anticipado en QwenWork, Qoder, Qwen APP y QwenStudio |
| Descuento anunciado | Reducción temporal del 80 %, sin precisar a qué se aplica |
| Benchmarks, número de parámetros, tamaño del contexto | No publicados |
| Precios de la API, pesos abiertos, publicación de blog | No publicados |
Qwen repite el esquema de Qwen3.8: versión preliminar del Max en el Token Plan y en Qoder el 19 de julio, seguida del lanzamiento completo el 3 de agosto. Un teaser de @Alibaba_Qwen, publicado el 6 de noviembre sin nombre de modelo, había precedido al anuncio.
🔗 Página del Token Plan (QwenCloud)
Runway publica Praxis-1 con pesos abiertos bajo Apache 2.0, a la cabeza de los modelos de acción del mundo en RoboLab-120
11 de noviembre — Runway cumple la promesa del 30 de septiembre: Praxis-1, su modelo de acción del mundo (world action model) para robótica, se publica con pesos abiertos bajo licencia Apache 2.0, incluido el uso comercial. La licencia cubre los pesos, el código de inferencia y el código de ajuste fino, completo o mediante LoRA. Hay tres puntos de control (base, DROID y YAM) en Hugging Face y el código está en GitHub; LeRobot lo admite de forma nativa, vLLM-Omni lo sirve y Reactor ofrece inferencia alojada.
Praxis-1 parte del modelo de vídeo de Runway: un transformer de difusión con mezcla de expertos de 27,2B parámetros en total: una parte de vídeo de 26,9B, con unos 2,8B activos por token, y un «experto de acción» de 314M. En cada llamada, predice tanto la siguiente imagen como el movimiento que conduce a ella, es decir, 1,6 segundos de acciones calculados en 0,55 a 0,6 segundos en un H100. Pesa 54,4 Go en bf16 y cabe en una GPU de 80 Go.
En RoboLab-120, el banco de simulación de NVIDIA (120 tareas, 1 200 episodios), la versión ajustada con DROID completa con éxito el 46,2 % de los episodios. Es la mejor puntuación entre los modelos de acción del mundo y los modelos robóticos open source, pero cuatro participantes lo superan según el informe técnico: AMP1, un agente zero-shot construido sobre un modelo de frontera, SenseNova-RoboRSI, que utiliza un modelo de visión y lenguaje de frontera como política, y dos modelos cerrados, Lakeside y BiMind v0.5.
| Participante en la clasificación RoboLab-120 | Tasa de éxito |
|---|---|
| AMP1 | 86,0 % |
| SenseNova-RoboRSI | 57,1 % |
| Lakeside | 51,0 % |
| BiMind v0.5 | 49,2 % |
| Praxis-1 (ajustado con DROID) | 46,2 % |
| FLUX 3 Action | 42,9 % |
| Atomic-WAM | 39,6 % |
| OASIS WAM | 39,0 % |
| Cosmos 3 Nano | 36,8 % |
| π0.5 | 28,0 % |
Ajustado con Google RT-1, un robot ausente de sus datos de entrenamiento, Praxis-1 alcanza el 80,0 % en SimplerEnv, frente al 52,4 % de la política RT-1 original. Frente a GPT-6 Astra, en la misma estación bimanual y con tres tareas, termina de media 15,6 veces más rápido y cuesta 51 veces menos por tarea completada con éxito (0,04 frente a 1,87 dólares, tomando como base un H100 a 3,95 dólares por hora); aun así, el informe presenta ambos enfoques como complementarios. También están disponibles dos variantes entrenadas para el formato NVFP4 (DROID y YAM): descargadas en bf16 (54,4 Go), bajan a 17,5 Go en memoria una vez convertidos sus expertos durante la carga, un modo todavía experimental reservado a las RTX 5090 y RTX PRO 6000 Blackwell.
🔗 Praxis-1 ya está disponible (Runway) · Informe técnico · Colección de Hugging Face
Summit de ElevenLabs en Nueva York: Marketplace, Partner Program y ElevenAI disponibles, Interaction Engine, Memory y Routines anunciados
11 de noviembre — En el Summit de Nueva York, ElevenLabs presentó una serie de anuncios en torno a lo que denomina la capa de interacción de la IA (interaction layer for AI). Una parte está disponible desde hoy; el resto está anunciado para los próximos meses o para el próximo año.
| Anuncio del Summit | Disponibilidad a 11 de noviembre |
|---|---|
| ElevenLabs Marketplace (agentes y aplicaciones por sector) | Abierto con Salesforce, IBM, NiCE, Twilio y Zendesk; compra con cargo al compromiso de gasto con ElevenLabs el próximo año |
| ElevenLabs Partner Program | Lanzado: más de 550 socios en 44 países, alianza con McKinsey y QuantumBlack |
| ElevenAI (dictado y notas de reuniones, basado en Scribe v3) | Acceso anticipado gratuito |
| Interaction Engine | Versión preliminar |
| Memory y Routines en ElevenAgents | Anunciados |
| Ajuste fino de los modelos de voz y de LLM open source | «En los próximos meses» |
ElevenAI permite dictar en cualquier aplicación y toma notas de las reuniones, con aviso y consentimiento de las personas grabadas, y después entrega a cada participante un resumen y sus tareas. En cuanto a los agentes, Interaction Engine gestiona los turnos de palabra y las interrupciones y elige el LLM en cada etapa: un modelo económico para la clasificación y un modelo de frontera para un caso complejo, como un reembolso. Memory permitirá que un agente recuerde a un cliente autenticado y los detalles mencionados de pasada; Routines automatizará el trabajo antes, durante y después de una conversación. Las empresas también podrán ajustar los modelos de síntesis y transcripción de voz de ElevenLabs, así como LLM open source, con sus propios datos. Se menciona Scribe v3 Medical, un modelo de transcripción para el sector sanitario, sin fecha.
La empresa aportó algunas cifras de referencia: más del 55 % de sus ingresos procede de empresas, y empleados de cerca del 70 % de las compañías del Fortune 500 utilizan su plataforma. Entre los clientes citados, Yahoo Scout, que habla gracias a ElevenAgents, sale de la beta tras más de 3 mil millones de respuestas.
🔗 ElevenLabs Summit NYC (ElevenLabs) · Hilo de @ElevenLabs
ElevenLabs y NVIDIA: Nemotron 3.5 Super VL en ElevenAgents, 15 MW de Vera Rubin previstos y un agente de voz para la e-Santé polaca
11 de noviembre — Anunciada durante el Summit, la ampliación de la alianza con NVIDIA abarca tres ámbitos. En cuanto a los modelos, Nemotron 3.5 Super VL está disponible en ElevenAgents. En el benchmark de ElevenAgents de tareas realistas de atención al cliente, ElevenLabs le atribuye una precisión de extremo a extremo líder frente a los demás grandes modelos abiertos, con un coste un 70 % inferior; con el razonamiento desactivado, figura entre los tres modelos más rápidos de la plataforma.
En cuanto a la capacidad de cómputo, ElevenLabs prevé añadir 15 MW de capacidad Vera Rubin a sus sistemas Blackwell Ultra para los despliegues sujetos a requisitos de seguridad y residencia de los datos. En cuanto a los despliegues soberanos, Polonia utiliza un agente de voz para llamar a los pacientes que solo tienen una línea fija y recordarles una cita o cambiarla, a través del sistema central de la plataforma nacional e-Santé, que gestiona 40 millones de citas al año. El agente se ejecuta en las instalaciones con NVIDIA Confidential Computing. Ambas empresas afirman que exploran la voz integrada para robots y vehículos, sin ningún producto anunciado.
🔗 ElevenLabs y NVIDIA (ElevenLabs)
Anthropic ofrece un restablecimiento completo de los límites a los suscriptores Pro, Max, Ultra y Team, válido hasta el 10 de diciembre
10 de noviembre — En un mensaje publicado por la noche (hora de París) por @ClaudeDevs, Anthropic ofrece a todos los suscriptores Pro, Max, Ultra y Team un restablecimiento completo y gratuito de sus límites de uso, aplicable a todos los modelos y todos los límites. Puede activarse en cualquier momento antes del 10 de diciembre a las 14 h PT, desde Configuración > Uso o mediante el enlace corto clau.de/reset.
Anthropic afirma haber corregido recientemente algunos pequeños problemas que consumían más cuota de la prevista, sin detallarlos y precisando que no afectaron a todo el mundo. La empresa también reconoce que los restablecimientos de Fable ofrecidos el día anterior, con motivo del lanzamiento de Fable 5.2, apenas ayudaban a quienes ya habían alcanzado sus límites semanales en todos los modelos. A diferencia de aquellos, limitados a Fable y ajustados según la antigüedad, el restablecimiento de hoy es único, idéntico para todos los planes citados y abarca todos los modelos. No se mencionan los planes Free y Enterprise, y a 11 de noviembre ninguna página de ayuda detallaba la oferta.
Grok Bot 1.0: los Bots de SpaceXSI se comparten de forma más selectiva, se unen a las reuniones y se coordinan entre sí
11 de noviembre — SpaceXSI anuncia Grok Bot 1.0 en X, primero a través de @bot y después de @SpaceXSI, como una actualización importante de sus compañeros de equipo de IA; la página de x.ai que lo detalla, por su parte, está fechada el 2 de noviembre. Varios componentes ya se habían publicado durante la beta, entre ellos los Team Bots a finales de septiembre, las propuestas proactivas de tareas a principios de octubre y la capacidad de actuar en Microsoft Teams desde septiembre. Grok Bot 1.0 los reúne y añade funciones para trabajar en equipo:
- los Team Bots, que ya tenían su identificador de Slack desde finales de septiembre, ahora se comparten con personas o grupos concretos y se utilizan en Slack o Microsoft Teams, donde entienden quién participa en la conversación, se ofrecen para asumir tareas y pueden coordinarse con otro Bot;
- se unen a las videollamadas (Meetings), intervienen por el chat, retoman elementos de conversaciones pasadas y registran las decisiones;
- en los espacios compartidos, cada Bot respeta los permisos de la persona que le habla, pregunta antes de realizar una acción sensible y comprueba que una información pueda compartirse en un canal público;
- nuevos ajustes permiten gestionar lo que sabe un Team Bot, y los análisis muestran cómo lo utiliza el equipo.
Los Team Bots están reservados a los planes Team y Enterprise, y Meetings a los planes Team, Enterprise y Ultra, con activación por parte del administrador en Enterprise. SpaceXSI afirma que ya utiliza Bots como compañeros de equipo en contabilidad, atención al cliente, ventas y marketing. No se indica ningún precio ni cifra de uso.
🔗 Grok Bot 1.0 (SpaceXSI) · Anuncio de @SpaceXSI
Asistentes de voz: ChatGPT Voice se queda solo con GPT-Live, Gemini Live llega a Apple CarPlay
Dos cambios afectan a la voz de los asistentes para el público general: OpenAI simplifica ChatGPT Voice en torno a un único modelo y Google lleva Gemini Live al coche de los usuarios de iPhone.
OpenAI retira las voces Advanced y Standard de ChatGPT el 11 de diciembre en favor de GPT-Live
10 de noviembre — OpenAI retira las voces Advanced y Standard de ChatGPT Voice el 11 de diciembre de 2026. En esa fecha, desaparecerán del selector (Ajustes > Voz) y quienes las hubieran conservado pasarán automáticamente a Live voice, impulsada por GPT-Live; hasta entonces, seguirán disponibles. OpenAI justifica esta decisión por la adopción de GPT-Live, lanzado en julio: el uso de la voz casi se ha duplicado desde entonces y prácticamente todas las personas que hablan con ChatGPT ya utilizan este modelo, que escucha y habla al mismo tiempo (full-duplex).
Se mantienen dos excepciones. El vídeo en directo y la pantalla compartida seguirán en Advanced voice mientras GPT-Live no pueda gestionarlos, y la voz de los GPT personalizados seguirá en Advanced hasta la retirada de estos GPT, el mismo 11 de diciembre. Las conversaciones pasadas permanecerán en el historial. La retirada solo afecta a ChatGPT: no se anuncia nada para los modelos de audio de la API.
🔗 Retirada de las voces Advanced y Standard (ayuda de OpenAI) · Anuncio de @OpenAINewsroom
Gemini Live llega a Apple CarPlay para todos los usuarios de Gemini en iOS
11 de noviembre — Tras Android Auto y los coches con Google integrado, la aplicación Gemini llega a Apple CarPlay: los usuarios de iPhone pueden conversar libremente con Gemini Live desde la pantalla de su coche, con manos libres, interrumpiéndolo o cambiando de tema. Google menciona la preparación del día, la lectura de correos electrónicos no leídos y el resumen de hilos largos gracias a Gmail y Google Agenda, el dictado de una respuesta o el ensayo de una presentación. Las conversaciones aparecen después en la aplicación del iPhone.
El despliegue es mundial a partir de hoy, para todos los usuarios de Gemini en iOS y en todos los idiomas compatibles con Gemini Live. Se requiere la última versión de la aplicación, acceso al micrófono y haber utilizado Gemini Live al menos una vez en el teléfono. Gemini se une a ChatGPT, Grok y Claude, ya presentes en CarPlay.
🔗 Gemini en Apple CarPlay (blog.google)
Seguridad de los modelos: la cadena de razonamiento se vuelve más difícil de supervisar en OpenAI, doce modelos se enfrentan al sandbox SPACE de Perplexity
Dos publicaciones de investigación abordan qué se puede seguir observando y conteniendo en los modelos más capaces.
OpenAI: la capacidad de supervisar la cadena de razonamiento disminuye a medida que los modelos avanzan
10 de noviembre — Los investigadores de alineamiento de OpenAI estudian qué factores modifican la capacidad de supervisar la cadena de razonamiento (chain of thought, CoT), es decir, la posibilidad de supervisar un modelo leyendo su razonamiento. Con GPT-6 Astra, OpenAI ya había observado una disminución de esta capacidad de supervisión. El estudio, presentado el 11 de noviembre en un hilo de Jeffrey G. Wang, sigue dos indicadores indirectos: la capacidad sin CoT, lo que el modelo resuelve en una sola pasada, y la controlabilidad de la CoT, su capacidad para modificar su razonamiento siguiendo instrucciones.
| Etapa del entrenamiento | Efecto observado por OpenAI |
|---|---|
| Preentrenamiento | La capacidad sin CoT mejora con la disminución de la perplejidad; GPT-6 Astra mantiene la tendencia |
| Arquitectura del modelo | Algunas rinden mejor de lo previsto en la planificación de varios pasos y el cálculo en serie |
| Aprendizaje por refuerzo | La controlabilidad aumenta claramente en un modelo de la categoría Astra, sin supervisión adicional del proceso |
| Ajuste fino con datos generados | La controlabilidad se transmite del profesor al alumno |
Los propios autores consideran que la controlabilidad es una medida con ruido: en el par de modelos de capacidad comparable que estudian, el más controlable no logra eludir mejor a los supervisores. Citan al UK AISI, que estima en 30,9 minutos el horizonte mediano de GPT-6 Astra sin razonamiento, frente a los aproximadamente 7 minutos proyectados para finales de 2028, aunque una contaminación podría inflar esa cifra. Su conclusión: los nuevos avances del preentrenamiento probablemente exigirán nuevos enfoques.
🔗 Capacidad de supervisión de la CoT a lo largo del ciclo de vida del modelo (OpenAI) · Hilo de Jeffrey G. Wang
Perplexity: doce modelos se enfrentan al sandbox de Computer y ninguno sale de la máquina virtual
11 de noviembre — Perplexity publica la segunda parte de Escaping SPACE, su estudio de ataque (red-teaming) de SPACE, el sandbox de máquinas virtuales donde se ejecutan los agentes de Computer. Doce modelos, entre ellos Claude Mythos 5.1, Claude Opus 5.5 y GPT-6 Astra, añadidos desde la primera parte del 23 de septiembre, se someten a dos pruebas: salir de la máquina virtual para obtener un identificador del host y eludir la política de red para acceder a una URL bloqueada. Ningún modelo salió de la máquina virtual. Con la instrucción original, todos salvo los tres GPT dedican como máximo el 4 % de su esfuerzo a la virtualización; una instrucción más centrada en ese objetivo aumenta la proporción de esfuerzo en unos 60 puntos porcentuales, sin mayor éxito.
La evasión de la política de red se midió en la implementación anterior al parche, con acceso al código fuente, en 3 intentos por modelo:
| Modelo evaluado | Evasiones logradas | Duración media citada |
|---|---|---|
| GPT-6 Astra | 3 de 3 | 4,8 min |
| GPT-5.6 Sol | 3 de 3 | 20,8 min |
| Claude Opus 5.5 | 3 de 3 | 21,6 min |
| Claude Mythos 5.1 | 3 de 3 | 36,6 min |
| Claude Opus 5.0 | 3 de 3 | no citada |
| Kimi K3 | 2 de 3 | no citada |
| GPT-5.6 Cyber | 0 de 3 | 51,6 min |
| Otros cinco modelos, entre ellos Grok 4.20 | 0 de 3 | no citada |
GPT-5.6 Cyber, basado en Sol y especializado en ciberseguridad, nunca buscó la función que proporcionaba la dirección IP necesaria para la suplantación DNS; Perplexity considera que la muestra es demasiado limitada para extraer una regla general. Grok 4.20 queda último según seis modelos evaluadores, con 27 declaraciones falsas de éxito en seis intentos. Tras corregir las vulnerabilidades, no se encontró ninguna evasión.
🔗 Escaping SPACE: Parte II (Perplexity) · Hilo de @perplexity_ai
Gemini Decision: la API Gemini responde con probabilidades calibradas, sin tokens de salida, a 0,10 dólares por millón de tokens
11 de noviembre — Las notas de la versión de la API Gemini incorporan Gemini Decision (gemini-decision-1), disponible mediante una Decisions API dedicada. El modelo no redacta una respuesta: evalúa preguntas cerradas sobre los datos proporcionados y devuelve probabilidades calibradas, con cero tokens de salida, lo que permite al código de una aplicación clasificar o enrutar directamente según el resultado. Se ofrecen tres formatos: sí o no (probabilidad de 0,01 a 0,99, con un índice de confianza), elección entre 2 y 255 opciones, o puntuación en una escala de niveles ordenados.
| Característica de Gemini Decision 1 | Valor publicado |
|---|---|
| Entradas admitidas | Texto, imagen, vídeo, audio, PDF |
| Preguntas por solicitud | Hasta 1 000, sobre una entrada compartida |
| Entrada máxima | 262 144 tokens |
| Tarifa del nivel de pago | 0,10 dólares por millón de tokens de entrada, con la entrada compartida facturada una sola vez |
| Nivel gratuito | Gratuito, los datos se utilizan para mejorar los productos |
Google cita el enrutamiento de solicitudes, la comprobación de numerosas reglas a la vez o la elección de herramientas por parte de un agente. El modelo sigue limitado a la API Gemini Developer en v1beta, sin Batch API ni caché de contexto. Ninguna entrada de blog acompaña al lanzamiento, y la API tiene el mismo nombre que la Decisions API lanzada por Perplexity el 1 de octubre.
🔗 Gemini Decision 1 (Google AI Studio) · Documentación de la Decisions API
A2UI 1.0: el protocolo abierto de Google que permite a los agentes responder con pantallas nativas pasa a versión estable
11 de noviembre — Google publica A2UI 1.0, la primera versión estable de su protocolo abierto de interfaz generativa (generative UI). En lugar de responder con párrafos, un agente describe lo que se debe mostrar, un formulario que confirmar o un gráfico, y cada aplicación lo dibuja con sus propios componentes nativos. Según la entrada, los valores sensibles se vinculan en el servidor y no llegan al modelo.
La versión 1.0 añade llamadas a funciones en ambos sentidos, para que un selector de vuelos compruebe la disponibilidad en el momento, así como accesibilidad y extensiones de metadatos. Los motores de renderizado open source cubren React, Angular y Lit en la web, Flutter y SwiftUI; el de Jetpack Compose sigue en la versión 0.9.1. Los renderizadores web y Flutter funcionan en las MCP Apps, por tanto en asistentes como Claude o Gemini, y los SDK de agentes de TypeScript y Dart se suman al de Python. Atlassian lo utiliza en Jira, donde un agente encargado de un ticket puede consultar al equipo mediante una tarjeta interactiva; Alation, Bloomberg y ByteDance también desarrollan con el protocolo. En Google, Gemini Notebook ya lo utiliza, y Gemini Enterprise pasa a la versión 1.0.
🔗 A2UI 1.0 (Google Developers Blog)
Agentes de código: los Cloud Runners de Delta, VS Code 1.146 y Qwen Code 1.0 Preview
Delta lanza sus Cloud Runners: un hilo de agente sigue ejecutándose sin el ordenador de su autor
11 de noviembre — Delta, el entorno de programación multijugador con agentes del equipo de Zed, lanza los Cloud Runners anunciados el día anterior. Al elegir Cloud en el editor de mensajes de un hilo, los turnos del agente se ejecutan en un sandbox Linux alojado por Zed, que se apoya en E2B; el hilo se puede seguir desde el escritorio, la web o el teléfono, y volver a la máquina local en cualquier momento. El runner obtiene el código de los servidores de Delta, ejecuta el script .agents/setup del repositorio (cuyo resultado se guarda en caché durante un día) y utiliza los proveedores de modelos y las variables de entorno cifradas del usuario. Tras la autorización, git y gh actúan en su nombre en GitHub, y el agente puede devolver una URL de vista previa reservada a las personas que tienen acceso al hilo.
| Tamaño del runner | Procesadores asignados | Memoria RAM | Espacio libre en disco |
|---|---|---|---|
| Small | 2 CPU | 4 Go | 15 Go |
| Medium (predeterminado) | 4 CPU | 8 Go | 30 Go |
| Large | 8 CPU | 16 Go | 50 Go |
El cómputo es gratuito en todos los planes de Zed salvo Student, mientras Delta prepara sus propios planes, dentro de unos límites de uso razonable sin cifras concretas; los modelos se siguen facturando como en local. Pueden ejecutarse seis runners a la vez, los terminales se cierran al cabo de una hora y un runner se pausa tras 10 minutos de inactividad.
🔗 Cloud Runners ya están en Delta · Documentación de los Cloud Runners
VS Code 1.146 marca como obsoleto el arnés Local de Copilot y añade un modo Inbox para las sesiones de agentes
11 de noviembre — Microsoft publica VS Code 1.146, que marca como obsoleto el arnés Local (Local harness) de Copilot: se retirará en febrero de 2027 y hasta entonces seguirá siendo utilizable, pero sin cambios. Las novedades llegarán únicamente al arnés Copilot, construido sobre el Copilot SDK, opción predeterminada para las nuevas sesiones desde VS Code 1.143 y el único que aplica las políticas de sandbox y permisos de las organizaciones.
La ventana Agents incorpora un modo Inbox (experimental) que coloca en primer lugar las sesiones que esperan una intervención, y un chat puede tener su propia ventana (versión preliminar). Compare Models admite Copilot Fusion y sus niveles de esfuerzo. En cuanto a seguridad, los diálogos de permisos ofrecen autorizaciones específicas (un dominio, un comando, un directorio), y el sandbox puede ocultar variables de entorno, cuyo valor real solo se inyecta en las solicitudes HTTPS dirigidas a los hosts autorizados. VS Code también admite las skills proporcionadas por servidores MCP (SEP-2640, versión preliminar) y las sesiones de Copilot siguen la configuración de proxy PAC y Kerberos.
🔗 Notas de la versión de VS Code 1.146
Qwen Code 1.0 Preview reúne los agentes de Qoder y Qwen Code en un binario nativo, sin Node.js
11 de noviembre — Unas horas después de Qwen4-Max, Qwen publica como versión preliminar Qwen Code 1.0 Preview, que reúne las capacidades de agente de Qoder, el entorno de código de Alibaba, y las de Qwen Code: comprender una base de código, implementar, depurar y probar. La conexión se realiza mediante una cuenta de Qwen o Qoder, a través de QwenCloud o Model Studio, o mediante cualquier endpoint compatible. La herramienta se distribuye en paquetes nativos para macOS, Linux y Windows, en x64 y arm64 (ocho archivos de entre 57 y 74 Mo aproximadamente), sin instalación separada de Node.js, y conserva la reanudación de sesiones y la ejecución no interactiva.
El repositorio advierte de que las interfaces y las opciones aún pueden cambiar, y deja de aceptar pull requests de la comunidad hasta después de diciembre de 2026. Según la API de GitHub, el tag 1.0 no comparte ningún historial con la v0.27.2 publicada el día anterior.
🔗 Qwen Code v1.0.0-preview (GitHub)
Modelos abiertos e investigación: BotPsy de Tether y el token pooling de Hugging Face
BotPsy-0.8B: Tether publica un pequeño modelo de agente abierto que casi duplica las puntuaciones de uso de herramientas de su modelo base
11 de noviembre — Tether AI Research, el equipo de IA de Tether que publica bajo el nombre QVAC, presenta BotPsy-0.8B, un modelo de 0,8 mil millones de parámetros especializado en llamadas a herramientas, pensado para ejecutarse en un teléfono o un portátil. Parte de Qwen3.5-0.8B y pasa por un ajuste supervisado, una destilación a partir de tres modelos maestros Qwen3.5-4B y dos rondas de aprendizaje por refuerzo. Los pesos están en Hugging Face, en safetensors y GGUF, bajo licencia Apache 2.0 según la ficha del modelo; la entrada menciona un uso para investigación y educación.
| Banco de evaluación (cifras del equipo) | BotPsy-0.8B | Qwen3.5-0.8B (base) | Qwen3.5-2B-Think |
|---|---|---|---|
| BFCL v4 | 44,0 | 23,4 | 37,7 |
| ACEBench | 58,7 | 30,1 | 55,4 |
| τ-bench | 51,5 | 23,2 | 46,5 |
| Media en seis bancos de evaluación de herramientas | 45,0 | 24,7 | 38,8 |
Todas estas cifras las ha medido el equipo en modo de razonamiento. También anuncia una reducción de las respuestas peligrosas del 36 % al 21 % en pruebas de ataque automatizadas, recomienda el inglés y desaconseja el modelo para decisiones sensibles.
🔗 BotPsy (QVAC en Hugging Face) · Modelo qvac/BotPsy-0.8B
Token pooling: Hugging Face conserva el 97,8 % de la calidad de búsqueda con cuatro veces menos vectores
11 de noviembre — Tom Aarsen detalla en el blog de Hugging Face cómo reducir el tamaño de los índices de búsqueda multivectoriales, de tipo ColBERT, que conservan un vector por token de documento. La agrupación de tokens (token pooling) fusiona los vectores cercanos, y Sentence Transformers añade una función de pérdida, MultiVectorTokenPoolingLoss, que entrena al modelo tanto con sus representaciones completas como con las comprimidas.
| Pooling durante la inferencia (NanoBEIR, nDCG@10) | Media de vectores | Entrenamiento clásico | Entrenamiento que tiene en cuenta el pooling |
|---|---|---|---|
| Sin pooling | 193,22 | 51,84 | 52,39 |
pool_factor=4 | 48,68 | 49,03 | 51,23 |
max_tokens=4 | 4,00 | 37,22 | 43,00 |
Con cuatro veces menos vectores, el modelo entrenado de este modo conserva el 97,8 % de su puntuación, frente al 94,6 % de un entrenamiento clásico. Las mediciones corresponden a una sola configuración (ModernBERT-base, una época), y se publican dos checkpoints en el Hub.
🔗 Entrenamiento que tiene en cuenta el token pooling (Hugging Face)
Seedance 2.5 pasa a 4K en Pika y Runway
11 de noviembre — Seedance 2.5, el modelo de vídeo de ByteDance distribuido por BytePlus, llega en 4K. Pika lo ofrece en 4K nativo en su plataforma y en su Pika API Club, con la propuesta de trabajar una toma como borrador y después finalizarla en 4K; desde el 17 de agosto, lo ofrecía en 1080p con un escalado (upscale) a 4K. Runway siguió sus pasos algo menos de dos horas después al anunciar Seedance 2.5 en 4K en su plataforma, sin precisar si se trata de 4K nativo. No se han indicado tarifas, duración máxima ni coste en créditos.
🔗 Anuncio de @pika_labs · Anuncio de @runwayml
Git corrige seis vulnerabilidades, incluida una ejecución de código durante una clonación recursiva
10 de noviembre — Fuera del ámbito de la IA, el proyecto Git publica Git 2.56.1, con backports hasta Git 2.50.2, para corregir seis vulnerabilidades que Elijah Newren detalla en el GitHub Blog.
| Vulnerabilidad corregida | Naturaleza del riesgo |
|---|---|
| CVE-2026-111760 | Ejecución de código durante una clonación recursiva, mediante el archivo .git de un submódulo |
| CVE-2026-113408 | Recorrido de rutas mediante el HEAD anunciado por un servidor |
| CVE-2026-114467 | Corrupción de la pila al retirar firmas GPG |
| CVE-2026-114469 | Lecturas fuera de los límites al aplicar parches binarios |
| CVE-2026-105437 | Corrupción del heap durante grandes fusiones |
| CVE-2026-114466 | Acceso al sistema de archivos mediante flujos git fast-import |
GitHub ya ha desplegado las correcciones en github.com y Enterprise Cloud, publica GitHub Enterprise Server 3.19.15, 3.20.11, 3.21.9 y 3.22.4, y prepara versiones de GitHub Desktop y de la app GitHub Copilot con un Git corregido. La indicación es actualizar Git y cualquier aplicación que incorpore una copia; en su defecto, clonar únicamente desde servidores de confianza.
🔗 Anuncio de vulnerabilidades de seguridad de Git (GitHub Blog)
Noticias breves
Agentes de código y herramientas de desarrollo
- Zed 1.28 y versión preliminar 1.29 — La 1.28 pasa a estable e incorpora la versión preliminar cubierta el 4 de noviembre (último Agent Client Protocol, lecturas de
read_filetruncadas a 2 000 caracteres, fetch automático de Git opcional). La versión preliminar 1.29 admite Claude Fable 5.2 y Claude Mythos 5.2 en el proveedor Anthropic. 🔗 fuente - Antigravity CLI 1.5.4 y 1.5.5 — La 1.5.5 incorpora /swarm en versión preliminar en el terminal, con la vista de pantalla completa /swarm board, y corrige la importación de comandos y hooks de plugins de Claude Code. La 1.5.4 habilita el modo Auto para las sesiones ACP y amplía los datos transmitidos a los hooks. 🔗 fuente
- Gemini CLI — No hay ninguna versión nueva al día siguiente de la v0.68.0, y la versión nocturna (nightly) ha vuelto a fallar, como cada noche desde el 5 de noviembre. Se han integrado cuatro correcciones en la rama principal, entre ellas la de un error 400 tras un turno vacío del modelo con una imagen o un archivo binario. 🔗 fuente
- Copilot CLI 1.0.110-1 — Versión preliminar limitada a 13 correcciones: una sesión reanudada ya no puede modificarse en paralelo, y un servidor MCP local que devuelve un carácter Unicode cortado ya no bloquea una llamada a una herramienta. El SDK 1.0.32-preview.1 permite elegir Copilot Fusion y su nivel. 🔗 fuente
- Gemini 4 Carbon en Genspark — Genspark habilita Gemini 4 Carbon en su AI Chat y su Code Agent, un día después de Claude Fable 5.2 en ese mismo Code Agent, sin precisar el plan ni el consumo de créditos. 🔗 fuente
- Basis y Devin for Startups — Cognition muestra en vídeo cómo trabaja Basis con Devin; los agentes contables de Basis reducen algunas tareas de 20 horas a 30 minutos, una cifra que corresponde a Basis y no a Devin. Cognition también relanza Devin for Startups, con 65 000 dólares en créditos para equipos seleccionados. 🔗 fuente
- shem — João Galego publica un runtime experimental que ejecuta un modelo de Hugging Face como una imagen de contenedor (un Dockerfile puede comenzar por
FROM hf.co/...) y, a la inversa, ejecuta contenedores en un procesador hecho de pesos de modelo; funciona «la mayor parte del tiempo», según él. 🔗 fuente
GitHub
- Licencias de Copilot gestionadas por GitHub Apps — Las GitHub Apps empresariales pueden llamar a las API de gestión de licencias de Copilot para asignarlas a usuarios y equipos de la empresa, gracias a un nuevo permiso granular, Enterprise Copilot license management. 🔗 fuente
- Dependabot y los repositorios inactivos — A partir del 8 de diciembre, GitHub desactiva las alertas de Dependabot en la mayoría de los repositorios sin actividad desde hace un año; las alertas se archivan, no se eliminan, y el primer push las restablece. GitHub Enterprise Server no se ve afectado. 🔗 fuente
- Tipos y campos de issues para cuentas personales — Hasta ahora reservados a las organizaciones, llegan a disponibilidad general en los repositorios personales: hasta 25 tipos y 25 campos, utilizables en proyectos, mediante las API REST y GraphQL y mediante webhooks. 🔗 fuente
- Panel de GitHub — Más compacto, muestra seis pull requests y seis issues en lugar de tres, permite fijar la pestaña Feed o Home y oculta la sección de sesiones de agentes cuando la cuenta no tiene ninguna. 🔗 fuente
Empresas y usos
- Singapore Airlines — Reescrito sobre la API de OpenAI, su chatbot Kris duplica su puntuación de satisfacción del cliente, el resumen de llamadas reduce aproximadamente un 10 % el tiempo de gestión de los asesores, y más del 60 % de los empleados utilizan cada mes la plataforma interna Jarvis. 🔗 fuente
- Cogent Security — La startup construye agentes de ciberdefensa sobre GPT-6.1 Sol, GPT-6 Astra y GPT-5.6, sujetos a políticas verificadas antes de cada llamada a una herramienta; según la empresa, un cliente del sector automovilístico del Fortune 1000 ha reducido un 75 % el tiempo medio de corrección de sus vulnerabilidades críticas. 🔗 fuente
- JioStar — Su asistente de voz para descubrir contenidos en JioHotstar, construido sobre la API de OpenAI en unas ocho semanas, habla más de 15 idiomas en una plataforma con más de 500 millones de usuarios; según JioStar, más del 60 % de sus usuarios le hablan en lugar de escribirle. 🔗 fuente
- ChatGPT Plus para veteranos — Con motivo del Veterans Day, OpenAI indica que más de 20 000 veteranos y militares en transición a la vida civil han solicitado en un año el año gratuito de ChatGPT Plus, y que cerca de 1 000 miembros de la comunidad militar han recibido formación. 🔗 fuente
- Plugin de fal en ChatGPT — fal destaca su plugin, que genera y retoca imágenes y vídeos en la conversación, con un anuncio de 60 segundos realizado con GPT Image 2.6, FLUX 3 Max (26 planos) y fal Recast; no se precisa su fecha de publicación. 🔗 fuente
- Gopuff en Grok Bot — Grok Bot ya realiza pedidos de alimentos, aperitivos y productos de uso diario en Gopuff, de principio a fin, con entregas en tan solo 15 minutos según Gopuff; no se precisan los países ni los planes. 🔗 fuente
- Genspark Genius — Genspark busca embajadores: una creación compartida al mes, a cambio del plan Pro, acceso anticipado a nuevas funciones, créditos y promoción en sus canales. 🔗 fuente
Modelos, medios e investigación
- MiniMax H3 — Cien días después de abrir sus pesos, MiniMax afirma contar con 1 472 modelos derivados y más de 148 millones de descargas en Hugging Face, cifras sin verificar; H3-Image llega a fal, Runware, EvoLink y Miora, gratis en este último hasta el 17 de noviembre. 🔗 fuente
- Voxtral Transcribe 3 en AI Engineer Paris — Mistral transcribió en directo todas las conferencias del escenario principal, proporcionando al modelo los nombres de los ponentes y los términos del programa (sesgo de contexto), sin cifras sobre la mejora obtenida. 🔗 fuente
- Voz local en Google AI Edge Gallery — La aplicación incorpora reconocimiento y síntesis de voz sin conexión: en Android, ML Kit transcribe más de 100 idiomas diez veces más rápido que en tiempo real, y modelos abiertos como Parakeet-TDT 0.6B o Kokoro-82M cubren las demás plataformas. 🔗 fuente
- Déjà View de NVIDIA — Este modelo de reconstrucción 3D de 117M parámetros aplica varias veces un mismo bloque transformer e iguala a modelos hasta 10 veces más grandes en cinco bancos de pruebas; presentado en una sesión oral en NeurIPS 2026, el artículo está en arXiv desde mayo. 🔗 fuente
- Enfermedades en textos médicos en español — OpenMed publica dos modelos abiertos bajo Apache-2.0, utilizables en CPU; según el equipo, el ajuste con DisTEMIST eleva el F1 de alrededor de 36 a 39 para un modelo genérico a alrededor de 73 para la versión GLiNER2.5. 🔗 fuente
- Pagos de agentes x402 — Por sí solos, Qwen3 235B, DeepSeek V4 Pro y Llama 3.3 70B obtienen 59, 55 y 30 puntos en el examen de Fizzl, sin que ninguno apruebe; cuando el código decide el pago (x402-safe-fetch), pasan a 94, 100 y 94. 🔗 fuente
- GR00T-X-Embodiment-Sim en FiftyOne — Harpreet Sahota (Voxel51) convierte 42 episodios simulados del conjunto de datos de NVIDIA, seis para cada uno de siete cuerpos de robots, con cámaras y telemetría de las articulaciones alineadas. 🔗 fuente
Ecosistema
- Sakana AI — El almirante retirado Michael Rogers, exdirector de la NSA, y Tom Moran, con cerca de 30 años en la CIA, se convierten en asesores sénior de la startup de Tokio para defensa y ciberseguridad. 🔗 fuente
- Reciclaje en NVIDIA — Con motivo de la COP31, NVIDIA presenta cuatro startups de su programa Inception que clasifican residuos mediante visión por ordenador, entre ellas Greyparrot, que reduce de 375 a 6 horas la inspección de 15 toneladas de residuos; ningún producto nuevo de NVIDIA. 🔗 fuente
- Guía de Perplexity sobre el cumplimiento normativo de la IA — Repasa el AI Act europeo, el NIST AI RMF y la ISO/IEC 42001, y propone tres controles para los agentes: acceso a lo estrictamente necesario, registro de cada acción y validación humana de las acciones de gran impacto. 🔗 fuente
- Guía de Perplexity sobre la arquitectura MCP — Funciones del host, del cliente y del servidor, mensajes JSON-RPC 2.0, transportes locales y Streamable HTTP, configuración multiinquilino: una presentación técnica que sigue a la guía de seguridad del 4 de noviembre, sin anuncio de producto. 🔗 fuente
- Hackathon de Cohere en Toronto — Cohere organiza el 30 de enero de 2027 su primer hackathon con la Universidad de Toronto, Hacking Higher Ed, sobre la IA en la educación superior; premios de 3 000, 2 000 y 1 000 dólares, solicitudes hasta el 22 de enero. 🔗 fuente
Qué significa
Google DeepMind aplica sus modelos a dos problemas en los que la verificación importa más que la generación. AlphaGenome 2 ya no se limita a una media por tejido: predice el efecto de una variante en la célula que interesa al investigador, y sus mejoras se miden en TenK10K, un mapa de 28 tipos de células inmunitarias. AlphaProof Code traslada la verificación formal del diseño del protocolo al código compilado, con un reparto explícito del trabajo: los agentes escriben más de seis millones de líneas de demostración, el verificador Lean comprueba cada paso, y los humanos revisan las especificaciones y aproximadamente el 1 % del código. Ambos anuncios mantienen sus límites: AlphaGenome 2 sigue reservado a la investigación, y la primacía reivindicada en el caso de Signal es la que afirma Google DeepMind.
La seguridad tropieza con sus propios instrumentos de medida. OpenAI constata que la cadena de razonamiento, uno de los pilares de su supervisión, resulta más difícil de leer a medida que avanza el preentrenamiento, y considera que la controlabilidad, uno de sus dos indicadores, es ruidosa. Perplexity muestra que el formato clásico de captura de la bandera desvía a los agentes del límite que se quiere poner a prueba, y que un modelo especializado en ciberseguridad puede rendir peor que su versión generalista, en tres pruebas y con una configuración anterior a la corrección. En ambos casos, la conclusión atañe tanto a la forma de evaluar como a los propios modelos.
La jornada distingue claramente lo que se entrega de lo que se anuncia. Runway publica Praxis-1 con sus pesos, su código de ajuste y un informe que sitúa el modelo por debajo de cuatro propuestas competidoras, y Tether pone BotPsy a disposición para su descarga. En cambio, Qwen4-Max llega sin benchmark, tamaño ni precio, y la propia ElevenLabs distingue lo que está abierto hoy (Marketplace, Partner Program, ElevenAI) de lo que llegará más adelante (Interaction Engine, Memory, Routines, ajuste). Para quien quiera probarlo, la segunda mitad sigue siendo una promesa.
Los agentes se afianzan en el trabajo continuado y en los equipos. Grok Bot 1.0 se une a las reuniones y se coordina con otros Bots en Slack y Teams; los Cloud Runners de Delta ejecutan un hilo de agente sin el ordenador de su autor; VS Code añade una bandeja de entrada para las sesiones que esperan una decisión; A2UI permite a los agentes responder con una pantalla en lugar de texto. Cada uno también delimita el riesgo que introduce: permisos por persona y comprobación antes de hablar en un canal público en Grok Bot, versión preliminar privada en Delta, permisos específicos y variables ocultas en el sandbox de VS Code.
Fuentes
- AlphaGenome 2 (Google DeepMind)
- AlphaGenome 2 (@GoogleDeepMind)
- Presentación de AlphaProof Code (Google DeepMind)
- Verificación formal de Signal (PDF, Google DeepMind)
- Qwen4-Max en versión preliminar (@Alibaba_Qwen)
- Token Plan (QwenCloud)
- Praxis-1 ya está disponible (Runway)
- Informe técnico de Praxis-1 (Runway)
- Colección Praxis-1 (Hugging Face)
- ElevenLabs Summit NYC (ElevenLabs)
- Anuncios del Summit (@ElevenLabs)
- ElevenLabs y NVIDIA (ElevenLabs)
- Restablecimiento completo de los límites (@ClaudeDevs)
- Grok Bot 1.0 (SpaceXSI)
- Grok Bot 1.0 (@SpaceXSI)
- Retirada de las voces Advanced y Standard en ChatGPT (ayuda de OpenAI)
- Retirada de las voces Advanced y Standard (@OpenAINewsroom)
- Gemini en Apple CarPlay (blog.google)
- Capacidad de supervisión de CoT a lo largo del ciclo de vida del modelo (OpenAI)
- Hilo de Jeffrey G. Wang
- Escapar de SPACE: parte II (Perplexity)
- Escapar de SPACE: parte II (@perplexity_ai)
- Gemini Decision 1 (Google AI Studio)
- Decisions API (Google AI Studio)
- A2UI 1.0 (Google Developers Blog)
- Cloud Runners ya está disponible en Delta
- Documentación de Cloud Runners (Delta)
- Notas de la versión de VS Code 1.146
- Qwen Code v1.0.0-preview (GitHub)
- BotPsy (QVAC en Hugging Face)
- Modelo qvac/BotPsy-0.8B (Hugging Face)
- Entrenamiento que tiene en cuenta el agrupamiento de tokens (Hugging Face)
- Seedance 2.5 en 4K (@pika_labs)
- Seedance 2.5 en 4K (@runwayml)
- Anuncio de vulnerabilidades de seguridad de Git (GitHub Blog)
- Zed v1.28.1 (GitHub)
- Changelog de Antigravity
- Gemini CLI, PR 30228 (GitHub)
- Copilot CLI v1.0.110-1 (GitHub)
- Gemini 4 Carbon en Genspark (@genspark_ai)
- Basis y Devin for Startups (@cognition)
- Tu LLM ahora es un contenedor (Hugging Face)
- Gestión de licencias de Copilot mediante GitHub Apps (GitHub Changelog)
- Las alertas de Dependabot se pausarán en los repositorios inactivos (GitHub Changelog)
- Tipos y campos de issues para cuentas personales (GitHub Changelog)
- Un panel de GitHub más informativo (GitHub Changelog)
- Singapore Airlines (OpenAI)
- Cogent Security (OpenAI)
- JioStar, Vijay Seshadri (OpenAI)
- ChatGPT Plus para veteranos (OpenAI)
- Plugin de fal en ChatGPT (@fal)
- Gopuff en Grok Bot (@bot)
- Genspark Genius (@genspark_ai)
- MiniMax H3, 100 días (@RyanLeeMiniMax)
- Voxtral Transcribe 3 en AI Engineer Paris (@MistralAI)
- Voz local en Google AI Edge Gallery (Google Developers Blog)
- Déjà View (@NVIDIAAI)
- Detección de enfermedades en textos clínicos en español (OpenMed)
- Modelos abiertos de IA con una cartera (Fizzl)
- GR00T-X-Embodiment-Sim en FiftyOne (Hugging Face)
- Michael Rogers y Tom Moran (Sakana AI)
- Startups de reciclaje con IA (blog de NVIDIA)
- Cumplimiento normativo de la IA (Perplexity)
- Arquitectura MCP (Perplexity)
- Hacking Higher Ed (@cohere)