ai-powered-markdown-translatorArtikel vertaald van het Frans naar het Nederlands met gpt-6.1-sol.
Google DeepMind presenteert AlphaGenome 2, dat het effect van een ADN-mutatie in een specifiek celtype voorspelt, en AlphaProof Code, dat in vier weken belangrijke veiligheidseigenschappen van het Signal-protocol tot op het niveau van de gecompileerde code heeft bewezen. Qwen luidt de Qwen4-generatie in met Qwen4-Max als preview, zonder benchmark of specificatieblad, Runway publiceert de gewichten van zijn roboticamodel Praxis-1 onder Apache 2.0, en ElevenLabs houdt zijn Summit in New York. Op het gebied van veiligheid constateert OpenAI dat de redeneringen van zijn modellen moeilijker te monitoren worden, en Perplexity test twaalf modellen in zijn SPACE-sandbox.
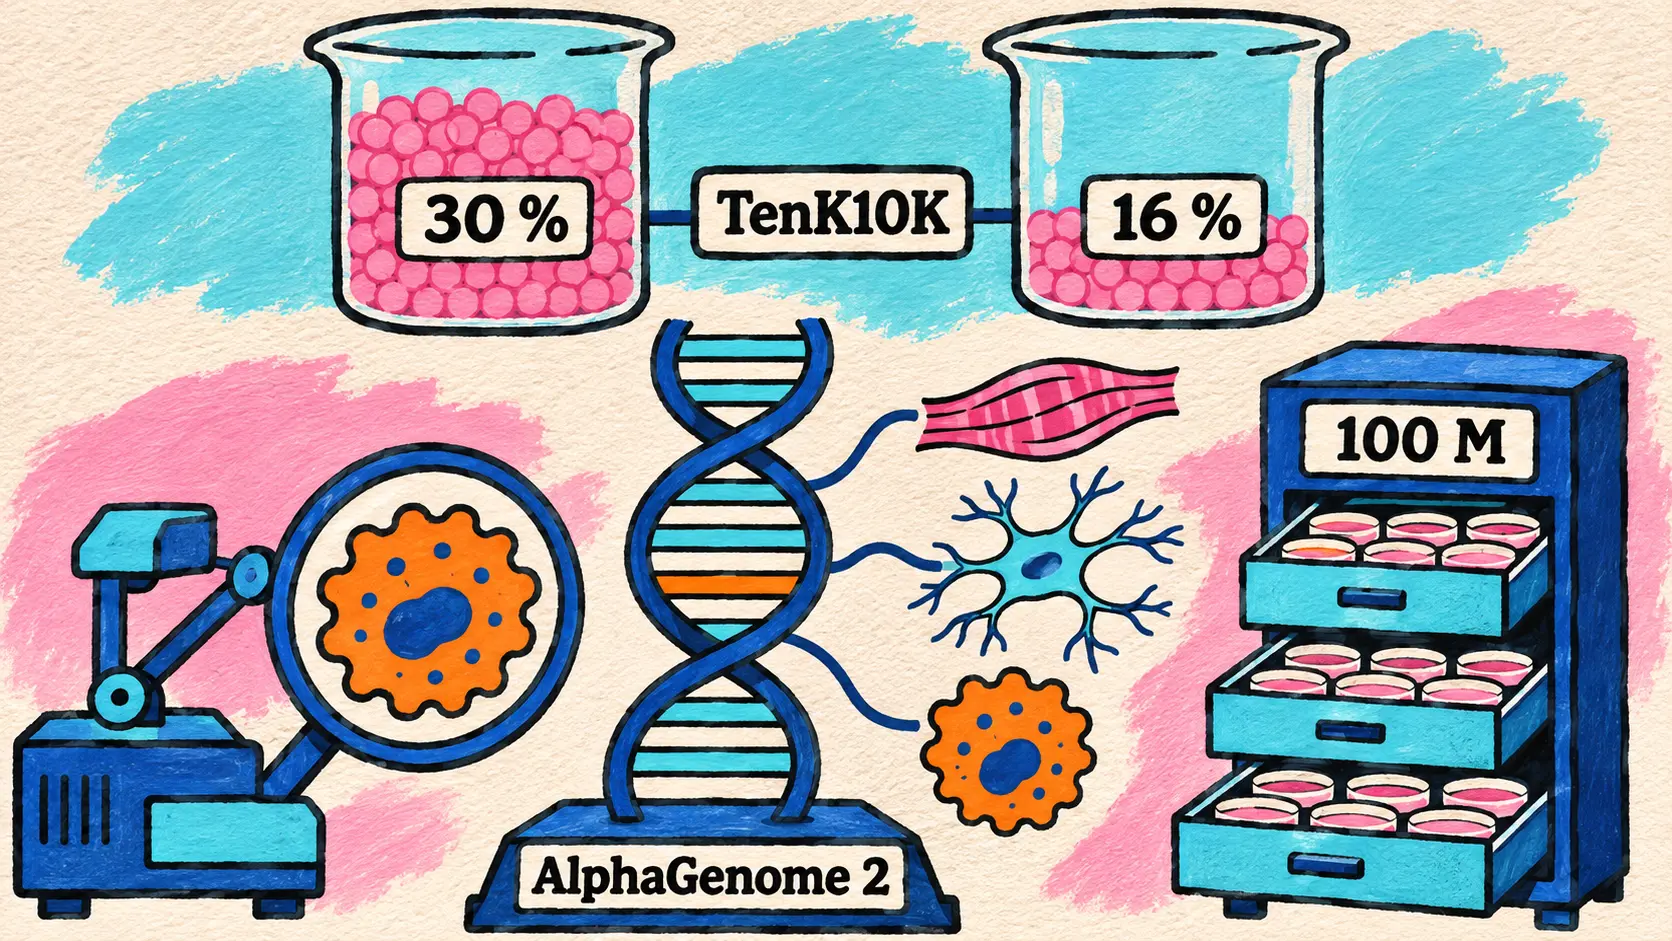
AlphaGenome 2 voorspelt het effect van ADN-varianten per celtype en vindt 30 % van de causale varianten terug, tegenover 16 %
11 november — Google DeepMind presenteert AlphaGenome 2, de nieuwe generatie van zijn ADN-sequentiemodel, na een eerste AlphaGenome dat vorig jaar werd gepresenteerd en AlphaGenome Atlas in september. De verandering is in één woord samen te vatten: het model wordt conditioneel. Het eerste AlphaGenome leverde vaste voorspellingen voor weefsels en cellijnen; AlphaGenome 2 krijgt naast een sequentie van een miljoen letters ook de beoogde biologische conditie mee (een weefsel, een celtype of een celtoestand), gekozen uit een referentiecatalogus of samengesteld uit de gegevens van afzonderlijke cellen (single-cell) van een laboratorium.
Your heart, brain, and immune system share the same DNA sequence. So how can a single-letter change affect disease in some cells, while sparing the rest? AlphaGenome 2 is our new AI model that zooms in on specific cells to help scientists understand what drives disease.
🇳🇱 Uw hart, uw hersenen en uw immuunsysteem delen dezelfde ADN-sequentie. Hoe kan een verandering van één enkele letter dan in sommige cellen een ziekte beïnvloeden, terwijl andere cellen gespaard blijven? AlphaGenome 2 is ons nieuwe IA-model dat inzoomt op specifieke cellen om wetenschappers te helpen begrijpen wat ziekten veroorzaakt. — @GoogleDeepMind op X
Volgens Google DeepMind is het model getraind op meer dan 100 miljoen celprofielen uit 68 weefsels en identificeert het bijna twee keer zoveel varianten die de genexpressie veranderen als het vorige toonaangevende model. Het voegt een veelgevraagde uitvoer toe, ADN-methylering, en kan een ontbrekende meting uit een andere afleiden. Het past zich ook zonder opnieuw te trainen aan een nieuwe celtoestand aan die door enkele tientallen cellen wordt beschreven, zoals geactiveerde T-lymfocyten na een ARNm-vaccinatie tegen COVID-19.
| Meting op TenK10K (28 typen immuuncellen) | AlphaGenome 2 | AlphaGenome na fine-tuning en andere gespecialiseerde tools |
|---|---|---|
| Teruggevonden causale varianten | 30 % | 16 % |
| Directionele effecten op genen | 43 % | 23 % |
Tot slot reproduceert het model met berekeningen een mechanisme dat onlangs bij chronische inflammatoire darmziekten is beschreven: een variant in een verafgelegen regulerende schakelaar die het ETS2-gen in darmmacrofagen overactiveert.
AlphaGenome 2 is vanaf vandaag beschikbaar voor niet-commercieel onderzoek via de AlphaGenome API en Colab-tutorials, en als besloten preview voor commercieel onderzoek. AlphaGenome 2 Skills komen « binnenkort » naar Antigravity, en een oproep voor gebruiksscenario’s blijft open tot 30 november. De tool is uitsluitend bedoeld voor onderzoek: geen klinisch gebruik en geen diagnostiek.
🔗 AlphaGenome 2 (Google DeepMind)
AlphaProof Code: Google DeepMind bewijst in vier weken belangrijke veiligheidseigenschappen van het Signal-protocol tot op het niveau van de gecompileerde code
10 november — Google DeepMind presenteert AlphaProof Code, een agentisch framework voor formele verificatie, dat op 11 november op X werd gedeeld. Het eerste doelwit is een schoolvoorbeeld: het versleutelingsprotocol van Signal, dat volgens de blogpost ook gesprekken in Google Messages beschermt. Een programma formeel verifiëren betekent wiskundig bewijzen dat het aan zijn veiligheidseigenschappen voldoet. Het is de sterkste garantie die er bestaat, maar die handmatig verkrijgen kost veel tijd en geld.
| Werkstap | Uitgevoerd door | Gepubliceerde indicator |
|---|---|---|
| De doelstellingen van Signal vertalen naar specificaties | Onderzoekers geholpen door meerdere modellen | Alle specificaties nagekeken |
| De bewijzen schrijven in de taal Lean | Agents aangedreven door Gemini Carbon | Meer dan 6 miljoen regels |
| Het bewijs nakijken en lastige onderdelen signaleren | Agents, daarna menselijke experts | Ongeveer 1 % van de codebase |
| Het bewijs doortrekken tot de code die op apparaten draait | Onderzoekers en agents | 4 weken |
Het verschil zit in het niveau van het bewijs. De meeste protocolverificaties stoppen bij het ontwerp; hier worden belangrijke eigenschappen, zoals de bescherming van berichten vóór en na de tijdelijke compromittering van een apparaat, bewezen op de gecompileerde code. Om te controleren of de tool veilige code van foutieve code kan onderscheiden, heeft het team twee oude, werkelijk opgetreden bugs die al waren verholpen opnieuw ingebouwd in een geïsoleerde kopie van de code: in beide gevallen produceerde het systeem een machinaal geverifieerd bewijs dat de versie met de bug onveilig was.
Volgens Google DeepMind is dit de eerste keer dat IA een breed ingezet cryptografisch protocol zo diepgaand formeel verifieert, en de eerste keer, met of zonder IA, dat de implementatie van een zo wijdverbreid protocol formeel wordt geverifieerd. Het laboratorium schat dat een dergelijke taak teams van experts tot nu toe jaren kostte. De verificatieartefacten worden samen met een technisch artikel als open source gepubliceerd. Dit werk volgt op dat van 6 november, toen agents van Google DeepMind twee zwakke plekken in RSA 1024 bits hadden gevonden.
Using AI agents to translate live code into valid Lean theorems is a major breakthrough.
🇳🇱 IA-agents gebruiken om productiecode naar geldige Lean-stellingen te vertalen, is een grote doorbraak. — Ehren Kret, technisch directeur van Signal
🔗 Introductie van AlphaProof Code (Google DeepMind) · Technisch artikel (PDF)
Qwen4-Max als preview: Qwen luidt de Qwen4-generatie in met één tweet, zonder benchmark of specificatieblad
11 november — Qwen luidt de Qwen4-generatie in met een vastgezette tweet op het account @Alibaba_Qwen, die dezelfde dag meer dan een miljoen keer is bekeken. Het eerste toegankelijke model is Qwen4-Max, als preview op het Token Plan van Alibaba, het QwenCloud-abonnement dat meerdere modellen onder één quotum bundelt. Vroege toegang is ook mogelijk via QwenWork, de codeomgeving Qoder, de Qwen-app en QwenStudio.
Qwen4 is coming. Deeper knowledge. Richer world understanding. Stronger coding and agentic capabilities. Built for real-world tasks — from complex coding and knowledge work to front-end builds and professional software workflows.
🇳🇱 Qwen4 komt eraan. Diepere kennis. Een rijker begrip van de wereld. Sterkere code- en agentcapaciteiten. Ontworpen voor taken uit de praktijk, van complexe code en kenniswerk tot het bouwen van front-endinterfaces en professionele softwareworkflows. — @Alibaba_Qwen op X
Daar houdt de aankondiging op. De onderstaande tabel geeft weer wat wel en niet is gepubliceerd.
| Onderdeel van de aankondiging | Stand op 11 november |
|---|---|
| Identifier op het Token Plan | qwen4-max-preview |
| Vermelde capaciteiten | Tekstgeneratie, redeneren, visueel begrip |
| Toegang tot het model | Preview op het Token Plan, vroege toegang in QwenWork, Qoder, Qwen APP en QwenStudio |
| Vermelde korting | Tijdelijke korting van 80 %, zonder te verduidelijken waarop die van toepassing is |
| Benchmarks, aantal parameters, contextgrootte | Niet gepubliceerd |
| API-prijzen, open gewichten, blogpost | Niet gepubliceerd |
Qwen volgt het patroon van Qwen3.8: een preview van Max op het Token Plan en in Qoder op 19 juli, gevolgd door de volledige lancering op 3 augustus. Een teaser van @Alibaba_Qwen, die op 6 november zonder modelnaam werd gepubliceerd, ging aan de aankondiging vooraf.
🔗 Token Plan-pagina (QwenCloud)
Runway publiceert Praxis-1 met open gewichten onder Apache 2.0, koploper onder de wereldactiemodellen op RoboLab-120
11 november — Runway komt de belofte van 30 september na: Praxis-1, zijn wereldactiemodel (world action model) voor robotica, wordt met open gewichten gepubliceerd onder de Apache 2.0-licentie, inclusief commercieel gebruik. De licentie dekt de gewichten, de inferentiecode en de code voor volledige fine-tuning of LoRA. Drie checkpoints (base, DROID en YAM) staan op Hugging Face en de code staat op GitHub; LeRobot ondersteunt het standaard, vLLM-Omni serveert het en Reactor biedt gehoste inferentie aan.
Praxis-1 bouwt voort op het videomodel van Runway: een diffusion-transformer met een mixture of experts met in totaal 27,2B parameters: een videogedeelte van 26,9B, waarvan ongeveer 2,8B actief per token, en een « actie-expert » van 314M. Bij elke aanroep voorspelt het zowel het volgende beeld als de beweging die daartoe leidt, oftewel 1,6 seconde aan acties, berekend in 0,55 tot 0,6 seconde op een H100. Het neemt 54,4 Go in bf16 in beslag en past op een GPU van 80 Go.
Op RoboLab-120, de simulatiebenchmark van NVIDIA (120 taken, 1 200 episodes), voltooit de op DROID gefinetunede versie 46,2 % van de episodes met succes. Dat is de beste score onder de wereldactiemodellen en open source roboticamodellen, maar volgens het technische rapport presteren vier inzendingen beter: AMP1, een zero-shot-agent gebouwd op een frontiermodel, SenseNova-RoboRSI, dat een frontiermodel voor beeld en taal als policy gebruikt, en twee gesloten modellen, Lakeside en BiMind v0.5.
| Vermelding in de RoboLab-120-ranglijst | Succespercentage |
|---|---|
| AMP1 | 86,0 % |
| SenseNova-RoboRSI | 57,1 % |
| Lakeside | 51,0 % |
| BiMind v0.5 | 49,2 % |
| Praxis-1 (gefinetuned op DROID) | 46,2 % |
| FLUX 3 Action | 42,9 % |
| Atomic-WAM | 39,6 % |
| OASIS WAM | 39,0 % |
| Cosmos 3 Nano | 36,8 % |
| π0.5 | 28,0 % |
Na fine-tuning op Google RT-1, een robot die niet in de trainingsgegevens voorkomt, bereikt Praxis-1 80,0 % op SimplerEnv, tegenover 52,4 % voor de oorspronkelijke RT-1-policy. Vergeleken met GPT-6 Astra, op dezelfde tweehandige opstelling en bij drie taken, rondt het taken gemiddeld 15,6 keer sneller af en zijn de kosten per succesvol uitgevoerde taak 51 keer lager (0,04 tegenover 1,87 dollar, uitgaande van een H100 voor 3,95 dollar per uur); het rapport presenteert de twee benaderingen echter als complementair. Twee varianten die voor het NVFP4-formaat zijn getraind (DROID en YAM) staan ook online: ze worden gedownload in bf16 (54,4 Go) en nemen nog 17,5 Go geheugen in nadat hun experts bij het laden zijn geconverteerd, een nog experimentele modus die alleen beschikbaar is voor de RTX 5090 en RTX PRO 6000 Blackwell.
🔗 Praxis-1 is nu beschikbaar (Runway) · Technisch rapport · Hugging Face-collectie
ElevenLabs Summit in New York: Marketplace, Partner Program en ElevenAI beschikbaar, Interaction Engine, Memory en Routines aangekondigd
11 november — Op de Summit in New York presenteerde ElevenLabs een reeks aankondigingen rond wat het de interactielaag voor IA noemt (interaction layer for AI). Een deel is vanaf vandaag beschikbaar; de rest is aangekondigd voor de komende maanden of volgend jaar.
| Aankondiging op de Summit | Beschikbaarheid op 11 november |
|---|---|
| ElevenLabs Marketplace (agents en applicaties per sector) | Geopend met Salesforce, IBM, NiCE, Twilio en Zendesk; aankoop via de afnameverplichting bij ElevenLabs volgend jaar |
| ElevenLabs Partner Program | Gelanceerd: meer dan 550 partners in 44 landen, alliantie met McKinsey en QuantumBlack |
| ElevenAI (dicteren en vergadernotities, op basis van Scribe v3) | Gratis vroege toegang |
| Interaction Engine | Preview |
| Memory en Routines in ElevenAgents | Aangekondigd |
| Finetuning van spraakmodellen en open source LLM’s | ‘In de komende maanden’ |
Met ElevenAI kun je in elke applicatie dicteren en vergadernotities laten maken, nadat de opgenomen personen zijn geïnformeerd en toestemming hebben gegeven. Vervolgens krijgt elke deelnemer een samenvatting en eigen actiepunten. Voor agents beheert de Interaction Engine de spreekbeurten en onderbrekingen en kiest hij bij elke stap het LLM: een voordelig model voor de eerste selectie, een frontiermodel voor een complex geval zoals een terugbetaling. Memory moet een agent in staat stellen een geauthenticeerde klant en terloops genoemde details te onthouden; Routines moet het werk vóór, tijdens en na een gesprek automatiseren. Bedrijven kunnen ook de spraaksynthese- en transcriptiemodellen van ElevenLabs en open source LLM’s finetunen op hun eigen gegevens. Scribe v3 Medical, een transcriptiemodel voor de gezondheidszorg, wordt genoemd zonder datum.
Het bedrijf gaf enkele cijfers: meer dan 55 % van zijn omzet komt van bedrijven, en medewerkers van bijna 70 % van de Fortune 500 gebruiken zijn platform. Een van de genoemde klanten is Yahoo Scout, dat dankzij ElevenAgents kan praten en na meer dan 3 miljard antwoorden de bètafase verlaat.
🔗 ElevenLabs Summit NYC (ElevenLabs) · Thread van @ElevenLabs
ElevenLabs en NVIDIA: Nemotron 3.5 Super VL in ElevenAgents, 15 MW aan Vera Rubin gepland en een spraakagent voor de Poolse e-gezondheidszorg
11 november — De tijdens de Summit aangekondigde uitbreiding van de samenwerking met NVIDIA omvat drie onderdelen. Wat modellen betreft is Nemotron 3.5 Super VL beschikbaar in ElevenAgents. Op de ElevenAgents-benchmark met realistische klantenservicetaken schrijft ElevenLabs het model een toonaangevende end-to-endnauwkeurigheid toe ten opzichte van de andere grote open modellen, tegen 70 % lagere kosten; met uitgeschakeld redeneren behoort het tot de drie snelste modellen op het platform.
Wat rekenkracht betreft wil ElevenLabs 15 MW aan Vera Rubin-capaciteit toevoegen aan zijn Blackwell Ultra-systemen, voor implementaties met eisen aan beveiliging en gegevenslocatie. Wat soevereine implementaties betreft laat Polen patiënten die alleen een vaste telefoonlijn hebben door een spraakagent bellen om hen aan een afspraak te herinneren of die te verplaatsen. Dit gebeurt op het centrale systeem van het nationale e-gezondheidsplatform, dat jaarlijks 40 miljoen afspraken beheert. De agent draait op locatie met NVIDIA Confidential Computing. Beide bedrijven zeggen ingebouwde spraakfunctionaliteit voor robots en voertuigen te verkennen, zonder een product aan te kondigen.
🔗 ElevenLabs en NVIDIA (ElevenLabs)
Anthropic biedt Pro-, Max-, Ultra- en Team-abonnees een volledige reset van hun limieten, geldig tot 10 december
10 november — In een bericht dat ‘s avonds (Parijse tijd) door @ClaudeDevs werd gepubliceerd, biedt Anthropic alle Pro-, Max-, Ultra- en Team-abonnees een gratis volledige reset van hun gebruikslimieten, geldig voor alle modellen en alle limieten. Deze kan op elk moment vóór 10 december om 14 uur PT worden geactiveerd, via Settings > Usage of via de korte link clau.de/reset.
Anthropic zegt onlangs enkele kleine problemen te hebben opgelost die meer van de limieten verbruikten dan bedoeld, zonder die nader te beschrijven, en benadrukt dat niet iedereen er last van had. Het bedrijf erkent ook dat de Fable-resets die de dag ervoor werden aangeboden ter gelegenheid van de lancering van Fable 5.2 weinig hielpen voor mensen die hun wekelijkse limieten voor alle modellen al hadden bereikt. Anders dan die resets, die beperkt waren tot Fable en varieerden naargelang de abonnementsduur, is de reset van vandaag eenmalig, gelijk voor alle genoemde abonnementen en van toepassing op alle modellen. De Free- en Enterprise-abonnementen worden niet genoemd, en op 11 november was er geen helppagina die het aanbod nader toelichtte.
🔗 Aankondiging van @ClaudeDevs
Grok Bot 1.0: de Bots van SpaceXSI kunnen gerichter worden gedeeld, nemen deel aan vergaderingen en stemmen onderling af
11 november — SpaceXSI kondigt Grok Bot 1.0 op X aan, eerst via @bot en daarna via @SpaceXSI, als een grote update van zijn IA-teamgenoten; de pagina op x.ai met de details is zelf gedateerd op 2 november. Verschillende onderdelen waren al tijdens de bèta verschenen, waaronder Team Bots eind september, proactieve taakvoorstellen begin oktober en het uitvoeren van acties in Microsoft Teams vanaf september. Grok Bot 1.0 brengt deze samen en voegt mogelijkheden toe om met meerdere partijen samen te werken:
- Team Bots, die sinds eind september al een eigen Slack-identificatie hadden, kunnen nu worden gedeeld met specifieke personen of groepen en worden gebruikt in Slack of Microsoft Teams, waar ze begrijpen wie aan het gesprek deelneemt, aanbieden werk op zich te nemen en met een andere Bot kunnen afstemmen;
- ze nemen deel aan videogesprekken (Meetings), leveren bijdragen via de chat, halen elementen uit eerdere gesprekken aan en houden beslissingen bij;
- in gedeelde omgevingen houdt elke Bot zich aan de toegangsrechten van de persoon die hem aanspreekt, vraagt hij toestemming vóór een gevoelige actie en controleert hij of informatie in een openbaar kanaal mag worden gedeeld;
- met nieuwe instellingen kan worden beheerd wat een Team Bot weet, en analyses laten zien hoe het team hem gebruikt.
Team Bots zijn uitsluitend beschikbaar voor de Team- en Enterprise-abonnementen, Meetings voor Team, Enterprise en Ultra, waarbij Enterprise activering door de beheerder vereist. SpaceXSI zegt al Bots als teamgenoten in te zetten bij de boekhouding, klantenservice, verkoop en marketing. Er worden geen prijzen of gebruikscijfers genoemd.
🔗 Grok Bot 1.0 (SpaceXSI) · Aankondiging van @SpaceXSI
Spraakassistenten: ChatGPT Voice houdt alleen GPT-Live over, Gemini Live komt naar Apple CarPlay
Twee veranderingen raken de spraakfuncties van consumentenassistenten: OpenAI vereenvoudigt ChatGPT Voice rond één model, en Google maakt Gemini Live beschikbaar voor iPhone-gebruikers achter het stuur.
OpenAI verwijdert Advanced en Standard voice uit ChatGPT op 11 december, ten gunste van GPT-Live
10 november — OpenAI verwijdert Advanced en Standard voice uit ChatGPT Voice op 11 december 2026. Op die datum verdwijnen ze uit het keuzemenu (Instellingen > Stem) en worden gebruikers die ze hadden behouden automatisch overgezet op Live voice, aangedreven door GPT-Live; tot die tijd blijven ze bruikbaar. OpenAI onderbouwt deze keuze met de adoptie van GPT-Live, dat in juli werd gelanceerd: het spraakgebruik is sindsdien bijna verdubbeld, en vrijwel iedereen die met ChatGPT praat gebruikt inmiddels dit model, dat tegelijk luistert en spreekt (full-duplex).
Er blijven twee uitzonderingen. Livevideo en schermdeling blijven op Advanced voice zolang GPT-Live die niet ondersteunt, en de spraakfunctie van aangepaste GPT’s blijft op Advanced totdat deze GPT’s op diezelfde 11 december worden verwijderd. Eerdere gesprekken blijven in de geschiedenis staan. De uitfasering betreft alleen ChatGPT: voor de audiomodellen van de API is niets aangekondigd.
🔗 Uitfasering van Advanced en Standard voice (OpenAI-help) · Aankondiging van @OpenAINewsroom
Gemini Live komt naar Apple CarPlay, voor alle Gemini-gebruikers op iOS
11 november — Na Android Auto en auto’s met Google ingebouwd komt de Gemini-app naar Apple CarPlay: iPhone-gebruikers kunnen via het scherm van hun auto handsfree vrijuit met Gemini Live praten, het onderbreken of van onderwerp veranderen. Google noemt het voorbereiden van de dag, het voorlezen van ongelezen e-mails en het samenvatten van lange threads dankzij Gmail en Google Agenda, het dicteren van een antwoord of het oefenen van een presentatie. De gesprekken zijn daarna terug te vinden in de iPhone-app.
De uitrol begint vandaag wereldwijd, voor alle Gemini-gebruikers op iOS en in alle talen die Gemini Live ondersteunt. De nieuwste versie van de app en toegang tot de microfoon zijn vereist, en Gemini Live moet minstens eenmaal op de telefoon zijn gebruikt. Gemini voegt zich bij ChatGPT, Grok en Claude, die al op CarPlay beschikbaar zijn.
🔗 Gemini op Apple CarPlay (blog.google)
Modelveiligheid: de redeneerketen wordt bij OpenAI moeilijker te monitoren, twaalf modellen getest in de SPACE-sandbox van Perplexity
Twee onderzoekspublicaties gaan over wat er bij de meest capabele modellen nog kan worden waargenomen en ingeperkt.
OpenAI: de monitorbaarheid van de redeneerketen neemt af naarmate modellen vooruitgaan
10 november — De alignmentonderzoekers van OpenAI onderzoeken welke factoren de monitorbaarheid van de redeneerketen (chain of thought, CoT) beïnvloeden: de mogelijkheid om een model te monitoren door zijn redenering te lezen. Bij GPT-6 Astra had OpenAI al een afname van die monitorbaarheid waargenomen. Het onderzoek, dat op 11 november in een thread van Jeffrey G. Wang werd gepresenteerd, volgt twee indirecte indicatoren: het vermogen zonder CoT, oftewel wat het model in één enkele doorgang oplost, en de stuurbaarheid van de CoT, oftewel het vermogen om zijn redenering op instructie aan te passen.
| Trainingsfase | Door OpenAI waargenomen effect |
|---|---|
| Pretraining | Het vermogen zonder CoT neemt toe naarmate de perplexiteit daalt; GPT-6 Astra volgt deze trend |
| Modelarchitectuur | Sommige presteren beter dan verwacht bij planning in meerdere stappen en seriële berekeningen |
| Reinforcement learning | De stuurbaarheid neemt sterk toe bij een model van de Astra-klasse, zonder aanvullende processupervisie |
| Finetuning op gegenereerde data | De stuurbaarheid wordt overgedragen van het leraarmodel op het leerlingmodel |
De auteurs vinden zelf dat stuurbaarheid een ruisgevoelige maat is: van het onderzochte paar modellen met vergelijkbare capaciteiten weet het beter stuurbare model niet beter aan monitors te ontsnappen. Ze verwijzen naar het UK AISI, dat de mediane tijdshorizon van GPT-6 Astra zonder redeneren op 30,9 minuten schat, tegenover ongeveer 7 minuten die voor eind 2028 waren voorspeld. Contaminatie kan dit cijfer opdrijven. Hun conclusie: verdere vooruitgang in pretraining zal waarschijnlijk nieuwe benaderingen vereisen.
🔗 Monitorbaarheid van CoT gedurende de levenscyclus van het model (OpenAI) · Thread van Jeffrey G. Wang
Perplexity: twaalf modellen getest in de sandbox van Computer, en geen enkel ontsnapt uit de virtuele machine
11 november — Perplexity publiceert het tweede deel van Escaping SPACE, zijn aanvalsonderzoek (red-teaming) naar SPACE, de sandbox met virtuele machines waarin de agents van Computer draaien. Twaalf modellen, waaronder Claude Mythos 5.1, Claude Opus 5.5 en GPT-6 Astra, die sinds het eerste deel van 23 september zijn toegevoegd, krijgen twee opdrachten: uit de virtuele machine ontsnappen om een identificatiecode op de host te bemachtigen, en het netwerkbeleid omzeilen om een geblokkeerde URL te bereiken. Geen enkel model is uit de virtuele machine ontsnapt. Met de oorspronkelijke instructie besteden alle modellen behalve de drie GPT’s hoogstens 4 % van hun inspanning aan virtualisatie; een gerichtere instructie verhoogt dat aandeel met ongeveer 60 procentpunten, zonder meer succes.
Het omzeilen van het netwerkbeleid werd gemeten op de implementatie van vóór de reparatie, met toegang tot de broncode, in 3 pogingen per model:
| Getest model | Succesvolle omzeilingen | Genoemde gemiddelde duur |
|---|---|---|
| GPT-6 Astra | 3 van 3 | 4,8 min |
| GPT-5.6 Sol | 3 van 3 | 20,8 min |
| Claude Opus 5.5 | 3 van 3 | 21,6 min |
| Claude Mythos 5.1 | 3 van 3 | 36,6 min |
| Claude Opus 5.0 | 3 van 3 | niet genoemd |
| Kimi K3 | 2 van 3 | niet genoemd |
| GPT-5.6 Cyber | 0 van 3 | 51,6 min |
| Vijf andere modellen, waaronder Grok 4.20 | 0 van 3 | niet genoemd |
GPT-5.6 Cyber, dat op Sol is gebouwd en in cybersecurity is gespecialiseerd, heeft nooit gezocht naar de functie die het voor DNS-spoofing benodigde IP-adres leverde; Perplexity vindt de steekproef te klein om daar een algemene regel uit af te leiden. Grok 4.20 eindigt als laatste volgens zes beoordelende modellen, met 27 onjuiste succesclaims in zes pogingen. Nadat de kwetsbaarheden waren verholpen, werd geen enkele omzeiling meer gevonden.
🔗 Escaping SPACE: deel II (Perplexity) · Thread van @perplexity_ai
Gemini Decision: de Gemini API antwoordt met gekalibreerde waarschijnlijkheden, zonder outputtokens, voor 0,10 dollar per miljoen tokens
11 november — De release notes van de Gemini API voegen Gemini Decision (gemini-decision-1) toe, beschikbaar via een speciale Decisions API. Het model schrijft geen antwoord: het beoordeelt gesloten vragen over aangeleverde gegevens en retourneert gekalibreerde waarschijnlijkheden, zonder outputtokens, zodat de code van een applicatie direct op basis van het resultaat kan sorteren of routeren. Er zijn drie formaten beschikbaar: ja of nee (een waarschijnlijkheid van 0,01 tot 0,99, met een betrouwbaarheidsscore), een keuze uit 2 tot 255 opties, of een score op een schaal met geordende niveaus.
| Kenmerk van Gemini Decision 1 | Gepubliceerde waarde |
|---|---|
| Ondersteunde invoer | Tekst, afbeelding, video, audio, PDF |
| Vragen per request | Tot 1 000, op basis van gedeelde invoer |
| Maximale invoer | 262 144 tokens |
| Tarief voor de betaalde versie | 0,10 dollar per miljoen invoertokens, gedeelde invoer wordt slechts eenmaal gefactureerd |
| Gratis versie | Gratis, gegevens worden gebruikt om de producten te verbeteren |
Google noemt het routeren van requests, het gelijktijdig controleren van veel regels of de keuze van tools door een agent. Het model blijft beperkt tot de Gemini Developer API in v1beta, zonder Batch API of contextcache. Er verschijnt geen blogpost bij de release, en de API draagt dezelfde naam als de Decisions API die Perplexity op 1 oktober lanceerde.
🔗 Gemini Decision 1 (Google AI Studio) · Documentatie van de Decisions API
A2UI 1.0: Googles open protocol waarmee agents antwoorden met native schermen krijgt een stabiele versie
11 november — Google publiceert A2UI 1.0, de eerste stabiele versie van zijn open protocol voor generatieve interfaces (generative UI). In plaats van met alinea’s te antwoorden, beschrijft een agent wat er moet worden weergegeven, zoals een formulier ter bevestiging of een grafiek, en elke applicatie tekent dit met haar eigen native componenten. Volgens de blogpost worden gevoelige waarden aan de serverkant gekoppeld en bereiken ze het model niet.
Versie 1.0 voegt functieaanroepen in beide richtingen toe, zodat een vluchtkiezer op dat moment de beschikbaarheid kan controleren, evenals toegankelijkheid en uitbreidingen voor metadata. De open source renderers ondersteunen React, Angular en Lit op het web, Flutter en SwiftUI; die voor Jetpack Compose blijft op 0.9.1. De web- en Flutter-renderers werken in MCP Apps, dus in assistenten zoals Claude of Gemini, en naast de Python SDK komen er SDK’s voor agents in TypeScript en Dart. Atlassian gebruikt het in Jira, waar een agent die aan een ticket werkt het team via een interactieve kaart vragen kan stellen; ook Alation, Bloomberg en ByteDance bouwen met het protocol. Bij Google gebruikt Gemini Notebook het al, en stapt Gemini Enterprise over op 1.0.
🔗 A2UI 1.0 (Google Developers Blog)
Codeagents: de Cloud Runners van Delta, VS Code 1.146 en Qwen Code 1.0 Preview
Delta lanceert zijn Cloud Runners: een agentthread blijft draaien zonder de computer van de maker
11 november — Delta, de multiplayercodeeromgeving met agents van het team achter Zed, lanceert de Cloud Runners die een dag eerder waren aangekondigd. Door Cloud te kiezen in de composer van een thread, worden de beurten van de agent uitgevoerd in een door Zed gehoste Linux-sandbox die op E2B draait; de thread is te volgen vanaf de desktop, het web of de telefoon en kan op elk moment terugkeren naar de lokale machine. De runner haalt de code op van de servers van Delta, voert het script .agents/setup van de repository uit (het resultaat wordt één dag gecachet) en gebruikt de modelproviders en versleutelde omgevingsvariabelen van de gebruiker. Na toestemming handelen git en gh namens de gebruiker op GitHub, en kan de agent een preview-URL teruggeven die alleen toegankelijk is voor mensen met toegang tot de thread.
| Grootte van de runner | Toegewezen processors | Werkgeheugen | Vrije schijfruimte |
|---|---|---|---|
| Small | 2 CPU | 4 Go | 15 Go |
| Medium (standaard) | 4 CPU | 8 Go | 30 Go |
| Large | 8 CPU | 16 Go | 50 Go |
De rekenkracht is gratis bij alle Zed-abonnementen behalve Student, zolang Delta aan zijn eigen abonnementen werkt, binnen niet nader gekwantificeerde grenzen voor redelijk gebruik; de modellen worden net als bij lokaal gebruik gefactureerd. Er kunnen zes runners tegelijk draaien, terminals sluiten na een uur en een runner pauzeert na 10 minuten inactiviteit.
🔗 Cloud Runners zijn nu beschikbaar in Delta · Documentatie van de Cloud Runners
VS Code 1.146 markeert de Local harness van Copilot als verouderd en voegt een Inbox-modus toe voor agentsessies
11 november — Microsoft brengt VS Code 1.146 uit, waarin de Local harness (Local harness) van Copilot als verouderd wordt gemarkeerd: deze wordt in februari 2027 verwijderd en blijft tot die tijd bruikbaar, maar krijgt geen verdere ontwikkeling. Nieuwe functies komen uitsluitend naar de Copilot harness, die op de Copilot SDK is gebouwd, sinds VS Code 1.143 de standaard is voor nieuwe sessies en als enige het sandbox- en machtigingenbeleid van organisaties toepast.
Het Agents-venster krijgt een Inbox-modus (experimenteel) die sessies die op een ingreep wachten bovenaan zet, en een chat kan in een eigen venster worden geopend (preview). Compare Models ondersteunt Copilot Fusion en de bijbehorende inspanningsniveaus. Op het gebied van beveiliging bieden machtigingsprompts gerichte toestemmingen aan (een domein, een commando, een map), en kan de sandbox omgevingsvariabelen verbergen, waarbij de echte waarde alleen wordt ingevoegd in HTTPS-requests naar toegestane hosts. VS Code ondersteunt ook skills die door MCP-servers worden aangeboden (SEP-2640, preview), en Copilot-sessies volgen de proxyconfiguratie voor PAC en Kerberos.
🔗 Release notes van VS Code 1.146
Qwen Code 1.0 Preview verenigt de agents van Qoder en Qwen Code in een native binary, zonder Node.js
11 november — Enkele uren na Qwen4-Max publiceert Qwen de prerelease Qwen Code 1.0 Preview, die de agentmogelijkheden van Qoder, de codeomgeving van Alibaba, en die van Qwen Code samenbrengt: een codebase begrijpen, implementeren, debuggen en testen. Verbinding maken kan via een Qwen- of Qoder-account, via QwenCloud of Model Studio, of via elk compatibel endpoint. De tool wordt geleverd als native pakketten voor macOS, Linux en Windows, in x64 en arm64 (acht archieven van ongeveer 57 tot 74 Mo), zonder aparte installatie van Node.js, en behoudt het hervatten van sessies en niet-interactieve uitvoering.
De repository waarschuwt dat de interfaces en opties nog kunnen veranderen en accepteert tot na december 2026 geen pull requests meer van de community. Volgens de GitHub API deelt de tag 1.0 geen geschiedenis met de v0.27.2 die een dag eerder werd gepubliceerd.
🔗 Qwen Code v1.0.0-preview (GitHub)
Open modellen en onderzoek: BotPsy van Tether en token pooling van Hugging Face
BotPsy-0.8B: Tether publiceert een klein open agentmodel dat de toolscores van zijn basismodel ongeveer verdubbelt
11 november — Tether AI Research, het AI-team van Tether dat onder de naam QVAC publiceert, presenteert BotPsy-0.8B, een model met 0,8 miljard parameters dat is gespecialiseerd in het aanroepen van tools en bedoeld is om op een telefoon of laptop te draaien. Het begint bij Qwen3.5-0.8B en doorloopt supervised fine-tuning, distillatie op basis van drie Qwen3.5-4B-teachermodellen en twee rondes reinforcement learning. De gewichten staan op Hugging Face, in safetensors en GGUF, volgens de modelkaart onder de Apache 2.0-licentie; de blogpost spreekt over gebruik voor onderzoek en onderwijs.
| Benchmark (cijfers van het team) | BotPsy-0.8B | Qwen3.5-0.8B (basis) | Qwen3.5-2B-Think |
|---|---|---|---|
| BFCL v4 | 44,0 | 23,4 | 37,7 |
| ACEBench | 58,7 | 30,1 | 55,4 |
| τ-bench | 51,5 | 23,2 | 46,5 |
| Gemiddelde over zes toolbenchmarks | 45,0 | 24,7 | 38,8 |
Al deze cijfers zijn door het team gemeten, in redeneermodus. Het meldt ook dat het aandeel gevaarlijke antwoorden bij geautomatiseerde aanvalstests daalt van 36 % naar 21 %, beveelt Engels aan en raadt het model af voor gevoelige beslissingen.
🔗 BotPsy (QVAC op Hugging Face) · Model qvac/BotPsy-0.8B
Token pooling: Hugging Face behoudt 97,8 % van de zoekkwaliteit met vier keer minder vectoren
11 november — Tom Aarsen legt op de blog van Hugging Face uit hoe de omvang van zoekindexen met meerdere vectoren, zoals ColBERT, kan worden verkleind. Die bewaren één vector per documenttoken. Het groeperen van tokens (token pooling) voegt dicht bij elkaar liggende vectoren samen, en Sentence Transformers voegt een lossfunctie toe, MultiVectorTokenPoolingLoss, die het model zowel op zijn volledige als op zijn gecomprimeerde representaties traint.
| Pooling bij inferentie (NanoBEIR, nDCG@10) | Gemiddeld aantal vectoren | Klassieke training | Training die rekening houdt met pooling |
|---|---|---|---|
| Zonder pooling | 193,22 | 51,84 | 52,39 |
pool_factor=4 | 48,68 | 49,03 | 51,23 |
max_tokens=4 | 4,00 | 37,22 | 43,00 |
Met vier keer minder vectoren behoudt het zo getrainde model 97,8 % van zijn score, tegenover 94,6 % bij klassieke training. De metingen hebben betrekking op één configuratie (ModernBERT-base, één epoch), en er zijn twee checkpoints op de Hub gepubliceerd.
🔗 Training die rekening houdt met token pooling (Hugging Face)
Seedance 2.5 krijgt 4K bij Pika en Runway
11 november — Seedance 2.5, het videomodel van ByteDance dat via BytePlus wordt aangeboden, komt beschikbaar in 4K. Pika biedt het in native 4K aan op zijn platform en in zijn Pika API Club, met de mogelijkheid om een opname eerst als concept uit te werken en vervolgens in 4K af te ronden; sinds 17 augustus bood het bedrijf het aan in 1080p met opschaling (upscale) naar 4K. Runway volgde iets minder dan twee uur later met de aankondiging van Seedance 2.5 in 4K op zijn platform, zonder te verduidelijken of het om native 4K gaat. Er zijn geen prijzen, maximale duur of kosten in credits bekendgemaakt.
🔗 Aankondiging van @pika_labs · Aankondiging van @runwayml
Git verhelpt zes kwetsbaarheden, waaronder code-uitvoering bij recursief klonen
10 november — Buiten AI brengt het Git-project Git 2.56.1 uit, met backports tot en met Git 2.50.2, om zes kwetsbaarheden te verhelpen die Elijah Newren op de GitHub Blog beschrijft.
| Verholpen kwetsbaarheid | Aard van het risico |
|---|---|
| CVE-2026-111760 | Code-uitvoering bij recursief klonen, via het bestand .git van een submodule |
| CVE-2026-113408 | Path traversal via de door een server aangekondigde HEAD |
| CVE-2026-114467 | Stackcorruptie bij het verwijderen van GPG-handtekeningen |
| CVE-2026-114469 | Lezen buiten de grenzen bij het toepassen van binaire patches |
| CVE-2026-105437 | Heapcorruptie bij grote merges |
| CVE-2026-114466 | Toegang tot het bestandssysteem via git fast-import-streams |
GitHub heeft de fixes al uitgerold op github.com en Enterprise Cloud, brengt GitHub Enterprise Server 3.19.15, 3.20.11, 3.21.9 en 3.22.4 uit en bereidt versies van GitHub Desktop en de GitHub Copilot-app voor met een gepatchte Git-versie. Het advies is om Git en elke applicatie die een kopie ervan bevat bij te werken; als dat niet mogelijk is, alleen vanaf vertrouwde servers te klonen.
🔗 Beveiligingskwetsbaarheden in Git aangekondigd (GitHub Blog)
Kort nieuws
Codeagents en ontwikkeltools
- Zed 1.28 en previewversie 1.29 — Versie 1.28 wordt stabiel en neemt de previewversie over die op 4 november werd besproken (het nieuwste Agent Client Protocol, leesresultaten van
read_fileafgekapt op 2 000 tekens, optioneel automatisch ophalen van Git-updates). Previewversie 1.29 ondersteunt Claude Fable 5.2 en Claude Mythos 5.2 bij de Anthropic-provider. 🔗 bron - Antigravity CLI 1.5.4 en 1.5.5 — Versie 1.5.5 introduceert /swarm als preview in de terminal, met de schermvullende weergave /swarm board, en verhelpt problemen bij het importeren van commando’s en hooks uit Claude Code-plugins. Versie 1.5.4 stelt de Auto-modus beschikbaar voor ACP-sessies en breidt de gegevens uit die aan hooks worden doorgegeven. 🔗 bron
- Gemini CLI — Geen nieuwe versie op de dag na v0.68.0, en de nachtelijke versie (nightly) is opnieuw mislukt, zoals elke nacht sinds 5 november. Vier fixes zijn samengevoegd in de hoofdbranch, waaronder een oplossing voor een fout 400 na een lege modelbeurt bij een afbeelding of binair bestand. 🔗 bron
- Copilot CLI 1.0.110-1 — Previewversie met uitsluitend 13 fixes: een hervatte sessie kan niet meer gelijktijdig worden gewijzigd, en een lokale MCP-server die een afgekapt Unicode-teken terugstuurt, blokkeert geen toolaanroep meer. Met SDK 1.0.32-preview.1 kunnen Copilot Fusion en het bijbehorende niveau worden gekozen. 🔗 bron
- Gemini 4 Carbon bij Genspark — Genspark stelt Gemini 4 Carbon beschikbaar in zijn AI Chat en Code Agent, een dag nadat Claude Fable 5.2 in diezelfde Code Agent verscheen, zonder informatie over abonnementen of creditverbruik. 🔗 bron
- Basis en Devin for Startups — Cognition laat in een video zien hoe Basis met Devin werkt; de boekhoudagents van Basis brengen sommige taken terug van 20 uur naar 30 minuten, een cijfer dat betrekking heeft op Basis en niet op Devin. Cognition lanceert ook Devin for Startups opnieuw, met 65 000 dollar aan credits voor geselecteerde teams. 🔗 bron
- shem — João Galego publiceert een experimentele runtime die een model van Hugging Face als containerimage start (een Dockerfile kan beginnen met
FROM hf.co/...) en, omgekeerd, containers uitvoert op een processor die uit modelgewichten bestaat; volgens hem werkt dit ‘meestal’. 🔗 bron
GitHub
- Copilot-licenties beheerd door GitHub Apps — GitHub Apps voor ondernemingen kunnen de API’s voor het beheer van Copilot-licenties aanroepen om licenties toe te wijzen aan gebruikers en ondernemingsteams, dankzij een nieuwe fijnmazige machtiging, Enterprise Copilot license management. 🔗 bron
- Dependabot en inactieve repositories — Vanaf 8 december schakelt GitHub Dependabot-meldingen uit voor de meeste repositories die een jaar lang inactief zijn geweest; de meldingen worden gearchiveerd, niet verwijderd, en bij de eerste push hersteld. Dit geldt niet voor GitHub Enterprise Server. 🔗 bron
- Issuetypen en -velden voor persoonlijke accounts — Tot nu toe waren ze voorbehouden aan organisaties, maar nu worden ze algemeen beschikbaar voor persoonlijke repositories: maximaal 25 typen en 25 velden, te gebruiken in projecten, via de REST- en GraphQL-API’s en via webhooks. 🔗 bron
- GitHub-dashboard — Het compactere dashboard toont zes pull requests en zes issues in plaats van drie, biedt de mogelijkheid het tabblad Feed of Home vast te zetten en verbergt de sectie met agentsessies wanneer het account er geen heeft. 🔗 bron
Bedrijven en toepassingen
- Singapore Airlines — Na een herschrijving op basis van de API van OpenAI verdubbelt chatbot Kris zijn klanttevredenheidsscore, verkorten gesprekssamenvattingen de afhandeltijd van medewerkers met ongeveer 10 %, en gebruikt meer dan 60 % van de werknemers elke maand het interne platform Jarvis. 🔗 bron
- Cogent Security — De startup bouwt agents voor cyberverdediging op GPT-6.1 Sol, GPT-6 Astra en GPT-5.6, met beleidsregels die vóór elke toolaanroep worden gecontroleerd; volgens het bedrijf heeft een klant uit de auto-industrie in de Fortune 1000 de gemiddelde tijd om kritieke kwetsbaarheden te verhelpen met 75 % verkort. 🔗 bron
- JioStar — De spraakassistent voor het ontdekken van content in JioHotstar, in ongeveer acht weken gebouwd op de API van OpenAI, spreekt meer dan 15 talen op een platform met meer dan 500 miljoen gebruikers; volgens JioStar spreekt meer dan 60 % van de gebruikers tegen de assistent in plaats van te typen. 🔗 bron
- ChatGPT Plus voor veteranen — Voor Veterans Day meldt OpenAI dat in een jaar tijd meer dan 20 000 veteranen en militairen die overstappen naar het burgerleven het aangeboden gratis jaar ChatGPT Plus hebben aangevraagd, en dat bijna 1 000 leden van de militaire gemeenschap zijn opgeleid. 🔗 bron
- fal-plugin in ChatGPT — fal brengt zijn plugin onder de aandacht, die afbeeldingen en video’s genereert en bewerkt in het gesprek, met een reclamespot van 60 seconden gemaakt met GPT Image 2.6, FLUX 3 Max (26 shots) en fal Recast; de publicatiedatum wordt niet vermeld. 🔗 bron
- Gopuff in Grok Bot — Grok Bot bestelt nu van begin tot eind boodschappen, snacks en dagelijkse benodigdheden bij Gopuff, met volgens Gopuff een bezorging vanaf 15 minuten; landen en abonnementen worden niet vermeld. 🔗 bron
- Genspark Genius — Genspark werft ambassadeurs: elke maand één gedeelde creatie, in ruil voor het Pro-abonnement, vroege toegang tot nieuwe functies, credits en aandacht op zijn kanalen. 🔗 bron
Modellen, media en onderzoek
- MiniMax H3 — Honderd dagen na het vrijgeven van de modelgewichten claimt MiniMax 1 472 afgeleide modellen en meer dan 148 miljoen downloads op Hugging Face, cijfers die niet zijn geverifieerd; H3-Image komt beschikbaar bij fal, Runware, EvoLink en Miora, bij die laatste gratis tot 17 november. 🔗 bron
- Voxtral Transcribe 3 op AI Engineer Paris — Mistral heeft alle lezingen op het hoofdpodium live getranscribeerd en daarbij de namen van de sprekers en de termen uit het programma aan het model meegegeven (contextbias), zonder cijfers over de behaalde verbetering. 🔗 bron
- Lokale spraak in Google AI Edge Gallery — De app krijgt offline spraakherkenning en spraaksynthese: op Android transcribeert ML Kit meer dan 100 talen tien keer sneller dan realtime, en open modellen zoals Parakeet-TDT 0.6B of Kokoro-82M bedienen de andere platforms. 🔗 bron
- Déjà View bij NVIDIA — Dit model voor 3D-reconstructie met 117M parameters past hetzelfde transformerblok meerdere keren toe en evenaart op vijf benchmarks modellen die tot 10 keer groter zijn; het wordt mondeling gepresenteerd op NeurIPS 2026 en het artikel staat sinds mei op arXiv. 🔗 bron
- Ziekten in Spaanse medische teksten — OpenMed publiceert twee open modellen onder Apache-2.0 die op een CPU kunnen draaien; volgens het team verhoogt finetuning op DisTEMIST de F1 van ongeveer 36 tot 39 voor een generiek model naar ongeveer 73 voor de GLiNER2.5-versie. 🔗 bron
- Agentbetalingen met x402 — Zelfstandig behalen Qwen3 235B, DeepSeek V4 Pro en Llama 3.3 70B 59, 55 en 30 punten op het examen van Fizzl, waarmee geen van de modellen slaagt; wanneer code beslist over de betaling (x402-safe-fetch), stijgen de scores naar 94, 100 en 94. 🔗 bron
- GR00T-X-Embodiment-Sim in FiftyOne — Harpreet Sahota (Voxel51) converteert 42 gesimuleerde episodes uit de dataset van NVIDIA, zes voor elk van zeven robotlichamen, met gesynchroniseerde camera’s en gewrichtstelemetrie. 🔗 bron
Ecosysteem
- Sakana AI — Gepensioneerd admiraal Michael Rogers, voormalig directeur van de NSA, en Tom Moran, die bijna 30 jaar bij de CIA werkte, worden senior adviseurs voor defensie en cyberbeveiliging bij de startup uit Tokio. 🔗 bron
- Recycling bij NVIDIA — Voor COP31 presenteert NVIDIA vier startups uit zijn Inception-programma die afval sorteren met computervisie, waaronder Greyparrot, dat de controle van 15 ton afval terugbrengt van 375 naar 6 uur; er is geen nieuw NVIDIA-product. 🔗 bron
- Perplexity-gids over naleving van AI-regels — De gids behandelt de Europese AI Act, het NIST AI RMF en ISO/IEC 42001, en stelt drie controlemaatregelen voor agents voor: alleen strikt noodzakelijke toegang, een logboek van elke actie en menselijke goedkeuring van acties met grote gevolgen. 🔗 bron
- Perplexity-gids over MCP-architectuur — De rollen van host, client en server, JSON-RPC 2.0-berichten, lokale transporten en Streamable HTTP, een multi-tenantopzet: een technische uiteenzetting die volgt op de beveiligingsgids van 4 november, zonder productaankondiging. 🔗 bron
- Cohere-hackathon in Toronto — Cohere organiseert op 30 januari 2027 samen met de Universiteit van Toronto zijn eerste hackathon, Hacking Higher Ed, over AI in het hoger onderwijs; prijzen van 3 000, 2 000 en 1 000 dollar, aanmelden kan tot 22 januari. 🔗 bron
Wat dit betekent
Google DeepMind past zijn modellen toe op twee problemen waarbij verificatie zwaarder weegt dan generatie. AlphaGenome 2 neemt geen genoegen meer met een gemiddelde per weefsel: het voorspelt het effect van een variant in de cel waarin de onderzoeker geïnteresseerd is, en de verbeteringen worden gemeten op TenK10K, een kaart van 28 typen immuuncellen. AlphaProof Code verplaatst formele verificatie van het protocolontwerp naar de gecompileerde code, met een expliciete taakverdeling: de agents schrijven meer dan zes miljoen regels bewijscode, de Lean-verificateur controleert elke stap, en mensen beoordelen de specificaties en ongeveer 1 % van de code. Beide aankondigingen hebben hun beperkingen: AlphaGenome 2 blijft voorbehouden aan onderzoek, en de claim op de primeur voor Signal komt van Google DeepMind zelf.
Veiligheid stuit op de beperkingen van haar eigen meetinstrumenten. OpenAI stelt vast dat de redeneerketen, een van de pijlers van zijn monitoring, moeilijker te lezen wordt naarmate de pretraining vordert, en vindt zelf dat controleerbaarheid, een van zijn twee indicatoren, veel ruis bevat. Perplexity laat zien dat het klassieke capture-the-flag-formaat agents afleidt van de grens die getest moet worden, en dat een model dat gespecialiseerd is in cyberbeveiliging slechter kan presteren dan zijn generalistische versie, op basis van drie proeven en een configuratie van vóór de fix. In beide gevallen gaat de conclusie evenzeer over de evaluatiemethode als over de modellen zelf.
De dag laat een duidelijk verschil zien tussen wat wordt geleverd en wat wordt aangekondigd. Runway publiceert Praxis-1 met de modelgewichten, de code voor finetuning en een rapport dat het model achter vier concurrerende inzendingen plaatst, en Tether stelt BotPsy beschikbaar om te downloaden. Qwen4-Max verschijnt daarentegen zonder benchmark, modelgrootte of prijs, en ElevenLabs maakt zelf onderscheid tussen wat vandaag beschikbaar is (Marketplace, Partner Program, ElevenAI) en wat later komt (Interaction Engine, Memory, Routines, finetuning). Voor wie wil testen, blijft die tweede helft een belofte.
Agents krijgen een blijvende plek en worden onderdeel van teams. Grok Bot 1.0 neemt deel aan vergaderingen en stemt af met andere Bots in Slack en Teams; de Cloud Runners van Delta laten een agentthread draaien zonder de computer van de maker; VS Code voegt een inbox toe voor sessies die op een beslissing wachten; A2UI laat agents antwoorden met een scherm in plaats van tekst. Elk product begrenst ook de risico’s die het introduceert: machtigingen per persoon en een controle voordat er in een openbaar kanaal wordt gesproken bij Grok Bot, een privépreview bij Delta, gerichte machtigingen en afgeschermde variabelen in de sandbox van VS Code.
Bronnen
- AlphaGenome 2 (Google DeepMind)
- AlphaGenome 2 (@GoogleDeepMind)
- Introductie van AlphaProof Code (Google DeepMind)
- Formele verificatie van Signal (PDF, Google DeepMind)
- Qwen4-Max in preview (@Alibaba_Qwen)
- Token Plan (QwenCloud)
- Praxis-1 is nu beschikbaar (Runway)
- Technisch rapport over Praxis-1 (Runway)
- Praxis-1-collectie (Hugging Face)
- ElevenLabs Summit NYC (ElevenLabs)
- Aankondigingen van de Summit (@ElevenLabs)
- ElevenLabs en NVIDIA (ElevenLabs)
- Volledige reset van de limieten (@ClaudeDevs)
- Grok Bot 1.0 (SpaceXSI)
- Grok Bot 1.0 (@SpaceXSI)
- Uitfasering van de stemmen Advanced en Standard in ChatGPT (OpenAI-helpcentrum)
- Uitfasering van de stemmen Advanced en Standard (@OpenAINewsroom)
- Gemini op Apple CarPlay (blog.google)
- Mogelijkheid om CoT te monitoren tijdens de levenscyclus van het model (OpenAI)
- Thread van Jeffrey G. Wang
- Ontsnappen uit SPACE: deel II (Perplexity)
- Ontsnappen uit SPACE: deel II (@perplexity_ai)
- Gemini Decision 1 (Google AI Studio)
- Decisions API (Google AI Studio)
- A2UI 1.0 (Google Developers Blog)
- Cloud Runners zijn nu beschikbaar in Delta
- Documentatie van Cloud Runners (Delta)
- Release notes voor VS Code 1.146
- Qwen Code v1.0.0-preview (GitHub)
- BotPsy (QVAC op Hugging Face)
- Model qvac/BotPsy-0.8B (Hugging Face)
- Token Pooling-Aware Training (Hugging Face)
- Seedance 2.5 in 4K (@pika_labs)
- Seedance 2.5 in 4K (@runwayml)
- Beveiligingskwetsbaarheden in Git bekendgemaakt (GitHub Blog)
- Zed v1.28.1 (GitHub)
- Changelog van Antigravity
- Gemini CLI, PR 30228 (GitHub)
- Copilot CLI v1.0.110-1 (GitHub)
- Gemini 4 Carbon in Genspark (@genspark_ai)
- Basis en Devin for Startups (@cognition)
- Je LLM is nu een container (Hugging Face)
- Beheer van Copilot-licenties door GitHub Apps (GitHub Changelog)
- Dependabot-meldingen worden gepauzeerd voor inactieve repositories (GitHub Changelog)
- Issuetypen en -velden voor persoonlijke accounts (GitHub Changelog)
- Een informatiever GitHub-dashboard (GitHub Changelog)
- Singapore Airlines (OpenAI)
- Cogent Security (OpenAI)
- JioStar, Vijay Seshadri (OpenAI)
- ChatGPT Plus voor veteranen (OpenAI)
- fal-plugin in ChatGPT (@fal)
- Gopuff in Grok Bot (@bot)
- Genspark Genius (@genspark_ai)
- MiniMax H3, 100 dagen (@RyanLeeMiniMax)
- Voxtral Transcribe 3 op AI Engineer Paris (@MistralAI)
- Lokale spraak in Google AI Edge Gallery (Google Developers Blog)
- Déjà View (@NVIDIAAI)
- Ziekten vinden in Spaanse klinische teksten (OpenMed)
- Open AI-modellen met een portemonnee (Fizzl)
- GR00T-X-Embodiment-Sim in FiftyOne (Hugging Face)
- Michael Rogers en Tom Moran (Sakana AI)
- AI-startups voor recycling (NVIDIA-blog)
- Naleving van AI-regels (Perplexity)
- MCP-architectuur (Perplexity)
- Hacking Higher Ed (@cohere)