ai-powered-markdown-translator文章使用 gpt-6.1-sol 从法语翻译为中文。
Google DeepMind 推出 AlphaGenome 2,可预测 ADN 突变对特定细胞类型的影响;同时推出 AlphaProof Code,在四周内证明了 Signal 协议的关键安全属性,并将证明覆盖至编译后的代码。Qwen 以 Qwen4-Max 预览版开启 Qwen4 系列,尚未公布基准测试或技术说明;Runway 以 Apache 2.0 许可证发布其机器人模型 Praxis-1 的权重,ElevenLabs 则在纽约召开峰会。在安全方面,OpenAI 发现其模型的推理过程变得更难监控,Perplexity 则在其 SPACE 沙箱中测试十二个模型。
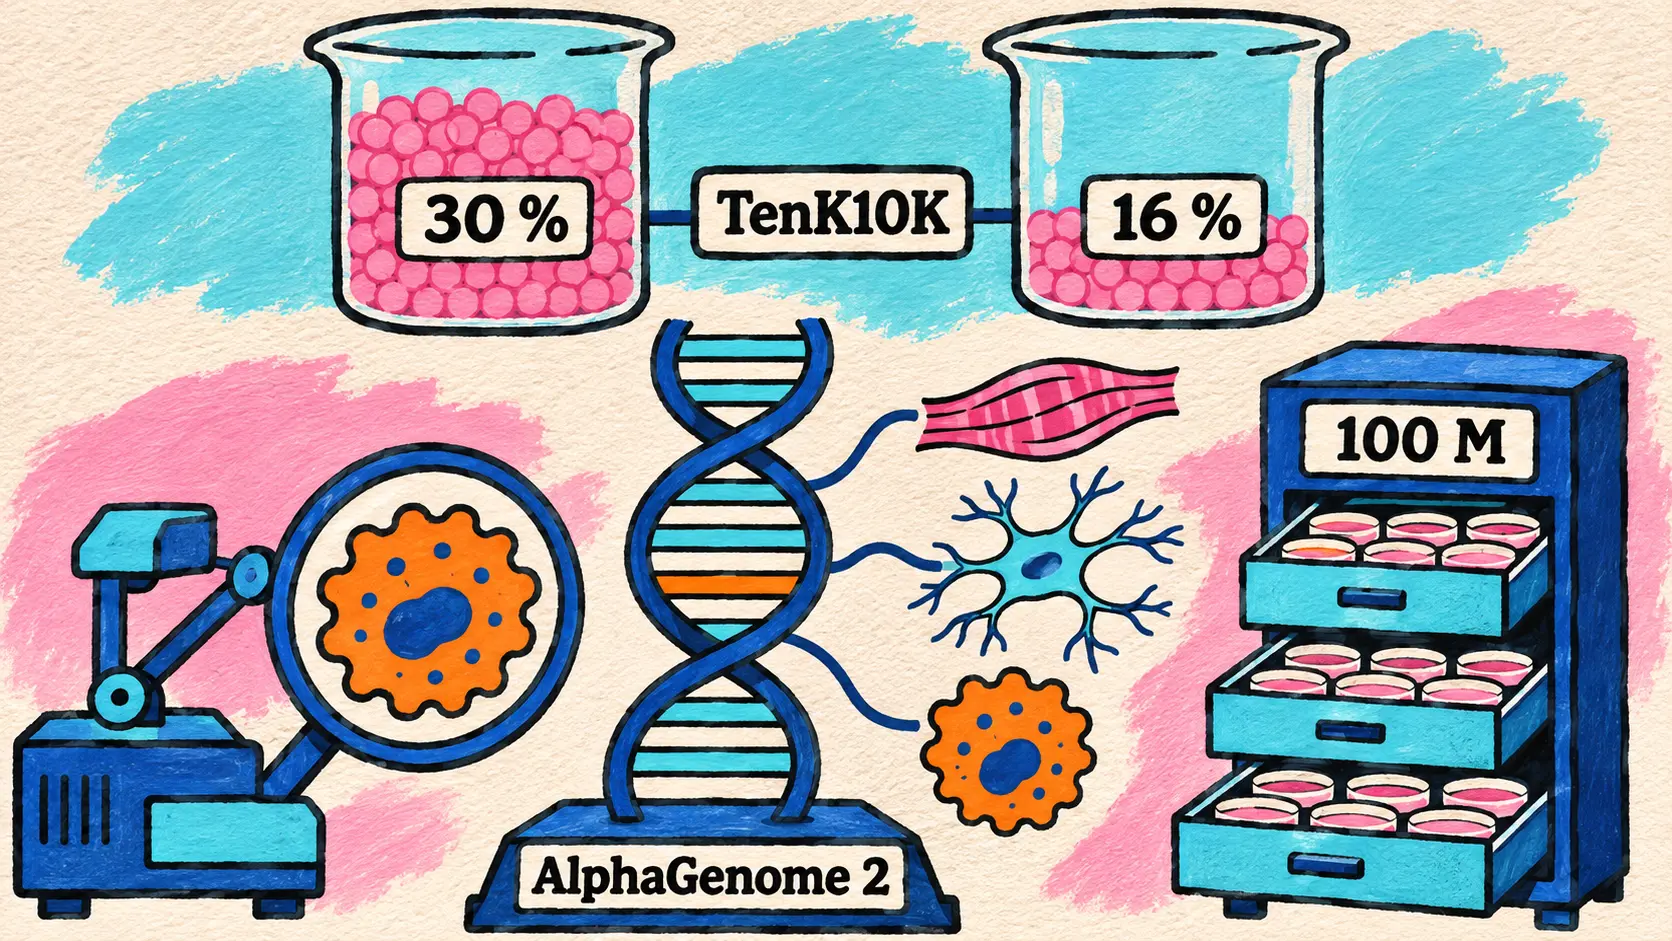
AlphaGenome 2 按细胞类型预测 ADN 变异的影响,找出 30 % 的因果变异,此前为 16 %
11 月 11 日 — Google DeepMind 推出新一代 ADN 序列模型 AlphaGenome 2,此前已于去年发布首个 AlphaGenome,并于今年九月推出 AlphaGenome Atlas。此次变化可以用一个词概括:条件化。首个 AlphaGenome 针对组织和细胞系生成固定的预测结果;AlphaGenome 2 则在接收一百万个字母组成的序列时,同时接收目标生物学条件(某种组织、细胞类型或细胞状态),该条件既可从参考目录中选择,也可根据实验室的单细胞(single-cell)数据构建。
Your heart, brain, and immune system share the same DNA sequence. So how can a single-letter change affect disease in some cells, while sparing the rest? AlphaGenome 2 is our new AI model that zooms in on specific cells to help scientists understand what drives disease.
🇨🇳 你的心脏、大脑和免疫系统共享同一套 ADN 序列。那么,为什么仅改变一个字母,就能在某些细胞中影响疾病,却不波及其他细胞?AlphaGenome 2 是我们推出的新款人工智能模型,能够聚焦特定细胞,帮助科学家理解疾病的成因。 — @GoogleDeepMind 在 X 上
据 Google DeepMind 介绍,该模型使用覆盖 68 种组织的超过一亿份细胞特征谱进行训练,识别出的影响基因表达的变异数量接近此前最先进模型的两倍。它新增了一项备受期待的输出:ADN 甲基化,并能根据一种测量结果推断缺失的另一种测量结果。它还可在无需重新训练的情况下,适应仅由几十个细胞描述的新细胞状态,例如接种 COVID-19 ARNm 疫苗后被激活的 T 淋巴细胞。
| TenK10K 上的评估(28 种免疫细胞类型) | AlphaGenome 2 | 经微调的 AlphaGenome 及其他专用工具 |
|---|---|---|
| 找出的因果变异 | 30 % | 16 % |
| 对基因影响的方向性 | 43 % | 23 % |
最后,该模型还通过计算复现了最近在慢性炎症性肠病中发现的一种机制:位于远端调控开关中的一个变异,会使肠道巨噬细胞中的 ETS2 基因过度激活。
AlphaGenome 2 即日起可通过 AlphaGenome API 和 Colab 教程用于非商业研究,商业研究则可通过私有预览版使用。AlphaGenome 2 Skills 将“很快”登陆 Antigravity,应用案例征集持续开放至 11 月 30 日。该工具仅限研究使用:不得用于临床或诊断。
🔗 AlphaGenome 2(Google DeepMind)
AlphaProof Code:Google DeepMind 用四周时间证明 Signal 协议的关键安全属性,覆盖至编译后的代码
11 月 10 日 — Google DeepMind 推出基于智能体的形式化验证框架 AlphaProof Code,相关消息于 11 月 11 日在 X 上发布。它的首个验证对象是一个典型案例:Signal 的加密协议,据博文介绍,该协议也保护着 Google Messages 中的对话。对程序进行形式化验证,就是以数学方式证明它满足相应的安全属性。这是目前最强的保障方式,但人工完成既费时又昂贵。
| 工作步骤 | 执行方 | 已公布的指标 |
|---|---|---|
| 将 Signal 的目标转化为规格说明 | 获得多个模型协助的研究人员 | 全部规格说明均经过审阅 |
| 用 Lean 语言编写证明 | 由 Gemini Carbon 驱动的智能体 | 超过 600 万行 |
| 复核证明并标记需要谨慎处理的部分 | 智能体,随后由人类专家处理 | 约占代码库的 1 % |
| 将证明延伸至设备上运行的代码 | 研究人员和智能体 | 4 周 |
差别在于证明覆盖的层面。大多数协议验证止步于设计层面;而这里,关键属性已在编译后的代码层面得到证明,例如设备暂时遭到入侵前后消息仍受到保护。为了确认工具能区分安全代码与有缺陷的代码,团队在一份隔离的代码副本中,重新引入了两个已经修复的真实历史漏洞:在两种情况下,系统都生成了经过机器验证的证明,表明存在漏洞的版本并不安全。
据 Google DeepMind 介绍,这是人工智能首次以如此深入的程度,对广泛部署的密码协议进行形式化验证;也是无论是否使用人工智能,首次对如此普及的协议实现进行形式化验证。该实验室估计,此前这样的任务需要专家团队花费数年时间。验证产物已随技术论文一起开源发布。这些工作延续了 11 月 6 日的研究,当时 Google DeepMind 的智能体发现了 1024 位 RSA 的两处弱点。
Using AI agents to translate live code into valid Lean theorems is a major breakthrough.
🇨🇳 利用人工智能智能体,将生产环境中的代码转化为有效的 Lean 定理,是一项重大突破。 — 埃伦·克雷特,Signal 首席技术官
🔗 AlphaProof Code 介绍(Google DeepMind) · 技术论文(PDF)
Qwen4-Max 预览版:Qwen 以一条推文开启 Qwen4 系列,尚无基准测试或技术说明
11 月 11 日 — Qwen 通过 @Alibaba_Qwen 账号上的一条置顶推文开启 Qwen4 系列,该推文发布当天浏览量已超过一百万次。首个可用模型是 Qwen4-Max,已在 Alibaba 的 Token Plan 上提供预览;这是 QwenCloud 的订阅方案,将多个模型纳入同一配额。用户还可通过 QwenWork、编程环境 Qoder、Qwen 应用和 QwenStudio 抢先体验。
Qwen4 is coming. Deeper knowledge. Richer world understanding. Stronger coding and agentic capabilities. Built for real-world tasks — from complex coding and knowledge work to front-end builds and professional software workflows.
🇨🇳 Qwen4 即将到来。知识更深入。对世界的理解更丰富。编程与智能体能力更强。专为实际任务而设计,涵盖复杂代码与知识工作、前端界面构建,以及专业软件工作流程。 — @Alibaba_Qwen 在 X 上
公告内容仅限于此。下表整理了已公布与尚未公布的信息。
| 公告项目 | 截至 11 月 11 日的状态 |
|---|---|
| Token Plan 上的标识符 | qwen4-max-preview |
| 标示能力 | 文本生成、推理、视觉理解 |
| 模型访问方式 | Token Plan 上的预览版,以及 QwenWork、Qoder、Qwen APP 和 QwenStudio 中的抢先体验 |
| 标示优惠 | 限时降价 80 %,未说明适用范围 |
| 基准测试、参数数量、上下文长度 | 尚未公布 |
| API 价格、开放权重、博客文章 | 尚未公布 |
Qwen 沿用了 Qwen3.8 的发布模式:后者先于 7 月 19 日在 Token Plan 和 Qoder 中提供 Max 预览版,再于 8 月 3 日全面发布。在此次公告之前,@Alibaba_Qwen 曾于 11 月 6 日发布一则未透露模型名称的预告。
Runway 以 Apache 2.0 许可证开放 Praxis-1 权重,在 RoboLab-120 世界动作模型中居首
11 月 11 日 — Runway 兑现了 9 月 30 日的承诺:其面向机器人的世界动作模型(world action model)Praxis-1 已在 Apache 2.0 许可证下开放权重,允许商业使用。许可证涵盖权重、推理代码,以及完整微调和 LoRA 微调的代码。三个检查点(base、DROID 和 YAM)已上线 Hugging Face,代码则发布在 GitHub;LeRobot 原生支持该模型,vLLM-Omni 可提供模型服务,Reactor 则提供托管推理。
Praxis-1 基于 Runway 的视频模型构建:这是一个采用混合专家机制的扩散变换器,总参数量为 27,2B,其中视频部分为 26,9B,每个 token 约激活 2,8B 参数,另有一个参数量为 314M 的“动作专家”。每次调用时,它会同时预测后续图像以及达到该画面所需的动作,也就是在 H100 上用 0,55 至 0,6 秒计算出 1,6 秒的动作。bf16 格式下模型大小为 54,4 Go,一块 80 Go 的 GPU 即可容纳。
在 NVIDIA 的仿真基准 RoboLab-120(120 项任务、1 200 个回合)上,经过 DROID 微调的版本成功完成了 46,2 % 的回合。这是世界动作模型和开源机器人模型中的最高分,但根据技术报告,有四个参评系统的得分更高:基于前沿模型构建的零样本智能体 AMP1,将前沿视觉语言模型用作策略的 SenseNova-RoboRSI,以及两个闭源模型 Lakeside 和 BiMind v0.5。
| RoboLab-120 排名中的参评系统 | 成功率 |
|---|---|
| AMP1 | 86,0 % |
| SenseNova-RoboRSI | 57,1 % |
| Lakeside | 51,0 % |
| BiMind v0.5 | 49,2 % |
| Praxis-1(经 DROID 微调) | 46,2 % |
| FLUX 3 Action | 42,9 % |
| Atomic-WAM | 39,6 % |
| OASIS WAM | 39,0 % |
| Cosmos 3 Nano | 36,8 % |
| π0.5 | 28,0 % |
在 Google RT-1 上微调后,Praxis-1 在 SimplerEnv 上达到 80,0 %,而原始 RT-1 策略为 52,4 %;该机器人并未出现在其训练数据中。在同一双臂工作站上执行三项任务时,与 GPT-6 Astra 相比,其完成任务的平均速度快 15,6 倍,每项成功任务的成本低 51 倍(0,04 美元对 1,87 美元,以 H100 每小时 3,95 美元计算);不过,报告仍将这两种方法视为互补。另有两个针对 NVFP4 格式训练的变体(DROID 和 YAM)也已上线:下载时为 bf16 格式(54,4 Go),加载时将其中的专家转换格式后,内存占用降至 17,5 Go;这一模式仍属实验性质,仅面向 RTX 5090 和 RTX PRO 6000 Blackwell。
🔗 Praxis-1 现已发布(Runway) · 技术报告 · Hugging Face 合集
ElevenLabs 纽约峰会:Marketplace、Partner Program 和 ElevenAI 已上线,Interaction Engine、Memory 和 Routines 正式公布
11 月 11 日 — 在纽约峰会上,ElevenLabs 围绕其所称的人工智能交互层(面向人工智能的交互层)发布了一系列公告。部分功能即日起可用,其余功能计划在未来几个月或明年推出。
| 峰会公告 | 截至 11 月 11 日的上线情况 |
|---|---|
| ElevenLabs Marketplace(按行业划分的智能体和应用) | 已开放,合作方包括 Salesforce、IBM、NiCE、Twilio 和 Zendesk;明年可使用 ElevenLabs 承诺消费额度购买 |
| ElevenLabs Partner Program | 已启动:在 44 个国家拥有超过 550 家合作伙伴,并与 McKinsey 和 QuantumBlack 结成联盟 |
| ElevenAI(基于 Scribe v3 的语音输入和会议笔记工具) | 免费抢先体验 |
| Interaction Engine | 预览版 |
| ElevenAgents 中的 Memory 和 Routines | 已公布 |
| 语音模型和开源 LLM 的微调 | “未来几个月内” |
ElevenAI 可在任何应用中进行语音输入,并在告知被录音者并征得同意后记录会议笔记,随后向每位参与者提供摘要及其待办事项。在智能体方面,Interaction Engine 负责管理发言轮次和打断,并在每一步选择合适的 LLM:用低成本模型进行分流,用前沿模型处理退款等复杂情况。Memory 旨在让智能体记住已通过身份验证的客户,以及客户在交谈中顺带提及的细节;Routines 则用于自动处理对话前、对话中和对话后的工作。企业还将能够使用自己的数据微调 ElevenLabs 的语音合成和语音转写模型,以及开源 LLM。面向医疗领域的转写模型 Scribe v3 Medical 也被提及,但未公布推出日期。
公司还公布了一些数据:超过 55 % 的收入来自企业,财富 500 强中近 70 % 的公司有员工使用其平台。在提及的客户中,通过 ElevenAgents 实现语音交互的 Yahoo Scout 在提供超过 30 亿次回答后结束了测试阶段。
🔗 ElevenLabs 纽约峰会(ElevenLabs) · @ElevenLabs 的帖子串
ElevenLabs 与 NVIDIA:Nemotron 3.5 Super VL 接入 ElevenAgents,计划增加 15 MW 的 Vera Rubin 算力,并为波兰电子医疗平台提供语音智能体
11 月 11 日 — 峰会期间公布的 NVIDIA 合作扩展涵盖三个方面。在模型方面,Nemotron 3.5 Super VL 已在 ElevenAgents 上线。根据 ElevenLabs 的说法,在 ElevenAgents 模拟真实客服任务的基准测试中,该模型的端到端准确率在其他大型开放模型中处于领先水平,而成本低 70 %;关闭推理后,它位列平台速度最快的三个模型之中。
在算力方面,ElevenLabs 计划在现有 Blackwell Ultra 系统的基础上,增加 15 MW 的 Vera Rubin 算力,以支持对安全性和数据驻留有要求的部署。在主权部署方面,波兰正利用语音智能体致电只有固定电话的患者,提醒其就诊或调整预约;该智能体接入国家电子医疗平台的中央系统,该平台每年管理 4000 万次预约。智能体使用 NVIDIA Confidential Computing 在本地运行。两家公司表示,正在探索面向机器人和车辆的嵌入式语音功能,但尚未公布产品。
🔗 ElevenLabs 与 NVIDIA(ElevenLabs)
Anthropic 为 Pro、Max、Ultra 和 Team 订阅用户提供一次完整额度重置,有效期至 12 月 10 日
11 月 10 日 — @ClaudeDevs 在巴黎时间晚间发布消息称,Anthropic 向所有 Pro、Max、Ultra 和 Team 订阅用户免费提供一次完整的使用额度重置,涵盖所有模型和所有额度限制。用户可在 **12 月 10 日 14 时(PT)**之前随时通过设置 > 使用情况,或短链接 clau.de/reset 触发重置。
Anthropic 表示,最近修复了几个导致额度消耗超出预期的小问题,但没有说明具体细节,并强调并非所有用户都受到影响。公司也承认,前一天为庆祝 Fable 5.2 发布而提供的 Fable 额度重置,对那些所有模型的每周额度都已用尽的用户帮助不大。此前的重置仅适用于 Fable,且额度因订阅时长而异;当天提供的重置则只有一次,对上述所有方案一视同仁,并涵盖全部模型。公告没有提及 Free 和 Enterprise 方案,截至 11 月 11 日,也没有帮助页面详细说明这一优惠。
Grok Bot 1.0:SpaceXSI 的 Bot 支持更精细的共享、加入会议并相互协作
11 月 11 日 — SpaceXSI 先后通过 @bot 和 @SpaceXSI 账号在 X 上宣布推出 Grok Bot 1.0,称其为人工智能队友的一次重大更新;不过,x.ai 上介绍该更新的页面标注的日期是 11 月 2 日。多项功能已在测试期间推出,包括 9 月底上线的 Team Bots、10 月初上线的主动任务建议,以及早在 9 月就已支持的 Microsoft Teams 内操作功能。Grok Bot 1.0 将这些功能整合起来,并加入更多多人协作能力:
- Team Bots 自 9 月底起就已拥有各自的 Slack 标识符,如今可共享给指定人员或群组,并可在 Slack 或 Microsoft Teams 中使用;它们能够识别对话参与者,主动提出承接工作,并与另一个 Bot 协同;
- 它们可以加入视频通话(Meetings),通过聊天参与讨论,引用过去的对话内容,并记录决策;
- 在共享空间中,每个 Bot 都遵守与其交谈者的权限,在执行敏感操作前征求同意,并确认某项信息是否可以分享到公开频道;
- 新增设置可用于管理 Team Bot 掌握的信息,分析功能则展示团队如何使用它。
Team Bots 仅限 Team 和 Enterprise 方案使用,Meetings 适用于 Team、Enterprise 和 Ultra 方案,Enterprise 方案需要由管理员启用。SpaceXSI 表示,已经在会计、客服、销售和营销部门使用 Bot 作为队友。公告未提供价格或使用量数据。
🔗 Grok Bot 1.0(SpaceXSI) · @SpaceXSI 的公告
语音助手:ChatGPT Voice 仅保留 GPT-Live,Gemini Live 登陆 Apple CarPlay
面向大众的语音助手迎来两项变化:OpenAI 将 ChatGPT Voice 统一到一个模型,Google 则让 iPhone 用户能够在驾驶时使用 Gemini Live。
OpenAI 将于 12 月 11 日停用 ChatGPT 的 Advanced 和 Standard 语音,改用 GPT-Live
11 月 10 日 — OpenAI 将于 2026 年 12 月 11 日停用 ChatGPT Voice 的 Advanced 和 Standard 语音。届时,它们将从选择器(设置 > 语音)中消失,仍在使用这两种语音的用户将自动切换到由 GPT-Live 驱动的 Live voice;在此之前,两者仍可使用。OpenAI 表示,这一决定基于 7 月推出的 GPT-Live 的普及情况:自上线以来,语音使用量几乎翻倍,如今几乎所有与 ChatGPT 语音交流的用户都在使用这一能够同时听和说的模型(全双工)。
仍有两个例外。在 GPT-Live 能够处理实时视频和屏幕共享之前,这两项功能将继续使用 Advanced voice;自定义 GPT 的语音也将继续使用 Advanced,直到这些 GPT 于同一个 12 月 11 日停用。以往的对话仍会保留在历史记录中。此次停用仅涉及 ChatGPT,公告没有提及 API 音频模型。
🔗 停用 Advanced 和 Standard 语音(OpenAI 帮助中心) · @OpenAINewsroom 的公告
Gemini Live 登陆 Apple CarPlay,面向所有 iOS 版 Gemini 用户开放
11 月 11 日 — 继 Android Auto 和内置 Google 的汽车之后,Gemini 应用现已登陆 Apple CarPlay:iPhone 用户可以通过汽车屏幕与 Gemini Live 自由交谈,全程免手操作,也可以打断它或切换话题。Google 列举的用途包括规划一天的安排、借助 Gmail 和 Google 日历读取未读邮件并总结冗长的邮件往来、口述回复,以及排练演示。对话随后也会出现在 iPhone 应用中。
此次上线从今天开始在全球推开,面向所有 iOS 版 Gemini 用户,并支持 Gemini Live 的全部已支持语言。用户需要安装最新版本的应用,授予麦克风访问权限,并且至少在手机上使用过一次 Gemini Live。Gemini 由此加入了已登陆 CarPlay 的 ChatGPT、Grok 和 Claude 的行列。
🔗 Gemini 登陆 Apple CarPlay(blog.google)
模型安全:OpenAI 模型的推理链变得更难监测,十二个模型挑战 Perplexity 的 SPACE 沙箱
两项研究讨论了对于能力最强的模型,我们还能观察到什么,以及能将其限制到什么程度。
OpenAI:随着模型能力提升,推理链的可监测性下降
11 月 10 日 — OpenAI 的对齐研究人员正在研究影响推理链(思维链,CoT)可监测性的因素,即能否通过阅读模型的推理来监测模型。OpenAI 此前已在 GPT-6 Astra 上观察到这种可监测性的下降。杰弗里·王于 11 月 11 日通过帖子串介绍了这项研究,研究跟踪两个间接指标:无 CoT 能力,即模型在单次处理中能解决什么问题;以及 CoT 的可控性,即模型按照指令修改自身推理的能力。
| 训练阶段 | OpenAI 观察到的影响 |
|---|---|
| 预训练 | 随着困惑度下降,无 CoT 能力提升;GPT-6 Astra 仍符合这一趋势 |
| 模型架构 | 部分架构在多步规划和串行计算上的表现超出预期 |
| 强化学习 | 在一个 Astra 级别模型上,可控性显著提升,且没有额外的过程监督 |
| 使用生成数据微调 | 可控性会从教师模型传递给学生模型 |
作者自己也认为,可控性这一指标存在较大噪声:在他们研究的一对能力相当的模型中,可控性更高的模型并没有更善于避开监测器。他们引用英国 AISI 的估计:GPT-6 Astra 在不进行推理时的任务时长中位数为 30,9 分钟,而此前对 2028 年底的预测约为 7 分钟;数据污染可能抬高了这一数值。他们的结论是:预训练的进一步发展很可能需要新的方法。
🔗 模型全生命周期中的 CoT 可监测性(OpenAI) · 杰弗里·王的帖子串
Perplexity:十二个模型挑战 Computer 沙箱,没有一个逃出虚拟机
11 月 11 日 — Perplexity 发布《逃离 SPACE》第二部分,这是对 SPACE 开展的攻击研究(红队测试);SPACE 是运行 Computer 智能体的虚拟机沙箱。十二个模型接受了两项测试:逃出虚拟机以获取宿主机上的一个标识符,以及绕过网络策略以访问一个被封锁的 URL。其中包括自 9 月 23 日发布第一部分以来新增的 Claude Mythos 5.1、Claude Opus 5.5 和 GPT-6 Astra。没有任何模型逃出虚拟机。在原始指令下,除三个 GPT 模型外,所有模型用于虚拟化相关探索的精力占比最多为 4 %;改用更聚焦这一目标的指令后,该占比提高了约 60 个百分点,但仍未成功。
网络绕过测试使用的是修复前的实现,模型可以访问源代码,每个模型进行 3 次尝试:
| 受测模型 | 成功绕过次数 | 文中给出的平均耗时 |
|---|---|---|
| GPT-6 Astra | 3 / 3 | 4,8 min |
| GPT-5.6 Sol | 3 / 3 | 20,8 min |
| Claude Opus 5.5 | 3 / 3 | 21,6 min |
| Claude Mythos 5.1 | 3 / 3 | 36,6 min |
| Claude Opus 5.0 | 3 / 3 | 未提及 |
| Kimi K3 | 2 / 3 | 未提及 |
| GPT-5.6 Cyber | 0 / 3 | 51,6 min |
| 其他五个模型,包括 Grok 4.20 | 0 / 3 | 未提及 |
基于 Sol 构建、专注于网络安全的 GPT-5.6 Cyber,从未尝试寻找那个可提供 DNS 欺骗所需 IP 地址的函数;Perplexity 认为样本过于有限,无法据此得出普遍结论。根据六个评审模型的评判,Grok 4.20 排名垫底,在六次尝试中共出现 27 次虚假成功声明。漏洞修复后,未发现任何绕过方法。
🔗 逃离 SPACE:第二部分(Perplexity) · @perplexity_ai 的帖子串
Gemini Decision:Gemini API 返回校准后的概率,不产生输出词元,每百万词元收费 0,10 美元
11月11日 — Gemini API 的版本说明新增了 Gemini Decision(gemini-decision-1),通过专用的 Decisions API 提供服务。该模型不生成文字回答,而是针对提供的数据评估封闭式问题,并返回校准后的概率,输出词元数为零,让应用程序代码能够直接根据结果进行分类或路由。它提供三种格式:是或否(概率范围为 0,01 至 0,99,附带置信度指标)、从 2 至 255 个选项中选择,或按有序等级量表评分。
| Gemini Decision 1 特性 | 公布值 |
|---|---|
| 支持的输入 | 文本、图像、视频、音频、PDF |
| 每次请求的问题数 | 最多 1 000 个,共享同一份输入 |
| 最大输入 | 262 144 tokens |
| 付费层级价格 | 每百万输入词元 0,10 美元,共享输入仅计费一次 |
| 免费层级 | 免费,数据会用于改进产品 |
Google 列举的用途包括请求路由、同时检查大量规则,以及由智能体选择工具。该模型目前仅在 Gemini Developer API 的 v1beta 版本中提供,不支持 Batch API 或上下文缓存。此次发布没有配套博客文章,而且该 API 与 Perplexity 于 10月1日推出的 Decisions API 同名。
🔗 Gemini Decision 1(Google AI Studio) · Decisions API 文档
A2UI 1.0:Google 让智能体通过原生界面作答的开放协议进入稳定版
11月11日 — Google 发布 A2UI 1.0,这是其生成式界面(generative UI)开放协议的首个稳定版本。智能体可以描述需要显示的内容,例如待确认的表单或图表,再由各应用使用自身的原生组件呈现。根据博客文章,敏感值在服务器端绑定,不会传递给模型。
1.0 版本新增双向函数调用,让航班选择器能够即时检查余票,同时还加入了无障碍支持和元数据扩展。开源渲染器覆盖网页端的 React、Angular 和 Lit,以及 Flutter 和 SwiftUI;Jetpack Compose 渲染器仍停留在 0.9.1。网页和 Flutter 渲染器可在 MCP Apps 中运行,因此也能用于 Claude 或 Gemini 等助手;除已有的 Python 智能体 SDK 外,还新增了 TypeScript 和 Dart 版本。Atlassian 已在 Jira 中使用该协议,负责工单的智能体可以通过交互式卡片向团队提问;Alation、Bloomberg 和 ByteDance 也在基于该协议开发产品。在 Google 内部,Gemini Notebook 已经使用该协议,Gemini Enterprise 则升级到 1.0。
🔗 A2UI 1.0(Google Developers Blog)
编程智能体:Delta 的 Cloud Runners、VS Code 1.146 和 Qwen Code 1.0 Preview
Delta 推出 Cloud Runners:无需依赖创建者的电脑,智能体线程也能持续运行
11月11日 — Zed 团队打造的多人协作智能体编程环境 Delta,正式推出前一天预告的 Cloud Runners。在会话线程的输入框中选择 Cloud 后,智能体的各轮操作便会在 Zed 托管、基于 E2B 的 Linux 沙箱中执行;用户可以从桌面端、网页端或手机跟进线程,并随时切回本地机器。运行器从 Delta 服务器获取代码,执行仓库的 .agents/setup 脚本(结果缓存一天),并使用用户配置的模型供应商和加密环境变量。获得授权后,git 和 gh 可代表用户在 GitHub 上操作,智能体还可以返回仅限有权访问该线程的人打开的预览网址。
| 运行器规格 | 分配的处理器 | 内存 | 可用磁盘空间 |
|---|---|---|---|
| 小型 | 2 CPU | 4 Go | 15 Go |
| 中型(默认) | 4 CPU | 8 Go | 30 Go |
| 大型 | 8 CPU | 16 Go | 50 Go |
在 Delta 筹备自身套餐期间,除 Student 外,所有 Zed 套餐均可免费使用计算资源,但受未公布具体数值的合理使用限制约束;模型费用仍按本地使用的方式计收。最多可同时运行六个运行器,终端会在一小时后关闭,运行器则会在闲置 10 分钟后暂停。
🔗 Delta 现已推出 Cloud Runners · Cloud Runners 文档
VS Code 1.146 弃用 Copilot 的 Local 运行框架,并为智能体会话新增 Inbox 模式
11月11日 — Microsoft 发布 VS Code 1.146,弃用 Copilot 的 Local 运行框架(Local harness):该框架将于 2027年2月移除,在此之前仍可使用,但功能冻结。此后的新功能将仅加入基于 Copilot SDK 构建的 Copilot 运行框架。从 VS Code 1.143 起,它就是新会话的默认选项,也是唯一会执行组织沙箱和权限策略的运行框架。
Agents 窗口新增实验性的 Inbox 模式,会将等待用户介入的会话置顶;聊天也可以在独立窗口中打开(预览功能)。Compare Models 支持 Copilot Fusion 及其思考强度等级。在安全方面,权限提示提供针对特定域名、命令或目录的精细授权;沙箱还可以隐藏环境变量,仅在向获准主机发送 HTTPS 请求时注入真实值。VS Code 也开始支持由 MCP 服务器提供的技能(SEP-2640,预览功能),Copilot 会话则会遵循 PAC 和 Kerberos 代理配置。
Qwen Code 1.0 Preview 将 Qoder 与 Qwen Code 的智能体整合到原生二进制程序中,无需 Node.js
11月11日 — 在 Qwen4-Max 发布数小时后,Qwen 推出预发布版 Qwen Code 1.0 Preview,整合了阿里巴巴编程环境 Qoder 与 Qwen Code 的智能体能力,包括理解代码库、实现功能、调试和测试。用户可通过 Qwen 或 Qoder 账户、QwenCloud 或 Model Studio,以及任何兼容端点接入。该工具提供适用于 macOS、Linux 和 Windows 的 x64 与 arm64 原生软件包(共八个压缩包,大小约为 57 至 74 Mo),无需单独安装 Node.js,并保留会话恢复和非交互式执行能力。
仓库提醒,界面和选项仍可能变化,而且在 2026年12月结束前不再接受社区的拉取请求。根据 GitHub API,1.0 标签与前一天发布的 v0.27.2 没有共同历史。
🔗 Qwen Code v1.0.0-preview(GitHub)
开放模型与研究:Tether 的 BotPsy 和 Hugging Face 的词元池化
BotPsy-0.8B:Tether 发布小型开放智能体模型,工具评测得分约为基础模型的两倍
11月11日 — 以 QVAC 名义发布成果的 Tether 人工智能团队 Tether AI Research,推出 BotPsy-0.8B。这款拥有 8 亿参数的模型专注于工具调用,旨在手机或笔记本电脑上运行。它以 Qwen3.5-0.8B 为基础,经过监督微调、从三个 Qwen3.5-4B 教师模型进行知识蒸馏,以及两轮强化学习。权重已在 Hugging Face 上提供,格式包括 safetensors 和 GGUF;模型说明页标注采用 Apache 2.0 许可证,博客文章则提到研究和教育用途。
| 评测基准(团队公布数据) | BotPsy-0.8B | Qwen3.5-0.8B(基础模型) | Qwen3.5-2B-Think |
|---|---|---|---|
| BFCL v4 | 44,0 | 23,4 | 37,7 |
| ACEBench | 58,7 | 30,1 | 55,4 |
| τ-bench | 51,5 | 23,2 | 46,5 |
| 六项工具评测基准的平均值 | 45,0 | 24,7 | 38,8 |
这些数据均由团队在推理模式下测得。团队还表示,在自动化攻击测试中,危险回答的比例从 36 % 降至 21 %;建议使用英语,并不建议将该模型用于敏感决策。
🔗 BotPsy(Hugging Face 上的 QVAC) · qvac/BotPsy-0.8B 模型
词元池化:Hugging Face 将向量数量降至四分之一,仍保留 97,8 % 的检索质量
11月11日 — 汤姆·阿尔森在 Hugging Face 博客上详细介绍了如何缩小 ColBERT 这类多向量检索索引的体积;此类索引为文档的每个词元保留一个向量。词元池化(token pooling)会合并相近的向量,而 Sentence Transformers 新增了损失函数 MultiVectorTokenPoolingLoss,让模型同时基于完整表示和压缩表示进行训练。
| 推理时的池化方式(NanoBEIR,nDCG@10) | 平均向量数 | 常规训练 | 感知池化的训练 |
|---|---|---|---|
| 无池化 | 193,22 | 51,84 | 52,39 |
pool_factor=4 | 48,68 | 49,03 | 51,23 |
max_tokens=4 | 4,00 | 37,22 | 43,00 |
在向量数量降至四分之一后,以这种方式训练的模型仍保留原得分的 97,8 %,而常规训练仅保留 94,6 %。这些测量仅基于一种配置(ModernBERT-base,训练一个轮次),并在 Hub 上发布了两个检查点。
Pika 和 Runway 上的 Seedance 2.5 升级至 4K
11月11日 — ByteDance 开发、由 BytePlus 提供的 Seedance 2.5 视频模型开始支持 4K。Pika 在自身平台和 Pika API Club 中开放原生 4K,建议先制作草稿镜头,再以 4K 完成最终版本;自 8月17日起,Pika 此前提供的是 1080p 输出,再放大(upscale)至 4K。不到两小时后,Runway 也宣布在其平台上提供 4K 的 Seedance 2.5,但未说明是否为原生 4K。双方均未公布价格、最长时长或所需点数。
🔗 @pika_labs 公告 · @runwayml 公告
Git 修复六个漏洞,其中一个可在递归克隆时执行代码
11月10日 — 人工智能领域之外,Git 项目发布 Git 2.56.1,并向旧版本回移补丁,最低覆盖至 Git 2.50.2,以修复六个漏洞。伊莱贾·纽伦在 GitHub Blog 上详细介绍了这些漏洞。
| 已修复的漏洞 | 风险类型 |
|---|---|
| CVE-2026-111760 | 递归克隆时,通过子模块的 .git 文件执行代码 |
| CVE-2026-113408 | 通过服务器通告的 HEAD 实现路径遍历 |
| CVE-2026-114467 | 移除 GPG 签名时发生栈损坏 |
| CVE-2026-114469 | 应用二进制补丁时发生越界读取 |
| CVE-2026-105437 | 大规模合并时发生堆损坏 |
| CVE-2026-114466 | 通过 git fast-import 流访问文件系统 |
GitHub 已在 github.com 和 Enterprise Cloud 上部署补丁,并发布 GitHub Enterprise Server 3.19.15、3.20.11、3.21.9 和 3.22.4;同时正准备发布内置已修复 Git 的 GitHub Desktop 和 GitHub Copilot 应用版本。建议更新 Git 及所有内置 Git 副本的应用;如果无法更新,则仅从可信服务器克隆。
简讯
编程智能体与开发工具
- Zed 1.28 与 1.29 预览版 — 1.28 进入稳定版,纳入了 11 月 4 日报道的预览版功能(最新版 Agent Client Protocol、将
read_file的读取内容截断至 2 000 个字符、可选的自动 Git 抓取)。1.29 预览版在 Anthropic 提供商中支持 Claude Fable 5.2 和 Claude Mythos 5.2。🔗 来源 - Antigravity CLI 1.5.4 与 1.5.5 — 1.5.5 在终端中提供 /swarm 预览功能,配有全屏视图 /swarm board,并修复了 Claude Code 插件命令和钩子的导入问题。1.5.4 向 ACP 会话开放 Auto 模式,并丰富了传递给钩子的数据。🔗 来源
- Gemini CLI — v0.68.0 发布后的第二天没有新版本,夜间构建也再次失败,自 11 月 5 日起每晚都是如此。主分支合入了四项修复,其中一项解决了模型针对图像或二进制文件返回空轮次后出现的 400 错误。🔗 来源
- Copilot CLI 1.0.110-1 — 此预览版仅包含 13 项修复:恢复的会话无法再被并行修改,本地 MCP 服务器返回被截断的 Unicode 字符时也不再导致工具调用卡住。SDK 1.0.32-preview.1 支持选择 Copilot Fusion 及其级别。🔗 来源
- Genspark 上的 Gemini 4 Carbon — Genspark 在其 AI Chat 和 Code Agent 中开放 Gemini 4 Carbon;此前一天,同一 Code Agent 刚接入 Claude Fable 5.2。此次未说明适用套餐或积分消耗。🔗 来源
- Basis 与 Devin for Startups — Cognition 通过视频展示了 Basis 如何与 Devin 协作;Basis 的会计智能体将某些任务的耗时从 20 小时缩短到 30 分钟,这一数字指的是 Basis,而非 Devin。Cognition 还重新推出 Devin for Startups,为入选团队提供 65 000 美元额度。🔗 来源
- shem — 若昂·加莱戈发布了一个实验性运行时,可以像启动容器镜像一样启动 Hugging Face 模型(Dockerfile 可以以
FROM hf.co/...开头),反过来也能在由模型权重构成的处理器上运行容器;据他所说,这种方式“大多数时候”都能奏效。🔗 来源
GitHub
- 由 GitHub Apps 管理的 Copilot 席位 — 企业级 GitHub Apps 可以借助新增的细粒度权限 Enterprise Copilot license management,调用 Copilot 席位管理 API,为企业用户和团队分配席位。🔗 来源
- Dependabot 与不活跃的仓库 — 自 12 月 8 日起,GitHub 将停用大多数一年内没有活动的仓库的 Dependabot 警报;警报会被归档而非删除,首次推送后便会恢复。GitHub Enterprise Server 不受影响。🔗 来源
- 个人账户的议题类型与字段 — 此前仅面向组织的这些功能现已在个人仓库中正式开放:最多支持 25 种类型和 25 个字段,可用于项目,也可通过 REST 和 GraphQL API 以及网络钩子使用。🔗 来源
- GitHub 仪表板 — 布局更加紧凑,可显示六个拉取请求和六个议题,此前各为三个;支持固定 Feed 或 Home 标签页,并在账户没有智能体会话时隐藏对应区域。🔗 来源
企业与应用
- Singapore Airlines — 其聊天机器人 Kris 基于 OpenAI API 重写后,客户满意度得分翻倍;通话摘要使客服人员的处理时长缩短约 10 %,超过 60 % 的员工每月使用内部平台 Jarvis。🔗 来源
- Cogent Security — 这家初创企业基于 GPT-6.1 Sol、GPT-6 Astra 和 GPT-5.6 构建网络防御智能体,并在每次工具调用前检查是否符合策略;据该公司称,一家 Fortune 1000 汽车行业客户修复关键漏洞的平均耗时缩短了 75 %。🔗 来源
- JioStar — 其在 JioHotstar 中用于发现内容的语音助手,基于 OpenAI API 在约八周内构建完成,支持超过 15 种语言,所在平台拥有超过 5 亿用户;据 JioStar 称,该助手超过 60 % 的用户选择语音交流,而非打字。🔗 来源
- 面向退伍军人的 ChatGPT Plus — 值退伍军人节之际,OpenAI 表示,一年内已有超过 20 000 名退伍军人和正在转入平民生活的军人领取了免费的一年期 ChatGPT Plus,另有近 1 000 名军人社群成员接受了培训。🔗 来源
- ChatGPT 中的 fal 插件 — fal 推介了其可在对话中生成和编辑图像、视频的插件,并展示了一支 60 秒广告,使用 GPT Image 2.6、FLUX 3 Max(26 个镜头)和 fal Recast 制作;未说明该插件的上线日期。🔗 来源
- Grok Bot 中的 Gopuff — Grok Bot 现已支持在 Gopuff 上全程代购食品杂货、零食和日用品;据 Gopuff 称,最快可在 15 分钟内送达,未说明适用国家或套餐。🔗 来源
- Genspark Genius — Genspark 招募品牌大使:每月分享一项创作,即可获得 Pro 套餐、新功能抢先体验、积分以及官方渠道推广。🔗 来源
模型、媒体与研究
- MiniMax H3 — 开放权重 100 天后,MiniMax 声称已有 1 472 个衍生模型,在 Hugging Face 上的下载量超过 1.48 亿次,这些数字尚未核实;H3-Image 已上线 fal、Runware、EvoLink 和 Miora,其中 Miora 免费提供至 11 月 17 日。🔗 来源
- AI Engineer Paris 上的 Voxtral Transcribe 3 — Mistral 为主舞台的全部演讲提供了实时转录,并向模型提供演讲者姓名和议程术语以引导识别,但未公布由此带来的提升幅度。🔗 来源
- Google AI Edge Gallery 中的本地语音功能 — 该应用新增离线语音识别和语音合成:在 Android 上,ML Kit 支持转录超过 100 种语言,速度达到实时语速的十倍;Parakeet-TDT 0.6B 和 Kokoro-82M 等开放模型则覆盖其他平台。🔗 来源
- NVIDIA 的 Déjà View — 这个拥有 117M 参数的三维重建模型重复使用同一个 Transformer 模块,在五项基准测试上追平了规模最高达其 10 倍的模型;该成果将在 NeurIPS 2026 作口头报告,论文已于 5 月发布在 arXiv 上。🔗 来源
- 西班牙语医疗文本中的疾病识别 — OpenMed 发布了两个采用 Apache-2.0 许可的开放模型,可在 CPU 上运行;据团队称,在 DisTEMIST 上微调后,F1 从通用模型的约 36 至 39 提升到了 GLiNER2.5 版本的约 73。🔗 来源
- 智能体的 x402 支付 — 在独立决策时,Qwen3 235B、DeepSeek V4 Pro 和 Llama 3.3 70B 在 Fizzl 测试中分别获得 59、55 和 30 分,无一通过;当支付由代码决定时(x402-safe-fetch),得分提升至 94、100 和 94。🔗 来源
- FiftyOne 中的 GR00T-X-Embodiment-Sim — 哈普里特·萨霍塔(Voxel51)转换了 NVIDIA 数据集中的 42 段仿真序列,涵盖七种机器人形态,每种六段,并对齐了相机数据与关节遥测数据。🔗 来源
生态
- Sakana AI — 退役海军上将、美国国家安全局前局长迈克尔·罗杰斯,以及在美国中央情报局任职近 30 年的汤姆·莫兰,成为这家东京初创企业在国防与网络安全领域的高级顾问。🔗 来源
- NVIDIA 的回收应用 — 值 COP31 之际,NVIDIA 介绍了其 Inception 计划中四家利用计算机视觉进行垃圾分类的初创企业,其中 Greyparrot 将检查 15 吨垃圾的耗时从 375 小时缩短到 6 小时;此次没有新的 NVIDIA 产品。🔗 来源
- Perplexity 的人工智能合规指南 — 该指南梳理了欧盟《人工智能法案》、NIST AI RMF 和 ISO/IEC 42001,并为智能体提出三项控制措施:仅授予必要访问权限、记录每项操作,以及由人类审批影响重大的操作。🔗 来源
- Perplexity 的 MCP 架构指南 — 涵盖主机、客户端与服务器的角色,JSON-RPC 2.0 消息、本地传输与 Streamable HTTP,以及多租户部署:这是继 11 月 4 日安全指南之后的一篇技术介绍,没有产品公告。🔗 来源
- Cohere 多伦多黑客松 — Cohere 将于 2027 年 1 月 30 日与多伦多大学联合举办其首场黑客松 Hacking Higher Ed,主题为人工智能在高等教育中的应用;奖金分别为 3 000、2 000 和 1 000 美元,报名截止日期为 1 月 22 日。🔗 来源
这意味着什么
Google DeepMind 正将其模型应用于两个验证比生成更重要的问题。AlphaGenome 2 不再只提供按组织计算的平均结果:它能预测变异在研究者关注的细胞中的影响,其提升通过 TenK10K 衡量,这是一份涵盖 28 种免疫细胞类型的图谱。AlphaProof Code 将形式化验证从协议设计推进到编译后的代码,并明确划分了工作:智能体编写超过六百万行证明,Lean 验证器检查每一步,人类复核规范和约 1 % 的代码。两项公告都存在局限:AlphaGenome 2 仍仅限研究使用,而有关 Signal 的首创性说法来自 Google DeepMind 自己。
安全性研究正遇到自身测量工具的局限。OpenAI 发现,作为其监测支柱之一的思维链,随着预训练推进而变得越来越难以解读;它也认为,两个指标之一的可控性存在较大噪声。Perplexity 表明,传统夺旗赛形式会让智能体偏离需要测试的边界,而且在三次试验和修复前的配置下,专门用于网络安全的模型可能表现得不如其通用版本。在这两种情况下,结论既关乎模型本身,也同样关乎评估方式。
当天的动态清楚区分了已经交付的内容与刚刚宣布的内容。Runway 发布了 Praxis-1 的权重、微调代码和报告,报告显示该模型的表现低于四个竞争条目;Tether 则提供了 BotPsy 下载。相比之下,Qwen4-Max 发布时没有提供基准测试、规模或价格,ElevenLabs 自己也区分了今天已开放的内容(Marketplace、Partner Program、ElevenAI)与之后才会推出的内容(Interaction Engine、Memory、Routines、微调)。对于想要测试的人来说,后半部分仍然只是承诺。
智能体开始持续运行,并融入团队。Grok Bot 1.0 加入会议,并在 Slack 和 Teams 中与其他 Bot 协调;Delta 的 Cloud Runners 无需会话发起者的电脑也能运行智能体会话;VS Code 为等待决策的会话新增了收件箱;A2UI 让智能体可以用界面而非文字作答。各家也对新增能力带来的风险设置了约束:Grok Bot 按人设置权限,并在向公开频道发言前进行检查;Delta 提供私密预览;VS Code 则在沙箱中限定授权范围并隐藏变量。
来源
- AlphaGenome 2(Google DeepMind)
- AlphaGenome 2(@GoogleDeepMind)
- AlphaProof Code 简介(Google DeepMind)
- Signal 的形式化验证(PDF,Google DeepMind)
- Qwen4-Max 预览版(@Alibaba_Qwen)
- Token Plan(QwenCloud)
- Praxis-1 现已发布(Runway)
- Praxis-1 技术报告(Runway)
- Praxis-1 合集(Hugging Face)
- ElevenLabs 纽约峰会(ElevenLabs)
- 峰会公告(@ElevenLabs)
- ElevenLabs 与 NVIDIA(ElevenLabs)
- 全面重置使用限额(@ClaudeDevs)
- Grok Bot 1.0(SpaceXSI)
- Grok Bot 1.0(@SpaceXSI)
- 停用 ChatGPT 中的 Advanced 与 Standard 语音(OpenAI 帮助)
- 停用 Advanced 与 Standard 语音(@OpenAINewsroom)
- Apple CarPlay 上的 Gemini(blog.google)
- 模型生命周期各阶段的思维链可监测性(OpenAI)
- 杰弗里·王的系列帖子
- 逃离 SPACE:第二部分(Perplexity)
- 逃离 SPACE:第二部分(@perplexity_ai)
- Gemini Decision 1(Google AI Studio)
- Decisions API(Google AI Studio)
- A2UI 1.0(Google 开发者博客)
- Cloud Runners 现已上线 Delta
- Cloud Runners 文档(Delta)
- VS Code 1.146 版本说明
- Qwen Code v1.0.0-preview(GitHub)
- BotPsy(Hugging Face 上的 QVAC)
- qvac/BotPsy-0.8B 模型(Hugging Face)
- 感知词元池化的训练(Hugging Face)
- 4K 版 Seedance 2.5(@pika_labs)
- 4K 版 Seedance 2.5(@runwayml)
- Git 安全漏洞公告(GitHub 博客)
- Zed v1.28.1(GitHub)
- Antigravity 更新日志
- Gemini CLI,PR 30228(GitHub)
- Copilot CLI v1.0.110-1(GitHub)
- Genspark 中的 Gemini 4 Carbon(@genspark_ai)
- Basis 与 Devin for Startups(@cognition)
- 你的大语言模型现在是一个容器(Hugging Face)
- 通过 GitHub Apps 管理 Copilot 席位(GitHub 更新日志)
- Dependabot 将暂停不活跃仓库的警报(GitHub 更新日志)
- 个人账户的议题类型与字段(GitHub 更新日志)
- 信息更丰富的 GitHub 仪表板(GitHub 更新日志)
- Singapore Airlines(OpenAI)
- Cogent Security(OpenAI)
- JioStar,维贾伊·塞沙德里(OpenAI)
- 面向退伍军人的 ChatGPT Plus(OpenAI)
- ChatGPT 中的 fal 插件(@fal)
- Grok Bot 中的 Gopuff(@bot)
- Genspark Genius(@genspark_ai)
- MiniMax H3,100 天(@RyanLeeMiniMax)
- AI Engineer Paris 上的 Voxtral Transcribe 3(@MistralAI)
- Google AI Edge Gallery 中的本地语音功能(Google 开发者博客)
- Déjà View(@NVIDIAAI)
- 识别西班牙语临床文本中的疾病(OpenMed)
- 配备钱包的开放人工智能模型(Fizzl)
- FiftyOne 中的 GR00T-X-Embodiment-Sim(Hugging Face)
- 迈克尔·罗杰斯与汤姆·莫兰(Sakana AI)
- 人工智能回收初创企业(NVIDIA 博客)
- 人工智能合规(Perplexity)
- MCP 架构(Perplexity)
- Hacking Higher Ed(@cohere)