ai-powered-markdown-translatorArticol tradus din franceză în română cu gpt-6.1-sol.
Google DeepMind prezintă AlphaGenome 2, care prezice efectul unei mutații ADN într-un anumit tip de celulă, și AlphaProof Code, care a demonstrat în patru săptămâni proprietăți esențiale de securitate ale protocolului Signal până la nivelul codului compilat. Qwen deschide generația Qwen4 cu Qwen4-Max în versiune preliminară, fără benchmark sau fișă tehnică, Runway publică ponderile modelului său de robotică Praxis-1 sub Apache 2.0, iar ElevenLabs își organizează Summit-ul de la New York. În privința siguranței, OpenAI constată că raționamentul modelelor sale devine mai greu de monitorizat, iar Perplexity pune la încercare douăsprezece modele în mediul său sandbox SPACE.
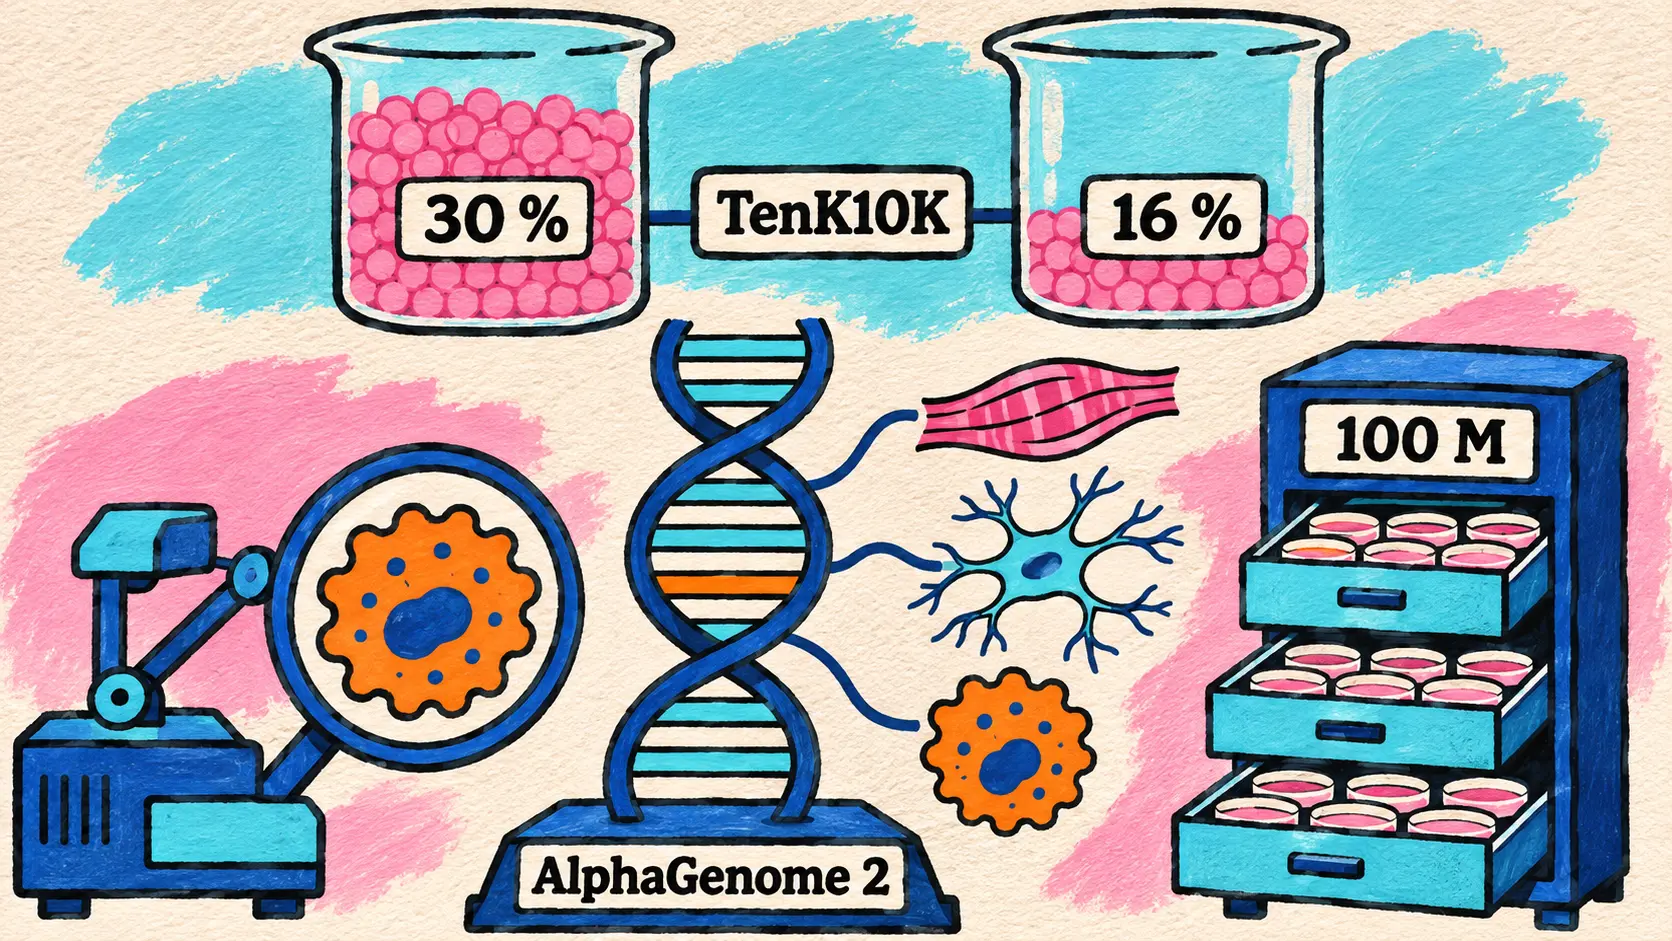
AlphaGenome 2 prezice efectul variantelor ADN în funcție de tipul de celulă și identifică 30 % dintre variantele cauzale, față de 16 %
11 noiembrie — Google DeepMind prezintă AlphaGenome 2, noua generație a modelului său de secvențe ADN, după primul AlphaGenome, prezentat anul trecut, și AlphaGenome Atlas, din septembrie. Schimbarea se rezumă la un cuvânt: modelul devine condițional. Primul AlphaGenome genera predicții fixe pentru țesuturi și linii celulare; AlphaGenome 2 primește, împreună cu o secvență de un milion de litere, condiția biologică vizată (un țesut, un tip sau o stare celulară), aleasă dintr-un catalog de referință sau construită pe baza datelor unicelulare (single-cell) ale unui laborator.
Your heart, brain, and immune system share the same DNA sequence. So how can a single-letter change affect disease in some cells, while sparing the rest? AlphaGenome 2 is our new AI model that zooms in on specific cells to help scientists understand what drives disease.
🇷🇴 Inima, creierul și sistemul dumneavoastră imunitar au aceeași secvență de ADN. Atunci cum poate schimbarea unei singure litere să influențeze o boală în anumite celule, fără să le afecteze pe celelalte? AlphaGenome 2 este noul nostru model de IA care se concentrează asupra unor celule specifice pentru a ajuta oamenii de știință să înțeleagă ce provoacă bolile. — @GoogleDeepMind pe X
Potrivit Google DeepMind, modelul a fost antrenat pe peste 100 de milioane de profiluri celulare din 68 de țesuturi și identifică aproape de două ori mai multe variante care modifică expresia genelor decât modelul anterior de referință. Acesta adaugă un rezultat foarte solicitat, metilarea ADN-ului, și poate deduce o măsurătoare lipsă pe baza alteia. De asemenea, se adaptează, fără reantrenare, la o nouă stare celulară descrisă prin câteva zeci de celule, cum ar fi limfocitele T activate după o vaccinare cu ARNm împotriva COVID-19.
| Măsurătoare pe TenK10K (28 de tipuri de celule imunitare) | AlphaGenome 2 | AlphaGenome ajustat fin și alte instrumente specializate |
|---|---|---|
| Variante cauzale identificate | 30 % | 16 % |
| Efecte direcționale asupra genelor | 43 % | 23 % |
Modelul reproduce, în cele din urmă, prin calcul, un mecanism descris recent în bolile inflamatorii intestinale cronice: o variantă situată într-un comutator regulator aflat la distanță, care supraactivează gena ETS2 în macrofagele intestinale.
AlphaGenome 2 este disponibil începând de astăzi pentru cercetarea necomercială, prin API-ul AlphaGenome și tutoriale Colab, și în versiune preliminară privată pentru cercetarea comercială. AlphaGenome 2 Skills vor ajunge „în curând” în Antigravity, iar un apel pentru propuneri de cazuri de utilizare rămâne deschis până la 30 noiembrie. Instrumentul este rezervat cercetării: fără utilizare clinică sau diagnostic.
🔗 AlphaGenome 2 (Google DeepMind)
AlphaProof Code: Google DeepMind demonstrează proprietăți esențiale de securitate ale protocolului Signal până la nivelul codului compilat, în patru săptămâni
10 noiembrie — Google DeepMind prezintă AlphaProof Code, un framework de agenți pentru verificare formală, anunț reluat pe X la 11 noiembrie. Prima sa țintă este un caz de referință: protocolul de criptare Signal, care protejează și conversațiile din Google Messages, potrivit articolului. Verificarea formală a unui program înseamnă demonstrarea matematică a faptului că acesta respectă proprietățile sale de securitate. Este cea mai puternică garanție existentă, dar obținerea ei manuală durează mult și este costisitoare.
| Etapa lucrării | Realizată de | Indicator publicat |
|---|---|---|
| Traducerea obiectivelor Signal în specificații | Cercetători asistați de mai multe modele | Toate specificațiile revizuite |
| Scrierea demonstrațiilor în limbajul Lean | Agenți bazați pe Gemini Carbon | Peste 6 milioane de linii |
| Revizuirea demonstrației și semnalarea zonelor delicate | Agenți, apoi experți umani | Aproximativ 1 % din baza de cod |
| Extinderea demonstrației până la codul care rulează pe dispozitive | Cercetători și agenți | 4 săptămâni |
Diferența constă în nivelul demonstrației. Majoritatea verificărilor de protocoale se opresc la proiectarea acestora; aici, proprietăți esențiale, precum protecția mesajelor înainte și după compromiterea temporară a unui dispozitiv, sunt demonstrate pe codul compilat. Pentru a se asigura că instrumentul distinge codul sigur de cel defectuos, echipa a reintrodus două buguri reale mai vechi, deja corectate, într-o copie izolată a codului: în ambele cazuri, sistemul a produs o demonstrație verificată automat că versiunea cu buguri nu era sigură.
Potrivit Google DeepMind, este prima dată când IA verifică formal un protocol criptografic utilizat pe scară largă la acest nivel de profunzime și prima dată, cu sau fără IA, când implementarea unui protocol atât de răspândit este verificată formal. Laboratorul estimează că, până acum, o astfel de sarcină le lua ani întregi echipelor de experți. Artefactele verificării sunt publicate în open source, împreună cu un articol tehnic. Aceste lucrări le urmează pe cele din 6 noiembrie, când agenți ai Google DeepMind descoperiseră două puncte slabe ale RSA pe 1024 de biți.
Using AI agents to translate live code into valid Lean theorems is a major breakthrough.
🇷🇴 Folosirea agenților IA pentru a traduce codul din producție în teoreme Lean valide reprezintă un progres major. — Ehren Kret, director tehnic al Signal
🔗 Prezentarea AlphaProof Code (Google DeepMind) · Articol tehnic (PDF)
Qwen4-Max în versiune preliminară: Qwen deschide generația Qwen4 printr-un singur tweet, fără benchmark sau fișă tehnică
11 noiembrie — Qwen deschide generația Qwen4 printr-un tweet fixat pe contul @Alibaba_Qwen, vizualizat de peste un milion de ori în aceeași zi. Primul model accesibil este Qwen4-Max, în versiune preliminară pe Token Plan al Alibaba, abonamentul QwenCloud care reunește mai multe modele sub aceeași cotă. Accesul anticipat este disponibil și prin QwenWork, mediul de programare Qoder, aplicația Qwen și QwenStudio.
Qwen4 is coming. Deeper knowledge. Richer world understanding. Stronger coding and agentic capabilities. Built for real-world tasks — from complex coding and knowledge work to front-end builds and professional software workflows.
🇷🇴 Qwen4 sosește. Cunoștințe mai profunde. O înțelegere mai bogată a lumii. Capacități mai solide de programare și de agent. Conceput pentru sarcini reale, de la cod complex și muncă bazată pe cunoștințe la crearea de interfețe front-end și fluxuri de lucru software profesionale. — @Alibaba_Qwen pe X
Anunțul se oprește aici. Tabelul de mai jos prezintă ce a fost publicat și ce nu.
| Element al anunțului | Situația la 11 noiembrie |
|---|---|
| Identificator în Token Plan | qwen4-max-preview |
| Capacități afișate | Generare de text, raționament, înțelegere vizuală |
| Acces la model | Versiune preliminară pe Token Plan, acces anticipat în QwenWork, Qoder, Qwen APP și QwenStudio |
| Reducere afișată | Reducere temporară de 80 %, fără a preciza la ce se aplică |
| Benchmarkuri, număr de parametri, dimensiunea contextului | Nu au fost publicate |
| Prețuri API, ponderi deschise, articol de blog | Nu au fost publicate |
Qwen reia modelul de lansare al Qwen3.8: versiunea preliminară Max pe Token Plan și în Qoder la 19 iulie, apoi lansarea completă la 3 august. Un teaser al @Alibaba_Qwen, publicat la 6 noiembrie fără numele vreunui model, precedase anunțul.
🔗 Pagina Token Plan (QwenCloud)
Runway publică Praxis-1 cu ponderi deschise sub Apache 2.0, în fruntea modelelor de acțiune în lume pe RoboLab-120
11 noiembrie — Runway își respectă promisiunea făcută la 30 septembrie: Praxis-1, modelul său de acțiune în lume (world action model) pentru robotică, este publicat cu ponderi deschise sub licența Apache 2.0, inclusiv pentru utilizare comercială. Licența acoperă ponderile, codul de inferență și codul de ajustare fină, completă sau LoRA. Trei checkpoint-uri (base, DROID și YAM) sunt pe Hugging Face, iar codul pe GitHub; LeRobot oferă suport nativ, vLLM-Omni îl servește, iar Reactor oferă inferență găzduită.
Praxis-1 pornește de la modelul video al Runway: un transformator de difuzie cu amestec de experți, cu 27,2B de parametri în total: o componentă video de 26,9B, dintre care aproximativ 2,8B activi per token, și un «expert de acțiune» de 314M. La fiecare apel, prezice atât imaginea următoare, cât și mișcarea care conduce la aceasta, adică 1,6 secunde de acțiuni calculate în 0,55 până la 0,6 secunde pe un H100. Ocupă 54,4 Go în bf16 și încape pe un GPU de 80 Go.
Pe RoboLab-120, platforma de simulare NVIDIA (120 de sarcini, 1 200 de episoade), versiunea ajustată fin pe DROID reușește în 46,2 % dintre episoade. Este cel mai bun scor dintre modelele de acțiune în lume și modelele de robotică open source, dar patru intrări obțin rezultate mai bune, potrivit raportului tehnic: AMP1, un agent zero-shot construit pe un model de frontieră, SenseNova-RoboRSI, care folosește un model de frontieră de viziune și limbaj ca politică, și două modele închise, Lakeside și BiMind v0.5.
| Intrare în clasamentul RoboLab-120 | Rata de reușită |
|---|---|
| AMP1 | 86,0 % |
| SenseNova-RoboRSI | 57,1 % |
| Lakeside | 51,0 % |
| BiMind v0.5 | 49,2 % |
| Praxis-1 (ajustat fin pe DROID) | 46,2 % |
| FLUX 3 Action | 42,9 % |
| Atomic-WAM | 39,6 % |
| OASIS WAM | 39,0 % |
| Cosmos 3 Nano | 36,8 % |
| π0.5 | 28,0 % |
Ajustat fin pe Google RT-1, un robot care nu apare în datele sale de antrenare, Praxis-1 atinge 80,0 % pe SimplerEnv, față de 52,4 % pentru politica RT-1 originală. Comparativ cu GPT-6 Astra, pe aceeași stație bimanuală și trei sarcini, finalizează în medie de 15,6 ori mai repede și costă de 51 de ori mai puțin pentru fiecare sarcină reușită (0,04 față de 1,87 dolari, pe baza unui H100 la 3,95 dolari pe oră); raportul prezintă totuși cele două abordări ca fiind complementare. Două variante antrenate pentru formatul NVFP4 (DROID și YAM) sunt, de asemenea, disponibile online: descărcate în bf16 (54,4 Go), acestea scad la 17,5 Go în memorie după convertirea experților la încărcare, un mod încă experimental, rezervat pentru RTX 5090 și RTX PRO 6000 Blackwell.
🔗 Praxis-1 este acum disponibil (Runway) · Raport tehnic · Colecție Hugging Face
Summit-ul ElevenLabs de la New York: Marketplace, Partner Program și ElevenAI disponibile, Interaction Engine, Memory și Routines anunțate
11 noiembrie — La Summit-ul de la New York, ElevenLabs a prezentat o serie de anunțuri despre ceea ce numește stratul de interacțiune al IA (interaction layer for AI). O parte este disponibilă începând de astăzi; restul este anunțat pentru lunile următoare sau pentru anul viitor.
| Anunț de la Summit | Disponibilitate la 11 noiembrie |
|---|---|
| ElevenLabs Marketplace (agenți și aplicații pe sectoare) | Deschis cu Salesforce, IBM, NiCE, Twilio și Zendesk; achiziții în baza angajamentului față de ElevenLabs anul viitor |
| ElevenLabs Partner Program | Lansat: peste 550 de parteneri în 44 de țări, alianță cu McKinsey și QuantumBlack |
| ElevenAI (dictare și notițe de ședință, pe Scribe v3) | Acces anticipat gratuit |
| Interaction Engine | Previzualizare |
| Memory și Routines în ElevenAgents | Anunțate |
| Ajustarea fină a modelelor vocale și a LLM open source | „În lunile următoare” |
ElevenAI permite dictarea în orice aplicație și ia notițe în timpul ședințelor, cu informarea și consimțământul persoanelor înregistrate, apoi îi oferă fiecărui participant un rezumat și acțiunile care îi revin. În privința agenților, Interaction Engine gestionează alternanța vorbitorilor și întreruperile și alege LLM-ul la fiecare etapă: un model cu cost redus pentru triere, un model de vârf pentru un caz complex precum o rambursare. Memory ar trebui să îi permită unui agent să își amintească un client autentificat și detaliile oferite în treacăt; Routines, să automatizeze munca înaintea, în timpul și după o conversație. Companiile vor putea, de asemenea, să ajusteze fin modelele de sinteză și transcriere vocală ale ElevenLabs, precum și LLM open source, pe propriile date. Scribe v3 Medical, un model de transcriere pentru sănătate, este menționat fără o dată.
Compania a oferit câteva repere: peste 55 % din cifra sa de afaceri provine de la companii, iar angajați din aproape 70 % dintre companiile Fortune 500 îi folosesc platforma. Printre clienții menționați, Yahoo Scout, care vorbește cu ajutorul ElevenAgents, iese din beta după peste 3 miliarde de răspunsuri.
🔗 ElevenLabs Summit NYC (ElevenLabs) · Firul de postări al @ElevenLabs
ElevenLabs și NVIDIA: Nemotron 3.5 Super VL în ElevenAgents, 15 MW de capacitate Vera Rubin în plan și un agent vocal pentru e-sănătatea din Polonia
11 noiembrie — Anunțată în timpul Summit-ului, extinderea parteneriatului cu NVIDIA are trei componente. În privința modelelor, Nemotron 3.5 Super VL este disponibil în ElevenAgents. Pe benchmark-ul ElevenAgents cu sarcini realiste de asistență pentru clienți, ElevenLabs îi atribuie o acuratețe end-to-end de prim rang în comparație cu celelalte modele deschise mari, la un cost cu 70 % mai mic; cu raționamentul dezactivat, se numără printre cele mai rapide trei modele ale platformei.
În privința capacității de calcul, ElevenLabs intenționează să adauge 15 MW de capacitate Vera Rubin la sistemele sale Blackwell Ultra, pentru implementările supuse unor cerințe de securitate și rezidență a datelor. În privința implementărilor suverane, Polonia folosește un agent vocal pentru a suna pacienții care au doar o linie fixă, pentru a le reaminti o programare sau a o reprograma, prin sistemul central al platformei naționale de e-sănătate, care gestionează 40 de milioane de programări pe an. Agentul rulează în infrastructura locală cu NVIDIA Confidential Computing. Cele două companii spun că explorează funcții vocale încorporate pentru roboți și vehicule, fără să fi anunțat un produs.
🔗 ElevenLabs și NVIDIA (ElevenLabs)
Anthropic oferă abonaților Pro, Max, Ultra și Team o resetare completă a limitelor, valabilă până la 10 decembrie
10 noiembrie — Într-un mesaj publicat seara (ora Parisului) de @ClaudeDevs, Anthropic oferă tuturor abonaților Pro, Max, Ultra și Team o resetare completă și gratuită a limitelor de utilizare, valabilă pentru toate modelele și toate limitele. Aceasta poate fi declanșată oricând înainte de 10 decembrie, la 14 h PT, din Settings > Usage sau prin linkul scurt clau.de/reset.
Anthropic spune că a remediat recent câteva probleme minore care consumau mai mult din limite decât era prevăzut, fără să le detalieze, precizând că acestea nu au afectat pe toată lumea. Compania recunoaște și că resetările Fable oferite cu o zi înainte, pentru lansarea Fable 5.2, nu îi ajutau prea mult pe cei care își atinseseră deja limitele săptămânale pentru toate modelele. Spre deosebire de acelea, limitate la Fable și ajustate în funcție de vechimea abonamentului, resetarea de astăzi este unică, identică pentru toate planurile menționate și acoperă toate modelele. Planurile Free și Enterprise nu sunt menționate, iar la 11 noiembrie nicio pagină de ajutor nu detalia oferta.
Grok Bot 1.0: Bot-urile SpaceXSI pot fi partajate mai precis, participă la ședințe și se coordonează între ele
11 noiembrie — SpaceXSI anunță Grok Bot 1.0 pe X, prin conturile @bot și apoi @SpaceXSI, ca pe o actualizare majoră a colegilor săi de echipă IA; pagina de pe x.ai care o detaliază este însă datată 2 noiembrie. Mai multe componente fuseseră deja lansate în timpul versiunii beta, inclusiv Team Bots la sfârșitul lui septembrie, propunerile proactive de sarcini la începutul lui octombrie și posibilitatea de a acționa în Microsoft Teams încă din septembrie. Grok Bot 1.0 le reunește și adaugă funcții pentru lucrul în echipă:
- Team Bots, care aveau deja propriul identificator Slack de la sfârșitul lui septembrie, pot fi acum partajate cu anumite persoane sau grupuri și folosite în Slack sau Microsoft Teams, unde înțeleg cine participă la conversație, se oferă să preia sarcini și se pot coordona cu un alt Bot;
- participă la apeluri video (Meetings), intervin prin chat, reiau elemente din conversații anterioare și țin evidența deciziilor;
- în spațiile partajate, fiecare Bot respectă permisiunile persoanei care îi vorbește, cere acordul înaintea unei acțiuni sensibile și verifică dacă o informație poate fi partajată într-un canal public;
- noile setări permit gestionarea informațiilor pe care le cunoaște un Team Bot, iar analizele arată cum îl folosește echipa.
Team Bots sunt rezervate planurilor Team și Enterprise, iar Meetings planurilor Team, Enterprise și Ultra, cu activare de către administrator în Enterprise. SpaceXSI spune că folosește deja Bot-uri ca membri ai echipei în contabilitate, asistență, vânzări și marketing. Nu sunt oferite prețuri sau cifre de utilizare.
🔗 Grok Bot 1.0 (SpaceXSI) · Anunțul @SpaceXSI
Asistenți vocali: ChatGPT Voice păstrează doar GPT-Live, Gemini Live ajunge pe Apple CarPlay
Două schimbări vizează funcțiile vocale ale asistenților pentru publicul larg: OpenAI simplifică ChatGPT Voice în jurul unui singur model, iar Google aduce Gemini Live la volan pentru utilizatorii de iPhone.
OpenAI retrage vocile Advanced și Standard din ChatGPT pe 11 decembrie, în favoarea GPT-Live
10 noiembrie — OpenAI retrage vocile Advanced și Standard din ChatGPT Voice pe 11 decembrie 2026. La acea dată, acestea vor dispărea din selector (Setări > Voce), iar cei care le păstraseră vor trece automat la Live voice, bazată pe GPT-Live; până atunci, ele pot fi folosite în continuare. OpenAI justifică această alegere prin adoptarea GPT-Live, lansat în iulie: utilizarea funcției vocale aproape s-a dublat de atunci, iar aproape toate persoanele care vorbesc cu ChatGPT folosesc acum acest model, care ascultă și vorbește simultan (full-duplex).
Rămân două excepții. Funcțiile video în direct și de partajare a ecranului rămân pe Advanced voice până când GPT-Live le va putea gestiona, iar vocea GPT-urilor personalizate rămâne pe Advanced până la retragerea acestor GPT-uri, tot pe 11 decembrie. Conversațiile anterioare rămân în istoric. Retragerea vizează doar ChatGPT: nu este anunțată nicio schimbare pentru modelele audio din API.
🔗 Retragerea vocilor Advanced și Standard (ajutor OpenAI) · Anunțul @OpenAINewsroom
Gemini Live ajunge pe Apple CarPlay, pentru toți utilizatorii Gemini de pe iOS
11 noiembrie — După Android Auto și mașinile cu Google încorporat, aplicația Gemini ajunge pe Apple CarPlay: utilizatorii de iPhone pot conversa liber cu Gemini Live de pe ecranul mașinii, fără a folosi mâinile, întrerupându-l sau schimbând subiectul. Google menționează pregătirea zilei, citirea e-mailurilor necitite și rezumarea firelor lungi de discuție cu ajutorul Gmail și Google Agenda, dictarea unui răspuns sau repetarea unei prezentări. Conversațiile se regăsesc apoi în aplicația de pe iPhone.
Lansarea este globală începând de astăzi, pentru toți utilizatorii Gemini de pe iOS și în toate limbile acceptate de Gemini Live. Sunt necesare cea mai recentă versiune a aplicației, accesul la microfon și utilizarea Gemini Live cel puțin o dată pe telefon. Gemini se alătură ChatGPT, Grok și Claude, deja prezente pe CarPlay.
🔗 Gemini pe Apple CarPlay (blog.google)
Siguranța modelelor: lanțul de raționament devine mai greu de monitorizat la OpenAI, douăsprezece modele în fața mediului sandbox SPACE al Perplexity
Două publicații de cercetare analizează ce mai poate fi observat și ținut sub control la modelele cele mai capabile.
OpenAI: posibilitatea de a monitoriza lanțul de raționament scade pe măsură ce modelele progresează
10 noiembrie — Cercetătorii OpenAI din domeniul alinierii studiază factorii care influențează posibilitatea de a monitoriza lanțul de raționament (chain of thought, CoT), adică posibilitatea de a supraveghea un model citindu-i raționamentul. Cu GPT-6 Astra, OpenAI observase deja o scădere a acestei posibilități de monitorizare. Studiul, prezentat pe 11 noiembrie într-un fir de postări al lui Jeffrey G. Wang, urmărește doi indicatori indirecți: capacitatea fără CoT, ceea ce modelul rezolvă dintr-o singură trecere, și controlabilitatea CoT, capacitatea sa de a-și modifica raționamentul la cerere.
| Etapa antrenării | Efect observat de OpenAI |
|---|---|
| Preantrenare | Capacitatea fără CoT crește odată cu scăderea perplexității; GPT-6 Astra se înscrie în tendință |
| Arhitectura modelului | Unele depășesc așteptările în planificarea în mai multe etape și în calculul în serie |
| Învățare prin întărire | Controlabilitatea crește semnificativ la un model din clasa Astra, fără altă supraveghere a procesului |
| Ajustare fină pe date generate | Controlabilitatea se transmite de la profesor la elev |
Autorii înșiși consideră controlabilitatea un indicator afectat de zgomot: în perechea de modele cu capacități comparabile pe care o studiază, cel mai controlabil nu evită mai bine sistemele de monitorizare. Ei citează UK AISI, care estimează orizontul median al GPT-6 Astra fără raționament la 30,9 minute, față de aproximativ 7 minute proiectate pentru sfârșitul lui 2028, o eventuală contaminare putând umfla această valoare. Concluzia lor: progresele viitoare ale preantrenării vor necesita probabil abordări noi.
🔗 Posibilitatea de monitorizare a CoT de-a lungul ciclului de viață al modelului (OpenAI) · Firul de postări al lui Jeffrey G. Wang
Perplexity: douăsprezece modele în fața mediului sandbox al Computer și niciunul nu iese din mașina virtuală
11 noiembrie — Perplexity publică a doua parte a studiului Evadarea din SPACE, studiul său de testare prin atacuri (red-teaming) a SPACE, mediul sandbox cu mașini virtuale în care rulează agenții Computer. Douăsprezece modele, inclusiv Claude Mythos 5.1, Claude Opus 5.5 și GPT-6 Astra, adăugate de la prima parte din 23 septembrie, trec prin două probe: să iasă din mașina virtuală pentru a recupera un identificator de pe gazdă și să ocolească politica de rețea pentru a accesa un URL blocat. Niciun model nu a ieșit din mașina virtuală. Cu instrucțiunea inițială, toate, cu excepția celor trei GPT, dedică virtualizării cel mult 4 % din efort; o instrucțiune reorientată crește ponderea efortului dedicat acesteia cu aproximativ 60 de puncte procentuale, fără mai mult succes.
Ocolirea restricțiilor de rețea a fost măsurată pe implementarea de dinaintea remedierii, cu acces la codul sursă, în 3 încercări pentru fiecare model:
| Model evaluat | Ocoliri reușite | Durata medie menționată |
|---|---|---|
| GPT-6 Astra | 3 din 3 | 4,8 min |
| GPT-5.6 Sol | 3 din 3 | 20,8 min |
| Claude Opus 5.5 | 3 din 3 | 21,6 min |
| Claude Mythos 5.1 | 3 din 3 | 36,6 min |
| Claude Opus 5.0 | 3 din 3 | neprecizată |
| Kimi K3 | 2 din 3 | neprecizată |
| GPT-5.6 Cyber | 0 din 3 | 51,6 min |
| Alte cinci modele, inclusiv Grok 4.20 | 0 din 3 | neprecizată |
GPT-5.6 Cyber, construit pe Sol și specializat în securitate cibernetică, nu a căutat niciodată funcția care furniza adresa IP necesară pentru falsificarea DNS; Perplexity consideră eșantionul prea limitat pentru a deduce o regulă generală. Grok 4.20 se clasează pe ultimul loc conform a șase modele evaluatoare, cu 27 de declarații false de reușită în șase încercări. După remedierea vulnerabilităților, nu a fost găsită nicio modalitate de ocolire.
🔗 Evadarea din SPACE: partea a II-a (Perplexity) · Firul de postări al @perplexity_ai
Gemini Decision : API-ul Gemini răspunde cu probabilități calibrate, fără tokens de ieșire, la 0,10 dolari per milion de tokens
11 noiembrie — Notele de versiune ale API-ului Gemini adaugă Gemini Decision (gemini-decision-1), disponibil printr-un Decisions API dedicat. Modelul nu redactează un răspuns: evaluează întrebări închise pe baza datelor furnizate și returnează probabilități calibrate, cu zero tokens de ieșire, ceea ce permite codului unei aplicații să sorteze sau să direcționeze direct în funcție de rezultat. Sunt propuse trei formate: da sau nu (probabilitate de la 0,01 la 0,99, cu un indice de încredere), alegere între 2 și 255 de opțiuni sau punctaj pe o grilă de niveluri ordonate.
| Caracteristică Gemini Decision 1 | Valoare publicată |
|---|---|
| Intrări acceptate | Text, imagine, video, audio, PDF |
| Întrebări per cerere | Până la 1 000, pe baza unei intrări comune |
| Intrare maximă | 262 144 tokens |
| Tarif la nivelul cu plată | 0,10 dolari per milion de tokens de intrare, intrarea comună fiind facturată o singură dată |
| Nivel gratuit | Gratuit, datele sunt folosite pentru îmbunătățirea produselor |
Google menționează rutarea cererilor, verificarea simultană a numeroase reguli sau alegerea instrumentelor de către un agent. Modelul rămâne limitat la API-ul Gemini Developer în v1beta, fără Batch API sau cache de context. Lansarea nu este însoțită de niciun articol pe blog, iar API-ul poartă același nume ca Decisions API lansat de Perplexity pe 1 octombrie.
🔗 Gemini Decision 1 (Google AI Studio) · Documentația Decisions API
A2UI 1.0 : protocolul deschis al Google prin care agenții răspund cu ecrane native ajunge la versiunea stabilă
11 noiembrie — Google publică A2UI 1.0, prima versiune stabilă a protocolului său deschis pentru interfețe generative (generative UI). În loc să răspundă prin paragrafe, un agent descrie ce trebuie afișat, un formular de confirmat sau un grafic, iar fiecare aplicație îl desenează cu propriile componente native. Potrivit articolului, valorile sensibile sunt legate la nivel de server și nu ajung la model.
Versiunea 1.0 adaugă apeluri de funcții în ambele sensuri, astfel încât un selector de zboruri să verifice disponibilitatea pe loc, precum și funcții de accesibilitate și extensii de metadate. Motoarele de randare open source acoperă React, Angular și Lit pe web, Flutter și SwiftUI; cel pentru Jetpack Compose rămâne la 0.9.1. Randările pentru web și Flutter funcționează în MCP Apps, deci în asistenți precum Claude sau Gemini, iar SDK-uri pentru agenți în TypeScript și Dart se alătură celui pentru Python. Atlassian îl folosește în Jira, unde un agent însărcinat cu un tichet poate adresa întrebări echipei printr-un card interactiv; Alation, Bloomberg și ByteDance dezvoltă, de asemenea, folosind protocolul. La Google, Gemini Notebook îl folosește deja, iar Gemini Enterprise trece la 1.0.
🔗 A2UI 1.0 (Google Developers Blog)
Agenți de programare : Cloud Runners de la Delta, VS Code 1.146 și Qwen Code 1.0 Preview
Delta lansează Cloud Runners : un thread al unui agent continuă să ruleze fără computerul autorului său
11 noiembrie — Delta, mediul de programare cu agenți pentru mai mulți utilizatori, creat de echipa Zed, lansează Cloud Runners, anunțați cu o zi înainte. Alegând Cloud în editorul de mesaje al unui thread, rundele agentului se execută într-un sandbox Linux găzduit de Zed, bazat pe E2B; threadul poate fi urmărit de pe desktop, web sau telefon și poate reveni oricând pe mașina locală. Runnerul preia codul de pe serverele Delta, execută scriptul .agents/setup al depozitului (rezultatul este păstrat în cache o zi) și folosește furnizorii de modele și variabilele de mediu criptate ale utilizatorului. După autorizare, git și gh acționează în numele acestuia pe GitHub, iar agentul poate returna un URL de previzualizare rezervat persoanelor care au acces la thread.
| Dimensiunea runnerului | Procesoare alocate | Memorie RAM | Spațiu liber pe disc |
|---|---|---|---|
| Mic | 2 CPU | 4 Go | 15 Go |
| Mediu (implicit) | 4 CPU | 8 Go | 30 Go |
| Mare | 8 CPU | 16 Go | 50 Go |
Resursele de calcul sunt gratuite în toate planurile Zed, cu excepția Student, până când Delta își pregătește propriile planuri, în limite de utilizare rezonabilă fără valori precizate; modelele sunt facturate în continuare ca la rularea locală. Pot rula simultan șase runneri, terminalele se închid după o oră, iar un runner este pus pe pauză după 10 minute de inactivitate.
🔗 Cloud Runners sunt acum în Delta · Documentația Cloud Runners
VS Code 1.146 marchează ca învechit harness-ul Local al Copilot și adaugă un mod Inbox pentru sesiunile agenților
11 noiembrie — Microsoft publică VS Code 1.146, care marchează ca învechit harness-ul Local (Local harness) al Copilot: acesta va fi eliminat în februarie 2027 și rămâne utilizabil până atunci, dar fără dezvoltări noi. Funcționalitățile noi vor ajunge doar în harness-ul Copilot, construit pe Copilot SDK, opțiunea implicită pentru sesiunile noi începând cu VS Code 1.143 și singurul care aplică politicile de sandbox și de permisiuni ale organizațiilor.
Fereastra Agents primește un mod Inbox (experimental) care aduce în partea de sus sesiunile ce așteaptă o intervenție, iar un chat poate avea propria fereastră (versiune preliminară). Compare Models acceptă Copilot Fusion și nivelurile sale de efort. În privința securității, solicitările de permisiuni oferă autorizări punctuale (un domeniu, o comandă, un director), iar sandboxul poate ascunde variabile de mediu, valoarea reală fiind injectată doar în cererile HTTPS către gazdele autorizate. VS Code acceptă și skills furnizate de servere MCP (SEP-2640, versiune preliminară), iar sesiunile Copilot respectă configurația proxy PAC și Kerberos.
🔗 Notele de versiune pentru VS Code 1.146
Qwen Code 1.0 Preview reunește agenții Qoder și Qwen Code într-un binar nativ, fără Node.js
11 noiembrie — La câteva ore după Qwen4-Max, Qwen publică în versiune preliminară Qwen Code 1.0 Preview, care reunește capacitățile de agent ale Qoder, mediul de programare al Alibaba, și pe cele ale Qwen Code: înțelegerea unei baze de cod, implementare, depanare și testare. Conectarea se face printr-un cont Qwen sau Qoder, prin QwenCloud sau Model Studio ori prin orice endpoint compatibil. Instrumentul este livrat în pachete native pentru macOS, Linux și Windows, în x64 și arm64 (opt arhive de aproximativ 57 până la 74 Mo), fără instalarea separată a Node.js, și păstrează reluarea sesiunii și execuția neinteractivă.
Depozitul avertizează că interfețele și opțiunile se mai pot schimba și nu mai acceptă pull requests din partea comunității până după decembrie 2026. Potrivit API-ului GitHub, tagul 1.0 nu are niciun istoric comun cu v0.27.2, publicată cu o zi înainte.
🔗 Qwen Code v1.0.0-preview (GitHub)
Modele deschise și cercetare : BotPsy de la Tether și token pooling de la Hugging Face
BotPsy-0.8B : Tether publică un mic model deschis pentru agenți, care aproape dublează scorurile la utilizarea instrumentelor față de modelul său de bază
11 noiembrie — Tether AI Research, echipa de IA a Tether care publică sub numele QVAC, prezintă BotPsy-0.8B, un model cu 0,8 miliarde de parametri, specializat în apelarea instrumentelor, conceput să ruleze pe un telefon sau pe un laptop. Pornește de la Qwen3.5-0.8B, trece printr-o ajustare fină supravegheată, o distilare de la trei modele profesor Qwen3.5-4B și două runde de învățare prin întărire. Ponderile sunt pe Hugging Face, în safetensors și GGUF, sub licența Apache 2.0, potrivit fișei modelului; articolul menționează utilizarea în cercetare și educație.
| Suită de evaluare (cifrele echipei) | BotPsy-0.8B | Qwen3.5-0.8B (bază) | Qwen3.5-2B-Think |
|---|---|---|---|
| BFCL v4 | 44,0 | 23,4 | 37,7 |
| ACEBench | 58,7 | 30,1 | 55,4 |
| τ-bench | 51,5 | 23,2 | 46,5 |
| Medie pe șase suite pentru instrumente | 45,0 | 24,7 | 38,8 |
Toate aceste cifre sunt măsurate de echipă, în modul de raționament. Aceasta anunță și o scădere a răspunsurilor periculoase de la 36 % la 21 % în testele de atac automatizate, recomandă limba engleză și descurajează utilizarea modelului pentru decizii sensibile.
🔗 BotPsy (QVAC pe Hugging Face) · Modelul qvac/BotPsy-0.8B
Token pooling : Hugging Face păstrează 97,8 % din calitatea căutării cu de patru ori mai puțini vectori
11 noiembrie — Tom Aarsen detaliază pe blogul Hugging Face cum se poate reduce dimensiunea indicilor de căutare multivectoriali, de tip ColBERT, care păstrează un vector pentru fiecare token din document. Gruparea tokenurilor (token pooling) combină vectorii apropiați, iar Sentence Transformers adaugă o funcție de pierdere, MultiVectorTokenPoolingLoss, care antrenează modelul atât pe reprezentările sale complete, cât și pe cele comprimate.
| Pooling la inferență (NanoBEIR, nDCG@10) | Număr mediu de vectori | Antrenare clasică | Antrenare care ține cont de pooling |
|---|---|---|---|
| Fără pooling | 193,22 | 51,84 | 52,39 |
pool_factor=4 | 48,68 | 49,03 | 51,23 |
max_tokens=4 | 4,00 | 37,22 | 43,00 |
Cu de patru ori mai puțini vectori, modelul antrenat astfel păstrează 97,8 % din scorul său, față de 94,6 % în cazul unei antrenări clasice. Măsurătorile vizează o singură configurație (ModernBERT-base, o epocă), iar două checkpoint-uri sunt publicate pe Hub.
🔗 Antrenare care ține cont de token pooling (Hugging Face)
Seedance 2.5 trece la 4K pe Pika și Runway
11 noiembrie — Seedance 2.5, modelul video al ByteDance distribuit de BytePlus, ajunge la 4K. Pika îl oferă în 4K nativ pe platforma sa și în Pika API Club, propunând lucrul la o secvență în variantă de ciornă, apoi finalizarea ei în 4K; din 17 august, îl oferea în 1080p cu mărire (upscale) la 4K. Runway a urmat la puțin mai puțin de două ore, anunțând Seedance 2.5 în 4K pe platforma sa, fără să precizeze dacă este vorba de 4K nativ. Nu au fost comunicate nici tariful, nici durata maximă, nici costul în credite.
🔗 Anunțul @pika_labs · Anunțul @runwayml
Git remediază șase vulnerabilități, inclusiv una care permite executarea de cod la o clonare recursivă
10 noiembrie — În afara domeniului IA, proiectul Git publică Git 2.56.1, cu remedieri retroportate până la Git 2.50.2, pentru a corecta șase vulnerabilități detaliate de Elijah Newren pe GitHub Blog.
| Vulnerabilitate remediată | Natura riscului |
|---|---|
| CVE-2026-111760 | Executare de cod la o clonare recursivă, prin fișierul .git al unui submodul |
| CVE-2026-113408 | Traversare de cale prin HEAD anunțat de un server |
| CVE-2026-114467 | Coruperea stivei la eliminarea semnăturilor GPG |
| CVE-2026-114469 | Citiri în afara limitelor la aplicarea de patch-uri binare |
| CVE-2026-105437 | Coruperea heap-ului în timpul unor operațiuni de merge mari |
| CVE-2026-114466 | Acces la sistemul de fișiere prin fluxuri git fast-import |
GitHub a implementat deja corecțiile pe github.com și Enterprise Cloud, publică GitHub Enterprise Server 3.19.15, 3.20.11, 3.21.9 și 3.22.4 și pregătește versiuni ale GitHub Desktop și ale aplicației GitHub Copilot cu o versiune Git corectată. Recomandarea este să actualizați Git și orice aplicație care include o copie a acestuia; în caz contrar, să clonați doar de pe servere de încredere.
🔗 Anunț privind vulnerabilitățile de securitate Git (GitHub Blog)
Știri pe scurt
Agenți de programare și instrumente de dezvoltare
- Zed 1.28 și versiunea preliminară 1.29 — Versiunea 1.28 devine stabilă și include noutățile versiunii preliminare prezentate pe 4 noiembrie (cel mai recent Agent Client Protocol, citiri ale
read_filetrunchiate la 2 000 de caractere, preluare Git automată opțională). Versiunea preliminară 1.29 acceptă Claude Fable 5.2 și Claude Mythos 5.2 prin furnizorul Anthropic. 🔗 sursă - Antigravity CLI 1.5.4 și 1.5.5 — Versiunea 1.5.5 introduce /swarm în versiune preliminară în terminal, cu vizualizarea pe tot ecranul /swarm board, și corectează importul comenzilor și al hook-urilor din pluginurile Claude Code. Versiunea 1.5.4 extinde modul Auto la sesiunile ACP și îmbogățește datele transmise hook-urilor. 🔗 sursă
- Gemini CLI — Nicio versiune nouă în ziua de după v0.68.0, iar compilarea nocturnă (nightly) a eșuat din nou, ca în fiecare noapte începând cu 5 noiembrie. Patru remedieri au fost integrate în ramura principală, inclusiv eliminarea unei erori 400 după un răspuns gol al modelului la o imagine sau un fișier binar. 🔗 sursă
- Copilot CLI 1.0.110-1 — Versiune preliminară limitată la 13 remedieri: o sesiune reluată nu mai poate fi modificată în paralel, iar un server MCP local care returnează un caracter Unicode trunchiat nu mai blochează un apel de instrument. SDK-ul 1.0.32-preview.1 permite alegerea Copilot Fusion și a nivelului său. 🔗 sursă
- Gemini 4 Carbon în Genspark — Genspark pune la dispoziție Gemini 4 Carbon în AI Chat și Code Agent, la o zi după introducerea Claude Fable 5.2 în același Code Agent, fără a preciza abonamentul necesar sau consumul de credite. 🔗 sursă
- Basis și Devin for Startups — Cognition prezintă într-un videoclip modul în care Basis lucrează cu Devin; agenții contabili ai Basis reduc unele sarcini de la 20 de ore la 30 de minute, o cifră care se referă la Basis, nu la Devin. Cognition relansează și Devin for Startups, cu 65 000 de dolari în credite pentru echipe selectate. 🔗 sursă
- shem — João Galego publică un runtime experimental care lansează un model de pe Hugging Face ca pe o imagine de container (un Dockerfile poate începe cu
FROM hf.co/...) și, invers, execută containere pe un procesor alcătuit din ponderi de model; potrivit lui, funcționează „de cele mai multe ori”. 🔗 sursă
GitHub
- Locuri Copilot gestionate prin GitHub Apps — GitHub Apps la nivel de întreprindere pot apela API-urile de gestionare a locurilor Copilot pentru a le atribui utilizatorilor și echipelor din întreprindere, datorită unei noi permisiuni granulare, Enterprise Copilot license management. 🔗 sursă
- Dependabot și depozitele inactive — Începând cu 8 decembrie, GitHub dezactivează alertele Dependabot pentru majoritatea depozitelor fără activitate de un an; alertele sunt arhivate, nu șterse, iar primul push le reactivează. GitHub Enterprise Server nu este vizat. 🔗 sursă
- Tipuri și câmpuri pentru issues în conturile personale — Rezervate până acum organizațiilor, acestea devin disponibile general în depozitele personale: până la 25 de tipuri și 25 de câmpuri, utilizabile în proiecte, prin API-urile REST și GraphQL și prin webhooks. 🔗 sursă
- Panoul de bord GitHub — Mai compact, acesta afișează șase pull requests și șase issues în loc de trei, permite fixarea filei Feed sau Home și ascunde secțiunea sesiunilor de agenți atunci când contul nu are niciuna. 🔗 sursă
Companii și utilizări
- Singapore Airlines — Rescris pe baza API-ului OpenAI, chatbotul Kris își dublează scorul de satisfacție a clienților, rezumarea apelurilor reduce cu aproximativ 10 % timpul de procesare al consilierilor, iar peste 60 % dintre angajați folosesc lunar platforma internă Jarvis. 🔗 sursă
- Cogent Security — Startupul construiește agenți de apărare cibernetică pe GPT-6.1 Sol, GPT-6 Astra și GPT-5.6, în baza unor politici verificate înaintea fiecărui apel de instrument; potrivit companiei, un client din industria auto inclus în Fortune 1000 a redus cu 75 % timpul mediu de remediere a vulnerabilităților sale critice. 🔗 sursă
- JioStar — Asistentul său vocal pentru descoperirea conținutului în JioHotstar, construit pe API-ul OpenAI în aproximativ opt săptămâni, vorbește peste 15 limbi pe o platformă cu peste 500 de milioane de utilizatori; potrivit JioStar, peste 60 % dintre utilizatorii săi îi vorbesc în loc să îi scrie. 🔗 sursă
- ChatGPT Plus pentru veterani — Cu ocazia Veterans Day, OpenAI anunță că peste 20 000 de veterani și militari în tranziție către viața civilă au solicitat, într-un an, anul gratuit de ChatGPT Plus și că aproape 1 000 de membri ai comunității militare au fost instruiți. 🔗 sursă
- Pluginul fal în ChatGPT — fal își promovează pluginul, care generează și retușează imagini și videoclipuri în conversație, printr-o reclamă de 60 de secunde realizată cu GPT Image 2.6, FLUX 3 Max (26 de cadre) și fal Recast; data publicării sale online nu este precizată. 🔗 sursă
- Gopuff în Grok Bot — Grok Bot comandă acum cumpărături, gustări și produse de uz zilnic de la Gopuff, gestionând întregul proces, cu livrare în cel mai bun caz în 15 minute, potrivit Gopuff; nu sunt precizate nici țările, nici abonamentele. 🔗 sursă
- Genspark Genius — Genspark recrutează ambasadori: o creație distribuită pe lună, în schimbul abonamentului Pro, al accesului anticipat la funcții noi, al creditelor și al promovării pe canalele sale. 🔗 sursă
Modele, media și cercetare
- MiniMax H3 — La o sută de zile de la publicarea ponderilor sale, MiniMax susține că există 1 472 de modele derivate și peste 148 de milioane de descărcări pe Hugging Face, cifre neverificate; H3-Image ajunge pe fal, Runware, EvoLink și Miora, fiind gratuit pe ultima platformă până pe 17 noiembrie. 🔗 sursă
- Voxtral Transcribe 3 la AI Engineer Paris — Mistral a transcris în direct toate prezentările de pe scena principală, furnizând modelului numele vorbitorilor și termenii din program (orientare contextuală), fără cifre privind îmbunătățirea obținută. 🔗 sursă
- Funcții vocale locale în Google AI Edge Gallery — Aplicația primește recunoaștere și sinteză vocală offline: pe Android, ML Kit transcrie peste 100 de limbi de zece ori mai repede decât în timp real, iar modele deschise precum Parakeet-TDT 0.6B sau Kokoro-82M acoperă celelalte platforme. 🔗 sursă
- Déjà View de la NVIDIA — Acest model de reconstrucție 3D cu 117M parametri aplică de mai multe ori același bloc transformer și egalează modele de până la 10 ori mai mari pe cinci benchmark-uri; prezentat într-o sesiune orală la NeurIPS 2026, articolul este pe arXiv din mai. 🔗 sursă
- Boli în textele medicale spaniole — OpenMed publică două modele deschise sub Apache-2.0, utilizabile pe CPU; potrivit echipei, ajustarea fină pe DisTEMIST crește scorul F1 de la aproximativ 36–39 pentru un model generic la aproximativ 73 pentru versiunea GLiNER2.5. 🔗 sursă
- Plăți efectuate de agenți prin x402 — Lăsate să acționeze singure, Qwen3 235B, DeepSeek V4 Pro și Llama 3.3 70B obțin 59, 55 și 30 de puncte la examenul Fizzl, fără ca vreunul să promoveze; când codul decide plata (x402-safe-fetch), scorurile lor cresc la 94, 100 și 94. 🔗 sursă
- GR00T-X-Embodiment-Sim în FiftyOne — Harpreet Sahota (Voxel51) convertește 42 de episoade simulate din setul de date NVIDIA, câte șase pentru fiecare dintre șapte corpuri de roboți, cu imagini de la camere și telemetria articulațiilor sincronizate. 🔗 sursă
Ecosistem
- Sakana AI — Amiralul în retragere Michael Rogers, fost director al NSA, și Tom Moran, cu aproape 30 de ani petrecuți la CIA, devin consilieri seniori ai startupului din Tokyo pentru apărare și securitate cibernetică. 🔗 sursă
- Reciclare la NVIDIA — Cu ocazia COP31, NVIDIA prezintă patru startupuri din programul său Inception care sortează deșeurile folosind viziunea computerizată, printre care Greyparrot, care reduce de la 375 la 6 ore verificarea a 15 tone de deșeuri; niciun produs NVIDIA nou. 🔗 sursă
- Ghidul Perplexity privind conformitatea AI — Acesta trece în revistă AI Act al UE, NIST AI RMF și ISO/IEC 42001 și propune trei măsuri de control pentru agenți: acces strict la ceea ce este necesar, înregistrarea fiecărei acțiuni și validarea umană a acțiunilor cu impact major. 🔗 sursă
- Ghidul Perplexity privind arhitectura MCP — Rolurile gazdei, clientului și serverului, mesaje JSON-RPC 2.0, transporturi locale și Streamable HTTP, configurare pentru mai mulți locatari: o prezentare tehnică ce continuă ghidul de securitate din 4 noiembrie, fără vreun anunț de produs. 🔗 sursă
- Hackathon Cohere la Toronto — Cohere organizează pe 30 ianuarie 2027 primul său hackathon împreună cu Universitatea din Toronto, Hacking Higher Ed, despre AI în învățământul superior; premii de 3 000, 2 000 și 1 000 de dolari, înscrieri până pe 22 ianuarie. 🔗 sursă
Ce înseamnă acest lucru
Google DeepMind își aplică modelele la două probleme în care verificarea contează mai mult decât generarea. AlphaGenome 2 nu se mai limitează la o medie pe țesut: prezice efectul unei variante în celula care îl interesează pe cercetător, iar îmbunătățirile sale sunt măsurate pe TenK10K, o hartă a 28 de tipuri de celule imunitare. AlphaProof Code mută verificarea formală de la proiectarea protocolului la codul compilat, cu o împărțire explicită a muncii: agenții scriu peste șase milioane de linii de demonstrație, verificatorul Lean controlează fiecare pas, iar oamenii revizuiesc specificațiile și aproximativ 1 % din cod. Ambele anunțuri își păstrează limitele: AlphaGenome 2 rămâne rezervat cercetării, iar afirmația privind prioritatea în cazul Signal îi aparține Google DeepMind.
Siguranța se lovește de propriile instrumente de măsurare. OpenAI constată că lanțul de raționament, unul dintre pilonii monitorizării sale, devine mai greu de citit pe măsură ce preantrenarea avansează și consideră chiar controlabilitatea, unul dintre cei doi indicatori ai săi, ca fiind afectată de zgomot. Perplexity arată că formatul clasic de capturare a steagului îndepărtează agenții de limita care trebuie testată și că un model specializat în securitate cibernetică poate avea rezultate mai slabe decât versiunea sa generalistă, în trei încercări și într-o configurație anterioară remedierii. În ambele cazuri, concluzia privește la fel de mult modul de evaluare, cât și modelele în sine.
Ziua delimitează clar ceea ce este livrat de ceea ce este anunțat. Runway publică Praxis-1 împreună cu ponderile sale, codul de ajustare fină și un raport care plasează modelul sub patru soluții concurente, iar Tether pune BotPsy la dispoziție pentru descărcare. În schimb, Qwen4-Max sosește fără benchmark, dimensiune sau preț, iar ElevenLabs distinge ea însăși între ceea ce este disponibil astăzi (Marketplace, Partner Program, ElevenAI) și ceea ce va veni mai târziu (Interaction Engine, Memory, Routines, ajustare fină). Pentru cei care vor să testeze, a doua jumătate rămâne o promisiune.
Agenții se instalează pe termen lung și în echipe. Grok Bot 1.0 participă la ședințe și se coordonează cu alți Bots în Slack și Teams; Cloud Runners de la Delta rulează un fir de lucru al unui agent fără computerul autorului său; VS Code adaugă o căsuță de primire pentru sesiunile care așteaptă o decizie; A2UI permite agenților să răspundă printr-un ecran în loc de text. Fiecare gestionează și riscul pe care îl introduce: permisiuni per persoană și verificare înainte de a vorbi într-un canal public la Grok Bot, previzualizare privată la Delta, autorizări specifice și variabile mascate în sandboxul VS Code.
Surse
- AlphaGenome 2 (Google DeepMind)
- AlphaGenome 2 (@GoogleDeepMind)
- Prezentarea AlphaProof Code (Google DeepMind)
- Verificarea formală a Signal (PDF, Google DeepMind)
- Qwen4-Max în versiune preliminară (@Alibaba_Qwen)
- Token Plan (QwenCloud)
- Praxis-1 este acum disponibil (Runway)
- Raportul tehnic al Praxis-1 (Runway)
- Colecția Praxis-1 (Hugging Face)
- ElevenLabs Summit NYC (ElevenLabs)
- Anunțurile de la Summit (@ElevenLabs)
- ElevenLabs și NVIDIA (ElevenLabs)
- Resetarea completă a limitelor (@ClaudeDevs)
- Grok Bot 1.0 (SpaceXSI)
- Grok Bot 1.0 (@SpaceXSI)
- Retragerea vocilor Advanced și Standard din ChatGPT (centrul de ajutor OpenAI)
- Retragerea vocilor Advanced și Standard (@OpenAINewsroom)
- Gemini pe Apple CarPlay (blog.google)
- Posibilitatea monitorizării CoT pe parcursul ciclului de viață al modelului (OpenAI)
- Firul de postări al lui Jeffrey G. Wang
- Evadarea din SPACE: partea a II-a (Perplexity)
- Evadarea din SPACE: partea a II-a (@perplexity_ai)
- Gemini Decision 1 (Google AI Studio)
- Decisions API (Google AI Studio)
- A2UI 1.0 (Google Developers Blog)
- Cloud Runners sunt acum în Delta
- Documentația Cloud Runners (Delta)
- Notele versiunii VS Code 1.146
- Qwen Code v1.0.0-preview (GitHub)
- BotPsy (QVAC pe Hugging Face)
- Modelul qvac/BotPsy-0.8B (Hugging Face)
- Antrenare care ține cont de Token Pooling (Hugging Face)
- Seedance 2.5 în 4K (@pika_labs)
- Seedance 2.5 în 4K (@runwayml)
- Vulnerabilități de securitate Git anunțate (GitHub Blog)
- Zed v1.28.1 (GitHub)
- Jurnalul modificărilor Antigravity
- Gemini CLI, PR 30228 (GitHub)
- Copilot CLI v1.0.110-1 (GitHub)
- Gemini 4 Carbon în Genspark (@genspark_ai)
- Basis și Devin for Startups (@cognition)
- LLM-ul tău este acum un container (Hugging Face)
- Gestionarea locurilor Copilot prin GitHub Apps (GitHub Changelog)
- Alertele Dependabot vor fi suspendate în depozitele inactive (GitHub Changelog)
- Tipuri și câmpuri pentru issues în conturile personale (GitHub Changelog)
- Un panou de bord GitHub mai informativ (GitHub Changelog)
- Singapore Airlines (OpenAI)
- Cogent Security (OpenAI)
- JioStar, Vijay Seshadri (OpenAI)
- ChatGPT Plus pentru veterani (OpenAI)
- Pluginul fal în ChatGPT (@fal)
- Gopuff în Grok Bot (@bot)
- Genspark Genius (@genspark_ai)
- MiniMax H3, 100 de zile (@RyanLeeMiniMax)
- Voxtral Transcribe 3 la AI Engineer Paris (@MistralAI)
- Funcții vocale locale în Google AI Edge Gallery (Google Developers Blog)
- Déjà View (@NVIDIAAI)
- Identificarea bolilor în texte clinice spaniole (OpenMed)
- Modele AI deschise cu un portofel (Fizzl)
- GR00T-X-Embodiment-Sim în FiftyOne (Hugging Face)
- Michael Rogers și Tom Moran (Sakana AI)
- Startupuri de reciclare cu AI (blogul NVIDIA)
- Conformitatea AI (Perplexity)
- Arhitectura MCP (Perplexity)
- Hacking Higher Ed (@cohere)