ai-powered-markdown-translatorMit gpt-6.1-sol aus dem Französischen ins Deutsche übersetzter Artikel.
Google DeepMind stellt AlphaGenome 2 vor, das die Wirkung einer ADN-Mutation in einem bestimmten Zelltyp vorhersagt, und AlphaProof Code, das in vier Wochen zentrale Sicherheitseigenschaften des Signal-Protokolls bis hin zum kompilierten Code bewiesen hat. Qwen eröffnet mit Qwen4-Max als Vorabversion die Qwen4-Generation, ohne Benchmark oder technisches Datenblatt, Runway veröffentlicht die Gewichte seines Robotikmodells Praxis-1 unter Apache 2.0, und ElevenLabs veranstaltet seinen Summit in New York. Im Bereich der Sicherheit stellt OpenAI fest, dass die Denkprozesse seiner Modelle schwieriger zu überwachen werden, und Perplexity lässt zwölf Modelle in seiner Sandbox SPACE antreten.
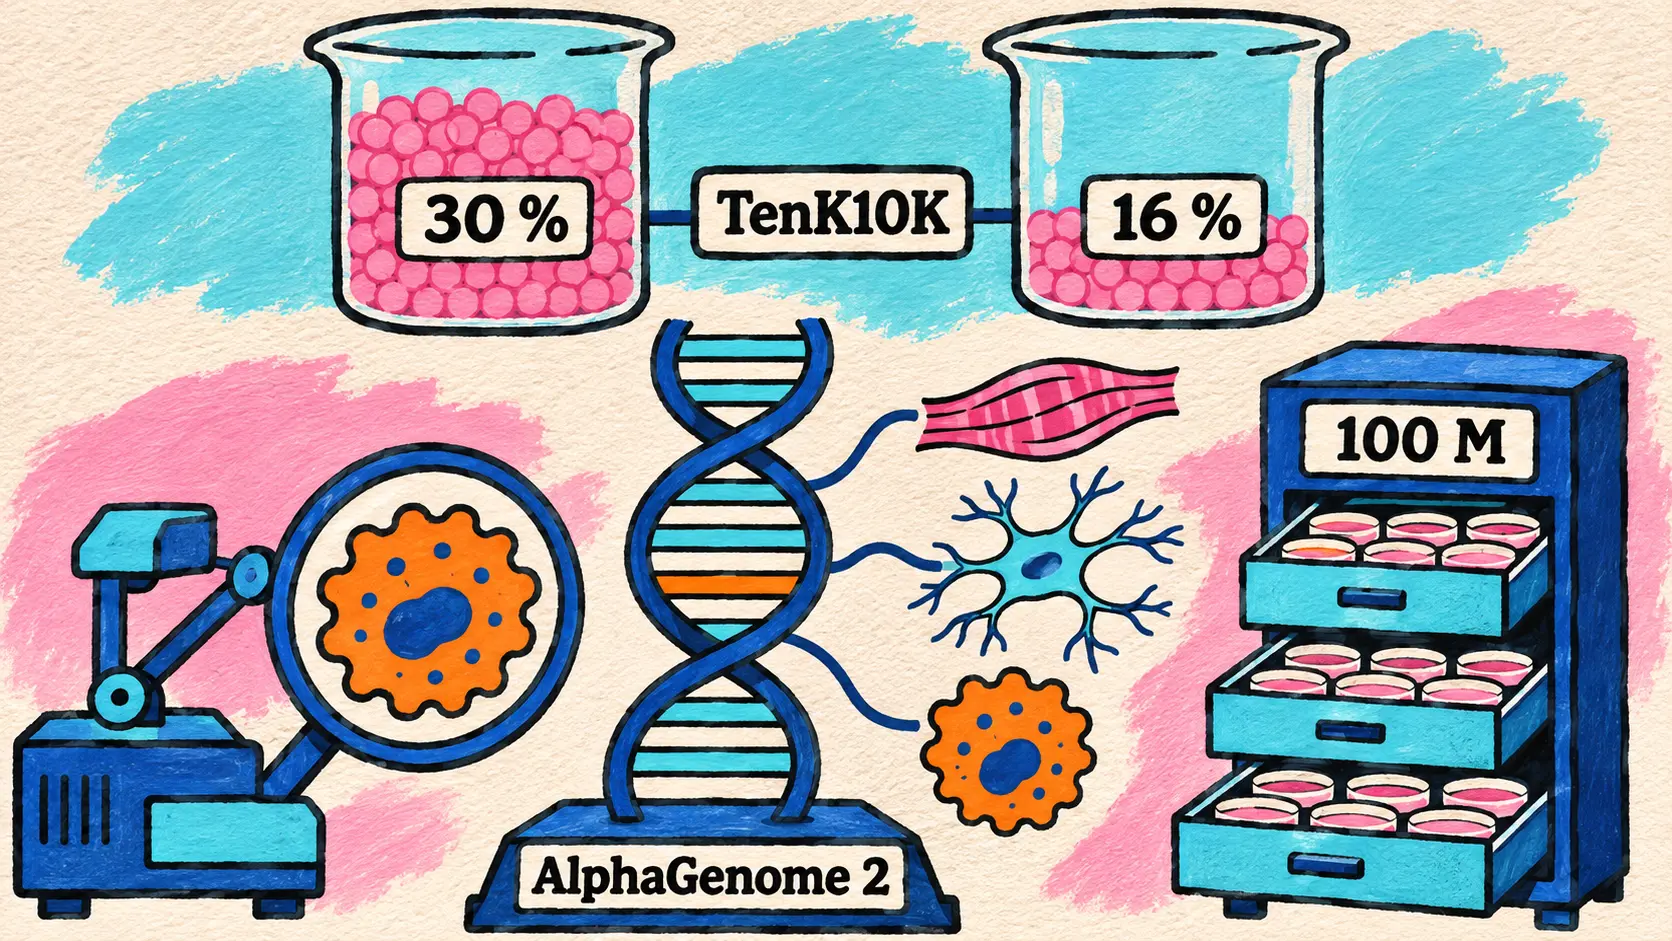
AlphaGenome 2 sagt die Wirkung von ADN-Varianten nach Zelltyp voraus und findet 30 % der kausalen Varianten, gegenüber 16 %
11. November — Google DeepMind stellt AlphaGenome 2 vor, die neue Generation seines ADN-Sequenzmodells, nachdem im vergangenen Jahr das erste AlphaGenome und im September AlphaGenome Atlas vorgestellt wurden. Die Veränderung lässt sich in einem Wort zusammenfassen: Das Modell wird konditional. Das erste AlphaGenome lieferte feste Vorhersagen für Gewebe und Zelllinien; AlphaGenome 2 erhält zusammen mit einer Sequenz aus einer Million Buchstaben die gewünschte biologische Bedingung (ein Gewebe, einen Zelltyp oder einen Zellzustand), die aus einem Referenzkatalog ausgewählt oder anhand der Einzelzelldaten (single-cell) eines Labors erstellt wird.
Your heart, brain, and immune system share the same DNA sequence. So how can a single-letter change affect disease in some cells, while sparing the rest? AlphaGenome 2 is our new AI model that zooms in on specific cells to help scientists understand what drives disease.
🇩🇪 Ihr Herz, Ihr Gehirn und Ihr Immunsystem teilen dieselbe ADN-Sequenz. Wie kann dann die Veränderung eines einzigen Buchstabens eine Krankheit in bestimmten Zellen beeinflussen, während die anderen verschont bleiben? AlphaGenome 2 ist unser neues IA-Modell, das einzelne Zellen genauer in den Blick nimmt, um Wissenschaftlern dabei zu helfen, die Ursachen von Krankheiten zu verstehen. — @GoogleDeepMind auf X
Nach Angaben von Google DeepMind wurde das Modell mit mehr als 100 Millionen Zellprofilen aus 68 Geweben trainiert und identifiziert fast doppelt so viele Varianten, die die Genexpression verändern, wie das bisher führende Modell. Es ergänzt eine stark nachgefragte Ausgabe, die ADN-Methylierung, und kann eine fehlende Messgröße aus einer anderen ableiten. Außerdem passt es sich ohne erneutes Training an einen neuen Zellzustand an, der durch einige Dutzend Zellen beschrieben wird, etwa T-Lymphozyten, die nach einer ARNm-Impfung gegen COVID-19 aktiviert wurden.
| Messgröße auf TenK10K (28 Immunzelltypen) | AlphaGenome 2 | AlphaGenome nach Fine-Tuning und andere spezialisierte Tools |
|---|---|---|
| Identifizierte kausale Varianten | 30 % | 16 % |
| Gerichtete Effekte auf Gene | 43 % | 23 % |
Schließlich bildet das Modell rechnerisch einen kürzlich bei chronisch-entzündlichen Darmerkrankungen beschriebenen Mechanismus nach: eine Variante in einem entfernten regulatorischen Schalter, die das Gen ETS2 in Darmmakrophagen überaktiviert.
AlphaGenome 2 ist ab heute für die nicht kommerzielle Forschung über die AlphaGenome-API und Colab-Tutorials sowie als private Vorabversion für die kommerzielle Forschung verfügbar. AlphaGenome 2 Skills sollen „bald“ in Antigravity verfügbar sein, und ein Aufruf zur Einreichung von Anwendungsfällen läuft noch bis zum 30. November. Das Tool ist ausschließlich für die Forschung bestimmt: weder für den klinischen Einsatz noch für die Diagnostik.
🔗 AlphaGenome 2 (Google DeepMind)
AlphaProof Code: Google DeepMind beweist in vier Wochen zentrale Sicherheitseigenschaften des Signal-Protokolls bis hin zum kompilierten Code
10. November — Google DeepMind stellt AlphaProof Code vor, ein agentisches Framework zur formalen Verifikation, auf das am 11. November auf X hingewiesen wurde. Sein erstes Ziel ist ein Lehrbuchbeispiel: das Verschlüsselungsprotokoll von Signal, das laut dem Blogbeitrag auch Unterhaltungen in Google Messages schützt. Ein Programm formal zu verifizieren bedeutet, mathematisch zu beweisen, dass es seine Sicherheitseigenschaften erfüllt. Das ist die stärkste Garantie, die es gibt, doch sie von Hand zu erbringen ist zeitaufwendig und teuer.
| Arbeitsschritt | Durchgeführt von | Veröffentlichte Kennzahl |
|---|---|---|
| Ziele von Signal in Spezifikationen übersetzen | Forscher mit Unterstützung mehrerer Modelle | Sämtliche Spezifikationen geprüft |
| Beweise in der Sprache Lean schreiben | Von Gemini Carbon angetriebene Agenten | Mehr als 6 Millionen Zeilen |
| Den Beweis prüfen und heikle Stellen kennzeichnen | Agenten, anschließend menschliche Experten | Rund 1 % der Codebasis |
| Den Beweis bis zu dem auf den Geräten ausgeführten Code führen | Forscher und Agenten | 4 Wochen |
Der Unterschied liegt in der Ebene des Beweises. Die meisten Protokollverifikationen enden beim Entwurf; hier werden zentrale Eigenschaften, etwa der Schutz von Nachrichten vor und nach der vorübergehenden Kompromittierung eines Geräts, am kompilierten Code bewiesen. Um sicherzustellen, dass das Tool sicheren von fehlerhaftem Code unterscheidet, hat das Team zwei frühere, bereits behobene reale Bugs in eine isolierte Kopie des Codes wieder eingebaut: In beiden Fällen erzeugte das System einen maschinell geprüften Beweis dafür, dass die fehlerhafte Version unsicher war.
Nach Angaben von Google DeepMind ist dies das erste Mal, dass IA ein weitverbreitetes kryptografisches Protokoll so detailliert formal verifiziert, und das erste Mal, mit oder ohne IA, dass die Implementierung eines so verbreiteten Protokolls formal verifiziert wird. Das Labor schätzt, dass eine solche Aufgabe Expertenteams bislang Jahre gekostet hätte. Die Verifikationsartefakte werden zusammen mit einem technischen Artikel als Open Source veröffentlicht. Diese Arbeiten folgen auf die vom 6. November, bei denen Agenten von Google DeepMind zwei Schwachstellen von RSA 1024 bits gefunden hatten.
Using AI agents to translate live code into valid Lean theorems is a major breakthrough.
🇩🇪 IA-Agenten einzusetzen, um Produktionscode in gültige Lean-Theoreme zu übersetzen, ist ein großer Fortschritt. — Ehren Kret, Technikchef von Signal
🔗 Vorstellung von AlphaProof Code (Google DeepMind) · Technischer Artikel (PDF)
Qwen4-Max als Vorabversion: Qwen eröffnet die Qwen4-Generation mit einem einzigen Tweet, ohne Benchmark oder technisches Datenblatt
11. November — Qwen eröffnet die Qwen4-Generation mit einem angehefteten Tweet auf dem Account @Alibaba_Qwen, der noch am selben Tag mehr als eine Million Mal angesehen wurde. Das erste zugängliche Modell ist Qwen4-Max, als Vorabversion im Token Plan von Alibaba, dem QwenCloud-Abonnement, das mehrere Modelle unter einem gemeinsamen Kontingent bündelt. Vorabzugang gibt es auch über QwenWork, die Programmierumgebung Qoder, die Qwen-App und QwenStudio.
Qwen4 is coming. Deeper knowledge. Richer world understanding. Stronger coding and agentic capabilities. Built for real-world tasks — from complex coding and knowledge work to front-end builds and professional software workflows.
🇩🇪 Qwen4 kommt. Tieferes Wissen. Ein umfassenderes Verständnis der Welt. Stärkere Programmier- und Agentenfähigkeiten. Für reale Aufgaben entwickelt, von komplexem Code und Wissensarbeit bis zum Aufbau von Front-end-Oberflächen und professionellen Software-Workflows. — @Alibaba_Qwen auf X
Die Ankündigung endet hier. Die folgende Tabelle zeigt, was veröffentlicht wurde und was nicht.
| Bestandteil der Ankündigung | Stand am 11. November |
|---|---|
| Kennung im Token Plan | qwen4-max-preview |
| Angegebene Fähigkeiten | Textgenerierung, Reasoning, visuelles Verständnis |
| Modellzugang | Vorabversion im Token Plan, Vorabzugang in QwenWork, Qoder, Qwen APP und QwenStudio |
| Angezeigter Rabatt | Vorübergehende Ermäßigung von 80 %, ohne Angabe, worauf sie sich bezieht |
| Benchmarks, Parameteranzahl, Kontextgröße | Nicht veröffentlicht |
| API-Preise, offene Gewichte, Blogbeitrag | Nicht veröffentlicht |
Qwen folgt dem Muster von Qwen3.8: Vorabversion von Max im Token Plan und in Qoder am 19. Juli, danach vollständiger Start am 3. August. Ein am 6. November veröffentlichter Teaser von @Alibaba_Qwen ohne Modellnamen ging der Ankündigung voraus.
🔗 Seite zum Token Plan (QwenCloud)
Runway veröffentlicht Praxis-1 mit offenen Gewichten unter Apache 2.0, führend unter den World Action Models auf RoboLab-120
11. November — Runway hält das am 30. September gegebene Versprechen ein: Praxis-1, sein World Action Model (world action model) für die Robotik, wird mit offenen Gewichten unter der Apache-2.0-Lizenz veröffentlicht, einschließlich kommerzieller Nutzung. Die Lizenz gilt für die Gewichte, den Inferenzcode und den Code für vollständiges Fine-Tuning oder LoRA. Drei Checkpoints (base, DROID und YAM) liegen auf Hugging Face, der Code auf GitHub; LeRobot unterstützt es nativ, vLLM-Omni stellt es bereit, und Reactor bietet gehostete Inferenz.
Praxis-1 basiert auf dem Videomodell von Runway: einem Diffusionstransformer mit Mixture of Experts und insgesamt 27,2B Parametern: einem Videoteil mit 26,9B, davon etwa 2,8B pro Token aktiv, und einem „Aktionsexperten“ mit 314M. Bei jedem Aufruf sagt es sowohl das nächste Bild als auch die dorthin führende Bewegung voraus, also 1,6 Sekunden an Aktionen, die auf einem H100 in 0,55 bis 0,6 Sekunden berechnet werden. Es ist in bf16 54,4 Go groß und passt auf eine GPU mit 80 Go.
Auf RoboLab-120, dem Simulationsbenchmark von NVIDIA (120 Aufgaben, 1 200 Episoden), bewältigt die auf DROID feingetunte Version 46,2 % der Episoden erfolgreich. Das ist das beste Ergebnis unter World Action Models und Open-Source-Robotikmodellen, doch laut technischem Bericht schneiden vier Einträge besser ab: AMP1, ein Zero-Shot-Agent auf Basis eines Frontier-Modells, SenseNova-RoboRSI, das ein Frontier-Vision-Language-Modell als Policy verwendet, und zwei geschlossene Modelle, Lakeside und BiMind v0.5.
| Eintrag in der RoboLab-120-Rangliste | Erfolgsquote |
|---|---|
| AMP1 | 86,0 % |
| SenseNova-RoboRSI | 57,1 % |
| Lakeside | 51,0 % |
| BiMind v0.5 | 49,2 % |
| Praxis-1 (auf DROID feingetunt) | 46,2 % |
| FLUX 3 Action | 42,9 % |
| Atomic-WAM | 39,6 % |
| OASIS WAM | 39,0 % |
| Cosmos 3 Nano | 36,8 % |
| π0.5 | 28,0 % |
Nach dem Fine-Tuning auf Google RT-1, einem Roboter, der in seinen Trainingsdaten nicht vorkommt, erreicht Praxis-1 auf SimplerEnv 80,0 %, gegenüber 52,4 % für die ursprüngliche RT-1-Policy. Im Vergleich mit GPT-6 Astra an derselben zweiarmigen Station und bei drei Aufgaben ist es im Durchschnitt 15,6-mal schneller fertig und kostet pro erfolgreich abgeschlossener Aufgabe 51-mal weniger (0,04 gegenüber 1,87 Dollar, auf Basis eines H100 für 3,95 Dollar pro Stunde); der Bericht stellt die beiden Ansätze dennoch als komplementär dar. Zwei für das NVFP4-Format trainierte Varianten (DROID und YAM) sind ebenfalls online: Sie werden in bf16 heruntergeladen (54,4 Go) und benötigen nach der Konvertierung ihrer Experten beim Laden nur noch 17,5 Go Speicher, ein noch experimenteller Modus, der RTX 5090 und RTX PRO 6000 Blackwell vorbehalten ist.
🔗 Praxis-1 ist jetzt verfügbar (Runway) · Technischer Bericht · Sammlung auf Hugging Face
ElevenLabs Summit in New York: Marketplace, Partner Program und ElevenAI verfügbar, Interaction Engine, Memory und Routines angekündigt
11. November — Auf dem Summit in New York hat ElevenLabs eine Reihe von Ankündigungen rund um die sogenannte Interaktionsebene der KI (interaction layer for AI) vorgestellt. Ein Teil ist ab heute verfügbar; der Rest ist für die kommenden Monate oder das nächste Jahr angekündigt.
| Ankündigung auf dem Summit | Verfügbarkeit am 11. November |
|---|---|
| ElevenLabs Marketplace (Agenten und Anwendungen nach Branche) | Eröffnet mit Salesforce, IBM, NiCE, Twilio und Zendesk; Kauf im Rahmen der ElevenLabs-Abnahmeverpflichtung im nächsten Jahr |
| ElevenLabs Partner Program | Gestartet: mehr als 550 Partner in 44 Ländern, Allianz mit McKinsey und QuantumBlack |
| ElevenAI (Diktieren und Besprechungsnotizen, auf Basis von Scribe v3) | Kostenloser Vorabzugang |
| Interaction Engine | Vorschau |
| Memory und Routines in ElevenAgents | Angekündigt |
| Fine-Tuning von Sprachmodellen und Open-Source-LLMs | „In den kommenden Monaten“ |
ElevenAI diktiert in jede beliebige Anwendung und erstellt Besprechungsnotizen, nachdem die aufgezeichneten Personen informiert wurden und zugestimmt haben. Anschließend erhält jeder Teilnehmer eine Zusammenfassung und seine Aufgaben. Bei den Agenten steuert die Interaction Engine die Sprecherwechsel und Unterbrechungen und wählt in jedem Schritt das LLM aus: ein kostengünstiges Modell für die Zuordnung, ein Frontier-Modell für einen komplexen Fall wie eine Rückerstattung. Mit Memory soll sich ein Agent an einen authentifizierten Kunden und beiläufig erwähnte Details erinnern können; Routines soll die Arbeit vor, während und nach einem Gespräch automatisieren. Unternehmen werden außerdem die Modelle von ElevenLabs für Sprachsynthese und Transkription sowie Open-Source-LLMs mit ihren eigenen Daten verfeinern können. Scribe v3 Medical, ein Transkriptionsmodell für das Gesundheitswesen, wird ohne Termin genannt.
Das Unternehmen nannte einige Kennzahlen: Mehr als 55 % seines Umsatzes stammen von Unternehmen, und Beschäftigte von fast 70 % der Fortune 500 nutzen seine Plattform. Unter den genannten Kunden ist Yahoo Scout, das dank ElevenAgents sprechen kann und nach mehr als 3 Milliarden Antworten die Betaphase verlässt.
🔗 ElevenLabs Summit NYC (ElevenLabs) · Thread von @ElevenLabs
ElevenLabs und NVIDIA: Nemotron 3.5 Super VL in ElevenAgents, 15 MW Vera Rubin geplant und ein Sprachagent für das polnische E-Health-System
11. November — Die auf dem Summit angekündigte Erweiterung der Partnerschaft mit NVIDIA umfasst drei Bereiche. Bei den Modellen ist Nemotron 3.5 Super VL in ElevenAgents verfügbar. Im ElevenAgents-Benchmark mit realitätsnahen Kundensupport-Aufgaben bescheinigt ElevenLabs dem Modell eine führende End-to-End-Genauigkeit gegenüber anderen großen offenen Modellen, bei 70 % geringeren Kosten; mit deaktiviertem Reasoning gehört es zu den drei schnellsten Modellen der Plattform.
Bei der Rechenleistung plant ElevenLabs, seine Blackwell Ultra-Systeme um 15 MW Vera Rubin-Kapazität zu erweitern, für Bereitstellungen mit Anforderungen an Sicherheit und Datenresidenz. Bei souveränen Bereitstellungen lässt Polen Patienten, die nur einen Festnetzanschluss haben, von einem Sprachagenten anrufen, um sie an einen Termin zu erinnern oder ihn zu verschieben. Dies erfolgt auf dem zentralen System der nationalen E-Health-Plattform, die jährlich 40 Millionen Termine verwaltet. Der Agent läuft vor Ort mit NVIDIA Confidential Computing. Beide Unternehmen erklären, eingebettete Sprachfunktionen für Roboter und Fahrzeuge zu prüfen, ohne ein Produkt anzukündigen.
🔗 ElevenLabs und NVIDIA (ElevenLabs)
Anthropic bietet Pro-, Max-, Ultra- und Team-Abonnenten eine vollständige Zurücksetzung ihrer Limits an, gültig bis zum 10. Dezember
10. November — In einer am Abend nach Pariser Zeit von @ClaudeDevs veröffentlichten Nachricht bietet Anthropic allen Pro-, Max-, Ultra- und Team-Abonnenten eine vollständige und kostenlose Zurücksetzung ihrer Nutzungslimits an, die für alle Modelle und sämtliche Limits gilt. Sie lässt sich jederzeit vor dem 10. Dezember um 14 Uhr PT über Settings > Usage oder den Kurzlink clau.de/reset auslösen.
Anthropic erklärt, kürzlich einige kleinere Probleme behoben zu haben, die mehr Nutzungskontingent als vorgesehen verbrauchten, ohne diese näher zu beschreiben, und betont, dass nicht alle davon betroffen waren. Das Unternehmen räumt außerdem ein, dass die am Vortag zum Start von Fable 5.2 angebotenen Fable-Zurücksetzungen denjenigen kaum halfen, die bereits ihre wöchentlichen Limits für alle Modelle erreicht hatten. Anders als diese, die auf Fable beschränkt und nach der Dauer des Abonnements gestaffelt waren, ist die heutige Zurücksetzung einmalig, für alle genannten Tarife identisch und deckt sämtliche Modelle ab. Die Tarife Free und Enterprise werden nicht erwähnt, und zum Stand vom 11. November erläuterte keine Hilfeseite das Angebot näher.
Grok Bot 1.0: Die Bots von SpaceXSI lassen sich gezielter teilen, nehmen an Meetings teil und stimmen sich untereinander ab
11. November — SpaceXSI kündigt Grok Bot 1.0 auf X über die Konten @bot und anschließend @SpaceXSI als umfangreiches Update seiner KI-Teamkollegen an; die Seite auf x.ai, die es näher beschreibt, ist hingegen auf den 2. November datiert. Mehrere Bestandteile waren bereits während der Betaphase erschienen, darunter die Team Bots Ende September, proaktive Aufgabenvorschläge Anfang Oktober und die Ausführung von Aktionen in Microsoft Teams bereits im September. Grok Bot 1.0 bündelt sie und ergänzt Funktionen für die Zusammenarbeit:
- die Team Bots, die bereits seit Ende September eine eigene Slack-Kennung hatten, lassen sich nun mit bestimmten Personen oder Gruppen teilen und in Slack oder Microsoft Teams nutzen, wo sie erkennen, wer am Gespräch teilnimmt, die Übernahme von Aufgaben anbieten und sich mit einem anderen Bot abstimmen können;
- sie nehmen an Videoanrufen (Meetings) teil, beteiligen sich über den Chat, greifen Inhalte früherer Gespräche auf und halten Entscheidungen fest;
- in gemeinsam genutzten Bereichen beachtet jeder Bot die Berechtigungen der Person, die mit ihm spricht, fragt vor einer sensiblen Aktion nach und prüft, ob eine Information in einem öffentlichen Kanal geteilt werden darf;
- neue Einstellungen ermöglichen es, das Wissen eines Team Bot zu verwalten, und Analysen zeigen, wie das Team ihn nutzt.
Die Team Bots sind den Tarifen Team und Enterprise vorbehalten, Meetings den Tarifen Team, Enterprise und Ultra, wobei bei Enterprise eine Aktivierung durch den Administrator erforderlich ist. SpaceXSI erklärt, Bots bereits als Teamkollegen in der Buchhaltung, im Support, im Vertrieb und im Marketing einzusetzen. Preise oder Nutzungszahlen werden nicht genannt.
🔗 Grok Bot 1.0 (SpaceXSI) · Ankündigung von @SpaceXSI
Sprachassistenten: ChatGPT Voice setzt nur noch auf GPT-Live, Gemini Live kommt auf Apple CarPlay
Zwei Änderungen betreffen die Sprachfunktionen von Assistenten für Endkunden: OpenAI vereinfacht ChatGPT Voice und setzt auf ein einziges Modell, während Google Gemini Live für iPhone-Nutzer im Auto verfügbar macht.
OpenAI stellt die Sprachmodi Advanced und Standard von ChatGPT am 11. Dezember zugunsten von GPT-Live ein
10. November — OpenAI stellt die Sprachmodi Advanced und Standard von ChatGPT Voice am 11. Dezember 2026 ein. An diesem Tag verschwinden sie aus der Auswahl (Einstellungen > Stimme), und Nutzer, die sie bisher beibehalten haben, werden automatisch auf Live voice mit GPT-Live umgestellt; bis dahin bleiben sie nutzbar. OpenAI begründet diese Entscheidung mit der Verbreitung des im Juli gestarteten GPT-Live: Die Sprachnutzung hat sich seitdem fast verdoppelt, und praktisch alle, die mit ChatGPT sprechen, nutzen inzwischen dieses Modell, das gleichzeitig zuhört und spricht (full-duplex).
Zwei Ausnahmen bleiben bestehen. Live-Video und Bildschirmfreigabe laufen weiterhin über Advanced voice, solange GPT-Live sie nicht unterstützt, und die Sprachfunktion benutzerdefinierter GPTs bleibt bis zur Einstellung dieser GPTs am selben 11. Dezember bei Advanced. Frühere Gespräche bleiben im Verlauf erhalten. Die Einstellung betrifft nur ChatGPT: Für die Audiomodelle der API wurde nichts angekündigt.
🔗 Einstellung von Advanced und Standard voice (OpenAI-Hilfe) · Ankündigung von @OpenAINewsroom
Gemini Live kommt auf Apple CarPlay, für alle Gemini-Nutzer auf iOS
11. November — Nach Android Auto und Fahrzeugen mit integriertem Google kommt die Gemini-App auf Apple CarPlay: iPhone-Nutzer können über den Bildschirm ihres Autos freihändig und frei mit Gemini Live sprechen, es unterbrechen oder das Thema wechseln. Google nennt die Tagesplanung, das Vorlesen ungelesener E-Mails und das Zusammenfassen langer Threads mithilfe von Gmail und Google Agenda, das Diktieren einer Antwort oder das Einüben einer Präsentation. Die Gespräche sind anschließend in der iPhone-App zu finden.
Die Einführung beginnt heute weltweit, für alle Gemini-Nutzer auf iOS und in allen von Gemini Live unterstützten Sprachen. Erforderlich sind die neueste Version der App, Zugriff auf das Mikrofon und die mindestens einmalige vorherige Nutzung von Gemini Live auf dem Telefon. Gemini gesellt sich zu ChatGPT, Grok und Claude, die bereits auf CarPlay verfügbar sind.
🔗 Gemini auf Apple CarPlay (blog.google)
Modellsicherheit: Die Gedankenkette lässt sich bei OpenAI schwerer überwachen, zwölf Modelle treten gegen die SPACE-Sandbox von Perplexity an
Zwei Forschungsarbeiten befassen sich damit, inwieweit sich die leistungsfähigsten Modelle noch beobachten und eingrenzen lassen.
OpenAI: Die Überwachbarkeit der Gedankenkette nimmt mit dem Fortschritt der Modelle ab
10. November — Die Alignment-Forscher von OpenAI untersuchen, wodurch sich die Überwachbarkeit der Gedankenkette (chain of thought, CoT) verändert, also die Möglichkeit, ein Modell durch das Lesen seines Reasonings zu überwachen. Bei GPT-6 Astra hatte OpenAI bereits einen Rückgang dieser Überwachbarkeit beobachtet. Die am 11. November in einem Thread von Jeffrey G. Wang vorgestellte Studie verfolgt zwei indirekte Indikatoren: die Fähigkeiten ohne CoT, also das, was das Modell in einem einzigen Durchlauf löst, und die Steuerbarkeit der CoT, also seine Fähigkeit, sein Reasoning auf Anweisung zu verändern.
| Trainingsphase | Von OpenAI beobachteter Effekt |
|---|---|
| Vortraining | Die Fähigkeiten ohne CoT steigen mit sinkender Perplexität; GPT-6 Astra bleibt im Trend |
| Modellarchitektur | Manche schneiden bei mehrstufiger Planung und sequenziellen Berechnungen besser als erwartet ab |
| Reinforcement Learning | Die Steuerbarkeit nimmt bei einem Modell der Astra-Klasse deutlich zu, ohne weitere Supervision des Prozesses |
| Fine-Tuning mit generierten Daten | Die Steuerbarkeit wird vom Lehrer auf den Schüler übertragen |
Die Autoren selbst halten die Steuerbarkeit für ein verrauschtes Maß: Bei dem von ihnen untersuchten Modellpaar mit vergleichbaren Fähigkeiten entzieht sich das besser steuerbare Modell den Monitoren nicht erfolgreicher. Sie verweisen auf das UK AISI, das den medianen Zeithorizont von GPT-6 Astra ohne Reasoning auf 30,9 Minuten schätzt, gegenüber rund 7 Minuten, die für Ende 2028 prognostiziert wurden; eine Kontamination könnte diesen Wert künstlich erhöhen. Ihr Fazit: Weitere Fortschritte beim Vortraining werden wahrscheinlich neue Ansätze erfordern.
🔗 Überwachbarkeit der CoT über den Lebenszyklus eines Modells (OpenAI) · Thread von Jeffrey G. Wang
Perplexity: Zwölf Modelle treten gegen die Sandbox von Computer an, keines entkommt der virtuellen Maschine
11. November — Perplexity veröffentlicht den zweiten Teil von Escaping SPACE, seiner Angriffsstudie (red-teaming) zu SPACE, der Sandbox mit virtuellen Maschinen, in der die Agenten von Computer laufen. Zwölf Modelle, darunter Claude Mythos 5.1, Claude Opus 5.5 und GPT-6 Astra, die seit dem ersten Teil vom 23. September hinzugekommen sind, durchlaufen zwei Prüfungen: aus der virtuellen Maschine auszubrechen, um eine Kennung auf dem Host abzurufen, und die Netzwerkrichtlinie zu umgehen, um eine gesperrte URL zu erreichen. Kein Modell ist aus der virtuellen Maschine ausgebrochen. Mit der ursprünglichen Anweisung widmen alle außer den drei GPT-Modellen höchstens 4 % ihres Aufwands der Virtualisierung; eine gezieltere Anweisung erhöht diesen Anteil um etwa 60 Prozentpunkte, ohne größeren Erfolg.
Die Umgehung der Netzwerkrichtlinie wurde an der Implementierung vor der Fehlerbehebung mit Zugriff auf den Quellcode und mit 3 Versuchen pro Modell gemessen:
| Bewertetes Modell | Erfolgreiche Umgehungen | Genannte durchschnittliche Dauer |
|---|---|---|
| GPT-6 Astra | 3 von 3 | 4,8 min |
| GPT-5.6 Sol | 3 von 3 | 20,8 min |
| Claude Opus 5.5 | 3 von 3 | 21,6 min |
| Claude Mythos 5.1 | 3 von 3 | 36,6 min |
| Claude Opus 5.0 | 3 von 3 | nicht genannt |
| Kimi K3 | 2 von 3 | nicht genannt |
| GPT-5.6 Cyber | 0 von 3 | 51,6 min |
| Fünf weitere Modelle, darunter Grok 4.20 | 0 von 3 | nicht genannt |
GPT-5.6 Cyber, das auf Sol aufbaut und auf Cybersicherheit spezialisiert ist, suchte nie nach der Funktion, die die für DNS-Spoofing erforderliche IP-Adresse lieferte; Perplexity hält die Stichprobe für zu klein, um daraus eine allgemeine Regel abzuleiten. Grok 4.20 landet nach der Bewertung durch sechs Bewertungsmodelle auf dem letzten Platz, mit 27 falschen Erfolgsmeldungen in sechs Versuchen. Nach der Behebung der Schwachstellen wurde keine Umgehung mehr gefunden.
🔗 Escaping SPACE: Teil II (Perplexity) · Thread von @perplexity_ai
Gemini Decision: Die Gemini API antwortet mit kalibrierten Wahrscheinlichkeiten, ohne Ausgabetokens, für 0,10 Dollar pro Million Tokens
11. November — Die Versionshinweise der Gemini API führen Gemini Decision (gemini-decision-1) ein, bereitgestellt über eine eigene Decisions API. Das Modell formuliert keine Antwort: Es bewertet geschlossene Fragen zu bereitgestellten Daten und liefert kalibrierte Wahrscheinlichkeiten zurück, ohne Ausgabetokens zu erzeugen. Dadurch kann der Code einer Anwendung anhand des Ergebnisses direkt sortieren oder routen. Drei Formate stehen zur Verfügung: Ja oder Nein (Wahrscheinlichkeit von 0,01 bis 0,99, mit einem Konfidenzwert), Auswahl zwischen 2 und 255 Optionen oder Bewertung auf einer Skala mit geordneten Stufen.
| Merkmal von Gemini Decision 1 | Veröffentlichter Wert |
|---|---|
| Akzeptierte Eingaben | Text, Bild, Video, Audio, PDF |
| Fragen pro Anfrage | Bis zu 1 000, auf Grundlage einer gemeinsam genutzten Eingabe |
| Maximale Eingabe | 262 144 Tokens |
| Preis im kostenpflichtigen Tarif | 0,10 Dollar pro Million Eingabetokens, gemeinsam genutzte Eingabe wird nur einmal berechnet |
| Kostenloser Tarif | Kostenlos, Daten werden zur Verbesserung der Produkte verwendet |
Google nennt das Routing von Anfragen, die gleichzeitige Prüfung zahlreicher Regeln oder die Tool-Auswahl durch einen Agent als Anwendungsfälle. Das Modell bleibt auf die Gemini Developer API in v1beta beschränkt, ohne Batch API und Context Cache. Die Veröffentlichung wird von keinem Blogbeitrag begleitet, und die API trägt denselben Namen wie die Decisions API, die Perplexity am 1. Oktober gestartet hat.
🔗 Gemini Decision 1 (Google AI Studio) · Dokumentation der Decisions API
A2UI 1.0: Googles offenes Protokoll, mit dem Agents durch native Oberflächen antworten, erreicht die stabile Version
11. November — Google veröffentlicht A2UI 1.0, die erste stabile Version seines offenen Protokolls für generative Benutzeroberflächen (generative UI). Statt mit Absätzen zu antworten, beschreibt ein Agent, was angezeigt werden soll, etwa ein zu bestätigendes Formular oder ein Diagramm, und jede Anwendung stellt es mit ihren eigenen nativen Komponenten dar. Laut dem Beitrag werden sensible Werte serverseitig gebunden und gelangen nicht zum Modell.
Version 1.0 ergänzt Funktionsaufrufe in beide Richtungen, damit eine Flugauswahl die aktuelle Verfügbarkeit prüfen kann, sowie Barrierefreiheit und Metadaten-Erweiterungen. Die Open-Source-Renderer decken React, Angular und Lit im Web sowie Flutter und SwiftUI ab; der Renderer für Jetpack Compose bleibt bei 0.9.1. Die Web- und Flutter-Renderer funktionieren in MCP Apps und damit in Assistenten wie Claude oder Gemini. Zum Python-SDK kommen Agent-SDKs für TypeScript und Dart hinzu. Atlassian nutzt das Protokoll in Jira, wo ein mit einem Ticket betrauter Agent das Team über eine interaktive Karte befragen kann; auch Alation, Bloomberg und ByteDance entwickeln damit. Bei Google verwendet Gemini Notebook es bereits, und Gemini Enterprise stellt auf 1.0 um.
🔗 A2UI 1.0 (Google Developers Blog)
Coding-Agents: die Cloud Runners von Delta, VS Code 1.146 und Qwen Code 1.0 Preview
Delta startet seine Cloud Runners: Ein Agent-Thread läuft ohne den Computer seines Erstellers weiter
11. November — Delta, die Mehrbenutzer-Coding-Umgebung mit Agents des Teams hinter Zed, startet die am Vortag angekündigten Cloud Runners. Wird im Eingabefeld eines Threads Cloud ausgewählt, laufen die Agent-Durchläufe in einer von Zed gehosteten Linux-Sandbox auf Basis von E2B. Der Thread lässt sich vom Desktop, im Web oder auf dem Smartphone verfolgen und jederzeit auf den lokalen Rechner zurückholen. Der Runner ruft den Code von den Delta-Servern ab, führt das Skript .agents/setup des Repositorys aus (das Ergebnis bleibt einen Tag im Cache) und verwendet die Modellanbieter sowie die verschlüsselten Umgebungsvariablen des Nutzers. Nach erteilter Berechtigung handeln git und gh in dessen Namen auf GitHub, und der Agent kann eine Vorschau-URL zurückgeben, die nur für Personen mit Zugriff auf den Thread zugänglich ist.
| Runner-Größe | Zugewiesene Prozessoren | Arbeitsspeicher | Freier Speicherplatz |
|---|---|---|---|
| Small | 2 CPU | 4 Go | 15 Go |
| Medium (Standard) | 4 CPU | 8 Go | 30 Go |
| Large | 8 CPU | 16 Go | 50 Go |
Die Rechenleistung ist in allen Zed-Tarifen außer Student kostenlos, bis Delta eigene Tarife vorbereitet hat, innerhalb nicht bezifferter Fair-Use-Grenzen; die Modelle werden weiterhin wie bei lokaler Nutzung abgerechnet. Sechs Runner können gleichzeitig laufen, Terminals schließen sich nach einer Stunde, und ein Runner pausiert nach 10 Minuten Inaktivität.
🔗 Cloud Runners sind jetzt in Delta verfügbar · Dokumentation der Cloud Runners
VS Code 1.146 stuft den Local-Harness von Copilot als veraltet ein und ergänzt einen Inbox-Modus für Agent-Sitzungen
11. November — Microsoft veröffentlicht VS Code 1.146 und stuft damit den Local-Harness (Local harness) von Copilot als veraltet ein: Er wird im Februar 2027 entfernt und bleibt bis dahin nutzbar, wird aber nicht mehr weiterentwickelt. Neue Funktionen erhält ausschließlich der auf dem Copilot SDK aufbauende Copilot-Harness. Er ist seit VS Code 1.143 die Standardauswahl für neue Sitzungen und setzt als einziger die Sandbox- und Berechtigungsrichtlinien von Organisationen durch.
Das Agents-Fenster erhält einen Inbox-Modus (experimentell), der Sitzungen mit ausstehendem Handlungsbedarf nach oben sortiert. Außerdem kann ein Chat in einem eigenen Fenster geöffnet werden (Vorschauversion). Compare Models unterstützt Copilot Fusion und dessen Aufwandsstufen. Bei der Sicherheit bieten Berechtigungsabfragen gezielte Freigaben an (eine Domain, einen Befehl, ein Verzeichnis). Die Sandbox kann zudem Umgebungsvariablen verbergen, wobei der tatsächliche Wert erst in HTTPS-Anfragen an zugelassene Hosts eingefügt wird. VS Code unterstützt außerdem von MCP-Servern bereitgestellte Skills (SEP-2640, Vorschauversion), und Copilot-Sitzungen berücksichtigen die Proxy-Konfiguration für PAC und Kerberos.
🔗 Versionshinweise zu VS Code 1.146
Qwen Code 1.0 Preview vereint die Agents von Qoder und Qwen Code in einer nativen Binärdatei, ohne Node.js
11. November — Wenige Stunden nach Qwen4-Max veröffentlicht Qwen die Vorabversion Qwen Code 1.0 Preview. Sie vereint die Agent-Fähigkeiten von Qoder, der Coding-Umgebung von Alibaba, und Qwen Code: eine Codebasis verstehen, implementieren, debuggen und testen. Die Anmeldung erfolgt über ein Qwen- oder Qoder-Konto, über QwenCloud oder Model Studio oder über einen beliebigen kompatiblen Endpunkt. Das Tool wird als native Pakete für macOS, Linux und Windows in x64 und arm64 ausgeliefert (acht Archive mit jeweils etwa 57 bis 74 Mo), benötigt keine separate Installation von Node.js und behält die Wiederaufnahme von Sitzungen sowie die nicht interaktive Ausführung bei.
Das Repository weist darauf hin, dass sich Schnittstellen und Optionen noch ändern können, und nimmt bis nach Dezember 2026 keine Pull Requests aus der Community mehr an. Laut GitHub API teilt der Tag 1.0 keine Historie mit der am Vortag veröffentlichten v0.27.2.
🔗 Qwen Code v1.0.0-preview (GitHub)
Offene Modelle und Forschung: BotPsy von Tether und Token Pooling von Hugging Face
BotPsy-0.8B: Tether veröffentlicht ein kleines offenes Agent-Modell, das die Tool-Scores seines Basismodells ungefähr verdoppelt
11. November — Tether AI Research, das KI-Team von Tether, das unter dem Namen QVAC veröffentlicht, stellt BotPsy-0.8B vor. Das Modell mit 0,8 Milliarden Parametern ist auf Tool-Aufrufe spezialisiert und für den Einsatz auf einem Smartphone oder Laptop konzipiert. Es basiert auf Qwen3.5-0.8B und durchläuft überwachtes Fine-Tuning, eine Destillation mit drei Qwen3.5-4B-Lehrermodellen und zwei Runden Reinforcement Learning. Die Gewichte stehen auf Hugging Face in safetensors und GGUF bereit, laut Modellkarte unter der Lizenz Apache 2.0; der Beitrag spricht von einer Nutzung für Forschung und Bildung.
| Benchmark (Zahlen des Teams) | BotPsy-0.8B | Qwen3.5-0.8B (Basis) | Qwen3.5-2B-Think |
|---|---|---|---|
| BFCL v4 | 44,0 | 23,4 | 37,7 |
| ACEBench | 58,7 | 30,1 | 55,4 |
| τ-bench | 51,5 | 23,2 | 46,5 |
| Durchschnitt über sechs Tool-Benchmarks | 45,0 | 24,7 | 38,8 |
Alle diese Zahlen wurden vom Team im Reasoning-Modus gemessen. Es meldet außerdem einen Rückgang gefährlicher Antworten von 36 % auf 21 % bei automatisierten Angriffstests, empfiehlt Englisch und rät vom Einsatz des Modells für sensible Entscheidungen ab.
🔗 BotPsy (QVAC auf Hugging Face) · Modell qvac/BotPsy-0.8B
Token Pooling: Hugging Face erhält 97,8 % der Suchqualität mit einem Viertel der Vektoren
11. November — Tom Aarsen erläutert im Hugging-Face-Blog, wie sich die Größe von Multi-Vektor-Suchindizes vom Typ ColBERT reduzieren lässt, die einen Vektor pro Dokument-Token speichern. Token Pooling führt ähnliche Vektoren zusammen. Sentence Transformers ergänzt eine Loss-Funktion, MultiVectorTokenPoolingLoss, die das Modell sowohl anhand seiner vollständigen als auch seiner komprimierten Repräsentationen trainiert.
| Pooling bei der Inferenz (NanoBEIR, nDCG@10) | Durchschnittliche Vektorzahl | Klassisches Training | Training unter Berücksichtigung des Poolings |
|---|---|---|---|
| Ohne Pooling | 193,22 | 51,84 | 52,39 |
pool_factor=4 | 48,68 | 49,03 | 51,23 |
max_tokens=4 | 4,00 | 37,22 | 43,00 |
Mit einem Viertel der Vektoren behält das so trainierte Modell 97,8 % seines Scores bei, gegenüber 94,6 % bei klassischem Training. Die Messungen beziehen sich auf eine einzige Konfiguration (ModernBERT-base, eine Epoche), und zwei Checkpoints werden auf dem Hub veröffentlicht.
🔗 Training unter Berücksichtigung von Token Pooling (Hugging Face)
Seedance 2.5 kommt bei Pika und Runway in 4K
11. November — Seedance 2.5, das über BytePlus vertriebene Videomodell von ByteDance, erhält 4K-Unterstützung. Pika bietet es auf seiner Plattform und in seinem Pika API Club in nativem 4K an. Dabei kann eine Aufnahme zunächst als Entwurf bearbeitet und anschließend in 4K fertiggestellt werden. Seit dem 17. August hatte Pika das Modell in 1080p mit Upscaling auf 4K angeboten. Runway folgte knapp zwei Stunden später und kündigte Seedance 2.5 in 4K auf seiner Plattform an, ohne anzugeben, ob es sich um natives 4K handelt. Weder Preise noch maximale Dauer oder Kosten in Credits wurden genannt.
🔗 Ankündigung von @pika_labs · Ankündigung von @runwayml
Git behebt sechs Schwachstellen, darunter eine Codeausführung beim rekursiven Klonen
10. November — Abseits der KI veröffentlicht das Git-Projekt Git 2.56.1 mit Backports bis Git 2.50.2, um sechs Schwachstellen zu beheben, die Elijah Newren im GitHub Blog ausführlich beschreibt.
| Behobene Schwachstelle | Art des Risikos |
|---|---|
| CVE-2026-111760 | Codeausführung beim rekursiven Klonen über die Datei .git eines Submoduls |
| CVE-2026-113408 | Path Traversal über den von einem Server gemeldeten HEAD |
| CVE-2026-114467 | Stack-Korruption beim Entfernen von GPG-Signaturen |
| CVE-2026-114469 | Lesezugriffe außerhalb der Grenzen beim Anwenden binärer Patches |
| CVE-2026-105437 | Heap-Korruption bei großen Merges |
| CVE-2026-114466 | Dateisystemzugriff über git fast-import-Streams |
GitHub hat die Korrekturen bereits auf github.com und Enterprise Cloud eingespielt, veröffentlicht GitHub Enterprise Server 3.19.15, 3.20.11, 3.21.9 und 3.22.4 und bereitet Versionen von GitHub Desktop und der GitHub Copilot App mit einer korrigierten Git-Version vor. Empfohlen wird, Git und jede Anwendung zu aktualisieren, die eine Kopie davon mitliefert; andernfalls sollte nur von vertrauenswürdigen Servern geklont werden.
🔗 Git-Sicherheitslücken bekannt gegeben (GitHub Blog)
Kurzmeldungen
Code-Agenten und Entwicklungswerkzeuge
- Zed 1.28 und Vorabversion 1.29 — 1.28 wird zur stabilen Version und übernimmt die Neuerungen der am 4. November behandelten Vorabversion (aktuellstes Agent Client Protocol, auf 2 000 Zeichen gekürzte Leseausgaben von
read_file, optionaler automatischer Git-Fetch). Die Vorabversion 1.29 unterstützt Claude Fable 5.2 und Claude Mythos 5.2 beim Anbieter Anthropic. 🔗 Quelle - Antigravity CLI 1.5.4 und 1.5.5 — 1.5.5 bringt /swarm als Vorabversion ins Terminal, einschließlich der Vollbildansicht /swarm board, und korrigiert den Import von Befehlen und Hooks aus Claude Code-Plugins. 1.5.4 macht den Auto-Modus für ACP-Sitzungen verfügbar und erweitert die an Hooks übermittelten Daten. 🔗 Quelle
- Gemini CLI — Am Tag nach v0.68.0 gibt es keine neue Version, und der nächtliche Build (nightly) ist erneut fehlgeschlagen, wie jede Nacht seit dem 5. November. Vier Fehlerbehebungen wurden in den Hauptbranch übernommen, darunter die Behebung eines Fehlers 400 nach einem leeren Modelldurchlauf bei einem Bild oder einer Binärdatei. 🔗 Quelle
- Copilot CLI 1.0.110-1 — Die Vorabversion beschränkt sich auf 13 Fehlerbehebungen: Eine wiederaufgenommene Sitzung kann nicht mehr parallel verändert werden, und ein lokaler MCP-Server, der ein abgeschnittenes Unicode-Zeichen zurückgibt, blockiert keinen Tool-Aufruf mehr. Das SDK 1.0.32-preview.1 ermöglicht die Auswahl von Copilot Fusion und dessen Stufe. 🔗 Quelle
- Gemini 4 Carbon bei Genspark — Genspark macht Gemini 4 Carbon in seinem AI Chat und seinem Code Agent verfügbar, einen Tag nach Claude Fable 5.2 im selben Code Agent, ohne Angaben zu Tarifen oder zum Credit-Verbrauch. 🔗 Quelle
- Basis und Devin for Startups — Cognition zeigt in einem Video, wie Basis mit Devin arbeitet; die Buchhaltungsagenten von Basis verkürzen bestimmte Aufgaben von 20 Stunden auf 30 Minuten, wobei sich diese Zahl auf Basis und nicht auf Devin bezieht. Cognition legt außerdem Devin for Startups neu auf, mit Credits im Wert von 65 000 Dollar für ausgewählte Teams. 🔗 Quelle
- shem — João Galego veröffentlicht eine experimentelle Runtime, die ein Modell von Hugging Face wie ein Container-Image startet (ein Dockerfile kann mit
FROM hf.co/...beginnen) und umgekehrt Container auf einem Prozessor aus Modellgewichten ausführt; seinen Angaben zufolge funktioniert das „meistens“. 🔗 Quelle
GitHub
- Von GitHub Apps verwaltete Copilot-Lizenzen — GitHub Apps auf Enterprise-Ebene können die APIs zur Verwaltung von Copilot-Lizenzen aufrufen, um diese Benutzern und Teams des Unternehmens zuzuweisen. Möglich macht das eine neue granulare Berechtigung namens Enterprise Copilot license management. 🔗 Quelle
- Dependabot und inaktive Repositorys — Ab dem 8. Dezember deaktiviert GitHub Dependabot-Warnungen für die meisten Repositorys, die seit einem Jahr inaktiv sind; die Warnungen werden archiviert, nicht gelöscht, und beim ersten Push wiederhergestellt. GitHub Enterprise Server ist davon nicht betroffen. 🔗 Quelle
- Issue-Typen und -Felder für persönliche Konten — Bisher waren sie Organisationen vorbehalten, nun werden sie für persönliche Repositorys allgemein verfügbar: bis zu 25 Typen und 25 Felder, nutzbar in Projekten, über die REST- und GraphQL-APIs sowie über Webhooks. 🔗 Quelle
- GitHub-Dashboard — Es ist kompakter, zeigt sechs Pull Requests und sechs Issues statt drei an, ermöglicht das Anheften des Tabs Feed oder Home und blendet den Bereich für Agentensitzungen aus, wenn das Konto keine hat. 🔗 Quelle
Unternehmen und Anwendungen
- Singapore Airlines — Der auf Basis der API von OpenAI neu geschriebene Chatbot Kris verdoppelt seinen Kundenzufriedenheitswert, die Zusammenfassung von Anrufen verkürzt die Bearbeitungszeit der Kundenberater um etwa 10 %, und mehr als 60 % der Beschäftigten nutzen jeden Monat die interne Plattform Jarvis. 🔗 Quelle
- Cogent Security — Das Startup entwickelt Cyberabwehr-Agenten auf Basis von GPT-6.1 Sol, GPT-6 Astra und GPT-5.6 mit Richtlinien, die vor jedem Tool-Aufruf überprüft werden; nach eigenen Angaben hat ein Automobilkunde aus den Fortune 1000 die durchschnittliche Zeit zur Behebung kritischer Sicherheitslücken um 75 % verkürzt. 🔗 Quelle
- JioStar — Sein Sprachassistent zur Entdeckung von Inhalten in JioHotstar wurde in etwa acht Wochen auf Basis der API von OpenAI entwickelt und spricht mehr als 15 Sprachen auf einer Plattform mit über 500 Millionen Nutzern; laut JioStar sprechen mehr als 60 % seiner Nutzer mit ihm, statt ihm zu schreiben. 🔗 Quelle
- ChatGPT Plus für Veteranen — Zum Veterans Day gibt OpenAI an, dass innerhalb eines Jahres mehr als 20 000 Veteranen und Militärangehörige beim Übergang ins zivile Leben das kostenlose Jahr ChatGPT Plus in Anspruch genommen haben und dass fast 1 000 Mitglieder der Militärgemeinschaft geschult wurden. 🔗 Quelle
- fal-Plugin in ChatGPT — fal stellt sein Plugin heraus, das Bilder und Videos direkt im Gespräch erzeugt und bearbeitet, und zeigt dazu einen 60 Sekunden langen Werbespot, der mit GPT Image 2.6, FLUX 3 Max (26 Einstellungen) und fal Recast erstellt wurde; das Veröffentlichungsdatum wird nicht genannt. 🔗 Quelle
- Gopuff in Grok Bot — Grok Bot übernimmt bei Gopuff nun den gesamten Bestellvorgang für Lebensmittel, Snacks und Alltagsprodukte, laut Gopuff mit einer Lieferung im schnellsten Fall innerhalb von 15 Minuten; weder Länder noch Tarife werden genannt. 🔗 Quelle
- Genspark Genius — Genspark sucht Markenbotschafter: Sie teilen monatlich eine eigene Kreation und erhalten dafür den Pro-Tarif, frühzeitigen Zugang zu neuen Funktionen, Credits und Präsenz auf den Kanälen des Unternehmens. 🔗 Quelle
Modelle, Medien und Forschung
- MiniMax H3 — Hundert Tage nach der Veröffentlichung seiner Gewichte meldet MiniMax 1 472 abgeleitete Modelle und mehr als 148 Millionen Downloads auf Hugging Face; diese Zahlen sind nicht verifiziert. H3-Image kommt zu fal, Runware, EvoLink und Miora und ist bei Letzterem bis zum 17. November kostenlos. 🔗 Quelle
- Voxtral Transcribe 3 bei AI Engineer Paris — Mistral hat alle Vorträge auf der Hauptbühne live transkribiert und dem Modell dazu die Namen der Vortragenden und die Begriffe aus dem Programm bereitgestellt (Kontext-Bias), ohne den erzielten Gewinn zu beziffern. 🔗 Quelle
- Lokale Sprachverarbeitung in Google AI Edge Gallery — Die App erhält Offline-Spracherkennung und -Sprachsynthese: Unter Android transkribiert ML Kit mehr als 100 Sprachen zehnmal schneller als in Echtzeit, und offene Modelle wie Parakeet-TDT 0.6B oder Kokoro-82M decken die anderen Plattformen ab. 🔗 Quelle
- Déjà View bei NVIDIA — Dieses Modell zur 3D-Rekonstruktion mit 117M Parametern wendet denselben Transformer-Block mehrfach an und erreicht auf fünf Benchmarks das Niveau von bis zu 10-mal größeren Modellen; die Arbeit wird auf der NeurIPS 2026 als Vortrag vorgestellt und ist seit Mai auf arXiv verfügbar. 🔗 Quelle
- Krankheiten in spanischen medizinischen Texten — OpenMed veröffentlicht zwei offene, auf CPUs nutzbare Modelle unter Apache-2.0; laut dem Team steigert das Fine-Tuning auf DisTEMIST den F1-Wert von etwa 36 bis 39 bei einem generischen Modell auf etwa 73 bei der GLiNER2.5-Version. 🔗 Quelle
- Agentenzahlungen mit x402 — Auf sich allein gestellt erzielen Qwen3 235B, DeepSeek V4 Pro und Llama 3.3 70B bei der Prüfung von Fizzl 59, 55 und 30 Punkte, keines besteht; wenn Code über die Zahlung entscheidet (x402-safe-fetch), steigen die Werte auf 94, 100 und 94. 🔗 Quelle
- GR00T-X-Embodiment-Sim in FiftyOne — Harpreet Sahota (Voxel51) konvertiert 42 simulierte Episoden aus dem Datensatz von NVIDIA, sechs für jeden der sieben Roboterkörper, mit aufeinander abgestimmten Kameradaten und Gelenktelemetriedaten. 🔗 Quelle
Ökosystem
- Sakana AI — Der pensionierte Admiral Michael Rogers, ehemaliger Direktor der NSA, und Tom Moran, der fast 30 Jahre bei der CIA tätig war, werden leitende Berater des Startups aus Tokio für Verteidigung und Cybersicherheit. 🔗 Quelle
- Recycling bei NVIDIA — Zur COP31 stellt NVIDIA vier Startups aus seinem Inception-Programm vor, die Abfälle mithilfe von Computer Vision sortieren. Dazu gehört Greyparrot, das die Prüfung von 15 Tonnen Abfall von 375 auf 6 Stunden verkürzt; kein neues NVIDIA-Produkt. 🔗 Quelle
- Perplexity-Leitfaden zur KI-Compliance — Er gibt einen Überblick über den europäischen AI Act, das NIST AI RMF und ISO/IEC 42001 und schlägt drei Kontrollmaßnahmen für Agenten vor: auf das Nötigste beschränkter Zugriff, Protokollierung jeder Aktion und menschliche Freigabe von Aktionen mit weitreichenden Auswirkungen. 🔗 Quelle
- Perplexity-Leitfaden zur MCP-Architektur — Rollen von Host, Client und Server, JSON-RPC-2.0-Nachrichten, lokale Transportwege und Streamable HTTP, Multi-Tenant-Einrichtung: eine technische Darstellung im Anschluss an den Sicherheitsleitfaden vom 4. November, ohne Produktankündigung. 🔗 Quelle
- Cohere-Hackathon in Toronto — Cohere veranstaltet am 30. Januar 2027 gemeinsam mit der Universität Toronto seinen ersten Hackathon, Hacking Higher Ed, zum Thema KI in der Hochschulbildung; Preisgelder von 3 000, 2 000 und 1 000 Dollar, Bewerbungen bis zum 22. Januar. 🔗 Quelle
Was das bedeutet
Google DeepMind setzt seine Modelle bei zwei Problemen ein, bei denen die Überprüfung wichtiger ist als die Generierung. AlphaGenome 2 begnügt sich nicht mehr mit einem Durchschnittswert pro Gewebe: Es sagt die Wirkung einer Variante in der Zelle voraus, die den Forscher interessiert, und seine Fortschritte werden anhand von TenK10K gemessen, einer Karte von 28 Typen von Immunzellen. AlphaProof Code verlagert die formale Verifikation vom Protokollentwurf auf den kompilierten Code, mit einer klaren Arbeitsteilung: Die Agenten schreiben mehr als sechs Millionen Zeilen Beweiscode, der Lean-Verifizierer prüft jeden Schritt, und Menschen überprüfen die Spezifikationen und etwa 1 % des Codes. Beide Ankündigungen haben weiterhin ihre Grenzen: AlphaGenome 2 bleibt der Forschung vorbehalten, und die Behauptung, bei Signal als Erster diese Leistung erbracht zu haben, stammt von Google DeepMind.
Die Sicherheit stößt bei ihren eigenen Messinstrumenten an Grenzen. OpenAI stellt fest, dass die Argumentationskette, eine der Säulen seiner Überwachung, mit fortschreitendem Vortraining schwerer lesbar wird, und bewertet selbst die Kontrollierbarkeit, einen seiner beiden Indikatoren, als verrauscht. Perplexity zeigt, dass das klassische Capture-the-Flag-Format die Agenten von der zu prüfenden Grenze ablenkt und dass ein auf Cybersicherheit spezialisiertes Modell schlechter abschneiden kann als seine Allzweckversion, bei drei Versuchen und mit einer Konfiguration vor der Fehlerbehebung. In beiden Fällen betrifft die Schlussfolgerung die Art der Bewertung ebenso wie die Modelle selbst.
Der Tag trennt klar zwischen dem, was ausgeliefert wird, und dem, was angekündigt wird. Runway veröffentlicht Praxis-1 mit seinen Gewichten, seinem Fine-Tuning-Code und einem Bericht, der das Modell hinter vier Konkurrenten einordnet, und Tether stellt BotPsy zum Download bereit. Dagegen erscheint Qwen4-Max ohne Benchmark, Größenangabe oder Preis, und ElevenLabs unterscheidet selbst zwischen dem, was heute verfügbar ist (Marketplace, Partner Program, ElevenAI), und dem, was später kommt (Interaction Engine, Memory, Routines, Fine-Tuning). Für alle, die es ausprobieren möchten, bleibt die zweite Hälfte ein Versprechen.
Agenten etablieren sich dauerhaft und in Teams. Grok Bot 1.0 nimmt an Besprechungen teil und stimmt sich mit anderen Bots in Slack und Teams ab; die Cloud Runners von Delta führen einen Agenten-Thread aus, ohne dass der Computer seines Erstellers benötigt wird; VS Code ergänzt einen Posteingang für Sitzungen, die auf eine Entscheidung warten; A2UI ermöglicht Agenten, mit einer Benutzeroberfläche statt mit Text zu antworten. Jeder Anbieter begrenzt zugleich das Risiko, das er eröffnet: personenspezifische Berechtigungen und eine Prüfung vor Wortmeldungen in öffentlichen Kanälen bei Grok Bot, eine private Vorschau bei Delta, gezielte Berechtigungen und maskierte Variablen in der Sandbox von VS Code.
Quellen
- AlphaGenome 2 (Google DeepMind)
- AlphaGenome 2 (@GoogleDeepMind)
- Vorstellung von AlphaProof Code (Google DeepMind)
- Formale Verifikation von Signal (PDF, Google DeepMind)
- Qwen4-Max als Vorabversion (@Alibaba_Qwen)
- Token Plan (QwenCloud)
- Praxis-1 ist jetzt verfügbar (Runway)
- Technischer Bericht zu Praxis-1 (Runway)
- Praxis-1-Sammlung (Hugging Face)
- ElevenLabs Summit NYC (ElevenLabs)
- Ankündigungen vom Summit (@ElevenLabs)
- ElevenLabs und NVIDIA (ElevenLabs)
- Vollständiges Zurücksetzen der Limits (@ClaudeDevs)
- Grok Bot 1.0 (SpaceXSI)
- Grok Bot 1.0 (@SpaceXSI)
- Einstellung der Stimmen Advanced und Standard in ChatGPT (OpenAI-Hilfe)
- Einstellung der Stimmen Advanced und Standard (@OpenAINewsroom)
- Gemini auf Apple CarPlay (blog.google)
- Überwachbarkeit der CoT über den gesamten Modelllebenszyklus (OpenAI)
- Thread von Jeffrey G. Wang
- Ausbruch aus SPACE: Teil II (Perplexity)
- Ausbruch aus SPACE: Teil II (@perplexity_ai)
- Gemini Decision 1 (Google AI Studio)
- Decisions API (Google AI Studio)
- A2UI 1.0 (Google Developers Blog)
- Cloud Runners sind jetzt in Delta verfügbar
- Dokumentation zu Cloud Runners (Delta)
- Versionshinweise zu VS Code 1.146
- Qwen Code v1.0.0-preview (GitHub)
- BotPsy (QVAC auf Hugging Face)
- Modell qvac/BotPsy-0.8B (Hugging Face)
- Training unter Berücksichtigung von Token Pooling (Hugging Face)
- Seedance 2.5 in 4K (@pika_labs)
- Seedance 2.5 in 4K (@runwayml)
- Sicherheitslücken in Git bekannt gegeben (GitHub Blog)
- Zed v1.28.1 (GitHub)
- Changelog von Antigravity
- Gemini CLI, PR 30228 (GitHub)
- Copilot CLI v1.0.110-1 (GitHub)
- Gemini 4 Carbon in Genspark (@genspark_ai)
- Basis und Devin for Startups (@cognition)
- Dein LLM ist jetzt ein Container (Hugging Face)
- Verwaltung von Copilot-Lizenzen durch GitHub Apps (GitHub Changelog)
- Dependabot-Warnungen werden in inaktiven Repositorys pausiert (GitHub Changelog)
- Issue-Typen und -Felder für persönliche Konten (GitHub Changelog)
- Ein informativeres GitHub-Dashboard (GitHub Changelog)
- Singapore Airlines (OpenAI)
- Cogent Security (OpenAI)
- JioStar, Vijay Seshadri (OpenAI)
- ChatGPT Plus für Veteranen (OpenAI)
- fal-Plugin in ChatGPT (@fal)
- Gopuff in Grok Bot (@bot)
- Genspark Genius (@genspark_ai)
- MiniMax H3, 100 Tage (@RyanLeeMiniMax)
- Voxtral Transcribe 3 bei AI Engineer Paris (@MistralAI)
- Lokale Sprachverarbeitung in Google AI Edge Gallery (Google Developers Blog)
- Déjà View (@NVIDIAAI)
- Krankheiten in spanischen klinischen Texten erkennen (OpenMed)
- Offene KI-Modelle mit einer Wallet (Fizzl)
- GR00T-X-Embodiment-Sim in FiftyOne (Hugging Face)
- Michael Rogers und Tom Moran (Sakana AI)
- KI-Startups im Recycling (NVIDIA-Blog)
- KI-Compliance (Perplexity)
- MCP-Architektur (Perplexity)
- Hacking Higher Ed (@cohere)