Google DeepMind présente AlphaGenome 2, qui prédit l’effet d’une mutation de l’ADN dans un type de cellule précis, et AlphaProof Code, qui a prouvé en quatre semaines des propriétés de sécurité clés du protocole Signal jusqu’au code compilé. Qwen ouvre la génération Qwen4 avec Qwen4-Max en préversion, sans benchmark ni fiche technique, Runway publie les poids de son modèle robotique Praxis-1 sous Apache 2.0, et ElevenLabs réunit son Summit de New York. Côté sûreté, OpenAI constate que le raisonnement de ses modèles devient plus difficile à surveiller, et Perplexity confronte douze modèles à son bac à sable SPACE.
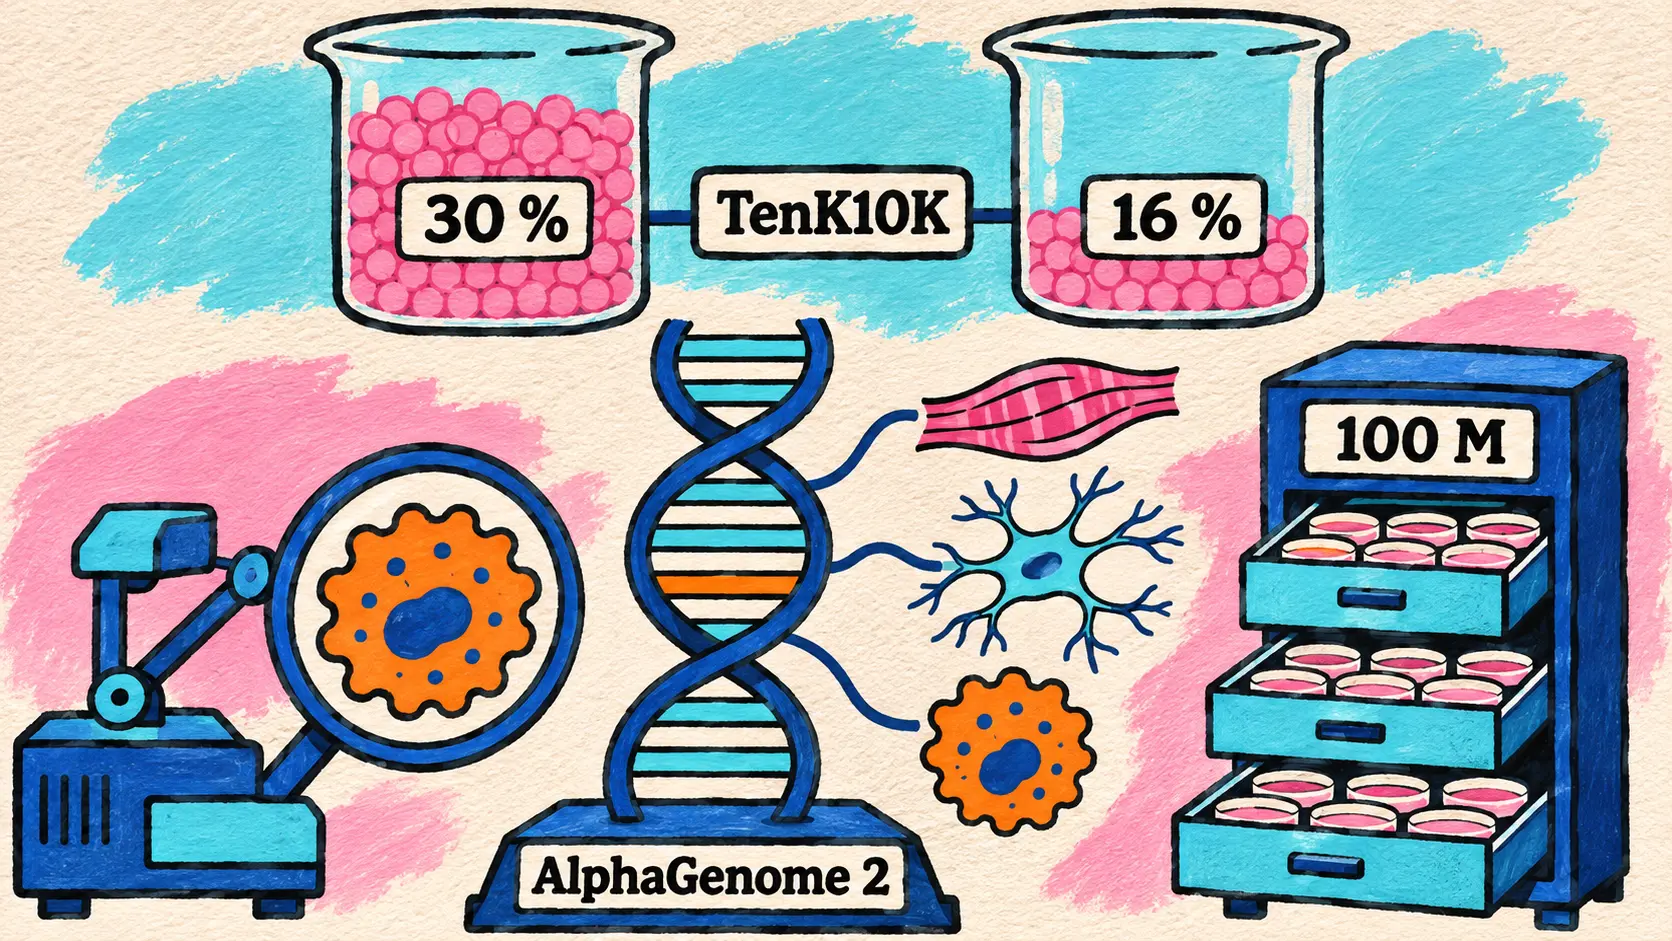
AlphaGenome 2 prédit l’effet des variants de l’ADN par type de cellule et retrouve 30 % des variants causaux, contre 16 %
11 novembre — Google DeepMind présente AlphaGenome 2, la nouvelle génération de son modèle de séquence ADN, après un premier AlphaGenome présenté l’an dernier et AlphaGenome Atlas en septembre. Le changement tient en un mot : le modèle devient conditionnel. Le premier AlphaGenome produisait des prédictions fixes pour des tissus et des lignées cellulaires ; AlphaGenome 2 reçoit, avec une séquence d’un million de lettres, la condition biologique visée (un tissu, un type ou un état cellulaire), choisie dans un catalogue de référence ou construite à partir des données unicellulaires (single-cell) d’un laboratoire.
Your heart, brain, and immune system share the same DNA sequence. So how can a single-letter change affect disease in some cells, while sparing the rest? AlphaGenome 2 is our new AI model that zooms in on specific cells to help scientists understand what drives disease.
🇫🇷 Votre cœur, votre cerveau et votre système immunitaire partagent la même séquence d’ADN. Alors comment le changement d’une seule lettre peut-il agir sur une maladie dans certaines cellules tout en épargnant les autres ? AlphaGenome 2 est notre nouveau modèle d’IA qui zoome sur des cellules précises pour aider les scientifiques à comprendre ce qui provoque les maladies. — @GoogleDeepMind sur X
Selon Google DeepMind, le modèle a été entraîné sur plus de 100 millions de profils cellulaires couvrant 68 tissus, et identifie près de deux fois plus de variants qui modifient l’expression des gènes que le précédent modèle de l’état de l’art. Il ajoute une sortie très demandée, la méthylation de l’ADN, et sait déduire une mesure manquante à partir d’une autre. Il s’adapte aussi, sans réentraînement, à un nouvel état cellulaire décrit par quelques dizaines de cellules, comme des lymphocytes T activés après une vaccination ARNm contre la COVID-19.
| Mesure sur TenK10K (28 types de cellules immunitaires) | AlphaGenome 2 | AlphaGenome affiné et autres outils spécialisés |
|---|---|---|
| Variants causaux retrouvés | 30 % | 16 % |
| Effets directionnels sur les gènes | 43 % | 23 % |
Le modèle reproduit enfin par le calcul un mécanisme récemment décrit dans les maladies inflammatoires chroniques de l’intestin : un variant situé dans un interrupteur régulateur éloigné, qui suractive le gène ETS2 dans les macrophages intestinaux.
AlphaGenome 2 est disponible dès aujourd’hui pour la recherche non commerciale, via l’API AlphaGenome et des tutoriels Colab, et en préversion privée pour la recherche commerciale. Des AlphaGenome 2 Skills arriveront « bientôt » dans Antigravity, et un appel à cas d’usage reste ouvert jusqu’au 30 novembre. L’outil est réservé à la recherche : ni usage clinique, ni diagnostic.
🔗 AlphaGenome 2 (Google DeepMind)
AlphaProof Code : Google DeepMind prouve des propriétés de sécurité clés du protocole Signal jusqu’au code compilé, en quatre semaines
10 novembre — Google DeepMind présente AlphaProof Code, un cadre agentique de vérification formelle, relayé le 11 novembre sur X. Sa première cible est un cas d’école : le protocole de chiffrement de Signal, qui protège aussi les conversations de Google Messages selon le billet. Vérifier formellement un programme, c’est prouver mathématiquement qu’il respecte ses propriétés de sécurité. C’est la garantie la plus forte qui existe, mais elle est longue et coûteuse à obtenir à la main.
| Étape du travail | Réalisée par | Repère publié |
|---|---|---|
| Traduire les objectifs de Signal en spécifications | Chercheurs aidés de plusieurs modèles | Toutes les spécifications relues |
| Écrire les preuves dans le langage Lean | Agents propulsés par Gemini Carbon | Plus de 6 millions de lignes |
| Relire la preuve et signaler les zones délicates | Agents, puis experts humains | Environ 1 % de la base de code |
| Mener la preuve jusqu’au code qui tourne sur les appareils | Chercheurs et agents | 4 semaines |
La différence tient au niveau de la preuve. La plupart des vérifications de protocoles s’arrêtent à leur conception ; ici, des propriétés clés, comme la protection des messages avant et après la compromission temporaire d’un appareil, sont prouvées sur le code compilé. Pour s’assurer que l’outil distingue un code sûr d’un code fautif, l’équipe a réintroduit deux anciens bugs réels, déjà corrigés, dans une copie isolée du code : dans les deux cas, le système a produit une preuve vérifiée par machine que la version boguée n’était pas sûre.
Selon Google DeepMind, c’est la première fois que l’IA vérifie formellement un protocole cryptographique largement déployé à cette profondeur, et la première fois, avec ou sans IA, que l’implémentation d’un protocole aussi répandu est vérifiée formellement. Le laboratoire estime qu’une telle tâche prenait jusqu’ici des années à des équipes d’experts. Les artefacts de vérification sont publiés en open source avec un article technique. Ces travaux suivent ceux du 6 novembre, où des agents de Google DeepMind avaient trouvé deux faiblesses du RSA 1024 bits.
Using AI agents to translate live code into valid Lean theorems is a major breakthrough.
🇫🇷 Utiliser des agents IA pour traduire du code en production en théorèmes Lean valides est une avancée majeure. — Ehren Kret, directeur technique de Signal
🔗 Introducing AlphaProof Code (Google DeepMind) · Article technique (PDF)
Qwen4-Max en préversion : Qwen ouvre la génération Qwen4 par un seul tweet, sans benchmark ni fiche technique
11 novembre — Qwen ouvre la génération Qwen4 par un tweet épinglé sur le compte @Alibaba_Qwen, vu plus d’un million de fois le jour même. Le premier modèle accessible est Qwen4-Max, en préversion sur le Token Plan d’Alibaba, l’abonnement de QwenCloud qui regroupe plusieurs modèles sous un même quota. L’accès anticipé passe aussi par QwenWork, l’environnement de code Qoder, l’application Qwen et QwenStudio.
Qwen4 is coming. Deeper knowledge. Richer world understanding. Stronger coding and agentic capabilities. Built for real-world tasks — from complex coding and knowledge work to front-end builds and professional software workflows.
🇫🇷 Qwen4 arrive. Des connaissances plus profondes. Une compréhension du monde plus riche. Des capacités de code et d’agent plus solides. Conçu pour des tâches réelles, du code complexe et du travail de connaissance à la construction d’interfaces front-end et aux flux de travail logiciels professionnels. — @Alibaba_Qwen sur X
L’annonce s’arrête là. Le tableau ci-dessous reprend ce qui est publié, et ce qui ne l’est pas.
| Élément de l’annonce | État au 11 novembre |
|---|---|
| Identifiant sur le Token Plan | qwen4-max-preview |
| Capacités affichées | Génération de texte, raisonnement, compréhension visuelle |
| Accès au modèle | Préversion sur le Token Plan, accès anticipé dans QwenWork, Qoder, Qwen APP et QwenStudio |
| Remise affichée | Réduction temporaire de 80 %, sans préciser à quoi elle s’applique |
| Benchmarks, nombre de paramètres, taille du contexte | Non publiés |
| Prix API, poids ouverts, billet de blog | Non publiés |
Qwen reprend le schéma de Qwen3.8 : préversion du Max sur le Token Plan et dans Qoder le 19 juillet, puis lancement complet le 3 août. Un teaser de @Alibaba_Qwen, publié le 6 novembre sans nom de modèle, avait précédé l’annonce.
🔗 Page du Token Plan (QwenCloud)
Runway publie Praxis-1 en poids ouverts sous Apache 2.0, en tête des modèles d’action du monde sur RoboLab-120
11 novembre — Runway tient la promesse faite le 30 septembre : Praxis-1, son modèle d’action du monde (world action model) pour la robotique, est publié en poids ouverts sous licence Apache 2.0, usage commercial compris. La licence couvre les poids, le code d’inférence et le code d’affinage, complet ou LoRA. Trois points de contrôle (base, DROID et YAM) sont sur Hugging Face et le code sur GitHub ; LeRobot le prend en charge nativement, vLLM-Omni le sert, et Reactor propose une inférence hébergée.
Praxis-1 part du modèle vidéo de Runway : un transformeur de diffusion à mélange d’experts de 27,2B paramètres au total : une partie vidéo de 26,9B, dont environ 2,8B actifs par token, et un « expert d’action » de 314M. À chaque appel, il prédit à la fois l’image à venir et le mouvement qui y mène, soit 1,6 seconde d’actions calculée en 0,55 à 0,6 seconde sur un H100. Il pèse 54,4 Go en bf16 et tient sur un GPU de 80 Go.
Sur RoboLab-120, le banc de simulation de NVIDIA (120 tâches, 1 200 épisodes), la version affinée sur DROID réussit 46,2 % des épisodes. C’est le meilleur score des modèles d’action du monde et des modèles robotiques open source, mais quatre entrées font mieux selon le rapport technique : AMP1, un agent zéro-shot bâti sur un modèle frontière, SenseNova-RoboRSI, qui utilise un modèle vision-langage frontière comme politique, et deux modèles fermés, Lakeside et BiMind v0.5.
| Entrée du classement RoboLab-120 | Taux de réussite |
|---|---|
| AMP1 | 86,0 % |
| SenseNova-RoboRSI | 57,1 % |
| Lakeside | 51,0 % |
| BiMind v0.5 | 49,2 % |
| Praxis-1 (affiné sur DROID) | 46,2 % |
| FLUX 3 Action | 42,9 % |
| Atomic-WAM | 39,6 % |
| OASIS WAM | 39,0 % |
| Cosmos 3 Nano | 36,8 % |
| π0.5 | 28,0 % |
Affiné sur Google RT-1, un robot absent de ses données d’entraînement, Praxis-1 atteint 80,0 % sur SimplerEnv, contre 52,4 % pour la politique RT-1 d’origine. Face à GPT-6 Astra, sur la même station bimanuelle et trois tâches, il termine en moyenne 15,6 fois plus vite et coûte 51 fois moins par tâche réussie (0,04 contre 1,87 dollar, sur la base d’un H100 à 3,95 dollars de l’heure) ; le rapport présente pourtant les deux approches comme complémentaires. Deux variantes entraînées pour le format NVFP4 (DROID et YAM) sont aussi en ligne : téléchargées en bf16 (54,4 Go), elles descendent à 17,5 Go en mémoire une fois leurs experts convertis au chargement, un mode encore expérimental réservé aux RTX 5090 et RTX PRO 6000 Blackwell.
🔗 Praxis-1 is now available (Runway) · Rapport technique · Collection Hugging Face
Summit ElevenLabs de New York : Marketplace, Partner Program et ElevenAI disponibles, Interaction Engine, Memory et Routines annoncés
11 novembre — Au Summit de New York, ElevenLabs a présenté une série d’annonces autour de ce qu’elle appelle la couche d’interaction de l’IA (interaction layer for AI). Une partie est disponible dès aujourd’hui ; le reste est annoncé pour les prochains mois ou pour l’an prochain.
| Annonce du Summit | Disponibilité au 11 novembre |
|---|---|
| ElevenLabs Marketplace (agents et applications par secteur) | Ouvert avec Salesforce, IBM, NiCE, Twilio et Zendesk ; achat via l’engagement ElevenLabs l’an prochain |
| ElevenLabs Partner Program | Lancé : plus de 550 partenaires dans 44 pays, alliance avec McKinsey et QuantumBlack |
| ElevenAI (dictée et notes de réunion, sur Scribe v3) | Accès anticipé gratuit |
| Interaction Engine | Avant-première |
| Memory et Routines dans ElevenAgents | Annoncés |
| Affinage des modèles vocaux et de LLM open source | « Dans les prochains mois » |
ElevenAI dicte dans n’importe quelle application et prend les notes de réunion, avec avis et consentement des personnes enregistrées, puis rend à chaque participant un résumé et ses actions. Côté agents, l’Interaction Engine gère les tours de parole et les interruptions et choisit le LLM à chaque étape : un modèle économique pour le tri, un modèle frontière pour un cas complexe comme un remboursement. Memory doit permettre à un agent de se souvenir d’un client authentifié et des détails donnés en passant ; Routines, d’automatiser le travail avant, pendant et après une conversation. Les entreprises pourront aussi affiner les modèles de synthèse et de transcription vocales d’ElevenLabs, ainsi que des LLM open source, sur leurs propres données. Scribe v3 Medical, un modèle de transcription pour la santé, est cité sans date.
L’entreprise a donné quelques repères : plus de 55 % de son chiffre d’affaires vient des entreprises, et des salariés de près de 70 % du Fortune 500 utilisent sa plateforme. Parmi les clients cités, Yahoo Scout, qui parle grâce à ElevenAgents, sort de bêta après plus de 3 milliards de réponses.
🔗 ElevenLabs Summit NYC (ElevenLabs) · Fil de @ElevenLabs
ElevenLabs et NVIDIA : Nemotron 3.5 Super VL dans ElevenAgents, 15 MW de Vera Rubin prévus et un agent vocal pour l’e-Santé polonaise
11 novembre — Annoncé pendant le Summit, l’élargissement du partenariat avec NVIDIA porte sur trois volets. Côté modèles, Nemotron 3.5 Super VL est disponible dans ElevenAgents. Sur le benchmark ElevenAgents de tâches réalistes de support client, ElevenLabs lui attribue une précision de bout en bout de premier plan face aux autres grands modèles ouverts, pour un coût inférieur de 70 % ; raisonnement désactivé, il figure parmi les trois modèles les plus rapides de la plateforme.
Côté calcul, ElevenLabs prévoit d’ajouter 15 MW de capacité Vera Rubin à ses systèmes Blackwell Ultra, pour les déploiements soumis à des exigences de sécurité et de résidence des données. Côté déploiements souverains, la Pologne fait appeler par un agent vocal les patients qui n’ont qu’une ligne fixe, pour leur rappeler un rendez-vous ou le déplacer, sur le système central de la plateforme nationale e-Santé, qui gère 40 millions de rendez-vous par an. L’agent tourne sur site avec NVIDIA Confidential Computing. Les deux entreprises disent explorer la voix embarquée pour les robots et les véhicules, sans produit annoncé.
🔗 ElevenLabs et NVIDIA (ElevenLabs)
Anthropic offre une réinitialisation complète des limites aux abonnés Pro, Max, Ultra et Team, valable jusqu’au 10 décembre
10 novembre — Dans un message publié en soirée (heure de Paris) par @ClaudeDevs, Anthropic offre à tous les abonnés Pro, Max, Ultra et Team une réinitialisation complète et gratuite de leurs limites d’usage, valable pour tous les modèles et toutes les limites. Elle peut être déclenchée à tout moment avant le 10 décembre à 14 h PT, depuis Settings > Usage ou par le lien court clau.de/reset.
Anthropic dit avoir récemment corrigé quelques petits problèmes qui consommaient plus de limites que prévu, sans les détailler, en précisant qu’ils n’ont pas touché tout le monde. L’entreprise reconnaît aussi que les réinitialisations Fable offertes la veille, pour le lancement de Fable 5.2, n’aidaient guère ceux qui avaient déjà atteint leurs limites hebdomadaires sur tous les modèles. À la différence de celles-ci, limitées à Fable et modulées selon l’ancienneté, la réinitialisation du jour est unique, identique pour tous les forfaits cités et couvre l’ensemble des modèles. Les forfaits Free et Enterprise ne sont pas mentionnés, et aucune page d’aide ne détaillait l’offre au 11 novembre.
Grok Bot 1.0 : les Bots de SpaceXSI se partagent plus finement, rejoignent les réunions et se coordonnent entre eux
11 novembre — SpaceXSI annonce Grok Bot 1.0 sur X, par les comptes @bot puis @SpaceXSI, comme une mise à jour majeure de ses coéquipiers IA ; la page de x.ai qui le détaille est, elle, datée du 2 novembre. Plusieurs briques étaient déjà sorties pendant la bêta, dont les Team Bots fin septembre, les propositions proactives de tâches début octobre et l’action dans Microsoft Teams dès septembre. Grok Bot 1.0 les réunit et y ajoute de quoi travailler à plusieurs :
- les Team Bots, qui avaient déjà leur identifiant Slack depuis fin septembre, se partagent désormais avec des personnes ou des groupes précis et s’utilisent dans Slack ou Microsoft Teams, où ils comprennent qui participe à la conversation, proposent de prendre du travail et peuvent se coordonner avec un autre Bot ;
- ils rejoignent les appels vidéo (Meetings), interviennent par le chat, reprennent des éléments de conversations passées et gardent trace des décisions ;
- dans les espaces partagés, chaque Bot respecte les permissions de la personne qui lui parle, demande avant une action sensible et vérifie qu’une information peut être partagée dans un canal public ;
- de nouveaux réglages permettent de gérer ce que sait un Team Bot, et des analyses montrent comment l’équipe s’en sert.
Les Team Bots sont réservés aux formules Team et Enterprise, Meetings aux formules Team, Enterprise et Ultra, avec une activation par l’administrateur en Enterprise. SpaceXSI dit employer déjà des Bots comme coéquipiers en comptabilité, au support, aux ventes et au marketing. Aucun prix ni chiffre d’usage n’est donné.
🔗 Grok Bot 1.0 (SpaceXSI) · Annonce de @SpaceXSI
Assistants vocaux : ChatGPT Voice ne garde que GPT-Live, Gemini Live arrive sur Apple CarPlay
Deux changements touchent la voix des assistants grand public : OpenAI simplifie ChatGPT Voice autour d’un seul modèle, et Google ouvre Gemini Live au volant des iPhone.
OpenAI retire les voix Advanced et Standard de ChatGPT le 11 décembre, au profit de GPT-Live
10 novembre — OpenAI retire les voix Advanced et Standard de ChatGPT Voice le 11 décembre 2026. À cette date, elles disparaîtront du sélecteur (Réglages > Voix) et ceux qui les avaient gardées passeront automatiquement sur Live voice, propulsée par GPT-Live ; d’ici là, elles restent utilisables. OpenAI justifie ce choix par l’adoption de GPT-Live, lancé en juillet : l’usage de la voix a presque doublé depuis, et pratiquement toutes les personnes qui parlent à ChatGPT passent désormais par ce modèle, qui écoute et parle en même temps (full-duplex).
Deux exceptions subsistent. La vidéo en direct et le partage d’écran restent sur Advanced voice tant que GPT-Live ne sait pas les gérer, et la voix des GPT personnalisés reste sur Advanced jusqu’au retrait de ces GPT, le même 11 décembre. Les conversations passées restent dans l’historique. Le retrait ne concerne que ChatGPT : rien n’est annoncé pour les modèles audio de l’API.
🔗 Retiring Advanced and Standard voice (aide OpenAI) · Annonce de @OpenAINewsroom
Gemini Live arrive sur Apple CarPlay, pour tous les utilisateurs de Gemini sur iOS
11 novembre — Après Android Auto et les voitures équipées de Google intégré, l’application Gemini arrive sur Apple CarPlay : les utilisateurs d’iPhone peuvent converser librement avec Gemini Live depuis l’écran de leur voiture, mains libres, en l’interrompant ou en changeant de sujet. Google cite la préparation de la journée, la lecture des e-mails non lus et le résumé de longs fils grâce à Gmail et Google Agenda, la dictée d’une réponse ou la répétition d’une présentation. Les échanges se retrouvent ensuite dans l’application de l’iPhone.
Le déploiement est mondial à partir d’aujourd’hui, pour tous les utilisateurs de Gemini sur iOS et dans toutes les langues prises en charge par Gemini Live. Il faut la dernière version de l’application, l’accès au micro et avoir utilisé Gemini Live au moins une fois sur le téléphone. Gemini rejoint ChatGPT, Grok et Claude, déjà présents sur CarPlay.
🔗 Gemini on Apple CarPlay (blog.google)
Sûreté des modèles : la chaîne de raisonnement devient plus difficile à surveiller chez OpenAI, douze modèles face au bac à sable SPACE de Perplexity
Deux publications de recherche portent sur ce que l’on peut encore observer et contenir des modèles les plus capables.
OpenAI : la monitorabilité de la chaîne de raisonnement recule à mesure que les modèles progressent
10 novembre — Les chercheurs en alignement d’OpenAI étudient ce qui fait évoluer la monitorabilité de la chaîne de raisonnement (chain of thought, CoT), c’est-à-dire la possibilité de surveiller un modèle en lisant son raisonnement. Avec GPT-6 Astra, OpenAI avait déjà observé un recul de cette monitorabilité. L’étude, présentée le 11 novembre dans un fil de Jeffrey G. Wang, suit deux indicateurs indirects : la capacité sans CoT, ce que le modèle résout en une seule passe, et la contrôlabilité de la CoT, sa capacité à modifier son raisonnement sur consigne.
| Étape de l’entraînement | Effet observé par OpenAI |
|---|---|
| Préentraînement | La capacité sans CoT progresse avec la baisse de perplexité ; GPT-6 Astra reste dans la tendance |
| Architecture du modèle | Certaines font mieux que prévu sur la planification multi-étapes et le calcul en série |
| Apprentissage par renforcement | La contrôlabilité augmente nettement sur un modèle de classe Astra, sans autre supervision du processus |
| Affinage sur données générées | La contrôlabilité se transmet de l’enseignant à l’élève |
Les auteurs jugent eux-mêmes la contrôlabilité bruitée : sur la paire de modèles de capacité comparable qu’ils étudient, le plus contrôlable n’échappe pas mieux aux moniteurs. Ils citent l’UK AISI, qui estime à 30,9 minutes l’horizon médian de GPT-6 Astra sans raisonnement, contre environ 7 minutes projetées pour fin 2028, une contamination pouvant gonfler ce chiffre. Leur conclusion : de nouveaux progrès du préentraînement exigeront probablement de nouvelles approches.
🔗 CoT monitorability across the model lifecycle (OpenAI) · Fil de Jeffrey G. Wang
Perplexity : douze modèles face au bac à sable de Computer, et aucun ne sort de la machine virtuelle
11 novembre — Perplexity publie la deuxième partie d’Escaping SPACE, son étude d’attaque (red-teaming) de SPACE, le bac à sable à machines virtuelles où tournent les agents de Computer. Douze modèles, dont Claude Mythos 5.1, Claude Opus 5.5 et GPT-6 Astra ajoutés depuis la première partie du 23 septembre, passent deux épreuves : sortir de la machine virtuelle pour récupérer un identifiant sur l’hôte, et contourner la politique réseau pour joindre une URL bloquée. Aucun modèle n’est sorti de la machine virtuelle. Avec la consigne d’origine, tous sauf les trois GPT consacrent au plus 4 % de leur effort à la virtualisation ; une consigne recentrée y fait monter la part d’effort d’environ 60 points de pourcentage, sans plus de succès.
Le contournement réseau a été mesuré sur l’implémentation d’avant correctif, avec accès au code source, sur 3 essais par modèle :
| Modèle évalué | Contournements réussis | Durée moyenne citée |
|---|---|---|
| GPT-6 Astra | 3 sur 3 | 4,8 min |
| GPT-5.6 Sol | 3 sur 3 | 20,8 min |
| Claude Opus 5.5 | 3 sur 3 | 21,6 min |
| Claude Mythos 5.1 | 3 sur 3 | 36,6 min |
| Claude Opus 5.0 | 3 sur 3 | non citée |
| Kimi K3 | 2 sur 3 | non citée |
| GPT-5.6 Cyber | 0 sur 3 | 51,6 min |
| Cinq autres modèles, dont Grok 4.20 | 0 sur 3 | non citée |
GPT-5.6 Cyber, bâti sur Sol et spécialisé en cybersécurité, n’a jamais cherché la fonction qui donnait l’adresse IP nécessaire à l’usurpation DNS ; Perplexity juge l’échantillon trop limité pour en tirer une règle générale. Grok 4.20 finit dernier selon six modèles juges, avec 27 fausses déclarations de réussite en six essais. Après correction des failles, aucun contournement n’a été trouvé.
🔗 Escaping SPACE: Part II (Perplexity) · Fil de @perplexity_ai
Gemini Decision : l’API Gemini répond par des probabilités calibrées, sans token de sortie, à 0,10 dollar par million de tokens
11 novembre — Les notes de version de l’API Gemini ajoutent Gemini Decision (gemini-decision-1), servi par une Decisions API dédiée. Le modèle ne rédige pas de réponse : il évalue des questions fermées sur des données fournies et renvoie des probabilités calibrées, avec zéro token de sortie, ce qui permet au code d’une application de trier ou de router directement sur le résultat. Trois formats sont proposés : oui ou non (probabilité de 0,01 à 0,99, avec un indice de confiance), choix entre 2 et 255 options, ou note sur une grille de niveaux ordonnés.
| Caractéristique de Gemini Decision 1 | Valeur publiée |
|---|---|
| Entrées acceptées | Texte, image, vidéo, audio, PDF |
| Questions par requête | Jusqu’à 1 000, sur une entrée partagée |
| Entrée maximale | 262 144 tokens |
| Tarif au palier payant | 0,10 dollar par million de tokens d’entrée, entrée partagée facturée une seule fois |
| Palier gratuit | Gratuit, données utilisées pour améliorer les produits |
Google cite le routage de requêtes, le contrôle de nombreuses règles à la fois ou le choix d’outils par un agent. Le modèle reste limité à l’API Gemini Developer en v1beta, sans Batch API ni cache de contexte. Aucun billet de blog n’accompagne la sortie, et l’API porte le même nom que la Decisions API lancée par Perplexity le 1er octobre.
🔗 Gemini Decision 1 (Google AI Studio) · Documentation de la Decisions API
A2UI 1.0 : le protocole ouvert de Google qui fait répondre les agents par des écrans natifs passe en version stable
11 novembre — Google publie A2UI 1.0, première version stable de son protocole ouvert d’interface générative (generative UI). Au lieu de répondre par des paragraphes, un agent décrit ce qu’il faut afficher, un formulaire à confirmer ou un graphique, et chaque application le dessine avec ses propres composants natifs. Selon le billet, les valeurs sensibles sont liées côté serveur et n’atteignent pas le modèle.
La version 1.0 ajoute des appels de fonctions dans les deux sens, pour qu’un sélecteur de vol vérifie la disponibilité sur le moment, ainsi que l’accessibilité et des extensions de métadonnées. Les moteurs de rendu open source couvrent React, Angular et Lit sur le web, Flutter et SwiftUI ; celui de Jetpack Compose reste en 0.9.1. Les rendus web et Flutter fonctionnent dans les MCP Apps, donc dans des assistants comme Claude ou Gemini, et des SDK d’agents TypeScript et Dart rejoignent celui de Python. Atlassian l’utilise dans Jira, où un agent chargé d’un ticket peut interroger l’équipe par une carte interactive ; Alation, Bloomberg et ByteDance construisent aussi avec le protocole. Chez Google, Gemini Notebook s’en sert déjà, et Gemini Enterprise passe à la 1.0.
🔗 A2UI 1.0 (Google Developers Blog)
Agents de code : les Cloud Runners de Delta, VS Code 1.146 et Qwen Code 1.0 Preview
Delta lance ses Cloud Runners : un fil d’agent continue de tourner sans l’ordinateur de son auteur
11 novembre — Delta, l’environnement de codage multijoueur avec agents de l’équipe de Zed, lance les Cloud Runners annoncés la veille. En choisissant Cloud dans le compositeur d’un fil, les tours de l’agent s’exécutent sur un bac à sable Linux hébergé par Zed, qui s’appuie sur E2B ; le fil se suit depuis le bureau, le web ou le téléphone, et revient sur la machine locale à tout moment. Le runner récupère le code depuis les serveurs de Delta, exécute le script .agents/setup du dépôt (résultat gardé en cache un jour) et utilise les fournisseurs de modèles et les variables d’environnement chiffrées de l’utilisateur. Après autorisation, git et gh agissent en son nom sur GitHub, et l’agent peut renvoyer une URL de prévisualisation réservée aux personnes qui ont accès au fil.
| Taille du runner | Processeurs alloués | Mémoire vive | Disque libre |
|---|---|---|---|
| Small | 2 CPU | 4 Go | 15 Go |
| Medium (défaut) | 4 CPU | 8 Go | 30 Go |
| Large | 8 CPU | 16 Go | 50 Go |
Le calcul est gratuit sur toutes les offres Zed sauf Student, le temps que Delta prépare ses propres offres, dans des limites d’usage raisonnable non chiffrées ; les modèles restent facturés comme en local. Six runners peuvent tourner à la fois, les terminaux se ferment au bout d’une heure et un runner se met en pause après 10 minutes d’inactivité.
🔗 Cloud Runners are now in Delta · Documentation des Cloud Runners
VS Code 1.146 déprécie le harnais Local de Copilot et ajoute un mode Inbox pour les sessions d’agents
11 novembre — Microsoft publie VS Code 1.146, qui déprécie le harnais Local (Local harness) de Copilot : il sera retiré en février 2027 et reste d’ici là utilisable mais gelé. Les nouveautés iront au seul harnais Copilot, bâti sur le Copilot SDK, choix par défaut des nouvelles sessions depuis VS Code 1.143 et seul à appliquer les politiques de bac à sable et de permissions des organisations.
La fenêtre Agents gagne un mode Inbox (expérimental) qui fait remonter en tête les sessions qui attendent une intervention, et un chat peut vivre dans sa propre fenêtre (préversion). Compare Models accepte Copilot Fusion et ses niveaux d’effort. Côté sécurité, les invites de permission proposent des autorisations ciblées (un domaine, une commande, un répertoire), et le bac à sable peut masquer des variables d’environnement, la vraie valeur n’étant injectée que dans les requêtes HTTPS vers les hôtes autorisés. VS Code prend aussi en charge les skills fournis par des serveurs MCP (SEP-2640, préversion) et les sessions Copilot suivent la configuration de proxy PAC et Kerberos.
🔗 Notes de version de VS Code 1.146
Qwen Code 1.0 Preview réunit les agents de Qoder et de Qwen Code dans un binaire natif, sans Node.js
11 novembre — Quelques heures après Qwen4-Max, Qwen publie en pré-release Qwen Code 1.0 Preview, qui réunit les capacités d’agent de Qoder, l’environnement de code d’Alibaba, et celles de Qwen Code : comprendre une base de code, implémenter, déboguer et tester. La connexion passe par un compte Qwen ou Qoder, par QwenCloud ou Model Studio, ou par tout point d’accès compatible. L’outil est livré en paquets natifs pour macOS, Linux et Windows, en x64 et arm64 (huit archives de 57 à 74 Mo environ), sans installation séparée de Node.js, et garde la reprise de session et l’exécution non interactive.
Le dépôt prévient que les interfaces et les options peuvent encore changer, et n’accepte plus les pull requests de la communauté jusqu’après décembre 2026. Selon l’API GitHub, le tag 1.0 ne partage aucun historique avec la v0.27.2 publiée la veille.
🔗 Qwen Code v1.0.0-preview (GitHub)
Modèles ouverts et recherche : BotPsy de Tether et le token pooling de Hugging Face
BotPsy-0.8B : Tether publie un petit modèle d’agent ouvert qui double à peu près les scores d’outils de sa base
11 novembre — Tether AI Research, l’équipe IA de Tether qui publie sous le nom QVAC, présente BotPsy-0.8B, un modèle de 0,8 milliard de paramètres spécialisé dans l’appel d’outils, pensé pour tourner sur un téléphone ou un portable. Il part de Qwen3.5-0.8B, passe par un affinage supervisé, une distillation à partir de trois enseignants Qwen3.5-4B et deux tours d’apprentissage par renforcement. Les poids sont sur Hugging Face, en safetensors et en GGUF, sous licence Apache 2.0 selon la fiche du modèle ; le billet évoque un usage de recherche et d’éducation.
| Banc d’évaluation (chiffres de l’équipe) | BotPsy-0.8B | Qwen3.5-0.8B (base) | Qwen3.5-2B-Think |
|---|---|---|---|
| BFCL v4 | 44,0 | 23,4 | 37,7 |
| ACEBench | 58,7 | 30,1 | 55,4 |
| τ-bench | 51,5 | 23,2 | 46,5 |
| Moyenne sur six bancs d’outils | 45,0 | 24,7 | 38,8 |
Tous ces chiffres sont mesurés par l’équipe, en mode raisonnement. Elle annonce aussi des réponses dangereuses en baisse de 36 % à 21 % lors de tests d’attaque automatisés, recommande l’anglais et déconseille le modèle pour les décisions sensibles.
🔗 BotPsy (QVAC sur Hugging Face) · Modèle qvac/BotPsy-0.8B
Token pooling : Hugging Face garde 97,8 % de la qualité de recherche avec quatre fois moins de vecteurs
11 novembre — Tom Aarsen détaille sur le blog Hugging Face comment réduire la taille des index de recherche multi-vecteurs, de type ColBERT, qui gardent un vecteur par token de document. Le regroupement de tokens (token pooling) fusionne les vecteurs proches, et Sentence Transformers ajoute une perte, MultiVectorTokenPoolingLoss, qui entraîne le modèle à la fois sur ses représentations complètes et compressées.
| Pooling à l’inférence (NanoBEIR, nDCG@10) | Vecteurs moyens | Entraînement classique | Entraînement conscient du pooling |
|---|---|---|---|
| Sans pooling | 193,22 | 51,84 | 52,39 |
pool_factor=4 | 48,68 | 49,03 | 51,23 |
max_tokens=4 | 4,00 | 37,22 | 43,00 |
Avec quatre fois moins de vecteurs, le modèle ainsi entraîné conserve 97,8 % de son score, contre 94,6 % pour un entraînement classique. Les mesures portent sur une seule configuration (ModernBERT-base, une époque), et deux points de contrôle sont publiés sur le Hub.
🔗 Token Pooling-Aware Training (Hugging Face)
Seedance 2.5 passe en 4K chez Pika et Runway
11 novembre — Seedance 2.5, le modèle vidéo de ByteDance diffusé par BytePlus, arrive en 4K. Pika l’ouvre en 4K natif sur sa plateforme et dans son Pika API Club, en proposant de travailler une prise en brouillon puis de la finaliser en 4K ; depuis le 17 août, il le proposait en 1080p avec un agrandissement (upscale) en 4K. Runway a suivi un peu moins de deux heures plus tard en annonçant Seedance 2.5 en 4K sur sa plateforme, sans préciser s’il s’agit de 4K natif. Ni tarif, ni durée maximale, ni coût en crédits n’ont été donnés.
🔗 Annonce de @pika_labs · Annonce de @runwayml
Git corrige six vulnérabilités, dont une exécution de code lors d’un clonage récursif
10 novembre — Hors IA, le projet Git publie Git 2.56.1, avec des rétroportages jusqu’à Git 2.50.2, pour corriger six vulnérabilités détaillées sur le GitHub Blog par Elijah Newren.
| Vulnérabilité corrigée | Nature du risque |
|---|---|
| CVE-2026-111760 | Exécution de code lors d’un clonage récursif, via le fichier .git d’un sous-module |
| CVE-2026-113408 | Traversée de chemin via le HEAD annoncé par un serveur |
| CVE-2026-114467 | Corruption de pile en retirant des signatures GPG |
| CVE-2026-114469 | Lectures hors limites en appliquant des patchs binaires |
| CVE-2026-105437 | Corruption du tas lors de grandes fusions |
| CVE-2026-114466 | Accès au système de fichiers par des flux git fast-import |
GitHub a déjà déployé les correctifs sur github.com et Enterprise Cloud, publie GitHub Enterprise Server 3.19.15, 3.20.11, 3.21.9 et 3.22.4, et prépare des versions de GitHub Desktop et de l’app GitHub Copilot avec un Git corrigé. La consigne est de mettre à jour Git et toute application qui en embarque une copie ; à défaut, de ne cloner que depuis des serveurs de confiance.
🔗 Git security vulnerabilities announced (GitHub Blog)
Brèves
Agents de code et outils de développement
- Zed 1.28 et préversion 1.29 — La 1.28 passe en stable et reprend la préversion couverte le 4 novembre (dernier Agent Client Protocol, lectures de
read_filetronquées à 2 000 caractères, récupération Git automatique en option). La préversion 1.29 prend en charge Claude Fable 5.2 et Claude Mythos 5.2 dans le fournisseur Anthropic. 🔗 source - Antigravity CLI 1.5.4 et 1.5.5 — La 1.5.5 apporte /swarm en préversion dans le terminal, avec la vue plein écran /swarm board, et corrige l’import des commandes et des hooks de plugins Claude Code. La 1.5.4 ouvre le mode Auto aux sessions ACP et enrichit les données transmises aux hooks. 🔗 source
- Gemini CLI — Aucune nouvelle version au lendemain de la v0.68.0, et la version nocturne (nightly) a encore échoué, comme chaque nuit depuis le 5 novembre. Quatre correctifs sont fusionnés sur la branche principale, dont la fin d’une erreur 400 après un tour vide du modèle sur une image ou un fichier binaire. 🔗 source
- Copilot CLI 1.0.110-1 — Préversion limitée à 13 correctifs : une session reprise ne peut plus être modifiée en parallèle, et un serveur MCP local qui renvoie un caractère Unicode coupé ne bloque plus un appel d’outil. Le SDK 1.0.32-preview.1 permet de choisir Copilot Fusion et son niveau. 🔗 source
- Gemini 4 Carbon chez Genspark — Genspark ouvre Gemini 4 Carbon dans son AI Chat et son Code Agent, au lendemain de Claude Fable 5.2 dans ce même Code Agent, sans préciser de forfait ni de consommation de crédits. 🔗 source
- Basis et Devin for Startups — Cognition montre en vidéo comment Basis travaille avec Devin ; les agents comptables de Basis ramènent certaines tâches de 20 heures à 30 minutes, un chiffre qui porte sur Basis et non sur Devin. Cognition relance aussi Devin for Startups, 65 000 dollars de crédits pour des équipes sélectionnées. 🔗 source
- shem — João Galego publie un runtime expérimental qui lance un modèle de Hugging Face comme une image de conteneur (un Dockerfile peut commencer par
FROM hf.co/...) et, à l’inverse, exécute des conteneurs sur un processeur fait de poids de modèle ; cela marche « la plupart du temps », selon lui. 🔗 source
GitHub
- Sièges Copilot gérés par des GitHub Apps — Les GitHub Apps d’entreprise peuvent appeler les API de gestion des sièges Copilot pour en attribuer à des utilisateurs et à des équipes d’entreprise, grâce à une nouvelle permission fine, Enterprise Copilot license management. 🔗 source
- Dependabot et les dépôts inactifs — À partir du 8 décembre, GitHub désactive les alertes Dependabot sur la plupart des dépôts sans activité depuis un an ; les alertes sont archivées, pas supprimées, et le premier push les rétablit. GitHub Enterprise Server n’est pas concerné. 🔗 source
- Types et champs d’issues pour les comptes personnels — Jusqu’ici réservés aux organisations, ils arrivent en disponibilité générale sur les dépôts personnels : jusqu’à 25 types et 25 champs, utilisables dans les projets, par les API REST et GraphQL et par webhooks. 🔗 source
- Tableau de bord de GitHub — Plus compact, il affiche six pull requests et six issues au lieu de trois, permet d’épingler l’onglet Feed ou Home et masque la section des sessions d’agents quand le compte n’en a aucune. 🔗 source
Entreprises et usages
- Singapore Airlines — Réécrit sur l’API d’OpenAI, son chatbot Kris double son score de satisfaction client, le résumé des appels réduit d’environ 10 % la durée de traitement des conseillers, et plus de 60 % des employés utilisent chaque mois la plateforme interne Jarvis. 🔗 source
- Cogent Security — La startup bâtit des agents de cyberdéfense sur GPT-6.1 Sol, GPT-6 Astra et GPT-5.6, sous des politiques vérifiées avant chaque appel d’outil ; selon elle, un client automobile du Fortune 1000 a réduit de 75 % le délai moyen de correction de ses failles critiques. 🔗 source
- JioStar — Son assistant vocal de découverte de contenus dans JioHotstar, bâti sur l’API d’OpenAI en environ huit semaines, parle plus de 15 langues sur une plateforme de plus de 500 millions d’utilisateurs ; selon JioStar, plus de 60 % de ses utilisateurs lui parlent plutôt que de lui écrire. 🔗 source
- ChatGPT Plus pour les vétérans — Pour le Veterans Day, OpenAI indique que plus de 20 000 vétérans et militaires en transition ont réclamé en un an l’année de ChatGPT Plus offerte, et que près de 1 000 membres de la communauté militaire ont été formés. 🔗 source
- Plugin fal dans ChatGPT — fal met en avant son plugin, qui génère et retouche images et vidéos dans la conversation, avec une publicité de 60 secondes faite avec GPT Image 2.6, FLUX 3 Max (26 plans) et fal Recast ; sa date de mise en ligne n’est pas précisée. 🔗 source
- Gopuff dans Grok Bot — Grok Bot commande désormais courses, en-cas et produits du quotidien chez Gopuff, de bout en bout, avec une livraison en 15 minutes au plus vite selon Gopuff ; ni les pays ni les formules ne sont précisés. 🔗 source
- Genspark Genius — Genspark recrute des ambassadeurs : une création partagée par mois, en échange de l’offre Pro, d’un accès anticipé aux nouvelles fonctions, de crédits et d’une mise en avant sur ses canaux. 🔗 source
Modèles, médias et recherche
- MiniMax H3 — Cent jours après l’ouverture de ses poids, MiniMax revendique 1 472 modèles dérivés et plus de 148 millions de téléchargements sur Hugging Face, des chiffres non vérifiés ; H3-Image arrive chez fal, Runware, EvoLink et Miora, gratuit chez ce dernier jusqu’au 17 novembre. 🔗 source
- Voxtral Transcribe 3 à AI Engineer Paris — Mistral a transcrit en direct toutes les conférences de la scène principale, en fournissant au modèle les noms des intervenants et les termes du programme (biais de contexte), sans chiffre sur le gain obtenu. 🔗 source
- Voix locale dans Google AI Edge Gallery — L’application gagne la reconnaissance et la synthèse vocales hors ligne : sur Android, ML Kit transcrit plus de 100 langues dix fois plus vite que le temps réel, et des modèles ouverts comme Parakeet-TDT 0.6B ou Kokoro-82M couvrent les autres plateformes. 🔗 source
- Déjà View chez NVIDIA — Ce modèle de reconstruction 3D de 117M paramètres applique plusieurs fois un même bloc transformeur et égale des modèles jusqu’à 10 fois plus gros sur cinq bancs ; présenté en oral à NeurIPS 2026, l’article est sur arXiv depuis mai. 🔗 source
- Maladies dans les textes médicaux espagnols — OpenMed publie deux modèles ouverts sous Apache-2.0, utilisables sur CPU ; selon l’équipe, l’affinage sur DisTEMIST fait passer le F1 d’environ 36 à 39 pour un modèle générique à environ 73 pour la version GLiNER2.5. 🔗 source
- Paiements d’agents x402 — Laissés seuls, Qwen3 235B, DeepSeek V4 Pro et Llama 3.3 70B obtiennent 59, 55 et 30 points à l’examen de Fizzl, sans aucun admis ; quand du code décide du paiement (x402-safe-fetch), ils passent à 94, 100 et 94. 🔗 source
- GR00T-X-Embodiment-Sim dans FiftyOne — Harpreet Sahota (Voxel51) convertit 42 épisodes simulés du jeu de NVIDIA, six pour chacun de sept corps de robots, avec caméras et télémétrie des articulations alignées. 🔗 source
Écosystème
- Sakana AI — L’amiral à la retraite Michael Rogers, ancien directeur de la NSA, et Tom Moran, près de 30 ans à la CIA, deviennent conseillers seniors de la startup de Tokyo pour la défense et la cybersécurité. 🔗 source
- Recyclage chez NVIDIA — Pour la COP31, NVIDIA présente quatre jeunes pousses de son programme Inception qui trient les déchets par vision par ordinateur, dont Greyparrot, qui ramène de 375 à 6 heures le contrôle de 15 tonnes de déchets ; aucun produit NVIDIA nouveau. 🔗 source
- Guide de Perplexity sur la conformité de l’IA — Il passe en revue l’AI Act européen, le NIST AI RMF et l’ISO/IEC 42001, et propose trois contrôles pour les agents : accès au strict nécessaire, journal de chaque action et validation humaine des actions à fort impact. 🔗 source
- Guide de Perplexity sur l’architecture MCP — Rôles de l’hôte, du client et du serveur, messages JSON-RPC 2.0, transports locaux et Streamable HTTP, mise en place multi-locataire : une présentation technique qui fait suite au guide sécurité du 4 novembre, sans annonce produit. 🔗 source
- Hackathon Cohere à Toronto — Cohere organise le 30 janvier 2027 son premier hackathon avec l’université de Toronto, Hacking Higher Ed, sur l’IA dans l’enseignement supérieur ; prix de 3 000, 2 000 et 1 000 dollars, candidatures jusqu’au 22 janvier. 🔗 source
Ce que ça signifie
Google DeepMind applique ses modèles à deux problèmes où la vérification compte plus que la génération. AlphaGenome 2 ne se contente plus d’une moyenne par tissu : il prédit l’effet d’un variant dans la cellule qui intéresse le chercheur, et ses gains se mesurent sur TenK10K, une carte de 28 types de cellules immunitaires. AlphaProof Code déplace la vérification formelle de la conception du protocole vers le code compilé, avec un partage du travail explicite : les agents écrivent plus de six millions de lignes de preuve, le vérificateur Lean contrôle chaque étape, et les humains relisent les spécifications et environ 1 % du code. Les deux annonces gardent leurs limites : AlphaGenome 2 reste réservé à la recherche, et la primauté revendiquée sur Signal est celle de Google DeepMind.
La sûreté bute sur ses propres instruments de mesure. OpenAI constate que la chaîne de raisonnement, l’un des piliers de sa surveillance, devient plus difficile à lire à mesure que le préentraînement progresse, et juge lui-même la contrôlabilité, l’un de ses deux indicateurs, bruitée. Perplexity montre que le format classique de capture du drapeau détourne les agents de la frontière à tester, et qu’un modèle spécialisé en cybersécurité peut faire moins bien que sa version généraliste, sur trois essais et une configuration d’avant correctif. Dans les deux cas, la conclusion porte autant sur la façon d’évaluer que sur les modèles eux-mêmes.
La journée sépare nettement ce qui est livré de ce qui est annoncé. Runway publie Praxis-1 avec ses poids, son code d’affinage et un rapport qui situe le modèle sous quatre entrées concurrentes, et Tether met BotPsy en téléchargement. À l’inverse, Qwen4-Max arrive sans benchmark, taille ni prix, et ElevenLabs distingue elle-même ce qui est ouvert aujourd’hui (Marketplace, Partner Program, ElevenAI) de ce qui viendra plus tard (Interaction Engine, Memory, Routines, affinage). Pour qui veut tester, la seconde moitié reste une promesse.
Les agents s’installent dans la durée et dans les équipes. Grok Bot 1.0 rejoint les réunions et se coordonne avec d’autres Bots dans Slack et Teams ; les Cloud Runners de Delta font tourner un fil d’agent sans l’ordinateur de son auteur ; VS Code ajoute une boîte de réception pour les sessions qui attendent une décision ; A2UI permet aux agents de répondre par un écran plutôt que par du texte. Chacun encadre aussi le risque qu’il ouvre : permissions par personne et vérification avant de parler dans un canal public chez Grok Bot, prévisualisation privée chez Delta, autorisations ciblées et variables masquées dans le bac à sable de VS Code.
Sources
- AlphaGenome 2 (Google DeepMind)
- AlphaGenome 2 (@GoogleDeepMind)
- Introducing AlphaProof Code (Google DeepMind)
- Formal Verification of Signal (PDF, Google DeepMind)
- Qwen4-Max en préversion (@Alibaba_Qwen)
- Token Plan (QwenCloud)
- Praxis-1 is now available (Runway)
- Rapport technique de Praxis-1 (Runway)
- Collection Praxis-1 (Hugging Face)
- ElevenLabs Summit NYC (ElevenLabs)
- Annonces du Summit (@ElevenLabs)
- ElevenLabs et NVIDIA (ElevenLabs)
- Réinitialisation complète des limites (@ClaudeDevs)
- Grok Bot 1.0 (SpaceXSI)
- Grok Bot 1.0 (@SpaceXSI)
- Retiring Advanced and Standard voice in ChatGPT (aide OpenAI)
- Retrait des voix Advanced et Standard (@OpenAINewsroom)
- Gemini on Apple CarPlay (blog.google)
- CoT monitorability across the model lifecycle (OpenAI)
- Fil de Jeffrey G. Wang
- Escaping SPACE: Part II (Perplexity)
- Escaping SPACE: Part II (@perplexity_ai)
- Gemini Decision 1 (Google AI Studio)
- Decisions API (Google AI Studio)
- A2UI 1.0 (Google Developers Blog)
- Cloud Runners are now in Delta
- Documentation des Cloud Runners (Delta)
- Notes de version de VS Code 1.146
- Qwen Code v1.0.0-preview (GitHub)
- BotPsy (QVAC sur Hugging Face)
- Modèle qvac/BotPsy-0.8B (Hugging Face)
- Token Pooling-Aware Training (Hugging Face)
- Seedance 2.5 en 4K (@pika_labs)
- Seedance 2.5 en 4K (@runwayml)
- Git security vulnerabilities announced (GitHub Blog)
- Zed v1.28.1 (GitHub)
- Changelog d’Antigravity
- Gemini CLI, PR 30228 (GitHub)
- Copilot CLI v1.0.110-1 (GitHub)
- Gemini 4 Carbon dans Genspark (@genspark_ai)
- Basis et Devin for Startups (@cognition)
- Your LLM is a container now (Hugging Face)
- Gestion des sièges Copilot par les GitHub Apps (GitHub Changelog)
- Dependabot alerts will pause on inactive repositories (GitHub Changelog)
- Issue types and fields for personal accounts (GitHub Changelog)
- A more informative GitHub dashboard (GitHub Changelog)
- Singapore Airlines (OpenAI)
- Cogent Security (OpenAI)
- JioStar, Vijay Seshadri (OpenAI)
- ChatGPT Plus for veterans (OpenAI)
- Plugin fal dans ChatGPT (@fal)
- Gopuff dans Grok Bot (@bot)
- Genspark Genius (@genspark_ai)
- MiniMax H3, 100 jours (@RyanLeeMiniMax)
- Voxtral Transcribe 3 à AI Engineer Paris (@MistralAI)
- Voix locale dans Google AI Edge Gallery (Google Developers Blog)
- Déjà View (@NVIDIAAI)
- Finding diseases in Spanish clinical text (OpenMed)
- Open AI models with a wallet (Fizzl)
- GR00T-X-Embodiment-Sim dans FiftyOne (Hugging Face)
- Michael Rogers et Tom Moran (Sakana AI)
- AI recycling startups (blog NVIDIA)
- AI compliance (Perplexity)
- MCP architecture (Perplexity)
- Hacking Higher Ed (@cohere)