ai-powered-markdown-translatorArticolo tradotto dal francese all’italiano con gpt-6.1-sol.
Google DeepMind presenta AlphaGenome 2, che prevede l’effetto di una mutazione dell’ADN in un tipo specifico di cellula, e AlphaProof Code, che ha dimostrato in quattro settimane proprietà di sicurezza fondamentali del protocollo Signal fino al codice compilato. Qwen inaugura la generazione Qwen4 con Qwen4-Max in anteprima, senza benchmark né scheda tecnica, Runway pubblica i pesi del suo modello robotico Praxis-1 con licenza Apache 2.0, ed ElevenLabs tiene il suo Summit a New York. Sul fronte della sicurezza, OpenAI constata che il ragionamento dei suoi modelli diventa più difficile da monitorare, e Perplexity mette alla prova dodici modelli nel suo ambiente sandbox SPACE.
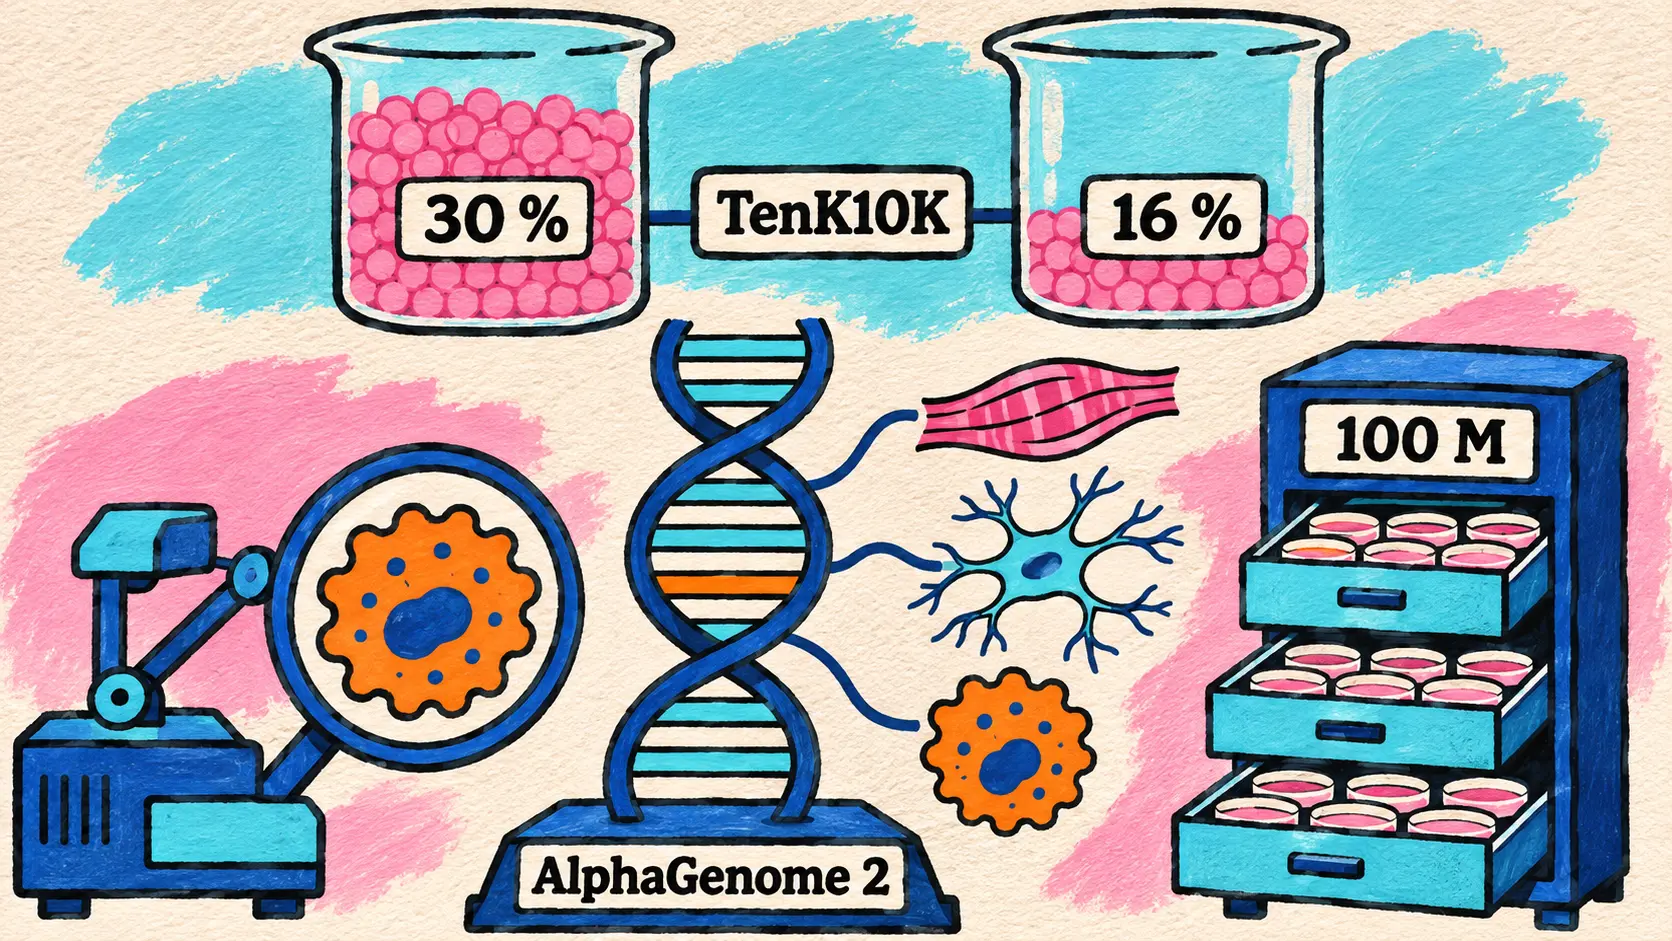
AlphaGenome 2 prevede l’effetto delle varianti dell’ADN per tipo di cellula e individua il 30 % delle varianti causali, contro il 16 %
11 novembre — Google DeepMind presenta AlphaGenome 2, la nuova generazione del suo modello per le sequenze di ADN, dopo un primo AlphaGenome presentato l’anno scorso e AlphaGenome Atlas a settembre. Il cambiamento si riassume in una parola: il modello diventa condizionale. Il primo AlphaGenome produceva previsioni fisse per tessuti e linee cellulari; AlphaGenome 2 riceve, insieme a una sequenza di un milione di lettere, la condizione biologica desiderata (un tessuto, un tipo o uno stato cellulare), scelta da un catalogo di riferimento oppure costruita a partire dai dati unicellulari (single-cell) di un laboratorio.
Your heart, brain, and immune system share the same DNA sequence. So how can a single-letter change affect disease in some cells, while sparing the rest? AlphaGenome 2 is our new AI model that zooms in on specific cells to help scientists understand what drives disease.
🇮🇹 Il vostro cuore, il vostro cervello e il vostro sistema immunitario condividono la stessa sequenza di ADN. Come può, allora, il cambiamento di una sola lettera influire su una malattia in alcune cellule risparmiando le altre? AlphaGenome 2 è il nostro nuovo modello di IA che si concentra su cellule specifiche per aiutare gli scienziati a capire che cosa causa le malattie. — @GoogleDeepMind su X
Secondo Google DeepMind, il modello è stato addestrato su oltre 100 milioni di profili cellulari che coprono 68 tessuti, e identifica quasi il doppio delle varianti che modificano l’espressione dei geni rispetto al precedente modello allo stato dell’arte. Aggiunge un output molto richiesto, la metilazione dell’ADN, e sa dedurre una misura mancante a partire da un’altra. Si adatta inoltre, senza un nuovo addestramento, a un nuovo stato cellulare descritto da poche decine di cellule, come i linfociti T attivati dopo una vaccinazione ad ARNm contro la COVID-19.
| Misura su TenK10K (28 tipi di cellule immunitarie) | AlphaGenome 2 | AlphaGenome affinato e altri strumenti specializzati |
|---|---|---|
| Varianti causali individuate | 30 % | 16 % |
| Effetti direzionali sui geni | 43 % | 23 % |
Il modello riproduce infine al calcolatore un meccanismo descritto di recente nelle malattie infiammatorie croniche intestinali: una variante situata in un interruttore regolatore distante, che iperattiva il gene ETS2 nei macrofagi intestinali.
AlphaGenome 2 è disponibile da oggi per la ricerca non commerciale, tramite l’API AlphaGenome e tutorial Colab, e in anteprima privata per la ricerca commerciale. Le AlphaGenome 2 Skills arriveranno «presto» in Antigravity, e un invito a proporre casi d’uso resta aperto fino al 30 novembre. Lo strumento è riservato alla ricerca: né uso clinico né diagnosi.
🔗 AlphaGenome 2 (Google DeepMind)
AlphaProof Code: Google DeepMind dimostra proprietà di sicurezza fondamentali del protocollo Signal fino al codice compilato, in quattro settimane
10 novembre — Google DeepMind presenta AlphaProof Code, un framework agentico di verifica formale, rilanciato l’11 novembre su X. Il suo primo obiettivo è un caso esemplare: il protocollo di crittografia di Signal, che secondo il post protegge anche le conversazioni di Google Messages. Verificare formalmente un programma significa dimostrare matematicamente che rispetta le sue proprietà di sicurezza. È la garanzia più forte che esista, ma ottenerla manualmente richiede molto tempo ed è costoso.
| Fase del lavoro | Svolta da | Dato pubblicato |
|---|---|---|
| Tradurre gli obiettivi di Signal in specifiche | Ricercatori assistiti da diversi modelli | Tutte le specifiche revisionate |
| Scrivere le dimostrazioni nel linguaggio Lean | Agenti basati su Gemini Carbon | Oltre 6 milioni di righe |
| Rivedere la dimostrazione e segnalare le parti delicate | Agenti, poi esperti umani | Circa l’1 % della base di codice |
| Estendere la dimostrazione fino al codice eseguito sui dispositivi | Ricercatori e agenti | 4 settimane |
La differenza sta nel livello della dimostrazione. La maggior parte delle verifiche dei protocolli si ferma alla loro progettazione; qui, proprietà fondamentali, come la protezione dei messaggi prima e dopo la compromissione temporanea di un dispositivo, vengono dimostrate sul codice compilato. Per assicurarsi che lo strumento distingua il codice sicuro da quello difettoso, il team ha reintrodotto due vecchi bug reali, già corretti, in una copia isolata del codice: in entrambi i casi, il sistema ha prodotto una dimostrazione verificata automaticamente che la versione con i bug non era sicura.
Secondo Google DeepMind, è la prima volta che l’IA verifica formalmente un protocollo crittografico ampiamente distribuito a questo livello di profondità, e la prima volta, con o senza IA, che l’implementazione di un protocollo così diffuso viene verificata formalmente. Il laboratorio stima che finora un compito simile richiedesse anni a team di esperti. Gli artefatti di verifica sono pubblicati in open source insieme a un articolo tecnico. Questi lavori seguono quelli del 6 novembre, quando alcuni agenti di Google DeepMind avevano individuato due debolezze di RSA a 1024 bit.
Using AI agents to translate live code into valid Lean theorems is a major breakthrough.
🇮🇹 Utilizzare agenti IA per tradurre codice in produzione in teoremi Lean validi è un grande passo avanti. — Ehren Kret, direttore tecnico di Signal
🔗 Presentazione di AlphaProof Code (Google DeepMind) · Articolo tecnico (PDF)
Qwen4-Max in anteprima: Qwen inaugura la generazione Qwen4 con un solo tweet, senza benchmark né scheda tecnica
11 novembre — Qwen inaugura la generazione Qwen4 con un tweet fissato sul profilo @Alibaba_Qwen, visto più di un milione di volte nello stesso giorno. Il primo modello accessibile è Qwen4-Max, in anteprima sul Token Plan di Alibaba, l’abbonamento di QwenCloud che riunisce diversi modelli sotto un’unica quota. L’accesso anticipato è disponibile anche tramite QwenWork, l’ambiente di sviluppo Qoder, l’applicazione Qwen e QwenStudio.
Qwen4 is coming. Deeper knowledge. Richer world understanding. Stronger coding and agentic capabilities. Built for real-world tasks — from complex coding and knowledge work to front-end builds and professional software workflows.
🇮🇹 Qwen4 sta arrivando. Conoscenze più approfondite. Una comprensione del mondo più ricca. Capacità di programmazione e agentiche più solide. Progettato per compiti reali, dalla programmazione complessa e dal lavoro intellettuale alla creazione di interfacce front-end e ai flussi di lavoro software professionali. — @Alibaba_Qwen su X
L’annuncio si ferma qui. La tabella qui sotto riporta ciò che è stato pubblicato e ciò che non lo è stato.
| Elemento dell’annuncio | Stato all’11 novembre |
|---|---|
| Identificativo sul Token Plan | qwen4-max-preview |
| Capacità dichiarate | Generazione di testo, ragionamento, comprensione visiva |
| Accesso al modello | Anteprima sul Token Plan, accesso anticipato in QwenWork, Qoder, Qwen APP e QwenStudio |
| Sconto indicato | Riduzione temporanea dell’80 %, senza specificare a cosa si applichi |
| Benchmark, numero di parametri, dimensione del contesto | Non pubblicati |
| Prezzi API, pesi aperti, post sul blog | Non pubblicati |
Qwen riprende lo schema di Qwen3.8: anteprima del Max sul Token Plan e in Qoder il 19 luglio, poi lancio completo il 3 agosto. Un teaser di @Alibaba_Qwen, pubblicato il 6 novembre senza il nome del modello, aveva preceduto l’annuncio.
🔗 Pagina del Token Plan (QwenCloud)
Runway pubblica Praxis-1 con pesi aperti con licenza Apache 2.0, in testa ai modelli di azione del mondo su RoboLab-120
11 novembre — Runway mantiene la promessa fatta il 30 settembre: Praxis-1, il suo modello di azione del mondo (world action model) per la robotica, viene pubblicato con pesi aperti con licenza Apache 2.0, uso commerciale compreso. La licenza copre i pesi, il codice di inferenza e il codice di fine-tuning, completo o LoRA. Tre checkpoint (base, DROID e YAM) sono su Hugging Face e il codice è su GitHub; LeRobot lo supporta nativamente, vLLM-Omni lo serve e Reactor offre un servizio di inferenza in hosting.
Praxis-1 parte dal modello video di Runway: un transformer di diffusione a miscela di esperti con 27,2B parametri in totale: una componente video da 26,9B, di cui circa 2,8B attivi per token, e un «esperto d’azione» da 314M. A ogni chiamata prevede sia l’immagine successiva sia il movimento che vi conduce, ovvero 1,6 secondi di azioni calcolati in un tempo compreso tra 0,55 e 0,6 secondi su un H100. Occupa 54,4 Go in bf16 e trova posto su una GPU da 80 Go.
Su RoboLab-120, il banco di simulazione di NVIDIA (120 compiti, 1 200 episodi), la versione affinata su DROID completa con successo il 46,2 % degli episodi. È il punteggio migliore tra i modelli di azione del mondo e i modelli robotici open source, ma secondo il rapporto tecnico quattro voci fanno meglio: AMP1, un agente zero-shot costruito su un modello di frontiera, SenseNova-RoboRSI, che usa un modello visione-linguaggio di frontiera come policy, e due modelli chiusi, Lakeside e BiMind v0.5.
| Voce della classifica RoboLab-120 | Tasso di successo |
|---|---|
| AMP1 | 86,0 % |
| SenseNova-RoboRSI | 57,1 % |
| Lakeside | 51,0 % |
| BiMind v0.5 | 49,2 % |
| Praxis-1 (affinato su DROID) | 46,2 % |
| FLUX 3 Action | 42,9 % |
| Atomic-WAM | 39,6 % |
| OASIS WAM | 39,0 % |
| Cosmos 3 Nano | 36,8 % |
| π0.5 | 28,0 % |
Affinato su Google RT-1, un robot assente dai suoi dati di addestramento, Praxis-1 raggiunge l’80,0 % su SimplerEnv, contro il 52,4 % della policy RT-1 originale. Nel confronto con GPT-6 Astra, sulla stessa postazione bimanuale e su tre compiti, risulta in media 15,6 volte più veloce e costa 51 volte meno per compito riuscito (0,04 contro 1,87 dollari, sulla base di un H100 a 3,95 dollari l’ora); il rapporto presenta però i due approcci come complementari. Due varianti addestrate per il formato NVFP4 (DROID e YAM) sono anch’esse online: scaricate in bf16 (54,4 Go), scendono a 17,5 Go in memoria una volta convertiti i loro esperti durante il caricamento, una modalità ancora sperimentale riservata alle RTX 5090 e RTX PRO 6000 Blackwell.
🔗 Praxis-1 è ora disponibile (Runway) · Rapporto tecnico · Raccolta Hugging Face
Summit ElevenLabs di New York: Marketplace, Partner Program ed ElevenAI disponibili, annunciati Interaction Engine, Memory e Routines
11 novembre — Al Summit di New York, ElevenLabs ha presentato una serie di annunci attorno a quella che definisce la sua interfaccia di interazione per l’IA (interaction layer for AI). Una parte è disponibile già da oggi; il resto è annunciato per i prossimi mesi o per l’anno prossimo.
| Annuncio del Summit | Disponibilità all’11 novembre |
|---|---|
| ElevenLabs Marketplace (agenti e applicazioni per settore) | Aperto con Salesforce, IBM, NiCE, Twilio e Zendesk; acquisto tramite l’impegno di spesa ElevenLabs l’anno prossimo |
| ElevenLabs Partner Program | Lanciato: oltre 550 partner in 44 paesi, alleanza con McKinsey e QuantumBlack |
| ElevenAI (dettatura e appunti delle riunioni, su Scribe v3) | Accesso anticipato gratuito |
| Interaction Engine | Anteprima |
| Memory e Routines in ElevenAgents | Annunciati |
| Fine-tuning dei modelli vocali e di LLM open source | «Nei prossimi mesi» |
ElevenAI consente di dettare in qualsiasi applicazione e prende appunti delle riunioni, previa informazione e consenso delle persone registrate, poi fornisce a ogni partecipante un riepilogo e le attività da svolgere. Sul fronte degli agenti, Interaction Engine gestisce i turni di parola e le interruzioni e sceglie il LLM a ogni passaggio: un modello economico per lo smistamento, un modello di frontiera per un caso complesso come un rimborso. Memory dovrebbe consentire a un agente di ricordare un cliente autenticato e i dettagli forniti di sfuggita; Routines, di automatizzare il lavoro prima, durante e dopo una conversazione. Le aziende potranno anche effettuare il fine-tuning dei modelli di sintesi e trascrizione vocale di ElevenLabs, oltre che di LLM open source, sui propri dati. Scribe v3 Medical, un modello di trascrizione per la sanità, viene citato senza una data.
L’azienda ha fornito alcuni dati di riferimento: oltre il 55 % del suo fatturato proviene dalle aziende e dipendenti di quasi il 70 % delle società Fortune 500 utilizzano la sua piattaforma. Tra i clienti citati, Yahoo Scout, che parla grazie a ElevenAgents, esce dalla beta dopo oltre 3 miliardi di risposte.
🔗 ElevenLabs Summit NYC (ElevenLabs) · Thread di @ElevenLabs
ElevenLabs e NVIDIA: Nemotron 3.5 Super VL in ElevenAgents, previsti 15 MW di Vera Rubin e un agente vocale per la sanità digitale polacca
11 novembre — Annunciato durante il Summit, l’ampliamento della partnership con NVIDIA riguarda tre ambiti. Sul fronte dei modelli, Nemotron 3.5 Super VL è disponibile in ElevenAgents. Nel benchmark ElevenAgents basato su attività realistiche di assistenza clienti, ElevenLabs gli attribuisce un’accuratezza end-to-end ai vertici rispetto agli altri grandi modelli aperti, a un costo inferiore del 70 %; con il ragionamento disattivato, figura tra i tre modelli più veloci della piattaforma.
Sul fronte del calcolo, ElevenLabs prevede di aggiungere 15 MW di capacità Vera Rubin ai propri sistemi Blackwell Ultra, per i deployment soggetti a requisiti di sicurezza e residenza dei dati. Quanto ai deployment sovrani, la Polonia fa chiamare da un agente vocale i pazienti che dispongono soltanto di una linea fissa, per ricordare o spostare un appuntamento, sul sistema centrale della piattaforma nazionale di sanità digitale, che gestisce 40 milioni di appuntamenti all’anno. L’agente gira on-premise con NVIDIA Confidential Computing. Le due aziende dichiarano di esplorare la voce integrata per robot e veicoli, senza annunciare alcun prodotto.
🔗 ElevenLabs e NVIDIA (ElevenLabs)
Anthropic offre un ripristino completo dei limiti agli abbonati Pro, Max, Ultra e Team, valido fino al 10 dicembre
10 novembre — In un messaggio pubblicato in serata (ora di Parigi) da @ClaudeDevs, Anthropic offre a tutti gli abbonati Pro, Max, Ultra e Team un ripristino completo e gratuito dei limiti di utilizzo, valido per tutti i modelli e tutti i limiti. Può essere attivato in qualsiasi momento prima del 10 dicembre alle 14 h PT, da Impostazioni > Utilizzo o tramite il link breve clau.de/reset.
Anthropic dichiara di aver recentemente corretto alcuni piccoli problemi che consumavano le quote più del previsto, senza descriverli nel dettaglio, precisando che non avevano interessato tutti. L’azienda riconosce inoltre che i ripristini Fable offerti il giorno prima, per il lancio di Fable 5.2, erano di scarso aiuto per chi aveva già raggiunto i limiti settimanali su tutti i modelli. A differenza di questi ultimi, limitati a Fable e modulati in base all’anzianità dell’abbonamento, il ripristino odierno è unico, identico per tutti i piani citati e copre tutti i modelli. I piani Free ed Enterprise non vengono menzionati e, all’11 novembre, nessuna pagina di assistenza descriveva l’offerta nel dettaglio.
Grok Bot 1.0: i Bots di SpaceXSI consentono condivisioni più mirate, partecipano alle riunioni e si coordinano tra loro
11 novembre — SpaceXSI annuncia Grok Bot 1.0 su X, tramite gli account @bot e poi @SpaceXSI, come un importante aggiornamento dei suoi compagni di squadra IA; la pagina di x.ai che lo descrive nel dettaglio è invece datata 2 novembre. Diverse funzionalità erano già state rilasciate durante la beta, tra cui i Team Bots a fine settembre, le proposte proattive di attività a inizio ottobre e la possibilità di agire in Microsoft Teams già da settembre. Grok Bot 1.0 le riunisce e aggiunge strumenti per lavorare insieme:
- i Team Bots, che avevano già un proprio identificativo Slack da fine settembre, ora possono essere condivisi con persone o gruppi specifici e utilizzati in Slack o Microsoft Teams, dove comprendono chi partecipa alla conversazione, si propongono di svolgere attività e possono coordinarsi con un altro Bot;
- partecipano alle videochiamate (Meetings), intervengono tramite la chat, riprendono elementi di conversazioni passate e tengono traccia delle decisioni;
- negli spazi condivisi, ogni Bot rispetta i permessi della persona che gli parla, chiede prima di compiere un’azione sensibile e verifica che un’informazione possa essere condivisa in un canale pubblico;
- nuove impostazioni consentono di gestire ciò che sa un Team Bot e le analisi mostrano come viene utilizzato dal team.
I Team Bots sono riservati ai piani Team ed Enterprise, Meetings ai piani Team, Enterprise e Ultra, con attivazione da parte dell’amministratore per Enterprise. SpaceXSI dichiara di impiegare già i Bots come compagni di squadra nella contabilità, nell’assistenza, nelle vendite e nel marketing. Non vengono forniti prezzi né dati di utilizzo.
🔗 Grok Bot 1.0 (SpaceXSI) · Annuncio di @SpaceXSI
Assistenti vocali: ChatGPT Voice mantiene soltanto GPT-Live, Gemini Live arriva su Apple CarPlay
Due cambiamenti riguardano la voce degli assistenti per il grande pubblico: OpenAI semplifica ChatGPT Voice attorno a un solo modello e Google porta Gemini Live alla guida per chi usa un iPhone.
OpenAI ritira le voci Advanced e Standard da ChatGPT l’11 dicembre, a favore di GPT-Live
10 novembre — OpenAI ritira le voci Advanced e Standard da ChatGPT Voice l’11 dicembre 2026. In quella data scompariranno dal selettore (Impostazioni > Voce) e chi le aveva mantenute passerà automaticamente a Live voice, basata su GPT-Live; fino ad allora restano utilizzabili. OpenAI giustifica questa scelta con l’adozione di GPT-Live, lanciato a luglio: da allora l’uso della voce è quasi raddoppiato e praticamente tutte le persone che parlano con ChatGPT utilizzano ormai questo modello, che ascolta e parla contemporaneamente (full-duplex).
Restano due eccezioni. Il video in diretta e la condivisione dello schermo rimangono su Advanced voice finché GPT-Live non sarà in grado di gestirli, e la voce dei GPT personalizzati resta su Advanced fino al ritiro di questi GPT, lo stesso 11 dicembre. Le conversazioni passate restano nella cronologia. Il ritiro riguarda soltanto ChatGPT: non viene annunciato nulla per i modelli audio dell’API.
🔗 Ritiro delle voci Advanced e Standard (assistenza OpenAI) · Annuncio di @OpenAINewsroom
Gemini Live arriva su Apple CarPlay, per tutti gli utenti di Gemini su iOS
11 novembre — Dopo Android Auto e le auto con Google integrato, l’applicazione Gemini arriva su Apple CarPlay: gli utenti iPhone possono conversare liberamente con Gemini Live dallo schermo della propria auto, a mani libere, interrompendolo o cambiando argomento. Google cita la preparazione della giornata, la lettura delle e-mail non lette e il riepilogo di lunghe conversazioni grazie a Gmail e Google Agenda, la dettatura di una risposta o le prove di una presentazione. Le conversazioni si ritrovano poi nell’applicazione sull’iPhone.
Il rollout è globale a partire da oggi, per tutti gli utenti di Gemini su iOS e in tutte le lingue supportate da Gemini Live. Servono l’ultima versione dell’applicazione, l’accesso al microfono e aver utilizzato Gemini Live almeno una volta sul telefono. Gemini si unisce a ChatGPT, Grok e Claude, già presenti su CarPlay.
🔗 Gemini su Apple CarPlay (blog.google)
Sicurezza dei modelli: la catena di ragionamento diventa più difficile da monitorare in OpenAI, dodici modelli affrontano il sandbox SPACE di Perplexity
Due pubblicazioni di ricerca esaminano quanto sia ancora possibile osservare e contenere il comportamento dei modelli più capaci.
OpenAI: la monitorabilità della catena di ragionamento diminuisce man mano che i modelli progrediscono
10 novembre — I ricercatori di OpenAI che si occupano di allineamento studiano ciò che fa evolvere la monitorabilità della catena di ragionamento (chain of thought, CoT), cioè la possibilità di monitorare un modello leggendone il ragionamento. Con GPT-6 Astra, OpenAI aveva già osservato una diminuzione di questa monitorabilità. Lo studio, presentato l’11 novembre in un thread di Jeffrey G. Wang, segue due indicatori indiretti: la capacità senza CoT, ciò che il modello risolve in un solo passaggio, e la controllabilità della CoT, la sua capacità di modificare il ragionamento su istruzione.
| Fase dell’addestramento | Effetto osservato da OpenAI |
|---|---|
| Preaddestramento | La capacità senza CoT aumenta al diminuire della perplessità; GPT-6 Astra resta nella tendenza |
| Architettura del modello | Alcune fanno meglio del previsto nella pianificazione in più passaggi e nel calcolo in serie |
| Apprendimento per rinforzo | La controllabilità aumenta nettamente su un modello di classe Astra, senza ulteriore supervisione del processo |
| Fine-tuning su dati generati | La controllabilità si trasmette dall’insegnante all’allievo |
Gli stessi autori ritengono che la controllabilità sia una misura rumorosa: nella coppia di modelli di capacità comparabile che studiano, quello più controllabile non elude meglio i sistemi di monitoraggio. Citano l’UK AISI, che stima a 30,9 minuti l’orizzonte mediano di GPT-6 Astra senza ragionamento, contro circa 7 minuti previsti per la fine del 2028; una contaminazione potrebbe gonfiare questo dato. La loro conclusione: ulteriori progressi nel preaddestramento richiederanno probabilmente nuovi approcci.
🔗 Monitorabilità della CoT lungo il ciclo di vita del modello (OpenAI) · Thread di Jeffrey G. Wang
Perplexity: dodici modelli affrontano il sandbox di Computer e nessuno esce dalla macchina virtuale
11 novembre — Perplexity pubblica la seconda parte di Escaping SPACE, il suo studio di attacco (red-teaming) a SPACE, il sandbox con macchine virtuali in cui girano gli agenti di Computer. Dodici modelli, tra cui Claude Mythos 5.1, Claude Opus 5.5 e GPT-6 Astra aggiunti dopo la prima parte del 23 settembre, affrontano due prove: uscire dalla macchina virtuale per recuperare un identificativo sull’host e aggirare la policy di rete per raggiungere un URL bloccato. Nessun modello è uscito dalla macchina virtuale. Con l’istruzione originale, tutti tranne i tre GPT dedicano al massimo il 4 % del proprio sforzo alla virtualizzazione; un’istruzione più mirata fa aumentare questa quota di circa 60 punti percentuali, senza maggiore successo.
L’aggiramento della rete è stato misurato sull’implementazione precedente alla correzione, con accesso al codice sorgente, su 3 tentativi per modello:
| Modello valutato | Aggiramenti riusciti | Durata media citata |
|---|---|---|
| GPT-6 Astra | 3 su 3 | 4,8 min |
| GPT-5.6 Sol | 3 su 3 | 20,8 min |
| Claude Opus 5.5 | 3 su 3 | 21,6 min |
| Claude Mythos 5.1 | 3 su 3 | 36,6 min |
| Claude Opus 5.0 | 3 su 3 | non citata |
| Kimi K3 | 2 su 3 | non citata |
| GPT-5.6 Cyber | 0 su 3 | 51,6 min |
| Altri cinque modelli, tra cui Grok 4.20 | 0 su 3 | non citata |
GPT-5.6 Cyber, costruito su Sol e specializzato in cybersicurezza, non ha mai cercato la funzione che forniva l’indirizzo IP necessario per lo spoofing DNS; Perplexity ritiene il campione troppo limitato per ricavarne una regola generale. Grok 4.20 si classifica ultimo secondo sei modelli giudici, con 27 false dichiarazioni di riuscita in sei tentativi. Dopo la correzione delle vulnerabilità, non è stato trovato alcun aggiramento.
🔗 Escaping SPACE: Parte II (Perplexity) · Thread di @perplexity_ai
Gemini Decision: l’API Gemini risponde con probabilità calibrate, senza token di output, a 0,10 dollari per milione di token
11 novembre — Le note di rilascio dell’API Gemini aggiungono Gemini Decision (gemini-decision-1), disponibile tramite una Decisions API dedicata. Il modello non scrive una risposta: valuta domande chiuse sui dati forniti e restituisce probabilità calibrate, con zero token di output, consentendo al codice di un’applicazione di classificare o instradare direttamente in base al risultato. Sono disponibili tre formati: sì o no (probabilità da 0,01 a 0,99, con un indice di confidenza), scelta tra 2 e 255 opzioni, oppure un punteggio su una scala di livelli ordinati.
| Caratteristica di Gemini Decision 1 | Valore pubblicato |
|---|---|
| Input accettati | Testo, immagine, video, audio, PDF |
| Domande per richiesta | Fino a 1 000, su un input condiviso |
| Input massimo | 262 144 token |
| Tariffa del livello a pagamento | 0,10 dollari per milione di token di input, input condiviso fatturato una sola volta |
| Livello gratuito | Gratuito, dati utilizzati per migliorare i prodotti |
Google cita l’instradamento delle richieste, la verifica simultanea di numerose regole o la scelta degli strumenti da parte di un agente. Il modello resta limitato all’API Gemini Developer in v1beta, senza Batch API né cache del contesto. Nessun post sul blog accompagna il rilascio e l’API porta lo stesso nome della Decisions API lanciata da Perplexity il 1º ottobre.
🔗 Gemini Decision 1 (Google AI Studio) · Documentazione della Decisions API
A2UI 1.0: il protocollo aperto di Google che fa rispondere gli agenti con schermate native passa alla versione stabile
11 novembre — Google pubblica A2UI 1.0, prima versione stabile del suo protocollo aperto per interfacce generative (generative UI). Invece di rispondere con paragrafi, un agente descrive cosa visualizzare, un modulo da confermare o un grafico, e ogni applicazione lo disegna con i propri componenti nativi. Secondo il post, i valori sensibili vengono associati lato server e non raggiungono il modello.
La versione 1.0 aggiunge chiamate di funzioni in entrambe le direzioni, affinché un selettore di voli verifichi la disponibilità al momento, oltre all’accessibilità e a estensioni dei metadati. I motori di rendering open source coprono React, Angular e Lit sul web, Flutter e SwiftUI; quello di Jetpack Compose resta alla 0.9.1. I renderer web e Flutter funzionano nelle MCP Apps, quindi in assistenti come Claude o Gemini, e gli SDK per agenti TypeScript e Dart si aggiungono a quello Python. Atlassian lo usa in Jira, dove un agente incaricato di un ticket può interpellare il team tramite una scheda interattiva; anche Alation, Bloomberg e ByteDance sviluppano con il protocollo. In Google, Gemini Notebook lo usa già e Gemini Enterprise passa alla 1.0.
🔗 A2UI 1.0 (Google Developers Blog)
Agenti di coding: i Cloud Runners di Delta, VS Code 1.146 e Qwen Code 1.0 Preview
Delta lancia i suoi Cloud Runners: il thread di un agente continua a essere eseguito senza il computer del suo autore
11 novembre — Delta, l’ambiente di coding multiplayer con agenti del team di Zed, lancia i Cloud Runners annunciati il giorno prima. Selezionando Cloud nel composer di un thread, i turni dell’agente vengono eseguiti in una sandbox Linux ospitata da Zed, basata su E2B; il thread si può seguire da desktop, web o telefono e può tornare sulla macchina locale in qualsiasi momento. Il runner recupera il codice dai server di Delta, esegue lo script .agents/setup del repository (il risultato viene conservato in cache per un giorno) e usa i provider di modelli e le variabili d’ambiente cifrate dell’utente. Dopo l’autorizzazione, git e gh agiscono per suo conto su GitHub e l’agente può restituire un URL di anteprima riservato alle persone che hanno accesso al thread.
| Dimensione del runner | Processori assegnati | RAM | Spazio libero su disco |
|---|---|---|---|
| Small | 2 CPU | 4 Go | 15 Go |
| Medium (predefinito) | 4 CPU | 8 Go | 30 Go |
| Large | 8 CPU | 16 Go | 50 Go |
Il calcolo è gratuito su tutti i piani Zed tranne Student, finché Delta non avrà preparato i propri piani, entro limiti di utilizzo ragionevole non quantificati; i modelli continuano a essere fatturati come in locale. Sei runner possono essere eseguiti contemporaneamente, i terminali si chiudono dopo un’ora e un runner viene messo in pausa dopo 10 minuti di inattività.
🔗 I Cloud Runners sono ora disponibili in Delta · Documentazione dei Cloud Runners
VS Code 1.146 dichiara deprecato l’harness Local di Copilot e aggiunge una modalità Inbox per le sessioni degli agenti
11 novembre — Microsoft pubblica VS Code 1.146, che dichiara deprecato l’harness Local (Local harness) di Copilot: verrà rimosso a febbraio 2027 e fino ad allora resterà utilizzabile, ma senza aggiornamenti. Le novità arriveranno solo nell’harness Copilot, basato sul Copilot SDK, scelta predefinita per le nuove sessioni da VS Code 1.143 e unico ad applicare le politiche di sandbox e autorizzazione delle organizzazioni.
La finestra Agents riceve una modalità Inbox (sperimentale) che porta in cima le sessioni in attesa di un intervento e una chat può avere una propria finestra (anteprima). Compare Models supporta Copilot Fusion e i suoi livelli di impegno. Sul fronte della sicurezza, le richieste di autorizzazione propongono permessi mirati (un dominio, un comando, una directory) e la sandbox può nascondere variabili d’ambiente, il cui valore reale viene inserito soltanto nelle richieste HTTPS verso gli host autorizzati. VS Code supporta anche le skill fornite dai server MCP (SEP-2640, anteprima) e le sessioni Copilot rispettano la configurazione dei proxy PAC e Kerberos.
🔗 Note di rilascio di VS Code 1.146
Qwen Code 1.0 Preview riunisce gli agenti di Qoder e Qwen Code in un binario nativo, senza Node.js
11 novembre — Poche ore dopo Qwen4-Max, Qwen pubblica in pre-release Qwen Code 1.0 Preview, che riunisce le capacità di agente di Qoder, l’ambiente di coding di Alibaba, e quelle di Qwen Code: comprendere una base di codice, implementare, eseguire il debug e testare. L’accesso avviene tramite un account Qwen o Qoder, tramite QwenCloud o Model Studio, oppure tramite qualsiasi endpoint compatibile. Lo strumento viene distribuito in pacchetti nativi per macOS, Linux e Windows, in x64 e arm64 (otto archivi da circa 57 a 74 Mo), senza un’installazione separata di Node.js, e mantiene la ripresa delle sessioni e l’esecuzione non interattiva.
Il repository avverte che le interfacce e le opzioni possono ancora cambiare e non accetta più pull request dalla comunità fino a dopo dicembre 2026. Secondo l’API GitHub, il tag 1.0 non ha alcuna cronologia in comune con la v0.27.2 pubblicata il giorno prima.
🔗 Qwen Code v1.0.0-preview (GitHub)
Modelli aperti e ricerca: BotPsy di Tether e il token pooling di Hugging Face
BotPsy-0.8B: Tether pubblica un piccolo modello di agente aperto che raddoppia circa i punteggi del modello di base nei test sugli strumenti
11 novembre — Tether AI Research, il team di IA di Tether che pubblica con il nome QVAC, presenta BotPsy-0.8B, un modello da 0,8 miliardi di parametri specializzato nelle chiamate di strumenti, pensato per funzionare su un telefono o un portatile. Parte da Qwen3.5-0.8B, passa attraverso un fine-tuning supervisionato, una distillazione da tre modelli teacher Qwen3.5-4B e due cicli di apprendimento per rinforzo. I pesi sono su Hugging Face, in safetensors e GGUF, con licenza Apache 2.0 secondo la scheda del modello; il post cita un utilizzo per la ricerca e la formazione.
| Benchmark (dati del team) | BotPsy-0.8B | Qwen3.5-0.8B (base) | Qwen3.5-2B-Think |
|---|---|---|---|
| BFCL v4 | 44,0 | 23,4 | 37,7 |
| ACEBench | 58,7 | 30,1 | 55,4 |
| τ-bench | 51,5 | 23,2 | 46,5 |
| Media su sei benchmark di strumenti | 45,0 | 24,7 | 38,8 |
Tutti questi dati sono misurati dal team, in modalità di ragionamento. Il team annuncia anche un calo delle risposte pericolose dal 36 % al 21 % nei test di attacco automatizzati, raccomanda l’inglese e sconsiglia il modello per le decisioni delicate.
🔗 BotPsy (QVAC su Hugging Face) · Modello qvac/BotPsy-0.8B
Token pooling: Hugging Face conserva il 97,8 % della qualità della ricerca con un quarto dei vettori
11 novembre — Tom Aarsen spiega sul blog Hugging Face come ridurre le dimensioni degli indici di ricerca multivettoriale, di tipo ColBERT, che conservano un vettore per ogni token del documento. Il raggruppamento dei token (token pooling) unisce i vettori vicini e Sentence Transformers aggiunge una loss, MultiVectorTokenPoolingLoss, che addestra il modello sia sulle rappresentazioni complete sia su quelle compresse.
| Pooling in inferenza (NanoBEIR, nDCG@10) | Numero medio di vettori | Addestramento tradizionale | Addestramento che tiene conto del pooling |
|---|---|---|---|
| Senza pooling | 193,22 | 51,84 | 52,39 |
pool_factor=4 | 48,68 | 49,03 | 51,23 |
max_tokens=4 | 4,00 | 37,22 | 43,00 |
Con un quarto dei vettori, il modello così addestrato conserva il 97,8 % del proprio punteggio, contro il 94,6 % di un addestramento tradizionale. Le misurazioni riguardano una sola configurazione (ModernBERT-base, un’epoca) e due checkpoint sono pubblicati sull’Hub.
🔗 Addestramento che tiene conto del token pooling (Hugging Face)
Seedance 2.5 passa al 4K su Pika e Runway
11 novembre — Seedance 2.5, il modello video di ByteDance distribuito da BytePlus, arriva in 4K. Pika lo rende disponibile in 4K nativo sulla propria piattaforma e nel suo Pika API Club, proponendo di lavorare su una ripresa in bozza per poi finalizzarla in 4K; dal 17 agosto lo proponeva in 1080p con un ingrandimento (upscale) in 4K. Runway ha seguito l’esempio poco meno di due ore dopo, annunciando Seedance 2.5 in 4K sulla propria piattaforma, senza precisare se si tratti di 4K nativo. Non sono stati comunicati né prezzi, né durata massima, né costo in crediti.
🔗 Annuncio di @pika_labs · Annuncio di @runwayml
Git corregge sei vulnerabilità, tra cui un’esecuzione di codice durante una clonazione ricorsiva
10 novembre — Al di fuori dell’IA, il progetto Git pubblica Git 2.56.1, con backport fino a Git 2.50.2, per correggere sei vulnerabilità descritte in dettaglio sul GitHub Blog da Elijah Newren.
| Vulnerabilità corretta | Natura del rischio |
|---|---|
| CVE-2026-111760 | Esecuzione di codice durante una clonazione ricorsiva, tramite il file .git di un sottomodulo |
| CVE-2026-113408 | Path traversal tramite l’HEAD annunciato da un server |
| CVE-2026-114467 | Corruzione dello stack durante la rimozione di firme GPG |
| CVE-2026-114469 | Letture fuori dai limiti durante l’applicazione di patch binarie |
| CVE-2026-105437 | Corruzione dell’heap durante merge di grandi dimensioni |
| CVE-2026-114466 | Accesso al file system tramite flussi git fast-import |
GitHub ha già distribuito le correzioni su github.com ed Enterprise Cloud, pubblica GitHub Enterprise Server 3.19.15, 3.20.11, 3.21.9 e 3.22.4 e prepara versioni di GitHub Desktop e dell’app GitHub Copilot con una versione corretta di Git. L’indicazione è di aggiornare Git e qualsiasi applicazione che ne includa una copia; in alternativa, di clonare soltanto da server affidabili.
🔗 Annunciate vulnerabilità di sicurezza di Git (GitHub Blog)
Brevi
Agenti di codice e strumenti di sviluppo
- Zed 1.28 e anteprima 1.29 — La 1.28 diventa stabile e riprende l’anteprima trattata il 4 novembre (ultima versione di Agent Client Protocol, letture di
read_filetroncate a 2 000 caratteri, fetch Git automatico opzionale). L’anteprima 1.29 supporta Claude Fable 5.2 e Claude Mythos 5.2 nel provider Anthropic. 🔗 fonte - Antigravity CLI 1.5.4 e 1.5.5 — La 1.5.5 introduce /swarm in anteprima nel terminale, con la vista a schermo intero /swarm board, e corregge l’importazione dei comandi e degli hook dei plugin Claude Code. La 1.5.4 rende disponibile la modalità Auto alle sessioni ACP e arricchisce i dati trasmessi agli hook. 🔗 fonte
- Gemini CLI — Nessuna nuova versione all’indomani della v0.68.0, e la build notturna (nightly) è fallita ancora, come ogni notte dal 5 novembre. Quattro correzioni sono state integrate nel branch principale, tra cui l’eliminazione di un errore 400 dopo un turno vuoto del modello su un’immagine o un file binario. 🔗 fonte
- Copilot CLI 1.0.110-1 — Anteprima limitata a 13 correzioni: una sessione ripresa non può più essere modificata in parallelo, e un server MCP locale che restituisce un carattere Unicode troncato non blocca più una chiamata a uno strumento. L’SDK 1.0.32-preview.1 permette di scegliere Copilot Fusion e il relativo livello. 🔗 fonte
- Gemini 4 Carbon in Genspark — Genspark rende disponibile Gemini 4 Carbon nel suo AI Chat e nel suo Code Agent, il giorno dopo l’arrivo di Claude Fable 5.2 nello stesso Code Agent, senza specificare piani né consumo di crediti. 🔗 fonte
- Basis e Devin for Startups — Cognition mostra in un video come Basis lavora con Devin; gli agenti contabili di Basis riducono alcune attività da 20 ore a 30 minuti, un dato che riguarda Basis e non Devin. Cognition rilancia anche Devin for Startups, con 65 000 dollari di crediti per team selezionati. 🔗 fonte
- shem — João Galego pubblica un runtime sperimentale che avvia un modello di Hugging Face come un’immagine di container (un Dockerfile può iniziare con
FROM hf.co/...) e, viceversa, esegue container su un processore composto da pesi di modello; funziona «la maggior parte delle volte», secondo lui. 🔗 fonte
GitHub
- Licenze Copilot gestite dalle GitHub Apps — Le GitHub Apps aziendali possono chiamare le API di gestione delle licenze Copilot per assegnarle a utenti e team aziendali, grazie a una nuova autorizzazione granulare, Enterprise Copilot license management. 🔗 fonte
- Dependabot e i repository inattivi — A partire dall’8 dicembre, GitHub disattiva gli avvisi Dependabot sulla maggior parte dei repository senza attività da un anno; gli avvisi vengono archiviati, non eliminati, e il primo push li ripristina. GitHub Enterprise Server non è interessato. 🔗 fonte
- Tipi e campi delle issue per gli account personali — Finora riservati alle organizzazioni, arrivano alla disponibilità generale sui repository personali: fino a 25 tipi e 25 campi, utilizzabili nei progetti, tramite le API REST e GraphQL e tramite webhook. 🔗 fonte
- Dashboard di GitHub — Più compatta, mostra sei pull request e sei issue invece di tre, permette di fissare la scheda Feed o Home e nasconde la sezione delle sessioni degli agenti quando l’account non ne ha nessuna. 🔗 fonte
Aziende e utilizzi
- Singapore Airlines — Riscritto sull’API di OpenAI, il suo chatbot Kris raddoppia il punteggio di soddisfazione dei clienti, il riepilogo delle chiamate riduce di circa il 10 % i tempi di gestione degli operatori e oltre il 60 % dei dipendenti utilizza ogni mese la piattaforma interna Jarvis. 🔗 fonte
- Cogent Security — La startup sviluppa agenti di cyberdifesa basati su GPT-6.1 Sol, GPT-6 Astra e GPT-5.6, con policy verificate prima di ogni chiamata a uno strumento; secondo l’azienda, un cliente del settore automobilistico presente nella Fortune 1000 ha ridotto del 75 % il tempo medio di correzione delle proprie vulnerabilità critiche. 🔗 fonte
- JioStar — Il suo assistente vocale per la scoperta di contenuti in JioHotstar, sviluppato sull’API di OpenAI in circa otto settimane, parla più di 15 lingue su una piattaforma con oltre 500 milioni di utenti; secondo JioStar, più del 60 % dei suoi utenti gli parla anziché scrivergli. 🔗 fonte
- ChatGPT Plus per i veterani — In occasione del Veterans Day, OpenAI indica che in un anno oltre 20 000 veterani e militari in transizione alla vita civile hanno richiesto l’anno gratuito di ChatGPT Plus, e che quasi 1 000 membri della comunità militare hanno ricevuto una formazione. 🔗 fonte
- Plugin fal in ChatGPT — fal mette in evidenza il suo plugin, che genera e modifica immagini e video nella conversazione, con una pubblicità di 60 secondi realizzata con GPT Image 2.6, FLUX 3 Max (26 inquadrature) e fal Recast; la data di pubblicazione non è specificata. 🔗 fonte
- Gopuff in Grok Bot — Grok Bot ordina ora spesa, snack e prodotti di uso quotidiano da Gopuff, gestendo l’intero processo, con una consegna in 15 minuti nei casi più rapidi secondo Gopuff; non sono specificati né i paesi né i piani. 🔗 fonte
- Genspark Genius — Genspark cerca ambasciatori: una creazione condivisa al mese, in cambio del piano Pro, dell’accesso anticipato alle nuove funzioni, di crediti e di visibilità sui suoi canali. 🔗 fonte
Modelli, media e ricerca
- MiniMax H3 — Cento giorni dopo la pubblicazione dei suoi pesi, MiniMax rivendica 1 472 modelli derivati e oltre 148 milioni di download su Hugging Face, dati non verificati; H3-Image arriva su fal, Runware, EvoLink e Miora, gratuito su quest’ultimo fino al 17 novembre. 🔗 fonte
- Voxtral Transcribe 3 ad AI Engineer Paris — Mistral ha trascritto in diretta tutte le conferenze del palco principale, fornendo al modello i nomi dei relatori e i termini del programma (bias di contesto), senza indicare dati sul miglioramento ottenuto. 🔗 fonte
- Voce in locale in Google AI Edge Gallery — L’applicazione introduce il riconoscimento e la sintesi vocale offline: su Android, ML Kit trascrive oltre 100 lingue dieci volte più velocemente del tempo reale, e modelli aperti come Parakeet-TDT 0.6B o Kokoro-82M coprono le altre piattaforme. 🔗 fonte
- Déjà View di NVIDIA — Questo modello di ricostruzione 3D da 117M parametri applica più volte uno stesso blocco transformer ed eguaglia modelli fino a 10 volte più grandi su cinque benchmark; presentato in una sessione orale a NeurIPS 2026, l’articolo è su arXiv da maggio. 🔗 fonte
- Malattie nei testi medici spagnoli — OpenMed pubblica due modelli aperti sotto Apache-2.0, utilizzabili su CPU; secondo il team, il fine-tuning su DisTEMIST porta il punteggio F1 da valori compresi tra circa 36 e 39 per un modello generico a circa 73 per la versione GLiNER2.5. 🔗 fonte
- Pagamenti degli agenti x402 — Lasciati da soli, Qwen3 235B, DeepSeek V4 Pro e Llama 3.3 70B ottengono 59, 55 e 30 punti all’esame di Fizzl, senza che nessuno lo superi; quando è il codice a decidere il pagamento (x402-safe-fetch), salgono a 94, 100 e 94. 🔗 fonte
- GR00T-X-Embodiment-Sim in FiftyOne — Harpreet Sahota (Voxel51) converte 42 episodi simulati del dataset di NVIDIA, sei per ciascuno di sette corpi di robot, con dati delle telecamere e telemetria delle articolazioni allineati. 🔗 fonte
Ecosistema
- Sakana AI — L’ammiraglio in pensione Michael Rogers, ex direttore della NSA, e Tom Moran, con quasi 30 anni alla CIA, diventano consulenti senior della startup di Tokyo per la difesa e la cybersicurezza. 🔗 fonte
- Riciclo in NVIDIA — Per la COP31, NVIDIA presenta quattro startup del suo programma Inception che smistano i rifiuti tramite visione artificiale, tra cui Greyparrot, che riduce da 375 a 6 ore il controllo di 15 tonnellate di rifiuti; nessun nuovo prodotto NVIDIA. 🔗 fonte
- Guida di Perplexity alla conformità dell’IA — Passa in rassegna l’AI Act europeo, il NIST AI RMF e l’ISO/IEC 42001, e propone tre controlli per gli agenti: accesso allo stretto necessario, registrazione di ogni azione e convalida umana delle azioni ad alto impatto. 🔗 fonte
- Guida di Perplexity all’architettura MCP — Ruoli dell’host, del client e del server, messaggi JSON-RPC 2.0, trasporti locali e Streamable HTTP, configurazione multi-tenant: una presentazione tecnica che segue la guida alla sicurezza del 4 novembre, senza annunci di prodotto. 🔗 fonte
- Hackathon Cohere a Toronto — Cohere organizza il 30 gennaio 2027 il suo primo hackathon con l’Università di Toronto, Hacking Higher Ed, sull’IA nell’istruzione superiore; premi di 3 000, 2 000 e 1 000 dollari, candidature fino al 22 gennaio. 🔗 fonte
Cosa significa
Google DeepMind applica i suoi modelli a due problemi in cui la verifica conta più della generazione. AlphaGenome 2 non si limita più a una media per tessuto: prevede l’effetto di una variante nella cellula di interesse per il ricercatore, e i suoi miglioramenti si misurano su TenK10K, una mappa di 28 tipi di cellule immunitarie. AlphaProof Code sposta la verifica formale dalla progettazione del protocollo al codice compilato, con una ripartizione esplicita del lavoro: gli agenti scrivono oltre sei milioni di righe di dimostrazione, il verificatore Lean controlla ogni passaggio e gli esseri umani rivedono le specifiche e circa l’1 % del codice. Entrambi gli annunci mantengono i propri limiti: AlphaGenome 2 resta riservato alla ricerca, e il primato su Signal è rivendicato da Google DeepMind.
La sicurezza si scontra con i propri strumenti di misurazione. OpenAI constata che la catena di ragionamento, uno dei pilastri del suo monitoraggio, diventa più difficile da leggere con il progredire del pretraining, e considera essa stessa soggetta a rumore la controllabilità, uno dei suoi due indicatori. Perplexity mostra che il formato classico del capture the flag distoglie gli agenti dal limite da testare, e che un modello specializzato in cybersicurezza può ottenere risultati peggiori della sua versione generalista, su tre prove e con una configurazione precedente alla correzione. In entrambi i casi, la conclusione riguarda tanto il modo di valutare quanto i modelli stessi.
La giornata distingue nettamente ciò che viene reso disponibile da ciò che viene annunciato. Runway pubblica Praxis-1 con i suoi pesi, il codice di fine-tuning e un rapporto che colloca il modello al di sotto di quattro proposte concorrenti, e Tether rende BotPsy scaricabile. Al contrario, Qwen4-Max arriva senza benchmark, dimensioni né prezzi, ed ElevenLabs distingue essa stessa ciò che è disponibile oggi (Marketplace, Partner Program, ElevenAI) da ciò che arriverà più avanti (Interaction Engine, Memory, Routines, fine-tuning). Per chi vuole fare delle prove, la seconda metà resta una promessa.
Gli agenti si inseriscono stabilmente nel lavoro e nei team. Grok Bot 1.0 partecipa alle riunioni e si coordina con altri Bot in Slack e Teams; i Cloud Runners di Delta mantengono attivo un thread dell’agente senza il computer del suo autore; VS Code aggiunge una casella di posta per le sessioni in attesa di una decisione; A2UI consente agli agenti di rispondere con una schermata anziché con del testo. Ciascuno limita anche il rischio che introduce: autorizzazioni per persona e verifica prima di intervenire in un canale pubblico per Grok Bot, anteprima privata per Delta, autorizzazioni mirate e variabili nascoste nella sandbox di VS Code.
Fonti
- AlphaGenome 2 (Google DeepMind)
- AlphaGenome 2 (@GoogleDeepMind)
- Presentazione di AlphaProof Code (Google DeepMind)
- Verifica formale di Signal (PDF, Google DeepMind)
- Qwen4-Max in anteprima (@Alibaba_Qwen)
- Token Plan (QwenCloud)
- Praxis-1 è ora disponibile (Runway)
- Rapporto tecnico di Praxis-1 (Runway)
- Raccolta Praxis-1 (Hugging Face)
- ElevenLabs Summit NYC (ElevenLabs)
- Annunci del Summit (@ElevenLabs)
- ElevenLabs e NVIDIA (ElevenLabs)
- Ripristino completo dei limiti (@ClaudeDevs)
- Grok Bot 1.0 (SpaceXSI)
- Grok Bot 1.0 (@SpaceXSI)
- Ritiro delle voci Advanced e Standard in ChatGPT (assistenza OpenAI)
- Ritiro delle voci Advanced e Standard (@OpenAINewsroom)
- Gemini su Apple CarPlay (blog.google)
- Monitorabilità della CoT durante il ciclo di vita del modello (OpenAI)
- Thread di Jeffrey G. Wang
- Fuggire da SPACE: parte II (Perplexity)
- Fuggire da SPACE: parte II (@perplexity_ai)
- Gemini Decision 1 (Google AI Studio)
- Decisions API (Google AI Studio)
- A2UI 1.0 (Google Developers Blog)
- I Cloud Runners sono ora disponibili in Delta
- Documentazione dei Cloud Runners (Delta)
- Note di rilascio di VS Code 1.146
- Qwen Code v1.0.0-preview (GitHub)
- BotPsy (QVAC su Hugging Face)
- Modello qvac/BotPsy-0.8B (Hugging Face)
- Addestramento che tiene conto del Token Pooling (Hugging Face)
- Seedance 2.5 in 4K (@pika_labs)
- Seedance 2.5 in 4K (@runwayml)
- Annunciate vulnerabilità di sicurezza in Git (GitHub Blog)
- Zed v1.28.1 (GitHub)
- Changelog di Antigravity
- Gemini CLI, PR 30228 (GitHub)
- Copilot CLI v1.0.110-1 (GitHub)
- Gemini 4 Carbon in Genspark (@genspark_ai)
- Basis e Devin for Startups (@cognition)
- Ora il tuo LLM è un container (Hugging Face)
- Gestione delle licenze Copilot tramite le GitHub Apps (GitHub Changelog)
- Gli avvisi Dependabot verranno sospesi sui repository inattivi (GitHub Changelog)
- Tipi e campi delle issue per gli account personali (GitHub Changelog)
- Una dashboard di GitHub più informativa (GitHub Changelog)
- Singapore Airlines (OpenAI)
- Cogent Security (OpenAI)
- JioStar, Vijay Seshadri (OpenAI)
- ChatGPT Plus per i veterani (OpenAI)
- Plugin fal in ChatGPT (@fal)
- Gopuff in Grok Bot (@bot)
- Genspark Genius (@genspark_ai)
- MiniMax H3, 100 giorni (@RyanLeeMiniMax)
- Voxtral Transcribe 3 ad AI Engineer Paris (@MistralAI)
- Voce in locale in Google AI Edge Gallery (Google Developers Blog)
- Déjà View (@NVIDIAAI)
- Individuare malattie nei testi clinici spagnoli (OpenMed)
- Modelli di IA aperti con un portafoglio (Fizzl)
- GR00T-X-Embodiment-Sim in FiftyOne (Hugging Face)
- Michael Rogers e Tom Moran (Sakana AI)
- Startup del riciclo basate sull’IA (blog NVIDIA)
- Conformità dell’IA (Perplexity)
- Architettura MCP (Perplexity)
- Hacking Higher Ed (@cohere)