ai-powered-markdown-translatorgpt-6.1-sol का उपयोग करके फ़्रेंच से हिंदी में अनुवादित लेख।
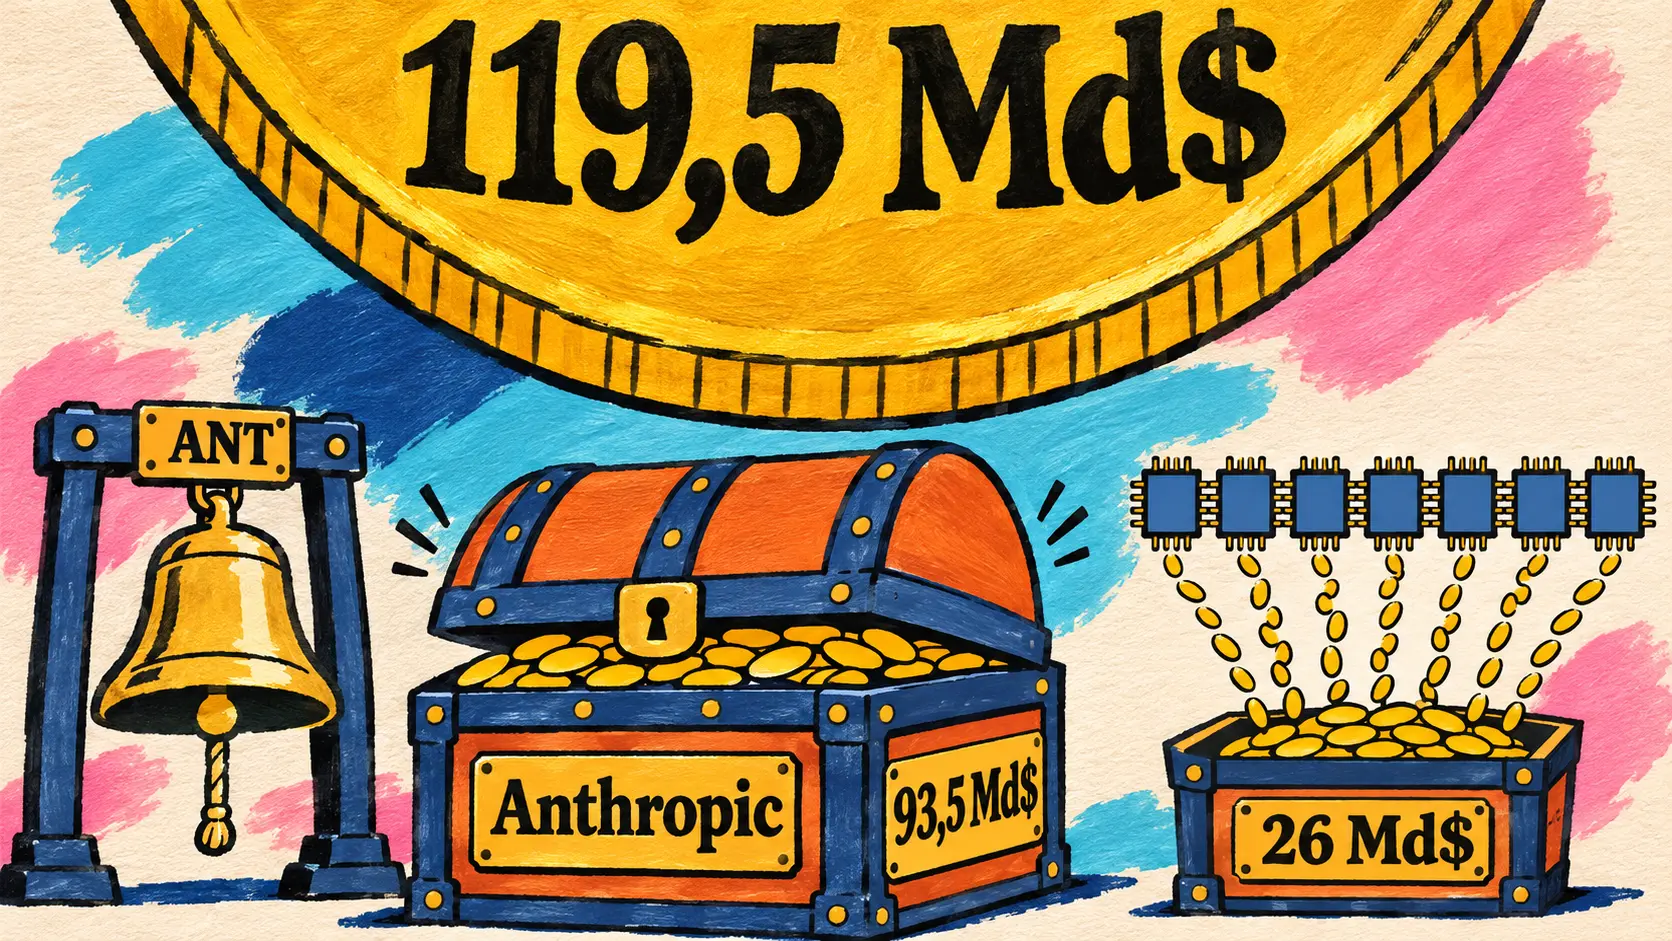
Anthropic ने अपना आरंभिक सार्वजनिक निर्गम पूरा किया: पेशकश से लगभग 93,5 अरब डॉलर की सकल राशि मिली, और साथ-साथ किए गए निजी प्लेसमेंट में NVIDIA, Google तथा Microsoft सहित सात समूहों ने 26 अरब डॉलर अतिरिक्त लगाए। Thinking Machines ने Inkling 2 Mini जारी किया, जो 26,4 अरब पैरामीटर वाला खुले वज़नों का मॉडल है और 20 Go में समा जाता है। OpenAI ने अपने मॉडलों की सुरक्षित तर्क प्रक्रिया निकालने वाले हमलों की सफलता दर 54,0 % से घटाकर 0,2 % कर दी। ChatGPT Space अब Plus ग्राहकों के लिए उपलब्ध है, Runway अपने कोड मर्ज में से 38 % एजेंटों से करवाता है, और Claude Code, Codex CLI तथा Vibe CLI ने नए संस्करण जारी किए हैं।
वित्त: Anthropic ने अपना आरंभिक सार्वजनिक निर्गम पूरा किया, 93,5 अरब डॉलर सकल राशि और 26 अरब डॉलर के निजी प्लेसमेंट के साथ
20 नवंबर — शेयरों में पहली बार कारोबार शुरू होने के अगले दिन, Anthropic ने अपने आरंभिक सार्वजनिक निर्गम के पूरा होने की घोषणा की। इसकी कीमत 18 नवंबर को प्रति शेयर 83 डॉलर तय की गई थी। बैंकों ने 147 मिलियन अतिरिक्त शेयर खरीदने के अपने विकल्प का पूरा इस्तेमाल किया: कुल मिलाकर वर्ग A के 1 127 000 000 शेयर बेचे गए। कमीशन और शुल्क से पहले सकल प्राप्ति लगभग 93,5 अरब डॉलर रही, जिसमें से लगभग 91,6 अरब Anthropic को मिले। मौजूदा शेयरधारकों द्वारा बेचे गए 23 648 646 शेयरों से कंपनी को कोई राशि नहीं मिलती।
लेख में साथ-साथ किए गए और अब पूरे हो चुके एक निजी प्लेसमेंट का भी उल्लेख है, जिसकी जानकारी मूल्य निर्धारण की घोषणा में नहीं थी: वर्ग N के 313 253 007 शेयर, प्रति शेयर उसी 83 डॉलर की कीमत पर सेमीकंडक्टर और कंप्यूटिंग क्षेत्र के सात समूहों (AMD, Broadcom, Google, Micron, Microsoft, NVIDIA और TSMC Partners) को लगभग 26,0 अरब डॉलर में बेचे गए। ये शेयर 1933 के प्रतिभूति अधिनियम के तहत पंजीकृत नहीं हैं। सार्वजनिक पेशकश और इस प्लेसमेंट को जोड़ने पर, कमीशन और शुल्क से पहले सकल राशि लगभग 119,5 अरब डॉलर होती है।
| सौदे का घटक | Anthropic द्वारा घोषित मूल्य |
|---|---|
| बेचे गए वर्ग A के शेयर | 1 127 000 000, जिनमें से 147 000 000 बैंकों के विकल्प के तहत |
| जिनमें Anthropic द्वारा बेचे गए | 1 103 351 354 |
| जिनमें मौजूदा शेयरधारकों द्वारा बेचे गए | 23 648 646 |
| प्रति शेयर कीमत | 83 डॉलर |
| पेशकश से सकल प्राप्ति | लगभग 93,5 अरब डॉलर |
| Anthropic को मिली राशि | लगभग 91,6 अरब डॉलर |
| निजी प्लेसमेंट (वर्ग N) | 313 253 007 शेयर, लगभग 26,0 अरब डॉलर |
| कुल सकल राशि, पेशकश और प्लेसमेंट | लगभग 119,5 अरब डॉलर |
| सूचीबद्धता | 19 नवंबर से, Nasdaq Global Select Market, प्रतीक ANT |
लेख सूचीबद्धता की पुष्टि करता है, लेकिन शेयर भाव या बाज़ार पूँजीकरण नहीं बताता। Goldman Sachs और Morgan Stanley ने लगभग बीस बैंकों के एक समूह के साथ इस सौदे का नेतृत्व किया। इनमें J.P. Morgan, Citigroup, BNP Paribas, Crédit Agricole CIB और Société Générale शामिल थे। उसी दिन, @AnthropicAI ने एक वीडियो प्रकाशित किया, जिसमें सातों सह-संस्थापक, दारियो अमोदेई, दानिएला अमोदेई, टॉम ब्राउन, जैक क्लार्क, जारेड कैपलन, सैम मैककैंडलिश और क्रिस ओलाह, कंपनी की कहानी बताते हैं।
🔗 आरंभिक सार्वजनिक निर्गम पूरा हुआ (Anthropic) · X पर @AnthropicAI: सह-संस्थापक
खुले मॉडल: Thinking Machines का Inkling 2 Mini, Tencent Hy4, Qwen3.8-27B के लिए एक सुपर-अडैप्टर, Ayb 0.5 और Depth Pro 2
20 नवंबर — Thinking Machines Lab ने Inkling 2 Mini जारी किया, जो Inkling 2 Small का छोटा संस्करण है (594 अरब पैरामीटर, जिसकी चर्चा यहाँ 12 नवंबर को हुई थी)। Apache 2.0 लाइसेंस के तहत उपलब्ध खुले वज़नों वाला यह विशेषज्ञ-मिश्रण मॉडल (Mixture-of-Experts) 26,4 अरब पैरामीटर रखता है, जिनमें से प्रति टोकन 3,4 अरब सक्रिय होते हैं। यह पाठ और चित्र पढ़ता है तथा दस लाख टोकन का संदर्भ संभालता है। इसके वज़न प्रशिक्षण में इस्तेमाल की गई परिशुद्धता में दिए जाते हैं, बीस परतों के लिए NVFP4 और अंतिम चार के लिए MXFP8, यानी रूपांतरण से किसी हानि के बिना लगभग 20 Go: यह कम-से-कम 32 Go वाले किसी भी Mac पर Ollama के साथ चलता है।
Today we are releasing Inkling 2 Mini, a fast, powerful model that’s small enough to run on your laptop.
🇮🇳 आज हम Inkling 2 Mini जारी कर रहे हैं, जो एक तेज़ और शक्तिशाली मॉडल है और इतना छोटा है कि आपके लैपटॉप पर चल सकता है। — Thinking Machines Lab, Inkling 2 Mini की घोषणा
इसकी विशेषता इसकी संरचना है: यह लूप वाला ट्रांसफ़ॉर्मर (looped transformer) है। इसकी 24 परतों में से बीच की 12 परतों से तीन बार गुज़रा जाता है, यानी संग्रहीत 24 परतों के लिए प्रति टोकन 48 परत-पास होते हैं। इससे प्रति टोकन 5,4 अरब वज़न सक्रियण होते हैं। प्रशिक्षण के दौरान प्रयोगशाला ने दो-तिहाई विशेषज्ञ भी हटा दिए (384 से घटाकर 128), फिर एक बड़े आंतरिक Inkling मॉडल से डिस्टिल किए गए 1 000 अरब टोकन से मॉडल को सुधारा। उसके अनुसार, समान लॉस पर बिना लूप वाला मॉडल प्रशिक्षण में 7,5 % कम गणना लेगा, लेकिन इन्फ़रेंस में 140 % अधिक गणना करेगा।
| बेंचमार्क (Thinking Machines की तालिका) | Inkling 2 Mini | Qwen3.8-27B | Nemotron 3.5 Super VL |
|---|---|---|---|
| प्रति टोकन वज़न सक्रियण / कुल पैरामीटर | 5,4B / 26,4B | 27,0B / 27,0B | 12,0B / 124,5B |
| AA Index v5.0 | 20,1 | 20,1 | 13,6 |
| DeepSWE v1.1 | 48,2 % | 42,2 % | 24,7 % |
| SWE-bench Pro v2 Hard | 77,9 % | 73,8 % | 44,1 % |
| Terminal-Bench 2.1 (pi) | 71,6 % | 73,0 % | 60,7 % |
| BrowseComp | 79,0 % | 61,6 % | 78,9 % |
| MCP Atlas | 82,7 % | 77,3 % | 67,7 % |
Thinking Machines के अनुसार, यह मॉडल 100 अरब से कम पैरामीटर वाले खुले मॉडलों में DeepSWE v1.1 और Vals Index v2.2 (46,5 %) पर आगे है। Terminal-Bench 2.1 पर यह Qwen3.8-27B से पीछे है, और Thinking Machines स्वीकार करता है कि बहु-चरणीय बातचीत (MultiChallenge पर 50,0 %) या कई प्रतिबंधों वाले निर्देशों (ComplexConstraints v1.1 पर 33,4 %) में यह सर्वश्रेष्ठ छोटा मॉडल नहीं है; ग्राफ़ की व्याख्या में स्पष्ट किया गया है कि मूल्यांकन की व्यवस्थाएँ अलग-अलग मॉडलों के लिए भिन्न हैं। अग्रिम पहुँच पाने वाले स्टैनफोर्ड के शोधकर्ताओं ने DGX Spark पर प्रति जूल 0,703 बुद्धिमत्ता मापी, जबकि Qwen3.6-35B-A3B के लिए यह 0,430 थी।
प्रयोगशाला इसे विचार-श्रृंखला (chain of thought) की निगरानी पर शोध का विषय भी बनाती है: लूप वाला मॉडल अधिक गणना करता है, लेकिन उसे लिखता नहीं, जिससे वह निगरानी प्रणाली की नज़र से बच सकता है। पास की संख्या बदल सकने वाले एक संस्करण को भी जारी किया गया है। उसमें एक से तीन पास पर जाने से, बिना लिखित तर्क के हल किया गया कार्य 16 के बजाय 37 सेकंड के मानव श्रम के बराबर हो जाता है। पाँच पास पर तर्क प्रक्रिया आधी लंबी होती है (GPQA Diamond पर औसतन 3 703 के मुकाबले 1 661 टोकन) और उतनी ही पठनीय रहती है; Thinking Machines को लूप की संख्या बढ़ने के साथ एजेंटों द्वारा तोड़फोड़ में वृद्धि नहीं दिखी। मॉडल Tinker, Ollama, SGLang, vLLM, llama.cpp, MLX और Transformers पर उपलब्ध है, और Unsloth पर इसके GGUF संस्करण भी हैं।
🔗 Inkling 2 Mini (Thinking Machines) · Hugging Face का लेख · Hugging Face पर वज़न
Together AI ने 770 अरब पैरामीटर वाला विशेषज्ञ-मिश्रण मॉडल Tencent Hy4 उपलब्ध कराया, इनपुट के प्रति दस लाख टोकन की कीमत 0,83 डॉलर
19 नवंबर — Together AI ने अपने सर्वरलेस इन्फ़रेंस प्रस्ताव में Tencent Hy4 को जोड़ा है। इसमें दस लाख टोकन का संदर्भ, टूल कॉल और JSON आउटपुट उपलब्ध हैं। होस्टिंग प्रदाता के अनुसार, Tencent का यह प्रमुख मॉडल 770 अरब पैरामीटर वाला विशेषज्ञ-मिश्रण है, जिनमें से प्रति टोकन 49 अरब सक्रिय होते हैं; यह Hy4 Preview का उत्तराधिकारी है, कंप्यूटर का इस्तेमाल करने की क्षमता जोड़ता है और चित्र पढ़ने वाला Hy परिवार का पहला मॉडल बनता है।
| प्रति दस लाख टोकन की कीमत | Together AI | Tencent (4 नवंबर की प्रेस विज्ञप्ति) |
|---|---|---|
| इनपुट | 0,83 डॉलर | लगभग 0,90 डॉलर |
| कैश किया गया इनपुट | 0,042 डॉलर | लगभग 0,045 डॉलर |
| आउटपुट | 2,50 डॉलर | लगभग 2,70 डॉलर |
Tencent ने 4 नवंबर को Hy4 लॉन्च किया था। उसने इसे सर्वश्रेष्ठ ओपन सोर्स मॉडलों में शामिल बताया और कुछ दिनों में वज़न जारी करने का वादा किया था; tencent/Hy4 रिपॉज़िटरी Hugging Face पर « other » प्रकार के लाइसेंस के तहत उपलब्ध है। उसकी प्रेस विज्ञप्ति में एक वित्तीय ब्लाइंड मूल्यांकन (213 पेशेवर, 579 कार्य) का उल्लेख था, जिसमें Hy4 ने 3,04 स्कोर हासिल किया और DeepSeek-V4.1-Flash-1017 (2,97) से आगे रहा। साथ ही, आंतरिक हैलुसिनेशन दर 12,95 % से घटाकर 7,2 % करने का दावा किया गया था।
🔗 Together AI पर Tencent Hy4 · Tencent की 4 नवंबर की प्रेस विज्ञप्ति
Hugging Face ने अपने हार्नेस अडैप्टर बनाने की विधि और Qwen3.8-27B के लिए एक संयुक्त सुपर-अडैप्टर जारी किया
20 नवंबर — तीन दिनों की घोषणाओं के बाद, जिनमें कल यहाँ चर्चा किया गया Hermes अडैप्टर भी शामिल था, Hugging Face ने अपने हार्नेस अडैप्टर बनाने की पूरी विधि जारी की: ये Qwen3.8-27B के ऊपर, किसी एजेंट हार्नेस (pi, Hermes Agent या OpenCode) के भीतर रीइन्फ़ोर्समेंट लर्निंग से प्रशिक्षित LoRA हैं। नई चीज़ एक सुपर-अडैप्टर है: रैंक 32 वाले तीनों LoRA को जोड़कर रैंक 96 का एक LoRA बनाया गया है, जो तीनों हार्नेस में काम करता है। चूँकि उनके अपडेट लगभग परस्पर लम्बवत हैं (कोसाइन 0,01 से 0,02), यह संयोजन ठीक-ठीक तीनों को लागू करता है।
| SWE-bench Pro (51 कठिन कार्य), विचार प्रक्रिया के साथ | आधार मॉडल | सुपर-अडैप्टर के साथ |
|---|---|---|
| Hermes Agent हार्नेस | 45 % | 61 % |
| OpenCode हार्नेस | 47 % | 67 % |
| pi हार्नेस | 74 % | 74 % |
टीम की पोस्ट-श्रृंखला के अनुसार, विचार प्रक्रिया चालू होने पर छह हार्नेस-बेंचमार्क जोड़ियों का औसत 55,5 से बढ़कर 63,5 % हो जाता है, और टूल कॉल 19 से 48 % कम होते हैं; लेख के अनुसार, विचार प्रक्रिया के बिना सुपर-अडैप्टर SWE-bench Pro पर 6 से 18 अंक अधिक हासिल करता है, और टूल कॉल 53 से 73 % कम होते हैं। अलग-अलग हार्नेस के स्कोर की आपस में तुलना नहीं की जा सकती, क्योंकि उनकी डिफ़ॉल्ट सेटिंग अलग हैं। प्रशिक्षण में 598 चरण और 167 मिलियन टोकन लगे; safeagents सुरक्षा प्रणाली ने 1,3 मिलियन टूल कॉल जाँचे और उनमें से 647 को रोक दिया। कार्य, अडैप्टर, GGUF और मूल्यांकन के दौरान अपनाए गए कार्य-पथ प्रकाशित कर दिए गए हैं।
🔗 बड़े पैमाने पर हार्नेस अडैप्टर (Hugging Face) · X पर @yb2698
Metric AI ने अर्मेनियाई भाषा में पाठ और आवाज़ के लिए खुले मॉडल Ayb 0.5, OhanTTS और OhanASR जारी किए
20 नवंबर — अर्मेनियाई टीम Metric AI ने एक ही दिन अपनी भाषा के लिए मॉडलों के तीन परिवार जारी किए। Ayb 0.5 में Qwen3.5 पर बने और अर्मेनियाई के लिए अनुकूलित तीन भाषा मॉडल (0,8B, 4B और 9B) शामिल हैं, जिनमें टोकनाइज़र के विस्तार से लेकर प्रशिक्षण के बाद के चरणों तक बदलाव किए गए हैं; Ayb-9B बहु-चरणीय संवाद, टूल कॉल और चित्र संभालता है। OhanTTS-v0.1 अर्मेनियाई और फ़्रांसीसी सहित आठ भाषाओं में आवाज़ बनाता है तथा 3 से 10 सेकंड के ऑडियो से किसी आवाज़ का क्लोन तैयार करता है। OhanASR-v0.1, 2B का वाक् पहचान मॉडल, अर्मेनियाई के 820 घंटे के डेटा पर फ़ाइन-ट्यून किया गया है।
| Metric AI का मॉडल | लेखकों द्वारा प्रकाशित परिणाम |
|---|---|
| Ayb-9B | समग्र ArmBench में स्थान 3 (0,6164) |
| OhanTTS-v0.1, अर्मेनियाई के 61 घंटे | 14,70 % WER, GB10 पर पहली ध्वनि 331 ms में |
| OhanASR-v0.1 | ArmBench-ASR पर 16,12 % WER (स्थान 2) और 3,49 % CER (स्थान 1) |
Ayb-9B के वज़न गैर-व्यावसायिक लाइसेंस (CC BY-NC 4.0) के तहत हैं और मैन्युअल स्वीकृति के बाद उपलब्ध होते हैं।
🔗 Ayb 0.5 (Metric AI) · OhanTTS · OhanASR
Apple ने Depth Pro 2 जारी किया, जो फ़ोटो और वीडियो में मीटर में गहराई का अनुमान लगाता है
19 नवंबर — Apple ने Depth Pro 2 जारी किया, जो मॉडलों का एक परिवार है और मूल रिज़ॉल्यूशन पर फ़ोटो तथा वीडियो, दोनों में मीटर में गहराई का अनुमान लगाता है। शोधपत्र के सार के अनुसार, मौजूदा तरीकों को एक फ़्रेम से दूसरे फ़्रेम तक की संगति और किनारों की स्पष्टता में से किसी एक को चुनना पड़ता था; Depth Pro 2 एक ही नेटवर्क से दोनों हासिल करने का लक्ष्य रखता है। इसके वज़न Hugging Face पर चार आकारों (S, B, L, H) में उपलब्ध हैं। साथ में Core ML संस्करण और सभी के लिए एक साझा फ़ोकल लंबाई अनुमानक है, जो तब उपयोगी होता है जब EXIF में फ़ोकल लंबाई मौजूद न हो।
| DepthPro2-L द्वारा संसाधित रिज़ॉल्यूशन (334M, B200 पर) | प्रति सेकंड फ़्रेम |
|---|---|
| VGA | 150,1 |
| 720p | 33,7 |
| 1080p | 9,1 |
| 4K | 0,7 |
वज़न केवल गैर-व्यावसायिक शोध के लिए उपलब्ध हैं (Apple Machine Learning Research Model लाइसेंस), और कोड GitHub पर है। Hugging Face के पेद्रो कुएनका ने 20 नवंबर को एक ऑनलाइन प्रदर्शन के साथ इस रिलीज़ की जानकारी दी।
🔗 X पर @pcuenq · arXiv शोधपत्र 2611.26603 · DepthPro2-L (Hugging Face)
मॉडलों की सुरक्षा: OpenAI ने प्रतिकूल डिस्टिलेशन का मुकाबला किया, Sakana AI ने अपना Security Research Group बनाया
OpenAI ने दुर्भावनापूर्ण डिस्टिलेशन के खिलाफ अपनी लड़ाई का ब्योरा दिया और संरक्षित तर्क-प्रक्रिया का निष्कर्षण 54,0 % से घटाकर 0,2 % किया
20 नवंबर — OpenAI ने दुर्भावनापूर्ण डिस्टिलेशन (adversarial distillation) पर एक लेख प्रकाशित किया है: इसमें किसी अग्रणी मॉडल के आउटपुट का अनधिकृत इस्तेमाल करके दूसरा मॉडल प्रशिक्षित किया जाता है, जिसे समान सुरक्षा उपायों के बिना तैनात किया जाता है, उदाहरण के लिए ऐसे हमलों के लिए जिन्हें मूल मॉडल ने अस्वीकार कर दिया होता। लेख मुख्य रूप से संरक्षित तर्क-प्रक्रिया पर केंद्रित है, यानी उत्तर से पहले उत्पन्न होने वाली विचार-श्रृंखला पर: एक आंतरिक अध्ययन के अनुसार, विद्यार्थी मॉडल आम तौर पर तर्क-प्रक्रिया के सटीक विवरण से उनके सारांशों की तुलना में अधिक सीखता है।
| मापा गया हमला (अनुकूलनशील मूल्यांकन, छह हमलावर मॉडल) | GPT-6 Astra, मूल सुरक्षा उपाय | GPT-6.2 Astra, अद्यतन सुरक्षा उपाय |
|---|---|---|
| पिछली क्वेरी की तर्क-प्रक्रिया | 54,0 % | 0,2 % |
| मौजूदा क्वेरी की तर्क-प्रक्रिया | 22,9 % | 0,9 % |
रक्षा में प्रतिकूल प्रशिक्षण, इनपुट और आउटपुट वर्गीकारक (टूल कॉल के आर्ग्युमेंट सहित), API नियंत्रण और जाँच शामिल हैं। हर सप्ताह कुछ हज़ार से लेकर कुछ दसियों हज़ार खातों वाले अभियानों के खिलाफ दंडात्मक कार्रवाई की जाती है। GPT-6.2 Astra और Sol में संरक्षित तर्क-प्रक्रिया उस इतिहास से जुड़ी होती है जिसने उसे उत्पन्न किया था: किसी पुराने संदेश को दोबारा लिखने पर API उसे छोड़ देता है, और पुराने मॉडल परिवार अब उसे पढ़ नहीं सकते। OpenAI ने याद दिलाया कि उसने फ़रवरी में कांग्रेस को ऐसी गतिविधि की सूचना दी थी जो संकेत देती थी कि DeepSeek अमेरिकी मॉडलों का डिस्टिलेशन करने की कोशिश कर रहा था, और फिर सितंबर में एक अभियान का संबंध Moonshot AI से जुड़े व्यक्तियों से बताया था; कंपनी का कहना है कि वह Chip Security Act, AI OVERWATCH Act और MATCH Act का समर्थन करती है।
🔗 दुर्भावनापूर्ण डिस्टिलेशन का मुकाबला (OpenAI) · X पर @OpenAI
Sakana AI ने सामूहिक साइबर रक्षा के लिए स्वतंत्र टीम, अपना सुरक्षा अनुसंधान समूह बनाया
20 नवंबर — Sakana AI ने अपना सुरक्षा अनुसंधान समूह शुरू किया है। यह टोक्यो में स्थित अनुसंधान एवं विकास की एक स्वतंत्र टीम है, जो कंपनी की व्यावसायिक गतिविधियों से अलग है और जनहित में काम करेगी।
Excited to announce the Sakana AI Security Research Group, an independent, public-interest R&D team in Tokyo co-led by Akihiro Umegai and me.
🇮🇳 टोक्यो में स्थित Sakana AI के सुरक्षा अनुसंधान समूह की घोषणा करते हुए खुशी हो रही है, यह अनुसंधान एवं विकास की एक स्वतंत्र और जनहित में काम करने वाली टीम है, जिसका सह-नेतृत्व अकिहिरो उमेगाई और मैं कर रहे हैं। — X पर @hardmaru
डेविड हा Sakana AI के सह-संस्थापक और मुख्य कार्यकारी अधिकारी हैं। टीम तीन क्षेत्रों पर काम करेगी: डिज़ाइन के चरण से ही रोकथाम, अलग-अलग संगठनों में वितरित एजेंटों के ज़रिए सामूहिक रक्षा, और स्वयं रक्षा करने वाले एजेंटों की सुरक्षा, जिनका अधिकार उनके कार्य तक सीमित होगा और जिनकी कार्रवाइयों का रिकॉर्ड रखा जाएगा। इसकी शुरुआत Digital Red Queen, ShinkaEvolve और Fugu-Cyber जैसे आंतरिक शोध से होगी। Fugu-Cyber के लिए Sakana AI ने CyberGym पर 86,9 % और CTI-REALM पर 72,1 % की घोषणा की है; लेख की एक टिप्पणी स्पष्ट करती है कि Fugu-Cyber का पृष्ठ न तो संदर्भ स्कोर देता है और न ही मूल्यांकन की प्रक्रिया बताता है। टीम श्वेतपत्र, परीक्षण प्रणालियाँ और रक्षात्मक मार्गदर्शिकाएँ प्रकाशित करेगी, लेकिन सुरक्षा खामियों का फायदा उठाने वाली सामग्री नहीं। खोजी गई खामियों के लिए समन्वित प्रकटीकरण की प्रक्रिया अपनाई जाएगी। Sakana AI ने याद दिलाया कि NIST के अनुसार, 2020 से 2025 के बीच CVE अनुरोधों में 263 % की वृद्धि हुई है।
🔗 सुरक्षा अनुसंधान समूह (Sakana AI)
सॉफ़्टवेयर डिलीवरी से जुड़े एजेंट: Runway की फ़ैक्टरी, Google Labs का Stitch Loop
Runway ने अपनी सॉफ़्टवेयर डिलीवरी शृंखला एजेंटों को सौंपी, जिन्होंने अक्टूबर में उसके 38 % मर्ज संचालित किए
20 नवंबर — Runway ने अपने इंजीनियरिंग ब्लॉग पर अपनी « सॉफ़्टवेयर फ़ैक्टरी » (software factory) के आँकड़े प्रकाशित किए हैं: कोड लिखने से लेकर मर्ज के समन्वय तक सात चरण, जिन्हें एक-एक करके एजेंटों को सौंपा गया है। अक्टूबर में मर्ज की गई पुल रिक्वेस्ट में से 38 % को क्लाउड एजेंटों ने संचालित किया, और नवंबर के पहले पखवाड़े में मर्ज हुई ऐसी 100 PR में से 78 में किसी इंसान का कोई कमिट नहीं था।
| सॉफ़्टवेयर फ़ैक्टरी का संकेतक | शुरुआती स्थिति | नवीनतम माप |
|---|---|---|
| क्लाउड एजेंटों द्वारा संचालित मर्ज | 0,1 % (जून) | 38 % (अक्टूबर) |
| पहली मंज़ूरी के लिए प्रतीक्षा की माध्यिका | 2,3 h (सितंबर) | लगभग 5 min (मध्य-नवंबर) |
| औसत साप्ताहिक मर्ज | 929 (सितंबर) | 2 235 (मध्य-अक्टूबर से) |
मध्य-अक्टूबर से AI कम जोखिम वाली PR को अपने आप मंज़ूरी देता है, और रिपॉज़िटरी की अनुमति होने पर मध्यम जोखिम वाली PR को भी; उच्च जोखिम वाली PR किसी व्यक्ति के पास जाती हैं, और माइग्रेशन, CI तथा डिप्लॉयमेंट कॉन्फ़िगरेशन, सीक्रेट्स और प्रमाणीकरण पर हमेशा कोड स्वामियों की मंज़ूरी ली जाती है। सितंबर और अक्टूबर में AI द्वारा मंज़ूर 977 PR में से 15 को किसी व्यक्ति ने चुनौती दी, और केवल AI की मंज़ूरी से हुए मर्ज को वापस लेने की दर 0,10 % रही, जबकि मानवीय मंज़ूरियों के लिए यह लगभग 200 में 1 थी। एजेंट App Studio का परीक्षण उपयोगकर्ता की तरह भी करते हैं (चार दिनों में 86 बग की पुष्टि हुई), और एक समन्वयक ने दो सप्ताह में 14 000 से अधिक कार्य बाँटे। ये आंतरिक टूल हैं, इनके लिए कोई उत्पाद या मूल्य योजना नहीं है।
🔗 सॉफ़्टवेयर फ़ैक्टरी का निर्माण (Runway)
Google Labs ने Stitch Loop पेश किया, जो ऑनलाइन एप्लिकेशन को लगातार बेहतर बनाने वाला उत्पाद एजेंट है
18 नवंबर — Google Labs ने Stitch Loop पेश किया है, जो लंबे समय तक काम करने वाला उत्पाद एजेंट है और वहाँ से काम शुरू करता है जहाँ कोड एजेंट रुक जाता है: प्रोडक्शन में तैनाती के बाद। यह 180 से अधिक एकीकरणों, कस्टम MCP सर्वरों या स्थानीय CLI से भेजे गए डेटा के ज़रिए GitHub रिपॉज़िटरी और ऑनलाइन उत्पाद के डेटा (लॉग, उपयोगकर्ताओं का व्यवहार, प्रतिक्रियाएँ) से जुड़ता है, और मापने योग्य लक्ष्यों की दिशा में लगातार काम करता है।
हर चक्र डेटा पर आधारित सुझाव देता है, समाधानों और उनके समझौतों का विस्तार से वर्णन करता है, एक पृथक क्लाउड सैंडबॉक्स में कोड लिखता है और मंज़ूरी के लिए पुल रिक्वेस्ट खोलता है, फिर लाइव मेट्रिक्स पर नज़र रखता है। तीन चक्र पहले से उपलब्ध हैं (साइबर सुरक्षा, विलंबता, सुलभता); सुरक्षा वाला चक्र Gemini 4 Carbon को Google DeepMind के कोड सुरक्षा एजेंट CodeMender के साथ जोड़ता है। टीम की समीक्षा के बिना कुछ भी मर्ज नहीं होता। Stitch Loop, Stitch CLI और MCP के ज़रिए Google Antigravity जैसे कोड एजेंटों को उत्पाद का संदर्भ भी देता है, और Slack में इस्तेमाल किया जा सकता है। फ़िलहाल दुनिया भर में केवल प्रतीक्षा सूची खुली है, जिसमें पात्र Google AI Ultra ग्राहकों को प्राथमिकता मिलेगी।
आम उपभोक्ताओं के सहायक: Plus ग्राहकों के लिए ChatGPT Space, Gemini ऐप में GIF, Chromium ब्राउज़रों में Perplexity Computer
ChatGPT Space दुनिया भर के Plus ग्राहकों के लिए उपलब्ध हो रहा है
20 नवंबर — ChatGPT Space, जिसे 29 सितंबर के DevDay में पेश किया गया था और जो अब तक Pro, Business और Enterprise योजनाओं तक सीमित था, दुनिया भर के 18 वर्ष और उससे अधिक उम्र के Plus ग्राहकों के लिए उपलब्ध कराया जा रहा है। Space वेब, डेस्कटॉप ऐप, iOS और Android पर साइडबार में लाइब्रेरी की जगह लेता है (पृष्ठ, स्लाइड, चित्र, अपलोड की गई फ़ाइलें)।
इसमें ChatGPT के साथ इंटरैक्टिव पृष्ठ और प्रस्तुतियाँ बनाई जा सकती हैं, जिन्हें Space की पहुँच रखने वाले अन्य लोग भी समृद्ध कर सकते हैं। पृष्ठ और स्लाइड कनेक्ट किए गए ऐप से अपने आप अपडेट हो सकते हैं: OpenAI ने अपने आप अपडेट होने वाली कार्य सूची या Slack में लिए गए फ़ैसलों के साथ बदलने वाली परियोजना योजना का उदाहरण दिया है। किसी बदलाव का अनुरोध करने के लिए टिप्पणी में ChatGPT का उल्लेख करना काफ़ी है, और सहयोग के लिए किसी dot को आमंत्रित किया जा सकता है। साझा करने की पहुँच सीमित रहती है: पढ़ने की अनुमति और Space की पहुँच वाला Plus, Pro, Business या Enterprise खाता ज़रूरी है; Free खाते साझा सामग्री नहीं खोल सकते, और कोई सार्वजनिक लिंक उपलब्ध नहीं है।
Gemini ऐप, Gemini Omni 1.2 Flash से ऐनिमेटेड GIF बनाता है, फ्रांस में मुफ़्त
20 नवंबर — Gemini ऐप अब Gemini Omni 1.2 Flash से ऐनिमेटेड GIF (बार-बार चलने वाले फ़ोटो प्रभाव, मीम) बनाता है। Google ने यह वीडियो मॉडल 5 नवंबर को पेश किया था और उसके अनुसार, इससे सहज गति और हर फ़्रेम में एक जैसी गुणवत्ता मिलती है। मुख्य चैट में अपना अनुरोध लिखा जा सकता है, या चित्र अथवा वीडियो टूल खोलकर फ़ॉर्मैट चयनकर्ता में GIF चुना जा सकता है।
GIFs are now available to all Google AI subscribers and free of charge in the U.S., Japan, Korea, Australia, Canada, U.K., Germany, and France.
🇮🇳 GIF अब सभी Google AI ग्राहकों के लिए उपलब्ध हैं, और अमेरिका, जापान, कोरिया, ऑस्ट्रेलिया, कनाडा, ब्रिटेन, जर्मनी तथा फ्रांस में मुफ़्त भी उपलब्ध हैं। — X पर @GeminiApp
इसलिए बिना सदस्यता वाले फ्रांसीसी उपयोगकर्ता भी इन्हें इस्तेमाल कर सकते हैं। Google ने OpenAI का अनुसरण किया है, जिसके ChatGPT में Images 2.6 के साथ ऐनिमेटेड GIF की चर्चा यहाँ 5 नवंबर को की गई थी।
🔗 X पर @GeminiApp: Gemini में GIF
Perplexity एक्सटेंशन की मदद से Perplexity Computer सीधे Chromium ब्राउज़रों में काम करता है
20 नवंबर — Perplexity Computer अब Perplexity एक्सटेंशन की मदद से Chromium पर आधारित ब्राउज़रों में सीधे काम करता है। एक्सटेंशन के साइड पैनल से कोई कार्य सौंपा जाता है, फिर Computer को उपयोगकर्ता के टैब और टूल में काम करते हुए देखा जा सकता है। घोषणा वाले ट्वीट में न तो संबंधित योजनाओं का उल्लेख है और न ही समर्थित ब्राउज़रों की सूची दी गई है।
इसके दो पूर्व उदाहरण हैं: 5 अक्टूबर को Mac ऐप 26.38.0 में Computer एक एक्सटेंशन की मदद से Chrome, Edge या Brave इस्तेमाल कर सकता था, और 30 अक्टूबर को एक Chrome एक्सटेंशन ने Computer के Mac और Windows ऐप को उपयोगकर्ता के ब्राउज़र से जोड़ा था। इस बार कार्य ब्राउज़र में एक्सटेंशन के साइड पैनल से सौंपा जाता है।
डेवलपरों के लिए API और SDK: Agents SDK Python में Codex, Perplexity की Context API में Decider
OpenAI के Agents SDK Python ने 1.0 का पूर्वावलोकन संस्करण जारी किया, जिसमें Codex एक मॉडल प्रदाता बन गया है
20 नवंबर — OpenAI के Agents SDK Python ने अपनी 1.0 शृंखला की शुरुआत एक ऐसे पूर्वावलोकन संस्करण से की है जो दृष्टिकोण बदलता है: 16 नवंबर को यहाँ चर्चा किए गए 0.24 पूर्वावलोकन की तरह अलग नेटिव इंजन होने के बजाय, Codex अब एक मॉडल प्रदाता है जिसे हर बार चलाते समय चुना जा सकता है। CodexProvider बनाकर उसे RunConfig(model_provider=provider) के ज़रिए Runner को दिया जाता है; फिर एजेंट सहेजे गए Codex कनेक्शन या API कुंजी के साथ चलता है।
Python wheel में PyO3 के ज़रिए Codex Core (rust-v0.166.0, बिना बदलाव के) शामिल है: SDK सीधे Codex के मूल इंजन को कॉल करता है, इसके लिए न codex app-server चलाया जाता है और न ही JSON-RPC का इस्तेमाल होता है। Python टूल, विशेषज्ञ एजेंट को कार्य सौंपना (handoffs), टूल चलाने से पहले मंज़ूरी और निर्धारित टाइप वाला आउटपुट उपलब्ध रहते हैं, तथा नेटिव कमांड Codex के सैंडबॉक्स और मंज़ूरी नियमों का पालन करते हैं। 1.0.0a1 के wheel केवल GitHub Releases के ज़रिए उपलब्ध हैं (Linux x86-64 और ARM64, Apple silicon पर macOS 11 और उससे नए संस्करण, Windows x64, CPython 3.10 से 3.14 तक)। पूर्वावलोकन 0.24.0-alpha.8 के बैकअप Runner के साथ संगत नहीं हैं, और स्थिर संस्करण अभी भी 18 नवंबर का 0.25.0 है।
🔗 openai-agents-python v1.0.0-alpha.1
Perplexity ने पृष्ठों को स्कोर देने के लिए Context API में Decider जोड़ा, जिसमें प्रॉम्प्ट इंजेक्शन की जाँच भी शामिल है
19 नवंबर — Perplexity ने दो दिन पहले शुरू की गई Context API में अपना निर्णय मॉडल Decider जोड़ा है (1 000 URL के लिए 1 डॉलर)। प्राप्त किए गए हर पृष्ठ पर अधिकतम पाँच ऐसे प्रश्न पूछे जा सकते हैं जिनका उत्तर हाँ या नहीं में हो, और Decider हर उत्तर को 0 से 1 तक स्कोर देता है। प्रमुख उपयोग सुरक्षा से जुड़ा है: किसी एजेंट के पृष्ठ पढ़ने से पहले उसमें प्रॉम्प्ट इंजेक्शन (prompt injection) का पता लगाना। Perplexity ने संभावित ग्राहकों का आकलन, सामग्री मॉडरेशन और बिना स्रोत वाले स्वास्थ्य संबंधी दावों की पहचान का भी उल्लेख किया है।
API अपने आप कुछ भी फ़िल्टर नहीं करता: वह सभी पृष्ठ उनके स्कोर के साथ लौटाता है, और सीमा लागू करने का काम एप्लिकेशन का कोड करता है। प्रति URL शुल्क के अलावा, स्कोर के लिए Decisions API के इनपुट टोकनों के हिसाब से शुल्क लगता है, और इससे अनुरोध पूरा होने में अधिकतम 15 सेकंड अतिरिक्त लग सकते हैं। दस्तावेज़ों की कुकबुक में 18 नवंबर को 0,7 की सीमा के साथ की गई जाँच दिखाई गई है:
| परीक्षण किया गया पृष्ठ (18 नवंबर की कुकबुक) | इंजेक्शन स्कोर | जाँच का निर्णय |
|---|---|---|
| इंजेक्शन का प्रदर्शन (ग्रेशाके व अन्य, 2023) | 0,97 | अलग रखा गया |
| OWASP, प्रॉम्प्ट इंजेक्शन पर पृष्ठ | 0,0018 | आगे भेजा गया |
| RFC 9111 | 0,0007 | आगे भेजा गया |
कुकबुक चेतावनी देती है कि कम स्कोर किसी पृष्ठ को सुरक्षित नहीं बनाता: Perplexity के BrowseSafe++ शोध के अनुसार, परीक्षण किया गया हर मॉडल तब भी कुछ ऐसे इंजेक्शनों का पालन कर रहा था जिन्हें उसने स्वयं चिह्नित किया था।
🔗 @perplexitydevs की पोस्ट शृंखला · दस्तावेज़ · कुकबुक
कोड एजेंट: Claude Code 2.1.329, Codex CLI 0.171.0, Vibe CLI 3.1.4 और Devin में Gemini 4 Neon
Claude Code 2.1.329 फ़ोल्डर खोलते समय हुक का स्रोत बताता है और निर्धारित कार्यों को /tasks में एकत्र करता है
19 नवंबर — Claude Code 2.1.329 में 130 प्रविष्टियाँ हैं, जिनमें 91 सुधार, 20 बदलाव और 7 नई सुविधाएँ शामिल हैं। सुरक्षा के मामले में, किसी फ़ोल्डर पर भरोसा करने के बारे में पूछने वाला संवाद बॉक्स अब बताता है कि उसके हुक कहाँ घोषित किए गए हैं, और जब प्रबंधित सेटिंग्स (managed settings) द्वारा अनिवार्य किए गए हुक लोड नहीं होते, तो Claude Desktop और अन्य गैर-इंटरैक्टिव होस्ट चेतावनी देते हैं। /tasks सत्र के निर्धारित कार्यों, /loop के वेक-अप, मौजूदा लक्ष्य और बातचीत के फ़ोर्क की सूची भी दिखाता है; पिछले संस्करणों में दर्ज अधिकांश निर्धारित कार्यों को दोबारा निर्धारित करना होगा।
बिना लक्ष्य के /code-review अब अधिकांश मॉडलों पर पूरी शाखा की समीक्षा डिफ़ॉल्ट शाखा की तुलना में करता है, और PR नंबर देने पर gh pr diff के ज़रिए स्वयं PR को पढ़ता है। macOS पर कंप्यूटर के इस्तेमाल के लिए नए सुरक्षा नियम लागू होते हैं, जो कुछ कार्रवाइयों को अस्वीकार करते हैं। max_tokens त्रुटि के बाद अपने आप दोबारा कोशिश करने की सुविधा, जिसे 2.1.326 में जोड़ा गया था, हटा दी गई है: गेटवे के पीछे काम करते समय CLAUDE_CODE_MAX_OUTPUT_TOKENS सेट करना होगा। Code Mode में 17 प्रविष्टियाँ हैं, जिनमें OpenTelemetry के इवेंट और मेट्रिक्स के साथ संगतता शामिल है। 2.1.330, 20 नवंबर से npm पर प्रकाशित है।
Codex CLI 0.171.0 ने GPT-6.2 Sol को डिफ़ॉल्ट बनाया और टर्मिनल कार्यक्षेत्र सक्रिय किया
20 नवंबर — Codex CLI 0.171.0, 18 नवंबर के 0.170.0 के बाद पहला स्थिर संस्करण है और इसमें 339 पुल रिक्वेस्ट शामिल हैं। GPT-6.2 Sol और GPT-6.2 Astra को मॉडल कैटलॉग में जोड़ा गया है, जिसमें Sol डिफ़ॉल्ट रूप से चुना जाता है, और /rc तथा /remote कमांड टर्मिनल से स्थानीय रिमोट कंट्रोल सँभालते हैं और उपकरणों के पेयरिंग कोड दिखाते हैं।
14 से 17 नवंबर के पूर्वावलोकन संस्करणों की कई नई सुविधाएँ स्थिर संस्करण में आ गई हैं: डिफ़ॉल्ट रूप से सक्रिय TUI कार्यक्षेत्र बातचीत के साथ दस्तावेज़ों और चित्रों के पूर्वावलोकन तथा उप-एजेंटों के संवाद-प्रतिलेख दिखाता है; codex exec --remote किसी मौजूदा एप्लिकेशन सर्वर पर गैर-इंटरैक्टिव सत्र शुरू करता है या फिर से जारी करता है; संदेश संपादक में पूर्ववत करने और दोबारा लागू करने की सुविधा जुड़ी है; एक विकल्प सक्षम करने पर /statusline किसी MCP सर्वर द्वारा उपलब्ध कराई गई स्थिति-पंक्तियाँ चुनता है। सुधारों में, ड्राफ़्ट और कतार में लगी दोबारा कोशिशें अपनी बातचीत से जुड़ी रहती हैं, और एंटरप्राइज़ MCP कनेक्शन उन पहचान प्रदाताओं के साथ काम करता है जो रिफ़्रेश टोकन जारी नहीं करते।
Vibe CLI 3.1.4 एजेंट को स्वीकृति नीति से अलग करता है और एजेंटों से पुष्टि की आवश्यकता हटाने का अधिकार वापस लेता है
20 नवंबर — Mistral ने Vibe CLI 3.1.4 जारी किया है, 3.1.3 के दो दिन बाद, जिसमें Mistral Large 4 को डिफ़ॉल्ट मॉडल बनाया गया था। इसकी 79 प्रविष्टियाँ (18 नई सुविधाएँ, 41 बदलाव, 18 सुधार, 2 हटाई गई सुविधाएँ) मुख्यतः अनुमतियों से जुड़ी हैं: अब हर सत्र में दो स्वतंत्र सेटिंग होती हैं, एक एजेंट (default, lean या कस्टम) और एक स्वीकृति नीति (ask, accept-edits, smart-approve या auto-approve), जिसे --approval-policy या default_approval_policy से चुना जाता है।
अब कोई एजेंट अकेले यह तय नहीं करता कि बिना पूछे क्या चलेगा: उसकी safety, bypass_tool_permissions और permission = "always" सेटिंग को अनदेखा किया जाता है। कोई परियोजना अब अपने .vibe/agents/ फ़ोल्डर में स्वीकृति नीति दोबारा परिभाषित नहीं कर सकती, और फ़ोर्क तथा उप-सत्र मूल नीति अपनाते हैं। इंटरफ़ेस में इनपुट के ऊपर चिपों की एक « पट्टी » जुड़ी है (उप-एजेंट, पृष्ठभूमि कार्य, पुल रिक्वेस्ट, लक्ष्य, कार्य), keep_awake सेटिंग किसी टर्न के दौरान कंप्यूटर को स्लीप मोड में जाने से रोकती है, और Vibe सिस्टम प्रमाणपत्र स्वीकार करता है, जिससे उसे कंपनी के प्रॉक्सी के पीछे काम करने में मदद मिलती है। अब Mistral मॉडलों को केवल सबसे हाल की 8 छवियाँ भेजी जाती हैं, और कस्टम कम्पैक्शन प्रॉम्प्ट हटा दिए गए हैं।
Devin में Gemini 4 Neon उपलब्ध, FrontierCode 2.0 पर प्रति कार्य 4,38 डॉलर की लागत से 46,2 % स्कोर
19 नवंबर (लेख पर 18 तारीख़ दर्ज है) — Cursor और GitHub Copilot के बाद, जिनकी चर्चा यहाँ कल हुई थी, Cognition ने Devin Desktop और Devin CLI में Gemini 4 Neon उपलब्ध कराया है। FrontierCode 2.0 पर, उसका बेंचमार्क जो जाँचता है कि कोई पुल रिक्वेस्ट मर्ज किए जाने योग्य है या नहीं, Neon ने 46,2 % हासिल किया है, जो Cognition के अनुसार किसी Google मॉडल का सर्वश्रेष्ठ परिणाम है। यह लगभग एक तिहाई लागत पर Claude Opus 5.5 (47,3 %) से लगभग एक प्रतिशत अंक पीछे है: प्रति कार्य 12,82 डॉलर के मुकाबले 4,38 डॉलर।
| FrontierCode 2.0 पर मूल्यांकित मॉडल | Cognition द्वारा प्रकाशित स्कोर |
|---|---|
| Claude Fable 5.2 | 50,2 % |
| Claude Opus 5.5 | 47,3 % |
| Gemini 4 Neon | 46,2 % |
| GPT-6.2 Astra | 44,2 % |
| GPT-6.2 Sol | 43,8 % |
| Gemini 4 Carbon | 42,6 % |
यह लागत API की सूचीबद्ध दर पर प्रति निष्पादन औसत खर्च है, जिसमें सार्वजनिक छूट शामिल हैं, और किसी अनिवार्य मानदंड पर विफल होने वाले समाधान को शून्य स्कोर मिलता है। इस चार्ट के कई स्कोर पिछले सप्ताहों में प्रकाशित मूल्यों से अलग हैं, जिसकी लेख में कोई व्याख्या नहीं दी गई है।
🔗 Devin में Gemini 4 Neon (Cognition) · X पर @cognition
विज्ञान: OpenAI ने औषधीय रसायन विज्ञान का बेंचमार्क MedChemBench जारी किया, जिसमें GPT-6.2 Astra ने 84,5 % हासिल किए
20 नवंबर — OpenAI ने MedChemBench प्रस्तुत किया है, एक बेंचमार्क जो औषधीय रसायनज्ञ की तरह तर्क करने की मॉडलों की क्षमता मापता है: किसी अणु की संरचना को प्रयोगात्मक परिणामों से जोड़ना, यौगिकों की तुलना करना, उनके गुणों का पूर्वानुमान लगाना। इसमें 117 शोधपत्रों और पेटेंट से लिए गए 99 प्रश्न हैं, जिनमें 761 अलग-अलग आणविक संरचनाएँ शामिल हैं, और यह चार घटकों का मूल्यांकन करता है: संरचनाएँ, वैज्ञानिक तर्क, यौगिकों का चयन और गुणों का पूर्वानुमान।
| मूल्यांकित मॉडल (तर्क स्तर xhigh) | प्राप्त अंक |
|---|---|
| GPT-6.2 Astra | 84,5 % |
| GPT-6 Astra | 83,3 % |
| GPT-6.1 Sol | 82,0 % |
| GPT-6.1 Terra | 75,1 % |
| GPT-5.6 Sol | 58,2 % |
प्रदर्शन असमान है: GPT-6 Astra संरचनाओं पर 95,4 % अंक हासिल करता है, लेकिन यौगिकों के चयन और संख्यात्मक मूल्यों के पूर्वानुमान पर लगभग आधे। OpenAI सावधानी बरतता है: यह बेंचमार्क पुराने डेटा पर आधारित है और इससे यह साबित नहीं होता कि मॉडल नई दवाएँ खोज सकते हैं, स्रोत प्रकाशनों से उनका पहले परिचित होना खारिज नहीं किया जा सकता, और केवल GPT मॉडलों का मूल्यांकन किया गया है। यह BioBasicsBench के बाद आया है, जिसकी चर्चा यहाँ 6 नवंबर को हुई थी।
🔗 MedChemBench का परिचय (OpenAI) · पूरा शोधपत्र (PDF)
जनरेटिव वीडियो और ऑडियो: ElevenLabs ने Ads Engine में बिना नई शूटिंग के विज्ञापनों के वैकल्पिक संस्करण बनाने की सुविधा जोड़ी
20 नवंबर — ElevenLabs ने Ads Engine को बेहतर बनाया है, जो ElevenCreative में शामिल उसका विज्ञापन निर्माण उपकरण है और जून में लॉन्च हुआ था। Google, Meta, LinkedIn और अब TikTok के विज्ञापन खातों से जुड़कर यह मौजूदा विज्ञापनों और उनके परिणामों के आधार पर बिना नई शूटिंग के उनके वैकल्पिक संस्करण बनाता है। यह शुरुआती आकर्षक हिस्से (हुक) को पहचानता है और सफल विज्ञापनों के आधार पर नए हिस्से लिखता है; इन्हें मूल वक्ता की आवाज़ की डिजिटल प्रतिकृति बोलती है, साथ में होंठों का तालमेल और उपशीर्षक भी अपडेट होते हैं। दृश्यों के भाव और गति के आधार पर ElevenLabs Music API से रची गई नई संगीत धुनों का व्यावसायिक उपयोग किया जा सकता है।
स्थानीयकरण के लिए, जो पहले से Dubbing v2 से होता था, Ads Engine अब वक्ता के होंठों की गति को लक्षित भाषा के अनुरूप ढालता है और वीडियो में जड़े उपशीर्षकों की जगह अनुवादित संस्करण लगाता है, जिसमें ब्रांड के समय-संयोजन और फ़ॉन्ट का पालन होता है। प्रसारण से पहले किसी व्यक्ति से समीक्षा कराना अब भी संभव है, जिसमें लक्षित भाषा का मूल वक्ता कोई स्थानीयकरण पेशेवर भी हो सकता है, और उपकरण सीधे प्लेटफ़ॉर्म पर प्रकाशित कर सकता है। पहुँच के लिए बिक्री टीम से संपर्क करना होता है; कोई दर प्रकाशित नहीं की गई है।
🔗 Ads Engine में वीडियो विज्ञापनों के वैकल्पिक संस्करण और स्थानीयकरण (ElevenLabs)
संक्षिप्त समाचार
कोड एजेंट
- Copilot CLI 1.0.115-2 — 351 प्रविष्टियों वाले इस पूर्वावलोकन संस्करण में, जिनमें 335 सुधार हैं, खाते को पहुँच होने पर Gemini 4 Hydrogen, Extra High प्रयास स्तर के साथ मॉडल चयन सूची में आता है, GPT-6.2 Astra का समर्थन जोड़ा गया है, और
/modelकस्टम प्रदाताओं के मॉडलों को भी संभालता है; स्थिर संस्करण अभी 1.0.114 है। 🔗 स्रोत - Codex CLI 0.173.0-alpha.1 और alpha.2 — इन पूर्वावलोकन संस्करणों के रिलीज़ नोट खाली हैं; 71 कमिट के शीर्षकों के अनुसार, MCP कनेक्शन साझा करना और कॉन्फ़िगर किए गए सर्वरों की OAuth खोज डिफ़ॉल्ट रूप से सक्रिय हो रहे हैं, और प्रशासक Codex डेमन के अपडेट बंद कर सकेंगे। स्थिर संस्करण आने से पहले सामग्री बदल सकती है। 🔗 स्रोत
- Gemini CLI — 4 नवंबर के बाद पहला नाइटली संस्करण (v0.71.0-nightly.20261120); मुख्य शाखा पर,
gemini --resumeअब सबसे हाल में उपयोग किया गया सत्र दोबारा खोलता है, सबसे अंत में शुरू किया गया सत्र नहीं, और Windows पर~\से शुरू होने वाले पथों का आखिरकार विस्तार होता है। 🔗 स्रोत - Antigravity IDE 2.8.0 — Google का संपादक अपना बैकएंड तुरंत शुरू करता है और पृष्ठभूमि में अपडेट जाँचता है, दूरस्थ कनेक्शन के लिए अपने-आप पोर्ट फ़ॉरवर्ड करता है, कीबोर्ड से किसी बातचीत में खोज करने देता है और कनेक्शन के समय कस्टम प्रमाणपत्र तथा प्रॉक्सी स्वीकार करता है। 🔗 स्रोत
- Qwen Code 0.28.1-preview.1 — 179 प्रविष्टियों वाला यह पूर्वावलोकन संस्करण GitHub को तीसरा समर्थित चैनल अडैप्टर बनाता है, वेब इंटरफ़ेस से कॉन्फ़िगर किए जा सकने वाले WeCom, Microsoft Teams और सामान्य आउटगोइंग वेबहुक जोड़ता है, और CLI में स्क्रीन रीडर के अनुकूल प्रस्तुति लाता है; स्थिर संस्करण अभी v0.28.0 है। 🔗 स्रोत
- Kimi Code 2.7.1 और 2.7.2, Kimi Code Desktop 1.4.1 और 1.4.2 — 2.7.0 के अगले दिन चार सुधार संस्करण: ड्राफ़्ट में चुना गया चिंतन प्रयास स्तर अब भेजने के बाद डिफ़ॉल्ट पर नहीं लौटता, और किसी टर्न के बीच दिशा बदले गए सत्र को बहाल करने के बाद फ़ोर्क अब विफल नहीं होते। 🔗 स्रोत
- CLI mistral 0.20.1 — किसी निष्पादन की सभी कॉल विफल होने पर, उदाहरण के लिए 401 त्रुटि पर,
mistral evals execअब उसे सफल बताने के बजाय विफलता (कोड 1) के साथ समाप्त होता है; Ctrl-C से किए गए व्यवधान को भी व्यवधान के रूप में बताया जाता है। 🔗 स्रोत - Replit — कार्यक्षेत्रों (Workspaces) को अब खोजा और पिन किया जा सकता है, यह विकल्प कम से कम पाँच कार्यक्षेत्र होने पर ही दिखता है। 🔗 स्रोत
- Manim के लिए Devin Bot — Cognition ने वह Devin Bot दिखाया है जिसे ग्रांट सैंडरसन ने Manim पर अपनी मदद के लिए स्थापित किया है। Manim, 3Blue1Brown के वीडियो का ओपन सोर्स एनिमेशन सिस्टम है (96,6 k स्टार, प्रति माह 250 000 डाउनलोड); ट्वीट में न तो बॉट को सौंपे गए कार्य बताए गए हैं, न उसके परिणाम। 🔗 स्रोत
API और प्लेटफ़ॉर्म
- Gemini API — 17 नवंबर से Gemini 3.5 Transcribe, अपने सामान्य और लाइव दोनों संस्करणों में, आवाज़ के निर्देश से डिक्टेशन या मौजूदा पाठ को बदलता, दोबारा लिखता और फ़ॉर्मैट करता है (पैरामीटर
source_text), और Google ने अनुवाद का भी उल्लेख किया है। 18 तारीख़ से API भेजी गई फ़ाइलों के केवल उपयोगी हिस्से को संसाधित करने और उसी के लिए भुगतान करने देता है: पृष्ठों की सीमाएँ, टैब, सेल, समय अंतराल या सामग्री की परतें। 🔗 स्रोत - Agents API में समय की जानकारी — एक प्रयोगात्मक विकल्प (
experimental={"time_awareness": True}) नियमित रूप से मॉडल को समय याद दिलाता है, ताकि वह अपने काम को समय-सीमा के अनुसार ढाल सके; असिंक्रोनस उपकरणों के साथ मिलकर यह किसी एजेंट को सवाल पूछने और जवाब की प्रतीक्षा करते हुए खोज जारी रखने देता है, जैसा कि OpenAI के डेवलपर ब्लॉग के एक लेख में दिखाया गया है। 🔗 स्रोत - GPT-6.2 के साथ बातचीत का इतिहास — @OpenAIDevs ने Responses API में पिछले संदेशों को बदलना बंद करने को कहा है, क्योंकि API बदलाव के बाद के तर्क को हटा देता है। उपयोग डैशबोर्ड का नया तर्क हटाए जाने वाला अनुभाग इसे पहचानने में मदद करता है, और संबंधित मार्गदर्शिका प्रयास स्तर या उपकरण बदलने के लिए इसके बजाय
configuration_updateयाadditional_toolsतत्व जोड़ने का सुझाव देती है। 🔗 स्रोत
आम उपयोगकर्ताओं के सहायक
- ChatGPT एक नया मोबाइल ऐप जारी कर रहा है, जिसमें dot के लिए एक टैब और पिन किए गए पसंदीदा विकल्प हैं — Codex, Projects या Images को टैब बार में पिन किया जा सकता है; इसे पहले उन स्थानों पर 18 वर्ष और उससे अधिक आयु के Pro उपयोगकर्ताओं के लिए जारी किया जा रहा है जहाँ dots उपलब्ध हैं, यूरोपीय आर्थिक क्षेत्र (यूरोपीय संघ सहित), यूनाइटेड किंगडम, स्विट्ज़रलैंड और कोरिया को छोड़कर, और Plus उपयोगकर्ताओं के एक छोटे समूह के लिए भी (19 नवंबर के रिलीज़ नोट, जिनका लिंक ऊपर है)।
- Perplexity के Teammates — Max सदस्य अब वेब पर किसी भी Computer कार्य से एक सहयोगी बना सकते हैं, फिर उसी बातचीत में उसका नाम, भूमिका या अवतार बदल सकते हैं। 🔗 स्रोत
- Perplexity का Mac ऐप — अब अधिक तेज़ यह ऐप किसी चल रहे कार्य की दिशा बदलने के लिए « अभी भेजें », तालिकाओं, Markdown और पूर्वावलोकनों में खोज के लिए ⌘F, और बंद टैब दोबारा खोलने के लिए ⌘⇧T जोड़ता है। 🔗 स्रोत
जनरेटिव वीडियो और ऑडियो
- Pika पर Seedance 2.5 Flash — Runway और HeyGen के बाद, Pika ने कई टेक वाले कामों के लिए ByteDance के वीडियो मॉडल का तेज़ संस्करण जोड़ा है: 480p या 720p में 30 सेकंड तक के वीडियो, संदर्भ के लिए अधिकतम 10 छवियाँ, 5 वीडियो और 5 ऑडियो क्लिप; ट्वीट में कोई दर नहीं दी गई है। 🔗 स्रोत
- HeyGen का Avatar 6 — तकनीकी रिपोर्ट से लिए गए नए ब्लाइंड टेस्ट: जब फ़िल्माए गए लोग, जो HeyGen के कर्मचारी हैं, अपने से सबसे अधिक मिलते-जुलते वीडियो को चुनते हैं, तो Avatar 6, Seedance 2.5 के मुकाबले 86,5 % और Wan 3.0 के मुकाबले 87,9 % मामलों में जीतता है; ये मूल्यांकन HeyGen ने किए हैं। 🔗 स्रोत
- Together AI पर Qwen3 TTS — खुला वाक् संश्लेषण मॉडल Qwen3-TTS-12Hz-1.7B (Apache 2.0) प्रति दस लाख अक्षरों के लिए 20 डॉलर की दर पर उपलब्ध है, जिसमें आम भाषा में निर्देश देकर समायोजित की जा सकने वाली नौ आवाज़ें, फ़्रेंच सहित दस भाषाएँ और सबसे अच्छे मामले में 97 ms में पहली ध्वनि मिलती है। 🔗 स्रोत
बुनियादी ढाँचा और अनुसंधान
- Together Storage Accelerator — Together AI हर GPU क्लस्टर के साथ S3 स्टोरेज और Hugging Face Hub के लिए NVMe कैश देता है, जिसके लिए कोड बदलने की ज़रूरत नहीं है; उसके मापों के अनुसार, Cloudflare R2 से पढ़ी जाने वाली 2 Gio की फ़ाइल का समय 12,7 से 15,0 s से घटकर 0,64 से 0,72 s हो जाता है, और 200 नोड वाला क्लस्टर मूल स्रोत से केवल एक बार डाउनलोड करता है। 🔗 स्रोत
- Hugging Face का CDN — अपने सह-संस्थापक जूलियन शोमों के अनुसार, Hugging Face हर महीने लगभग एक एक्साबाइट खुले मॉडल और डेटासेट उपलब्ध कराता है, और उसने AI डाउनलोड के लिए अपना वितरण नेटवर्क (CDN) बनाया है। 🔗 स्रोत
- basecompute का Superfluid — स्थानीय सर्वर अब Apple, AMD और NVIDIA मशीनों के बीच इन्फ़रेंस बाँटता है: निर्माता के अनुसार, छह मशीनें 64 सिम्युलेटेड उपयोगकर्ताओं के लिए आउटपुट दर को प्रति सेकंड 112 से 534 टोकन तक बढ़ाती हैं, और किसी नोड के बंद होने पर कोई अनुरोध नहीं खोता। 🔗 स्रोत
- WavLate — देर से अंतःक्रिया करने वाला यह खुला मॉडल पाठ से ध्वनियाँ और ध्वनि से पाठ खोजता है, जिसमें हर 0,31 सेकंड की ध्वनि के लिए एक वेक्टर और हर शब्द के लिए एक वेक्टर होता है; इसके लेखक ने AudioCaps और Clotho पर औसत Recall@1 स्कोर 37,9 बताया है, जो तुलना किए गए नौ खुले मॉडलों में सर्वश्रेष्ठ है, और मॉडल वेट तथा डेटा प्रकाशित किए हैं। 🔗 स्रोत
- WorldTrace — NVIDIA Research ने इंटरैक्टिव वीडियो वर्ल्ड मॉडलों के लिए बिना दोबारा प्रशिक्षण के काम करने वाली स्मृति प्रस्तुत की है (शोधपत्र NeurIPS 2026 में स्वीकृत): LoopBench पर, स्लाइडिंग विंडो की तुलना में दोबारा देखे गए दृश्यों की याद में 32,6 % सुधार होता है, जिसके लिए 3,1 Go GPU मेमोरी और 27 % अधिक निष्पादन समय लगता है। 🔗 स्रोत
- पुनर्बलन अधिगम के लिए Dynamo — NVIDIA ने विस्तार से बताया है कि Dynamo, प्रशिक्षण के बाद के चरण में रोलआउट कैसे चलाता है: KV कैश के अनुसार रूटिंग, ModelExpress से वेट के केवल बदले हुए हिस्सों का स्थानांतरण, विफल वर्कर प्रक्रियाओं को बहाल करना। Microsoft AI, Cognition (SWE-1.7 के लिए), Prime Intellect और H Company इसका उपयोग करते हैं; H Company को हर प्रशिक्षण चरण में 20 % तक समय की बचत होती है। 🔗 स्रोत
- स्पार्स अटेंशन — 17 नवंबर की एक मार्गदर्शिका में, NVIDIA ने अपने GPU पर प्रशिक्षित स्पार्स अटेंशन के लिए डिज़ाइन के आठ नियम दिए हैं; 128K टोकन पर DeepSeek V3.2 की एक प्रीफ़िल परत में टोकन चुनने वाले इंडेक्सर और Top-k का हिस्सा 47 % है। 🔗 स्रोत
GitHub
- GitHub Enterprise Server 3.23 का रिलीज़ कैंडिडेट — सार्वजनिक पूर्वावलोकन में उपलब्ध AI से सीक्रेट की पहचान की सुविधा उपकरण के प्रोसेसर पर चलती है, बिना GPU, बिना होस्ट किए गए LLM और बिना किसी आउटगोइंग कनेक्शन के, यहाँ तक कि नेटवर्क से अलग-थलग (एयर-गैप्ड) परिवेश में भी; यह संस्करण ज्ञात दुर्भावनापूर्ण पैकेजों की पहचान को npm के अलावा सात और इकोसिस्टम तक बढ़ाता है। 🔗 स्रोत
- AI से इतर — GitHub, पुल रिक्वेस्ट के नए अवलोकन पृष्ठ पर मर्ज की स्थिति स्पष्ट करता है, GitHub Desktop 3.7.0 एक ही होस्ट पर कई खाते स्वीकार करता है, और डैशबोर्ड अधिकतम 25 पसंदीदा रिपॉज़िटरी दिखाता है। 🔗 अवलोकन · 🔗 Desktop · 🔗 पसंदीदा
उद्यम और निबंध
- Hebbia — अगस्त और सितंबर के उसके वित्तीय शोध परीक्षणों में, GPT-6 Astra का एक पूर्वावलोकन संस्करण 99,5 % प्रासंगिक अंश उद्धृत करता है और प्रस्तुति संबंधी 97,9 % आवश्यकताओं का पालन करता है, जो परीक्षण किए गए सर्वश्रेष्ठ विकल्प से 14,4 प्रतिशत अंक आगे है; OpenAI द्वारा प्रकाशित केस स्टडी में उस विकल्प का नाम नहीं बताया गया है। 🔗 स्रोत
- मौन सहमति — OpenAI ने अपने बुद्धिमत्ता का युग (Intelligence Age) अनुभाग में डीन बॉल का एक निबंध प्रकाशित किया है, जिसे हार्वर्ड में दिए गए व्याख्यान से रूपांतरित किया गया है और लेखक के विचारों को दर्शाने वाला बताया गया है। यह इस धारणा का विरोध करता है कि मानव प्रधानता का त्याग अपरिहार्य होगा; इसमें ऐसे एजेंटों की वकालत की गई है जो व्यक्तियों से जुड़े हों और जिनकी अनुमतियाँ सीमित तथा वापस ली जा सकने वाली हों। 🔗 स्रोत
- डेटा संवर्धन — Perplexity की एक मार्गदर्शिका बताती है कि वेब से जुड़े मॉडल की मदद से CRM रिकॉर्ड को छह चरणों में कैसे पूरा और सत्यापित किया जाए; इसमें बताया गया है कि Apollo हर महीने Perplexity API के माध्यम से 5,6 मिलियन डेटा संवर्धन करता है। 🔗 स्रोत
इसका क्या मतलब है
Anthropic का शेयर बाज़ार में प्रवेश एक ही सौदे में बाज़ार और उद्योग, दोनों का पैसा साथ लाता है। सार्वजनिक पेशकश से कंपनी को लगभग 91,6 अरब डॉलर की सकल राशि मिलती है, और निजी प्लेसमेंट से 26 अरब डॉलर और मिलते हैं। सेमीकंडक्टर और कंप्यूटिंग क्षेत्र के सात समूहों ने 83 डॉलर के उसी मूल्य पर इसमें निवेश किया है: AMD, Broadcom, Google, Micron, Microsoft, NVIDIA और TSMC Partners। कुल मिलाकर, इस सौदे की सकल राशि लगभग 119,5 अरब डॉलर तक पहुँचती है: सार्वजनिक पेशकश के निवेशकों के साथ उद्योग के सात समूह भी एक ऐसी AI प्रयोगशाला के शेयर खरीद रहे हैं जो अब Nasdaq पर सूचीबद्ध है।
सुरक्षा को लगातार अधिक हद तक उपकरणों की कार्यप्रणाली में ही शामिल किया जा रहा है। OpenAI, GPT-6.2 के तर्क को उसे उत्पन्न करने वाले इतिहास से जोड़ता है, जिससे मापी गई निष्कर्षण दर 54,0 % से घटकर 0,2 % हो जाती है, लेकिन इसके लिए डेवलपरों को अपनी बातचीत का इतिहास दोबारा लिखना बंद करना पड़ता है। Vibe CLI एजेंटों से पुष्टि की आवश्यकताएँ खुद हटाने का अधिकार छीनता है, Claude Code किसी फ़ोल्डर पर भरोसा करने से पहले दिखाता है कि उसके हुक कहाँ से आते हैं, और Decider किसी एजेंट के पृष्ठ पढ़ने से पहले उनका मूल्यांकन करता है। वहीं, Sakana AI सामूहिक रक्षा के लिए एक समर्पित टीम बनाता है और कमज़ोरियों का फ़ायदा उठाने वाली सामग्री प्रकाशित न करने का वादा करता है।
एजेंट कोड लिखने से आगे बढ़कर सॉफ़्टवेयर की डिलीवरी प्रक्रिया में प्रवेश कर रहे हैं। Runway में वे अक्टूबर के 38 % मर्ज का संचालन करते हैं और AI कम जोखिम वाले बदलावों को अपने आप मंज़ूरी देता है; Stitch Loop एक ऑनलाइन उत्पाद की निगरानी करता है और मापनीय लक्ष्य हासिल करने के लिए पुल रिक्वेस्ट खोलता है। दोनों मामलों में अहम चीज़ों पर एक व्यक्ति का नियंत्रण बना रहता है: Runway में संवेदनशील हिस्सों पर और Stitch Loop में हर मर्ज पर। उपकरण भी इसी दिशा में बढ़ रहे हैं: Agents SDK Python, Codex को एक मॉडल प्रदाता बनाता है, और Cognition मॉडलों का मूल्यांकन उस सवाल पर करता है जो इन प्रक्रियाओं में उठता है, यानी क्या PR को मर्ज करना चाहिए।
खुले मॉडलों के मामले में प्रयास इस बात पर केंद्रित है कि कम वज़न से कितना हासिल किया जा सकता है। Inkling 2 Mini अपनी बीच की परतों से तीन बार गुज़रता है ताकि 20 Go में AA Index पर Qwen3.8-27B की बराबरी कर सके, Hugging Face का सुपर-अडैप्टर तीन विशेषज्ञताओं को एक ही LoRA में समेटता है, और Metric AI आर्मेनियाई भाषा के मॉडल बनाने के लिए Qwen3.5 से शुरुआत करता है। ये आँकड़े अब भी निर्माताओं के दिए हुए हैं, और MedChemBench इस अभ्यास की सीमाएँ याद दिलाता है: OpenAI इसमें केवल अपने मॉडलों का मूल्यांकन करता है और इस संभावना को खारिज नहीं करता कि उन्होंने स्रोत प्रकाशन पहले देखे हों।
स्रोत
- आरंभिक सार्वजनिक पेशकश का समापन (Anthropic)
- X पर @AnthropicAI: सह-संस्थापक
- Inkling 2 Mini (Thinking Machines)
- Inkling 2 Mini पर Hugging Face का लेख
- Inkling-2-Mini (Hugging Face)
- Together AI पर Tencent Hy4
- Hy4 पर Tencent की विज्ञप्ति
- बड़े पैमाने पर अडैप्टर का उपयोग (Hugging Face)
- X पर @yb2698: सुपर-अडैप्टर
- Ayb 0.5 (Metric AI)
- OhanTTS (Metric AI)
- OhanASR (Metric AI)
- X पर @pcuenq: Depth Pro 2
- arXiv शोधपत्र 2611.26603: Depth Pro 2
- DepthPro2-L (Hugging Face)
- प्रतिकूल डिस्टिलेशन का मुकाबला (OpenAI)
- X पर @OpenAI: प्रतिकूल डिस्टिलेशन
- X पर @hardmaru: सुरक्षा अनुसंधान समूह
- सुरक्षा अनुसंधान समूह (Sakana AI)
- सॉफ़्टवेयर फ़ैक्टरी का निर्माण (Runway)
- Stitch Loop (Google)
- ChatGPT के रिलीज़ नोट्स
- X पर @GeminiApp: GIF की उपलब्धता
- X पर @GeminiApp: Gemini में GIF
- X पर @perplexity_ai: Chromium में Computer
- openai-agents-python v1.0.0-alpha.1
- X पर @perplexitydevs: Context API में Decider
- मानदंडों के आधार पर पृष्ठों का मूल्यांकन करें (Perplexity दस्तावेज़)
- इंजेक्शन से बचाव की कार्यविधियाँ (Perplexity दस्तावेज़)
- Claude Code v2.1.329
- Codex CLI 0.171.0
- Vibe CLI v3.1.4
- Devin में Gemini 4 Neon (Cognition)
- X पर @cognition: Gemini 4 Neon
- MedChemBench का परिचय (OpenAI)
- MedChemBench का पूरा शोधपत्र (PDF)
- Ads Engine में वीडियो विज्ञापनों के विविध रूप और स्थानीयकरण (ElevenLabs)
- Copilot CLI 1.0.115-2
- Codex CLI 0.173.0-alpha.2
- Gemini CLI, PR 30389
- Antigravity का परिवर्तन विवरण
- Qwen Code v0.28.1-preview.1
- Kimi Code 2.7.2
- CLI mistral 0.20.1
- 20 नवंबर का Replit परिवर्तन विवरण
- X पर @cognition: Manim के लिए Devin Bot
- Gemini API के रिलीज़ नोट्स
- व्यक्तिगत एजेंटों के लिए समय की जानकारी और असिंक्रोनस इनपुट (OpenAI)
- X पर @OpenAIDevs: GPT-6.2 का इतिहास और तर्क
- X पर @AskPerplexity: Computer से teammates
- X पर @AskPerplexity: Mac ऐप
- X पर @pika_labs: Seedance 2.5 Flash
- X पर @HeyGen: Avatar 6 के ब्लाइंड परीक्षण
- Together AI पर Qwen3 TTS
- Together Storage Accelerator (Together AI)
- X पर @julien_c: Hugging Face का CDN
- फ़्लीट में Superfluid (basecompute)
- WavLate (Hugging Face)
- X पर @NVIDIAAI: WorldTrace
- Dynamo और RL के रोलआउट (NVIDIA)
- NVIDIA GPU पर स्पार्स अटेंशन (NVIDIA)
- GitHub Enterprise Server 3.23 रिलीज़ कैंडिडेट (GitHub परिवर्तन विवरण)
- पुल रिक्वेस्ट का अवलोकन पृष्ठ (GitHub परिवर्तन विवरण)
- GitHub Desktop और हर होस्ट पर कई खाते (GitHub परिवर्तन विवरण)
- डैशबोर्ड पर पसंदीदा रिपॉज़िटरी (GitHub परिवर्तन विवरण)
- Hebbia और GPT-6 Astra (OpenAI)
- मौन सहमति (OpenAI)
- AI से डेटा संवर्धन (Perplexity)