ai-powered-markdown-translatorArtigo traduzido do francês para o português com gpt-6.1-sol.
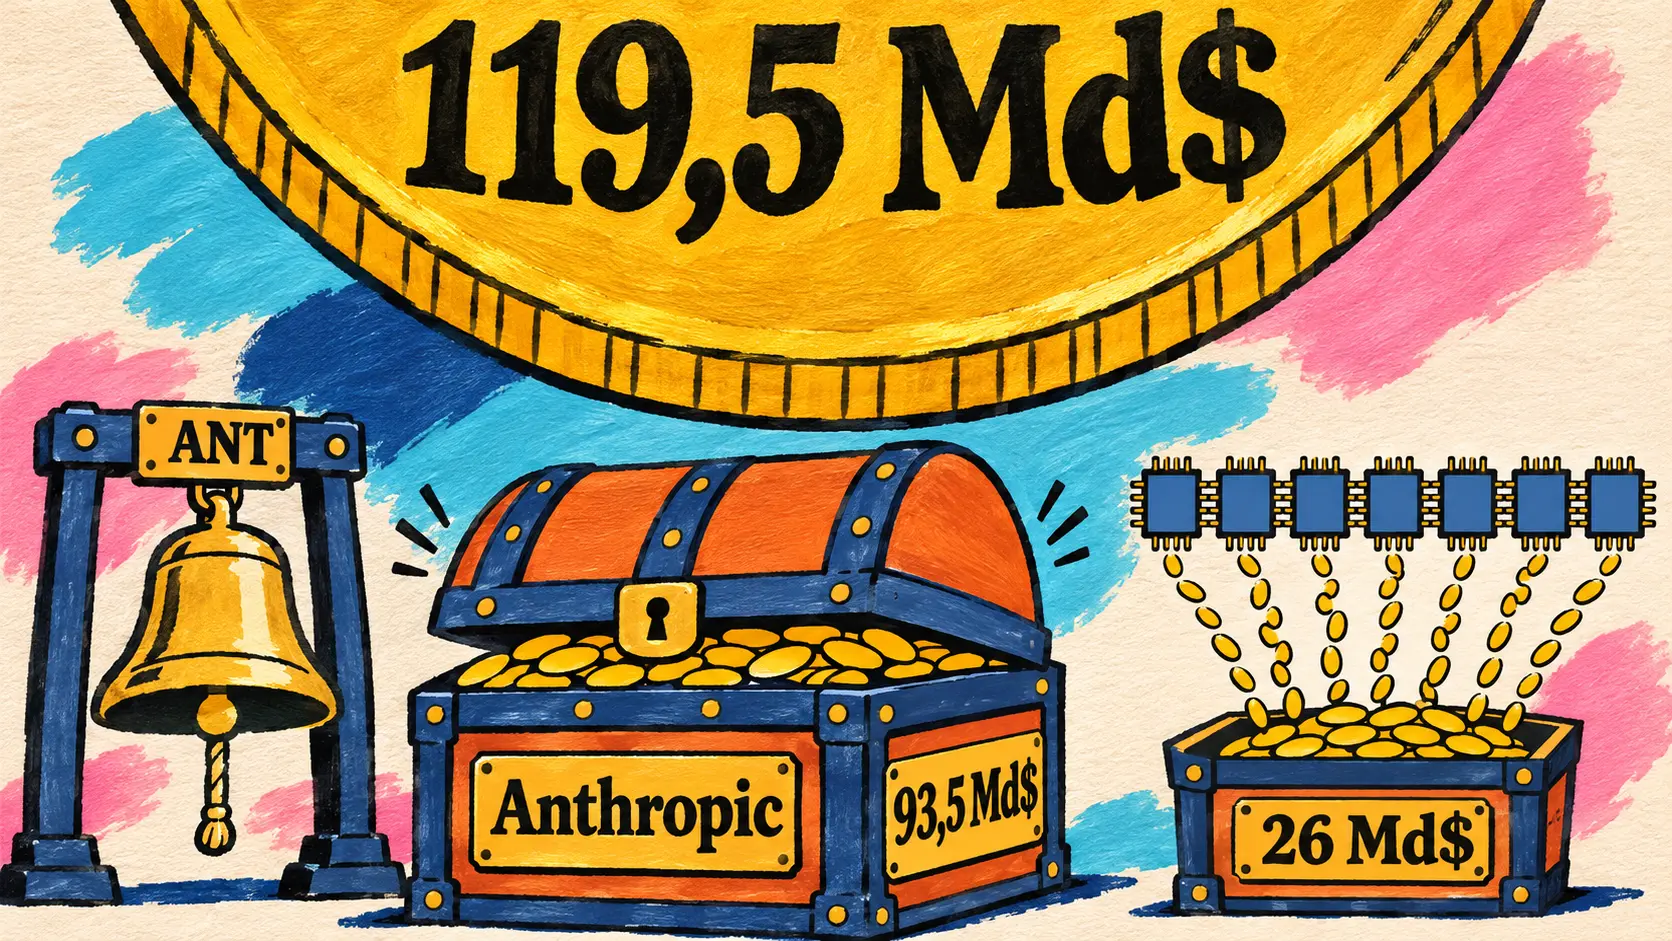
Anthropic conclui a sua entrada em bolsa: cerca de 93,5 mil milhões de dólares brutos pela oferta, e mais 26 mil milhões pagos por sete grupos, incluindo NVIDIA, Google e Microsoft, numa colocação privada realizada em paralelo. Thinking Machines publica Inkling 2 Mini, um modelo de pesos abertos com 26,4 mil milhões de parâmetros que cabe em 20 Go, e OpenAI reduz de 54,0 % para 0,2 % a taxa de sucesso dos ataques que extraem o raciocínio protegido dos seus modelos. ChatGPT Space fica disponível para os subscritores Plus, Runway confia a agentes 38 % das suas integrações de código, e Claude Code, Codex CLI e Vibe CLI lançam, cada um, uma nova versão.
Finanças: Anthropic conclui a sua entrada em bolsa, com 93,5 mil milhões de dólares brutos e uma colocação privada de 26 mil milhões
20 de novembro — No dia seguinte às suas primeiras negociações em bolsa, Anthropic anuncia a conclusão da sua entrada em bolsa, cujo preço tinha sido fixado a 18 de novembro em 83 dólares por ação. Os bancos exerceram integralmente a sua opção sobre 147 milhões de ações adicionais: no total, foram vendidas 1 127 000 000 ações de classe A. O produto bruto atinge cerca de 93,5 mil milhões de dólares antes de comissões e despesas, dos quais cerca de 91,6 mil milhões para Anthropic, que nada recebe pelas 23 648 646 ações vendidas por acionistas existentes.
O artigo também refere uma colocação privada realizada em paralelo e igualmente concluída, que não tinha sido mencionada no anúncio do preço: 313 253 007 ações de uma classe N, vendidas ao mesmo preço de 83 dólares a sete grupos dos semicondutores e da informática (AMD, Broadcom, Google, Micron, Microsoft, NVIDIA e TSMC Partners), por cerca de 26,0 mil milhões de dólares. Estas ações não estão registadas ao abrigo do Securities Act de 1933. Somando a oferta pública e esta colocação, o montante bruto aproxima-se dos 119,5 mil milhões de dólares, antes de comissões e despesas.
| Elemento da operação | Valor anunciado pela Anthropic |
|---|---|
| Ações de classe A vendidas | 1 127 000 000, das quais 147 000 000 ao abrigo da opção dos bancos |
| das quais vendidas pela Anthropic | 1 103 351 354 |
| das quais de acionistas existentes | 23 648 646 |
| Preço por ação | 83 dólares |
| Produto bruto da oferta | cerca de 93,5 mil milhões de dólares |
| Parcela recebida pela Anthropic | cerca de 91,6 mil milhões de dólares |
| Colocação privada (classe N) | 313 253 007 ações, cerca de 26,0 mil milhões de dólares |
| Total bruto, oferta e colocação | cerca de 119,5 mil milhões de dólares |
| Negociação em bolsa | desde 19 de novembro, Nasdaq Global Select Market, símbolo ANT |
O artigo confirma a negociação em bolsa, sem indicar a cotação nem a capitalização bolsista. Goldman Sachs e Morgan Stanley lideraram a operação, com um sindicato de cerca de vinte bancos, incluindo J.P. Morgan, Citigroup, BNP Paribas, Crédit Agricole CIB e Société Générale. No mesmo dia, @AnthropicAI publicou um vídeo em que os sete cofundadores, Dario Amodei, Daniela Amodei, Tom Brown, Jack Clark, Jared Kaplan, Sam McCandlish e Chris Olah, contam a história da empresa.
🔗 Conclusão da entrada em bolsa (Anthropic) · @AnthropicAI no X: os cofundadores
Modelos abertos: Inkling 2 Mini da Thinking Machines, Tencent Hy4, um superadaptador para Qwen3.8-27B, Ayb 0.5 e Depth Pro 2
20 de novembro — Thinking Machines Lab publica Inkling 2 Mini, o irmão mais pequeno de Inkling 2 Small (594 mil milhões de parâmetros, abordado aqui a 12 de novembro). Esta mistura de especialistas (Mixture-of-Experts) de pesos abertos, sob licença Apache 2.0, tem 26,4 mil milhões de parâmetros, dos quais 3,4 mil milhões ativos por token. Lê texto e imagens, com um contexto de um milhão de tokens. Os seus pesos são disponibilizados na precisão do treino, NVFP4 para vinte camadas e MXFP8 para as quatro últimas, ou seja, cerca de 20 Go sem perda de conversão: funciona com Ollama em qualquer Mac com pelo menos 32 Go.
Today we are releasing Inkling 2 Mini, a fast, powerful model that’s small enough to run on your laptop.
🇵🇹 Publicamos hoje Inkling 2 Mini, um modelo rápido e poderoso, suficientemente pequeno para funcionar no seu computador portátil. — Thinking Machines Lab, anúncio de Inkling 2 Mini
A sua particularidade é arquitetural: é um transformer com ciclos (looped transformer). Das suas 24 camadas, as 12 centrais são percorridas três vezes, ou seja, 48 passagens por camadas por token para 24 camadas armazenadas, resultando em 5,4 mil milhões de ativações de pesos por token. Durante o treino, o laboratório também eliminou dois terços dos especialistas (de 384 para 128) e depois reparou o modelo com 1 000 mil milhões de tokens destilados de um modelo Inkling interno maior. Segundo o laboratório, para a mesma perda, um modelo sem ciclos exigiria menos 7,5 % de computação no treino, mas mais 140 % de computação na inferência.
| Benchmark (tabela da Thinking Machines) | Inkling 2 Mini | Qwen3.8-27B | Nemotron 3.5 Super VL |
|---|---|---|---|
| Ativações de pesos por token / parâmetros totais | 5,4B / 26,4B | 27,0B / 27,0B | 12,0B / 124,5B |
| AA Index v5.0 | 20,1 | 20,1 | 13,6 |
| DeepSWE v1.1 | 48,2 % | 42,2 % | 24,7 % |
| SWE-bench Pro v2 Hard | 77,9 % | 73,8 % | 44,1 % |
| Terminal-Bench 2.1 (pi) | 71,6 % | 73,0 % | 60,7 % |
| BrowseComp | 79,0 % | 61,6 % | 78,9 % |
| MCP Atlas | 82,7 % | 77,3 % | 67,7 % |
Segundo Thinking Machines, o modelo lidera entre os modelos abertos com menos de 100 mil milhões de parâmetros no DeepSWE v1.1 e no Vals Index v2.2 (46,5 %). Fica atrás de Qwen3.8-27B no Terminal-Bench 2.1, e Thinking Machines reconhece que não é o melhor modelo pequeno em conversas de vários turnos (50,0 % no MultiChallenge) nem no cumprimento de instruções com múltiplas restrições (33,4 % no ComplexConstraints v1.1); a legenda do gráfico esclarece que as configurações de avaliação variam entre modelos. Investigadores de Stanford, com acesso antecipado, mediram 0,703 de inteligência por joule no DGX Spark, contra 0,430 para Qwen3.6-35B-A3B.
O laboratório também o usa como objeto de investigação sobre a monitorização da cadeia de pensamento (chain of thought): um modelo com ciclos faz mais computação sem a escrever, o que poderia escapar a um monitor. Numa variante com número variável de passagens, também publicada, a tarefa resolvida sem raciocínio escrito passa de 16 para 37 segundos de trabalho humano entre uma e três passagens. Com cinco passagens, o raciocínio é duas vezes mais curto (1 661 contra 3 703 tokens em média no GPQA Diamond) e mantém a mesma legibilidade; Thinking Machines não observa um aumento da sabotagem por agentes com o número de ciclos. O modelo está disponível em Tinker, Ollama, SGLang, vLLM, llama.cpp, MLX e Transformers, com versões GGUF na Unsloth.
🔗 Inkling 2 Mini (Thinking Machines) · Artigo da Hugging Face · Pesos no Hugging Face
Together AI disponibiliza Tencent Hy4, uma mistura de especialistas com 770 mil milhões de parâmetros, a 0,83 dólar por milhão de tokens de entrada
19 de novembro — Together AI acrescenta Tencent Hy4 à sua oferta de inferência serverless, com um contexto de um milhão de tokens, chamadas de ferramentas e saída JSON. Segundo o fornecedor de alojamento, o principal modelo da Tencent é uma mistura de especialistas com 770 mil milhões de parâmetros, dos quais 49 mil milhões ativos por token; sucede a Hy4 Preview, acrescenta a utilização de computador e torna-se o primeiro da família Hy a ler imagens.
| Preço por milhão de tokens | Together AI | Tencent (comunicado de 4 de novembro) |
|---|---|---|
| Entrada | 0,83 dólar | cerca de 0,90 dólar |
| Entrada em cache | 0,042 dólar | cerca de 0,045 dólar |
| Saída | 2,50 dólares | cerca de 2,70 dólares |
Tencent tinha lançado Hy4 a 4 de novembro, apresentando-o como um dos melhores modelos open source e prometendo os pesos dentro de poucos dias; o repositório tencent/Hy4 está no Hugging Face, sob uma licença do tipo «other». O seu comunicado citava uma avaliação financeira cega (213 profissionais, 579 tarefas) em que Hy4 obtinha 3,04, à frente de DeepSeek-V4.1-Flash-1017 (2,97), e uma taxa interna de alucinação reduzida de 12,95 % para 7,2 %.
🔗 Tencent Hy4 na Together AI · Comunicado da Tencent de 4 de novembro
Hugging Face publica a receita dos seus harness adapters e um superadaptador único para Qwen3.8-27B
20 de novembro — Após três dias de publicações, incluindo o adaptador Hermes abordado aqui ontem, Hugging Face disponibiliza a receita completa dos seus harness adapters: LoRA treinados por aprendizagem por reforço dentro de um harness de agente (pi, Hermes Agent ou OpenCode), sobre Qwen3.8-27B. A novidade é um superadaptador: os três LoRA de rank 32 são concatenados num único LoRA de rank 96, que funciona nos três harnesses. Como as suas atualizações são quase ortogonais (cosseno de 0,01 a 0,02), a combinação aplica exatamente as três.
| SWE-bench Pro (51 tarefas difíceis), com reflexão | Modelo de base | Com o superadaptador |
|---|---|---|
| Harness Hermes Agent | 45 % | 61 % |
| Harness OpenCode | 47 % | 67 % |
| Harness pi | 74 % | 74 % |
Com reflexão, a média dos seis pares harness-benchmark passa de 55,5 para 63,5 %, com menos 19 a 48 % de chamadas de ferramentas, segundo a sequência de publicações da equipa; sem reflexão, o superadaptador ganha 6 a 18 pontos no SWE-bench Pro, com menos 53 a 73 % de chamadas de ferramentas, segundo o artigo. As pontuações não são comparáveis entre harnesses, pois as suas configurações predefinidas diferem. O treino exigiu 598 etapas e 167 milhões de tokens; o mecanismo de proteção safeagents verificou 1,3 milhão de chamadas de ferramentas e bloqueou 647. As tarefas, os adaptadores, os GGUF e as trajetórias de avaliação estão publicados.
🔗 Harness adapters em escala (Hugging Face) · @yb2698 no X
Metric AI publica Ayb 0.5, OhanTTS e OhanASR, modelos abertos de texto e voz para arménio
20 de novembro — A equipa arménia Metric AI publica no mesmo dia três famílias de modelos para a sua língua. Ayb 0.5 reúne três modelos de linguagem (0,8B, 4B e 9B) construídos sobre Qwen3.5 e adaptados ao arménio, desde o tokenizer alargado até ao pós-treino; Ayb-9B suporta diálogo de vários turnos, chamadas de ferramentas e imagens. OhanTTS-v0.1 sintetiza voz em oito línguas, incluindo arménio e francês, e clona uma voz a partir de 3 a 10 segundos de áudio. OhanASR-v0.1, um modelo de reconhecimento de voz de 2B, foi afinado com 820 horas de arménio.
| Modelo da Metric AI | Resultado publicado pelos autores |
|---|---|
| Ayb-9B | 3.º na classificação geral do ArmBench (0,6164) |
| OhanTTS-v0.1, 61 horas de arménio | 14,70 % de WER, primeiro som em 331 ms numa GB10 |
| OhanASR-v0.1 | 16,12 % de WER (2.º) e 3,49 % de CER (1.º) no ArmBench-ASR |
Os pesos de Ayb-9B estão sob licença não comercial (CC BY-NC 4.0) e são acessíveis após validação manual.
🔗 Ayb 0.5 (Metric AI) · OhanTTS · OhanASR
Apple publica Depth Pro 2, que estima a profundidade em metros em fotografias e vídeos
19 de novembro — Apple publica Depth Pro 2, uma família de modelos que estimam a profundidade em metros, tanto em fotografias como em vídeos, na resolução nativa. Segundo o resumo do artigo, os métodos existentes tinham de escolher entre a coerência entre imagens consecutivas e a nitidez dos contornos; Depth Pro 2 procura alcançar ambas com uma única rede. Os pesos estão no Hugging Face em quatro tamanhos (S, B, L, H), com uma versão Core ML e um estimador de distância focal comum, útil quando falta a distância focal nos dados EXIF.
| Resolução processada por DepthPro2-L (334M, numa B200) | Imagens por segundo |
|---|---|
| VGA | 150,1 |
| 720p | 33,7 |
| 1080p | 9,1 |
| 4K | 0,7 |
Os pesos estão reservados à investigação não comercial (licença Apple Machine Learning Research Model), e o código está no GitHub. O lançamento foi assinalado a 20 de novembro por Pedro Cuenca, da Hugging Face, com uma demonstração online.
🔗 @pcuenq no X · Artigo arXiv 2611.26603 · DepthPro2-L (Hugging Face)
Segurança dos modelos: OpenAI contra a destilação adversarial, Sakana AI cria o seu Security Research Group
OpenAI detalha a sua luta contra a destilação adversária e reduz de 54,0 % para 0,2 % a extração do raciocínio protegido
20 de novembro — A OpenAI publica um artigo sobre a destilação adversária (adversarial distillation): a utilização não autorizada das saídas de um modelo de ponta para treinar outro, implementado sem as mesmas salvaguardas, por exemplo para ataques que o modelo original teria recusado. O artigo centra-se sobretudo no raciocínio protegido, a cadeia de pensamento produzida antes da resposta: segundo um estudo interno, um modelo aluno progride geralmente mais com os registos exatos de raciocínio do que com os respetivos resumos.
| Ataque medido (avaliação adaptativa, seis modelos atacantes) | GPT-6 Astra, salvaguardas originais | GPT-6.2 Astra, salvaguardas atualizadas |
|---|---|---|
| Raciocínio de um pedido anterior | 54,0 % | 0,2 % |
| Raciocínio do pedido atual | 22,9 % | 0,9 % |
A defesa combina treino adversário, classificadores de entrada e de saída (incluindo os argumentos das chamadas de ferramentas), controlos da API e investigações, com sanções semanais contra campanhas que envolvem alguns milhares a algumas dezenas de milhares de contas. Com GPT-6.2 Astra e Sol, o raciocínio protegido fica associado ao histórico que o produziu: a API descarta-o se uma mensagem anterior for reescrita, e as famílias de modelos mais antigas deixam de o poder ler. A OpenAI recorda ter comunicado ao Congresso, em fevereiro, uma atividade que indicava que a DeepSeek tentava destilar modelos americanos, tendo depois atribuído, em setembro, uma campanha a indivíduos associados à Moonshot AI; afirma apoiar o Chip Security Act, o AI OVERWATCH Act e o MATCH Act.
🔗 Combate à destilação adversária (OpenAI) · @OpenAI no X
Sakana AI cria o seu Security Research Group, uma equipa independente para a ciberdefesa coletiva
20 de novembro — A Sakana AI lança o seu Security Research Group, uma equipa de R&D independente sediada em Tóquio, separada da sua atividade comercial e orientada para o interesse público.
Excited to announce the Sakana AI Security Research Group, an independent, public-interest R&D team in Tokyo co-led by Akihiro Umegai and me.
🇵🇹 É com satisfação que anuncio o Sakana AI Security Research Group, uma equipa de R&D independente e de interesse público, em Tóquio, coliderada por Akihiro Umegai e por mim. — @hardmaru no X
David Ha é cofundador e diretor-geral da Sakana AI. A equipa trabalhará em três eixos: a prevenção desde a conceção, a defesa coletiva através de agentes distribuídos por várias organizações e a segurança dos próprios agentes defensores, cuja autoridade será limitada à sua tarefa e cujas ações serão registadas. Parte de trabalhos internos como Digital Red Queen, ShinkaEvolve e Fugu-Cyber, para o qual a Sakana AI anuncia 86,9 % no CyberGym e 72,1 % no CTI-REALM; uma nota do artigo esclarece que a página do Fugu-Cyber não apresenta pontuações de referência nem um protocolo de avaliação. Publicará livros brancos, bancos de ensaio e guias defensivos, mas não material de exploração, e as vulnerabilidades encontradas passarão por divulgação coordenada. A Sakana AI recorda que os pedidos de CVE aumentaram 263 % entre 2020 e 2025, segundo o NIST.
🔗 Security Research Group (Sakana AI)
Agentes ligados à entrega de software: a fábrica da Runway, Stitch Loop do Google Labs
Runway confia a sua cadeia de entrega de software a agentes, que geriram 38 % dos seus merges de outubro
20 de novembro — A Runway publica no seu blog de engenharia o balanço quantitativo da sua «fábrica de software» (software factory): sete etapas, da escrita do código à coordenação dos merges, confiadas uma a uma a agentes. Os agentes cloud geriram 38 % das pull requests integradas em outubro e, de 100 dessas PR integradas na primeira metade de novembro, 78 não continham qualquer commit humano.
| Indicador da fábrica de software | Ponto de partida | Última medição |
|---|---|---|
| Merges geridos por agentes cloud | 0,1 % (junho) | 38 % (outubro) |
| Espera mediana por uma primeira aprovação | 2,3 h (setembro) | cerca de 5 min (meados de novembro) |
| Média semanal de merges | 929 (setembro) | 2 235 (desde meados de outubro) |
Desde meados de outubro, a IA aprova sozinha as PR classificadas como de baixo risco e, se o repositório o permitir, as de risco médio; as de risco elevado ficam a cargo de uma pessoa, e os responsáveis pelo código continuam sempre a aprovar as migrações, a configuração de CI e de deploy, os segredos e a autenticação. Em setembro e outubro, uma pessoa contestou 15 das 977 PR aprovadas pela IA, e os merges aprovados apenas pela IA têm uma taxa de reversão de 0,10 %, contra cerca de 1 em 200 nas aprovações humanas. Há também agentes que testam o App Studio como um utilizador (86 bugs confirmados em quatro dias), e um coordenador distribuiu mais de 14 000 tarefas em duas semanas. São ferramentas internas, sem produto nem preço.
🔗 Construir uma fábrica de software (Runway)
Google Labs lança Stitch Loop, um agente de produto que melhora continuamente uma aplicação em produção
18 de novembro — O Google Labs apresenta Stitch Loop, um agente de produto de longa duração que retoma o trabalho onde um agente de código termina: depois da entrada em produção. Liga-se ao repositório GitHub e aos dados do produto em produção (registos, comportamento dos utilizadores, feedback) através de mais de 180 integrações, servidores MCP personalizados ou envios a partir de uma CLI local, e trabalha continuamente para atingir objetivos mensuráveis.
Cada ciclo propõe pistas apoiadas nos dados, detalha as soluções e os respetivos compromissos, escreve o código num sandbox cloud isolado e abre uma pull request para aprovação, observando depois as métricas em direto. São disponibilizados três ciclos de base (cibersegurança, latência, acessibilidade); o de segurança associa Gemini 4 Carbon ao CodeMender, o agente de segurança do código da Google DeepMind. Nada é integrado sem revisão da equipa. Stitch Loop também serve de fonte de contexto do produto para agentes de código como Google Antigravity, através da CLI Stitch e de MCP, e pode ser utilizado no Slack. Por enquanto, apenas está aberta uma lista de espera, em todo o mundo, com acesso prioritário para os subscritores elegíveis do Google AI Ultra.
Assistentes para o grande público: ChatGPT Space para subscritores Plus, GIF na aplicação Gemini, Perplexity Computer nos navegadores Chromium
ChatGPT Space chega aos subscritores Plus de todo o mundo
20 de novembro — ChatGPT Space, apresentado no DevDay de 29 de setembro e até agora reservado aos planos Pro, Business e Enterprise, está a ser disponibilizado em todo o mundo aos subscritores Plus com 18 anos ou mais. Space substitui a Biblioteca na barra lateral (páginas, diapositivos, imagens, ficheiros carregados), na web, na aplicação para computador, em iOS e em Android.
Permite criar com ChatGPT páginas interativas e apresentações que outras pessoas com acesso ao Space podem enriquecer. As páginas e os diapositivos podem atualizar-se automaticamente a partir das aplicações ligadas: a OpenAI dá como exemplos uma lista de tarefas que se atualiza sozinha ou um plano de projeto que acompanha as decisões tomadas no Slack. Basta mencionar ChatGPT num comentário para pedir uma alteração, e é possível convidar um dot para colaborar. A partilha continua restrita: é necessária uma permissão de leitura e uma conta Plus, Pro, Business ou Enterprise com acesso ao Space; as contas Free não conseguem abrir os conteúdos partilhados, e não existe uma ligação pública.
A aplicação Gemini cria GIF animados com Gemini Omni 1.2 Flash, gratuitamente em França
20 de novembro — A aplicação Gemini passa a criar GIF animados (efeitos fotográficos em ciclo, memes) com Gemini Omni 1.2 Flash, o modelo de vídeo lançado pela Google a 5 de novembro, para proporcionar movimentos fluidos e uma qualidade constante entre fotogramas, segundo a Google. O utilizador escreve o pedido no chat principal ou abre a ferramenta de imagem ou de vídeo e, em seguida, escolhe GIF no seletor de formato.
GIFs are now available to all Google AI subscribers and free of charge in the U.S., Japan, Korea, Australia, Canada, U.K., Germany, and France.
🇵🇹 Os GIF estão agora disponíveis para todos os subscritores Google AI e gratuitamente nos Estados Unidos, no Japão, na Coreia, na Austrália, no Canadá, no Reino Unido, na Alemanha e em França. — @GeminiApp no X
Os utilizadores em França sem subscrição têm, portanto, acesso. A Google segue a OpenAI, cujos GIF animados no ChatGPT com Images 2.6 foram abordados aqui a 5 de novembro.
🔗 @GeminiApp no X: os GIF no Gemini
Perplexity Computer funciona diretamente nos navegadores Chromium graças à extensão Perplexity
20 de novembro — Perplexity Computer passa a funcionar diretamente nos navegadores baseados em Chromium, graças à extensão Perplexity. O utilizador atribui uma tarefa a partir do painel lateral da extensão e acompanha depois o Computer enquanto este trabalha nos seus separadores e ferramentas. O tweet de anúncio não especifica os planos abrangidos nem a lista de navegadores suportados.
Há dois antecedentes: a 5 de outubro, a aplicação Mac 26.38.0 permitia ao Computer utilizar Chrome, Edge ou Brave através de uma extensão e, a 30 de outubro, uma extensão Chrome ligava as aplicações Mac e Windows do Computer ao navegador do utilizador. Desta vez, a tarefa é atribuída a partir do painel lateral da extensão, no navegador.
API e SDK para programadores: Codex no Agents SDK Python, Decider na Context API da Perplexity
O Agents SDK Python da OpenAI publica uma versão preliminar 1.0 que torna Codex um fornecedor de modelos
20 de novembro — O Agents SDK Python da OpenAI inicia a sua série 1.0 com uma versão preliminar que muda de abordagem: em vez de um motor nativo separado, como na versão preliminar 0.24 abordada aqui a 16 de novembro, Codex torna-se um fornecedor de modelos que se escolhe em cada execução. Cria-se um CodexProvider e passa-se ao Runner através de RunConfig(model_provider=provider); o agente passa então a executar-se com a ligação Codex guardada ou com uma chave de API.
O wheel Python inclui Codex Core (rust-v0.166.0, não modificado) através de PyO3: o SDK chama diretamente o núcleo do Codex, sem iniciar codex app-server nem passar por JSON-RPC. As ferramentas Python, as transferências para um agente especialista (handoffs), a aprovação antes de utilizar uma ferramenta e a saída tipada continuam disponíveis, e os comandos nativos seguem o sandbox e as regras de aprovação do Codex. Os wheels 1.0.0a1 são distribuídos exclusivamente através de GitHub Releases (Linux x86-64 e ARM64, macOS 11 ou posterior em Apple silicon, Windows x64, CPython 3.10 a 3.14). As cópias de segurança da versão preliminar 0.24.0-alpha.8 não são compatíveis com o Runner, e a versão estável continua a ser a 0.25.0 de 18 de novembro.
🔗 openai-agents-python v1.0.0-alpha.1
Perplexity adiciona Decider à Context API para pontuar páginas, incluindo injeções de prompt
19 de novembro — A Perplexity adiciona Decider, o seu modelo de decisão, à Context API lançada dois dias antes (1 dólar por 1 000 URL). É possível colocar até cinco perguntas fechadas (sim ou não) sobre cada página obtida, e Decider atribui a cada resposta uma pontuação de 0 a 1. A utilização destacada está relacionada com a segurança: detetar uma injeção de prompt (prompt injection) numa página antes de um agente a ler. A Perplexity refere também a qualificação de potenciais clientes, a moderação e a deteção de alegações de saúde sem fonte.
A API não filtra nada por si só: devolve todas as páginas com as respetivas pontuações, e é o código da aplicação que aplica um limiar. A pontuação é faturada em tokens de entrada da Decisions API, além do preço por URL, e pode prolongar o pedido em até 15 segundos. O cookbook da documentação mostra um controlo executado a 18 de novembro com um limiar de 0,7:
| Página testada (cookbook de 18 de novembro) | Pontuação de injeção | Decisão do controlo |
|---|---|---|
| Demonstração de injeção (Greshake et al., 2023) | 0,97 | colocada em quarentena |
| OWASP, página sobre injeção de prompt | 0,0018 | encaminhada |
| RFC 9111 | 0,0007 | encaminhada |
O cookbook adverte que uma pontuação baixa não torna uma página segura: segundo a investigação BrowseSafe++ da Perplexity, cada modelo testado ainda seguia algumas injeções que ele próprio tinha assinalado.
🔗 Thread de @perplexitydevs · Documentação · Cookbook
Agentes de código: Claude Code 2.1.329, Codex CLI 0.171.0, Vibe CLI 3.1.4 e Gemini 4 Neon no Devin
Claude Code 2.1.329 indica a origem dos hooks ao abrir uma pasta e reúne as tarefas agendadas em /tasks
19 de novembro — Claude Code 2.1.329 conta com 130 entradas, incluindo 91 correções, 20 alterações e 7 adições. Na segurança, a caixa de diálogo que pergunta se se confia numa pasta passa a indicar onde os seus hooks estão declarados, e tanto Claude Desktop como os restantes anfitriões não interativos avisam quando os hooks impostos pelas definições geridas (managed settings) não são carregados. /tasks também lista as tarefas agendadas da sessão, os despertares de /loop, o objetivo em curso e os forks da conversa; a maioria das tarefas agendadas registadas pelas versões anteriores terá de ser reagendada.
/code-review sem alvo passa a rever, na maioria dos modelos, todo o branch em relação ao branch predefinido e, com um número de PR, analisa a própria PR através de gh pr diff. No macOS, computer use passa a seguir regras de segurança mais recentes, que recusam certas ações. A nova tentativa automática adicionada na 2.1.326 após um erro max_tokens é removida: quando se utiliza um gateway, é necessário configurar CLAUDE_CODE_MAX_OUTPUT_TOKENS. Code Mode recebe 17 entradas, incluindo compatibilidade com eventos e métricas OpenTelemetry. A 2.1.330 está publicada no npm desde 20 de novembro.
Codex CLI 0.171.0 define GPT-6.2 Sol como predefinição e ativa o espaço de trabalho do terminal
20 de novembro — Codex CLI 0.171.0 é a primeira versão estável desde a 0.170.0 de 18 de novembro e reúne 339 pull requests. GPT-6.2 Sol e GPT-6.2 Astra passam a integrar os catálogos de modelos, com Sol selecionado por predefinição, e os comandos /rc e /remote gerem a partir do terminal o controlo remoto local e apresentam os códigos de emparelhamento dos dispositivos.
Várias novidades das versões preliminares de 14 a 17 de novembro passam à versão estável: o espaço de trabalho da TUI, ativado por predefinição, apresenta pré-visualizações de documentos e imagens e transcrições dos subagentes ao lado da conversa; codex exec --remote inicia ou retoma uma sessão não interativa num servidor de aplicações existente; o editor de mensagens ganha as funções anular e refazer; /statusline seleciona linhas de estado fornecidas por um servidor MCP, mediante uma opção. Entre as correções, os rascunhos e as novas tentativas em fila continuam associados à respetiva conversa, e a ligação MCP empresarial funciona com fornecedores de identidade que não emitem um token de atualização.
Vibe CLI 3.1.4 separa o agente da política de aprovação e retira aos agentes o direito de dispensar confirmações
20 de novembro — A Mistral publica o Vibe CLI 3.1.4, dois dias depois da 3.1.3, que tornou o Mistral Large 4 o modelo predefinido. As suas 79 entradas (18 adições, 41 alterações, 18 correções, 2 remoções) incidem sobretudo nas permissões: cada sessão combina agora duas definições independentes, um agente (default, lean ou personalizado) e uma política de aprovação (ask, accept-edits, smart-approve ou auto-approve), escolhida através de --approval-policy ou default_approval_policy.
Um agente deixa de decidir sozinho o que é executado sem pedir confirmação: as suas definições safety, bypass_tool_permissions e permission = "always" são ignoradas. Um projeto deixa de poder redefinir uma política de aprovação na sua pasta .vibe/agents/, e tanto os forks como as sessões filhas herdam a política original. A interface ganha uma faixa de etiquetas acima do campo de entrada (subagentes, tarefas em segundo plano, pull requests, objetivo, tarefas), uma definição keep_awake impede a suspensão durante um turno, e o Vibe aceita os certificados do sistema, o que o ajuda a funcionar atrás de um proxy empresarial. Apenas as 8 imagens mais recentes são agora enviadas aos modelos Mistral, e os prompts de compactação personalizados são removidos.
Devin disponibiliza Gemini 4 Neon, com 46,2 % no FrontierCode 2.0 por 4,38 dólares por tarefa
19 de novembro (publicação datada de 18) — Depois do Cursor e do GitHub Copilot, abordados aqui ontem, a Cognition disponibiliza o Gemini 4 Neon no Devin Desktop e no Devin CLI. No FrontierCode 2.0, o seu benchmark que avalia se uma pull request merece ser integrada, o Neon obtém 46,2 %, o melhor resultado de um modelo Google segundo a Cognition. Fica a cerca de um ponto do Claude Opus 5.5 (47,3 %) por cerca de um terço do custo: 4,38 dólares por tarefa contra 12,82 dólares.
| Modelo avaliado no FrontierCode 2.0 | Pontuação publicada pela Cognition |
|---|---|
| Claude Fable 5.2 | 50,2 % |
| Claude Opus 5.5 | 47,3 % |
| Gemini 4 Neon | 46,2 % |
| GPT-6.2 Astra | 44,2 % |
| GPT-6.2 Sol | 43,8 % |
| Gemini 4 Carbon | 42,6 % |
O custo corresponde à despesa média por execução ao preço de tabela da API, incluindo descontos públicos, e uma solução que falhe um critério eliminatório recebe uma pontuação nula. Várias pontuações deste gráfico diferem dos valores publicados nas semanas anteriores, sem explicação na publicação.
🔗 Gemini 4 Neon no Devin (Cognition) · @cognition no X
Ciência: OpenAI publica MedChemBench, um benchmark de química medicinal no qual GPT-6.2 Astra obtém 84,5 %
20 de novembro — A OpenAI apresenta o MedChemBench, um benchmark que mede a capacidade dos modelos para raciocinar como um químico medicinal: relacionar a estrutura de uma molécula com os resultados experimentais, comparar compostos, prever as suas propriedades. Reúne 99 problemas retirados de 117 artigos e patentes, com 761 estruturas moleculares distintas, e avalia quatro componentes: estruturas, raciocínio científico, seleção de compostos e previsão de propriedades.
| Modelo avaliado (nível de raciocínio xhigh) | Crédito obtido |
|---|---|
| GPT-6.2 Astra | 84,5 % |
| GPT-6 Astra | 83,3 % |
| GPT-6.1 Sol | 82,0 % |
| GPT-6.1 Terra | 75,1 % |
| GPT-5.6 Sol | 58,2 % |
O desempenho é desigual: o GPT-6 Astra obtém 95,4 % do crédito nas estruturas, mas cerca de metade na seleção de compostos e na previsão de valores numéricos. A OpenAI mantém a prudência: o benchmark incide sobre dados históricos e não demonstra que os modelos possam descobrir novos medicamentos, não se pode excluir uma exposição prévia às publicações de origem, e apenas foram avaliados modelos GPT. Surge na sequência do BioBasicsBench, abordado aqui a 6 de novembro.
🔗 Apresentação do MedChemBench (OpenAI) · Artigo completo (PDF)
Vídeo e áudio generativos: ElevenLabs acrescenta ao Ads Engine variantes de anúncios sem novas filmagens
20 de novembro — A ElevenLabs melhora o Ads Engine, a sua ferramenta de criação publicitária integrada no ElevenCreative e lançada em junho. Ligada às contas publicitárias do Google, Meta, LinkedIn e agora TikTok, parte dos anúncios existentes e dos seus resultados para produzir variantes sem novas filmagens. Identifica a frase de abertura que capta a atenção (hook) e escreve novas versões com base nos anúncios que tiveram sucesso; estas são ditas por uma réplica digital da voz do orador original, com sincronização labial e legendas atualizadas. As novas bandas sonoras, compostas pela API ElevenLabs Music com base no tom e no ritmo das imagens, podem ser utilizadas comercialmente.
Para a localização, já assegurada pelo Dubbing v2, o Ads Engine passa a sincronizar os lábios do orador com a língua de destino e a substituir as legendas incorporadas por uma versão traduzida, com a temporização e os tipos de letra da marca. Continua a ser possível uma revisão humana antes da divulgação, incluindo por um profissional de localização nativo, e a ferramenta pode publicar diretamente nas plataformas. O acesso é feito através da equipa comercial, sem preço publicado.
🔗 Variantes e localização de anúncios em vídeo no Ads Engine (ElevenLabs)
Breves
Agentes de código
- Copilot CLI 1.0.115-2 — Nesta versão de pré-lançamento com 351 entradas, das quais 335 são correções, o Gemini 4 Hydrogen passa a constar do seletor com o esforço Extra High quando a conta tem acesso, o GPT-6.2 Astra é suportado, e
/modeltambém gere modelos de fornecedores personalizados; a versão estável continua a ser a 1.0.114. 🔗 fonte - Codex CLI 0.173.0-alpha.1 e alpha.2 — As notas destas versões de pré-lançamento estão vazias; segundo os títulos dos 71 commits, a partilha de ligações MCP e a descoberta OAuth dos servidores configurados passam a estar ativadas por predefinição, e os administradores poderão desativar as atualizações do daemon Codex. O conteúdo pode mudar antes da versão estável. 🔗 fonte
- Gemini CLI — Primeira nightly desde 4 de novembro (v0.71.0-nightly.20261120); no ramo principal,
gemini --resumereabre a sessão utilizada mais recentemente e não a última iniciada, e os caminhos que começam por~\são finalmente expandidos no Windows. 🔗 fonte - Antigravity IDE 2.8.0 — O editor da Google inicia o seu backend instantaneamente e verifica as atualizações em segundo plano, encaminha automaticamente as portas para a ligação remota, permite pesquisar numa conversa através do teclado e aceita certificados personalizados e proxy na ligação. 🔗 fonte
- Qwen Code 0.28.1-preview.1 — Esta versão de pré-lançamento com 179 entradas torna o GitHub o terceiro adaptador de canal suportado, acrescenta WeCom, Microsoft Teams e webhooks de saída genéricos configuráveis a partir da interface web, e traz ao CLI uma apresentação para leitores de ecrã; a versão estável continua a ser a v0.28.0. 🔗 fonte
- Kimi Code 2.7.1 e 2.7.2, Kimi Code Desktop 1.4.1 e 1.4.2 — Quatro versões corretivas no dia seguinte à 2.7.0: o esforço de raciocínio escolhido num rascunho deixa de voltar ao valor predefinido após o envio, e os forks deixam de falhar após o restauro de uma sessão redirecionada durante um turno. 🔗 fonte
- CLI mistral 0.20.1 —
mistral evals execpassa a terminar com falha (código 1) quando todas as chamadas de uma execução falham, por exemplo devido a um erro 401, em vez de a declarar bem-sucedida; uma interrupção por Ctrl-C é assinalada como tal. 🔗 fonte - Replit — Os espaços de trabalho (Workspaces) passam a poder ser pesquisados e fixados, uma opção que só aparece a partir de cinco espaços. 🔗 fonte
- Devin Bot para Manim — A Cognition mostra o Devin Bot que Grant Sanderson configurou para o ajudar no Manim, o sistema de animação open source dos vídeos de 3Blue1Brown (96,6 k estrelas, 250 000 transferências por mês); o tweet não especifica as tarefas confiadas ao bot nem os seus resultados. 🔗 fonte
API e plataformas
- API Gemini — Desde 17 de novembro, o Gemini 3.5 Transcribe, tanto na versão clássica como em direto, modifica, reescreve e formata por voz um ditado ou um texto existente (parâmetro
source_text), e a Google também menciona a tradução. Desde dia 18, a API permite processar, e pagar, apenas a parte útil dos ficheiros enviados: intervalos de páginas, separadores, células, intervalos de tempo ou camadas de conteúdo. 🔗 fonte - Consciência do tempo na API Agents — Uma opção experimental (
experimental={"time_awareness": True}) recorda regularmente a hora ao modelo para que adapte o seu trabalho a um prazo; combinada com ferramentas assíncronas, permite a um agente fazer uma pergunta e continuar a pesquisar enquanto espera pela resposta, como mostra uma publicação no blog de programadores da OpenAI. 🔗 fonte - Histórico de conversas com GPT-6.2 — @OpenAIDevs pede que se deixe de modificar as mensagens anteriores na Responses API, porque a API descarta o raciocínio que se segue à alteração. Uma nova secção Reasoning removals no painel Usage ajuda a detetá-lo, e o guia associado propõe acrescentar um elemento
configuration_updateouadditional_toolspara alterar o esforço ou as ferramentas. 🔗 fonte
Assistentes para o público em geral
- ChatGPT disponibiliza uma nova aplicação móvel com um separador para o dot e favoritos fixados — Codex, Projects ou Images podem ser fixados na barra de separadores; a disponibilização começa pelos utilizadores Pro com 18 anos ou mais onde existem dots, fora do Espaço Económico Europeu (incluindo a UE), Reino Unido, Suíça e Coreia, e por um pequeno grupo de utilizadores Plus (notas de versão de 19 de novembro, com ligação acima).
- Teammates da Perplexity — Os subscritores Max podem agora criar um teammate a partir de qualquer tarefa Computer na web e depois alterar o seu nome, função ou avatar na mesma conversa. 🔗 fonte
- Aplicação Mac da Perplexity — Mais rápida, acrescenta «Send now» para redirecionar uma tarefa em curso, ⌘F para pesquisar em tabelas, Markdown e pré-visualizações, e ⌘⇧T para reabrir um separador fechado. 🔗 fonte
Vídeo e áudio generativos
- Seedance 2.5 Flash no Pika — Depois do Runway e do HeyGen, o Pika acrescenta a variante rápida do modelo de vídeo da ByteDance para trabalhos com muitas tomadas: vídeos até 30 segundos em 480p ou 720p, até 10 imagens, 5 vídeos e 5 clips de áudio como referência; o tweet não indica preços. 🔗 fonte
- Avatar 6 da HeyGen — Novos testes cegos retirados do relatório técnico: quando as pessoas filmadas, funcionários da HeyGen, escolhem o vídeo que mais se lhes assemelha, o Avatar 6 vence com 86,5 % face ao Seedance 2.5 e com 87,9 % face ao Wan 3.0; estas avaliações são conduzidas pela HeyGen. 🔗 fonte
- Qwen3 TTS na Together AI — A síntese de voz aberta Qwen3-TTS-12Hz-1.7B (Apache 2.0) é disponibilizada a 20 dólares por milhão de caracteres, com nove vozes ajustáveis através de uma instrução em linguagem corrente, dez línguas, incluindo francês, e um primeiro som em 97 ms no melhor dos casos. 🔗 fonte
Infraestrutura e investigação
- Together Storage Accelerator — A Together AI oferece, com cada cluster GPU, uma cache NVMe para o armazenamento S3 e o Hub Hugging Face, sem alterações de código; segundo as suas medições, um ficheiro de 2 Gio lido a partir do Cloudflare R2 passa de 12,7 a 15,0 s para 0,64 a 0,72 s, e um cluster de 200 nós só o transfere uma vez a partir da origem. 🔗 fonte
- CDN da Hugging Face — A Hugging Face serve perto de um exabyte de modelos e conjuntos de dados abertos por mês, segundo o seu cofundador Julien Chaumond, e construiu a sua própria rede de distribuição (CDN) para transferências de IA. 🔗 fonte
- Superfluid da basecompute — O servidor local passa a distribuir a inferência entre máquinas Apple, AMD e NVIDIA: seis máquinas aumentam o débito de 112 para 534 tokens de saída por segundo para 64 utilizadores simulados, e a paragem de um nó não provoca a perda de nenhum pedido, segundo o fornecedor. 🔗 fonte
- WavLate — Este modelo aberto de interação tardia pesquisa sons através de texto e texto através de som, com um vetor por cada 0,31 segundo de som e um por palavra; o seu autor anuncia um Recall@1 médio de 37,9 no AudioCaps e no Clotho, o melhor dos nove modelos abertos comparados, e publica os pesos e os dados. 🔗 fonte
- WorldTrace — A NVIDIA Research apresenta uma memória para modelos do mundo em vídeo interativos, sem novo treino (artigo aceite na NeurIPS 2026): no LoopBench, a recordação de cenas revisitadas melhora 32,6 % face à janela deslizante, com 3,1 Go de memória GPU e mais 27 % de tempo de execução. 🔗 fonte
- Dynamo para aprendizagem por reforço — A NVIDIA detalha como o Dynamo serve os rollouts do pós-treino: encaminhamento segundo a cache KV, transferência diferencial de pesos com ModelExpress, recuperação de processos de trabalho que falharam. A Microsoft AI, a Cognition (para o SWE-1.7), a Prime Intellect e a H Company utilizam-no; a H Company poupa até 20 % de tempo por etapa de treino. 🔗 fonte
- Atenção esparsa — Num guia de 17 de novembro, a NVIDIA apresenta oito regras de conceção para a atenção esparsa treinada nos seus GPU; o indexador que escolhe os tokens e o Top-k representam 47 % de uma camada de prefill do DeepSeek V3.2 a 128K tokens. 🔗 fonte
GitHub
- GitHub Enterprise Server 3.23 em release candidate — A deteção de segredos por IA, em pré-visualização pública, é executada no processador do appliance, sem GPU, sem LLM alojado nem ligação de saída, incluindo em ambientes isolados (air-gapped); a versão também alarga a deteção de pacotes maliciosos conhecidos a mais sete ecossistemas além do npm. 🔗 fonte
- Fora da IA — O GitHub clarifica o estado de integração na nova página Overview das pull requests, o GitHub Desktop 3.7.0 aceita várias contas no mesmo host, e o painel apresenta até 25 repositórios favoritos. 🔗 Overview · 🔗 Desktop · 🔗 favoritos
Empresas e ensaios
- Hebbia — Nos seus testes de investigação financeira de agosto e setembro, uma versão de pré-lançamento do GPT-6 Astra cita 99,5 % de excertos pertinentes e cumpre 97,9 % dos requisitos de apresentação, 14,4 pontos à frente da melhor alternativa testada, que o estudo de caso publicado pela OpenAI não identifica. 🔗 fonte
- O consenso silencioso — A OpenAI publica na sua secção A era da inteligência (Intelligence Age) um ensaio de Dean Ball, adaptado de uma conferência em Harvard e apresentado como refletindo as opiniões do autor, contra a ideia de que o abandono da primazia humana seria inevitável; defende agentes associados a pessoas, com permissões limitadas e revogáveis. 🔗 fonte
- Enriquecimento de dados — Um guia da Perplexity descreve como completar e verificar fichas CRM com um modelo ligado à web, em seis etapas; a Apollo faz passar 5,6 milhões de enriquecimentos por mês pela API da Perplexity. 🔗 fonte
O que isto significa
A entrada em bolsa da Anthropic reúne, numa mesma publicação, o dinheiro dos mercados e o da indústria. A oferta pública rende à empresa cerca de 91,6 mil milhões de dólares brutos, e a colocação privada mais 26 mil milhões, subscritos ao mesmo preço de 83 dólares por sete grupos dos setores dos semicondutores e da informática: AMD, Broadcom, Google, Micron, Microsoft, NVIDIA e TSMC Partners. No total, a operação aproxima-se dos 119,5 mil milhões de dólares brutos: a par dos investidores da oferta, sete grupos da indústria compram ações de um laboratório de IA agora cotado no Nasdaq.
A segurança é cada vez mais definida na própria mecânica das ferramentas. A OpenAI vincula o raciocínio do GPT-6.2 ao histórico que o produziu, o que faz cair a taxa de extração medida de 54,0 % para 0,2 %, mas exige que os programadores deixem de reescrever as suas conversas. O Vibe CLI retira aos agentes o direito de dispensarem por si mesmos as confirmações, o Claude Code mostra de onde vêm os hooks de uma pasta antes de se confiar nela, e o Decider atribui pontuações às páginas antes de um agente as ler. Por sua vez, a Sakana AI cria uma equipa dedicada à defesa coletiva, prometendo não publicar material de exploração de vulnerabilidades.
Os agentes saem da escrita de código para entrar na cadeia de entrega. Na Runway, gerem 38 % dos merges de outubro e a IA aprova sozinha as alterações de baixo risco; o Stitch Loop monitoriza um produto online e abre pull requests para atingir um objetivo mensurável. Em ambos os casos, uma pessoa mantém o controlo sobre o que conta: as áreas sensíveis na Runway, cada merge no Stitch Loop. As ferramentas acompanham esta evolução: o Agents SDK Python torna o Codex um fornecedor de modelos, e a Cognition avalia os modelos com base na questão que estas cadeias colocam, ou seja, se a PR deve ser integrada.
Quanto aos modelos abertos, o esforço centra-se no que se consegue extrair de pesos mais leves. O Inkling 2 Mini percorre três vezes as suas camadas intermédias para igualar o Qwen3.8-27B no AA Index com 20 GB, o superadaptador da Hugging Face faz caber três especializações num único LoRA, e a Metric AI parte do Qwen3.5 para construir modelos arménios. Os números continuam a ser os divulgados pelos fornecedores, e o MedChemBench recorda os limites do exercício: a OpenAI avalia aí apenas os seus próprios modelos e não exclui a possibilidade de terem visto as publicações de origem.
Fontes
- Conclusão da entrada em bolsa (Anthropic)
- @AnthropicAI no X: os cofundadores
- Inkling 2 Mini (Thinking Machines)
- Publicação da Hugging Face sobre o Inkling 2 Mini
- Inkling-2-Mini (Hugging Face)
- Tencent Hy4 na Together AI
- Comunicado da Tencent sobre o Hy4
- Adaptadores de harness em escala (Hugging Face)
- @yb2698 no X: o superadaptador
- Ayb 0.5 (Metric AI)
- OhanTTS (Metric AI)
- OhanASR (Metric AI)
- @pcuenq no X: Depth Pro 2
- Artigo arXiv 2611.26603: Depth Pro 2
- DepthPro2-L (Hugging Face)
- Combater a destilação adversarial (OpenAI)
- @OpenAI no X: a destilação adversarial
- @hardmaru no X: o Grupo de Investigação de Segurança
- Grupo de Investigação de Segurança (Sakana AI)
- Construir uma fábrica de software (Runway)
- Stitch Loop (Google)
- Notas de versão do ChatGPT
- @GeminiApp no X: disponibilidade dos GIF
- @GeminiApp no X: os GIF no Gemini
- @perplexity_ai no X: Computer no Chromium
- openai-agents-python v1.0.0-alpha.1
- @perplexitydevs no X: Decider na Context API
- Pontuar páginas com critérios (documentação da Perplexity)
- Cookbook contra injeção (documentação da Perplexity)
- Claude Code v2.1.329
- Codex CLI 0.171.0
- Vibe CLI v3.1.4
- Gemini 4 Neon no Devin (Cognition)
- @cognition no X: Gemini 4 Neon
- Apresentação do MedChemBench (OpenAI)
- Artigo completo do MedChemBench (PDF)
- Variantes e localização dos anúncios em vídeo no Ads Engine (ElevenLabs)
- Copilot CLI 1.0.115-2
- Codex CLI 0.173.0-alpha.2
- Gemini CLI, PR 30389
- Changelog do Antigravity
- Qwen Code v0.28.1-preview.1
- Kimi Code 2.7.2
- CLI mistral 0.20.1
- Changelog da Replit de 20 de novembro
- @cognition no X: Devin Bot para Manim
- Notas de versão da API Gemini
- Perceção do tempo e entrada assíncrona para agentes pessoais (OpenAI)
- @OpenAIDevs no X: histórico e raciocínio do GPT-6.2
- @AskPerplexity no X: teammates a partir do Computer
- @AskPerplexity no X: aplicação Mac
- @pika_labs no X: Seedance 2.5 Flash
- @HeyGen no X: testes cegos do Avatar 6
- Qwen3 TTS na Together AI
- Together Storage Accelerator (Together AI)
- @julien_c no X: o CDN da Hugging Face
- Superfluid em frota (basecompute)
- WavLate (Hugging Face)
- @NVIDIAAI no X: WorldTrace
- Dynamo e os rollouts de RL (NVIDIA)
- Atenção esparsa em GPU NVIDIA (NVIDIA)
- GitHub Enterprise Server 3.23 release candidate (changelog do GitHub)
- Página Overview dos pull requests (changelog do GitHub)
- GitHub Desktop e várias contas por anfitrião (changelog do GitHub)
- Repositórios favoritos no painel (changelog do GitHub)
- Hebbia e GPT-6 Astra (OpenAI)
- O consenso silencioso (OpenAI)
- Enriquecimento de dados com IA (Perplexity)