ai-powered-markdown-translatorArtikel mit gpt-6.1-sol aus dem Französischen ins Deutsche übersetzt.
Anthropic schließt seinen Börsengang ab: rund 93,5 Milliarden Dollar Bruttoerlös aus dem Angebot und weitere 26 Milliarden, die sieben Konzerne, darunter NVIDIA, Google und Microsoft, im Rahmen einer parallel durchgeführten Privatplatzierung einzahlen. Thinking Machines veröffentlicht Inkling 2 Mini, ein Modell mit offenen Gewichten und 26,4 Milliarden Parametern, das in 20 GB passt, und OpenAI senkt die Erfolgsquote von Angriffen, die das geschützte Reasoning seiner Modelle extrahieren, von 54,0 % auf 0,2 %. ChatGPT Space wird für Plus-Abonnenten geöffnet, Runway überlässt Agenten 38 % seiner Code-Merges, und Claude Code, Codex CLI und Vibe CLI veröffentlichen jeweils eine neue Version.
Finanzen: Anthropic schließt seinen Börsengang mit 93,5 Milliarden Dollar Bruttoerlös und einer Privatplatzierung über 26 Milliarden ab
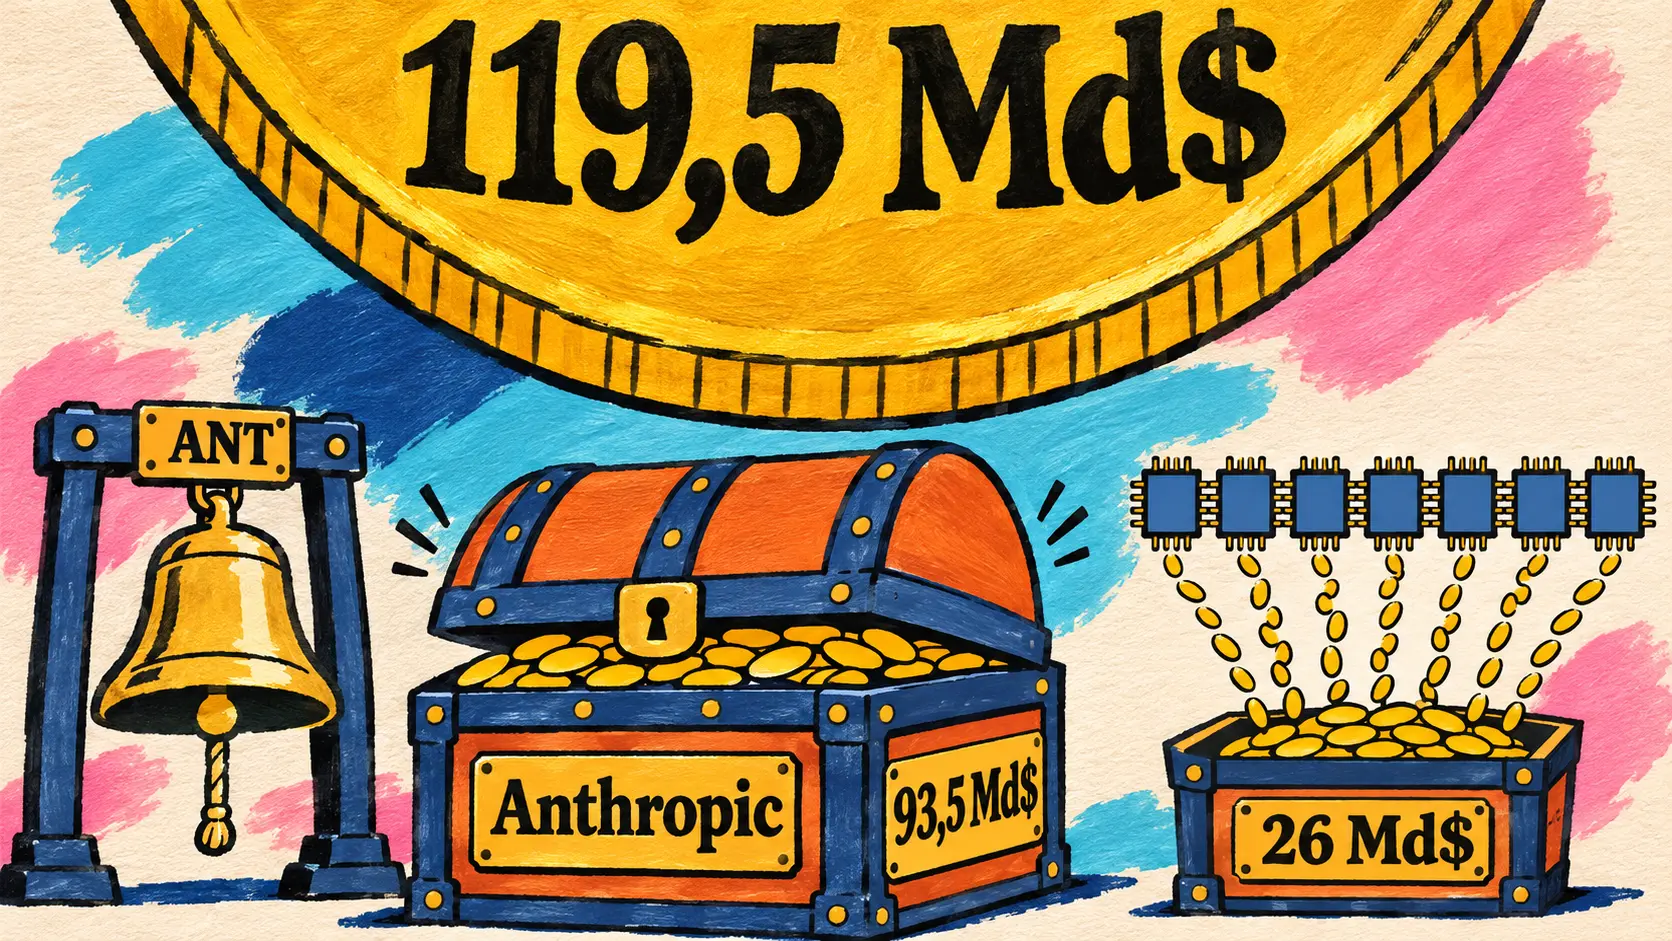
20. November — Am Tag nach dem Handelsstart gibt Anthropic den Abschluss seines Börsengangs bekannt, dessen Ausgabepreis am 18. November auf 83 Dollar je Aktie festgelegt worden war. Die Banken haben ihre Option auf 147 Millionen zusätzliche Aktien vollständig ausgeübt: Insgesamt wurden 1 127 000 000 Aktien der Klasse A verkauft. Der Bruttoerlös beläuft sich vor Provisionen und Gebühren auf rund 93,5 Milliarden Dollar, davon rund 91,6 Milliarden für Anthropic, das aus dem Verkauf der 23 648 646 von bestehenden Aktionären abgegebenen Aktien nichts erhält.
Der Beitrag berichtet außerdem über eine parallel durchgeführte und ebenfalls abgeschlossene Privatplatzierung, die in der Mitteilung zum Ausgabepreis nicht erwähnt worden war: 313 253 007 Aktien einer Klasse N, die zum gleichen Preis von 83 Dollar an sieben Halbleiter- und IT-Konzerne (AMD, Broadcom, Google, Micron, Microsoft, NVIDIA und TSMC Partners) verkauft wurden, für rund 26,0 Milliarden Dollar. Diese Aktien sind nicht gemäß dem Securities Act von 1933 registriert. Zusammen ergeben das öffentliche Angebot und diese Platzierung einen Bruttobetrag von nahezu 119,5 Milliarden Dollar, vor Provisionen und Gebühren.
| Bestandteil der Transaktion | Von Anthropic bekannt gegebener Wert |
|---|---|
| Verkaufte Aktien der Klasse A | 1 127 000 000, davon 147 000 000 im Rahmen der Option der Banken |
| davon von Anthropic verkauft | 1 103 351 354 |
| davon von bestehenden Aktionären | 23 648 646 |
| Preis je Aktie | 83 Dollar |
| Bruttoerlös aus dem Angebot | rund 93,5 Milliarden Dollar |
| Anteil für Anthropic | rund 91,6 Milliarden Dollar |
| Privatplatzierung (Klasse N) | 313 253 007 Aktien, rund 26,0 Milliarden Dollar |
| Bruttosumme, Angebot und Platzierung | rund 119,5 Milliarden Dollar |
| Börsennotierung | seit dem 19. November, Nasdaq Global Select Market, Symbol ANT |
Der Beitrag bestätigt die Börsennotierung, nennt jedoch weder Aktienkurs noch Marktkapitalisierung. Goldman Sachs und Morgan Stanley leiteten die Transaktion gemeinsam mit einem Konsortium aus rund zwanzig Banken, darunter J.P. Morgan, Citigroup, BNP Paribas, Crédit Agricole CIB und Société Générale. Am selben Tag veröffentlichte @AnthropicAI ein Video, in dem die sieben Mitgründer Dario Amodei, Daniela Amodei, Tom Brown, Jack Clark, Jared Kaplan, Sam McCandlish und Chris Olah die Geschichte des Unternehmens erzählen.
🔗 Abschluss des Börsengangs (Anthropic) · @AnthropicAI auf X: die Mitgründer
Offene Modelle: Inkling 2 Mini von Thinking Machines, Tencent Hy4, ein Super-Adapter für Qwen3.8-27B, Ayb 0.5 und Depth Pro 2
20. November — Thinking Machines Lab veröffentlicht Inkling 2 Mini, den kleinen Bruder von Inkling 2 Small (594 Milliarden Parameter, hier am 12. November behandelt). Diese Expertenmischung (Mixture-of-Experts) mit offenen Gewichten unter der Apache-2.0-Lizenz umfasst 26,4 Milliarden Parameter, von denen 3,4 Milliarden pro Token aktiv sind. Das Modell liest Text und Bilder und bietet einen Kontext von einer Million Tokens. Seine Gewichte werden in der Trainingspräzision bereitgestellt, NVFP4 für zwanzig Schichten und MXFP8 für die letzten vier, also rund 20 GB ohne Konvertierungsverluste: Es läuft mit Ollama auf jedem Mac mit mindestens 32 GB.
Today we are releasing Inkling 2 Mini, a fast, powerful model that’s small enough to run on your laptop.
🇩🇪 Wir veröffentlichen heute Inkling 2 Mini, ein schnelles und leistungsstarkes Modell, das klein genug ist, um auf Ihrem Laptop zu laufen. — Thinking Machines Lab, Ankündigung von Inkling 2 Mini
Seine Besonderheit liegt in der Architektur: Es handelt sich um einen Transformer mit Schleifen (looped transformer). Von seinen 24 Schichten werden die 12 mittleren dreimal durchlaufen, was bei 24 gespeicherten Schichten 48 Schichtdurchläufe pro Token ergibt und damit 5,4 Milliarden Gewichtsaktivierungen pro Token. Während des Trainings entfernte das Labor außerdem zwei Drittel der Experten (von 384 auf 128) und stellte die Leistungsfähigkeit des Modells anschließend mit 1 000 Milliarden Tokens wieder her, die aus einem größeren internen Inkling-Modell destilliert wurden. Nach seinen Angaben würde ein Modell ohne Schleifen bei gleichem Loss 7,5 % weniger Rechenaufwand beim Training, aber 140 % mehr bei der Inferenz benötigen.
| Benchmark (Tabelle von Thinking Machines) | Inkling 2 Mini | Qwen3.8-27B | Nemotron 3.5 Super VL |
|---|---|---|---|
| Gewichtsaktivierungen pro Token / Gesamtparameter | 5,4B / 26,4B | 27,0B / 27,0B | 12,0B / 124,5B |
| AA Index v5.0 | 20,1 | 20,1 | 13,6 |
| DeepSWE v1.1 | 48,2 % | 42,2 % | 24,7 % |
| SWE-bench Pro v2 Hard | 77,9 % | 73,8 % | 44,1 % |
| Terminal-Bench 2.1 (pi) | 71,6 % | 73,0 % | 60,7 % |
| BrowseComp | 79,0 % | 61,6 % | 78,9 % |
| MCP Atlas | 82,7 % | 77,3 % | 67,7 % |
Laut Thinking Machines führt das Modell unter den offenen Modellen mit weniger als 100 Milliarden Parametern auf DeepSWE v1.1 und im Vals Index v2.2 (46,5 %). Auf Terminal-Bench 2.1 bleibt es hinter Qwen3.8-27B zurück, und Thinking Machines räumt ein, dass es weder bei Gesprächen über mehrere Runden (50,0 % auf MultiChallenge) noch bei Anweisungen mit mehreren Einschränkungen (33,4 % auf ComplexConstraints v1.1) das beste kleine Modell ist; die Legende der Grafik weist darauf hin, dass sich die Evaluierungskonfigurationen je nach Modell unterscheiden. Forschende aus Stanford mit Vorabzugang haben auf DGX Spark 0,703 Intelligenz pro Joule gemessen, gegenüber 0,430 für Qwen3.6-35B-A3B.
Das Labor nutzt das Modell auch für die Erforschung der Überwachung von Gedankenketten (chain of thought): Ein Modell mit Schleifen führt mehr Berechnungen durch, ohne sie aufzuschreiben, was einem Überwachungssystem entgehen könnte. Bei einer ebenfalls veröffentlichten Variante mit variabler Anzahl von Durchläufen steigt der Umfang der ohne schriftliches Reasoning gelösten Aufgabe zwischen einem und drei Durchläufen von 16 auf 37 Sekunden menschlicher Arbeit. Bei fünf Durchläufen ist das Reasoning nur halb so lang (durchschnittlich 1 661 gegenüber 3 703 Tokens auf GPQA Diamond) und bleibt ebenso gut lesbar; Thinking Machines beobachtet mit zunehmender Schleifenzahl keinen Anstieg agentischer Sabotage. Das Modell ist auf Tinker, Ollama, SGLang, vLLM, llama.cpp, MLX und Transformers verfügbar, mit GGUF-Versionen bei Unsloth.
🔗 Inkling 2 Mini (Thinking Machines) · Beitrag von Hugging Face · Gewichte auf Hugging Face
Together AI bietet Tencent Hy4, eine Expertenmischung mit 770 Milliarden Parametern, für 0,83 Dollar pro Million Eingabetokens an
19. November — Together AI nimmt Tencent Hy4 in sein Angebot für serverlose Inferenz auf, mit einem Kontext von einer Million Tokens, Tool-Aufrufen und JSON-Ausgabe. Laut dem Hosting-Anbieter ist Tencents Spitzenmodell eine Expertenmischung mit 770 Milliarden Parametern, von denen 49 Milliarden pro Token aktiv sind; es folgt auf Hy4 Preview, ergänzt die Computerbedienung und kann als erstes Modell der Hy-Familie Bilder lesen.
| Preis pro Million Tokens | Together AI | Tencent (Mitteilung vom 4. November) |
|---|---|---|
| Eingabe | 0,83 Dollar | rund 0,90 Dollar |
| Eingabe aus dem Cache | 0,042 Dollar | rund 0,045 Dollar |
| Ausgabe | 2,50 Dollar | rund 2,70 Dollar |
Tencent hatte Hy4 am 4. November vorgestellt, es als eines der besten Open-Source-Modelle bezeichnet und die Gewichte innerhalb weniger Tage versprochen; das Repository tencent/Hy4 befindet sich auf Hugging Face unter einer Lizenz vom Typ „other“. Die Mitteilung verwies auf eine verblindete Evaluierung im Finanzbereich (213 Fachleute, 579 Aufgaben), bei der Hy4 3,04 erzielte, vor DeepSeek-V4.1-Flash-1017 (2,97), sowie auf eine intern gemessene Halluzinationsrate, die von 12,95 % auf 7,2 % gesenkt wurde.
🔗 Tencent Hy4 auf Together AI · Mitteilung von Tencent vom 4. November
Hugging Face veröffentlicht das Rezept für seine harness adapters und einen einzigen Super-Adapter für Qwen3.8-27B
20. November — Nach drei Tagen mit Veröffentlichungen, darunter der hier gestern behandelte Hermes-Adapter, liefert Hugging Face das vollständige Rezept für seine harness adapters: LoRA, die innerhalb eines Agenten-Harness (pi, Hermes Agent oder OpenCode) auf Basis von Qwen3.8-27B mit Reinforcement Learning trainiert werden. Neu ist ein Super-Adapter: Die drei LoRA mit Rang 32 werden zu einem einzigen LoRA mit Rang 96 verkettet, der in allen drei Harnesses funktioniert. Da ihre Updates nahezu orthogonal sind (Kosinus von 0,01 bis 0,02), wendet die Kombination alle drei exakt an.
| SWE-bench Pro (51 schwierige Aufgaben), mit Reasoning | Basismodell | Mit dem Super-Adapter |
|---|---|---|
| Harness Hermes Agent | 45 % | 61 % |
| Harness OpenCode | 47 % | 67 % |
| Harness pi | 74 % | 74 % |
Mit Reasoning steigt der Durchschnitt der sechs Kombinationen aus Harness und Benchmark laut dem Thread des Teams von 55,5 auf 63,5 %, bei 19 bis 48 % weniger Tool-Aufrufen; ohne Reasoning gewinnt der Super-Adapter laut dem Beitrag auf SWE-bench Pro 6 bis 18 Punkte hinzu, bei 53 bis 73 % weniger Tool-Aufrufen. Die Ergebnisse lassen sich zwischen den Harnesses nicht vergleichen, da sich deren Standardeinstellungen unterscheiden. Das Training erforderte 598 Schritte und 167 Millionen Tokens; der Schutzmechanismus safeagents überprüfte 1,3 Millionen Tool-Aufrufe und blockierte 647 davon. Aufgaben, Adapter, GGUF und Evaluierungstrajektorien sind veröffentlicht.
🔗 Harness adapters in großem Maßstab (Hugging Face) · @yb2698 auf X
Metric AI veröffentlicht Ayb 0.5, OhanTTS und OhanASR, offene Text- und Sprachmodelle für Armenisch
20. November — Das armenische Team Metric AI veröffentlicht am selben Tag drei Modellfamilien für seine Sprache. Ayb 0.5 umfasst drei Sprachmodelle (0,8B, 4B und 9B), die auf Qwen3.5 aufbauen und vom erweiterten Tokenizer bis zum Post-Training an Armenisch angepasst wurden; Ayb-9B unterstützt Dialoge über mehrere Runden, Tool-Aufrufe und Bilder. OhanTTS-v0.1 synthetisiert Sprache in acht Sprachen, darunter Armenisch und Französisch, und klont eine Stimme anhand von 3 bis 10 Sekunden Audiomaterial. OhanASR-v0.1, ein Spracherkennungsmodell mit 2B, wurde mit 820 Stunden Armenisch feinabgestimmt.
| Modell von Metric AI | Von den Autoren veröffentlichtes Ergebnis |
|---|---|
| Ayb-9B | 3. Platz in der Gesamtwertung von ArmBench (0,6164) |
| OhanTTS-v0.1, 61 Stunden Armenisch | 14,70 % WER, erste Audioausgabe nach 331 ms auf einer GB10 |
| OhanASR-v0.1 | 16,12 % WER (2. Platz) und 3,49 % CER (1. Platz) auf ArmBench-ASR |
Die Gewichte von Ayb-9B stehen unter einer nicht kommerziellen Lizenz (CC BY-NC 4.0) und sind nach manueller Freigabe zugänglich.
🔗 Ayb 0.5 (Metric AI) · OhanTTS · OhanASR
Apple veröffentlicht Depth Pro 2, das die Tiefe in Fotos und Videos in Metern schätzt
19. November — Apple veröffentlicht Depth Pro 2, eine Modellfamilie, die sowohl in Fotos als auch in Videos die Tiefe in Metern bei nativer Auflösung schätzt. Laut der Zusammenfassung des Artikels mussten bestehende Methoden zwischen Konsistenz von Bild zu Bild und scharfen Konturen wählen; Depth Pro 2 zielt mit einem einzigen Netzwerk auf beides ab. Die Gewichte sind auf Hugging Face in vier Größen (S, B, L, H) verfügbar, mit einer Version für Core ML und einem gemeinsamen Brennweitenschätzer, der nützlich ist, wenn die EXIF-Brennweite fehlt.
| Von DepthPro2-L verarbeitete Auflösung (334M, auf B200) | Bilder pro Sekunde |
|---|---|
| VGA | 150,1 |
| 720p | 33,7 |
| 1080p | 9,1 |
| 4K | 0,7 |
Die Gewichte sind der nicht kommerziellen Forschung vorbehalten (Lizenz Apple Machine Learning Research Model), und der Code ist auf GitHub verfügbar. Pedro Cuenca von Hugging Face wies am 20. November mit einer Online-Demonstration auf die Veröffentlichung hin.
🔗 @pcuenq auf X · arXiv-Artikel 2611.26603 · DepthPro2-L (Hugging Face)
Modellsicherheit: OpenAI gegen gegnerische Destillation, Sakana AI gründet seine Security Research Group
OpenAI erläutert seinen Kampf gegen adversariale Destillation und senkt die Extraktion geschützten Reasonings von 54,0 % auf 0,2 %
20. November — OpenAI veröffentlicht einen Beitrag über adversariale Destillation (adversarial distillation): die nicht autorisierte Nutzung der Ausgaben eines Spitzenmodells, um ein anderes Modell zu trainieren, das ohne dieselben Schutzmaßnahmen eingesetzt wird, etwa für Angriffe, die das ursprüngliche Modell abgelehnt hätte. Der Beitrag befasst sich vor allem mit geschütztem Reasoning, der vor der Antwort erzeugten Gedankenkette: Laut einer internen Studie macht ein Schülermodell mit den exakten Reasoning-Verläufen in der Regel größere Fortschritte als mit deren Zusammenfassungen.
| Gemessener Angriff (adaptive Evaluation, sechs Angreifermodelle) | GPT-6 Astra, ursprüngliche Schutzmaßnahmen | GPT-6.2 Astra, aktualisierte Schutzmaßnahmen |
|---|---|---|
| Reasoning einer früheren Anfrage | 54,0 % | 0,2 % |
| Reasoning der aktuellen Anfrage | 22,9 % | 0,9 % |
Die Abwehr kombiniert adversariales Training, Eingabe- und Ausgabeklassifikatoren (einschließlich der Argumente von Tool-Aufrufen), API-Kontrollen und Untersuchungen mit wöchentlichen Sanktionen gegen Kampagnen mit einigen Tausend bis einigen Zehntausend Konten. Bei GPT-6.2 Astra und Sol ist das geschützte Reasoning an den Verlauf gebunden, aus dem es entstanden ist: Die API verwirft es, wenn eine frühere Nachricht umgeschrieben wird, und ältere Modellfamilien können es nicht mehr lesen. OpenAI erinnert daran, dem Kongress im Februar Aktivitäten gemeldet zu haben, die darauf hindeuteten, dass DeepSeek versuchte, US-amerikanische Modelle zu destillieren, und im September eine Kampagne Personen zugeschrieben zu haben, die mit Moonshot AI in Verbindung stehen; das Unternehmen erklärt, den Chip Security Act, den AI OVERWATCH Act und den MATCH Act zu unterstützen.
🔗 Bekämpfung adversarialer Destillation (OpenAI) · @OpenAI auf X
Sakana AI gründet seine Security Research Group, ein unabhängiges Team für kollektive Cyberabwehr
20. November — Sakana AI startet seine Security Research Group, ein unabhängiges R&D-Team in Tokio, das vom kommerziellen Geschäft getrennt ist und im öffentlichen Interesse arbeitet.
Excited to announce the Sakana AI Security Research Group, an independent, public-interest R&D team in Tokyo co-led by Akihiro Umegai and me.
🇩🇪 Ich freue mich, die Sakana AI Security Research Group anzukündigen, ein unabhängiges R&D-Team in Tokio, das im öffentlichen Interesse arbeitet und von Akihiro Umegai und mir gemeinsam geleitet wird. — @hardmaru auf X
David Ha ist Mitgründer und Geschäftsführer von Sakana AI. Das Team wird an drei Schwerpunkten arbeiten: Prävention bereits bei der Entwicklung, kollektive Abwehr durch auf mehrere Organisationen verteilte Agenten und die Absicherung der Abwehragenten selbst, deren Befugnisse auf ihre Aufgabe beschränkt und deren Aktionen protokolliert werden. Es baut auf eigenen Arbeiten wie Digital Red Queen, ShinkaEvolve und Fugu-Cyber auf, für das Sakana AI 86,9 % auf CyberGym und 72,1 % auf CTI-REALM angibt; eine Anmerkung im Beitrag weist darauf hin, dass die Fugu-Cyber-Seite weder Vergleichswerte noch ein Evaluationsprotokoll nennt. Es wird Whitepapers, Benchmarks und Anleitungen zur Abwehr veröffentlichen, aber kein Exploit-Material; gefundene Schwachstellen werden im Rahmen einer koordinierten Offenlegung gemeldet. Sakana AI erinnert daran, dass die Zahl der CVE-Anträge laut NIST zwischen 2020 und 2025 um 263 % gestiegen ist.
🔗 Security Research Group (Sakana AI)
Agenten für die Softwarebereitstellung: Runways Fabrik, Stitch Loop von Google Labs
Runway überträgt seine Softwarebereitstellungskette Agenten, die im Oktober 38 % seiner Merges gesteuert haben
20. November — Runway veröffentlicht in seinem Engineering-Blog die Zahlen seiner „Softwarefabrik“ (software factory): sieben Schritte, vom Schreiben des Codes bis zur Koordination der Merges, die nacheinander an Agenten übertragen wurden. Cloud-Agenten steuerten 38 % der im Oktober gemergten Pull Requests, und von 100 dieser in der ersten Novemberhälfte gemergten PR enthielten 78 keinen von Menschen erstellten Commit.
| Kennzahl der Softwarefabrik | Ausgangswert | Letzte Messung |
|---|---|---|
| Von Cloud-Agenten gesteuerte Merges | 0,1 % (Juni) | 38 % (Oktober) |
| Mediane Wartezeit bis zur ersten Freigabe | 2,3 h (September) | etwa 5 min (Mitte November) |
| Durchschnittliche wöchentliche Merges | 929 (September) | 2 235 (seit Mitte Oktober) |
Seit Mitte Oktober genehmigt die KI PR mit niedrigem Risiko allein und solche mit mittlerem Risiko, sofern das Repository dies erlaubt; bei hohem Risiko entscheidet ein Mensch, und die Code-Verantwortlichen geben Migrationen, die CI- und Deployment-Konfiguration, Secrets und die Authentifizierung weiterhin selbst frei. Im September und Oktober erhob bei 15 der 977 von der KI genehmigten PR ein Mensch Einspruch, und allein von der KI genehmigte Merges haben eine Rollback-Rate von 0,10 %, gegenüber etwa 1 von 200 bei menschlichen Freigaben. Agenten testen App Studio auch wie ein Nutzer (86 bestätigte Bugs in vier Tagen), und ein Koordinator verteilte in zwei Wochen mehr als 14 000 Aufgaben. Es handelt sich um interne Tools; ein Produkt oder Preise gibt es nicht.
🔗 Aufbau einer Softwarefabrik (Runway)
Google Labs startet Stitch Loop, einen Produktagenten, der eine laufende Anwendung kontinuierlich verbessert
18. November — Google Labs stellt Stitch Loop vor, einen dauerhaft arbeitenden Produktagenten, der dort weitermacht, wo ein Coding-Agent aufhört: nach dem Produktivstart. Er verbindet sich über mehr als 180 Integrationen, benutzerdefinierte MCP-Server oder Übertragungen aus einer lokalen CLI mit dem GitHub-Repository und den Daten des laufenden Produkts (Logs, Nutzerverhalten, Feedback) und arbeitet kontinuierlich auf messbare Ziele hin.
Jede Schleife schlägt datengestützte Ansätze vor, beschreibt die Lösungen und ihre Kompromisse, schreibt den Code in einer isolierten Cloud-Sandbox und öffnet einen Pull Request zur Freigabe; anschließend beobachtet sie die Live-Metriken. Drei Schleifen sind standardmäßig enthalten (Cybersicherheit, Latenz, Barrierefreiheit); die Sicherheitsschleife kombiniert Gemini 4 Carbon mit CodeMender, dem Agenten für Codesicherheit von Google DeepMind. Ohne Review durch das Team wird nichts gemergt. Stitch Loop dient Coding-Agenten wie Google Antigravity über die Stitch-CLI und MCP auch als Quelle für Produktkontext und lässt sich in Slack nutzen. Geöffnet ist bislang nur eine weltweite Warteliste, mit bevorzugtem Zugang für berechtigte Abonnenten von Google AI Ultra.
Assistenten für die breite Öffentlichkeit: ChatGPT Space für Plus-Abonnenten, GIFs in der Gemini-App, Perplexity Computer in Chromium-Browsern
ChatGPT Space wird für Plus-Abonnenten weltweit verfügbar
20. November — ChatGPT Space, das am DevDay vom 29. September vorgestellt wurde und bisher den Tarifen Pro, Business und Enterprise vorbehalten war, wird weltweit für Plus-Abonnenten ab 18 Jahren ausgerollt. Space ersetzt die Bibliothek in der Seitenleiste (Seiten, Folien, Bilder, hochgeladene Dateien), im Web, in der Desktop-App sowie unter iOS und Android.
Dort erstellt man mit ChatGPT interaktive Seiten und Präsentationen, die andere Personen mit Zugang zu Space ergänzen können. Seiten und Folien können sich anhand verbundener Apps selbst aktualisieren: OpenAI nennt eine Aufgabenliste, die sich selbst aktualisiert, oder einen Projektplan, der die in Slack getroffenen Entscheidungen berücksichtigt. Eine Erwähnung von ChatGPT in einem Kommentar genügt, um eine Änderung anzufordern, und ein dot kann zur Zusammenarbeit eingeladen werden. Das Teilen bleibt zugangsbeschränkt: Erforderlich sind eine Leseberechtigung und ein Plus-, Pro-, Business- oder Enterprise-Konto mit Zugang zu Space; Free-Konten können geteilte Inhalte nicht öffnen, und es gibt keinen öffentlichen Link.
Die Gemini-App erstellt animierte GIFs mit Gemini Omni 1.2 Flash, in Frankreich kostenlos
20. November — Die Gemini-App erstellt jetzt animierte GIFs (Fotoeffekte in Endlosschleife, Memes) mit Gemini Omni 1.2 Flash, dem am 5. November von Google veröffentlichten Videomodell, das laut Google für flüssige Bewegungen und gleichbleibende Qualität von Bild zu Bild sorgt. Man schreibt seine Anfrage im Hauptchat oder öffnet das Bild- oder Videotool und wählt anschließend GIF in der Formatauswahl.
GIFs are now available to all Google AI subscribers and free of charge in the U.S., Japan, Korea, Australia, Canada, U.K., Germany, and France.
🇩🇪 GIFs sind jetzt für alle Abonnenten von Google AI verfügbar und in den USA, Japan, Korea, Australien, Kanada, dem Vereinigten Königreich, Deutschland und Frankreich kostenlos. — @GeminiApp auf X
Nutzer in Frankreich haben somit auch ohne Abonnement Zugang. Google folgt OpenAI, dessen animierte GIFs in ChatGPT mit Images 2.6 hier am 5. November behandelt wurden.
🔗 @GeminiApp auf X: GIFs in Gemini
Perplexity Computer funktioniert dank der Perplexity-Erweiterung direkt in Chromium-Browsern
20. November — Perplexity Computer funktioniert jetzt dank der Perplexity-Erweiterung direkt in Browsern auf Chromium-Basis. Man erteilt über die Seitenleiste der Erweiterung eine Aufgabe und verfolgt anschließend, wie Computer in den Tabs und Tools des Nutzers arbeitet. Der Ankündigungstweet nennt weder die betreffenden Tarife noch eine Liste der unterstützten Browser.
Zwei frühere Schritte: Am 5. Oktober konnte Computer in der Mac-App 26.38.0 über eine Erweiterung Chrome, Edge oder Brave nutzen, und am 30. Oktober verband eine Chrome-Erweiterung die Mac- und Windows-Apps von Computer mit dem Browser des Nutzers. Dieses Mal wird die Aufgabe über die Seitenleiste der Erweiterung im Browser erteilt.
API und SDK für Entwickler: Codex im Agents SDK Python, Decider in der Context API von Perplexity
OpenAIs Agents SDK Python veröffentlicht eine Vorabversion 1.0, die Codex zu einem Modellanbieter macht
20. November — OpenAIs Agents SDK Python eröffnet seine 1.0-Reihe mit einer Vorabversion, die einen neuen Ansatz verfolgt: Statt einer separaten nativen Engine wie in der hier am 16. November behandelten Vorabversion 0.24 wird Codex zu einem Modellanbieter, den man bei jeder Ausführung auswählt. Man erstellt CodexProvider und übergibt es dem Runner über RunConfig(model_provider=provider); der Agent läuft dann mit der gespeicherten Codex-Verbindung oder mit einem API-Schlüssel.
Das Python-Wheel enthält Codex Core (rust-v0.166.0, unverändert) über PyO3: Das SDK ruft den Kern von Codex direkt auf, ohne codex app-server zu starten oder JSON-RPC zu verwenden. Python-Tools, Übergaben an spezialisierte Agenten (handoffs), die Freigabe vor einem Tool-Aufruf und typisierte Ausgaben bleiben verfügbar, und native Befehle halten sich an die Sandbox und die Freigaberegeln von Codex. Die Wheels 1.0.0a1 werden ausschließlich über GitHub Releases verbreitet (Linux x86-64 und ARM64, macOS 11 und neuer auf Apple silicon, Windows x64, CPython 3.10 bis 3.14). Die Sicherungen aus der Vorabversion 0.24.0-alpha.8 sind nicht mit dem Runner kompatibel, und die stabile Version bleibt 0.25.0 vom 18. November.
🔗 openai-agents-python v1.0.0-alpha.1
Perplexity ergänzt die Context API um Decider zur Bewertung von Seiten, einschließlich Prompt Injections
19. November — Perplexity ergänzt die zwei Tage zuvor gestartete Context API (1 Dollar für 1 000 URLs) um sein Entscheidungsmodell Decider. Für jede abgerufene Seite lassen sich bis zu fünf geschlossene Fragen (ja oder nein) stellen, und Decider bewertet jede Antwort mit einem Wert von 0 bis 1. Der hervorgehobene Anwendungsfall betrifft die Sicherheit: eine Prompt Injection (prompt injection) auf einer Seite erkennen, bevor ein Agent sie liest. Perplexity nennt außerdem die Qualifizierung von Leads, Moderation und das Erkennen unbelegter gesundheitsbezogener Behauptungen.
Die API selbst filtert nichts: Sie liefert alle Seiten mit ihren Scores zurück, und der Anwendungscode wendet einen Schwellenwert an. Die Bewertung wird zusätzlich zum Preis pro URL in Input-Tokens der Decisions API abgerechnet und kann die Anfrage um höchstens 15 Sekunden verlängern. Das Cookbook der Dokumentation zeigt eine am 18. November mit einem Schwellenwert von 0,7 ausgeführte Prüfung:
| Getestete Seite (Cookbook vom 18. November) | Injection-Score | Entscheidung der Prüfung |
|---|---|---|
| Injection-Demonstration (Greshake et al., 2023) | 0,97 | in Quarantäne verschoben |
| OWASP, Seite zu Prompt Injection | 0,0018 | weitergeleitet |
| RFC 9111 | 0,0007 | weitergeleitet |
Das Cookbook warnt, dass ein niedriger Score eine Seite nicht sicher macht: Laut der BrowseSafe++-Forschung von Perplexity folgte jedes getestete Modell weiterhin bestimmten Injections, die es selbst gemeldet hatte.
🔗 Thread von @perplexitydevs · Dokumentation · Cookbook
Coding-Agenten: Claude Code 2.1.329, Codex CLI 0.171.0, Vibe CLI 3.1.4 und Gemini 4 Neon in Devin
Claude Code 2.1.329 zeigt beim Öffnen eines Ordners die Herkunft der Hooks an und bündelt geplante Aufgaben in /tasks
19. November — Claude Code 2.1.329 umfasst 130 Einträge, darunter 91 Fehlerbehebungen, 20 Änderungen und 7 Ergänzungen. Bei der Sicherheit zeigt der Dialog, der fragt, ob man einem Ordner vertraut, jetzt an, wo dessen Hooks deklariert sind, und Claude Desktop sowie andere nicht interaktive Hosts warnen, wenn die durch verwaltete Einstellungen (managed settings) vorgeschriebenen Hooks nicht geladen werden. /tasks listet außerdem die geplanten Aufgaben der Sitzung, die Aufweckereignisse von /loop, das aktuelle Ziel und die Forks der Unterhaltung auf; die meisten von früheren Versionen erfassten geplanten Aufgaben müssen neu geplant werden.
Ohne Ziel prüft /code-review nun bei den meisten Modellen den gesamten Branch im Vergleich zum Standard-Branch, und mit einer PR-Nummer prüft es über gh pr diff die PR selbst. Unter macOS wechselt computer use zu neueren Sicherheitsregeln, die bestimmte Aktionen ablehnen. Der in 2.1.326 hinzugefügte automatische Neuversuch nach einem Fehler max_tokens entfällt: Hinter einem Gateway muss CLAUDE_CODE_MAX_OUTPUT_TOKENS konfiguriert werden. Code Mode erhält 17 Einträge, darunter die Kompatibilität mit OpenTelemetry-Ereignissen und -Metriken. Version 2.1.330 ist seit dem 20. November auf npm veröffentlicht.
Codex CLI 0.171.0 setzt GPT-6.2 Sol als Standard und aktiviert den Arbeitsbereich des Terminals
20. November — Codex CLI 0.171.0 ist die erste stabile Version seit 0.170.0 vom 18. November und bündelt 339 Pull Requests. GPT-6.2 Sol und GPT-6.2 Astra werden in die Modellkataloge aufgenommen, wobei Sol standardmäßig ausgewählt ist, und die Befehle /rc und /remote verwalten die lokale Fernsteuerung über das Terminal und zeigen die Kopplungscodes der Geräte an.
Mehrere Neuerungen aus den Vorabversionen vom 14. bis 17. November erreichen die stabile Version: Der standardmäßig aktivierte Arbeitsbereich der TUI zeigt Dokument- und Bildvorschauen sowie Transkripte der Subagenten neben der Unterhaltung an; codex exec --remote startet eine nicht interaktive Sitzung auf einem bestehenden Anwendungsserver oder setzt sie fort; der Composer erhält Funktionen zum Rückgängigmachen und Wiederholen; /statusline wählt nach Aktivierung einer Option von einem MCP-Server bereitgestellte Statuszeilen aus. Zu den Fehlerbehebungen gehört, dass Entwürfe und eingereihte Neuversuche ihrer Unterhaltung zugeordnet bleiben und die MCP-Anmeldung für Unternehmen mit Identitätsanbietern funktioniert, die kein Refresh-Token ausstellen.
Vibe CLI 3.1.4 trennt den Agenten von der Genehmigungsrichtlinie und entzieht Agenten das Recht, Bestätigungsabfragen aufzuheben
20. November — Mistral veröffentlicht Vibe CLI 3.1.4, zwei Tage nach Version 3.1.3, die Mistral Large 4 zum Standardmodell machte. Die 79 Einträge (18 Ergänzungen, 41 Änderungen, 18 Fehlerbehebungen, 2 Entfernungen) betreffen vor allem die Berechtigungen: Jede Sitzung kombiniert nun zwei unabhängige Einstellungen, einen Agenten (default, lean oder benutzerdefiniert) und eine Genehmigungsrichtlinie (ask, accept-edits, smart-approve oder auto-approve), die über --approval-policy oder default_approval_policy gewählt wird.
Ein Agent entscheidet nicht mehr allein, was ohne Rückfrage ausgeführt wird: Seine Einstellungen safety, bypass_tool_permissions und permission = "always" werden ignoriert. Ein Projekt kann in seinem Ordner .vibe/agents/ keine Genehmigungsrichtlinie mehr überschreiben, und sowohl Forks als auch untergeordnete Sitzungen erben die ursprüngliche Richtlinie. Die Oberfläche erhält eine Leiste mit Chips über dem Eingabefeld (Subagenten, Hintergrundaufgaben, Pull Requests, Ziel, Aufgaben), die Einstellung keep_awake verhindert den Ruhezustand während eines Durchgangs, und Vibe akzeptiert Systemzertifikate, was den Betrieb hinter einem Unternehmensproxy erleichtert. Nur die 8 neuesten Bilder werden nun an die Mistral-Modelle gesendet, und benutzerdefinierte Prompts zur Kompaktierung werden entfernt.
Devin schaltet Gemini 4 Neon frei: 46,2 % auf FrontierCode 2.0 für 4,38 Dollar pro Aufgabe
19. November (Beitrag vom 18.) — Nach Cursor und GitHub Copilot, über die hier gestern berichtet wurde, schaltet Cognition Gemini 4 Neon in Devin Desktop und Devin CLI frei. Auf FrontierCode 2.0, seinem Benchmark zur Bewertung, ob ein Pull Request zusammengeführt werden sollte, erreicht Neon 46,2 %, laut Cognition das beste Ergebnis eines Google-Modells. Es liegt etwa einen Prozentpunkt hinter Claude Opus 5.5 (47,3 %) und kostet ungefähr ein Drittel: 4,38 Dollar pro Aufgabe gegenüber 12,82 Dollar.
| Auf FrontierCode 2.0 bewertetes Modell | Von Cognition veröffentlichte Punktzahl |
|---|---|
| Claude Fable 5.2 | 50,2 % |
| Claude Opus 5.5 | 47,3 % |
| Gemini 4 Neon | 46,2 % |
| GPT-6.2 Astra | 44,2 % |
| GPT-6.2 Sol | 43,8 % |
| Gemini 4 Carbon | 42,6 % |
Die Kosten entsprechen den durchschnittlichen Ausgaben pro Durchlauf zum API-Listenpreis einschließlich öffentlich verfügbarer Rabatte. Eine Lösung, die ein Ausschlusskriterium nicht erfüllt, erhält null Punkte. Mehrere Werte dieser Grafik weichen von den in den vergangenen Wochen veröffentlichten Werten ab, ohne dass der Beitrag dies erklärt.
🔗 Gemini 4 Neon in Devin (Cognition) · @cognition auf X
Wissenschaft: OpenAI veröffentlicht MedChemBench, einen Benchmark für medizinische Chemie, auf dem GPT-6.2 Astra 84,5 % erreicht
20. November — OpenAI stellt MedChemBench vor, einen Benchmark, der misst, wie gut Modelle wie ein Medizinalchemiker schlussfolgern können: die Struktur eines Moleküls mit experimentellen Ergebnissen verknüpfen, Verbindungen vergleichen und ihre Eigenschaften vorhersagen. Er umfasst 99 Aufgaben aus 117 Artikeln und Patenten mit 761 unterschiedlichen Molekülstrukturen und bewertet vier Komponenten: Strukturen, wissenschaftliches Schlussfolgern, Auswahl von Verbindungen und Vorhersage von Eigenschaften.
| Bewertetes Modell (Reasoning-Stufe xhigh) | Erreichte Punktzahl |
|---|---|
| GPT-6.2 Astra | 84,5 % |
| GPT-6 Astra | 83,3 % |
| GPT-6.1 Sol | 82,0 % |
| GPT-6.1 Terra | 75,1 % |
| GPT-5.6 Sol | 58,2 % |
Das Leistungsprofil ist uneinheitlich: GPT-6 Astra erreicht bei Strukturen 95,4 % der Punkte, bei der Auswahl von Verbindungen und der Vorhersage numerischer Werte jedoch nur etwa die Hälfte. OpenAI bleibt vorsichtig: Der Benchmark basiert auf historischen Daten und belegt nicht, dass die Modelle neue Medikamente entdecken können. Ein vorheriger Kontakt mit den zugrunde liegenden Veröffentlichungen lässt sich nicht ausschließen, und es wurden ausschließlich GPT-Modelle bewertet. Er folgt auf BioBasicsBench, über den hier am 6. November berichtet wurde.
🔗 Vorstellung von MedChemBench (OpenAI) · Vollständiger Artikel (PDF)
Generative Video- und Audiotechnik: ElevenLabs ergänzt Ads Engine um Werbevarianten ohne erneuten Dreh
20. November — ElevenLabs erweitert Ads Engine, sein in ElevenCreative integriertes und im Juni gestartetes Werkzeug zur Werbeerstellung. Es ist mit den Werbekonten von Google, Meta, LinkedIn und nun auch TikTok verbunden und erstellt aus bestehenden Anzeigen und deren Ergebnissen Varianten, ohne dass erneut gedreht werden muss. Es erkennt den Einstieg (Hook) und schreibt auf Grundlage erfolgreicher Anzeigen neue Einstiege; diese werden von einer digitalen Nachbildung der Stimme des ursprünglichen Sprechers gesprochen, mit Lippensynchronisation und aktualisierten Untertiteln. Neue Soundtracks, die die ElevenLabs Music API passend zu Ton und Rhythmus der Bilder komponiert, können kommerziell genutzt werden.
Bei der bereits von Dubbing v2 übernommenen Lokalisierung passt Ads Engine nun die Lippenbewegungen des Sprechers an die Zielsprache an und ersetzt eingebrannte Untertitel durch eine übersetzte Fassung mit dem Timing und den Schriftarten der Marke. Eine menschliche Prüfung vor der Veröffentlichung bleibt möglich, auch durch eine muttersprachliche Lokalisierungsfachkraft, und das Werkzeug kann direkt auf den Plattformen veröffentlichen. Der Zugang erfolgt über das Vertriebsteam; Preise wurden nicht veröffentlicht.
🔗 Varianten und Lokalisierung von Videoanzeigen in Ads Engine (ElevenLabs)
Kurzmeldungen
Coding-Agenten
- Copilot CLI 1.0.115-2 — In dieser Vorabversion mit 351 Einträgen, davon 335 Fehlerbehebungen, erscheint Gemini 4 Hydrogen mit dem Aufwand Extra High in der Modellauswahl, sofern das Konto Zugriff darauf hat. GPT-6.2 Astra wird unterstützt, und
/modelunterstützt auch Modelle benutzerdefinierter Anbieter; die stabile Version bleibt 1.0.114. 🔗 Quelle - Codex CLI 0.173.0-alpha.1 und alpha.2 — Die Versionshinweise dieser Vorabversionen sind leer; laut den Titeln der 71 Commits werden die gemeinsame Nutzung von MCP-Verbindungen und die OAuth-Erkennung konfigurierter Server standardmäßig aktiviert, und Administratoren können Aktualisierungen des Codex-Daemons deaktivieren. Der Inhalt kann sich bis zur stabilen Version ändern. 🔗 Quelle
- Gemini CLI — Erster Nightly-Build seit dem 4. November (v0.71.0-nightly.20261120); auf dem Hauptbranch öffnet
gemini --resumedie zuletzt verwendete Sitzung statt der zuletzt gestarteten erneut, und Pfade, die mit~\beginnen, werden unter Windows endlich expandiert. 🔗 Quelle - Antigravity IDE 2.8.0 — Googles Editor startet sein Backend sofort und prüft im Hintergrund auf Updates, leitet Ports für die Fernverbindung automatisch weiter, ermöglicht die Suche in einer Unterhaltung per Tastatur und akzeptiert beim Verbindungsaufbau benutzerdefinierte Zertifikate und Proxys. 🔗 Quelle
- Qwen Code 0.28.1-preview.1 — Diese Vorabversion mit 179 Einträgen macht GitHub zum dritten unterstützten Kanaladapter, ergänzt WeCom, Microsoft Teams und generische ausgehende Webhooks, die über die Weboberfläche konfigurierbar sind, und bietet im CLI eine Darstellung für Screenreader; die stabile Version bleibt v0.28.0. 🔗 Quelle
- Kimi Code 2.7.1 und 2.7.2, Kimi Code Desktop 1.4.1 und 1.4.2 — Vier Fehlerbehebungsversionen am Tag nach 2.7.0: Der in einem Entwurf gewählte Denkaufwand fällt nach dem Absenden nicht mehr auf den Standardwert zurück, und Forks schlagen nach der Wiederherstellung einer während eines Durchgangs neu ausgerichteten Sitzung nicht mehr fehl. 🔗 Quelle
- CLI mistral 0.20.1 —
mistral evals execendet nun mit einem Fehler (Code 1), wenn alle Aufrufe eines Durchlaufs fehlgeschlagen sind, etwa wegen eines Fehlers 401, statt den Durchlauf als erfolgreich zu melden; ein Abbruch durch Ctrl-C wird als solcher ausgewiesen. 🔗 Quelle - Replit — Arbeitsbereiche (Workspaces) lassen sich nun durchsuchen und anheften; diese Option erscheint erst ab fünf Arbeitsbereichen. 🔗 Quelle
- Devin Bot für Manim — Cognition zeigt den Devin Bot, den Grant Sanderson zur Unterstützung seiner Arbeit an Manim eingerichtet hat, dem Open-Source-Animationssystem für die Videos von 3Blue1Brown (96,6 k Sterne, 250 000 Downloads pro Monat); der Tweet nennt weder die Aufgaben des Bots noch seine Ergebnisse. 🔗 Quelle
APIs und Plattformen
- Gemini API — Seit dem 17. November kann Gemini 3.5 Transcribe sowohl in der klassischen als auch in der Live-Version ein Diktat oder einen bestehenden Text per Sprache bearbeiten, umschreiben und formatieren (Parameter
source_text); Google nennt auch die Übersetzung. Seit dem 18. ermöglicht die API, nur den benötigten Teil hochgeladener Dateien zu verarbeiten und zu bezahlen: Seitenbereiche, Tabellenblätter, Zellen, Zeitintervalle oder Inhaltsebenen. 🔗 Quelle - Zeitbewusstsein in der Agents API — Eine experimentelle Option (
experimental={"time_awareness": True}) erinnert das Modell regelmäßig an die Uhrzeit, damit es seine Arbeit an eine Frist anpassen kann. Zusammen mit asynchronen Tools ermöglicht sie einem Agenten, eine Frage zu stellen und während des Wartens auf die Antwort weiterzusuchen, wie ein Beitrag im Entwicklerblog von OpenAI zeigt. 🔗 Quelle - Gesprächsverlauf mit GPT-6.2 — @OpenAIDevs bittet darum, frühere Nachrichten in der Responses API nicht mehr zu verändern, da die API das auf die Änderung folgende Reasoning verwirft. Ein neuer Abschnitt Reasoning removals im Usage-Dashboard hilft, dies zu erkennen. Der zugehörige Leitfaden schlägt vor, stattdessen ein Element
configuration_updateoderadditional_toolshinzuzufügen, um den Aufwand oder die Tools zu ändern. 🔗 Quelle
Assistenten für Privatnutzer
- ChatGPT führt eine neue mobile App mit einem Tab für den Dot und angehefteten Favoriten ein — Codex, Projects oder Images lassen sich in der Tab-Leiste anheften; die Einführung beginnt bei Pro-Nutzern ab 18 Jahren dort, wo Dots verfügbar sind, außerhalb des Europäischen Wirtschaftsraums (einschließlich der EU), des Vereinigten Königreichs, der Schweiz und Koreas, sowie bei einer kleinen Gruppe von Plus-Nutzern (Versionshinweise vom 19. November, weiter oben verlinkt).
- Teammates von Perplexity — Max-Abonnenten können nun aus jeder Computer-Aufgabe im Web einen Teammate erstellen und anschließend dessen Namen, Rolle oder Avatar in derselben Unterhaltung ändern. 🔗 Quelle
- Mac-App von Perplexity — Die schnellere App ergänzt „Send now“, um eine laufende Aufgabe neu auszurichten, ⌘F für die Suche in Tabellen, Markdown und Vorschauen sowie ⌘⇧T zum erneuten Öffnen eines geschlossenen Tabs. 🔗 Quelle
Generative Video- und Audiotechnik
- Seedance 2.5 Flash auf Pika — Nach Runway und HeyGen ergänzt Pika die schnelle Variante des Videomodells von ByteDance für Arbeiten mit vielen Takes: Videos bis zu 30 Sekunden in 480p oder 720p, bis zu 10 Bilder, 5 Videos und 5 Audioclips als Referenz; der Tweet nennt keinen Preis. 🔗 Quelle
- Avatar 6 von HeyGen — Neue Blindtests aus dem technischen Bericht: Wenn die gefilmten Personen, Mitarbeiter von HeyGen, das Video auswählen, das ihnen am ähnlichsten sieht, gewinnt Avatar 6 mit 86,5 % gegen Seedance 2.5 und mit 87,9 % gegen Wan 3.0; diese Bewertungen werden von HeyGen durchgeführt. 🔗 Quelle
- Qwen3 TTS bei Together AI — Die offene Sprachsynthese Qwen3-TTS-12Hz-1.7B (Apache 2.0) wird für 20 Dollar pro Million Zeichen angeboten, mit neun per natürlichsprachlicher Anweisung anpassbaren Stimmen, zehn Sprachen einschließlich Französisch und einer ersten Audioausgabe nach bestenfalls 97 ms. 🔗 Quelle
Infrastruktur und Forschung
- Together Storage Accelerator — Together AI bietet mit jedem GPU-Cluster einen NVMe-Cache für S3-Speicher und den Hugging Face Hub, ohne dass Codeänderungen nötig sind. Laut eigenen Messungen sinkt die Lesezeit einer 2-Gio-Datei aus Cloudflare R2 von 12,7 bis 15,0 s auf 0,64 bis 0,72 s, und ein Cluster mit 200 Knoten lädt sie nur einmal vom Ursprungsserver herunter. 🔗 Quelle
- CDN von Hugging Face — Hugging Face liefert laut seinem Mitgründer Julien Chaumond monatlich fast ein Exabyte an offenen Modellen und Datensätzen aus und hat ein eigenes Verteilnetz (CDN) für KI-Downloads aufgebaut. 🔗 Quelle
- Superfluid von basecompute — Der lokale Server verteilt die Inferenz nun auf Rechner von Apple, AMD und NVIDIA: Sechs Rechner steigern den Durchsatz für 64 simulierte Nutzer von 112 auf 534 Ausgabe-Tokens pro Sekunde, und beim Abschalten eines Knotens geht laut Anbieter keine Anfrage verloren. 🔗 Quelle
- WavLate — Dieses offene Late-Interaction-Modell sucht Klänge anhand von Text und Text anhand von Klängen, mit einem Vektor pro 0,31 Sekunden Audio und einem pro Wort. Sein Autor meldet einen durchschnittlichen Recall@1 von 37,9 auf AudioCaps und Clotho, den besten Wert unter den neun verglichenen offenen Modellen, und veröffentlicht Gewichte und Daten. 🔗 Quelle
- WorldTrace — NVIDIA Research stellt einen Speicher für interaktive Video-Weltmodelle vor, der ohne erneutes Training auskommt (Artikel für NeurIPS 2026 angenommen): Auf LoopBench verbessert sich die Erinnerung an erneut besuchte Szenen gegenüber dem gleitenden Fenster um 32,6 %, bei 3,1 Go GPU-Speicher und 27 % zusätzlicher Laufzeit. 🔗 Quelle
- Dynamo für Reinforcement Learning — NVIDIA erläutert, wie Dynamo die Rollouts im Post-Training bereitstellt: Routing anhand des KV-Caches, differenzielle Gewichtsübertragung mit ModelExpress und Wiederherstellung ausgefallener Worker-Prozesse. Microsoft AI, Cognition (für SWE-1.7), Prime Intellect und H Company setzen es ein; H Company spart pro Trainingsschritt bis zu 20 % Zeit. 🔗 Quelle
- Sparse Attention — In einem Leitfaden vom 17. November nennt NVIDIA acht Designregeln für Sparse Attention, die auf seinen GPUs trainiert wird; der Indexer zur Token-Auswahl und Top-k machen bei 128K Tokens 47 % einer Prefill-Schicht von DeepSeek V3.2 aus. 🔗 Quelle
GitHub
- GitHub Enterprise Server 3.23 als Release Candidate — Die KI-gestützte Erkennung von Secrets läuft in der öffentlichen Vorabversion auf dem Prozessor der Appliance, ohne GPU, gehostetes LLM oder ausgehende Verbindung, auch in isolierten Umgebungen (air-gapped). Die Version erweitert außerdem die Erkennung bekannter schädlicher Pakete über npm hinaus auf sieben weitere Ökosysteme. 🔗 Quelle
- Abseits von KI — GitHub verdeutlicht den Merge-Status auf der neuen Overview-Seite von Pull Requests, GitHub Desktop 3.7.0 unterstützt mehrere Konten auf demselben Host, und das Dashboard zeigt bis zu 25 favorisierte Repositories an. 🔗 Overview · 🔗 Desktop · 🔗 Favoriten
Unternehmen und Essays
- Hebbia — In seinen Tests zur Finanzrecherche im August und September zitiert eine Vorabversion von GPT-6 Astra zu 99,5 % relevante Auszüge und erfüllt 97,9 % der Darstellungsvorgaben, 14,4 Punkte mehr als die beste getestete Alternative, die in der von OpenAI veröffentlichten Fallstudie nicht genannt wird. 🔗 Quelle
- Der stille Konsens — OpenAI veröffentlicht in seiner Rubrik Das Zeitalter der Intelligenz (Intelligence Age) einen Essay von Dean Ball, der auf einem Vortrag in Harvard beruht und ausdrücklich die Ansichten des Autors wiedergibt. Er wendet sich gegen die Vorstellung, dass die Aufgabe des menschlichen Vorrangs unvermeidlich sei, und plädiert für Agenten, die Personen zugeordnet sind und begrenzte, widerrufbare Berechtigungen haben. 🔗 Quelle
- Datenanreicherung — Ein Leitfaden von Perplexity beschreibt in sechs Schritten, wie sich CRM-Datensätze mit einem ans Web angebundenen Modell ergänzen und überprüfen lassen; Apollo führt dabei monatlich 5,6 Millionen Anreicherungen über die API von Perplexity durch. 🔗 Quelle
Was das bedeutet
Anthropics Börsengang bringt in einem einzigen Beitrag das Kapital der Finanzmärkte und das der Industrie zusammen. Das öffentliche Angebot bringt dem Unternehmen brutto rund 91,6 Milliarden Dollar ein, die Privatplatzierung weitere 26 Milliarden, gezeichnet zum gleichen Preis von 83 Dollar von sieben Halbleiter- und Computerkonzernen: AMD, Broadcom, Google, Micron, Microsoft, NVIDIA und TSMC Partners. Insgesamt nähert sich die Transaktion einem Bruttovolumen von 119,5 Milliarden Dollar: Neben den Anlegern des öffentlichen Angebots kaufen sieben Industriekonzerne Aktien eines KI-Labors, das nun an der Nasdaq notiert ist.
Sicherheit wird zunehmend direkt über die Funktionsweise der Tools geregelt. OpenAI bindet das Reasoning von GPT-6.2 an den Gesprächsverlauf, aus dem es entstanden ist, wodurch die gemessene Extraktionsrate von 54,0 % auf 0,2 % sinkt, verlangt von Entwicklern aber, ihre Gesprächsverläufe nicht mehr umzuschreiben. Vibe CLI entzieht Agenten das Recht, Bestätigungen selbst aufzuheben, Claude Code zeigt, woher die Hooks eines Ordners stammen, bevor man ihm vertraut, und Decider bewertet Seiten, bevor ein Agent sie liest. Sakana AI gründet seinerseits ein Team für kollektive Verteidigung und verspricht, kein Exploit-Material zu veröffentlichen.
Agenten gehen über das Schreiben von Code hinaus und werden Teil der Softwareauslieferung. Bei Runway steuern sie 38 % der Merges im Oktober, und die KI genehmigt Änderungen mit geringem Risiko eigenständig; Stitch Loop überwacht ein Produkt im laufenden Betrieb und öffnet Pull Requests, um ein quantifiziertes Ziel zu erreichen. In beiden Fällen behält ein Mensch bei den entscheidenden Punkten die Kontrolle: über sensible Bereiche bei Runway, über jeden Merge bei Stitch Loop. Auch die Tools ziehen nach: Das Agents SDK für Python macht Codex zu einem Modellanbieter, und Cognition bewertet Modelle anhand der Frage, die diese Abläufe aufwerfen, nämlich ob die PR gemergt werden soll.
Bei offenen Modellen konzentrieren sich die Bemühungen darauf, was sich aus kompakteren Modellgewichten herausholen lässt. Inkling 2 Mini durchläuft seine mittleren Schichten dreimal, um mit 20 GB im AA Index mit Qwen3.8-27B gleichzuziehen, der Super-Adapter von Hugging Face vereint drei Spezialisierungen in einem einzigen LoRA, und Metric AI baut auf Qwen3.5 auf, um armenische Modelle zu entwickeln. Die Zahlen stammen weiterhin von den Anbietern, und MedChemBench erinnert an die Grenzen solcher Bewertungen: OpenAI evaluiert dort ausschließlich seine eigenen Modelle und schließt nicht aus, dass sie die zugrunde liegenden Veröffentlichungen bereits gesehen haben.
Quellen
- Abschluss des Börsengangs (Anthropic)
- @AnthropicAI auf X: die Mitgründer
- Inkling 2 Mini (Thinking Machines)
- Blogbeitrag von Hugging Face zu Inkling 2 Mini
- Inkling-2-Mini (Hugging Face)
- Tencent Hy4 auf Together AI
- Pressemitteilung von Tencent zu Hy4
- Adapter in großem Maßstab nutzen (Hugging Face)
- @yb2698 auf X: der Super-Adapter
- Ayb 0.5 (Metric AI)
- OhanTTS (Metric AI)
- OhanASR (Metric AI)
- @pcuenq auf X: Depth Pro 2
- arXiv-Artikel 2611.26603: Depth Pro 2
- DepthPro2-L (Hugging Face)
- Bekämpfung von Adversarial Distillation (OpenAI)
- @OpenAI auf X: Adversarial Distillation
- @hardmaru auf X: die Security Research Group
- Security Research Group (Sakana AI)
- Aufbau einer Softwarefabrik (Runway)
- Stitch Loop (Google)
- Versionshinweise zu ChatGPT
- @GeminiApp auf X: Verfügbarkeit von GIFs
- @GeminiApp auf X: GIFs in Gemini
- @perplexity_ai auf X: Computer in Chromium
- openai-agents-python v1.0.0-alpha.1
- @perplexitydevs auf X: Decider in der Context API
- Seiten anhand von Kriterien bewerten (Perplexity-Dokumentation)
- Cookbook zum Schutz vor Injection (Perplexity-Dokumentation)
- Claude Code v2.1.329
- Codex CLI 0.171.0
- Vibe CLI v3.1.4
- Gemini 4 Neon in Devin (Cognition)
- @cognition auf X: Gemini 4 Neon
- Vorstellung von MedChemBench (OpenAI)
- Vollständiger Artikel zu MedChemBench (PDF)
- Varianten und Lokalisierung von Videoanzeigen in Ads Engine (ElevenLabs)
- Copilot CLI 1.0.115-2
- Codex CLI 0.173.0-alpha.2
- Gemini CLI, PR 30389
- Changelog von Antigravity
- Qwen Code v0.28.1-preview.1
- Kimi Code 2.7.2
- CLI mistral 0.20.1
- Changelog von Replit vom 20. November
- @cognition auf X: Devin Bot für Manim
- Versionshinweise zur Gemini API
- Zeitbewusstsein und asynchrone Eingaben für persönliche Agenten (OpenAI)
- @OpenAIDevs auf X: Gesprächsverlauf und Reasoning von GPT-6.2
- @AskPerplexity auf X: teammates über Computer
- @AskPerplexity auf X: Mac-App
- @pika_labs auf X: Seedance 2.5 Flash
- @HeyGen auf X: Blindtests von Avatar 6
- Qwen3 TTS auf Together AI
- Together Storage Accelerator (Together AI)
- @julien_c auf X: das CDN von Hugging Face
- Superfluid im Flottenbetrieb (basecompute)
- WavLate (Hugging Face)
- @NVIDIAAI auf X: WorldTrace
- Dynamo und RL-Rollouts (NVIDIA)
- Sparse Attention auf NVIDIA-GPUs (NVIDIA)
- GitHub Enterprise Server 3.23 Release Candidate (GitHub-Changelog)
- Overview-Seite für Pull Requests (GitHub-Changelog)
- GitHub Desktop und mehrere Konten pro Host (GitHub-Changelog)
- Favorisierte Repositorys im Dashboard (GitHub-Changelog)
- Hebbia und GPT-6 Astra (OpenAI)
- Der stille Konsens (OpenAI)
- Datenanreicherung mit KI (Perplexity)