ai-powered-markdown-translatorArtikel vertaald uit het Frans naar het Nederlands met gpt-6.1-sol.
Anthropic rondt zijn beursgang af: ongeveer 93,5 miljard dollar bruto voor de aanbieding, en nog eens 26 miljard ingebracht door zeven groepen, waaronder NVIDIA, Google en Microsoft, via een gelijktijdige onderhandse plaatsing. Thinking Machines publiceert Inkling 2 Mini, een model met open gewichten en 26,4 miljard parameters dat in 20 GB past, en OpenAI verlaagt het slagingspercentage van aanvallen die de beschermde redeneringen van zijn modellen extraheren van 54,0 % naar 0,2 %. ChatGPT Space wordt beschikbaar voor Plus-abonnees, Runway laat 38 % van zijn code-merges door agents uitvoeren, en Claude Code, Codex CLI en Vibe CLI brengen elk een nieuwe versie uit.
Financiën: Anthropic rondt zijn beursgang af, met 93,5 miljard dollar bruto en een onderhandse plaatsing van 26 miljard
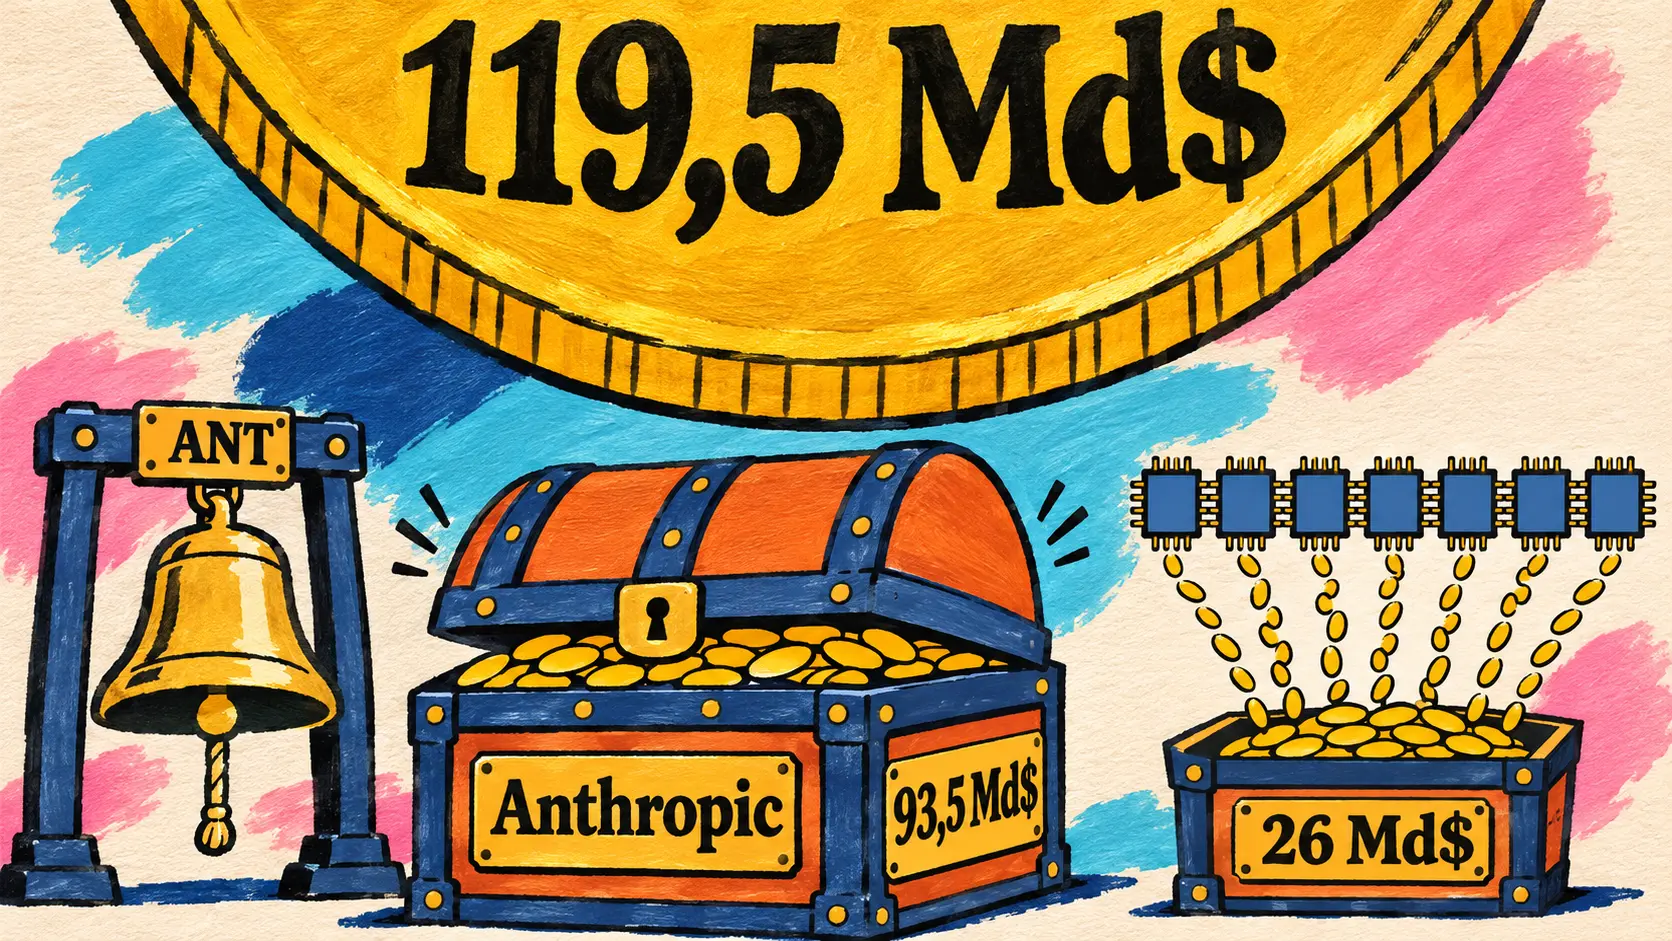
20 november — Een dag na de eerste beursnotering kondigt Anthropic de afronding van zijn beursgang aan, waarvan de prijs op 18 november was vastgesteld op 83 dollar per aandeel. De banken hebben hun optie op 147 miljoen extra aandelen volledig uitgeoefend: in totaal zijn 1 127 000 000 aandelen van klasse A verkocht. De bruto-opbrengst bedraagt ongeveer 93,5 miljard dollar vóór commissies en kosten, waarvan ongeveer 91,6 miljard voor Anthropic, dat niets ontvangt voor de 23 648 646 aandelen die door bestaande aandeelhouders zijn verkocht.
De blogpost vermeldt ook een gelijktijdige onderhandse plaatsing die eveneens is afgerond en niet werd genoemd bij de bekendmaking van de prijs: 313 253 007 aandelen van een klasse N, verkocht tegen dezelfde prijs van 83 dollar aan zeven groepen uit de halfgeleider- en IT-sector (AMD, Broadcom, Google, Micron, Microsoft, NVIDIA en TSMC Partners), voor ongeveer 26,0 miljard dollar. Deze aandelen zijn niet geregistreerd onder de Securities Act van 1933. Samen leveren de openbare aanbieding en deze plaatsing bruto bijna 119,5 miljard dollar op, vóór commissies en kosten.
| Onderdeel van de transactie | Door Anthropic bekendgemaakte waarde |
|---|---|
| Verkochte aandelen van klasse A | 1 127 000 000, waarvan 147 000 000 via de optie van de banken |
| waarvan verkocht door Anthropic | 1 103 351 354 |
| waarvan door bestaande aandeelhouders | 23 648 646 |
| Prijs per aandeel | 83 dollar |
| Bruto-opbrengst van de aanbieding | ongeveer 93,5 miljard dollar |
| Door Anthropic ontvangen deel | ongeveer 91,6 miljard dollar |
| Onderhandse plaatsing (klasse N) | 313 253 007 aandelen, ongeveer 26,0 miljard dollar |
| Brutototaal, aanbieding en plaatsing | ongeveer 119,5 miljard dollar |
| Beursnotering | sinds 19 november, Nasdaq Global Select Market, symbool ANT |
De blogpost bevestigt de beursnotering, zonder een koers of beurswaarde te noemen. Goldman Sachs en Morgan Stanley leidden de transactie, samen met een syndicaat van ongeveer twintig banken, waaronder J.P. Morgan, Citigroup, BNP Paribas, Crédit Agricole CIB en Société Générale. Diezelfde dag publiceerde @AnthropicAI een video waarin de zeven medeoprichters, Dario Amodei, Daniela Amodei, Tom Brown, Jack Clark, Jared Kaplan, Sam McCandlish en Chris Olah, de geschiedenis van het bedrijf vertellen.
🔗 Afronding van de beursgang (Anthropic) · @AnthropicAI op X: de medeoprichters
Open modellen: Inkling 2 Mini van Thinking Machines, Tencent Hy4, een superadapter voor Qwen3.8-27B, Ayb 0.5 en Depth Pro 2
20 november — Thinking Machines Lab publiceert Inkling 2 Mini, het kleine broertje van Inkling 2 Small (594 miljard parameters, hier besproken op 12 november). Dit model met open gewichten en een mixture-of-experts-architectuur (Mixture-of-Experts), onder de Apache 2.0-licentie, telt 26,4 miljard parameters, waarvan er 3,4 miljard actief zijn per token. Het leest tekst en afbeeldingen, met een context van een miljoen tokens. De gewichten worden geleverd met dezelfde precisie als tijdens de training, NVFP4 voor twintig lagen en MXFP8 voor de laatste vier, samen ongeveer 20 GB zonder conversieverlies: het draait met Ollama op elke Mac met minimaal 32 GB.
Today we are releasing Inkling 2 Mini, a fast, powerful model that’s small enough to run on your laptop.
🇳🇱 Vandaag publiceren we Inkling 2 Mini, een snel en krachtig model dat klein genoeg is om op je laptop te draaien. — Thinking Machines Lab, aankondiging van Inkling 2 Mini
Het bijzondere zit in de architectuur: het is een transformer met lussen (looped transformer). Van de 24 lagen worden de 12 middelste driemaal doorlopen, wat neerkomt op 48 laagdoorgangen per token voor 24 opgeslagen lagen, en daardoor 5,4 miljard gewichtsactivaties per token. Tijdens de training heeft het lab ook twee derde van de experts weggesnoeid (van 384 naar 128), en het model vervolgens hersteld met 1 000 miljard tokens die uit een groter intern Inkling-model zijn gedistilleerd. Volgens het lab zou een model zonder lussen bij hetzelfde verlies 7,5 % minder rekenwerk tijdens de training vergen, maar 140 % meer rekenwerk bij inferentie.
| Benchmark (tabel van Thinking Machines) | Inkling 2 Mini | Qwen3.8-27B | Nemotron 3.5 Super VL |
|---|---|---|---|
| Gewichtsactivaties per token / totaal aantal parameters | 5,4B / 26,4B | 27,0B / 27,0B | 12,0B / 124,5B |
| AA Index v5.0 | 20,1 | 20,1 | 13,6 |
| DeepSWE v1.1 | 48,2 % | 42,2 % | 24,7 % |
| SWE-bench Pro v2 Hard | 77,9 % | 73,8 % | 44,1 % |
| Terminal-Bench 2.1 (pi) | 71,6 % | 73,0 % | 60,7 % |
| BrowseComp | 79,0 % | 61,6 % | 78,9 % |
| MCP Atlas | 82,7 % | 77,3 % | 67,7 % |
Volgens Thinking Machines staat het model bovenaan bij de open modellen met minder dan 100 miljard parameters op DeepSWE v1.1 en op de Vals Index v2.2 (46,5 %). Het blijft achter bij Qwen3.8-27B op Terminal-Bench 2.1, en Thinking Machines erkent dat het niet het beste kleine model is voor gesprekken met meerdere beurten (50,0 % op MultiChallenge), noch voor instructies met meerdere beperkingen (33,4 % op ComplexConstraints v1.1); het bijschrift bij de grafiek vermeldt dat de evaluatieconfiguraties per model verschillen. Onderzoekers van Stanford met vroegtijdige toegang maten 0,703 intelligentie per joule op DGX Spark, tegenover 0,430 voor Qwen3.6-35B-A3B.
Het lab gebruikt het ook voor onderzoek naar het bewaken van de gedachtegang (chain of thought): een model met lussen rekent meer zonder dat uit te schrijven, wat aan een monitor zou kunnen ontsnappen. Bij een variant met een variabel aantal doorgangen, die eveneens is gepubliceerd, neemt de omvang van de taak die zonder uitgeschreven redenering wordt opgelost toe van 16 naar 37 seconden menselijk werk tussen één en drie doorgangen. Bij vijf doorgangen is de redenering twee keer zo kort (gemiddeld 1 661 tegenover 3 703 tokens op GPQA Diamond) en blijft ze even leesbaar; Thinking Machines ziet geen toename van sabotage door agents bij een groter aantal lussen. Het model is beschikbaar op Tinker, Ollama, SGLang, vLLM, llama.cpp, MLX en Transformers, met GGUF-versies bij Unsloth.
🔗 Inkling 2 Mini (Thinking Machines) · Blogpost van Hugging Face · Gewichten op Hugging Face
Together AI biedt Tencent Hy4 aan, een mixture-of-experts-model met 770 miljard parameters, voor 0,83 dollar per miljoen inputtokens
19 november — Together AI voegt Tencent Hy4 toe aan zijn aanbod voor serverless inferentie, met een context van een miljoen tokens, toolaanroepen en JSON-output. Volgens de hostingaanbieder is het vlaggenschipmodel van Tencent een mixture-of-experts-model met 770 miljard parameters, waarvan er 49 miljard actief zijn per token; het volgt Hy4 Preview op, voegt computergebruik toe en is het eerste model uit de Hy-familie dat afbeeldingen kan lezen.
| Tarief per miljoen tokens | Together AI | Tencent (persbericht van 4 november) |
|---|---|---|
| Input | 0,83 dollar | ongeveer 0,90 dollar |
| Gecachete input | 0,042 dollar | ongeveer 0,045 dollar |
| Output | 2,50 dollar | ongeveer 2,70 dollar |
Tencent lanceerde Hy4 op 4 november, presenteerde het als een van de beste open-sourcemodellen en beloofde de gewichten binnen enkele dagen beschikbaar te stellen; de repository tencent/Hy4 staat op Hugging Face, onder een licentie van het type ‘other’. Het persbericht verwees naar een blinde financiële evaluatie (213 professionals, 579 taken) waarin Hy4 een score van 3,04 behaalde, hoger dan DeepSeek-V4.1-Flash-1017 (2,97), en naar een intern hallucinatiepercentage dat was teruggebracht van 12,95 % naar 7,2 %.
🔗 Tencent Hy4 op Together AI · Persbericht van Tencent van 4 november
Hugging Face publiceert het recept voor zijn harness adapters en één superadapter voor Qwen3.8-27B
20 november — Na drie dagen met publicaties, waaronder de Hermes-adapter die hier gisteren is besproken, deelt Hugging Face het volledige recept voor zijn harness adapters: LoRA’s die via reinforcement learning binnen een agentharness (pi, Hermes Agent of OpenCode) zijn getraind, boven op Qwen3.8-27B. De nieuwigheid is een superadapter: de drie LoRA’s met rang 32 worden samengevoegd tot één LoRA met rang 96, die in alle drie de harnesses werkt. Doordat hun updates vrijwel orthogonaal zijn (cosinus van 0,01 tot 0,02), past de combinatie alle drie exact toe.
| SWE-bench Pro (51 moeilijke taken), met redenering | Basismodel | Met de superadapter |
|---|---|---|
| Hermes Agent-harness | 45 % | 61 % |
| OpenCode-harness | 47 % | 67 % |
| pi-harness | 74 % | 74 % |
Met redenering stijgt het gemiddelde van de zes combinaties van harness en benchmark van 55,5 naar 63,5 %, met 19 tot 48 % minder toolaanroepen, volgens de thread van het team; zonder redenering wint de superadapter 6 tot 18 punten op SWE-bench Pro, met 53 tot 73 % minder toolaanroepen, volgens de blogpost. De scores zijn niet tussen harnesses te vergelijken, omdat hun standaardinstellingen verschillen. De training vergde 598 stappen en 167 miljoen tokens; de beveiligingslaag safeagents controleerde 1,3 miljoen toolaanroepen en blokkeerde er 647. Taken, adapters, GGUF en evaluatietrajecten zijn gepubliceerd.
🔗 Harness adapters op schaal (Hugging Face) · @yb2698 op X
Metric AI publiceert Ayb 0.5, OhanTTS en OhanASR, open tekst- en spraakmodellen voor het Armeens
20 november — Het Armeense team Metric AI publiceert op dezelfde dag drie modelfamilies voor zijn taal. Ayb 0.5 omvat drie taalmodellen (0,8B, 4B en 9B) die zijn gebouwd op Qwen3.5 en aangepast aan het Armeens, van de uitgebreide tokenizer tot de post-training; Ayb-9B ondersteunt gesprekken met meerdere beurten, toolaanroepen en afbeeldingen. OhanTTS-v0.1 genereert spraak in acht talen, waaronder Armeens en Frans, en kloont een stem op basis van 3 tot 10 seconden audio. OhanASR-v0.1, een spraakherkenningsmodel van 2B, is gefinetuned op 820 uur Armeens.
| Model van Metric AI | Door de auteurs gepubliceerd resultaat |
|---|---|
| Ayb-9B | 3e in het algemene klassement van ArmBench (0,6164) |
| OhanTTS-v0.1, 61 uur Armeens | 14,70 % WER, eerste geluid na 331 ms op een GB10 |
| OhanASR-v0.1 | 16,12 % WER (2e) en 3,49 % CER (1e) op ArmBench-ASR |
De gewichten van Ayb-9B vallen onder een niet-commerciële licentie (CC BY-NC 4.0) en zijn toegankelijk na handmatige goedkeuring.
🔗 Ayb 0.5 (Metric AI) · OhanTTS · OhanASR
Apple publiceert Depth Pro 2, dat diepte in meters schat op foto’s en video’s
19 november — Apple publiceert Depth Pro 2, een familie van modellen die op zowel foto’s als video’s de diepte in meters schatten, op de oorspronkelijke resolutie. Volgens de samenvatting van het artikel moesten bestaande methoden kiezen tussen consistentie van beeld tot beeld en scherpe contouren; Depth Pro 2 streeft beide na met één netwerk. De gewichten staan op Hugging Face in vier groottes (S, B, L, H), met een Core ML-versie en een gedeelde schatter voor de brandpuntsafstand, handig wanneer die ontbreekt in de EXIF-gegevens.
| Door DepthPro2-L verwerkte resolutie (334M, op B200) | Beelden per seconde |
|---|---|
| VGA | 150,1 |
| 720p | 33,7 |
| 1080p | 9,1 |
| 4K | 0,7 |
De gewichten zijn uitsluitend bedoeld voor niet-commercieel onderzoek (Apple Machine Learning Research Model-licentie), en de code staat op GitHub. Pedro Cuenca van Hugging Face wees op 20 november op de release, met een online demonstratie.
🔗 @pcuenq op X · arXiv-artikel 2611.26603 · DepthPro2-L (Hugging Face)
Modelbeveiliging: OpenAI bestrijdt vijandige distillatie, Sakana AI richt zijn Security Research Group op
OpenAI licht zijn strijd tegen vijandige distillatie toe en verlaagt de extractie van beschermde redeneringen van 54,0 % naar 0,2 %
20 november — OpenAI publiceert een bericht over vijandige distillatie (adversarial distillation): het ongeoorloofde gebruik van de uitvoer van een geavanceerd model om een ander model te trainen, dat zonder dezelfde veiligheidsmaatregelen wordt ingezet, bijvoorbeeld voor aanvallen die het oorspronkelijke model zou hebben geweigerd. Het bericht richt zich vooral op beschermde redeneringen, de redeneerketen die vóór het antwoord wordt geproduceerd: volgens intern onderzoek boekt een leerlingmodel doorgaans meer vooruitgang met de exacte redeneerstappen dan met samenvattingen ervan.
| Gemeten aanval (adaptieve evaluatie, zes aanvallende modellen) | GPT-6 Astra, oorspronkelijke veiligheidsmaatregelen | GPT-6.2 Astra, bijgewerkte veiligheidsmaatregelen |
|---|---|---|
| Redenering bij een eerder verzoek | 54,0 % | 0,2 % |
| Redenering bij het huidige verzoek | 22,9 % | 0,9 % |
De verdediging combineert adversarial training, classificatiemodellen voor invoer en uitvoer (inclusief argumenten van toolaanroepen), API-controles en onderzoeken, met wekelijkse sancties tegen campagnes van enkele duizenden tot enkele tienduizenden accounts. Bij GPT-6.2 Astra en Sol is de beschermde redenering gekoppeld aan de gespreksgeschiedenis waaruit die is ontstaan: de API verwerpt die als een eerder bericht wordt herschreven, en oudere modelfamilies kunnen die niet meer lezen. OpenAI herinnert eraan dat het in februari aan het Congres activiteiten heeft gemeld die erop wezen dat DeepSeek Amerikaanse modellen probeerde te distilleren, en in september een campagne heeft toegeschreven aan personen met banden met Moonshot AI; het zegt de Chip Security Act, de AI OVERWATCH Act en de MATCH Act te steunen.
🔗 Bestrijding van adversarial distillation (OpenAI) · @OpenAI op X
Sakana AI richt zijn Security Research Group op, een onafhankelijk team voor collectieve cyberverdediging
20 november — Sakana AI lanceert zijn Security Research Group, een onafhankelijk R&D-team in Tokio, dat losstaat van de commerciële activiteiten en zich richt op het algemeen belang.
Excited to announce the Sakana AI Security Research Group, an independent, public-interest R&D team in Tokyo co-led by Akihiro Umegai and me.
🇳🇱 Ik ben blij de Sakana AI Security Research Group aan te kondigen, een onafhankelijk R&D-team in het algemeen belang in Tokio, dat Akihiro Umegai en ik samen leiden. — @hardmaru op X
David Ha is medeoprichter en algemeen directeur van Sakana AI. Het team zal aan drie speerpunten werken: preventie vanaf het ontwerp, collectieve verdediging met agents die over organisaties zijn verspreid, en de beveiliging van de verdedigende agents zelf, waarvan de bevoegdheden tot hun taak worden beperkt en de acties worden vastgelegd. Het bouwt voort op eigen werk zoals Digital Red Queen, ShinkaEvolve en Fugu-Cyber, waarvoor Sakana AI 86,9 % op CyberGym en 72,1 % op CTI-REALM meldt; een toelichting in het bericht vermeldt dat de pagina van Fugu-Cyber geen referentiescores of evaluatieprotocol geeft. Het zal whitepapers, benchmarks en verdedigingsgidsen publiceren, maar geen exploitmateriaal, en gevonden kwetsbaarheden zullen via gecoördineerde openbaarmaking worden gemeld. Sakana AI herinnert eraan dat het aantal CVE-aanvragen volgens het NIST tussen 2020 en 2025 met 263 % is gestegen.
🔗 Security Research Group (Sakana AI)
Agents voor softwarelevering: de fabriek van Runway, Stitch Loop van Google Labs
Runway vertrouwt zijn softwareleveringsproces toe aan agents, die in oktober 38 % van zijn merges aanstuurden
20 november — Runway publiceert op zijn engineeringblog de cijfers van zijn ‘softwarefabriek’ (software factory): zeven stappen, van het schrijven van code tot de coördinatie van merges, die één voor één aan agents zijn toevertrouwd. Cloudagents stuurden 38 % van de in oktober gemergede pull requests aan, en van 100 van deze PR’s die in de eerste helft van november werden gemerged, bevatten er 78 geen enkele door een mens gemaakte commit.
| Indicator van de softwarefabriek | Uitgangspunt | Laatste meting |
|---|---|---|
| Merges aangestuurd door cloudagents | 0,1 % (juni) | 38 % (oktober) |
| Mediane wachttijd tot de eerste goedkeuring | 2,3 h (september) | ongeveer 5 min (half november) |
| Gemiddeld aantal merges per week | 929 (september) | 2 235 (sinds half oktober) |
Sinds half oktober keurt de AI zelfstandig PR’s goed die als laag risico zijn ingedeeld, en ook die met een gemiddeld risico als de repository dat toestaat; PR’s met een hoog risico gaan naar een persoon, en de eigenaren van de code keuren nog altijd migraties, de CI- en deploymentconfiguratie, secrets en authenticatie goed. In september en oktober betwistte een persoon 15 van de 977 door de AI goedgekeurde PR’s, en merges die uitsluitend door de AI zijn goedgekeurd hebben een rollbackpercentage van 0,10 %, tegenover ongeveer 1 op 200 bij menselijke goedkeuringen. Agents testen App Studio ook als een gebruiker (86 bevestigde bugs in vier dagen), en een coördinator verdeelde in twee weken meer dan 14 000 taken. Het gaat om interne tools, zonder product of prijs.
🔗 Een softwarefabriek bouwen (Runway)
Google Labs lanceert Stitch Loop, een productagent die een online applicatie voortdurend verbetert
18 november — Google Labs presenteert Stitch Loop, een langdurig actieve productagent die verdergaat waar een codeagent stopt: na de ingebruikname in productie. Hij maakt verbinding met de GitHub-repository en de gegevens van het online product (logs, gebruikersgedrag, feedback) via meer dan 180 integraties, aangepaste MCP-servers of gegevens die vanuit een lokale CLI worden aangeleverd, en werkt voortdurend aan meetbare doelen.
Elke cyclus stelt op gegevens gebaseerde verbeteringen voor, werkt de oplossingen en hun afwegingen uit, schrijft de code in een geïsoleerde cloudsandbox en opent een pull request ter goedkeuring, waarna de live meetgegevens worden gevolgd. Er worden standaard drie cycli aangeboden (cyberbeveiliging, latentie, toegankelijkheid); de beveiligingscyclus combineert Gemini 4 Carbon met CodeMender, de codebeveiligingsagent van Google DeepMind. Er wordt pas gemerged nadat het team de wijzigingen heeft nagekeken. Stitch Loop dient via de Stitch CLI en MCP ook als bron van productcontext voor codeagents zoals Google Antigravity, en is te gebruiken in Slack. Voorlopig is er alleen een wereldwijd opengestelde wachtlijst, met voorrang voor Google AI Ultra-abonnees die daarvoor in aanmerking komen.
Assistenten voor consumenten: ChatGPT Space voor Plus-abonnees, GIF’s in de Gemini-app, Perplexity Computer in Chromium-browsers
ChatGPT Space wordt beschikbaar voor Plus-abonnees over de hele wereld
20 november — ChatGPT Space, dat op de DevDay van 29 september werd gepresenteerd en tot nu toe was voorbehouden aan de abonnementen Pro, Business en Enterprise, wordt wereldwijd uitgerold voor Plus-abonnees van 18 jaar en ouder. Space vervangt de Bibliotheek in de zijbalk (pagina’s, dia’s, afbeeldingen, geüploade bestanden), op het web, in de desktopapp, op iOS en op Android.
Je maakt er met ChatGPT interactieve pagina’s en presentaties, die andere mensen met toegang tot Space kunnen aanvullen. Pagina’s en dia’s kunnen zichzelf bijwerken vanuit gekoppelde apps: OpenAI noemt een takenlijst die zichzelf actualiseert of een projectplan dat de in Slack genomen besluiten volgt. Een vermelding van ChatGPT in een opmerking volstaat om een wijziging te vragen, en een dot kan worden uitgenodigd om samen te werken. Delen blijft beperkt: er is leesmachtiging nodig en een Plus-, Pro-, Business- of Enterprise-account met toegang tot Space; Free-accounts kunnen gedeelde inhoud niet openen, en er is geen openbare link.
De Gemini-app maakt geanimeerde GIF’s met Gemini Omni 1.2 Flash, gratis in Frankrijk
20 november — De Gemini-app maakt nu geanimeerde GIF’s (herhalende foto-effecten, memes) met Gemini Omni 1.2 Flash, het videomodel dat Google op 5 november lanceerde, volgens Google voor vloeiende bewegingen en een consistente kwaliteit van frame tot frame. Je schrijft je verzoek in de hoofdchat, of opent de afbeeldings- of videotool, en kiest vervolgens GIF in de formaatkiezer.
GIFs are now available to all Google AI subscribers and free of charge in the U.S., Japan, Korea, Australia, Canada, U.K., Germany, and France.
🇳🇱 GIF’s zijn nu beschikbaar voor alle Google AI-abonnees, en gratis in de Verenigde Staten, Japan, Korea, Australië, Canada, het Verenigd Koninkrijk, Duitsland en Frankrijk. — @GeminiApp op X
Franse gebruikers zonder abonnement hebben er dus toegang toe. Google volgt daarmee OpenAI, waarvan de geanimeerde GIF’s in ChatGPT met Images 2.6 hier op 5 november zijn besproken.
🔗 @GeminiApp op X: GIF’s in Gemini
Perplexity Computer werkt dankzij de Perplexity-extensie rechtstreeks in Chromium-browsers
20 november — Perplexity Computer werkt nu dankzij de Perplexity-extensie rechtstreeks in browsers die op Chromium zijn gebaseerd. Je geeft een taak op vanuit het zijpaneel van de extensie en volgt Computer terwijl die in de tabbladen en tools van de gebruiker werkt. De aankondigingstweet vermeldt niet voor welke abonnementen dit geldt of welke browsers worden ondersteund.
Twee eerdere stappen: op 5 oktober kon Computer via de Mac-app 26.38.0 dankzij een extensie Chrome, Edge of Brave gebruiken, en op 30 oktober koppelde een Chrome-extensie de Mac- en Windows-apps van Computer aan de browser van de gebruiker. Deze keer wordt de taak vanuit het zijpaneel van de extensie in de browser opgegeven.
API’s en SDK’s voor ontwikkelaars: Codex in de Agents SDK Python, Decider in de Context API van Perplexity
De Agents SDK Python van OpenAI publiceert een preview van 1.0 die van Codex een modelprovider maakt
20 november — De Agents SDK Python van OpenAI begint zijn 1.0-reeks met een preview die de aanpak verandert: in plaats van een afzonderlijke native engine, zoals in de hier op 16 november besproken preview 0.24, wordt Codex een modelprovider die je bij elke uitvoering kiest. Je maakt een CodexProvider en geeft die via RunConfig(model_provider=provider) door aan de Runner; de agent draait dan met de opgeslagen Codex-aanmelding of met een API-sleutel.
De Python-wheel bevat Codex Core (rust-v0.166.0, ongewijzigd) via PyO3: de SDK roept de kern van Codex rechtstreeks aan, zonder codex app-server te starten of JSON-RPC te gebruiken. Python-tools, overdrachten naar een gespecialiseerde agent (handoffs), goedkeuring vóór het gebruik van een tool en getypeerde uitvoer blijven beschikbaar, en native commando’s volgen de sandbox- en goedkeuringsregels van Codex. De wheels voor 1.0.0a1 worden uitsluitend via GitHub Releases verspreid (Linux x86-64 en ARM64, macOS 11 en hoger op Apple silicon, Windows x64, CPython 3.10 tot en met 3.14). De opgeslagen gegevens van preview 0.24.0-alpha.8 zijn niet compatibel met de Runner, en de stabiele versie blijft 0.25.0 van 18 november.
🔗 openai-agents-python v1.0.0-alpha.1
Perplexity voegt Decider toe aan de Context API om pagina’s te scoren, ook op prompt injections
19 november — Perplexity voegt Decider, zijn beslismodel, toe aan de Context API die twee dagen eerder werd gelanceerd (1 dollar voor 1 000 URL). Je kunt over elke opgehaalde pagina maximaal vijf gesloten vragen stellen (ja of nee), en Decider geeft elk antwoord een score van 0 tot 1. De uitgelichte toepassing betreft beveiliging: een prompt injection (prompt injection) in een pagina opsporen voordat een agent die leest. Perplexity noemt ook de kwalificatie van prospects, moderatie en het opsporen van gezondheidsclaims zonder bron.
De API filtert zelf niets: die retourneert alle pagina’s met hun scores, en de code van de applicatie past een drempelwaarde toe. De score wordt gefactureerd in invoertokens van de Decisions API, boven op de prijs per URL, en kan het verzoek met maximaal 15 seconden vertragen. Het cookbook in de documentatie toont een controle die op 18 november is uitgevoerd met een drempelwaarde van 0,7:
| Geteste pagina (cookbook van 18 november) | Injectiescore | Beslissing van de controle |
|---|---|---|
| Demonstratie van een injectie (Greshake et al., 2023) | 0,97 | in quarantaine geplaatst |
| OWASP, pagina over prompt injection | 0,0018 | doorgelaten |
| RFC 9111 | 0,0007 | doorgelaten |
Het cookbook waarschuwt dat een lage score een pagina niet veilig maakt: volgens het BrowseSafe++-onderzoek van Perplexity volgde elk getest model nog steeds bepaalde injecties op die het zelf had gemarkeerd.
🔗 Thread van @perplexitydevs · Documentatie · Cookbook
Codeagents: Claude Code 2.1.329, Codex CLI 0.171.0, Vibe CLI 3.1.4 en Gemini 4 Neon in Devin
Claude Code 2.1.329 toont bij het openen van een map waar hooks vandaan komen en bundelt geplande taken in /tasks
19 november — Claude Code 2.1.329 telt 130 vermeldingen, waaronder 91 fixes, 20 wijzigingen en 7 toevoegingen. Wat beveiliging betreft, geeft het dialoogvenster dat vraagt of je een map vertrouwt nu aan waar de hooks zijn gedeclareerd, en waarschuwen Claude Desktop en andere niet-interactieve hosts wanneer hooks die door beheerde instellingen (managed settings) worden opgelegd niet worden geladen. /tasks toont ook de geplande taken van de sessie, de wekmomenten van /loop, het huidige doel en de forks van het gesprek; de meeste geplande taken die met eerdere versies zijn opgeslagen, moeten opnieuw worden ingepland.
/code-review controleert zonder doel nu bij de meeste modellen de hele branch ten opzichte van de standaardbranch, en leest met een PR-nummer de PR zelf via gh pr diff. Op macOS gaat computer use over op nieuwere beveiligingsregels, die bepaalde acties weigeren. De automatische herstart die in 2.1.326 na een max_tokens-fout werd toegevoegd, verdwijnt: achter een gateway moet CLAUDE_CODE_MAX_OUTPUT_TOKENS worden ingesteld. Code Mode krijgt 17 vermeldingen, waaronder ondersteuning voor OpenTelemetry-events en -metrics. Versie 2.1.330 staat sinds 20 november op npm.
Codex CLI 0.171.0 stelt GPT-6.2 Sol als standaard in en activeert de terminalwerkruimte
20 november — Codex CLI 0.171.0 is de eerste stabiele versie sinds 0.170.0 van 18 november en bundelt 339 pull requests. GPT-6.2 Sol en GPT-6.2 Astra worden aan de modelcatalogi toegevoegd, waarbij Sol standaard is geselecteerd, en de commando’s /rc en /remote beheren vanuit de terminal de lokale bediening op afstand en tonen de koppelcodes van apparaten.
Verschillende vernieuwingen uit de previews van 14 tot en met 17 november komen naar de stabiele versie: de werkruimte van de TUI, die standaard is ingeschakeld, toont voorbeelden van documenten en afbeeldingen en transcripties van subagents naast het gesprek; codex exec --remote start of hervat een niet-interactieve sessie op een bestaande applicatieserver; het invoerveld krijgt functies voor ongedaan maken en opnieuw uitvoeren; /statusline kiest statusregels die door een MCP-server worden aangeleverd, waarvoor een optie moet worden ingeschakeld. Onder de fixes: concepten en nieuwe pogingen in de wachtrij blijven gekoppeld aan hun gesprek, en de MCP-verbinding voor bedrijven werkt met identiteitsproviders die geen refresh token afgeven.
Vibe CLI 3.1.4 scheidt de agent van het goedkeuringsbeleid en ontneemt agents het recht bevestigingen over te slaan
20 november — Mistral brengt Vibe CLI 3.1.4 uit, twee dagen na 3.1.3, waarin Mistral Large 4 het standaardmodel werd. De 79 vermeldingen (18 toevoegingen, 41 wijzigingen, 18 fixes, 2 verwijderingen) gaan vooral over rechten: elke sessie combineert voortaan twee onafhankelijke instellingen, een agent (default, lean of een aangepaste agent) en een goedkeuringsbeleid (ask, accept-edits, smart-approve of auto-approve), gekozen via --approval-policy of default_approval_policy.
Een agent bepaalt niet langer zelf wat zonder bevestiging wordt uitgevoerd: zijn instellingen safety, bypass_tool_permissions en permission = "always" worden genegeerd. Een project kan het goedkeuringsbeleid niet meer overschrijven in zijn map .vibe/agents/, en zowel forks als onderliggende sessies erven het oorspronkelijke beleid. De interface krijgt een rij badges boven het invoerveld (subagents, achtergrondtaken, pull requests, doel, taken), een instelling keep_awake voorkomt de slaapstand tijdens een beurt, en Vibe ondersteunt systeemcertificaten, wat helpt bij gebruik achter een bedrijfsproxy. Alleen de 8 recentste afbeeldingen worden voortaan naar de modellen van Mistral gestuurd, en aangepaste prompts voor compaction zijn verwijderd.
Devin stelt Gemini 4 Neon beschikbaar, met 46,2 % op FrontierCode 2.0 voor 4,38 dollar per taak
19 november (bericht gedateerd op de 18e) — Na Cursor en GitHub Copilot, die hier gisteren aan bod kwamen, stelt Cognition Gemini 4 Neon beschikbaar in Devin Desktop en Devin CLI. Op FrontierCode 2.0, de benchmark die beoordeelt of een pull request moet worden gemerged, behaalt Neon 46,2 %, volgens Cognition het beste resultaat van een Google-model. Het zit daarmee ongeveer één procentpunt onder Claude Opus 5.5 (47,3 %) voor ongeveer een derde van de kosten: 4,38 dollar per taak tegenover 12,82 dollar.
| Model geëvalueerd op FrontierCode 2.0 | Door Cognition gepubliceerde score |
|---|---|
| Claude Fable 5.2 | 50,2 % |
| Claude Opus 5.5 | 47,3 % |
| Gemini 4 Neon | 46,2 % |
| GPT-6.2 Astra | 44,2 % |
| GPT-6.2 Sol | 43,8 % |
| Gemini 4 Carbon | 42,6 % |
De kosten komen overeen met de gemiddelde uitgaven per uitvoering tegen het standaardtarief van de API, inclusief openbare kortingen, en een oplossing die niet aan een doorslaggevend criterium voldoet, krijgt een nulscore. Verschillende scores in deze grafiek wijken af van waarden die in de voorgaande weken zijn gepubliceerd, zonder toelichting in het bericht.
🔗 Gemini 4 Neon in Devin (Cognition) · @cognition op X
Wetenschap: OpenAI publiceert MedChemBench, een benchmark voor medicinale chemie waarop GPT-6.2 Astra 84,5 % behaalt
20 november — OpenAI presenteert MedChemBench, een benchmark die meet hoe goed modellen kunnen redeneren als een medicinaal chemicus: de structuur van een molecuul koppelen aan experimentele resultaten, verbindingen vergelijken en hun eigenschappen voorspellen. De benchmark bevat 99 vraagstukken uit 117 artikelen en patenten, met 761 verschillende molecuulstructuren, en beoordeelt vier onderdelen: structuren, wetenschappelijk redeneren, selectie van verbindingen en voorspelling van eigenschappen.
| Geëvalueerd model (redeneerniveau xhigh) | Behaalde score |
|---|---|
| GPT-6.2 Astra | 84,5 % |
| GPT-6 Astra | 83,3 % |
| GPT-6.1 Sol | 82,0 % |
| GPT-6.1 Terra | 75,1 % |
| GPT-5.6 Sol | 58,2 % |
De prestaties zijn ongelijk: GPT-6 Astra behaalt 95,4 % van de punten voor structuren, maar ongeveer de helft voor de selectie van verbindingen en de voorspelling van numerieke waarden. OpenAI blijft voorzichtig: de benchmark gebruikt historische gegevens en toont niet aan dat de modellen nieuwe geneesmiddelen kunnen ontdekken, eerdere blootstelling aan de bronpublicaties kan niet worden uitgesloten, en alleen GPT-modellen zijn geëvalueerd. Hij volgt op BioBasicsBench, dat hier op 6 november aan bod kwam.
🔗 Introductie van MedChemBench (OpenAI) · Volledig artikel (PDF)
Generatieve video en audio: ElevenLabs voegt aan Ads Engine advertentievarianten zonder nieuwe opnamen toe
20 november — ElevenLabs breidt Ads Engine uit, zijn tool voor het maken van advertenties die in ElevenCreative is geïntegreerd en in juni werd gelanceerd. De tool is gekoppeld aan advertentieaccounts van Google, Meta, LinkedIn en nu ook TikTok en gebruikt bestaande advertenties en hun resultaten om varianten te produceren zonder nieuwe opnamen. Hij herkent de aandachtstrekker aan het begin (hook) en schrijft nieuwe op basis van advertenties die goed presteerden; die worden uitgesproken door een digitale replica van de stem van de oorspronkelijke spreker, met lipsynchronisatie en bijgewerkte ondertiteling. Nieuwe soundtracks, die de ElevenLabs Music API componeert op basis van de sfeer en het ritme van de beelden, mogen commercieel worden gebruikt.
Voor lokalisatie, die al door Dubbing v2 werd verzorgd, stemt Ads Engine de lipbewegingen van de spreker voortaan af op de doeltaal en vervangt de tool de ingebakken ondertiteling door een vertaalde versie, met de timing en lettertypen van het merk. Menselijke controle blijft mogelijk vóór publicatie, ook door een lokalisatieprofessional die de doeltaal als moedertaal heeft, en de tool kan rechtstreeks op de platforms publiceren. Toegang verloopt via het verkoopteam; er zijn geen prijzen gepubliceerd.
🔗 Varianten en lokalisatie van videoadvertenties in Ads Engine (ElevenLabs)
Kort nieuws
Codeagents
- Copilot CLI 1.0.115-2 — In deze preview met 351 vermeldingen, waaronder 335 fixes, verschijnt Gemini 4 Hydrogen in de modelkiezer met de inspanning Extra High wanneer het account toegang heeft, wordt GPT-6.2 Astra ondersteund en werkt
/modelook met modellen van aangepaste providers; de stabiele versie blijft 1.0.114. 🔗 bron - Codex CLI 0.173.0-alpha.1 en alpha.2 — De releasenotes van deze previews zijn leeg; volgens de titels van de 71 commits worden gedeelde MCP-verbindingen en OAuth-discovery voor geconfigureerde servers standaard ingeschakeld, en kunnen beheerders updates van de Codex-daemon uitschakelen. De inhoud kan nog veranderen vóór de stabiele versie. 🔗 bron
- Gemini CLI — Eerste nightly sinds 4 november (v0.71.0-nightly.20261120); op de hoofdbranch opent
gemini --resumede laatst gebruikte sessie opnieuw in plaats van de laatst gestarte, en paden die met~\beginnen, worden eindelijk ook onder Windows uitgebreid. 🔗 bron - Antigravity IDE 2.8.0 — De editor van Google start zijn backend onmiddellijk en controleert op de achtergrond op updates, stuurt automatisch poorten door voor verbindingen op afstand, laat je met het toetsenbord in een gesprek zoeken en ondersteunt aangepaste certificaten en een proxy bij het verbinden. 🔗 bron
- Qwen Code 0.28.1-preview.1 — Deze preview met 179 vermeldingen maakt GitHub de derde ondersteunde kanaaladapter, voegt WeCom, Microsoft Teams en generieke uitgaande webhooks toe die via de webinterface kunnen worden geconfigureerd, en geeft de CLI een weergave voor schermlezers; de stabiele versie blijft v0.28.0. 🔗 bron
- Kimi Code 2.7.1 en 2.7.2, Kimi Code Desktop 1.4.1 en 1.4.2 — Vier versies met fixes op de dag na 2.7.0: de in een concept gekozen redeneerinspanning valt na verzending niet meer terug op de standaardwaarde, en forks mislukken niet meer na het herstellen van een sessie die tijdens een beurt is bijgestuurd. 🔗 bron
- mistral CLI 0.20.1 —
mistral evals execeindigt voortaan met een fout (code 1) wanneer alle aanroepen tijdens een uitvoering zijn mislukt, bijvoorbeeld door een 401-fout, in plaats van de uitvoering als geslaagd te melden; een onderbreking met Ctrl-C wordt als zodanig gemeld. 🔗 bron - Replit — Werkruimten (Workspaces) kunnen voortaan worden doorzocht en vastgezet, een optie die pas vanaf vijf werkruimten verschijnt. 🔗 bron
- Devin Bot voor Manim — Cognition toont de Devin Bot die Grant Sanderson heeft ingesteld om hem te helpen met Manim, het open source animatiesysteem achter de video’s van 3Blue1Brown (96,6 k sterren, 250 000 downloads per maand); de tweet vermeldt niet welke taken de bot kreeg of wat de resultaten waren. 🔗 bron
API’s en platforms
- Gemini API — Sinds 17 november kan Gemini 3.5 Transcribe, zowel in de klassieke als in de liveversie, een dictaat of bestaande tekst via spraak wijzigen, herschrijven en opmaken (parameter
source_text), en Google noemt ook vertalen. Sinds de 18e maakt de API het mogelijk om alleen het relevante deel van verstuurde bestanden te verwerken en te betalen: paginabereiken, tabbladen, cellen, tijdsintervallen of inhoudslagen. 🔗 bron - Tijdsbesef in de Agents API — Een experimentele optie (
experimental={"time_awareness": True}) herinnert het model regelmatig aan de tijd, zodat het zijn werk kan afstemmen op een deadline; in combinatie met asynchrone tools kan een agent hiermee een vraag stellen en verder zoeken terwijl hij op het antwoord wacht, zoals een bericht op het ontwikkelaarsblog van OpenAI laat zien. 🔗 bron - Gespreksgeschiedenis met GPT-6.2 — @OpenAIDevs vraagt om eerdere berichten in de Responses API niet meer te wijzigen, omdat de API het redeneerwerk na de wijziging verwijdert. Een nieuwe sectie Reasoning removals in het Usage-dashboard helpt dit te herkennen, en de bijbehorende gids stelt voor om in plaats daarvan een element
configuration_updateofadditional_toolstoe te voegen om de inspanning of tools te wijzigen. 🔗 bron
Consumentenassistenten
- ChatGPT rolt een nieuwe mobiele app uit met een tabblad voor de dot en vastgezette favorieten — Codex, Projects of Images kunnen in de tabbladbalk worden vastgezet; de uitrol begint bij Pro-gebruikers van 18 jaar en ouder waar dots beschikbaar zijn, buiten de Europese Economische Ruimte (inclusief de EU), het Verenigd Koninkrijk, Zwitserland en Korea, en bij een kleine groep Plus-gebruikers (releasenotes van 19 november, hierboven gelinkt).
- Teammates van Perplexity — Max-abonnees kunnen voortaan vanuit elke Computer-taak op het web een teammate maken en vervolgens de naam, rol of avatar ervan in hetzelfde gesprek wijzigen. 🔗 bron
- Mac-app van Perplexity — De app is sneller en voegt ‘Send now’ toe om een lopende taak bij te sturen, ⌘F om in tabellen, Markdown en voorvertoningen te zoeken, en ⌘⇧T om een gesloten tabblad opnieuw te openen. 🔗 bron
Generatieve video en audio
- Seedance 2.5 Flash op Pika — Na Runway en HeyGen voegt Pika de snelle variant van het videomodel van ByteDance toe voor werk met veel takes: video’s tot 30 seconden in 480p of 720p, met maximaal 10 afbeeldingen, 5 video’s en 5 audioclips als referentie; de tweet vermeldt geen prijs. 🔗 bron
- Avatar 6 van HeyGen — Nieuwe blinde tests uit het technische rapport: wanneer de gefilmde personen, medewerkers van HeyGen, de video kiezen die het meest op hen lijkt, wint Avatar 6 in 86,5 % van de gevallen van Seedance 2.5 en in 87,9 % van Wan 3.0; deze evaluaties worden door HeyGen uitgevoerd. 🔗 bron
- Qwen3 TTS bij Together AI — Het open spraaksynthesemodel Qwen3-TTS-12Hz-1.7B (Apache 2.0) wordt aangeboden voor 20 dollar per miljoen tekens, met negen stemmen die via een instructie in gewone taal kunnen worden aangepast, tien talen waaronder Frans en in het beste geval het eerste geluid na 97 ms. 🔗 bron
Infrastructuur en onderzoek
- Together Storage Accelerator — Together AI biedt bij elk GPU-cluster een NVMe-cache voor S3-opslag en de Hugging Face Hub, zonder codewijzigingen; volgens eigen metingen daalt de leestijd van een bestand van 2 Gio uit Cloudflare R2 van 12,7 tot 15,0 s naar 0,64 tot 0,72 s, en downloadt een cluster van 200 nodes slechts één keer van de oorspronkelijke bron. 🔗 bron
- CDN van Hugging Face — Hugging Face levert volgens medeoprichter Julien Chaumond maandelijks bijna een exabyte aan open modellen en datasets en heeft een eigen distributienetwerk (CDN) gebouwd voor AI-downloads. 🔗 bron
- Superfluid van basecompute — De lokale server verdeelt inference voortaan over machines van Apple, AMD en NVIDIA: zes machines verhogen de doorvoer van 112 naar 534 outputtokens per seconde voor 64 gesimuleerde gebruikers, en bij het uitschakelen van een node gaat volgens de maker geen enkel verzoek verloren. 🔗 bron
- WavLate — Dit open model met late interaction zoekt geluiden via tekst en tekst via geluid, met één vector per 0,31 seconde geluid en één per woord; de auteur meldt een gemiddelde Recall@1 van 37,9 op AudioCaps en Clotho, de beste score van de negen vergeleken open modellen, en publiceert de gewichten en gegevens. 🔗 bron
- WorldTrace — NVIDIA Research presenteert een geheugen voor interactieve videowereldmodellen, zonder hertraining (artikel geaccepteerd voor NeurIPS 2026): op LoopBench verbetert het terughalen van opnieuw bezochte scènes met 32,6 % ten opzichte van een schuivend venster, bij 3,1 Go GPU-geheugen en 27 % extra uitvoeringstijd. 🔗 bron
- Dynamo voor reinforcement learning — NVIDIA beschrijft hoe Dynamo rollouts tijdens post-training afhandelt: routering op basis van de KV-cache, differentiële overdracht van gewichten met ModelExpress en herstel van uitgevallen workerprocessen. Microsoft AI, Cognition (voor SWE-1.7), Prime Intellect en H Company gebruiken het; H Company bespaart tot 20 % tijd per trainingsstap. 🔗 bron
- Sparse attention — In een gids van 17 november geeft NVIDIA acht ontwerpregels voor sparse attention die op zijn GPU’s wordt getraind; de indexer die de tokens selecteert en Top-k nemen 47 % in beslag van een prefill-laag van DeepSeek V3.2 bij 128K tokens. 🔗 bron
GitHub
- GitHub Enterprise Server 3.23 als release candidate — Detectie van secrets met AI, in publieke preview, draait op de processor van de appliance, zonder GPU, gehost LLM of uitgaande verbinding, ook in een geïsoleerde omgeving (air-gapped); de versie breidt de detectie van bekende schadelijke pakketten ook uit naar zeven andere ecosystemen naast npm. 🔗 bron
- Buiten AI — GitHub verduidelijkt de mergestatus op de nieuwe Overview-pagina van pull requests, GitHub Desktop 3.7.0 ondersteunt meerdere accounts op dezelfde host, en het dashboard toont maximaal 25 favoriete repositories. 🔗 Overview · 🔗 Desktop · 🔗 favorieten
Bedrijven en essays
- Hebbia — In tests met financieel onderzoek uit augustus en september citeert een preview van GPT-6 Astra in 99,5 % van de gevallen relevante fragmenten en voldoet die aan 97,9 % van de presentatievereisten, 14,4 procentpunt meer dan het beste geteste alternatief, dat niet wordt genoemd in de door OpenAI gepubliceerde casestudy. 🔗 bron
- De stille consensus — OpenAI publiceert in zijn rubriek Het tijdperk van intelligentie (Intelligence Age) een essay van Dean Ball, bewerkt op basis van een lezing aan Harvard en gepresenteerd als de opvattingen van de auteur, tegen het idee dat het opgeven van de menselijke voorrang onvermijdelijk zou zijn; hij pleit voor agents die aan personen zijn gekoppeld, met beperkte en intrekbare rechten. 🔗 bron
- Dataverrijking — Een gids van Perplexity beschrijft in zes stappen hoe je CRM-records aanvult en controleert met een model dat met het web is verbonden; Apollo voert hiervoor maandelijks 5,6 miljoen verrijkingen uit via de API van Perplexity. 🔗 bron
Wat dit betekent
De beursgang van Anthropic brengt in één bericht het geld van de financiële markten en dat van de industrie samen. Het openbare aanbod levert het bedrijf ongeveer 91,6 miljard dollar bruto op, en de private plaatsing nog eens 26 miljard, waarvoor zeven groepen uit de halfgeleider- en computerindustrie tegen dezelfde prijs van 83 dollar hebben ingeschreven: AMD, Broadcom, Google, Micron, Microsoft, NVIDIA en TSMC Partners. In totaal nadert de operatie 119,5 miljard dollar bruto: naast de beleggers in het openbare aanbod kopen zeven industriegroepen aandelen in een laboratorium voor IA dat nu aan de Nasdaq genoteerd staat.
Beveiliging wordt steeds vaker in de werking van de tools zelf geregeld. OpenAI koppelt de redenering van GPT-6.2 aan de gespreksgeschiedenis waaruit die is voortgekomen, waardoor de gemeten extractie daalt van 54,0 % naar 0,2 %, maar ontwikkelaars hun gesprekken niet meer mogen herschrijven. Vibe CLI ontneemt agents de bevoegdheid om zelf bevestigingen uit te schakelen, Claude Code toont waar de hooks van een map vandaan komen voordat je die map vertrouwt, en Decider beoordeelt pagina’s voordat een agent ze leest. Sakana AI richt op zijn beurt een team op voor gezamenlijke verdediging en belooft geen exploitmateriaal te publiceren.
Agents gaan verder dan het schrijven van code en krijgen een rol in het releaseproces. Bij Runway sturen ze 38 % van de merges in oktober aan en keurt IA wijzigingen met een laag risico zelfstandig goed; Stitch Loop bewaakt een online product en opent pull requests om een meetbaar doel te bereiken. In beide gevallen houdt een persoon de controle over wat ertoe doet: de gevoelige onderdelen bij Runway, elke merge bij Stitch Loop. De tooling volgt: de Agents SDK Python maakt van Codex een modelprovider, en Cognition beoordeelt modellen op de vraag die deze processen oproepen, namelijk of de PR moet worden gemerged.
Bij open modellen draait de inspanning om wat lichtere modelgewichten kunnen opleveren. Inkling 2 Mini doorloopt zijn middelste lagen drie keer om Qwen3.8-27B op de AA Index te evenaren met 20 Go, de superadapter van Hugging Face brengt drie specialisaties samen in één LoRA, en Metric AI bouwt op basis van Qwen3.5 Armeense modellen. De cijfers blijven afkomstig van de makers, en MedChemBench herinnert aan de beperkingen van deze aanpak: OpenAI beoordeelt er alleen zijn eigen modellen en sluit niet uit dat die de bronpublicaties hebben gezien.
Bronnen
- Afronding van de beursgang (Anthropic)
- @AnthropicAI op X: de medeoprichters
- Inkling 2 Mini (Thinking Machines)
- Blogbericht van Hugging Face over Inkling 2 Mini
- Inkling-2-Mini (Hugging Face)
- Tencent Hy4 op Together AI
- Persbericht van Tencent over Hy4
- Adapters op grote schaal inzetten (Hugging Face)
- @yb2698 op X: de superadapter
- Ayb 0.5 (Metric AI)
- OhanTTS (Metric AI)
- OhanASR (Metric AI)
- @pcuenq op X: Depth Pro 2
- arXiv-artikel 2611.26603: Depth Pro 2
- DepthPro2-L (Hugging Face)
- Adversarial distillation bestrijden (OpenAI)
- @OpenAI op X: adversarial distillation
- @hardmaru op X: de Security Research Group
- Security Research Group (Sakana AI)
- Een softwarefabriek bouwen (Runway)
- Stitch Loop (Google)
- Releaseopmerkingen van ChatGPT
- @GeminiApp op X: beschikbaarheid van GIF’s
- @GeminiApp op X: GIF’s in Gemini
- @perplexity_ai op X: Computer in Chromium
- openai-agents-python v1.0.0-alpha.1
- @perplexitydevs op X: Decider in de Context API
- Pagina’s beoordelen aan de hand van criteria (documentatie van Perplexity)
- Cookbook tegen injectie (documentatie van Perplexity)
- Claude Code v2.1.329
- Codex CLI 0.171.0
- Vibe CLI v3.1.4
- Gemini 4 Neon in Devin (Cognition)
- @cognition op X: Gemini 4 Neon
- Introductie van MedChemBench (OpenAI)
- Volledig artikel over MedChemBench (PDF)
- Varianten en lokalisatie van videoadvertenties in Ads Engine (ElevenLabs)
- Copilot CLI 1.0.115-2
- Codex CLI 0.173.0-alpha.2
- Gemini CLI, PR 30389
- Changelog van Antigravity
- Qwen Code v0.28.1-preview.1
- Kimi Code 2.7.2
- CLI mistral 0.20.1
- Changelog van Replit van 20 november
- @cognition op X: Devin Bot voor Manim
- Releaseopmerkingen van de Gemini API
- Tijdsbesef en async input voor persoonlijke agents (OpenAI)
- @OpenAIDevs op X: gespreksgeschiedenis en redenering van GPT-6.2
- @AskPerplexity op X: teammates vanuit Computer
- @AskPerplexity op X: Mac-app
- @pika_labs op X: Seedance 2.5 Flash
- @HeyGen op X: blinde tests van Avatar 6
- Qwen3 TTS op Together AI
- Together Storage Accelerator (Together AI)
- @julien_c op X: het CDN van Hugging Face
- Superfluid in een vloot (basecompute)
- WavLate (Hugging Face)
- @NVIDIAAI op X: WorldTrace
- Dynamo en RL-rollouts (NVIDIA)
- Sparse attention op NVIDIA GPU’s (NVIDIA)
- GitHub Enterprise Server 3.23 release candidate (changelog van GitHub)
- De pagina Overview voor pull requests (changelog van GitHub)
- GitHub Desktop en meerdere accounts per host (changelog van GitHub)
- Favoriete repositories op het dashboard (changelog van GitHub)
- Hebbia en GPT-6 Astra (OpenAI)
- De stille consensus (OpenAI)
- Gegevensverrijking met AI (Perplexity)