ai-powered-markdown-translatorArticol tradus din fr în ro cu gpt-6.1-sol.
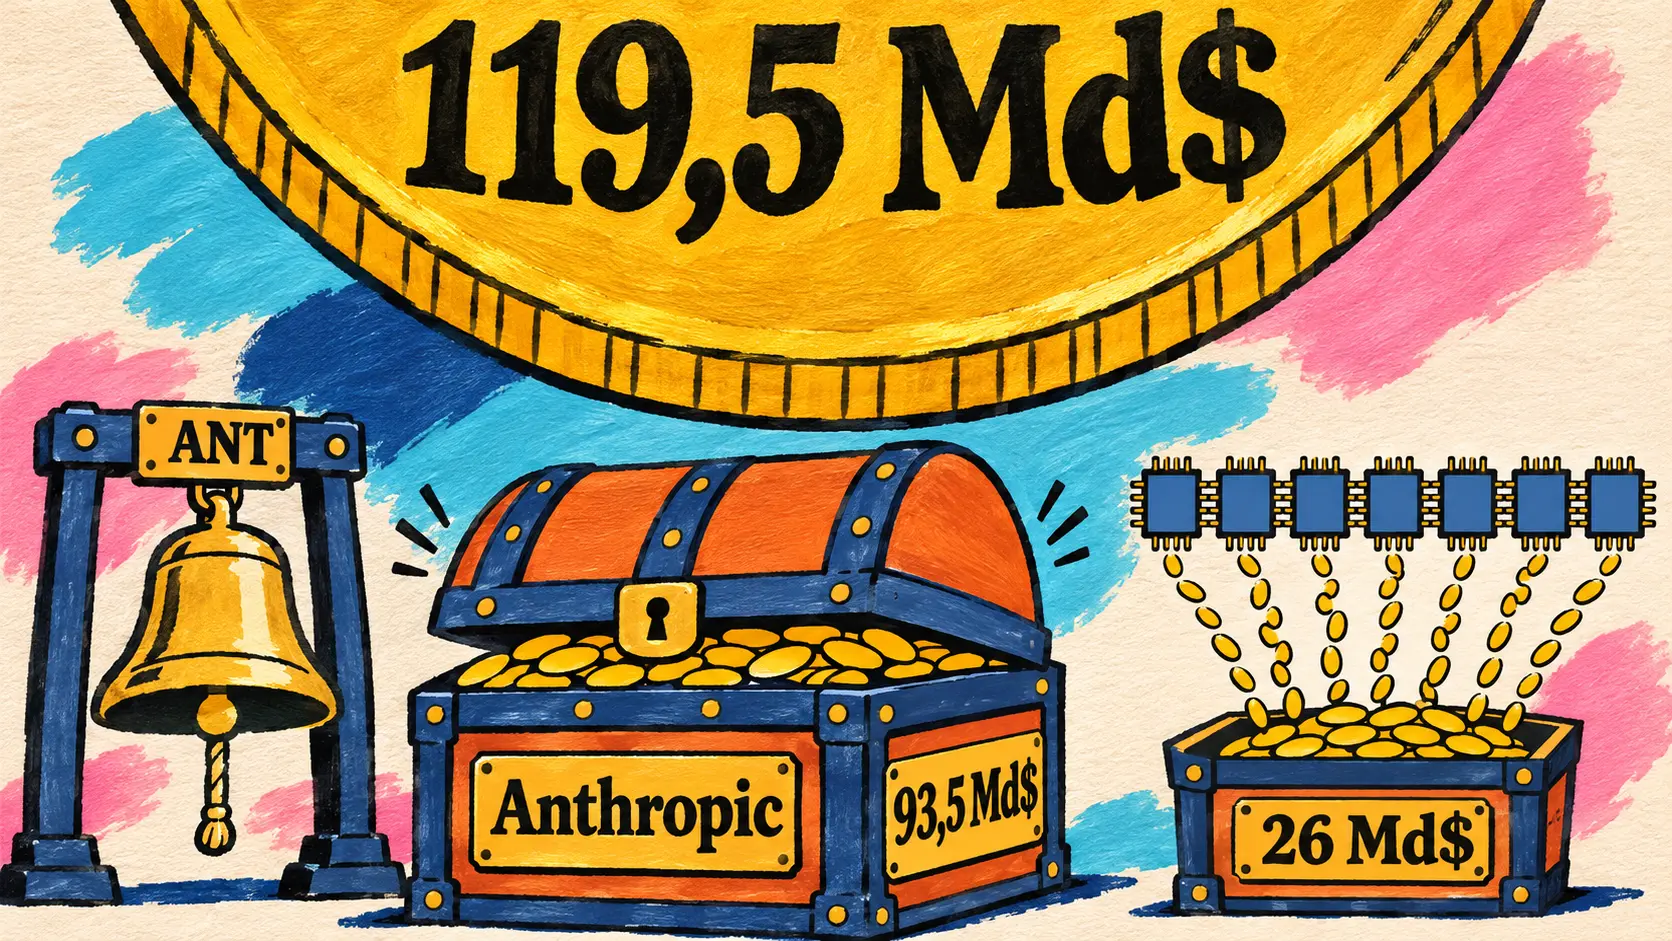
Anthropic își finalizează oferta publică inițială: aproximativ 93,5 miliarde de dolari brut din ofertă și încă 26 de miliarde investite de șapte grupuri, printre care NVIDIA, Google și Microsoft, printr-un plasament privat desfășurat în paralel. Thinking Machines publică Inkling 2 Mini, un model cu ponderi deschise și 26,4 miliarde de parametri, care încape în 20 Go, iar OpenAI reduce de la 54,0 % la 0,2 % rata de succes a atacurilor care extrag raționamentul protejat al modelelor sale. ChatGPT Space devine disponibil pentru abonații Plus, Runway încredințează agenților 38 % din integrările sale de cod, iar Claude Code, Codex CLI și Vibe CLI publică fiecare o versiune nouă.
Finanțe: Anthropic își finalizează oferta publică inițială, cu 93,5 miliarde de dolari brut și un plasament privat de 26 de miliarde
20 noiembrie — La o zi după debutul la bursă, Anthropic anunță încheierea ofertei sale publice inițiale, al cărei preț fusese stabilit pe 18 noiembrie la 83 de dolari pe acțiune. Băncile și-au exercitat integral opțiunea pentru 147 de milioane de acțiuni suplimentare: în total, au fost vândute 1 127 000 000 de acțiuni de clasă A. Încasările brute ajung la aproximativ 93,5 miliarde de dolari înainte de comisioane și cheltuieli, dintre care aproximativ 91,6 miliarde revin Anthropic, care nu încasează nimic din cele 23 648 646 de acțiuni vândute de acționarii existenți.
Articolul menționează și un plasament privat desfășurat în paralel și, de asemenea, încheiat, despre care anunțul privind prețul nu vorbise: 313 253 007 acțiuni dintr-o clasă N, vândute la același preț de 83 de dolari către șapte grupuri din domeniul semiconductorilor și al informaticii (AMD, Broadcom, Google, Micron, Microsoft, NVIDIA și TSMC Partners), pentru aproximativ 26,0 miliarde de dolari. Aceste acțiuni nu sunt înregistrate în temeiul Securities Act din 1933. Adunând oferta publică și acest plasament, suma brută se apropie de 119,5 miliarde de dolari, înainte de comisioane și cheltuieli.
| Elementul operațiunii | Valoarea anunțată de Anthropic |
|---|---|
| Acțiuni de clasă A vândute | 1 127 000 000, dintre care 147 000 000 prin opțiunea băncilor |
| dintre care vândute de Anthropic | 1 103 351 354 |
| dintre care de acționarii existenți | 23 648 646 |
| Preț pe acțiune | 83 de dolari |
| Încasări brute din ofertă | aproximativ 93,5 miliarde de dolari |
| Partea primită de Anthropic | aproximativ 91,6 miliarde de dolari |
| Plasament privat (clasa N) | 313 253 007 acțiuni, aproximativ 26,0 miliarde de dolari |
| Total brut, ofertă și plasament | aproximativ 119,5 miliarde de dolari |
| Listare | din 19 noiembrie, Nasdaq Global Select Market, simbol ANT |
Articolul confirmă listarea, fără să ofere o cotație sau o capitalizare bursieră. Goldman Sachs și Morgan Stanley au coordonat operațiunea, împreună cu un sindicat de aproximativ douăzeci de bănci, printre care J.P. Morgan, Citigroup, BNP Paribas, Crédit Agricole CIB și Société Générale. În aceeași zi, @AnthropicAI a publicat un videoclip în care cei șapte cofondatori, Dario Amodei, Daniela Amodei, Tom Brown, Jack Clark, Jared Kaplan, Sam McCandlish și Chris Olah, povestesc istoria companiei.
🔗 Încheierea ofertei publice inițiale (Anthropic) · @AnthropicAI pe X: cofondatorii
Modele deschise: Inkling 2 Mini de la Thinking Machines, Tencent Hy4, un super-adaptor pentru Qwen3.8-27B, Ayb 0.5 și Depth Pro 2
20 noiembrie — Thinking Machines Lab publică Inkling 2 Mini, fratele mai mic al Inkling 2 Small (594 de miliarde de parametri, prezentat aici pe 12 noiembrie). Acest amestec de experți (Mixture-of-Experts) cu ponderi deschise, sub licență Apache 2.0, are 26,4 miliarde de parametri, dintre care 3,4 miliarde sunt activi per token. Citește text și imagini, cu un context de un milion de tokenuri. Ponderile sale sunt distribuite la precizia folosită în antrenare, NVFP4 pentru douăzeci de straturi și MXFP8 pentru ultimele patru, adică aproximativ 20 Go fără pierderi din conversie: rulează cu Ollama pe orice Mac cu cel puțin 32 Go.
Today we are releasing Inkling 2 Mini, a fast, powerful model that’s small enough to run on your laptop.
🇷🇴 Publicăm astăzi Inkling 2 Mini, un model rapid și puternic, suficient de mic pentru a rula pe laptopul vostru. — Thinking Machines Lab, anunțul Inkling 2 Mini
Particularitatea sa ține de arhitectură: este un transformer cu buclă (looped transformer). Dintre cele 24 de straturi, cele 12 din mijloc sunt parcurse de trei ori, adică 48 de parcurgeri de strat per token pentru 24 de straturi stocate, de unde rezultă 5,4 miliarde de activări ale ponderilor per token. În timpul antrenării, laboratorul a eliminat și două treimi dintre experți (de la 384 la 128), apoi a reparat modelul cu 1 000 de miliarde de tokenuri distilate dintr-un model Inkling intern mai mare. Potrivit laboratorului, la aceeași valoare a funcției de pierdere, un model fără buclă ar necesita cu 7,5 % mai puține calcule la antrenare, dar cu 140 % mai multe calcule la inferență.
| Benchmark (tabelul Thinking Machines) | Inkling 2 Mini | Qwen3.8-27B | Nemotron 3.5 Super VL |
|---|---|---|---|
| Activări ale ponderilor per token / parametri totali | 5,4B / 26,4B | 27,0B / 27,0B | 12,0B / 124,5B |
| AA Index v5.0 | 20,1 | 20,1 | 13,6 |
| DeepSWE v1.1 | 48,2 % | 42,2 % | 24,7 % |
| SWE-bench Pro v2 Hard | 77,9 % | 73,8 % | 44,1 % |
| Terminal-Bench 2.1 (pi) | 71,6 % | 73,0 % | 60,7 % |
| BrowseComp | 79,0 % | 61,6 % | 78,9 % |
| MCP Atlas | 82,7 % | 77,3 % | 67,7 % |
Potrivit Thinking Machines, modelul conduce clasamentul modelelor deschise cu mai puțin de 100 de miliarde de parametri pe DeepSWE v1.1 și pe Vals Index v2.2 (46,5 %). Rămâne în urma Qwen3.8-27B pe Terminal-Bench 2.1, iar Thinking Machines recunoaște că nu este cel mai bun model mic pentru conversații cu mai multe schimburi de replici (50,0 % pe MultiChallenge) și nici pentru instrucțiuni cu constrângeri multiple (33,4 % pe ComplexConstraints v1.1); legenda graficului precizează că configurațiile de evaluare variază de la un model la altul. Cercetători de la Stanford, cu acces anticipat, au măsurat 0,703 unități de inteligență per joule pe DGX Spark, față de 0,430 pentru Qwen3.6-35B-A3B.
Laboratorul îl folosește și ca obiect de cercetare privind monitorizarea lanțului de gândire (chain of thought): un model cu buclă efectuează mai multe calcule fără să le scrie, ceea ce ar putea scăpa unui sistem de monitorizare. Pe o variantă cu număr variabil de parcurgeri, publicată și ea, dificultatea sarcinii rezolvate fără raționament scris crește de la echivalentul a 16 secunde de muncă umană la 37 de secunde când se trece de la una la trei parcurgeri. La cinci parcurgeri, raționamentul este de două ori mai scurt (1 661 față de 3 703 tokenuri în medie pe GPQA Diamond) și rămâne la fel de lizibil; Thinking Machines nu observă o creștere a sabotajului agentic odată cu numărul de bucle. Modelul este disponibil pe Tinker, Ollama, SGLang, vLLM, llama.cpp, MLX și Transformers, cu versiuni GGUF la Unsloth.
🔗 Inkling 2 Mini (Thinking Machines) · Articolul Hugging Face · Ponderi pe Hugging Face
Together AI oferă Tencent Hy4, un amestec de experți cu 770 de miliarde de parametri, la 0,83 dolari pentru un milion de tokenuri de intrare
19 noiembrie — Together AI adaugă Tencent Hy4 la oferta sa de inferență serverless, cu un context de un milion de tokenuri, apeluri de instrumente și ieșire JSON. Potrivit furnizorului de găzduire, modelul de vârf al Tencent este un amestec de experți cu 770 de miliarde de parametri, dintre care 49 de miliarde sunt activi per token; acesta succede Hy4 Preview, adaugă utilizarea computerului și devine primul din familia Hy care poate citi imagini.
| Tarif pentru un milion de tokenuri | Together AI | Tencent (comunicatul din 4 noiembrie) |
|---|---|---|
| Intrare | 0,83 dolari | aproximativ 0,90 dolari |
| Intrare în cache | 0,042 dolari | aproximativ 0,045 dolari |
| Ieșire | 2,50 dolari | aproximativ 2,70 dolari |
Tencent lansase Hy4 pe 4 noiembrie, prezentându-l printre cele mai bune modele open source și promițând publicarea ponderilor în câteva zile; depozitul tencent/Hy4 se află pe Hugging Face, sub o licență de tip „other”. Comunicatul său cita o evaluare financiară oarbă (213 profesioniști, 579 de sarcini), în care Hy4 obținea 3,04, înaintea DeepSeek-V4.1-Flash-1017 (2,97), și o rată internă a halucinațiilor redusă de la 12,95 % la 7,2 %.
🔗 Tencent Hy4 pe Together AI · Comunicatul Tencent din 4 noiembrie
Hugging Face publică rețeta pentru harness adapters și un super-adaptor unic pentru Qwen3.8-27B
20 noiembrie — După trei zile de publicări, inclusiv adaptorul Hermes prezentat aici ieri, Hugging Face oferă rețeta completă pentru harness adapters: adaptoare LoRA antrenate prin învățare prin întărire în interiorul unui harness pentru agenți (pi, Hermes Agent sau OpenCode), peste Qwen3.8-27B. Noutatea este un super-adaptor: cele trei adaptoare LoRA de rang 32 sunt concatenate într-un singur LoRA de rang 96, care funcționează în toate cele trei harness-uri. Actualizările lor fiind aproape ortogonale (cosinus de la 0,01 la 0,02), ansamblul le aplică exact pe toate trei.
| SWE-bench Pro (51 de sarcini dificile), cu reflecție | Model de bază | Cu super-adaptorul |
|---|---|---|
| Harness Hermes Agent | 45 % | 61 % |
| Harness OpenCode | 47 % | 67 % |
| Harness pi | 74 % | 74 % |
Cu reflecție, media celor șase perechi harness-benchmark crește de la 55,5 la 63,5 %, cu 19 până la 48 % mai puține apeluri de instrumente, potrivit firului de postări al echipei; fără reflecție, super-adaptorul câștigă între 6 și 18 puncte pe SWE-bench Pro, cu 53 până la 73 % mai puține apeluri de instrumente, potrivit articolului. Scorurile nu sunt comparabile între harness-uri, deoarece setările lor implicite diferă. Antrenarea a necesitat 598 de pași și 167 de milioane de tokenuri; mecanismul de protecție safeagents a verificat 1,3 milioane de apeluri de instrumente și a blocat 647 dintre ele. Sarcinile, adaptoarele, GGUF și traiectoriile de evaluare sunt publicate.
🔗 Harness adapters la scară largă (Hugging Face) · @yb2698 pe X
Metric AI publică Ayb 0.5, OhanTTS și OhanASR, modele deschise de text și voce pentru limba armeană
20 noiembrie — Echipa armeană Metric AI publică în aceeași zi trei familii de modele pentru limba sa. Ayb 0.5 reunește trei modele de limbaj (0,8B, 4B și 9B) construite pe Qwen3.5 și adaptate pentru armeană, de la tokenizer-ul extins până la post-antrenare; Ayb-9B gestionează dialogul cu mai multe schimburi de replici, apelurile de instrumente și imaginile. OhanTTS-v0.1 sintetizează vocea în opt limbi, inclusiv armeană și franceză, și clonează o voce pornind de la 3 până la 10 secunde de audio. OhanASR-v0.1, un model de recunoaștere vocală de 2B, este ajustat fin pe 820 de ore de armeană.
| Model Metric AI | Rezultatul publicat de autori |
|---|---|
| Ayb-9B | Locul 3 în clasamentul general ArmBench (0,6164) |
| OhanTTS-v0.1, 61 de ore de armeană | 14,70 % WER, primul sunet în 331 ms pe un GB10 |
| OhanASR-v0.1 | 16,12 % WER (locul 2) și 3,49 % CER (locul 1) pe ArmBench-ASR |
Ponderile Ayb-9B sunt sub licență necomercială (CC BY-NC 4.0) și sunt accesibile după validare manuală.
🔗 Ayb 0.5 (Metric AI) · OhanTTS · OhanASR
Apple publică Depth Pro 2, care estimează adâncimea în metri în fotografii și videoclipuri
19 noiembrie — Apple publică Depth Pro 2, o familie de modele care estimează adâncimea în metri, atât în fotografii, cât și în videoclipuri, la rezoluție nativă. Potrivit rezumatului articolului, metodele existente trebuiau să aleagă între coerența de la un cadru la altul și claritatea contururilor; Depth Pro 2 urmărește ambele obiective cu o singură rețea. Ponderile sunt pe Hugging Face în patru dimensiuni (S, B, L, H), cu o versiune Core ML și un estimator comun al distanței focale, util când distanța focală lipsește din EXIF.
| Rezoluție procesată de DepthPro2-L (334M, pe B200) | Imagini pe secundă |
|---|---|
| VGA | 150,1 |
| 720p | 33,7 |
| 1080p | 9,1 |
| 4K | 0,7 |
Ponderile sunt rezervate cercetării necomerciale (licența Apple Machine Learning Research Model), iar codul este pe GitHub. Lansarea a fost semnalată pe 20 noiembrie de Pedro Cuenca, de la Hugging Face, cu o demonstrație online.
🔗 @pcuenq pe X · Articolul arXiv 2611.26603 · DepthPro2-L (Hugging Face)
Securitatea modelelor: OpenAI combate distilarea adversarială, Sakana AI își creează Security Research Group
OpenAI detaliază lupta împotriva distilării adversariale și reduce de la 54,0 % la 0,2 % extragerea raționamentului protejat
20 noiembrie — OpenAI publică un articol despre distilarea adversarială (adversarial distillation): utilizarea neautorizată a rezultatelor unui model de vârf pentru a antrena un altul, implementat fără aceleași măsuri de protecție, de exemplu pentru atacuri pe care modelul inițial le-ar fi refuzat. Articolul vizează în primul rând raționamentul protejat, lanțul de gândire produs înaintea răspunsului: potrivit unui studiu intern, un model elev progresează în general mai mult cu traseele exacte de raționament decât cu rezumatele acestora.
| Atac măsurat (evaluare adaptivă, șase modele atacatoare) | GPT-6 Astra, măsuri de protecție inițiale | GPT-6.2 Astra, măsuri de protecție actualizate |
|---|---|---|
| Raționamentul unei cereri anterioare | 54,0 % | 0,2 % |
| Raționamentul cererii curente | 22,9 % | 0,9 % |
Apărarea combină antrenarea adversarială, clasificatoare de intrare și de ieșire (inclusiv pentru argumentele apelurilor de instrumente), controale API și investigații, cu sancțiuni săptămânale împotriva unor campanii care implică de la câteva mii la câteva zeci de mii de conturi. Cu GPT-6.2 Astra și Sol, raționamentul protejat este legat de istoricul care l-a produs: API-ul îl elimină dacă un mesaj anterior este rescris, iar familiile de modele mai vechi nu îl mai pot citi. OpenAI amintește că a semnalat Congresului, în februarie, o activitate care indica faptul că DeepSeek încerca să distileze modele americane, apoi a atribuit în septembrie o campanie unor persoane asociate cu Moonshot AI; compania afirmă că susține Chip Security Act, AI OVERWATCH Act și MATCH Act.
🔗 Combaterea distilării adversariale (OpenAI) · @OpenAI pe X
Sakana AI își înființează Security Research Group, o echipă independentă pentru apărarea cibernetică colectivă
20 noiembrie — Sakana AI lansează Security Research Group, o echipă independentă de R&D cu sediul la Tokyo, separată de activitatea sa comercială și orientată spre interesul public.
Excited to announce the Sakana AI Security Research Group, an independent, public-interest R&D team in Tokyo co-led by Akihiro Umegai and me.
🇷🇴 Mă bucur să anunț Sakana AI Security Research Group, o echipă independentă de R&D în interes public, la Tokyo, condusă împreună de Akihiro Umegai și mine. — @hardmaru pe X
David Ha este cofondator și director general al Sakana AI. Echipa va lucra pe trei direcții: prevenirea încă din faza de proiectare, apărarea colectivă prin agenți distribuiți între organizații și securizarea agenților de apărare înșiși, a căror autoritate va fi limitată la sarcina lor și ale căror acțiuni vor fi înregistrate. Punctul de plecare îl constituie proiecte proprii precum Digital Red Queen, ShinkaEvolve și Fugu-Cyber, pentru care Sakana AI anunță 86,9 % pe CyberGym și 72,1 % pe CTI-REALM; o notă din articol precizează că pagina Fugu-Cyber nu oferă nici scoruri de referință, nici un protocol de evaluare. Echipa va publica cărți albe, suite de testare și ghiduri de apărare, dar nu materiale de exploatare, iar vulnerabilitățile descoperite vor face obiectul divulgării coordonate. Sakana AI amintește că solicitările de CVE au crescut cu 263 % între 2020 și 2025, potrivit NIST.
🔗 Security Research Group (Sakana AI)
Agenți conectați la livrarea software: fabrica Runway, Stitch Loop de la Google Labs
Runway își încredințează fluxul de livrare software agenților, care au coordonat 38 % dintre merge-urile sale din octombrie
20 noiembrie — Runway publică pe blogul său de inginerie bilanțul în cifre al „fabricii software” (software factory): șapte etape, de la scrierea codului la coordonarea merge-urilor, încredințate pe rând agenților. Agenții cloud au coordonat 38 % dintre pull requests integrate în octombrie, iar din 100 de astfel de PR-uri integrate în prima jumătate a lunii noiembrie, 78 nu conțineau niciun commit uman.
| Indicator al fabricii software | Punct de plecare | Cea mai recentă măsurătoare |
|---|---|---|
| Merge-uri coordonate de agenți cloud | 0,1 % (iunie) | 38 % (octombrie) |
| Timp median de așteptare pentru prima aprobare | 2,3 h (septembrie) | aproximativ 5 min (mijlocul lui noiembrie) |
| Număr mediu de merge-uri săptămânale | 929 (septembrie) | 2 235 (de la mijlocul lui octombrie) |
De la mijlocul lui octombrie, IA aprobă singură PR-urile clasificate cu risc scăzut și pe cele cu risc mediu dacă depozitul permite acest lucru; cele cu risc ridicat revin unei persoane, iar responsabilii codului aprobă întotdeauna migrările, configurația CI și de implementare, secretele și autentificarea. În septembrie și octombrie, o persoană a contestat 15 dintre cele 977 de PR-uri aprobate de IA, iar merge-urile aprobate exclusiv de IA au o rată de revenire la versiunea anterioară de 0,10 %, față de aproximativ 1 din 200 pentru aprobările umane. Agenții testează și App Studio asemenea unui utilizator (86 de buguri confirmate în patru zile), iar un coordonator a distribuit peste 14 000 de sarcini în două săptămâni. Sunt instrumente interne, fără un produs sau un tarif.
🔗 Construirea unei fabrici software (Runway)
Google Labs lansează Stitch Loop, un agent de produs care îmbunătățește continuu o aplicație online
18 noiembrie — Google Labs prezintă Stitch Loop, un agent de produs cu funcționare de lungă durată care continuă de unde se oprește un agent de programare: după lansarea în producție. Se conectează la depozitul GitHub și la datele produsului online (jurnale, comportamentul utilizatorilor, feedback) prin peste 180 de integrări, servere MCP personalizate sau trimiteri dintr-o CLI locală și lucrează continuu pentru atingerea unor obiective măsurabile.
Fiecare ciclu propune direcții susținute de date, detaliază soluțiile și compromisurile lor, scrie codul într-un sandbox cloud izolat și deschide un pull request pentru aprobare, apoi urmărește indicatorii în timp real. Trei cicluri sunt incluse implicit (securitate cibernetică, latență, accesibilitate); cel de securitate combină Gemini 4 Carbon cu CodeMender, agentul de securitate a codului de la Google DeepMind. Niciun merge nu are loc fără revizuirea echipei. Stitch Loop servește și drept sursă de context despre produs pentru agenți de programare precum Google Antigravity, prin CLI-ul Stitch și MCP, și poate fi utilizat în Slack. Este deschisă doar o listă de așteptare, la nivel mondial, cu acces prioritar pentru abonații Google AI Ultra eligibili.
Asistenți pentru publicul larg: ChatGPT Space pentru abonații Plus, GIF-uri în aplicația Gemini, Perplexity Computer în browserele Chromium
ChatGPT Space devine disponibil pentru abonații Plus din întreaga lume
20 noiembrie — ChatGPT Space, prezentat la DevDay pe 29 septembrie și rezervat până acum planurilor Pro, Business și Enterprise, devine disponibil la nivel mondial pentru abonații Plus cu vârsta de cel puțin 18 ani. Space înlocuiește Biblioteca în bara laterală (pagini, diapozitive, imagini, fișiere încărcate), pe web, în aplicația desktop, pe iOS și Android.
Aici se creează cu ChatGPT pagini interactive și prezentări, pe care alte persoane cu acces la Space le pot îmbogăți. Paginile și diapozitivele se pot actualiza singure din aplicațiile conectate: OpenAI dă ca exemple o listă de sarcini care se actualizează singură sau un plan de proiect care urmărește deciziile luate în Slack. O menționare a ChatGPT într-un comentariu este suficientă pentru a solicita o modificare, iar un dot poate fi invitat să colaboreze. Partajarea rămâne restricționată: sunt necesare permisiunea de citire și un cont Plus, Pro, Business sau Enterprise cu acces la Space; conturile Free nu pot deschide conținutul partajat și nu există un link public.
Aplicația Gemini creează GIF-uri animate cu Gemini Omni 1.2 Flash, gratuit în Franța
20 noiembrie — Aplicația Gemini creează acum GIF-uri animate (efecte foto în buclă, meme) cu Gemini Omni 1.2 Flash, modelul video lansat de Google pe 5 noiembrie, pentru mișcare fluidă și calitate constantă de la un cadru la altul, potrivit Google. Utilizatorul își scrie cererea în chatul principal sau deschide instrumentul pentru imagini ori video, apoi alege formatul GIF în selectorul de format.
GIFs are now available to all Google AI subscribers and free of charge in the U.S., Japan, Korea, Australia, Canada, U.K., Germany, and France.
🇷🇴 GIF-urile sunt acum disponibile pentru toți abonații Google AI și gratuit în Statele Unite, Japonia, Coreea, Australia, Canada, Regatul Unit, Germania și Franța. — @GeminiApp pe X
Prin urmare, utilizatorii din Franța fără abonament au acces la această funcție. Google urmează OpenAI, ale cărui GIF-uri animate în ChatGPT cu Images 2.6 au fost prezentate aici pe 5 noiembrie.
🔗 @GeminiApp pe X: GIF-urile în Gemini
Perplexity Computer funcționează direct în browserele Chromium prin extensia Perplexity
20 noiembrie — Perplexity Computer funcționează acum direct în browserele bazate pe Chromium, prin extensia Perplexity. Utilizatorul atribuie o sarcină din panoul lateral al extensiei, apoi urmărește Computer în timp ce acesta lucrează în filele și instrumentele sale. Tweetul de anunț nu precizează nici planurile vizate, nici lista browserelor acceptate.
Există două precedente: pe 5 octombrie, aplicația Mac 26.38.0 îi permitea lui Computer să utilizeze Chrome, Edge sau Brave printr-o extensie, iar pe 30 octombrie, o extensie Chrome conecta aplicațiile Mac și Windows ale Computer la browserul utilizatorului. De această dată, sarcina este atribuită din panoul lateral al extensiei, în browser.
API și SDK pentru dezvoltatori: Codex în Agents SDK Python, Decider în Context API de la Perplexity
Agents SDK Python de la OpenAI lansează o versiune preliminară 1.0 care transformă Codex într-un furnizor de modele
20 noiembrie — Agents SDK Python de la OpenAI își deschide seria 1.0 cu o versiune preliminară care schimbă abordarea: în locul unui motor nativ separat, ca în versiunea preliminară 0.24 prezentată aici pe 16 noiembrie, Codex devine un furnizor de modele ales la fiecare execuție. Se creează un CodexProvider și se transmite către Runner prin RunConfig(model_provider=provider); agentul rulează apoi cu conexiunea Codex salvată sau cu o cheie API.
Pachetul wheel Python include Codex Core (rust-v0.166.0, nemodificat) prin PyO3: SDK-ul apelează direct nucleul Codex, fără a lansa codex app-server și fără a trece prin JSON-RPC. Instrumentele Python, transferurile către un agent specialist (handoffs), aprobarea înaintea utilizării unui instrument și ieșirea tipizată rămân disponibile, iar comenzile native respectă mediul sandbox și regulile de aprobare ale Codex. Pachetele wheel 1.0.0a1 sunt distribuite exclusiv prin GitHub Releases (Linux x86-64 și ARM64, macOS 11 și versiunile ulterioare pe Apple silicon, Windows x64, CPython 3.10 până la 3.14). Salvările din versiunea preliminară 0.24.0-alpha.8 nu sunt compatibile cu Runner, iar versiunea stabilă rămâne 0.25.0 din 18 noiembrie.
🔗 openai-agents-python v1.0.0-alpha.1
Perplexity adaugă Decider în Context API pentru a evalua paginile, inclusiv injectările de prompt
19 noiembrie — Perplexity adaugă Decider, modelul său de decizie, în Context API, lansată cu două zile înainte (1 dolar pentru 1 000 URL). Se pot pune până la cinci întrebări închise (da sau nu) despre fiecare pagină preluată, iar Decider atribuie fiecărui răspuns un scor de la 0 la 1. Utilizarea evidențiată ține de securitate: detectarea unei injectări de prompt (prompt injection) într-o pagină înainte ca un agent să o citească. Perplexity menționează și calificarea potențialilor clienți, moderarea și detectarea afirmațiilor despre sănătate fără sursă.
API-ul nu filtrează nimic singur: returnează toate paginile cu scorurile lor, iar codul aplicației aplică un prag. Evaluarea este facturată în tokenuri de intrare ale Decisions API, în plus față de prețul per URL, și poate prelungi cererea cu cel mult 15 secunde. Cookbook-ul din documentație prezintă o verificare executată pe 18 noiembrie cu un prag de 0,7:
| Pagină testată (cookbook-ul din 18 noiembrie) | Scor de injectare | Decizia verificării |
|---|---|---|
| Demonstrație de injectare (Greshake et al., 2023) | 0,97 | plasată în carantină |
| OWASP, pagina despre injectarea de prompt | 0,0018 | transmisă |
| RFC 9111 | 0,0007 | transmisă |
Cookbook-ul avertizează că un scor scăzut nu face o pagină sigură: potrivit cercetării BrowseSafe++ de la Perplexity, fiecare model testat urma în continuare anumite injectări pe care le semnalase el însuși.
🔗 Firul de postări al @perplexitydevs · Documentație · Cookbook
Agenți de programare: Claude Code 2.1.329, Codex CLI 0.171.0, Vibe CLI 3.1.4 și Gemini 4 Neon în Devin
Claude Code 2.1.329 indică originea hook-urilor la deschiderea unui dosar și grupează sarcinile programate în /tasks
19 noiembrie — Claude Code 2.1.329 cuprinde 130 de intrări, dintre care 91 de remedieri, 20 de modificări și 7 adăugări. În privința securității, caseta de dialog care întreabă dacă utilizatorul are încredere într-un dosar indică acum unde sunt declarate hook-urile acestuia, iar Claude Desktop, la fel ca celelalte gazde neinteractive, avertizează când hook-urile impuse de setările gestionate (managed settings) nu se încarcă. /tasks listează și sarcinile programate ale sesiunii, reactivările /loop, obiectivul curent și fork-urile conversației; majoritatea sarcinilor programate înregistrate de versiunile anterioare vor trebui reprogramate.
/code-review fără o țintă revizuiește acum, pe majoritatea modelelor, întreaga ramură în raport cu ramura implicită, iar cu un număr de PR revizuiește PR-ul propriu-zis prin gh pr diff. Pe macOS, computer use trece la reguli de securitate mai recente, care refuză anumite acțiuni. Reîncercarea automată adăugată în 2.1.326 după o eroare max_tokens dispare: în spatele unui gateway trebuie configurat CLAUDE_CODE_MAX_OUTPUT_TOKENS. Code Mode primește 17 intrări, inclusiv compatibilitatea cu evenimentele și indicatorii OpenTelemetry. Versiunea 2.1.330 este publicată pe npm din 20 noiembrie.
Codex CLI 0.171.0 setează GPT-6.2 Sol ca model implicit și activează spațiul de lucru al terminalului
20 noiembrie — Codex CLI 0.171.0 este prima versiune stabilă de la 0.170.0 din 18 noiembrie și reunește 339 de pull requests. GPT-6.2 Sol și GPT-6.2 Astra intră în cataloagele de modele, Sol fiind selectat implicit, iar comenzile /rc și /remote gestionează din terminal controlul local de la distanță și afișează codurile de asociere a dispozitivelor.
Mai multe noutăți din versiunile preliminare din 14–17 noiembrie ajung în versiunea stabilă: spațiul de lucru din TUI, activat implicit, afișează previzualizări de documente și imagini și transcrieri ale subagenților lângă conversație; codex exec --remote lansează sau reia o sesiune neinteractivă pe un server de aplicații existent; editorul de mesaje primește funcțiile de anulare și refacere; /statusline selectează linii de stare furnizate de un server MCP, prin activarea unei opțiuni. Printre remedieri, ciornele și relansările din coadă rămân asociate conversației lor, iar conexiunea MCP pentru companii funcționează cu furnizorii de identitate care nu emit un token de reîmprospătare.
Vibe CLI 3.1.4 separă agentul de politica de aprobare și le retrage agenților dreptul de a dezactiva confirmările
20 noiembrie — Mistral lansează Vibe CLI 3.1.4, la două zile după 3.1.3, care făcea din Mistral Large 4 modelul implicit. Cele 79 de intrări ale sale (18 adăugări, 41 de modificări, 18 corecții, 2 eliminări) vizează în primul rând permisiunile: fiecare sesiune combină acum două setări independente, un agent (default, lean sau personalizat) și o politică de aprobare (ask, accept-edits, smart-approve sau auto-approve), aleasă prin --approval-policy sau default_approval_policy.
Un agent nu mai decide singur ce se execută fără a cere aprobare: setările sale safety, bypass_tool_permissions și permission = "always" sunt ignorate. Un proiect nu mai poate redefini o politică de aprobare în folderul său .vibe/agents/, iar fork-urile și sesiunile fiice moștenesc politica inițială. Interfața primește o « bară » de etichete deasupra câmpului de introducere (subagenți, sarcini în fundal, pull requests, obiectiv, sarcini), o setare keep_awake împiedică intrarea în repaus în timpul unei runde, iar Vibe acceptă certificatele sistemului, ceea ce îl ajută să funcționeze în spatele unui proxy de companie. Doar cele mai recente 8 imagini sunt acum trimise modelelor Mistral, iar prompturile personalizate de compactare sunt eliminate.
Devin oferă acces la Gemini 4 Neon, cu 46,2 % pe FrontierCode 2.0 la 4,38 dolari pe sarcină
19 noiembrie (articol datat pe 18) — După Cursor și GitHub Copilot, prezentate aici ieri, Cognition oferă acces la Gemini 4 Neon în Devin Desktop și Devin CLI. Pe FrontierCode 2.0, benchmarkul său care evaluează dacă un pull request merită integrat, Neon obține 46,2 %, cel mai bun rezultat al unui model Google potrivit Cognition. Se situează la aproximativ un punct de Claude Opus 5.5 (47,3 %), la circa o treime din cost: 4,38 dolari pe sarcină față de 12,82 dolari.
| Model evaluat pe FrontierCode 2.0 | Scor publicat de Cognition |
|---|---|
| Claude Fable 5.2 | 50,2 % |
| Claude Opus 5.5 | 47,3 % |
| Gemini 4 Neon | 46,2 % |
| GPT-6.2 Astra | 44,2 % |
| GPT-6.2 Sol | 43,8 % |
| Gemini 4 Carbon | 42,6 % |
Costul corespunde cheltuielii medii pe execuție la prețul de listă al API, cu reducerile publice incluse, iar o soluție care nu îndeplinește un criteriu eliminatoriu primește scorul zero. Mai multe scoruri din acest grafic diferă de valorile publicate în săptămânile precedente, fără explicații în articol.
🔗 Gemini 4 Neon în Devin (Cognition) · @cognition pe X
Știință: OpenAI publică MedChemBench, un benchmark de chimie medicinală în care GPT-6.2 Astra obține 84,5 %
20 noiembrie — OpenAI prezintă MedChemBench, un benchmark care măsoară capacitatea modelelor de a raționa ca un chimist specializat în chimie medicinală: să coreleze structura unei molecule cu rezultatele experimentale, să compare compuși, să le prezică proprietățile. Acesta reunește 99 de probleme extrase din 117 articole și brevete, cu 761 de structuri moleculare distincte, și evaluează patru componente: structuri, raționament științific, selecția compușilor și predicția proprietăților.
| Model evaluat (nivel de raționament xhigh) | Punctaj obținut |
|---|---|
| GPT-6.2 Astra | 84,5 % |
| GPT-6 Astra | 83,3 % |
| GPT-6.1 Sol | 82,0 % |
| GPT-6.1 Terra | 75,1 % |
| GPT-5.6 Sol | 58,2 % |
Profilul rezultatelor este inegal: GPT-6 Astra obține 95,4 % din punctaj la structuri, dar aproximativ jumătate la selecția compușilor și predicția valorilor numerice. OpenAI rămâne prudentă: benchmarkul se bazează pe date istorice și nu demonstrează că modelele pot descoperi medicamente noi, nu poate fi exclusă o expunere anterioară la publicațiile-sursă și au fost evaluate doar modele GPT. Acesta urmează după BioBasicsBench, prezentat aici pe 6 noiembrie.
🔗 Prezentarea MedChemBench (OpenAI) · Articol complet (PDF)
Video și audio generative: ElevenLabs adaugă în Ads Engine variante de reclame fără o nouă filmare
20 noiembrie — ElevenLabs îmbunătățește Ads Engine, instrumentul său de creare a reclamelor integrat în ElevenCreative și lansat în iunie. Conectat la conturile de publicitate Google, Meta, LinkedIn și acum TikTok, acesta pornește de la reclamele existente și rezultatele lor pentru a produce variante fără o nouă filmare. Identifică mesajul de captare a atenției de la început (hook) și scrie altele noi pe baza reclamelor care au funcționat; acestea sunt rostite de o replică digitală a vocii vorbitorului inițial, cu sincronizare labială și subtitrări actualizate. Noile coloane sonore, compuse de API ElevenLabs Music pe baza tonului și ritmului imaginilor, pot fi utilizate comercial.
Pentru localizare, asigurată deja de Dubbing v2, Ads Engine sincronizează acum buzele vorbitorului cu limba țintă și înlocuiește subtitrările încorporate cu o versiune tradusă, respectând temporizarea și fonturile mărcii. O verificare umană rămâne posibilă înainte de difuzare, inclusiv de către un profesionist în localizare, vorbitor nativ, iar instrumentul poate publica direct pe platforme. Accesul se obține prin echipa comercială, fără un tarif publicat.
🔗 Variante și localizarea reclamelor video în Ads Engine (ElevenLabs)
Pe scurt
Agenți de programare
- Copilot CLI 1.0.115-2 — În această versiune preliminară cu 351 de intrări, dintre care 335 de corecții, Gemini 4 Hydrogen apare în selector cu nivelul de efort Extra High atunci când contul are acces, GPT-6.2 Astra beneficiază de suport, iar
/modelgestionează și modelele furnizorilor personalizați; versiunea stabilă rămâne 1.0.114. 🔗 sursă - Codex CLI 0.173.0-alpha.1 și alpha.2 — Notele acestor versiuni preliminare sunt goale; potrivit titlurilor celor 71 de commituri, partajarea conexiunilor MCP și descoperirea OAuth a serverelor configurate sunt activate implicit, iar administratorii vor putea dezactiva actualizările daemonului Codex. Conținutul se poate schimba înainte de versiunea stabilă. 🔗 sursă
- Gemini CLI — Prima versiune nightly din 4 noiembrie încoace (v0.71.0-nightly.20261120); pe branchul principal,
gemini --resumeredeschide sesiunea utilizată cel mai recent, nu ultima pornită, iar căile care încep cu~\sunt în sfârșit expandate pe Windows. 🔗 sursă - Antigravity IDE 2.8.0 — Editorul Google își pornește backendul instantaneu și verifică actualizările în fundal, redirecționează automat porturile pentru conectarea la distanță, permite căutarea într-o conversație de la tastatură și acceptă certificate personalizate și proxy la conectare. 🔗 sursă
- Qwen Code 0.28.1-preview.1 — Această versiune preliminară cu 179 de intrări face din GitHub al treilea adaptor de canal acceptat, adaugă WeCom, Microsoft Teams și webhookuri de ieșire generice configurabile din interfața web și aduce în CLI o prezentare pentru cititoarele de ecran; versiunea stabilă rămâne v0.28.0. 🔗 sursă
- Kimi Code 2.7.1 și 2.7.2, Kimi Code Desktop 1.4.1 și 1.4.2 — Patru versiuni de corecție, la o zi după 2.7.0: efortul de raționament ales într-o ciornă nu mai revine la valoarea implicită după trimitere, iar fork-urile nu mai eșuează după restaurarea unei sesiuni reorientate în timpul unei runde. 🔗 sursă
- CLI mistral 0.20.1 —
mistral evals execse încheie acum cu eșec (cod 1) când toate apelurile dintr-o execuție au eșuat, de exemplu din cauza unei erori 401, în loc să declare execuția reușită; o întrerupere prin Ctrl-C este semnalată ca atare. 🔗 sursă - Replit — Spațiile de lucru (Workspaces) pot fi acum căutate și fixate, o opțiune care apare doar de la cinci spații în sus. 🔗 sursă
- Devin Bot pentru Manim — Cognition prezintă Devin Bot pe care Grant Sanderson l-a configurat pentru a-l ajuta cu Manim, sistemul de animație open source al videoclipurilor 3Blue1Brown (96,6 k stele, 250 000 de descărcări pe lună); tweetul nu precizează nici sarcinile încredințate botului, nici rezultatele sale. 🔗 sursă
API și platforme
- API Gemini — Începând cu 17 noiembrie, Gemini 3.5 Transcribe, atât în versiunea clasică, cât și în cea live, modifică, rescrie și formatează prin comenzi vocale un text dictat sau existent (parametrul
source_text), iar Google menționează și traducerea. Începând cu 18, API permite prelucrarea și plata doar a părții utile din fișierele trimise: intervale de pagini, foi, celule, intervale de timp sau straturi de conținut. 🔗 sursă - Percepția timpului în API Agents — O opțiune experimentală (
experimental={"time_awareness": True}) îi reamintește periodic modelului ora, pentru a-și adapta activitatea la un termen-limită; combinată cu instrumentele asincrone, îi permite unui agent să pună o întrebare și să continue căutarea în așteptarea răspunsului, așa cum arată un articol de pe blogul pentru dezvoltatori al OpenAI. 🔗 sursă - Istoricul conversațiilor cu GPT-6.2 — @OpenAIDevs cere să nu mai fie modificate mesajele anterioare în Responses API, deoarece API elimină raționamentul care urmează modificării. O nouă secțiune Eliminări ale raționamentului din tabloul de bord Utilizare ajută la identificarea acestui fenomen, iar ghidul asociat propune adăugarea în schimb a unui element
configuration_updatesauadditional_toolspentru a modifica efortul sau instrumentele. 🔗 sursă
Asistenți pentru publicul larg
- ChatGPT lansează o nouă aplicație mobilă cu o filă pentru dot și favorite fixate — Codex, Projects sau Images pot fi fixate în bara de file; lansarea începe cu utilizatorii Pro de cel puțin 18 ani din regiunile unde există dots, cu excepția Spațiului Economic European (inclusiv UE), a Regatului Unit, a Elveției și a Coreei, și cu un grup mic de utilizatori Plus (notele de versiune din 19 noiembrie, în linkul de mai sus).
- Teammates de la Perplexity — Abonații Max pot acum crea un teammate din orice sarcină Computer pe web, apoi îi pot schimba numele, rolul sau avatarul în aceeași conversație. 🔗 sursă
- Aplicația Mac de la Perplexity — Mai rapidă, adaugă « Trimite acum » pentru a reorienta o sarcină în curs, ⌘F pentru căutarea în tabele, Markdown și previzualizări, iar ⌘⇧T pentru redeschiderea unei file închise. 🔗 sursă
Video și audio generative
- Seedance 2.5 Flash pe Pika — După Runway și HeyGen, Pika adaugă varianta rapidă a modelului video de la ByteDance pentru proiectele cu multe duble: videoclipuri de până la 30 de secunde în 480p sau 720p, până la 10 imagini, 5 videoclipuri și 5 clipuri audio ca referință; tweetul nu indică un tarif. 🔗 sursă
- Avatar 6 de la HeyGen — Noi teste în orb din raportul tehnic: când persoanele filmate, angajați ai HeyGen, aleg videoclipul care le seamănă cel mai mult, Avatar 6 câștigă în proporție de 86,5 % în fața Seedance 2.5 și de 87,9 % în fața Wan 3.0; aceste evaluări sunt realizate de HeyGen. 🔗 sursă
- Qwen3 TTS la Together AI — Modelul deschis de sinteză vocală Qwen3-TTS-12Hz-1.7B (Apache 2.0) este oferit la 20 de dolari pentru un milion de caractere, cu nouă voci reglabile printr-o instrucțiune în limbaj obișnuit, zece limbi, inclusiv franceza, și primul sunet în cel mai bun caz în 97 ms. 🔗 sursă
Infrastructură și cercetare
- Together Storage Accelerator — Together AI oferă cu fiecare cluster GPU un cache NVMe pentru stocarea S3 și Hub Hugging Face, fără modificări de cod; conform măsurătorilor sale, timpul de citire a unui fișier de 2 Gio din Cloudflare R2 scade de la 12,7–15,0 s la 0,64–0,72 s, iar un cluster de 200 de noduri descarcă o singură dată de la sursa de origine. 🔗 sursă
- CDN de la Hugging Face — Hugging Face livrează lunar aproape un exaoctet de modele și seturi de date deschise, potrivit cofondatorului său Julien Chaumond, și și-a construit propria rețea de distribuție (CDN) pentru descărcările de IA. 🔗 sursă
- Superfluid de la basecompute — Serverul local distribuie acum inferența între sisteme Apple, AMD și NVIDIA: șase sisteme cresc debitul de la 112 la 534 de tokens de ieșire pe secundă pentru 64 de utilizatori simulați, iar oprirea unui nod nu duce la pierderea niciunei cereri, potrivit furnizorului. 🔗 sursă
- WavLate — Acest model deschis de interacțiune târzie caută sunete pe baza textului și text pe baza sunetului, cu un vector la fiecare 0,31 secunde de sunet și unul pentru fiecare cuvânt; autorul său anunță un Recall@1 mediu de 37,9 pe AudioCaps și Clotho, cel mai bun dintre cele nouă modele deschise comparate, și publică ponderile și datele. 🔗 sursă
- WorldTrace — NVIDIA Research prezintă o memorie pentru modelele de lume video interactive, fără reantrenare (articol acceptat la NeurIPS 2026): pe LoopBench, reamintirea scenelor revizitate se îmbunătățește cu 32,6 % față de fereastra glisantă, cu un consum de 3,1 Go de memorie GPU și un timp de execuție cu 27 % mai mare. 🔗 sursă
- Dynamo pentru învățarea prin întărire — NVIDIA detaliază modul în care Dynamo deservește rollout-urile din post-antrenare: rutare în funcție de cache-ul KV, transfer diferențial al ponderilor cu ModelExpress, repornirea proceselor de lucru care au eșuat. Microsoft AI, Cognition (pentru SWE-1.7), Prime Intellect și H Company îl folosesc; H Company economisește până la 20 % din timpul fiecărei etape de antrenare. 🔗 sursă
- Atenție rară — Într-un ghid din 17 noiembrie, NVIDIA prezintă opt reguli de proiectare pentru atenția rară antrenată pe GPU-urile sale; indexorul care selectează tokens și Top-k reprezintă 47 % dintr-un strat de prefill al DeepSeek V3.2 la 128K tokens. 🔗 sursă
GitHub
- GitHub Enterprise Server 3.23 în release candidate — Detectarea secretelor prin IA, în versiune preliminară publică, rulează pe procesorul appliance-ului, fără GPU, fără LLM găzduit și fără conexiune de ieșire, inclusiv într-un mediu izolat (air-gapped); versiunea extinde și detectarea pachetelor malițioase cunoscute la alte șapte ecosisteme, pe lângă npm. 🔗 sursă
- Dincolo de IA — GitHub clarifică starea integrării în noua pagină Prezentare generală a pull request-urilor, GitHub Desktop 3.7.0 acceptă mai multe conturi pe aceeași gazdă, iar tabloul de bord afișează până la 25 de depozite favorite. 🔗 Prezentare generală · 🔗 Desktop · 🔗 favorite
Companii și eseuri
- Hebbia — În testele sale de cercetare financiară din august și septembrie, o versiune preliminară de GPT-6 Astra citează fragmente relevante în proporție de 99,5 % și respectă 97,9 % dintre cerințele de prezentare, cu 14,4 puncte peste cea mai bună alternativă testată, pe care studiul de caz publicat de OpenAI nu o numește. 🔗 sursă
- Consensul tacit — OpenAI publică în rubrica sa Era inteligenței (Intelligence Age) un eseu de Dean Ball, adaptat după o prelegere la Harvard și prezentat ca reflectând opiniile autorului, împotriva ideii că renunțarea la primatul uman ar fi inevitabilă; acesta pledează pentru agenți asociați unor persoane, cu permisiuni limitate și revocabile. 🔗 sursă
- Îmbogățirea datelor — Un ghid Perplexity descrie cum pot fi completate și verificate fișele CRM cu un model conectat la web, în șase etape; Apollo procesează astfel 5,6 milioane de îmbogățiri pe lună prin API de la Perplexity. 🔗 sursă
Ce înseamnă acest lucru
Listarea la bursă a Anthropic reunește, în aceeași postare, banii piețelor și pe cei ai industriei. Oferta publică aduce companiei aproximativ 91,6 miliarde de dolari brut, iar plasamentul privat încă 26 de miliarde, subscrise la același preț de 83 de dolari de șapte grupuri din industria semiconductorilor și a informaticii: AMD, Broadcom, Google, Micron, Microsoft, NVIDIA și TSMC Partners. În total, operațiunea se apropie de 119,5 miliarde de dolari brut: alături de investitorii din ofertă, șapte grupuri industriale cumpără acțiuni ale unui laborator de IA cotat acum la Nasdaq.
Securitatea este integrată tot mai mult în mecanismele instrumentelor. OpenAI leagă raționamentul GPT-6.2 de istoricul care l-a produs, ceea ce reduce rata de extragere măsurată de la 54,0 % la 0,2 %, dar le impune dezvoltatorilor să nu-și mai rescrie conversațiile. Vibe CLI elimină dreptul agenților de a dezactiva singuri confirmările, Claude Code arată de unde provin hook-urile unui dosar înainte de a i se acorda încredere, iar Decider evaluează paginile înainte ca un agent să le citească. Sakana AI creează, la rândul său, o echipă dedicată apărării colective, promițând să nu publice materiale de exploatare a vulnerabilităților.
Agenții trec de la scrierea codului la lanțul de livrare. La Runway, aceștia coordonează 38 % dintre operațiunile de merge din octombrie, iar IA aprobă singură modificările cu risc scăzut; Stitch Loop monitorizează un produs online și deschide pull requests pentru a atinge un obiectiv cuantificat. În ambele cazuri, o persoană păstrează controlul asupra aspectelor esențiale: zonele sensibile la Runway, fiecare operațiune de merge la Stitch Loop. Instrumentele țin pasul: Agents SDK Python face din Codex un furnizor de modele, iar Cognition evaluează modelele în raport cu întrebarea pe care o ridică aceste lanțuri, și anume dacă trebuie făcut merge la PR.
În privința modelelor deschise, efortul se concentrează pe ceea ce se poate obține din ponderi mai ușoare. Inkling 2 Mini își parcurge de trei ori straturile intermediare pentru a egala Qwen3.8-27B la AA Index în 20 Go, super-adaptorul Hugging Face reunește trei specializări într-un singur LoRA, iar Metric AI pornește de la Qwen3.5 pentru a construi modele armenești. Cifrele rămân cele comunicate de producători, iar MedChemBench amintește limitele acestui exercițiu: OpenAI își evaluează acolo doar propriile modele și nu exclude posibilitatea ca acestea să fi văzut publicațiile-sursă.
Surse
- Încheierea listării la bursă (Anthropic)
- @AnthropicAI pe X: cofondatorii
- Inkling 2 Mini (Thinking Machines)
- Postarea Hugging Face despre Inkling 2 Mini
- Inkling-2-Mini (Hugging Face)
- Tencent Hy4 pe Together AI
- Comunicatul Tencent despre Hy4
- Utilizarea adaptoarelor la scară largă (Hugging Face)
- @yb2698 pe X: super-adaptorul
- Ayb 0.5 (Metric AI)
- OhanTTS (Metric AI)
- OhanASR (Metric AI)
- @pcuenq pe X: Depth Pro 2
- Articolul arXiv 2611.26603: Depth Pro 2
- DepthPro2-L (Hugging Face)
- Combaterea distilării adversariale (OpenAI)
- @OpenAI pe X: distilarea adversarială
- @hardmaru pe X: Security Research Group
- Security Research Group (Sakana AI)
- Construirea unei fabrici de software (Runway)
- Stitch Loop (Google)
- Notele de versiune ChatGPT
- @GeminiApp pe X: disponibilitatea GIF-urilor
- @GeminiApp pe X: GIF-urile în Gemini
- @perplexity_ai pe X: Computer în Chromium
- openai-agents-python v1.0.0-alpha.1
- @perplexitydevs pe X: Decider în Context API
- Evaluarea paginilor pe baza criteriilor (documentația Perplexity)
- Cookbook împotriva injecțiilor (documentația Perplexity)
- Claude Code v2.1.329
- Codex CLI 0.171.0
- Vibe CLI v3.1.4
- Gemini 4 Neon în Devin (Cognition)
- @cognition pe X: Gemini 4 Neon
- Prezentarea MedChemBench (OpenAI)
- Articolul complet despre MedChemBench (PDF)
- Variante și localizarea reclamelor video în Ads Engine (ElevenLabs)
- Copilot CLI 1.0.115-2
- Codex CLI 0.173.0-alpha.2
- Gemini CLI, PR 30389
- Changelog-ul Antigravity
- Qwen Code v0.28.1-preview.1
- Kimi Code 2.7.2
- CLI mistral 0.20.1
- Changelog-ul Replit din 20 noiembrie
- @cognition pe X: Devin Bot pentru Manim
- Notele de versiune ale API-ului Gemini
- Conștientizarea timpului și intrări asincrone pentru agenții personali (OpenAI)
- @OpenAIDevs pe X: istoricul și raționamentul GPT-6.2
- @AskPerplexity pe X: teammates din Computer
- @AskPerplexity pe X: aplicația Mac
- @pika_labs pe X: Seedance 2.5 Flash
- @HeyGen pe X: teste în orb pentru Avatar 6
- Qwen3 TTS pe Together AI
- Together Storage Accelerator (Together AI)
- @julien_c pe X: CDN-ul Hugging Face
- Superfluid la nivelul unei flote (basecompute)
- WavLate (Hugging Face)
- @NVIDIAAI pe X: WorldTrace
- Dynamo și rollout-urile de RL (NVIDIA)
- Atenție rară pe GPU NVIDIA (NVIDIA)
- GitHub Enterprise Server 3.23 release candidate (changelog GitHub)
- Pagina Overview pentru pull requests (changelog GitHub)
- GitHub Desktop și mai multe conturi per gazdă (changelog GitHub)
- Repository-uri favorite în tabloul de bord (changelog GitHub)
- Hebbia și GPT-6 Astra (OpenAI)
- Consensul tăcut (OpenAI)
- Îmbogățirea datelor cu IA (Perplexity)