ai-powered-markdown-translatorArtykuł przetłumaczony z francuskiego na polski za pomocą gpt-6.1-sol.
Anthropic finalizuje pierwszą ofertę publiczną: około 93,5 miliarda dolarów brutto z oferty oraz kolejne 26 miliardów wpłacone przez siedem grup, w tym NVIDIA, Google i Microsoft, w ramach równoległej oferty prywatnej. Thinking Machines udostępnia Inkling 2 Mini, model o otwartych wagach z 26,4 miliarda parametrów, który mieści się w 20 GB, a OpenAI obniża z 54,0 % do 0,2 % skuteczność ataków wydobywających chronione rozumowanie jego modeli. ChatGPT Space staje się dostępny dla subskrybentów Plus, Runway powierza agentom 38 % operacji scalania kodu, a Claude Code, Codex CLI i Vibe CLI udostępniają nowe wersje.
Finanse: Anthropic finalizuje pierwszą ofertę publiczną, pozyskując 93,5 miliarda dolarów brutto oraz 26 miliardów z oferty prywatnej
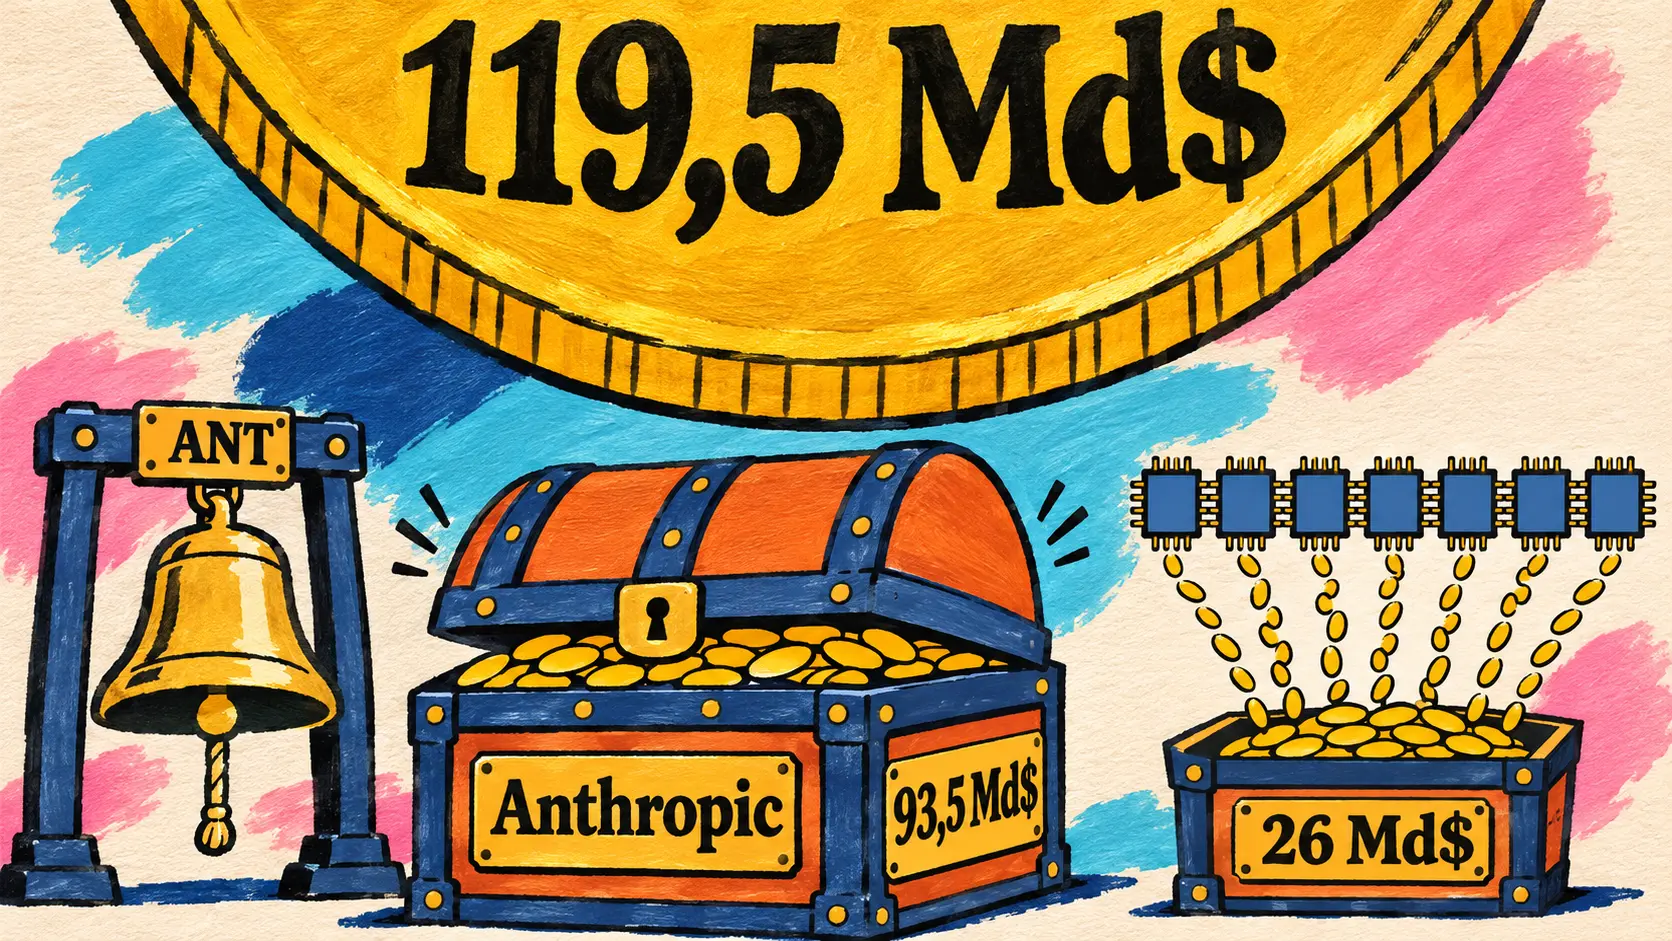
20 listopada — Dzień po rozpoczęciu notowań Anthropic ogłasza zamknięcie pierwszej oferty publicznej, której cenę ustalono 18 listopada na 83 dolary za akcję. Banki w pełni wykorzystały opcję zakupu 147 milionów dodatkowych akcji: łącznie sprzedano 1 127 000 000 akcji klasy A. Wpływy brutto wynoszą około 93,5 miliarda dolarów przed prowizjami i opłatami, z czego około 91,6 miliarda przypada Anthropic, które nie otrzymuje nic ze sprzedaży 23 648 646 akcji przez dotychczasowych akcjonariuszy.
Wpis informuje również o równoległej ofercie prywatnej, także już zamkniętej, o której nie wspomniano w komunikacie ustalającym cenę: 313 253 007 akcji klasy N, sprzedanych po tej samej cenie 83 dolarów siedmiu grupom z branży półprzewodników i informatyki (AMD, Broadcom, Google, Micron, Microsoft, NVIDIA i TSMC Partners), za około 26,0 miliarda dolarów. Akcje te nie są zarejestrowane na mocy Securities Act z 1933 roku. Po zsumowaniu oferty publicznej i prywatnej kwota brutto zbliża się do 119,5 miliarda dolarów, przed prowizjami i opłatami.
| Element transakcji | Wartość podana przez Anthropic |
|---|---|
| Sprzedane akcje klasy A | 1 127 000 000, w tym 147 000 000 w ramach opcji banków |
| w tym sprzedane przez Anthropic | 1 103 351 354 |
| w tym przez dotychczasowych akcjonariuszy | 23 648 646 |
| Cena za akcję | 83 dolary |
| Wpływy brutto z oferty | około 93,5 miliarda dolarów |
| Część otrzymana przez Anthropic | około 91,6 miliarda dolarów |
| Oferta prywatna (klasa N) | 313 253 007 akcji, około 26,0 miliarda dolarów |
| Łącznie brutto, oferta publiczna i prywatna | około 119,5 miliarda dolarów |
| Notowania | od 19 listopada, Nasdaq Global Select Market, symbol ANT |
Wpis potwierdza rozpoczęcie notowań, nie podając kursu ani kapitalizacji. Transakcję prowadziły Goldman Sachs i Morgan Stanley wraz z konsorcjum około dwudziestu banków, w tym J.P. Morgan, Citigroup, BNP Paribas, Crédit Agricole CIB i Société Générale. Tego samego dnia @AnthropicAI opublikowało film, w którym siedmioro współzałożycieli — Dario Amodei, Daniela Amodei, Tom Brown, Jack Clark, Jared Kaplan, Sam McCandlish i Chris Olah — opowiada historię firmy.
🔗 Zamknięcie pierwszej oferty publicznej (Anthropic) · @AnthropicAI na X: współzałożyciele
Modele otwarte: Inkling 2 Mini od Thinking Machines, Tencent Hy4, superadapter dla Qwen3.8-27B, Ayb 0.5 i Depth Pro 2
20 listopada — Thinking Machines Lab udostępnia Inkling 2 Mini, mniejszego brata Inkling 2 Small (594 miliardy parametrów, omówionego tutaj 12 listopada). Ta mieszanina ekspertów (Mixture-of-Experts) o otwartych wagach, na licencji Apache 2.0, ma 26,4 miliarda parametrów, z czego 3,4 miliarda jest aktywnych na token. Odczytuje tekst i obrazy, a jego kontekst obejmuje milion tokenów. Wagi są udostępniane z precyzją używaną podczas treningu, NVFP4 dla dwudziestu warstw i MXFP8 dla czterech ostatnich, co daje około 20 GB bez strat wynikających z konwersji: model działa z Ollama na każdym Macu z co najmniej 32 GB pamięci.
Today we are releasing Inkling 2 Mini, a fast, powerful model that’s small enough to run on your laptop.
🇵🇱 Dziś udostępniamy Inkling 2 Mini, szybki i wydajny model, wystarczająco mały, by działać na twoim laptopie. — Thinking Machines Lab, ogłoszenie Inkling 2 Mini
Jego cechą szczególną jest architektura: to transformer z pętlą (looped transformer). Spośród jego 24 warstw 12 środkowych jest przetwarzanych trzykrotnie, co daje 48 przejść przez warstwy na token przy 24 przechowywanych warstwach, a tym samym 5,4 miliarda aktywacji wag na token. Podczas treningu laboratorium usunęło też dwie trzecie ekspertów (z 384 do 128), a następnie naprawiło model za pomocą 1 000 miliardów tokenów wydestylowanych z większego wewnętrznego modelu Inkling. Według laboratorium przy tej samej wartości funkcji straty model bez pętli wymagałby o 7,5 % mniej obliczeń podczas treningu, ale o 140 % więcej podczas inferencji.
| Benchmark (tabela Thinking Machines) | Inkling 2 Mini | Qwen3.8-27B | Nemotron 3.5 Super VL |
|---|---|---|---|
| Aktywacje wag na token / łączna liczba parametrów | 5,4B / 26,4B | 27,0B / 27,0B | 12,0B / 124,5B |
| AA Index v5.0 | 20,1 | 20,1 | 13,6 |
| DeepSWE v1.1 | 48,2 % | 42,2 % | 24,7 % |
| SWE-bench Pro v2 Hard | 77,9 % | 73,8 % | 44,1 % |
| Terminal-Bench 2.1 (pi) | 71,6 % | 73,0 % | 60,7 % |
| BrowseComp | 79,0 % | 61,6 % | 78,9 % |
| MCP Atlas | 82,7 % | 77,3 % | 67,7 % |
Według Thinking Machines model prowadzi wśród modeli otwartych o mniej niż 100 miliardach parametrów w DeepSWE v1.1 i Vals Index v2.2 (46,5 %). Pozostaje za Qwen3.8-27B w Terminal-Bench 2.1, a Thinking Machines przyznaje, że nie jest najlepszym małym modelem w rozmowach wieloturowych (50,0 % w MultiChallenge) ani w wykonywaniu instrukcji z wieloma ograniczeniami (33,4 % w ComplexConstraints v1.1); legenda wykresu zaznacza, że konfiguracje oceny różnią się między modelami. Badacze ze Stanford, którzy otrzymali wcześniejszy dostęp, zmierzyli na DGX Spark 0,703 jednostki inteligencji na dżul, wobec 0,430 dla Qwen3.6-35B-A3B.
Laboratorium wykorzystuje go także do badań nad monitorowaniem łańcucha myśli (chain of thought): model z pętlą wykonuje więcej obliczeń bez ich zapisywania, co może umknąć systemowi monitorującemu. W również udostępnionym wariancie ze zmienną liczbą przebiegów czas pracy człowieka odpowiadający zadaniu rozwiązywanemu bez zapisywania rozumowania rośnie z 16 do 37 sekund przy zwiększeniu liczby przebiegów z jednego do trzech. Przy pięciu przebiegach rozumowanie jest dwukrotnie krótsze (średnio 1 661 wobec 3 703 tokenów w GPQA Diamond) i pozostaje równie czytelne; Thinking Machines nie obserwuje wzrostu sabotażu dokonywanego przez agentów wraz z liczbą pętli. Model jest dostępny w Tinker, Ollama, SGLang, vLLM, llama.cpp, MLX i Transformers, a wersje GGUF udostępnia Unsloth.
🔗 Inkling 2 Mini (Thinking Machines) · Wpis Hugging Face · Wagi na Hugging Face
Together AI udostępnia Tencent Hy4, mieszaninę ekspertów o 770 miliardach parametrów, za 0,83 dolara za milion tokenów wejściowych
19 listopada — Together AI dodaje Tencent Hy4 do swojej oferty inferencji bezserwerowej, z kontekstem obejmującym milion tokenów, wywoływaniem narzędzi i wyjściem w formacie JSON. Według dostawcy flagowy model Tencent to mieszanina ekspertów o 770 miliardach parametrów, z czego 49 miliardów jest aktywnych na token; zastępuje Hy4 Preview, dodaje obsługę komputera i jako pierwszy z rodziny Hy odczytuje obrazy.
| Cena za milion tokenów | Together AI | Tencent (komunikat z 4 listopada) |
|---|---|---|
| Wejście | 0,83 dolara | około 0,90 dolara |
| Wejście z pamięci podręcznej | 0,042 dolara | około 0,045 dolara |
| Wyjście | 2,50 dolara | około 2,70 dolara |
Tencent wprowadził Hy4 4 listopada, przedstawiając go jako jeden z najlepszych modeli open source i obiecując udostępnienie wag w ciągu kilku dni; repozytorium tencent/Hy4 znajduje się na Hugging Face, na licencji typu „other”. W komunikacie przywołano zaślepioną ocenę zadań finansowych (213 specjalistów, 579 zadań), w której Hy4 uzyskał 3,04, wyprzedzając DeepSeek-V4.1-Flash-1017 (2,97), oraz wewnętrznie mierzony odsetek halucynacji obniżony z 12,95 % do 7,2 %.
🔗 Tencent Hy4 w Together AI · Komunikat Tencent z 4 listopada
Hugging Face publikuje przepis na swoje harness adapters i jeden superadapter dla Qwen3.8-27B
20 listopada — Po trzech dniach publikacji, w tym adaptera Hermes omówionego tutaj wczoraj, Hugging Face udostępnia pełny przepis na swoje harness adapters: adaptery LoRA trenowane metodą uczenia ze wzmocnieniem wewnątrz środowiska agenta (pi, Hermes Agent lub OpenCode), na bazie Qwen3.8-27B. Nowością jest superadapter: trzy adaptery LoRA rangi 32 są łączone w jeden adapter LoRA rangi 96, który działa we wszystkich trzech środowiskach. Ponieważ ich aktualizacje są niemal ortogonalne (cosinus od 0,01 do 0,02), połączony adapter stosuje dokładnie wszystkie trzy.
| SWE-bench Pro (51 trudnych zadań), z rozumowaniem | Model bazowy | Z superadapterem |
|---|---|---|
| Środowisko Hermes Agent | 45 % | 61 % |
| Środowisko OpenCode | 47 % | 67 % |
| Środowisko pi | 74 % | 74 % |
Z rozumowaniem średnia dla sześciu par środowisko-benchmark rośnie z 55,5 do 63,5 %, przy liczbie wywołań narzędzi mniejszej o 19–48 %, według wątku zespołu; bez rozumowania superadapter zyskuje od 6 do 18 punktów w SWE-bench Pro, przy liczbie wywołań narzędzi mniejszej o 53–73 %, według wpisu. Wyników nie można porównywać między środowiskami, ponieważ różnią się ich ustawienia domyślne. Trening wymagał 598 kroków i 167 milionów tokenów; zabezpieczenie safeagents sprawdziło 1,3 miliona wywołań narzędzi i zablokowało 647 z nich. Opublikowano zadania, adaptery, GGUF i przebiegi oceny.
🔗 Harness adapters na dużą skalę (Hugging Face) · @yb2698 na X
Metric AI udostępnia Ayb 0.5, OhanTTS i OhanASR, otwarte modele tekstowe i głosowe dla języka ormiańskiego
20 listopada — Ormiański zespół Metric AI udostępnia tego samego dnia trzy rodziny modeli dla swojego języka. Ayb 0.5 obejmuje trzy modele językowe (0,8B, 4B i 9B) zbudowane na Qwen3.5 i dostosowane do języka ormiańskiego, od rozszerzonego tokenizera po dotrenowanie; Ayb-9B obsługuje dialog wieloturowy, wywoływanie narzędzi i obrazy. OhanTTS-v0.1 syntetyzuje mowę w ośmiu językach, w tym ormiańskim i francuskim, oraz klonuje głos na podstawie od 3 do 10 sekund nagrania. OhanASR-v0.1, model rozpoznawania mowy o 2B parametrów, został dostrojony na 820 godzinach nagrań w języku ormiańskim.
| Model Metric AI | Wynik opublikowany przez autorów |
|---|---|
| Ayb-9B | 3. miejsce w klasyfikacji ogólnej ArmBench (0,6164) |
| OhanTTS-v0.1, 61 godzin języka ormiańskiego | 14,70 % WER, pierwszy dźwięk po 331 ms na GB10 |
| OhanASR-v0.1 | 16,12 % WER (2. miejsce) i 3,49 % CER (1. miejsce) w ArmBench-ASR |
Wagi Ayb-9B są objęte licencją niekomercyjną (CC BY-NC 4.0) i dostępne po ręcznym zatwierdzeniu.
🔗 Ayb 0.5 (Metric AI) · OhanTTS · OhanASR
Apple udostępnia Depth Pro 2, który szacuje głębię w metrach na zdjęciach i filmach
19 listopada — Apple udostępnia Depth Pro 2, rodzinę modeli szacujących głębię w metrach, zarówno na zdjęciach, jak i filmach, w natywnej rozdzielczości. Według streszczenia artykułu dotychczasowe metody wymagały wyboru między spójnością kolejnych klatek a ostrością konturów; Depth Pro 2 dąży do zapewnienia obu tych cech za pomocą jednej sieci. Wagi są dostępne na Hugging Face w czterech rozmiarach (S, B, L, H), wraz z wersją Core ML i wspólnym estymatorem ogniskowej, przydatnym, gdy ogniskowej brakuje w danych EXIF.
| Rozdzielczość przetwarzana przez DepthPro2-L (334M, na B200) | Obrazy na sekundę |
|---|---|
| VGA | 150,1 |
| 720p | 33,7 |
| 1080p | 9,1 |
| 4K | 0,7 |
Wagi są przeznaczone wyłącznie do niekomercyjnych badań (licencja Apple Machine Learning Research Model), a kod znajduje się na GitHub. O premierze poinformował 20 listopada Pedro Cuenca z Hugging Face, udostępniając demonstrację online.
🔗 @pcuenq na X · Artykuł arXiv 2611.26603 · DepthPro2-L (Hugging Face)
Bezpieczeństwo modeli: OpenAI przeciwdziała wrogiej destylacji, Sakana AI tworzy swój Security Research Group
OpenAI szczegółowo opisuje walkę z destylacją adwersarialną i ogranicza ekstrakcję chronionego rozumowania z 54,0 % do 0,2 %
20 listopada — OpenAI publikuje wpis o destylacji adwersarialnej (adversarial distillation): nieautoryzowanym wykorzystywaniu wyników zaawansowanego modelu do trenowania innego, wdrażanego bez tych samych zabezpieczeń, na przykład do ataków, których oryginalny model odmówiłby przeprowadzenia. Wpis skupia się przede wszystkim na chronionym rozumowaniu, czyli łańcuchu myśli powstającym przed odpowiedzią: według badania wewnętrznego model uczeń zwykle robi większe postępy dzięki dokładnym zapisom rozumowania niż dzięki ich streszczeniom.
| Mierzony atak (ocena adaptacyjna, sześć modeli atakujących) | GPT-6 Astra, pierwotne zabezpieczenia | GPT-6.2 Astra, zaktualizowane zabezpieczenia |
|---|---|---|
| Rozumowanie dotyczące wcześniejszego zapytania | 54,0 % | 0,2 % |
| Rozumowanie dotyczące bieżącego zapytania | 22,9 % | 0,9 % |
Obrona łączy trening adwersarialny, klasyfikatory wejścia i wyjścia (obejmujące również argumenty wywołań narzędzi), kontrole API i dochodzenia, a co tydzień nakładane są sankcje na kampanie obejmujące od kilku do kilkudziesięciu tysięcy kont. W GPT-6.2 Astra i Sol chronione rozumowanie jest powiązane z historią, na podstawie której powstało: API je odrzuca, jeśli wcześniejsza wiadomość zostanie przepisana, a starsze rodziny modeli nie mogą go już odczytać. OpenAI przypomina, że w lutym zgłosiło Kongresowi aktywność wskazującą na próby destylacji amerykańskich modeli przez DeepSeek, a we wrześniu przypisało jedną z kampanii osobom związanym z Moonshot AI; deklaruje też poparcie dla Chip Security Act, AI OVERWATCH Act i MATCH Act.
🔗 Zwalczanie destylacji adwersarialnej (OpenAI) · @OpenAI na X
Sakana AI tworzy Security Research Group, niezależny zespół na rzecz zbiorowej cyberobrony
20 listopada — Sakana AI uruchamia Security Research Group, niezależny zespół R&D z siedzibą w Tokio, oddzielony od działalności komercyjnej firmy i działający w interesie publicznym.
Excited to announce the Sakana AI Security Research Group, an independent, public-interest R&D team in Tokyo co-led by Akihiro Umegai and me.
🇵🇱 Z przyjemnością ogłaszam powstanie Sakana AI Security Research Group, niezależnego zespołu R&D działającego w interesie publicznym w Tokio, którym współkierujemy Akihiro Umegai i ja. — @hardmaru na X
David Ha jest współzałożycielem i dyrektorem generalnym Sakana AI. Zespół będzie pracował w trzech obszarach: zapobiegania zagrożeniom już na etapie projektowania, zbiorowej obrony z udziałem agentów rozproszonych między organizacjami oraz zabezpieczania samych agentów obronnych, których uprawnienia będą ograniczone do ich zadań, a działania rejestrowane. Punktem wyjścia są własne prace, takie jak Digital Red Queen, ShinkaEvolve i Fugu-Cyber, dla którego Sakana AI podaje wyniki 86,9 % w CyberGym i 72,1 % w CTI-REALM; przypis we wpisie wyjaśnia, że strona Fugu-Cyber nie podaje ani wyników referencyjnych, ani protokołu oceny. Zespół będzie publikował białe księgi, benchmarki i poradniki obronne, ale nie materiały do wykorzystywania luk, a znalezione podatności będą zgłaszane w ramach skoordynowanego ujawniania. Sakana AI przypomina, że według NIST liczba zgłoszeń o nadanie identyfikatora CVE wzrosła o 263 % między 2020 a 2025 rokiem.
🔗 Grupa badawcza ds. bezpieczeństwa (Sakana AI)
Agenci w procesie dostarczania oprogramowania: fabryka Runway, Stitch Loop od Google Labs
Runway powierza agentom proces dostarczania oprogramowania; odpowiadali oni za 38 % październikowych scaleń
20 listopada — Runway publikuje na swoim blogu inżynieryjnym liczbowe podsumowanie swojej „fabryki oprogramowania” (software factory): siedmiu etapów, od pisania kodu po koordynację scaleń, powierzanych kolejno agentom. Agenci w chmurze odpowiadali za 38 % pull requests scalonych w październiku, a spośród 100 takich PR scalonych w pierwszej połowie listopada 78 nie zawierało żadnego commitu człowieka.
| Wskaźnik fabryki oprogramowania | Punkt wyjścia | Ostatni pomiar |
|---|---|---|
| Scalenia prowadzone przez agentów w chmurze | 0,1 % (czerwiec) | 38 % (październik) |
| Mediana oczekiwania na pierwszą akceptację | 2,3 h (wrzesień) | około 5 min (połowa listopada) |
| Średnia liczba scaleń tygodniowo | 929 (wrzesień) | 2 235 (od połowy października) |
Od połowy października AI samodzielnie zatwierdza PR o niskim ryzyku, a także o średnim ryzyku, jeśli repozytorium na to pozwala; wysokie ryzyko wymaga udziału człowieka, a właściciele kodu nadal zatwierdzają migracje, konfigurację CI i wdrożeń, sekrety oraz uwierzytelnianie. We wrześniu i październiku człowiek zakwestionował 15 z 977 PR zatwierdzonych przez AI, a wskaźnik wycofań scaleń zatwierdzonych wyłącznie przez AI wynosi 0,10 %, wobec około 1 na 200 w przypadku akceptacji przez ludzi. Agenci testują też App Studio jak użytkownik (86 potwierdzonych błędów w cztery dni), a koordynator przydzielił ponad 14 000 zadań w dwa tygodnie. Są to narzędzia wewnętrzne, bez dostępnego produktu ani cennika.
🔗 Budowa fabryki oprogramowania (Runway)
Google Labs uruchamia Stitch Loop, agenta produktowego, który stale ulepsza działającą aplikację
18 listopada — Google Labs prezentuje Stitch Loop, długotrwale działającego agenta produktowego, który podejmuje pracę tam, gdzie kończy ją agent kodujący: po wdrożeniu na produkcję. Łączy się z repozytorium GitHub oraz danymi działającego produktu (logami, zachowaniem użytkowników, opiniami) za pośrednictwem ponad 180 integracji, niestandardowych serwerów MCP lub danych przesyłanych z lokalnej CLI i stale pracuje nad mierzalnymi celami.
Każda pętla proponuje kierunki działań oparte na danych, szczegółowo opisuje rozwiązania i związane z nimi kompromisy, pisze kod w odizolowanym sandboxie w chmurze i otwiera pull request do zatwierdzenia, a następnie obserwuje metryki na żywo. Domyślnie dostępne są trzy pętle (cyberbezpieczeństwo, opóźnienia, dostępność); pętla bezpieczeństwa łączy Gemini 4 Carbon z CodeMender, agentem bezpieczeństwa kodu od Google DeepMind. Każde scalenie wymaga przeglądu przez zespół. Stitch Loop dostarcza też kontekst produktu agentom kodującym, takim jak Google Antigravity, za pośrednictwem CLI Stitch i MCP, i można z niego korzystać w Slack. Na razie otwarto jedynie zapisy na listę oczekujących na całym świecie, z priorytetowym dostępem dla uprawnionych subskrybentów Google AI Ultra.
Asystenci dla użytkowników indywidualnych: ChatGPT Space dla subskrybentów Plus, GIF-y w aplikacji Gemini, Perplexity Computer w przeglądarkach Chromium
ChatGPT Space trafia do subskrybentów Plus na całym świecie
20 listopada — ChatGPT Space, zaprezentowane podczas DevDay 29 września i dotychczas dostępne wyłącznie w planach Pro, Business i Enterprise, jest udostępniane na całym świecie subskrybentom Plus w wieku co najmniej 18 lat. Space zastępuje Bibliotekę na pasku bocznym (strony, slajdy, obrazy, przesłane pliki) w wersji przeglądarkowej, aplikacji desktopowej, iOS i Android.
Można w nim tworzyć z ChatGPT interaktywne strony i prezentacje, które mogą rozbudowywać inne osoby mające dostęp do Space. Strony i slajdy mogą aktualizować się samodzielnie na podstawie połączonych aplikacji: OpenAI podaje przykład automatycznie aktualizowanej listy zadań lub planu projektu uwzględniającego decyzje podejmowane w Slack. Wystarczy wspomnieć ChatGPT w komentarzu, aby poprosić o zmianę, a do współpracy można zaprosić także agenta dot. Udostępnianie pozostaje ograniczone: potrzebne są uprawnienia do odczytu oraz konto Plus, Pro, Business lub Enterprise z dostępem do Space; konta Free nie otwierają udostępnionych treści, a publiczne linki nie są dostępne.
🔗 Informacje o wydaniach ChatGPT
Aplikacja Gemini tworzy animowane GIF-y za pomocą Gemini Omni 1.2 Flash, bezpłatnie we Francji
20 listopada — Aplikacja Gemini tworzy teraz animowane GIF-y (zapętlone efekty fotograficzne, memy) za pomocą Gemini Omni 1.2 Flash, modelu wideo udostępnionego przez Google 5 listopada, który według firmy zapewnia płynny ruch i stałą jakość kolejnych klatek. Wystarczy wpisać prośbę w głównym czacie lub otworzyć narzędzie do obrazów albo wideo, a następnie wybrać GIF w selektorze formatu.
GIFs are now available to all Google AI subscribers and free of charge in the U.S., Japan, Korea, Australia, Canada, U.K., Germany, and France.
🇵🇱 GIF-y są już dostępne dla wszystkich subskrybentów Google AI oraz bezpłatnie w Stanach Zjednoczonych, Japonii, Korei, Australii, Kanadzie, Wielkiej Brytanii, Niemczech i Francji. — @GeminiApp na X
Użytkownicy we Francji mają więc do nich dostęp również bez subskrypcji. Google podąża śladem OpenAI, którego animowane GIF-y w ChatGPT z Images 2.6 omówiono tutaj 5 listopada.
🔗 @GeminiApp na X: GIF-y w Gemini
Perplexity Computer działa bezpośrednio w przeglądarkach Chromium dzięki rozszerzeniu Perplexity
20 listopada — Perplexity Computer działa teraz bezpośrednio w przeglądarkach opartych na Chromium dzięki rozszerzeniu Perplexity. Zadanie zleca się z panelu bocznego rozszerzenia, a następnie obserwuje pracę Computer w kartach i narzędziach użytkownika. Wpis z ogłoszeniem nie precyzuje, których planów dotyczy ta funkcja ani jakie przeglądarki są obsługiwane.
Były już dwa podobne rozwiązania: 5 października aplikacja na Maca w wersji 26.38.0 pozwalała Computer korzystać z Chrome, Edge lub Brave dzięki rozszerzeniu, a 30 października rozszerzenie Chrome łączyło aplikacje Computer na Maca i Windows z przeglądarką użytkownika. Tym razem zadanie zleca się z panelu bocznego rozszerzenia w przeglądarce.
API i SDK dla programistów: Codex w Agents SDK dla Pythona, Decider w Context API od Perplexity
Agents SDK dla Pythona od OpenAI udostępnia wersję zapoznawczą 1.0, w której Codex staje się dostawcą modelu
20 listopada — Agents SDK dla Pythona od OpenAI rozpoczyna serię 1.0 wersją zapoznawczą, która zmienia podejście: zamiast osobnego silnika natywnego, jak w wersji zapoznawczej 0.24 omówionej tutaj 16 listopada, Codex staje się dostawcą modelu wybieranym przy każdym uruchomieniu. Tworzy się CodexProvider i przekazuje do obiektu Runner przez RunConfig(model_provider=provider); agent korzysta wtedy z zapisanego logowania do Codex lub z klucza API.
Pakiet wheel Pythona zawiera Codex Core (rust-v0.166.0, bez modyfikacji) za pośrednictwem PyO3: SDK wywołuje bezpośrednio rdzeń Codex, bez uruchamiania codex app-server ani korzystania z JSON-RPC. Narzędzia Pythona, przekazywanie zadań agentowi specjaliście (handoffs), zatwierdzanie przed uruchomieniem narzędzia i typowane dane wyjściowe pozostają dostępne, a polecenia natywne respektują sandbox i reguły zatwierdzania Codex. Pakiety wheel 1.0.0a1 są rozpowszechniane wyłącznie przez GitHub Releases (Linux x86-64 i ARM64, macOS 11 i nowsze na Apple silicon, Windows x64, CPython od 3.10 do 3.14). Zapisane stany z wersji zapoznawczej 0.24.0-alpha.8 nie są zgodne z mechanizmem Runner, a wersją stabilną pozostaje 0.25.0 z 18 listopada.
🔗 openai-agents-python v1.0.0-alpha.1
Perplexity dodaje Decider do Context API, aby oceniać strony, w tym wykrywać wstrzyknięcia promptu
19 listopada — Perplexity dodaje Decider, swój model decyzyjny, do Context API uruchomionego dwa dni wcześniej (1 dolar za 1 000 URL). Dla każdej pobranej strony można zadać do pięciu pytań zamkniętych (tak lub nie), a Decider ocenia każdą odpowiedź w skali od 0 do 1. Główne prezentowane zastosowanie dotyczy bezpieczeństwa: wykrywania wstrzyknięcia promptu (prompt injection) na stronie, zanim przeczyta ją agent. Perplexity wymienia też kwalifikację potencjalnych klientów, moderację i wykrywanie twierdzeń dotyczących zdrowia bez podanego źródła.
API samo niczego nie filtruje: zwraca wszystkie strony wraz z ich wynikami, a próg stosuje kod aplikacji. Ocena jest rozliczana według tokenów wejściowych Decisions API, dodatkowo do ceny za URL, i może wydłużyć zapytanie maksymalnie o 15 sekund. Cookbook w dokumentacji przedstawia kontrolę przeprowadzoną 18 listopada z progiem 0,7:
| Testowana strona (cookbook z 18 listopada) | Wynik oceny wstrzyknięcia | Decyzja po kontroli |
|---|---|---|
| Demonstracja wstrzyknięcia (Greshake et al., 2023) | 0,97 | kwarantanna |
| OWASP, strona o wstrzyknięciach promptu | 0,0018 | przekazana |
| RFC 9111 | 0,0007 | przekazana |
Cookbook ostrzega, że niski wynik nie oznacza, że strona jest bezpieczna: według badania BrowseSafe++ od Perplexity każdy testowany model nadal wykonywał niektóre wstrzyknięte instrukcje, które sam wcześniej oznaczył.
🔗 Wątek @perplexitydevs · Dokumentacja · Cookbook
Agenci kodujący: Claude Code 2.1.329, Codex CLI 0.171.0, Vibe CLI 3.1.4 i Gemini 4 Neon w Devin
Claude Code 2.1.329 wskazuje pochodzenie hooków przy otwieraniu folderu i grupuje zaplanowane zadania w /tasks
19 listopada — Claude Code 2.1.329 obejmuje 130 pozycji, w tym 91 poprawek, 20 zmian i 7 nowości. W zakresie bezpieczeństwa okno dialogowe z pytaniem, czy zaufać folderowi, pokazuje teraz, gdzie zadeklarowano jego hooki, a Claude Desktop i pozostałe hosty nieinteraktywne ostrzegają, gdy hooki wymuszane przez ustawienia zarządzane (managed settings) się nie wczytują. /tasks wyświetla też zaplanowane zadania sesji, wybudzenia /loop, bieżący cel i forki rozmowy; większość zaplanowanych zadań zapisanych przez poprzednie wersje trzeba będzie zaplanować ponownie.
/code-review bez wskazanego celu przegląda teraz, w przypadku większości modeli, całą gałąź względem gałęzi domyślnej, a po podaniu numeru PR odczytuje samą PR przez gh pr diff. W macOS computer use przechodzi na nowsze reguły bezpieczeństwa, które odrzucają niektóre działania. Automatyczne ponawianie dodane w 2.1.326 po błędzie max_tokens zostaje usunięte: przy korzystaniu z bramy trzeba skonfigurować CLAUDE_CODE_MAX_OUTPUT_TOKENS. Code Mode otrzymuje 17 pozycji, w tym obsługę zdarzeń i metryk OpenTelemetry. Wersja 2.1.330 jest dostępna w npm od 20 listopada.
Codex CLI 0.171.0 ustawia GPT-6.2 Sol jako model domyślny i włącza przestrzeń roboczą terminala
20 listopada — Codex CLI 0.171.0 to pierwsza stabilna wersja od 0.170.0 z 18 listopada, obejmująca 339 pull requests. GPT-6.2 Sol i GPT-6.2 Astra trafiają do katalogów modeli, z Sol wybranym domyślnie, a polecenia /rc i /remote pozwalają z terminala zarządzać zdalnym sterowaniem na lokalnym urządzeniu i wyświetlają kody parowania urządzeń.
Kilka nowości z wersji zapoznawczych z 14–17 listopada trafia do wersji stabilnej: przestrzeń robocza TUI, domyślnie włączona, wyświetla podglądy dokumentów i obrazów oraz transkrypcje podagentów obok rozmowy; codex exec --remote uruchamia lub wznawia sesję nieinteraktywną na istniejącym serwerze aplikacji; edytor wiadomości zyskuje cofanie i ponawianie; /statusline wybiera wiersze stanu dostarczane przez serwer MCP, po włączeniu odpowiedniej opcji. Wśród poprawek: szkice i ponowienia w kolejce pozostają przypisane do swoich rozmów, a firmowe połączenie MCP działa z dostawcami tożsamości, którzy nie wydają tokena odświeżania.
Vibe CLI 3.1.4 oddziela agenta od polityki zatwierdzania i odbiera agentom prawo do wyłączania potwierdzeń
20 listopada — Mistral wydaje Vibe CLI 3.1.4, dwa dni po wersji 3.1.3, która uczyniła Mistral Large 4 modelem domyślnym. 79 pozycji w wykazie zmian (18 dodatków, 41 zmian, 18 poprawek, 2 usunięcia) dotyczy przede wszystkim uprawnień: każda sesja łączy teraz dwa niezależne ustawienia — agenta (default, lean lub niestandardowego) oraz politykę zatwierdzania (ask, accept-edits, smart-approve lub auto-approve), wybieraną przez --approval-policy lub default_approval_policy.
Agent nie decyduje już samodzielnie, co wykonuje się bez pytania: jego ustawienia safety, bypass_tool_permissions i permission = "always" są ignorowane. Projekt nie może już nadpisywać polityki zatwierdzania w swoim folderze .vibe/agents/, a forki i sesje potomne dziedziczą pierwotną politykę. Interfejs zyskuje pasek etykiet nad polem wprowadzania tekstu (subagenci, zadania w tle, pull requests, cel, zadania), ustawienie keep_awake zapobiega usypianiu podczas tury, a Vibe akceptuje certyfikaty systemowe, co ułatwia działanie za firmowym proxy. Do modeli Mistral trafia teraz tylko 8 najnowszych obrazów, a niestandardowe prompty kompakcji zostały usunięte.
Devin udostępnia Gemini 4 Neon: 46,2 % na FrontierCode 2.0 przy koszcie 4,38 dolara za zadanie
19 listopada (wpis datowany na 18 listopada) — Po Cursor i GitHub Copilot, opisanych tu wczoraj, Cognition udostępnia Gemini 4 Neon w Devin Desktop i Devin CLI. Na FrontierCode 2.0, swoim benchmarku oceniającym, czy pull request zasługuje na scalenie, Neon osiąga 46,2 % — według Cognition to najlepszy wynik modelu Google. Plasuje się około jednego punktu za Claude Opus 5.5 (47,3 %) przy mniej więcej jednej trzeciej kosztu: 4,38 dolara za zadanie wobec 12,82 dolara.
| Model oceniony na FrontierCode 2.0 | Wynik opublikowany przez Cognition |
|---|---|
| Claude Fable 5.2 | 50,2 % |
| Claude Opus 5.5 | 47,3 % |
| Gemini 4 Neon | 46,2 % |
| GPT-6.2 Astra | 44,2 % |
| GPT-6.2 Sol | 43,8 % |
| Gemini 4 Carbon | 42,6 % |
Koszt oznacza średni wydatek na wykonanie według cennika API, z uwzględnieniem publicznie dostępnych rabatów, a rozwiązanie, które nie spełni kryterium blokującego, otrzymuje zero punktów. Kilka wyników na tym wykresie różni się od wartości opublikowanych w poprzednich tygodniach, bez wyjaśnienia we wpisie.
🔗 Gemini 4 Neon w Devin (Cognition) · @cognition na X
Nauka: OpenAI publikuje MedChemBench, benchmark chemii medycznej, w którym GPT-6.2 Astra osiąga 84,5 %
20 listopada — OpenAI przedstawia MedChemBench, benchmark mierzący zdolność modeli do rozumowania jak chemik medyczny: łączenia struktury cząsteczki z wynikami eksperymentalnymi, porównywania związków i przewidywania ich właściwości. Obejmuje 99 problemów zaczerpniętych ze 117 artykułów i patentów, z 761 odrębnymi strukturami molekularnymi, i ocenia cztery elementy: struktury, rozumowanie naukowe, dobór związków oraz przewidywanie właściwości.
| Oceniony model (poziom rozumowania xhigh) | Uzyskana punktacja |
|---|---|
| GPT-6.2 Astra | 84,5 % |
| GPT-6 Astra | 83,3 % |
| GPT-6.1 Sol | 82,0 % |
| GPT-6.1 Terra | 75,1 % |
| GPT-5.6 Sol | 58,2 % |
Wyniki są nierównomierne: GPT-6 Astra uzyskuje 95,4 % punktów za struktury, ale około połowy za dobór związków i przewidywanie wartości liczbowych. OpenAI zachowuje ostrożność: benchmark opiera się na danych historycznych i nie dowodzi, że modele potrafią odkrywać nowe leki; nie można wykluczyć wcześniejszego kontaktu z publikacjami źródłowymi, a ocenie poddano wyłącznie modele GPT. To kolejny benchmark po BioBasicsBench, opisanym tu 6 listopada.
🔗 Przedstawiamy MedChemBench (OpenAI) · Pełny artykuł (PDF)
Generatywne wideo i audio: ElevenLabs dodaje do Ads Engine warianty reklam bez ponownego nagrywania
20 listopada — ElevenLabs rozbudowuje Ads Engine, swoje narzędzie do tworzenia reklam zintegrowane z ElevenCreative i uruchomione w czerwcu. Połączone z kontami reklamowymi Google, Meta, LinkedIn, a teraz także TikTok, wykorzystuje istniejące reklamy i ich wyniki do tworzenia wariantów bez ponownego nagrywania. Rozpoznaje początkowy element przyciągający uwagę (hook) i pisze nowe na podstawie reklam, które się sprawdziły; wypowiada je cyfrowa replika głosu pierwotnego mówcy, z synchronizacją ust i zaktualizowanymi napisami. Nowe ścieżki dźwiękowe, komponowane przez API ElevenLabs Music na podstawie tonu i rytmu obrazu, można wykorzystywać komercyjnie.
W zakresie lokalizacji, obsługiwanej już przez Dubbing v2, Ads Engine dostosowuje teraz ruch ust mówcy do języka docelowego i zastępuje napisy wtopione w obraz przetłumaczoną wersją, z odpowiednim czasem wyświetlania i krojami pisma marki. Przed publikacją nadal możliwa jest weryfikacja przez człowieka, w tym przez specjalistę od lokalizacji będącego rodzimym użytkownikiem języka, a narzędzie może publikować bezpośrednio na platformach. Dostęp uzyskuje się przez dział sprzedaży; ceny nie zostały opublikowane.
🔗 Warianty i lokalizacja reklam wideo w Ads Engine (ElevenLabs)
W skrócie
Agenci programistyczni
- Copilot CLI 1.0.115-2 — W tej wersji wstępnej z 351 pozycjami w wykazie zmian, w tym 335 poprawkami, Gemini 4 Hydrogen trafia do selektora z poziomem wysiłku Extra High, jeśli konto ma do niego dostęp, dodano obsługę GPT-6.2 Astra, a
/modelobsługuje też modele niestandardowych dostawców; wersją stabilną pozostaje 1.0.114. 🔗 źródło - Codex CLI 0.173.0-alpha.1 i alpha.2 — Informacje o tych wersjach wstępnych są puste; według tytułów 71 commitów współdzielenie połączeń MCP i wykrywanie OAuth dla skonfigurowanych serwerów stają się domyślnie włączone, a administratorzy będą mogli wyłączać aktualizacje demona Codex. Zawartość może się zmienić przed wydaniem stabilnym. 🔗 źródło
- Gemini CLI — Pierwsza wersja nightly od 4 listopada (v0.71.0-nightly.20261120); w głównej gałęzi
gemini --resumeponownie otwiera ostatnio używaną sesję zamiast ostatnio uruchomionej, a ścieżki zaczynające się od~\są wreszcie rozwijane w Windows. 🔗 źródło - Antigravity IDE 2.8.0 — Edytor Google błyskawicznie uruchamia swój backend i sprawdza aktualizacje w tle, automatycznie przekierowuje porty dla połączeń zdalnych, pozwala przeszukiwać rozmowę za pomocą klawiatury oraz akceptuje niestandardowe certyfikaty i proxy podczas łączenia. 🔗 źródło
- Qwen Code 0.28.1-preview.1 — Ta wersja wstępna ze 179 pozycjami w wykazie zmian czyni GitHub trzecim obsługiwanym adapterem kanału, dodaje WeCom, Microsoft Teams i ogólne webhooki wychodzące konfigurowane z interfejsu webowego, a także wprowadza w CLI układ dla czytników ekranu; wersją stabilną pozostaje v0.28.0. 🔗 źródło
- Kimi Code 2.7.1 i 2.7.2, Kimi Code Desktop 1.4.1 i 1.4.2 — Cztery wydania z poprawkami dzień po wersji 2.7.0: poziom wysiłku rozumowania wybrany w szkicu nie wraca już do domyślnego po wysłaniu, a forki nie zawodzą już po przywróceniu sesji, której kierunek zmieniono w trakcie tury. 🔗 źródło
- CLI mistral 0.20.1 —
mistral evals execkończy się teraz niepowodzeniem (kod 1), gdy wszystkie wywołania podczas wykonania zakończyły się błędem, na przykład błędem 401, zamiast zgłaszać sukces; przerwanie przez Ctrl-C jest odpowiednio sygnalizowane. 🔗 źródło - Replit — Obszary robocze (Workspaces) można teraz wyszukiwać i przypinać; opcja ta pojawia się dopiero przy co najmniej pięciu obszarach. 🔗 źródło
- Devin Bot dla Manim — Cognition pokazuje Devin Bot, którego Grant Sanderson skonfigurował do pomocy przy Manim, otwartym systemie animacji wykorzystywanym w filmach 3Blue1Brown (96,6 k gwiazdek, 250 000 pobrań miesięcznie); tweet nie precyzuje ani zadań powierzonych botowi, ani jego wyników. 🔗 źródło
API i platformy
- API Gemini — Od 17 listopada Gemini 3.5 Transcribe, zarówno w wersji klasycznej, jak i na żywo, umożliwia głosowe modyfikowanie, przeredagowywanie i formatowanie dyktowanego lub istniejącego tekstu (parametr
source_text), a Google wymienia też tłumaczenie. Od 18 listopada API pozwala przetwarzać i opłacać tylko potrzebną część przesłanych plików: zakresy stron, karty arkuszy, komórki, przedziały czasowe lub warstwy treści. 🔗 źródło - Świadomość czasu w API Agents — Eksperymentalna opcja (
experimental={"time_awareness": True}) regularnie przypomina modelowi aktualny czas, aby dostosowywał pracę do terminu; w połączeniu z narzędziami asynchronicznymi pozwala agentowi zadać pytanie i kontynuować poszukiwania w oczekiwaniu na odpowiedź, co pokazuje wpis na blogu deweloperskim OpenAI. 🔗 źródło - Historia rozmów z GPT-6.2 — @OpenAIDevs prosi, by nie modyfikować już wcześniejszych wiadomości w Responses API, ponieważ API odrzuca rozumowanie następujące po zmienionej wiadomości. Nowa sekcja Reasoning removals w panelu Usage pomaga to wykryć, a powiązany przewodnik proponuje zamiast tego dodać element
configuration_updatelubadditional_tools, aby zmienić poziom wysiłku lub narzędzia. 🔗 źródło
Asystenci dla użytkowników indywidualnych
- ChatGPT wdraża nową aplikację mobilną z kartą dla dot i przypiętymi ulubionymi — Codex, Projects lub Images można przypinać do paska kart; wdrażanie zaczyna się od użytkowników Pro w wieku co najmniej 18 lat tam, gdzie dostępne są dots, z wyłączeniem Europejskiego Obszaru Gospodarczego (w tym UE), Wielkiej Brytanii, Szwajcarii i Korei, oraz od małej grupy użytkowników Plus (informacje o wydaniu z 19 listopada, podlinkowane wyżej).
- Teammates w Perplexity — Abonenci Max mogą teraz tworzyć teammate z dowolnego zadania Computer w wersji webowej, a następnie zmieniać jego nazwę, rolę lub awatar w tej samej rozmowie. 🔗 źródło
- Aplikacja Perplexity na Maca — Działa szybciej, dodaje „Wyślij teraz” do zmiany kierunku trwającego zadania, ⌘F do wyszukiwania w tabelach, Markdown i podglądach oraz ⌘⇧T do ponownego otwierania zamkniętej karty. 🔗 źródło
Generatywne wideo i audio
- Seedance 2.5 Flash w Pika — Po Runway i HeyGen Pika dodaje szybki wariant modelu wideo ByteDance do projektów wymagających wielu ujęć: filmy do 30 sekund w 480p lub 720p, do 10 obrazów, 5 filmów i 5 klipów audio jako materiały referencyjne; tweet nie podaje ceny. 🔗 źródło
- Avatar 6 od HeyGen — Nowe ślepe testy z raportu technicznego: gdy nagrane osoby, będące pracownikami HeyGen, wybierają film, który najwierniej je przedstawia, Avatar 6 wygrywa w 86,5 % przypadków z Seedance 2.5 i w 87,9 % z Wan 3.0; oceny te przeprowadza HeyGen. 🔗 źródło
- Qwen3 TTS w Together AI — Otwarty model syntezy mowy Qwen3-TTS-12Hz-1.7B (Apache 2.0) jest udostępniany za 20 dolarów za milion znaków, z dziewięcioma głosami regulowanymi poleceniem w języku naturalnym, dziesięcioma językami, w tym francuskim, i pierwszym dźwiękiem po zaledwie 97 ms w najlepszym przypadku. 🔗 źródło
Infrastruktura i badania
- Together Storage Accelerator — Together AI oferuje z każdym klastrem GPU cache NVMe dla pamięci masowej S3 i Hub Hugging Face, bez zmian w kodzie; według pomiarów firmy czas odczytu pliku o wielkości 2 GiB z Cloudflare R2 spada z 12,7–15,0 s do 0,64–0,72 s, a klaster 200 węzłów pobiera go ze źródła tylko raz. 🔗 źródło
- CDN Hugging Face — Hugging Face dostarcza miesięcznie blisko eksabajt otwartych modeli i zbiorów danych, według współzałożyciela Juliena Chaumonda, i zbudowało własną sieć dostarczania treści (CDN) do pobierania zasobów AI. 🔗 źródło
- Superfluid od basecompute — Lokalny serwer rozdziela teraz inferencję między maszyny Apple, AMD i NVIDIA: sześć maszyn zwiększa przepustowość ze 112 do 534 tokenów wyjściowych na sekundę dla 64 symulowanych użytkowników, a wyłączenie węzła nie powoduje utraty żadnego żądania, według producenta. 🔗 źródło
- WavLate — Ten otwarty model późnej interakcji wyszukuje dźwięki na podstawie tekstu i tekst na podstawie dźwięku, z jednym wektorem na każde 0,31 sekundy dźwięku i jednym na słowo; jego autor podaje średni Recall@1 wynoszący 37,9 na AudioCaps i Clotho, najlepszy spośród dziewięciu porównanych otwartych modeli, oraz publikuje wagi i dane. 🔗 źródło
- WorldTrace — NVIDIA Research przedstawia pamięć dla interaktywnych modeli świata operujących na wideo, bez ponownego trenowania (artykuł przyjęty na NeurIPS 2026): na LoopBench odtwarzanie ponownie odwiedzanych scen poprawia się o 32,6 % względem przesuwnego okna, przy zużyciu 3,1 GB pamięci GPU i czasie wykonania dłuższym o 27 %. 🔗 źródło
- Dynamo do uczenia ze wzmocnieniem — NVIDIA szczegółowo opisuje, jak Dynamo obsługuje rollouts podczas dotrenowywania: routing według cache KV, różnicowe przesyłanie wag z ModelExpress, przywracanie procesów roboczych po awarii. Korzystają z niego Microsoft AI, Cognition (dla SWE-1.7), Prime Intellect i H Company; H Company oszczędza do 20 % czasu na każdym kroku treningu. 🔗 źródło
- Rzadka atencja — W przewodniku z 17 listopada NVIDIA podaje osiem zasad projektowania rzadkiej atencji trenowanej na jej GPU; indekser wybierający tokeny oraz Top-k odpowiadają za 47 % czasu warstwy prefill w DeepSeek V3.2 przy 128K tokenów. 🔗 źródło
GitHub
- GitHub Enterprise Server 3.23 w wersji release candidate — Wykrywanie sekretów za pomocą AI, dostępne w publicznej wersji wstępnej, działa na procesorze urządzenia, bez GPU, hostowanego LLM ani połączenia wychodzącego, także w środowisku odizolowanym (air-gapped); wersja rozszerza też wykrywanie znanych złośliwych pakietów na siedem ekosystemów poza npm. 🔗 źródło
- Poza AI — GitHub wyraźniej pokazuje stan scalenia na nowej stronie Overview pull requestów, GitHub Desktop 3.7.0 obsługuje wiele kont na tym samym hoście, a panel wyświetla do 25 ulubionych repozytoriów. 🔗 Overview · 🔗 Desktop · 🔗 ulubione
Biznes i eseje
- Hebbia — W testach badań finansowych z sierpnia i września wstępna wersja GPT-6 Astra cytuje 99,5 % trafnych fragmentów i spełnia 97,9 % wymagań dotyczących prezentacji, o 14,4 punktu więcej niż najlepsza przetestowana alternatywa, której studium przypadku opublikowane przez OpenAI nie wymienia z nazwy. 🔗 źródło
- Cichy konsensus — OpenAI publikuje w sekcji Era inteligencji (Intelligence Age) esej Deana Balla, będący adaptacją wykładu na Harvardzie i przedstawiony jako odzwierciedlający poglądy autora, polemizujący z przekonaniem, że rezygnacja z prymatu człowieka jest nieunikniona; autor opowiada się za agentami przypisanymi do konkretnych osób, z ograniczonymi i odwoływalnymi uprawnieniami. 🔗 źródło
- Wzbogacanie danych — Przewodnik Perplexity opisuje w sześciu krokach, jak uzupełniać i weryfikować rekordy CRM za pomocą modelu połączonego z internetem; Apollo przeprowadza w tym procesie 5,6 miliona operacji wzbogacania miesięcznie przez API Perplexity. 🔗 źródło
Co to oznacza
Debiut giełdowy Anthropic łączy w jednej transakcji pieniądze z rynków finansowych i przemysłu. Oferta publiczna przynosi firmie około 91,6 miliarda dolarów brutto, a emisja prywatna kolejne 26 miliardów, przy czym akcje obejmuje po tej samej cenie 83 dolarów siedem grup z branży półprzewodników i informatyki: AMD, Broadcom, Google, Micron, Microsoft, NVIDIA i TSMC Partners. Łącznie wartość operacji zbliża się do 119,5 miliarda dolarów brutto: obok inwestorów uczestniczących w ofercie siedem grup przemysłowych kupuje akcje laboratorium IA notowanego już na Nasdaq.
Bezpieczeństwo coraz częściej zapewniają mechanizmy wbudowane w same narzędzia. OpenAI wiąże rozumowanie GPT-6.2 z historią, w której ono powstało, co zmniejsza zmierzony poziom ekstrakcji z 54,0 % do 0,2 %, ale wymaga od deweloperów, by nie modyfikowali już treści swoich rozmów. Vibe CLI odbiera agentom możliwość samodzielnego wyłączania potwierdzeń, Claude Code pokazuje, skąd pochodzą hooks danego katalogu, zanim użytkownik uzna go za zaufany, a Decider ocenia strony, zanim agent je przeczyta. Sakana AI tworzy z kolei zespół zajmujący się wspólną obroną, obiecując, że nie będzie publikować materiałów umożliwiających wykorzystywanie luk.
Agenci wychodzą poza pisanie kodu i wkraczają w proces dostarczania oprogramowania. W Runway odpowiadają za 38 % październikowych scaleń, a IA samodzielnie zatwierdza zmiany o niskim ryzyku; Stitch Loop monitoruje działający produkt internetowy i otwiera pull requests, aby osiągnąć cel mierzony konkretnym wskaźnikiem. W obu przypadkach człowiek zachowuje kontrolę nad tym, co najważniejsze: obszarami wrażliwymi w Runway i każdym scaleniem w Stitch Loop. Narzędzia dotrzymują kroku: Agents SDK Python pozwala używać Codex jako dostawcy modelu, a Cognition ocenia modele pod kątem pytania, które stawiają te procesy, czyli tego, czy należy scalić PR.
W przypadku modeli otwartych wysiłki koncentrują się na tym, co można uzyskać dzięki mniejszym wagom. Inkling 2 Mini trzykrotnie przechodzi przez swoje środkowe warstwy, by dorównać Qwen3.8-27B w AA Index, mieszcząc się w 20 Go, superadapter Hugging Face mieści trzy specjalizacje w jednym LoRA, a Metric AI wykorzystuje Qwen3.5 jako podstawę do budowy modeli dla języka ormiańskiego. Dane liczbowe nadal pochodzą od twórców, a MedChemBench przypomina o ograniczeniach takiej oceny: OpenAI ocenia w nim wyłącznie własne modele i nie wyklucza, że mogły one zetknąć się z publikacjami źródłowymi.
Źródła
- Zamknięcie oferty publicznej (Anthropic)
- @AnthropicAI na X: współzałożyciele
- Inkling 2 Mini (Thinking Machines)
- Wpis Hugging Face o Inkling 2 Mini
- Inkling-2-Mini (Hugging Face)
- Tencent Hy4 w Together AI
- Komunikat Tencent o Hy4
- Wykorzystywanie adapterów na dużą skalę (Hugging Face)
- @yb2698 na X: superadapter
- Ayb 0.5 (Metric AI)
- OhanTTS (Metric AI)
- OhanASR (Metric AI)
- @pcuenq na X: Depth Pro 2
- Artykuł arXiv 2611.26603: Depth Pro 2
- DepthPro2-L (Hugging Face)
- Przeciwdziałanie wrogiej destylacji (OpenAI)
- @OpenAI na X: wroga destylacja
- @hardmaru na X: Security Research Group
- Security Research Group (Sakana AI)
- Budowa fabryki oprogramowania (Runway)
- Stitch Loop (Google)
- Informacje o wydaniach ChatGPT
- @GeminiApp na X: dostępność GIF-ów
- @GeminiApp na X: GIF-y w Gemini
- @perplexity_ai na X: Computer w Chromium
- openai-agents-python v1.0.0-alpha.1
- @perplexitydevs na X: Decider w Context API
- Ocenianie stron według kryteriów (dokumentacja Perplexity)
- Cookbook ochrony przed wstrzykiwaniem instrukcji (dokumentacja Perplexity)
- Claude Code v2.1.329
- Codex CLI 0.171.0
- Vibe CLI v3.1.4
- Gemini 4 Neon w Devin (Cognition)
- @cognition na X: Gemini 4 Neon
- Przedstawiamy MedChemBench (OpenAI)
- Pełny artykuł o MedChemBench (PDF)
- Warianty i lokalizacja reklam wideo w Ads Engine (ElevenLabs)
- Copilot CLI 1.0.115-2
- Codex CLI 0.173.0-alpha.2
- Gemini CLI, PR 30389
- Changelog Antigravity
- Qwen Code v0.28.1-preview.1
- Kimi Code 2.7.2
- CLI mistral 0.20.1
- Changelog Replit z 20 listopada
- @cognition na X: Devin Bot dla Manim
- Informacje o wydaniach API Gemini
- Świadomość czasu i asynchroniczne dane wejściowe dla osobistych agentów (OpenAI)
- @OpenAIDevs na X: historia i rozumowanie GPT-6.2
- @AskPerplexity na X: teammates z Computer
- @AskPerplexity na X: aplikacja na komputery Mac
- @pika_labs na X: Seedance 2.5 Flash
- @HeyGen na X: ślepe testy Avatar 6
- Qwen3 TTS w Together AI
- Together Storage Accelerator (Together AI)
- @julien_c na X: CDN Hugging Face
- Superfluid we flocie (basecompute)
- WavLate (Hugging Face)
- @NVIDIAAI na X: WorldTrace
- Dynamo i rollouts w RL (NVIDIA)
- Mechanizm rzadkiej uwagi na GPU NVIDIA (NVIDIA)
- GitHub Enterprise Server 3.23 release candidate (changelog GitHub)
- Strona Overview dla pull requests (changelog GitHub)
- GitHub Desktop i wiele kont na jednym hoście (changelog GitHub)
- Ulubione repozytoria na panelu głównym (changelog GitHub)
- Hebbia i GPT-6 Astra (OpenAI)
- Cichy konsensus (OpenAI)
- Wzbogacanie danych za pomocą AI (Perplexity)