ai-powered-markdown-translatorتُرجم المقال من الفرنسية إلى العربية باستخدام gpt-6.1-sol.
تُكمل Anthropic طرحها العام الأولي: نحو 93,5 مليار دولار من إجمالي عائدات الطرح، و26 مليارًا إضافية دفعتها سبع مجموعات، منها NVIDIA وGoogle وMicrosoft، في طرح خاص أُجري بالتوازي. وتُصدر Thinking Machines نموذج Inkling 2 Mini بأوزان مفتوحة و26,4 مليار معامل، يشغل 20 Go، فيما تُخفض OpenAI معدل نجاح الهجمات التي تستخرج الاستدلال المحمي لنماذجها من 54,0 % إلى 0,2 %. ويصبح ChatGPT Space متاحًا لمشتركي Plus، وتُسند Runway إلى الوكلاء 38 % من عمليات دمج الشيفرة لديها، ويُصدر كل من Claude Code وCodex CLI وVibe CLI نسخة جديدة.
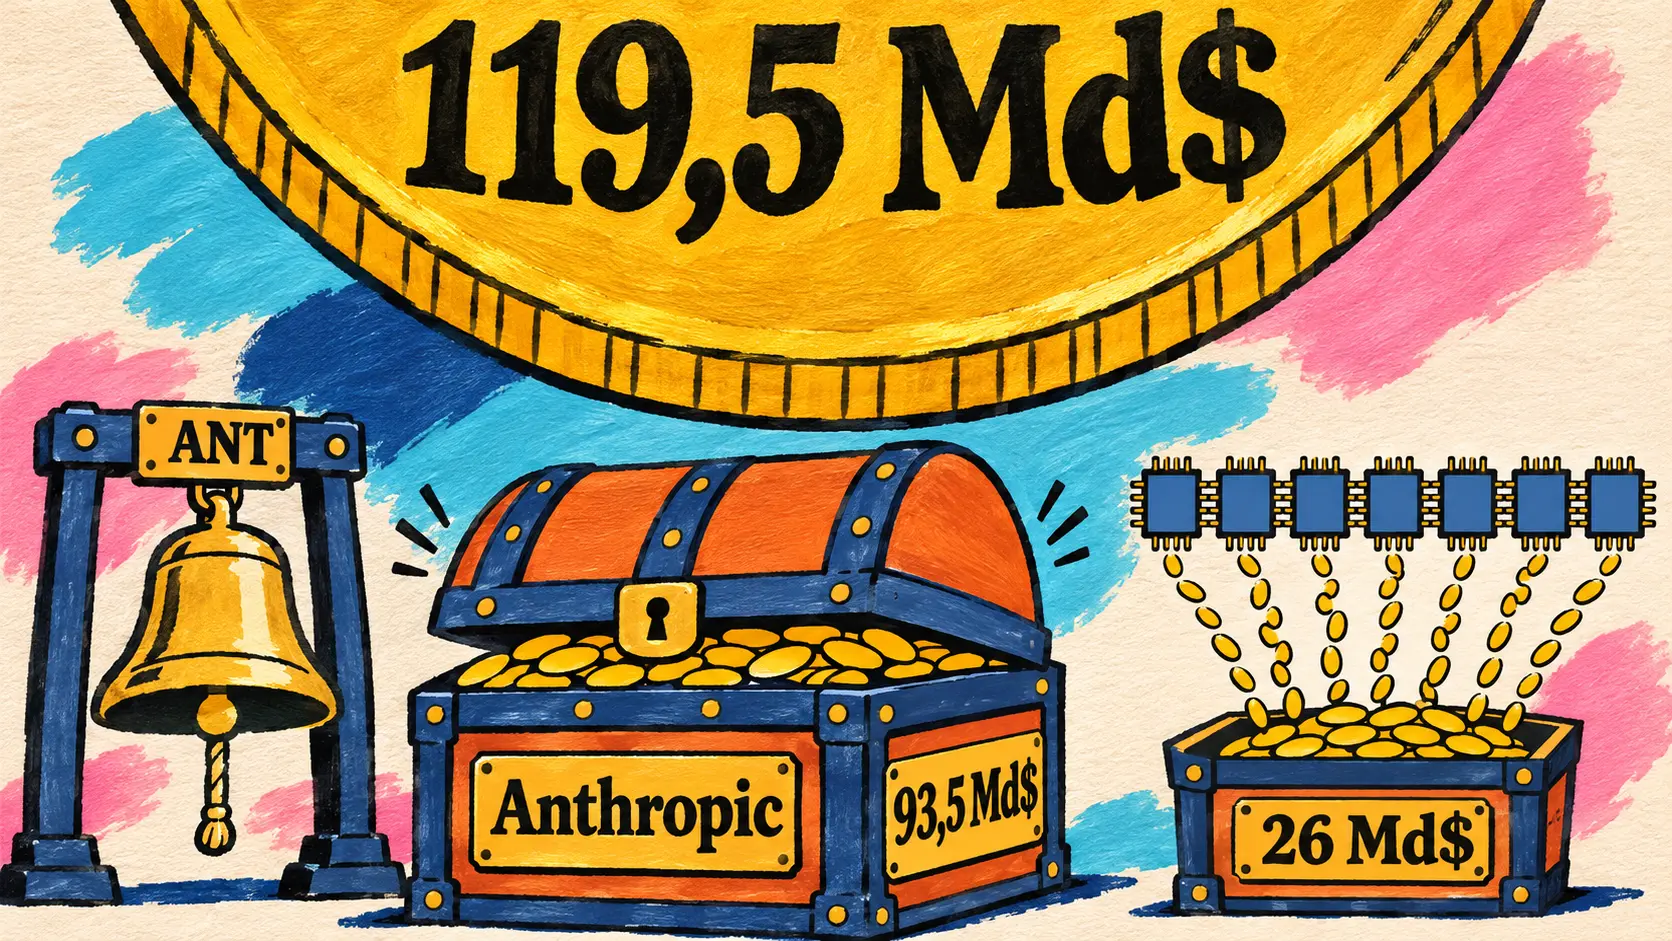
التمويل: Anthropic تُكمل طرحها العام الأولي بإجمالي عائدات 93,5 مليار دولار وطرح خاص بقيمة 26 مليارًا
20 نوفمبر — غداة بدء تداول أسهمها، تُعلن Anthropic إتمام طرحها العام الأولي، الذي حُدد سعره في 18 نوفمبر عند 83 دولارًا للسهم. وقد مارست البنوك كامل خيارها لشراء 147 مليون سهم إضافي: ليبلغ إجمالي ما بيع 1 127 000 000 سهم من الفئة A. وتصل العائدات الإجمالية إلى نحو 93,5 مليار دولار قبل العمولات والمصاريف، منها نحو 91,6 مليارًا لصالح Anthropic، التي لا تحصل على أي عائد من الأسهم البالغ عددها 23 648 646 سهمًا التي باعها مساهمون حاليون.
ويكشف المنشور أيضًا عن طرح خاص أُجري بالتوازي واكتمل بدوره، ولم يرد ذكره في إعلان سعر الطرح: 313 253 007 أسهم من الفئة N، بيعت بالسعر نفسه البالغ 83 دولارًا لسبع مجموعات تعمل في أشباه الموصلات والحوسبة (AMD وBroadcom وGoogle وMicron وMicrosoft وNVIDIA وTSMC Partners)، بقيمة تقارب 26,0 مليار دولار. وهذه الأسهم غير مسجلة بموجب قانون الأوراق المالية لعام 1933. وبجمع الطرح العام وهذا الطرح الخاص، يقترب المبلغ الإجمالي من 119,5 مليار دولار، قبل العمولات والمصاريف.
| عنصر العملية | القيمة التي أعلنتها Anthropic |
|---|---|
| الأسهم المبيعة من الفئة A | 1 127 000 000، منها 147 000 000 بموجب خيار البنوك |
| منها ما باعته Anthropic | 1 103 351 354 |
| منها ما باعه مساهمون حاليون | 23 648 646 |
| سعر السهم | 83 دولارًا |
| إجمالي عائدات الطرح | نحو 93,5 مليار دولار |
| حصة Anthropic | نحو 91,6 مليار دولار |
| الطرح الخاص (الفئة N) | 313 253 007 أسهم، بنحو 26,0 مليار دولار |
| إجمالي الطرح العام والخاص | نحو 119,5 مليار دولار |
| الإدراج | منذ 19 نوفمبر، في Nasdaq Global Select Market، بالرمز ANT |
يؤكد المنشور الإدراج، من دون ذكر سعر التداول أو القيمة السوقية. وقد قادت Goldman Sachs وMorgan Stanley العملية، بمشاركة تحالف يضم نحو عشرين بنكًا، منها J.P. Morgan وCitigroup وBNP Paribas وCrédit Agricole CIB وSociété Générale. وفي اليوم نفسه، نشر @AnthropicAI مقطع فيديو يروي فيه المؤسسون السبعة المشاركون، داريو أمودي ودانييلا أمودي وتوم براون وجاك كلارك وجاريد كابلان وسام ماكاندليش وكريس أولاه، قصة الشركة.
🔗 إتمام الطرح العام الأولي (Anthropic) · @AnthropicAI على X: المؤسسون المشاركون
النماذج المفتوحة: Inkling 2 Mini من Thinking Machines، وTencent Hy4، ومهايئ فائق لـ Qwen3.8-27B، وAyb 0.5 وDepth Pro 2
20 نوفمبر — تُصدر Thinking Machines Lab نموذج Inkling 2 Mini، الشقيق الأصغر لـ Inkling 2 Small (ذو 594 مليار معامل، الذي تناولناه هنا في 12 نوفمبر). ويعتمد هذا النموذج ذو الأوزان المفتوحة، المتاح بترخيص Apache 2.0، على مزيج من الخبراء (Mixture-of-Experts) ويضم 26,4 مليار معامل، منها 3,4 مليار نشطة لكل رمز. ويقرأ النصوص والصور، مع نافذة سياق تبلغ مليون رمز. وتُوزع أوزانه بالدقة المستخدمة في التدريب، وهي NVFP4 لعشرين طبقة وMXFP8 للطبقات الأربع الأخيرة، أي نحو 20 Go من دون فقدان بسبب التحويل: ويعمل باستخدام Ollama على أي جهاز Mac بذاكرة لا تقل عن 32 Go.
Today we are releasing Inkling 2 Mini, a fast, powerful model that’s small enough to run on your laptop.
🇸🇦 نُصدر اليوم Inkling 2 Mini، وهو نموذج سريع وقوي وصغير بما يكفي ليعمل على حاسوبك المحمول. — Thinking Machines Lab، إعلان Inkling 2 Mini
وتكمن خصوصيته في بنيته: فهو محوّل حلقي (looped transformer). فمن بين طبقاته البالغ عددها 24، تُجتاز الطبقات الـ 12 الوسطى ثلاث مرات، أي 48 مرورًا عبر الطبقات لكل رمز مقابل 24 طبقة مخزنة، ما ينتج عنه 5,4 مليار تفعيل للأوزان لكل رمز. وخلال التدريب، قلّص المختبر أيضًا عدد الخبراء بمقدار الثلثين (من 384 إلى 128)، ثم أصلح النموذج باستخدام 1 000 مليار رمز مقطّر من نموذج Inkling داخلي أكبر. ووفقًا للمختبر، عند تساوي الخسارة، يتطلب نموذج بلا حلقات حوسبة أقل بنسبة 7,5 % للتدريب، لكنه يتطلب حوسبة أكثر بنسبة 140 % للاستدلال.
| الاختبار المعياري (جدول Thinking Machines) | Inkling 2 Mini | Qwen3.8-27B | Nemotron 3.5 Super VL |
|---|---|---|---|
| تفعيلات الأوزان لكل رمز / إجمالي المعاملات | 5,4B / 26,4B | 27,0B / 27,0B | 12,0B / 124,5B |
| AA Index v5.0 | 20,1 | 20,1 | 13,6 |
| DeepSWE v1.1 | 48,2 % | 42,2 % | 24,7 % |
| SWE-bench Pro v2 Hard | 77,9 % | 73,8 % | 44,1 % |
| Terminal-Bench 2.1 (pi) | 71,6 % | 73,0 % | 60,7 % |
| BrowseComp | 79,0 % | 61,6 % | 78,9 % |
| MCP Atlas | 82,7 % | 77,3 % | 67,7 % |
بحسب Thinking Machines، يتصدر النموذج النماذج المفتوحة التي يقل حجمها عن 100 مليار معامل في DeepSWE v1.1 وفي Vals Index v2.2 (46,5 %). ويظل خلف Qwen3.8-27B في Terminal-Bench 2.1، وتقر Thinking Machines بأنه ليس أفضل نموذج صغير في المحادثات متعددة الجولات (50,0 % في MultiChallenge)، ولا في التعليمات ذات القيود المتعددة (33,4 % في ComplexConstraints v1.1)؛ ويوضح شرح الرسم البياني أن إعدادات التقييم تختلف من نموذج إلى آخر. وقد قاس باحثون من ستانفورد، حصلوا على وصول مبكر، معدل ذكاء لكل جول بلغ 0,703 على DGX Spark، مقابل 0,430 لـ Qwen3.6-35B-A3B.
ويستخدمه المختبر أيضًا موضوعًا للبحث في مراقبة سلسلة التفكير (chain of thought): فالنموذج الحلقي يُجري حسابات أكثر من دون كتابتها، ما قد يفلت من أداة المراقبة. وفي نسخة ذات عدد متغير من المرورات، نُشرت بدورها، يرتفع زمن العمل البشري المكافئ للمهمة المحلولة من دون استدلال مكتوب من 16 إلى 37 ثانية عند الانتقال من مرور واحد إلى ثلاثة. وعند خمسة مرورات، يصبح الاستدلال أقصر بمقدار النصف (1 661 مقابل 3 703 رموز في المتوسط على GPQA Diamond) مع الحفاظ على الوضوح نفسه؛ ولا ترصد Thinking Machines زيادة في التخريب الذي ينفذه الوكلاء مع زيادة عدد الحلقات. والنموذج متاح على Tinker وOllama وSGLang وvLLM وllama.cpp وMLX وTransformers، مع نسخ GGUF لدى Unsloth.
🔗 Inkling 2 Mini (Thinking Machines) · منشور Hugging Face · الأوزان على Hugging Face
Together AI تُتيح Tencent Hy4، وهو مزيج من الخبراء يضم 770 مليار معامل، بسعر 0,83 دولار لكل مليون رمز إدخال
19 نوفمبر — تضيف Together AI نموذج Tencent Hy4 إلى خدمات الاستدلال من دون خوادم لديها، مع سياق يبلغ مليون رمز، واستدعاء الأدوات، وإخراج بصيغة JSON. وبحسب مزود الاستضافة، فإن نموذج Tencent الرائد هو مزيج من الخبراء يضم 770 مليار معامل، منها 49 مليارًا نشطة لكل رمز؛ ويخلف Hy4 Preview، ويضيف استخدام الحاسوب، ويصبح أول نموذج في عائلة Hy يقرأ الصور.
| السعر لكل مليون رمز | Together AI | Tencent (بيان 4 نوفمبر) |
|---|---|---|
| الإدخال | 0,83 دولار | نحو 0,90 دولار |
| الإدخال المخزن مؤقتًا | 0,042 دولار | نحو 0,045 دولار |
| الإخراج | 2,50 دولار | نحو 2,70 دولار |
كانت Tencent قد أطلقت Hy4 في 4 نوفمبر، وقدّمته بوصفه من بين أفضل النماذج مفتوحة المصدر، ووعدت بإتاحة أوزانه خلال بضعة أيام؛ ومستودع tencent/Hy4 موجود على Hugging Face بترخيص من النوع «other». وذكر بيانها تقييمًا أعمى في المجال المالي (213 متخصصًا، و579 مهمة)، حصل فيه Hy4 على 3,04، متقدمًا على DeepSeek-V4.1-Flash-1017 (2,97)، ومعدل هلوسة داخليًا انخفض من 12,95 % إلى 7,2 %.
🔗 Tencent Hy4 على Together AI · بيان Tencent الصادر في 4 نوفمبر
Hugging Face تنشر طريقة إعداد مهايئات بيئة تشغيل الوكيل ومهايئًا فائقًا واحدًا لـ Qwen3.8-27B
20 نوفمبر — بعد ثلاثة أيام من الإصدارات، من بينها مهايئ Hermes الذي تناولناه هنا أمس، تنشر Hugging Face الطريقة الكاملة لإعداد مهايئات بيئة تشغيل الوكيل: وهي مهايئات LoRA دُربت بالتعلم المعزز داخل بيئة تشغيل وكيل (pi أو Hermes Agent أو OpenCode)، فوق Qwen3.8-27B. والجديد هو مهايئ فائق: إذ تُوصل مهايئات LoRA الثلاثة ذات الرتبة 32 لتكوين مهايئ LoRA واحد برتبة 96، يعمل في بيئات التشغيل الثلاث. ولأن تحديثاتها شبه متعامدة (جيب تمام بين 0,01 و0,02)، فإن هذا التجميع يطبّق التحديثات الثلاثة بدقة.
| SWE-bench Pro (51 مهمة صعبة)، مع التفكير | النموذج الأساسي | مع المهايئ الفائق |
|---|---|---|
| بيئة تشغيل Hermes Agent | 45 % | 61 % |
| بيئة تشغيل OpenCode | 47 % | 67 % |
| بيئة تشغيل pi | 74 % | 74 % |
مع التفكير، يرتفع متوسط الأزواج الستة من بيئات التشغيل والاختبارات المعيارية من 55,5 إلى 63,5 %، مع انخفاض استدعاءات الأدوات بنسبة تتراوح بين 19 و48 %، وفقًا لسلسلة منشورات الفريق؛ ومن دون التفكير، يكسب المهايئ الفائق من 6 إلى 18 نقطة في SWE-bench Pro، مع انخفاض استدعاءات الأدوات بنسبة تتراوح بين 53 و73 %، وفقًا للمنشور. ولا يمكن مقارنة النتائج بين بيئات التشغيل المختلفة، لاختلاف إعداداتها الافتراضية. وقد تطلب التدريب 598 خطوة و167 مليون رمز؛ وفحص حاجز safeagents عددًا بلغ 1,3 مليون استدعاء للأدوات وحظر 647 منها. وقد نُشرت المهام والمهايئات ونسخ GGUF ومسارات التقييم.
🔗 مهايئات بيئة التشغيل على نطاق واسع (Hugging Face) · @yb2698 على X
Metric AI تُصدر Ayb 0.5 وOhanTTS وOhanASR، وهي نماذج مفتوحة للنصوص والصوت باللغة الأرمنية
20 نوفمبر — يُصدر الفريق الأرمني Metric AI في اليوم نفسه ثلاث عائلات من النماذج للغته. ويضم Ayb 0.5 ثلاثة نماذج لغوية (0,8B و4B و9B) مبنية على Qwen3.5 ومكيّفة للأرمنية، بدءًا من توسيع مُجزّئ الرموز وصولًا إلى ما بعد التدريب؛ ويدعم Ayb-9B الحوار متعدد الجولات واستدعاء الأدوات والصور. ويولّد OhanTTS-v0.1 الكلام بثماني لغات، منها الأرمنية والفرنسية، ويستنسخ صوتًا انطلاقًا من تسجيل يتراوح طوله بين 3 و10 ثوانٍ. أما OhanASR-v0.1، وهو نموذج للتعرف على الكلام بحجم 2B، فقد خضع لضبط دقيق على 820 ساعة من الكلام بالأرمنية.
| نموذج Metric AI | النتيجة التي نشرها المؤلفون |
|---|---|
| Ayb-9B | المرتبة 3 في الترتيب العام لـ ArmBench (0,6164) |
| OhanTTS-v0.1، 61 ساعة من الأرمنية | WER بنسبة 14,70 %، وأول صوت خلال 331 ms على GB10 |
| OhanASR-v0.1 | WER بنسبة 16,12 % (المرتبة 2) وCER بنسبة 3,49 % (المرتبة 1) في ArmBench-ASR |
تخضع أوزان Ayb-9B لترخيص غير تجاري (CC BY-NC 4.0)، ويمكن الوصول إليها بعد موافقة يدوية.
🔗 Ayb 0.5 (Metric AI) · OhanTTS · OhanASR
Apple تُصدر Depth Pro 2، الذي يقدّر العمق بالأمتار في الصور ومقاطع الفيديو
19 نوفمبر — تُصدر Apple نموذج Depth Pro 2، وهو عائلة من النماذج التي تقدّر العمق بالأمتار في الصور ومقاطع الفيديو، بدقتها الأصلية. وبحسب ملخص الورقة، كانت الأساليب الحالية تضطر إلى الاختيار بين الاتساق من إطار إلى آخر وحدّة الحواف؛ ويستهدف Depth Pro 2 تحقيق الأمرين بشبكة واحدة. وتتوفر الأوزان على Hugging Face بأربعة أحجام (S وB وL وH)، مع نسخة Core ML ومُقدِّر مشترك للبعد البؤري، يفيد عند غياب بيانات البعد البؤري في EXIF.
| الدقة التي يعالجها DepthPro2-L (334M، على B200) | الإطارات في الثانية |
|---|---|
| VGA | 150,1 |
| 720p | 33,7 |
| 1080p | 9,1 |
| 4K | 0,7 |
الأوزان مخصصة للأبحاث غير التجارية (بترخيص Apple Machine Learning Research Model)، والشيفرة متاحة على GitHub. وقد أشار بيدرو كوينكا من Hugging Face إلى الإصدار في 20 نوفمبر، مع عرض توضيحي على الإنترنت.
🔗 @pcuenq على X · ورقة arXiv 2611.26603 · DepthPro2-L (Hugging Face)
أمان النماذج: OpenAI تتصدى للتقطير العدائي، وSakana AI تُنشئ مجموعة أبحاث الأمن
OpenAI تفصّل جهودها لمكافحة التقطير العدائي وتخفض استخراج الاستدلال المحمي من 54,0 % إلى 0,2 %
20 نوفمبر — تنشر OpenAI مقالًا عن التقطير العدائي (adversarial distillation): وهو الاستخدام غير المصرّح به لمخرجات نموذج متقدم لتدريب نموذج آخر يُنشر من دون ضوابط الحماية نفسها، مثل استخدامه في هجمات كان النموذج الأصلي سيرفضها. ويركّز المقال أولًا على الاستدلال المحمي، أي سلسلة التفكير التي تُنتَج قبل الإجابة: فبحسب دراسة داخلية، يحقق النموذج المتدرّب عادةً تقدمًا أكبر عند استخدام آثار الاستدلال الدقيقة مقارنةً بملخصاتها.
| الهجوم المقاس (تقييم تكيّفي، ستة نماذج مهاجمة) | GPT-6 Astra، ضوابط الحماية الأصلية | GPT-6.2 Astra، ضوابط الحماية المحدّثة |
|---|---|---|
| استدلال طلب سابق | 54,0 % | 0,2 % |
| استدلال الطلب الحالي | 22,9 % | 0,9 % |
يجمع الدفاع بين التدريب العدائي، ومصنّفات المدخلات والمخرجات (بما فيها معاملات استدعاءات الأدوات)، وضوابط API، والتحقيقات، مع فرض عقوبات أسبوعية على حملات تضم بضعة آلاف إلى بضع عشرات الآلاف من الحسابات. ومع GPT-6.2 Astra وSol، يرتبط الاستدلال المحمي بسجل المحادثة الذي أنتجه: فتستبعده API إذا أُعيدت كتابة رسالة سابقة، ولا تعود عائلات النماذج الأقدم قادرة على قراءته. وتذكّر OpenAI بأنها أبلغت الكونغرس في فبراير بنشاط يشير إلى أن DeepSeek تحاول تقطير نماذج أمريكية، ثم نسبت في سبتمبر حملةً إلى أفراد مرتبطين بـ Moonshot AI؛ وتقول إنها تدعم قانون أمن الرقائق، وقانون AI OVERWATCH، وقانون MATCH.
🔗 مكافحة التقطير العدائي (OpenAI) · @OpenAI على X
Sakana AI تؤسس مجموعة أبحاث الأمن، وهي فريق مستقل للدفاع السيبراني الجماعي
20 نوفمبر — تطلق Sakana AI مجموعة أبحاث الأمن، وهي فريق مستقل للبحث والتطوير مقره طوكيو، منفصل عن نشاطها التجاري وموجّه لخدمة المصلحة العامة.
Excited to announce the Sakana AI Security Research Group, an independent, public-interest R&D team in Tokyo co-led by Akihiro Umegai and me.
🇸🇦 يسرّني الإعلان عن مجموعة أبحاث الأمن في Sakana AI، وهي فريق مستقل للبحث والتطوير يخدم المصلحة العامة في طوكيو، أتولى قيادته بالاشتراك مع أكيهيرو أوميغاي. — @hardmaru على X
ديفيد ها هو المؤسس المشارك والرئيس التنفيذي لشركة Sakana AI. وسيعمل الفريق على ثلاثة محاور: الوقاية منذ مرحلة التصميم، والدفاع الجماعي عبر وكلاء موزّعين بين المؤسسات، وتأمين الوكلاء المدافعين أنفسهم، بحيث تقتصر صلاحياتهم على مهامهم وتُسجَّل إجراءاتهم. وينطلق الفريق من أعمال طوّرتها الشركة مثل Digital Red Queen وShinkaEvolve وFugu-Cyber، الذي تعلن Sakana AI تحقيقه 86,9 % على CyberGym و72,1 % على CTI-REALM؛ وتوضح ملاحظة في المقال أن صفحة Fugu-Cyber لا تقدّم درجات مرجعية ولا بروتوكول تقييم. وسينشر الفريق أوراقًا بيضاء واختبارات معيارية وأدلة دفاعية، لكنه لن ينشر مواد للاستغلال، وستُعالَج الثغرات المكتشفة عبر الإفصاح المنسّق. وتذكّر Sakana AI بأن طلبات CVE زادت بنسبة 263 % بين 2020 و2025، وفقًا لـ NIST.
🔗 مجموعة أبحاث الأمن (Sakana AI)
وكلاء مرتبطون بتسليم البرمجيات: مصنع Runway وStitch Loop من Google Labs
Runway تسند سلسلة تسليم برمجياتها إلى وكلاء تولّوا إدارة 38 % من عمليات الدمج في أكتوبر
20 نوفمبر — تنشر Runway على مدونتها الهندسية حصيلةً بالأرقام عن «مصنع البرمجيات» (software factory) الخاص بها: سبع مراحل، من كتابة الشيفرة إلى تنسيق عمليات الدمج، أُسندت إلى الوكلاء واحدةً تلو الأخرى. وقد تولّى الوكلاء السحابيون إدارة 38 % من طلبات السحب المدمجة في أكتوبر، ومن أصل 100 من طلبات PR هذه دُمجت في النصف الأول من نوفمبر، لم يتضمن 78 منها أي commit بشري.
| مؤشر مصنع البرمجيات | نقطة البداية | أحدث قياس |
|---|---|---|
| عمليات الدمج التي يديرها وكلاء سحابيون | 0,1 % (يونيو) | 38 % (أكتوبر) |
| وسيط مدة انتظار الموافقة الأولى | 2,3 h (سبتمبر) | نحو 5 min (منتصف نوفمبر) |
| متوسط عمليات الدمج الأسبوعية | 929 (سبتمبر) | 2 235 (منذ منتصف أكتوبر) |
منذ منتصف أكتوبر، يوافق الذكاء الاصطناعي وحده على طلبات PR المصنّفة منخفضة المخاطر، وعلى المتوسطة المخاطر إذا سمح المستودع بذلك؛ أما العالية المخاطر فيتولاها شخص، ويظل مالكو الشيفرة مسؤولين عن اعتماد عمليات ترحيل البيانات، وإعدادات CI والنشر، والأسرار، والمصادقة. وفي سبتمبر وأكتوبر، اعترض شخص على 15 من أصل 977 طلب PR وافق عليها الذكاء الاصطناعي، وتبلغ نسبة التراجع عن عمليات الدمج التي وافق عليها الذكاء الاصطناعي وحده 0,10 %، مقابل نحو 1 من كل 200 للموافقات البشرية. ويختبر وكلاء أيضًا App Studio كما يفعل المستخدم (86 خطأً مؤكّدًا خلال أربعة أيام)، ووزّع منسّق أكثر من 14 000 مهمة خلال أسبوعين. وهذه أدوات داخلية، ولا يوجد منتج أو تسعير.
🔗 بناء مصنع للبرمجيات (Runway)
Google Labs تطلق Stitch Loop، وكيلًا للمنتج يحسّن تطبيقًا منشورًا باستمرار
18 نوفمبر — تقدّم Google Labs وكيل Stitch Loop، وهو وكيل للمنتج يعمل لفترات طويلة ويواصل العمل من حيث يتوقف وكيل البرمجة: بعد النشر في بيئة الإنتاج. ويتصل بمستودع GitHub وببيانات المنتج المنشور (السجلات، وسلوك المستخدمين، والملاحظات) عبر أكثر من 180 تكاملًا، أو خوادم MCP مخصصة، أو عمليات إرسال من CLI محلية، ويعمل باستمرار نحو أهداف قابلة للقياس.
تقترح كل دورة مسارات تستند إلى البيانات، وتفصّل الحلول والمفاضلات بينها، وتكتب الشيفرة في بيئة سحابية معزولة، وتفتح طلب سحب للموافقة عليه، ثم تراقب المقاييس المباشرة. وتُوفَّر ثلاث دورات جاهزة (الأمن السيبراني، وزمن الاستجابة، وإمكانية الوصول)؛ وتجمع دورة الأمن بين Gemini 4 Carbon وCodeMender، وكيل أمن الشيفرة من Google DeepMind. ولا يُدمج أي شيء من دون مراجعة الفريق. ويعمل Stitch Loop أيضًا مصدرًا لسياق المنتج لوكلاء البرمجة مثل Google Antigravity، عبر CLI الخاصة بـ Stitch وMCP، ويُستخدم داخل Slack. والمتاح حاليًا هو التسجيل في قائمة انتظار في جميع أنحاء العالم، مع أولوية الوصول لمشتركي Google AI Ultra المؤهّلين.
مساعدون لعامة المستخدمين: ChatGPT Space لمشتركي Plus، وصور GIF في تطبيق Gemini، وPerplexity Computer في متصفحات Chromium
ChatGPT Space يصبح متاحًا لمشتركي Plus في جميع أنحاء العالم
20 نوفمبر — يبدأ طرح ChatGPT Space، الذي قُدّم في DevDay يوم 29 سبتمبر وكان مقتصرًا حتى الآن على خطط Pro وBusiness وEnterprise، لمشتركي Plus البالغين 18 عامًا فأكثر في جميع أنحاء العالم. ويحل Space محل المكتبة في الشريط الجانبي (الصفحات، والشرائح، والصور، والملفات المرفوعة)، على الويب وتطبيق سطح المكتب وiOS وAndroid.
يمكن إنشاء صفحات تفاعلية وعروض تقديمية فيه باستخدام ChatGPT، ويمكن لأشخاص آخرين لديهم وصول إلى Space إثراؤها. ويمكن للصفحات والشرائح أن تتحدّث تلقائيًا من التطبيقات المتصلة: وتذكر OpenAI مثال قائمة مهام تتحدّث تلقائيًا، أو خطة مشروع تتابع القرارات المتخذة في Slack. وتكفي الإشارة إلى ChatGPT في تعليق لطلب تعديل، ويمكن دعوة dot للتعاون. وتظل المشاركة مقيّدة: إذ تتطلب إذن قراءة وحساب Plus أو Pro أو Business أو Enterprise لديه وصول إلى Space؛ ولا تستطيع حسابات Free فتح المحتويات المشتركة، ولا يوجد رابط عام.
تطبيق Gemini ينشئ صور GIF متحركة باستخدام Gemini Omni 1.2 Flash، مجانًا في فرنسا
20 نوفمبر — أصبح تطبيق Gemini ينشئ صور GIF متحركة (تأثيرات صور متكررة، وصور ساخرة) باستخدام Gemini Omni 1.2 Flash، نموذج الفيديو الذي أطلقته Google في 5 نوفمبر، لتوفير حركة سلسة وجودة ثابتة من إطار إلى آخر، وفقًا لـ Google. ويمكن كتابة الطلب في المحادثة الرئيسية، أو فتح أداة الصور أو الفيديو، ثم اختيار تنسيق GIF من محدّد التنسيق.
GIFs are now available to all Google AI subscribers and free of charge in the U.S., Japan, Korea, Australia, Canada, U.K., Germany, and France.
🇸🇦 أصبحت صور GIF متاحة الآن لجميع مشتركي Google AI، ومجانًا في الولايات المتحدة واليابان وكوريا وأستراليا وكندا والمملكة المتحدة وألمانيا وفرنسا. — @GeminiApp على X
وبذلك يستطيع المستخدمون في فرنسا الذين لا يملكون اشتراكًا الوصول إليها. وتحذو Google حذو OpenAI، التي تناولنا هنا في 5 نوفمبر صور GIF المتحركة لديها في ChatGPT باستخدام Images 2.6.
🔗 @GeminiApp على X: صور GIF في Gemini
Perplexity Computer يعمل مباشرةً في متصفحات Chromium بفضل إضافة Perplexity
20 نوفمبر — أصبح Perplexity Computer يعمل مباشرةً في المتصفحات المبنية على Chromium، بفضل إضافة Perplexity. ويمكن إسناد مهمة من اللوحة الجانبية للإضافة، ثم متابعة Computer أثناء عمله في علامات تبويب المستخدم وأدواته. ولا تحدد تغريدة الإعلان الخطط المعنية ولا قائمة المتصفحات المدعومة.
سبقت ذلك خطوتان: في 5 أكتوبر، أتاح تطبيق Mac بالإصدار 26.38.0 لـ Computer استخدام Chrome أو Edge أو Brave بفضل إضافة، وفي 30 أكتوبر، ربطت إضافة Chrome تطبيقي Computer على Mac وWindows بمتصفح المستخدم. أما هذه المرة، فتُسنَد المهمة من اللوحة الجانبية للإضافة داخل المتصفح.
واجهات API وحزم SDK للمطورين: Codex ضمن Agents SDK بلغة Python، وDecider ضمن Context API من Perplexity
حزمة Agents SDK بلغة Python من OpenAI تطرح إصدارًا تجريبيًا 1.0 يجعل Codex مزوّدًا للنماذج
20 نوفمبر — تبدأ حزمة Agents SDK بلغة Python من OpenAI سلسلة 1.0 بإصدار تجريبي يغيّر النهج: فبدلًا من محرّك أصلي منفصل، كما في الإصدار التجريبي 0.24 الذي تناولناه هنا في 16 نوفمبر، يصبح Codex مزوّدًا للنماذج يُختار عند كل تشغيل. ويُنشَأ CodexProvider ويُمرَّر إلى Runner عبر RunConfig(model_provider=provider)؛ ثم يعمل الوكيل باستخدام اتصال Codex المحفوظ، أو باستخدام مفتاح API.
تضم حزمة wheel الخاصة بـ Python نواة Codex Core (rust-v0.166.0، من دون تعديل) عبر PyO3: وتستدعي SDK نواة Codex مباشرةً، من دون تشغيل codex app-server أو المرور عبر JSON-RPC. وتظل أدوات Python، وعمليات التسليم إلى وكيل متخصص (handoffs)، والموافقة قبل تشغيل أداة، والمخرجات ذات الأنواع المحددة متاحةً، وتتبع الأوامر الأصلية بيئة Codex المعزولة وقواعد الموافقة الخاصة به. وتُوزَّع حزم wheel للإصدار 1.0.0a1 حصريًا عبر GitHub Releases (على Linux بمعماريتَي x86-64 وARM64، وmacOS 11 فأحدث على Apple silicon، وWindows x64، وCPython من 3.10 إلى 3.14). ولا تتوافق البيانات المحفوظة من الإصدار التجريبي 0.24.0-alpha.8 مع Runner، ويظل الإصدار المستقر هو 0.25.0 الصادر في 18 نوفمبر.
🔗 openai-agents-python v1.0.0-alpha.1
Perplexity تضيف Decider إلى Context API لتقييم الصفحات، بما فيها حقن التعليمات
19 نوفمبر — تضيف Perplexity نموذج القرار الخاص بها، Decider، إلى Context API التي أُطلقت قبل يومين (1 دولار لكل 1 000 URL). ويمكن طرح ما يصل إلى خمسة أسئلة مغلقة (نعم أو لا) حول كل صفحة تُسترجَع، ويقيّم Decider كل إجابة بدرجة من 0 إلى 1. ويركّز الاستخدام المعروض على الأمن: اكتشاف حقن التعليمات (prompt injection) في صفحة قبل أن يقرأها وكيل. وتذكر Perplexity أيضًا تأهيل العملاء المحتملين، والإشراف على المحتوى، ورصد الادعاءات الصحية غير المسندة إلى مصادر.
لا ترشّح API أي شيء بنفسها: بل تعيد جميع الصفحات مع درجاتها، وتتولى شيفرة التطبيق تطبيق عتبة محددة. وتُحتسب تكلفة التقييم وفق رموز الإدخال في Decisions API، إضافةً إلى السعر لكل URL، وقد يطيل مدة الطلب بما لا يزيد على 15 ثانية. ويعرض دليل الأمثلة البرمجية في التوثيق فحصًا أُجري في 18 نوفمبر باستخدام عتبة قدرها 0,7:
| الصفحة المختبَرة (دليل الأمثلة البرمجية بتاريخ 18 نوفمبر) | درجة حقن التعليمات | قرار الفحص |
|---|---|---|
| عرض توضيحي لحقن التعليمات (غريشاك وآخرون، 2023) | 0,97 | عُزلت |
| OWASP، صفحة عن حقن التعليمات | 0,0018 | مُرِّرت |
| RFC 9111 | 0,0007 | مُرِّرت |
ويحذّر دليل الأمثلة البرمجية من أن الدرجة المنخفضة لا تجعل الصفحة آمنة: فبحسب بحث BrowseSafe++ من Perplexity، كان كل نموذج خضع للاختبار لا يزال يتبع بعض تعليمات الحقن التي سبق أن رصدها بنفسه.
🔗 سلسلة منشورات @perplexitydevs · التوثيق · دليل الأمثلة البرمجية
وكلاء البرمجة: Claude Code 2.1.329 وCodex CLI 0.171.0 وVibe CLI 3.1.4 وGemini 4 Neon في Devin
Claude Code 2.1.329 يوضح مصدر hooks عند فتح مجلد ويجمع المهام المجدولة في /tasks
19 نوفمبر — يتضمن Claude Code 2.1.329 عددًا من البنود يبلغ 130، منها 91 إصلاحًا و20 تغييرًا و7 إضافات. وعلى صعيد الأمن، يوضح الآن مربع الحوار الذي يسأل عما إذا كان المستخدم يثق بمجلد موضع تعريف hooks الخاصة به، ويحذّر Claude Desktop وغيره من المضيفين غير التفاعليين عندما لا تُحمَّل hooks المفروضة عبر الإعدادات المُدارة (managed settings). ويعرض /tasks أيضًا المهام المجدولة للجلسة، وعمليات الإيقاظ الخاصة بـ /loop، والهدف الحالي، وتفرعات المحادثة؛ وستحتاج معظم المهام المجدولة التي سجّلتها الإصدارات السابقة إلى إعادة جدولة.
أصبح /code-review، عند استخدامه من دون هدف ومع معظم النماذج، يراجع الفرع بأكمله مقارنةً بالفرع الافتراضي، وعند تزويده برقم PR يقرأ PR نفسها عبر gh pr diff. وعلى macOS، تنتقل ميزة computer use إلى قواعد أمان أحدث ترفض بعض الإجراءات. وتُزال إعادة التشغيل التلقائية التي أُضيفت في 2.1.326 بعد خطأ max_tokens: فعند العمل خلف بوابة، يجب ضبط CLAUDE_CODE_MAX_OUTPUT_TOKENS. ويحصل Code Mode على 17 بندًا، من بينها التوافق مع أحداث OpenTelemetry ومقاييسه. وقد نُشر الإصدار 2.1.330 على npm منذ 20 نوفمبر.
Codex CLI 0.171.0 يجعل GPT-6.2 Sol الخيار الافتراضي ويفعّل مساحة عمل الطرفية
20 نوفمبر — يُعد Codex CLI 0.171.0 أول إصدار مستقر منذ 0.170.0 الصادر في 18 نوفمبر، ويجمع 339 طلب سحب. وينضم GPT-6.2 Sol وGPT-6.2 Astra إلى كتالوجات النماذج، مع اختيار Sol افتراضيًا، ويدير الأمران /rc و/remote التحكم المحلي عن بُعد من الطرفية ويعرضان رموز إقران الأجهزة.
تنتقل عدة ميزات من الإصدارات التجريبية الصادرة بين 14 و17 نوفمبر إلى الإصدار المستقر: تعرض مساحة عمل TUI، المفعّلة افتراضيًا، معاينات المستندات والصور ونصوص محادثات الوكلاء الفرعيين بجانب المحادثة؛ ويبدأ codex exec --remote جلسة غير تفاعلية على خادم تطبيق قائم أو يستأنفها؛ ويحصل محرر الرسائل على التراجع والإعادة؛ ويختار /statusline أسطر حالة يوفّرها خادم MCP، مع اشتراط تفعيل خيار. ومن بين الإصلاحات، تظل المسودات وعمليات إعادة التشغيل الموضوعة في قائمة الانتظار مرتبطة بمحادثتها، ويعمل اتصال MCP الخاص بالمؤسسات مع مزوّدي الهوية الذين لا يصدرون رمز تحديث.
يفصل Vibe CLI 3.1.4 الوكيل عن سياسة الموافقة ويسحب من الوكلاء صلاحية تجاوز طلبات التأكيد
20 نوفمبر — تطرح Mistral إصدار Vibe CLI 3.1.4، بعد يومين من الإصدار 3.1.3 الذي جعل Mistral Large 4 النموذج الافتراضي. تتناول بنوده البالغ عددها 79 بندًا (18 إضافة، و41 تغييرًا، و18 إصلاحًا، وحالتا إزالة) الصلاحيات بالدرجة الأولى: تجمع كل جلسة الآن بين إعدادين مستقلين، هما الوكيل (default أو lean أو وكيل مخصص) وسياسة الموافقة (ask أو accept-edits أو smart-approve أو auto-approve)، التي تُختار عبر --approval-policy أو default_approval_policy.
لم يعد الوكيل يقرر بمفرده ما يُنفّذ دون طلب موافقة: إذ يجري تجاهل إعداداته safety وbypass_tool_permissions وpermission = "always". ولم يعد بإمكان المشروع إعادة تعريف سياسة الموافقة داخل مجلده .vibe/agents/، كما ترث عمليات التفريع والجلسات الفرعية السياسة الأصلية. وتضيف الواجهة «شريطًا» من الشارات فوق حقل الإدخال (الوكلاء الفرعيون، والمهام الخلفية، وطلبات السحب، والهدف، والمهام)، ويمنع الإعداد keep_awake الدخول في وضع السكون أثناء الجولة، كما يقبل Vibe شهادات النظام، مما يساعده على العمل خلف وكيل شبكة مؤسسي. ولا تُرسل الآن إلى نماذج Mistral سوى أحدث 8 صور، وقد أُزيلت تعليمات ضغط السياق المخصصة.
يتيح Devin استخدام Gemini 4 Neon، بنتيجة 46,2 % على FrontierCode 2.0 مقابل 4,38 دولار للمهمة
19 نوفمبر (التدوينة مؤرخة في 18 نوفمبر) — بعد Cursor وGitHub Copilot، اللذين تناولناهما هنا أمس، تتيح Cognition استخدام Gemini 4 Neon في Devin Desktop وDevin CLI. وعلى FrontierCode 2.0، وهو معيارها الذي يقيّم ما إذا كان طلب السحب يستحق الدمج، يحقق Neon نتيجة 46,2 %، وهي أفضل نتيجة لنموذج من Google بحسب Cognition. ويتأخر بنحو نقطة واحدة عن Claude Opus 5.5 (47,3 %) مقابل نحو ثلث التكلفة: 4,38 دولار للمهمة مقابل 12,82 دولار.
| النموذج المقيّم على FrontierCode 2.0 | النتيجة المنشورة من Cognition |
|---|---|
| Claude Fable 5.2 | 50,2 % |
| Claude Opus 5.5 | 47,3 % |
| Gemini 4 Neon | 46,2 % |
| GPT-6.2 Astra | 44,2 % |
| GPT-6.2 Sol | 43,8 % |
| Gemini 4 Carbon | 42,6 % |
تمثل التكلفة متوسط الإنفاق لكل تشغيل وفق السعر المعلن لواجهة API، مع احتساب الخصومات العامة، ويحصل أي حل يفشل في استيفاء معيار حاسم على درجة صفر. وتختلف عدة نتائج في هذا الرسم البياني عن القيم المنشورة في الأسابيع السابقة، دون تفسير في التدوينة.
🔗 Gemini 4 Neon في Devin (Cognition) · @cognition على X
العلوم: تنشر OpenAI معيار MedChemBench للكيمياء الدوائية، ويحقق فيه GPT-6.2 Astra نتيجة 84,5 %
20 نوفمبر — تقدم OpenAI معيار MedChemBench، الذي يقيس قدرة النماذج على الاستدلال مثل المتخصص في الكيمياء الدوائية: ربط بنية الجزيء بالنتائج التجريبية، ومقارنة المركبات، والتنبؤ بخصائصها. ويضم 99 مسألة مستمدة من 117 مقالة وبراءة اختراع، مع 761 بنية جزيئية متميزة، ويقيّم أربعة مكونات: البنى، والاستدلال العلمي، واختيار المركبات، والتنبؤ بالخصائص.
| النموذج المقيّم (مستوى الاستدلال xhigh) | النقاط المحصّلة |
|---|---|
| GPT-6.2 Astra | 84,5 % |
| GPT-6 Astra | 83,3 % |
| GPT-6.1 Sol | 82,0 % |
| GPT-6.1 Terra | 75,1 % |
| GPT-5.6 Sol | 58,2 % |
الأداء متفاوت: يحصل GPT-6 Astra على 95,4 % من النقاط في البنى، لكنه يحصل على نحو النصف في اختيار المركبات والتنبؤ بالقيم العددية. وتظل OpenAI حذرة: يعتمد المعيار على بيانات تاريخية ولا يثبت قدرة النماذج على اكتشاف أدوية جديدة، ولا يمكن استبعاد تعرضها سابقًا للمنشورات المصدرية، كما أن التقييم اقتصر على نماذج GPT. ويأتي هذا المعيار بعد BioBasicsBench، الذي تناولناه هنا في 6 نوفمبر.
🔗 تقديم MedChemBench (OpenAI) · المقالة الكاملة (PDF)
الفيديو والصوت التوليديان: تضيف ElevenLabs إلى Ads Engine نسخًا متنوعة من الإعلانات دون تصوير جديد
20 نوفمبر — توسّع ElevenLabs إمكانات Ads Engine، أداة إنشاء الإعلانات المدمجة في ElevenCreative والتي أُطلقت في يونيو. وتتصل الأداة بحسابات الإعلانات على Google وMeta وLinkedIn، والآن TikTok، وتنطلق من الإعلانات الحالية ونتائجها لإنتاج نسخ متنوعة منها دون تصوير جديد. فهي تحدد العبارة الافتتاحية الجاذبة (hook) وتكتب عبارات جديدة استنادًا إلى الإعلانات الناجحة؛ وتُؤدّى هذه العبارات بنسخة رقمية من صوت المتحدث الأصلي، مع مزامنة حركة الشفاه وتحديث الترجمة النصية. ويمكن استخدام المقاطع الموسيقية الجديدة تجاريًا، إذ تؤلفها واجهة API الخاصة بـ ElevenLabs Music وفق طابع الصور وإيقاعها.
وفي مجال التوطين، الذي يتولاه Dubbing v2 بالفعل، بات Ads Engine يزامن شفاه المتحدث مع اللغة المستهدفة، ويستبدل الترجمة النصية المدمجة بنسخة مترجمة تراعي التوقيت وخطوط العلامة التجارية. وتظل المراجعة البشرية ممكنة قبل النشر، بما في ذلك الاستعانة بمتخصص في التوطين من الناطقين الأصليين باللغة، ويمكن للأداة النشر مباشرة على المنصات. ويتطلب الوصول إليها التواصل مع فريق المبيعات، دون أسعار معلنة.
🔗 تنويع إعلانات الفيديو وتوطينها في Ads Engine (ElevenLabs)
أخبار موجزة
وكلاء البرمجة
- Copilot CLI 1.0.115-2 — في هذا الإصدار التجريبي الذي يضم 351 بندًا، منها 335 إصلاحًا، ينضم Gemini 4 Hydrogen إلى قائمة النماذج بمستوى الجهد Extra High عندما يتيح الحساب الوصول إليه، ويُضاف دعم GPT-6.2 Astra، كما يدير
/modelنماذج المزوّدين المخصصين أيضًا؛ ويظل الإصدار المستقر هو 1.0.114. 🔗 المصدر - Codex CLI 0.173.0-alpha.1 وalpha.2 — ملاحظات هذين الإصدارين التجريبيين فارغة؛ وبحسب عناوين التغييرات البالغ عددها 71، تصبح مشاركة اتصالات MCP واكتشاف OAuth للخوادم المُعدّة مفعّلتين افتراضيًا، وسيتمكن المسؤولون من تعطيل تحديثات خدمة Codex الخلفية. وقد يتغير المحتوى قبل الإصدار المستقر. 🔗 المصدر
- Gemini CLI — أول إصدار ليلي منذ 4 نوفمبر (v0.71.0-nightly.20261120)؛ وعلى الفرع الرئيسي، يعيد
gemini --resumeفتح الجلسة الأحدث استخدامًا بدلًا من الجلسة الأحدث بدءًا، وأصبحت المسارات التي تبدأ بـ~\تُوسَّع أخيرًا على Windows. 🔗 المصدر - Antigravity IDE 2.8.0 — يشغّل محرر Google واجهته الخلفية فورًا ويفحص التحديثات في الخلفية، ويعيد توجيه المنافذ تلقائيًا للاتصال عن بُعد، ويتيح البحث داخل المحادثة بلوحة المفاتيح، ويقبل شهادات مخصصة ووكيل شبكة عند الاتصال. 🔗 المصدر
- Qwen Code 0.28.1-preview.1 — يجعل هذا الإصدار التجريبي، الذي يضم 179 بندًا، GitHub ثالث موصّل قنوات مدعوم، ويضيف WeCom وMicrosoft Teams وخطافات ويب صادرة عامة قابلة للإعداد من واجهة الويب، ويضيف إلى CLI وضع عرض مناسبًا لقارئ الشاشة؛ ويظل الإصدار المستقر هو v0.28.0. 🔗 المصدر
- Kimi Code 2.7.1 و2.7.2، وKimi Code Desktop 1.4.1 و1.4.2 — أربعة إصدارات إصلاحية في اليوم التالي للإصدار 2.7.0: لم يعد مستوى جهد التفكير المحدد في مسودة يعود إلى القيمة الافتراضية بعد الإرسال، ولم تعد عمليات التفريع تفشل بعد استعادة جلسة أُعيد توجيهها أثناء الجولة. 🔗 المصدر
- CLI mistral 0.20.1 — ينتهي
mistral evals execالآن بحالة فشل (الرمز 1) عندما تفشل جميع الاستدعاءات ضمن تشغيل واحد، مثلًا بسبب خطأ 401، بدلًا من إعلان نجاحه؛ كما يُبلَّغ عن المقاطعة عبر Ctrl-C بوصفها مقاطعة. 🔗 المصدر - Replit — أصبح بالإمكان البحث عن مساحات العمل (Workspaces) وتثبيتها، وهو خيار لا يظهر إلا عند وجود خمس مساحات على الأقل. 🔗 المصدر
- Devin Bot لـ Manim — تعرض Cognition وكيل Devin Bot الذي أعدّه غرانت ساندرسون لمساعدته في Manim، نظام الرسوم المتحركة مفتوح المصدر المستخدم في فيديوهات 3Blue1Brown (96,6 ألف نجمة، و250 000 تنزيل شهريًا)؛ ولا تحدد التغريدة المهام المسندة إلى الوكيل أو نتائجه. 🔗 المصدر
واجهات API والمنصات
- واجهة Gemini API — منذ 17 نوفمبر، يتيح Gemini 3.5 Transcribe، بنسختيه العادية والمباشرة، تعديل نص مُملى أو نص موجود وإعادة كتابته وتنسيقه بالصوت (المعامل
source_text)، وتذكر Google الترجمة أيضًا. ومنذ 18 نوفمبر، تتيح واجهة API معالجة الجزء المفيد فقط من الملفات المرسلة، والدفع مقابله فقط: نطاقات الصفحات، أو علامات التبويب، أو الخلايا، أو الفترات الزمنية، أو طبقات المحتوى. 🔗 المصدر - الوعي بالوقت في واجهة Agents API — يذكّر خيار تجريبي (
experimental={"time_awareness": True}) النموذج بالوقت دوريًا ليكيّف عمله مع موعد نهائي؛ وعند دمجه مع الأدوات غير المتزامنة، يتيح للوكيل طرح سؤال ومواصلة البحث أثناء انتظار الإجابة، كما توضح تدوينة على مدونة مطوري OpenAI. 🔗 المصدر - سجل المحادثات مع GPT-6.2 — يطلب @OpenAIDevs التوقف عن تعديل الرسائل السابقة في Responses API، لأن الواجهة تتخلى عن الاستدلال الذي يلي التعديل. ويساعد قسم جديد بعنوان «حذف الاستدلال» في لوحة «الاستخدام» على رصد ذلك، ويقترح الدليل المرتبط إضافة عنصر
configuration_updateأوadditional_toolsبدلًا من ذلك لتغيير مستوى الجهد أو الأدوات. 🔗 المصدر
المساعدات الموجهة للجمهور العام
- يطرح ChatGPT تطبيقًا جديدًا للهاتف مع علامة تبويب لـ dot ومفضلات مثبتة — يمكن تثبيت Codex أو Projects أو Images في شريط علامات التبويب؛ ويبدأ الطرح لمشتركي Pro بعمر 18 عامًا فأكثر في المناطق التي تتوفر فيها dots، باستثناء المنطقة الاقتصادية الأوروبية (بما فيها الاتحاد الأوروبي) والمملكة المتحدة وسويسرا وكوريا، ولمجموعة صغيرة من مشتركي Plus أيضًا (ملاحظات إصدار 19 نوفمبر، المرتبطة أعلاه).
- Teammates من Perplexity — يمكن لمشتركي Max الآن إنشاء زميل من أي مهمة Computer على الويب، ثم تغيير اسمه أو دوره أو صورته الرمزية داخل المحادثة نفسها. 🔗 المصدر
- تطبيق Perplexity على Mac — أصبح أسرع، ويضيف خيار «إرسال الآن» لإعادة توجيه مهمة جارية، والاختصار ⌘F للبحث في الجداول وMarkdown والمعاينات، والاختصار ⌘⇧T لإعادة فتح علامة تبويب مغلقة. 🔗 المصدر
الفيديو والصوت التوليديان
- Seedance 2.5 Flash على Pika — بعد Runway وHeyGen، تضيف Pika النسخة السريعة من نموذج الفيديو لدى ByteDance للأعمال التي تتطلب لقطات عديدة: فيديوهات تصل مدتها إلى 30 ثانية بدقة 480p أو 720p، وما يصل إلى 10 صور و5 فيديوهات و5 مقاطع صوتية كمراجع؛ ولا تذكر التغريدة سعرًا. 🔗 المصدر
- Avatar 6 من HeyGen — اختبارات جديدة دون كشف هوية النماذج مستمدة من التقرير التقني: عندما يختار الأشخاص المصوَّرون، وهم موظفون في HeyGen، الفيديو الأكثر شبهًا بهم، يتفوق Avatar 6 بنسبة 86,5 % أمام Seedance 2.5 وبنسبة 87,9 % أمام Wan 3.0؛ وتجري HeyGen هذه التقييمات. 🔗 المصدر
- Qwen3 TTS لدى Together AI — تتوفر خدمة تحويل النص إلى كلام المفتوحة Qwen3-TTS-12Hz-1.7B (Apache 2.0) مقابل 20 دولارًا لكل مليون حرف، مع تسعة أصوات قابلة للضبط بتعليمات بلغة طبيعية، وعشر لغات منها الفرنسية، وظهور أول صوت خلال 97 ms في أفضل الحالات. 🔗 المصدر
البنية التحتية والأبحاث
- Together Storage Accelerator — تقدم Together AI مع كل عنقود GPU ذاكرة تخزين مؤقت NVMe لتخزين S3 ومركز Hugging Face Hub، دون تغيير الشيفرة؛ وبحسب قياساتها، ينخفض زمن قراءة ملف حجمه 2 Gio من Cloudflare R2 من نطاق 12,7 إلى 15,0 s إلى نطاق 0,64 إلى 0,72 s، ولا ينزّل عنقود من 200 عقدة الملف من المصدر إلا مرة واحدة. 🔗 المصدر
- شبكة CDN من Hugging Face — تقدم Hugging Face ما يقارب إكسابايت من النماذج ومجموعات البيانات المفتوحة شهريًا، بحسب شريكها المؤسس جوليان شومون، وقد بنت شبكة توزيع محتوى خاصة بها (CDN) لتنزيلات الذكاء الاصطناعي. 🔗 المصدر
- Superfluid من basecompute — يوزّع الخادم المحلي الآن الاستدلال بين أجهزة Apple وAMD وNVIDIA: ترفع ستة أجهزة معدل الإنتاج من 112 إلى 534 رمزًا مخرجًا في الثانية لـ 64 مستخدمًا في المحاكاة، ولا يؤدي توقف عقدة إلى فقدان أي طلب، بحسب الجهة المطورة. 🔗 المصدر
- WavLate — يبحث نموذج التفاعل المتأخر المفتوح هذا عن الأصوات بالنص وعن النص بالصوت، باستخدام متجه لكل 0,31 ثانية من الصوت ومتجه لكل كلمة؛ ويعلن مطوره عن متوسط Recall@1 يبلغ 37,9 على AudioCaps وClotho، وهو الأفضل بين النماذج المفتوحة التسعة التي شملتها المقارنة، وينشر الأوزان والبيانات. 🔗 المصدر
- WorldTrace — تقدم NVIDIA Research ذاكرة لنماذج العالم التفاعلية القائمة على الفيديو، دون إعادة تدريب (قُبلت الورقة في NeurIPS 2026): على LoopBench، يتحسن استرجاع المشاهد التي يُعاد المرور بها بنسبة 32,6 % مقارنة بالنافذة المنزلقة، مقابل استهلاك 3,1 Go من ذاكرة GPU وزيادة وقت التنفيذ بنسبة 27 %. 🔗 المصدر
- Dynamo للتعلم المعزز — توضح NVIDIA بالتفصيل كيف يخدم Dynamo مسارات التنفيذ في التدريب اللاحق: التوجيه بحسب ذاكرة KV المؤقتة، والنقل التفاضلي للأوزان باستخدام ModelExpress، واستعادة عمليات العمل المتعطلة. وتستخدمه Microsoft AI وCognition (لـ SWE-1.7) وPrime Intellect وH Company؛ وتوفر H Company ما يصل إلى 20 % من الوقت لكل خطوة تدريب. 🔗 المصدر
- الانتباه المتناثر — في دليل بتاريخ 17 نوفمبر، تقدم NVIDIA ثماني قواعد تصميم للانتباه المتناثر المدرَّب على وحدات GPU لديها؛ ويستأثر المفهرس الذي يختار الرموز وعملية Top-k بنسبة 47 % من زمن طبقة prefill في DeepSeek V3.2 عند 128K رمز. 🔗 المصدر
GitHub
- GitHub Enterprise Server 3.23 بنسخة مرشحة للإصدار — يعمل اكتشاف الأسرار بالذكاء الاصطناعي، المتاح في معاينة عامة، على معالج الجهاز، دون GPU أو LLM مستضاف أو اتصال صادر، بما في ذلك البيئات المعزولة (air-gapped)؛ كما يوسّع الإصدار اكتشاف الحزم الخبيثة المعروفة ليشمل سبع منظومات إضافية إلى جانب npm. 🔗 المصدر
- خارج الذكاء الاصطناعي — يوضح GitHub حالة الدمج في صفحة «نظرة عامة» الجديدة لطلبات السحب، ويقبل GitHub Desktop 3.7.0 عدة حسابات على المضيف نفسه، وتعرض لوحة المعلومات ما يصل إلى 25 مستودعًا مفضلًا. 🔗 نظرة عامة · 🔗 Desktop · 🔗 المفضلات
الأعمال والمقالات
- Hebbia — في اختبارات البحث المالي التي أجرتها خلال أغسطس وسبتمبر، تستشهد نسخة تجريبية من GPT-6 Astra بمقتطفات ذات صلة بنسبة 99,5 %، وتلتزم بنسبة 97,9 % من متطلبات العرض، متقدمة بـ 14,4 نقطة على أفضل بديل اختُبر، والذي لا تسميه دراسة الحالة المنشورة من OpenAI. 🔗 المصدر
- الإجماع الصامت — تنشر OpenAI في قسمها «عصر الذكاء» (عصر الذكاء) مقالًا لدين بول، مقتبسًا من محاضرة في هارفارد ومقدمًا بوصفه معبرًا عن آراء مؤلفه، يعارض فكرة أن التخلي عن أولوية الإنسان أمر حتمي؛ ويدعو إلى وكلاء مرتبطين بأشخاص، بصلاحيات محدودة وقابلة للإلغاء. 🔗 المصدر
- إثراء البيانات — يصف دليل من Perplexity كيفية استكمال سجلات CRM والتحقق منها باستخدام نموذج متصل بالويب، في ست خطوات؛ وتنفذ Apollo من خلال واجهة API الخاصة بـ Perplexity عددًا يبلغ 5,6 ملايين عملية إثراء شهريًا. 🔗 المصدر
ما الذي يعنيه ذلك
يجمع الطرح العام الأولي لشركة Anthropic، في منشور واحد، بين أموال الأسواق وأموال القطاع. ويوفّر الاكتتاب العام للشركة نحو 91,6 مليار دولار من العائدات الإجمالية، ويضيف الطرح الخاص 26 مليارًا أخرى، اكتتبت بها سبع مجموعات من قطاعَي أشباه الموصلات والحوسبة بالسعر نفسه البالغ 83 دولارًا: AMD وBroadcom وGoogle وMicron وMicrosoft وNVIDIA وTSMC Partners. وتقترب العائدات الإجمالية للعملية من 119,5 مليار دولار: فإلى جانب مستثمري الاكتتاب، تشتري سبع مجموعات من القطاع أسهمًا في مختبر للذكاء الاصطناعي أصبح الآن مدرجًا في Nasdaq.
يتزايد ضبط الأمان داخل آليات عمل الأدوات نفسها. تربط OpenAI استدلال GPT-6.2 بسجل المحادثة الذي أنتجه، ما يخفض نسبة الاستخراج المقاسة من 54,0 % إلى 0,2 %، لكنه يفرض على المطوّرين التوقف عن إعادة كتابة محادثاتهم. ويسحب Vibe CLI من الوكلاء صلاحية تجاوز التأكيدات بأنفسهم، ويعرض Claude Code مصادر hooks الخاصة بمجلد قبل الوثوق به، ويقيّم Decider الصفحات قبل أن يقرأها أي وكيل. ومن جانبها، تنشئ Sakana AI فريقًا مخصصًا للدفاع الجماعي، مع التعهد بعدم نشر مواد لاستغلال الثغرات.
ينتقل الوكلاء من كتابة الشيفرة إلى سلسلة تسليم البرمجيات. ففي Runway، يتولون 38 % من عمليات الدمج في أكتوبر، ويوافق الذكاء الاصطناعي وحده على التغييرات منخفضة المخاطر؛ ويراقب Stitch Loop منتجًا متاحًا على الإنترنت ويفتح طلبات سحب لتحقيق هدف قابل للقياس. وفي الحالتين، يحتفظ شخص بالسيطرة على ما يهم: الأجزاء الحساسة لدى Runway، وكل عملية دمج لدى Stitch Loop. وتواكب الأدوات هذا التطور: إذ تجعل Agents SDK الخاصة بلغة Python من Codex موفّرًا للنماذج، وتقيّم Cognition النماذج وفق السؤال الذي تطرحه هذه السلاسل، وهو ما إذا كان ينبغي دمج PR.
أما في النماذج المفتوحة، فيتركز الجهد على ما يمكن استخلاصه من أوزان أخف. يمر Inkling 2 Mini عبر طبقاته الوسطى ثلاث مرات ليعادل أداء Qwen3.8-27B في AA Index ضمن 20 غيغابايت، ويجمع المهايئ الفائق من Hugging Face ثلاثة تخصصات في LoRA واحد، وتنطلق Metric AI من Qwen3.5 لبناء نماذج للغة الأرمنية. وتظل الأرقام صادرة عن الجهات المطوّرة، فيما يذكّر MedChemBench بحدود هذا التقييم: إذ لا تقيّم OpenAI فيه سوى نماذجها، ولا تستبعد أن تكون قد اطّلعت على المنشورات المصدرية.
المصادر
- إتمام الطرح العام الأولي (Anthropic)
- @AnthropicAI على X: المؤسسون المشاركون
- Inkling 2 Mini (Thinking Machines)
- تدوينة Hugging Face حول Inkling 2 Mini
- Inkling-2-Mini (Hugging Face)
- Tencent Hy4 على Together AI
- بيان Tencent حول Hy4
- تسخير المهايئات على نطاق واسع (Hugging Face)
- @yb2698 على X: المهايئ الفائق
- Ayb 0.5 (Metric AI)
- OhanTTS (Metric AI)
- OhanASR (Metric AI)
- @pcuenq على X: Depth Pro 2
- ورقة arXiv 2611.26603: Depth Pro 2
- DepthPro2-L (Hugging Face)
- مكافحة التقطير العدائي (OpenAI)
- @OpenAI على X: التقطير العدائي
- @hardmaru على X: مجموعة أبحاث الأمان
- مجموعة أبحاث الأمان (Sakana AI)
- بناء مصنع للبرمجيات (Runway)
- Stitch Loop (Google)
- ملاحظات إصدار ChatGPT
- @GeminiApp على X: إتاحة صور GIF
- @GeminiApp على X: صور GIF في Gemini
- @perplexity_ai على X: Computer في Chromium
- openai-agents-python v1.0.0-alpha.1
- @perplexitydevs على X: Decider في Context API
- تقييم الصفحات وفق معايير (وثائق Perplexity)
- دليل تطبيقي لمكافحة حقن التعليمات (وثائق Perplexity)
- Claude Code v2.1.329
- Codex CLI 0.171.0
- Vibe CLI v3.1.4
- Gemini 4 Neon في Devin (Cognition)
- @cognition على X: Gemini 4 Neon
- تقديم MedChemBench (OpenAI)
- الورقة الكاملة عن MedChemBench (PDF)
- تنويعات إعلانات الفيديو وتوطينها في Ads Engine (ElevenLabs)
- Copilot CLI 1.0.115-2
- Codex CLI 0.173.0-alpha.2
- Gemini CLI، PR 30389
- سجل تغييرات Antigravity
- Qwen Code v0.28.1-preview.1
- Kimi Code 2.7.2
- CLI mistral 0.20.1
- سجل تغييرات Replit ليوم 20 نوفمبر
- @cognition على X: Devin Bot لـ Manim
- ملاحظات إصدار API الخاصة بـ Gemini
- الوعي بالوقت والمدخلات غير المتزامنة للوكلاء الشخصيين (OpenAI)
- @OpenAIDevs على X: سجل محادثة GPT-6.2 واستدلاله
- @AskPerplexity على X: زملاء الفريق من داخل Computer
- @AskPerplexity على X: تطبيق Mac
- @pika_labs على X: Seedance 2.5 Flash
- @HeyGen على X: الاختبارات العمياء لـ Avatar 6
- Qwen3 TTS على Together AI
- Together Storage Accelerator (Together AI)
- @julien_c على X: شبكة CDN الخاصة بـ Hugging Face
- Superfluid ضمن أسطول (basecompute)
- WavLate (Hugging Face)
- @NVIDIAAI على X: WorldTrace
- Dynamo وعمليات توليد المسارات في RL (NVIDIA)
- الانتباه المتناثر على وحدات GPU من NVIDIA (NVIDIA)
- النسخة المرشحة للإصدار من GitHub Enterprise Server 3.23 (سجل تغييرات GitHub)
- صفحة النظرة العامة لطلبات السحب (سجل تغييرات GitHub)
- GitHub Desktop وحسابات متعددة لكل مضيف (سجل تغييرات GitHub)
- المستودعات المفضلة على لوحة المعلومات (سجل تغييرات GitHub)
- Hebbia وGPT-6 Astra (OpenAI)
- الإجماع الصامت (OpenAI)
- إثراء البيانات بالذكاء الاصطناعي (Perplexity)